От прогноза потока клиентов к оптимальному штату сотрудников
Клиентский поток неоднороден. Он зависит от дня недели, месяца, праздников, времени суток, расположения и формата отделения, а также от локального расписания. Среднее значение за месяц для кадрового планирования почти бесполезно: два отделения с одинаковым месячным объёмом могут иметь совершенно разные утренние пики, продолжительность рабочего дня и долю вечерних посещений.
Поэтому банку критически важен прогноз клиентопотока для сбалансированного операционного планирования: нехватка сотрудников ведёт к росту очередей и риску нарушения целевых сроков обслуживания, а избыток — к оплате непродуктивных часов и неравномерной нагрузке на персонал, а сами работники получают неравномерное расписание и вынуждены компенсировать пики переработками.
Поэтому для операционного планирования нужен прогноз не только на уровне отделения и дня, но и для каждого рабочего часа.
Практическая ценность проявляется в трёх направлениях: для бизнеса — сокращение лишних трудочасов и авральных корректировок графика; для клиентов — более короткое и стабильное ожидание, особенно в пики; для сотрудников — равномерная нагрузка и предсказуемые смены.
Меня зовут Роман Гатауллин, я младший специалист по разработке нейронных сетей в Управлении по разработке моделей глубокого обучения [1] и прикладных исследований. В этом проекте я отвечал за time-series часть: эксперименты с Prophet и Temporal Fusion Transformer. Статью мы подготовили вместе с Иваном Семидетновым, специалистом по интеллектуальному анализу данных из Дирекции по разработке моделей общекорпоративных функций. Над задачей работали две команды, и ниже мы расскажем, как прогнозировали почасовой клиентопоток в отделениях и что из этого получилось.
В этой работе мы рассматриваем прогноз клиентопотока как первый слой системы управления ресурсами. Модель оценивает число клиентов для пары «отделение — дата — час» на горизонте одного месяца. Затем оптимизатор может преобразовать этот спрос в необходимое число сотрудников на рабочих местах с учётом производительности, длительности операций, компетенций, смен, трудовых ограничений и целевого качества сервиса. Такое разделение делает решение объяснимым: прогноз отвечает на вопрос «Какая нагрузка ожидается?», а оптимизатор — «Как покрыть её минимально необходимым и достаточным составом?».
В качестве базового решения использовался стекинг моделей на основе CatBoost: сначала прогнозируется дневной объём, затем он распределяется по часам с учётом календаря, графика работы, географии и исторического профиля отделения. Бейзлайн оказался сильным и пригодным для батчевого применения, но сложная мультисезонность оставалась ограничением. Развитие решения объединило Prophet как источник интерпретируемых сезонных компонент и Temporal Fusion Transformer как модель, способную работать с большим числом разнородных признаков и множеством рядов. На часовом micro-срезе финальная конфигурация снизила MAE с 1,951 до 1,478, то есть примерно на 24%. WAPE уменьшился с 32,1% до 30,3%: на 1,8 процентного пункта, или на 5,6% относительно бейзлайна.
Важно не приписывать весь эффект одной модели. Offline-качество прогноза ещё не равно экономии. Денежный и операционный результат измеряется после интеграции с оптимизатором, на пилоте с контрольной группой или сопоставимым историческим периодом.
Постановка задачи
Пусть y(b,d,h) — фактическое число клиентов в отделении b в дату d и час h. Требуется получить неотрицательный прогноз ŷ(b,d,h) на горизонте 45 дней, так как инференс производится двадцатого числа каждого месяца до конца текущего и конца следующего месяца, в среднем получается 45 дней. По умолчанию рассматриваются часы с 8:00 до 21:00. Одновременно строится дневной прогноз ŷ(b,d), равный ожидаемому суммарному потоку за день.
Решение работает в батчевом режиме. Это соответствует кадровому планированию: расписание нужно подготовить заранее, а не пересчитывать при каждом новом визите. При этом модель должна масштабироваться на сотни отделений, учитывать различия между ними и корректно обрабатывать нерабочие дни и часы.
Как измерять качество
Бизнес-метрики
Для конечной системы полезнее всего метрики, связанные с принятым расписанием:
-
доля интервалов с дефицитом сотрудников и суммарное число недопокрытых трудочасов;
-
доля интервалов с избыточным персоналом и стоимость лишних трудочасов;
-
среднее и верхние квантили времени ожидания клиента, а также доля обслуживания в пределах SLA;
-
объём сверхурочных, срочных замен и изменений расписания после публикации;
-
стабильность нагрузки на одного сотрудника и разброс загрузки между соседними сменами;
-
экономический эффект относительно действующего процесса планирования при сопоставимом уровне сервиса.
Эти показатели должен считать оптимизационный контур. В текущем исследовании они задают направление, но не подменяются модельными метриками.
Технические метрики
Для сравнения моделей используются MAE, RMSE, WAPE, SMAPE и MAPE. MAE легко интерпретировать как среднюю ошибку [2] в клиентах. RMSE сильнее штрафует редкие крупные промахи. WAPE показывает суммарную абсолютную ошибку относительно общего потока и поэтому удобен для оценки масштаба сети. SMAPE и MAPE помогают сравнивать ряды разного размера, но MAPE нестабилен при малых и нулевых значениях.
Основными метриками для выбора решения разумно считать MAE и WAPE, а SMAPE — контролем справедливости качества между отделениями.
Данные и основные сложности
Исходная витрина собирается из нескольких групп источников:
-
история клиентопотока по отделениям и часам;
-
графики работы отделений, начало и конец рабочего дня, доступные часы;
-
праздничный календарь, признаки выходных и расстояние до соседних праздников;
-
справочник отделений: город, федеральный субъект, тип, бизнес-линия, дата открытия и другие атрибуты;
-
географические и инфраструктурные признаки: координаты, население, транспортная доступность, POI и характеристики городской среды.
В time-series экспериментах панель насчитывала около 1,9 млн строк. Главные сложности были связаны не только с объёмом, но и со структурой данных: отделения имеют разные рабочие недели, внутри дня действует выраженный профиль, а недельная, месячная, годовая и праздничная сезонности накладываются друг на друга.
CatBoost-бейзлайн: сильная отправная точка
Почему архитектура двухэтапная
Прямой прогноз каждого часа — сложная задача: модели одновременно нужно оценить общий объём дня и форму внутридневного профиля. В бейзлайне эти задачи разделены.
-
Daily CatBoost оценивает суммарное число клиентов в отделении за день.
-
Hourly CatBoost получает дневной прогноз как один из ключевых признаков и детализирует объём по рабочим часам.
Такой каскад вводит полезное ограничение: почасовая модель знает ожидаемый масштаб дня и сосредотачивается на распределении потока внутри него.
Признаки дневной модели
Дневной уровень объединяет несколько типов признаков:
-
календарь: день недели, месяц, неделя года, квартал, начало и конец месяца, выходной;
-
праздники: признак праздника, длительность предыдущих и следующих праздничных периодов, расстояние до них;
-
профиль отделения: среднее, медиана, стандартное отклонение и 90-й процентиль дневного потока;
-
условные исторические средние по отделению и дню недели, месяцу и типу дня, а также городские и типовые агрегаты;
-
расписание: начало и конец работы, длительность смены, число активных часов, короткий или длинный рабочий день;
-
статические и географические признаки отделения.
Целевая переменная преобразуется как log(1 + y), что уменьшает влияние крупных отделений и выбросов. CatBoost оптимизирует RMSE в логарифмическом пространстве; после обратного преобразования прогноз ограничивается снизу нулём.
Признаки почасовой модели
Hourly CatBoost использует те же группы данных, но добавляет информацию о положении часа внутри дня:
-
циклические признаки часа и дня недели через
sin/cos; -
расстояние от открытия и до закрытия, зоны первого и последнего часа, утренний, дневной и вечерний сегменты;
-
исторические доли потока в окнах 08–11, 12–17 и 18–20, а также доли характерных пиков;
-
дневной прогноз, прогноз на активный час и взаимодействия дневного прогноза с часом, выходным и профилем отделения;
-
принудительный ноль для часов, в которые отделение не должно обслуживать клиентов.
Категориальные признаки передаются CatBoost напрямую. При большом наборе кандидатов отдельная модель ранжирует важности и ограничивает набор примерно 100 признаками для daily и 120 для hourly. Гиперпараметры подбираются Optuna по RMSE на хронологическом holdout; используются early stopping и фиксированный seed.
Валидация и качество бейзлайна
Валидация не перемешивает время: последние 45 дней полностью отделены от обучения. Кроме общих метрик сохраняются срезы по месяцу, отделению и часу, тепловые карты ошибок и распределения прогнозов. После выбора конфигурации обе модели переобучаются на всей доступной истории для формирования итоговых артефактов.
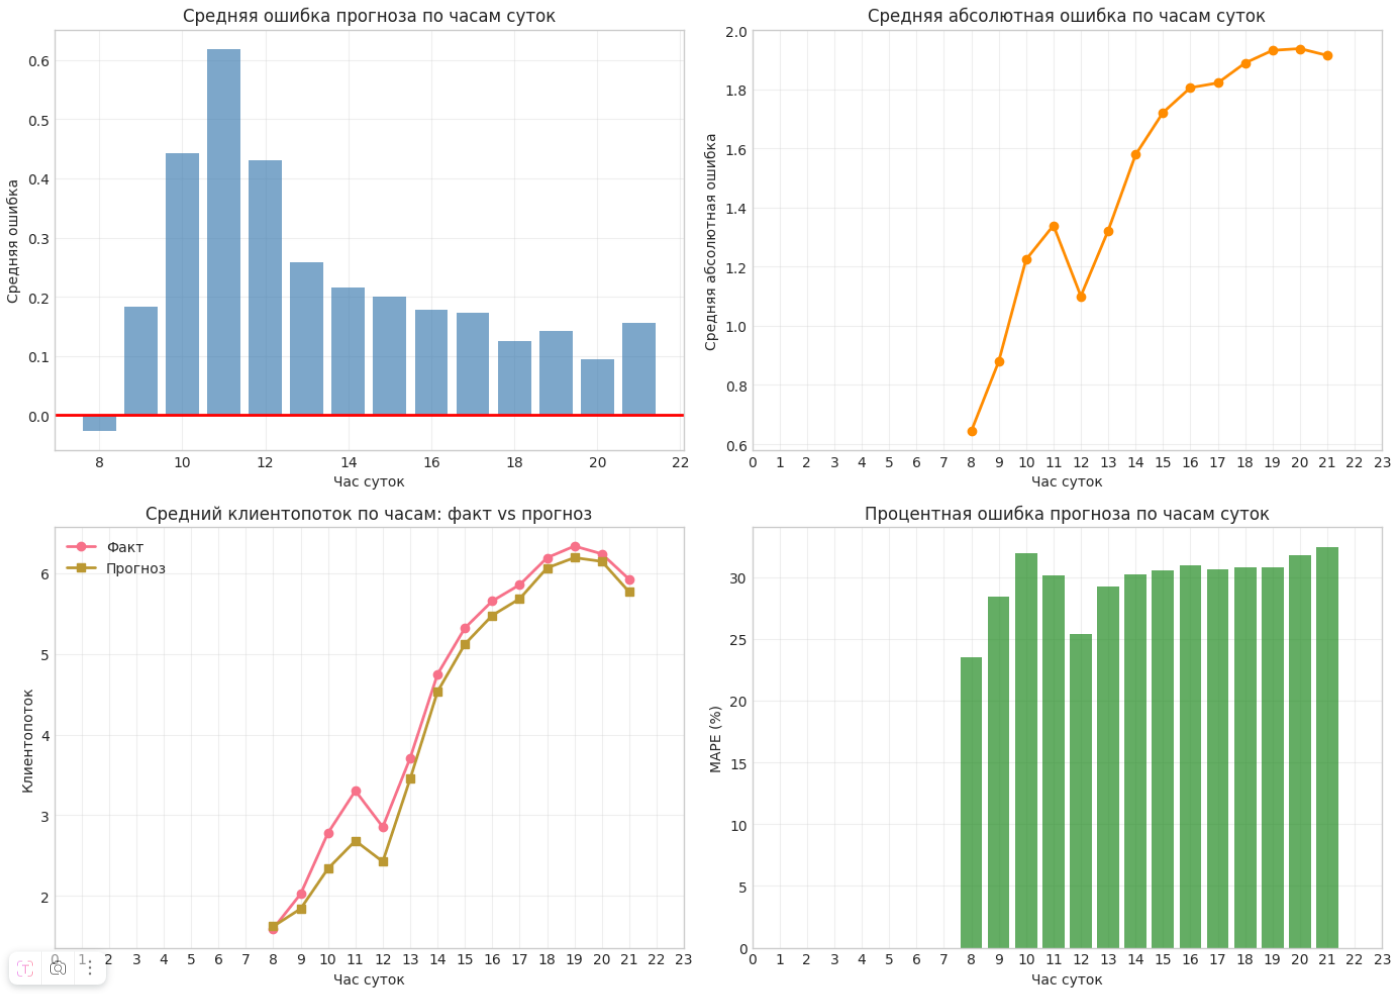
На часовом срезе, который далее используется для сравнения моделей, бейзлайн получил MAE 1,951, RMSE 2,809, WAPE 0,321, SMAPE 0,376 и MAPE 44,3%.
Что у бейзлайна получилось и где возник потолок
Сильные стороны CatBoost — устойчивость к пропускам и разнородным признакам, естественная работа с категориями, быстрый инференс и хорошая воспроизводимость. Для первого промышленного контура это рациональный выбор.
Ограничение проявилось во времени. CatBoost видит сезонность через заранее сконструированные календарные признаки и исторические агрегаты, но не моделирует длинную последовательность напрямую. Когда недельный, внутридневной, месячный и праздничный паттерны взаимодействуют, ручного набора признаков становится недостаточно. Это стало отправной точкой time-series команды.
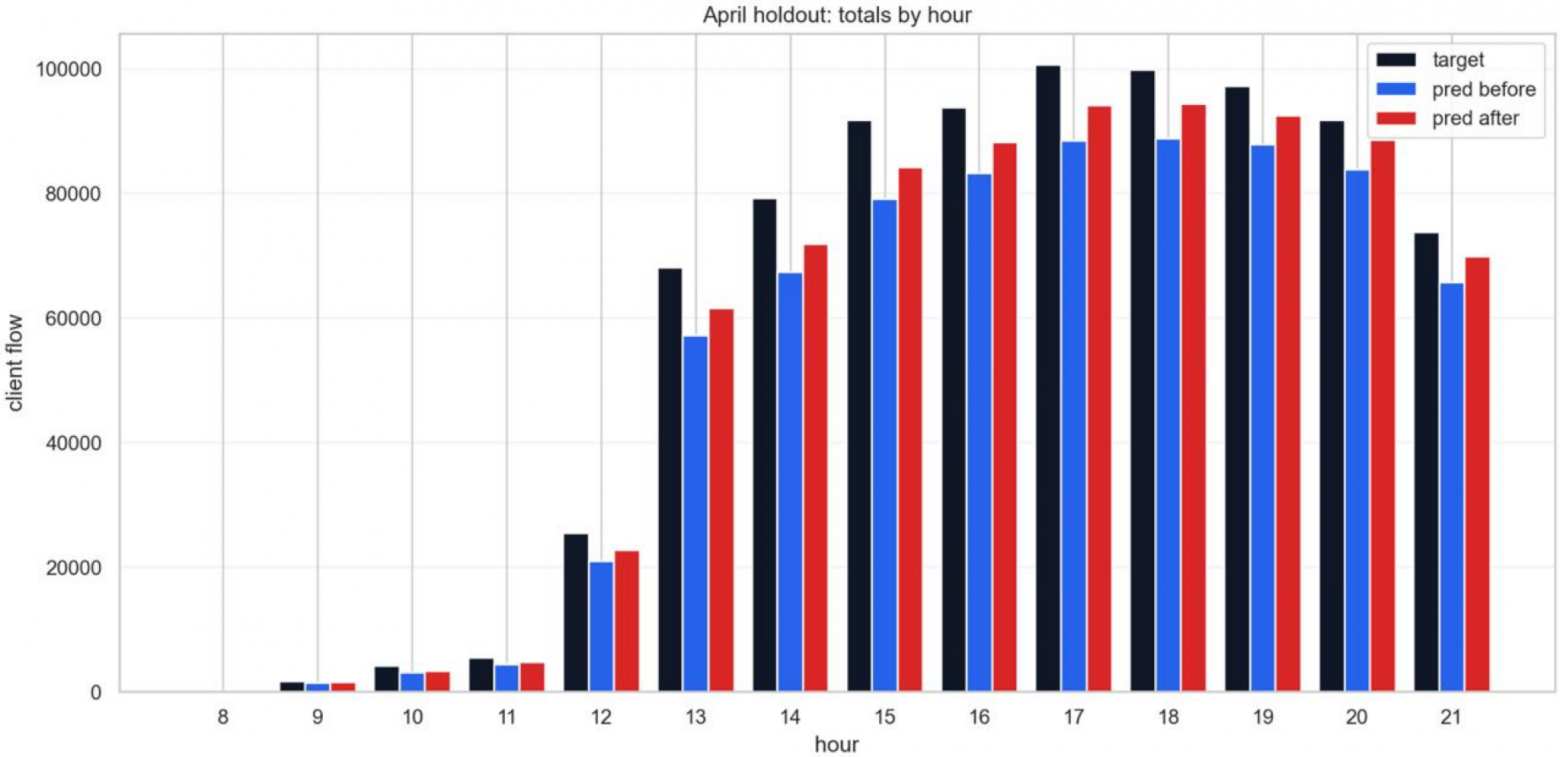
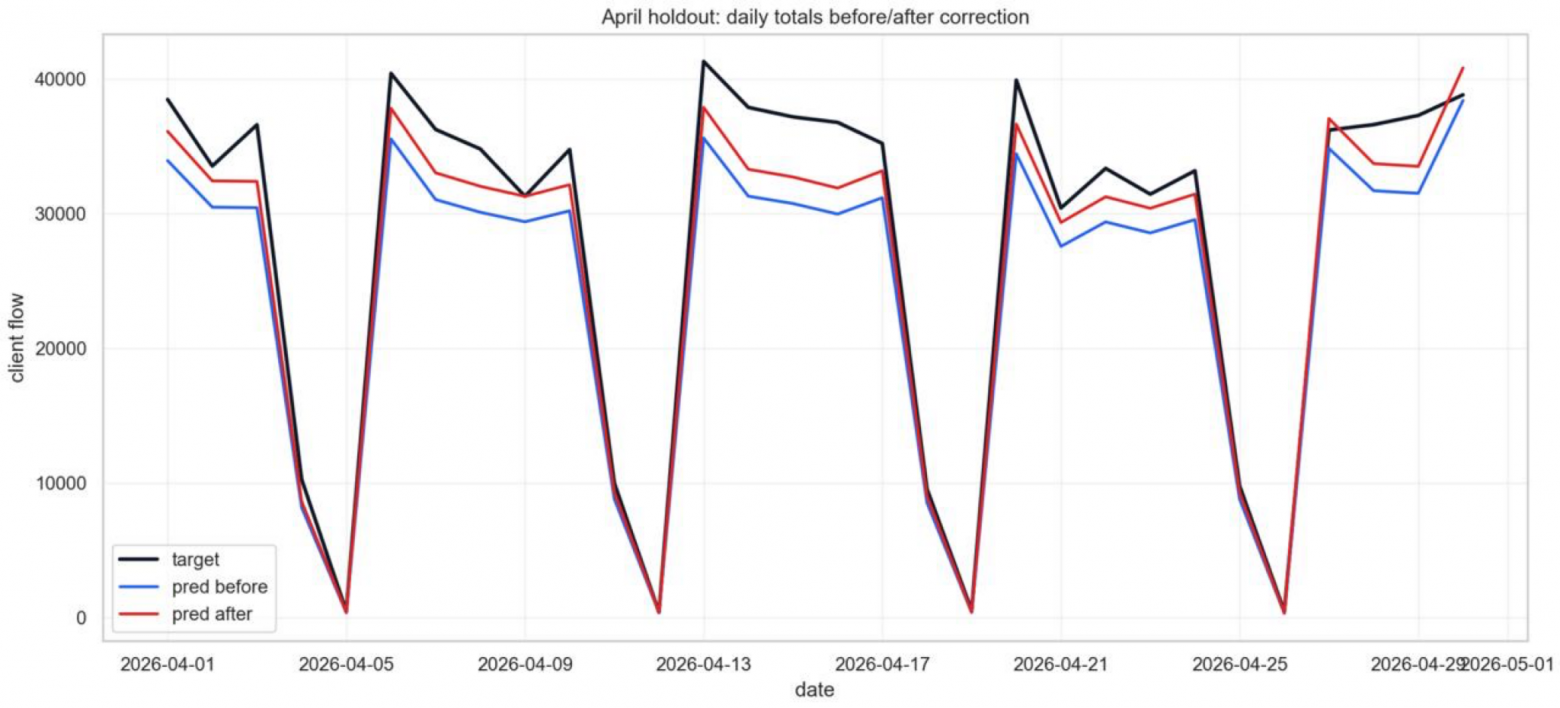
Также мы обнаружили, что дело имеем со смещением модели, дело скорее всего в том, что функция ошибки RMSE гладкая дифференцируемая и это ее специфика, либо деревья в Бустинге оказались недостаточно глубокими. Решение следующее: Взяли три месяца, февраль март апрель, и на марте, феврале смотрим недопредсказания, а на апреле проверяем, насколько поправки стали лучше. Берём поправку не одну общую добавку на всё, а будем делать отдельную добавку для каждой пары: департамент × час. Для каждой такой пары на первых двух месяцах считаем, насколько модель систематически занижала или завышала прогноз:
локальный фактор = sum(факт) / sum(предсказаний)
И дальше прогнозы для этой пары умножаются:
предсказания после калибровки = предсказания * локальный фактор
Технически чуть хитрее:
финальный фактор = exp(вес log(локальный фактор) + (1 - вес) log(глобальный фактор))
То есть если по конкретному department × hour много наблюдений, мы больше доверяем его собственной поправке. Если наблюдений мало или пара новая, больше доверяем общей поправке. По метрикам тоже соответственно получили улучшение: WAPE и MAE на 3%.
Статистические модели: что показала SARIMA
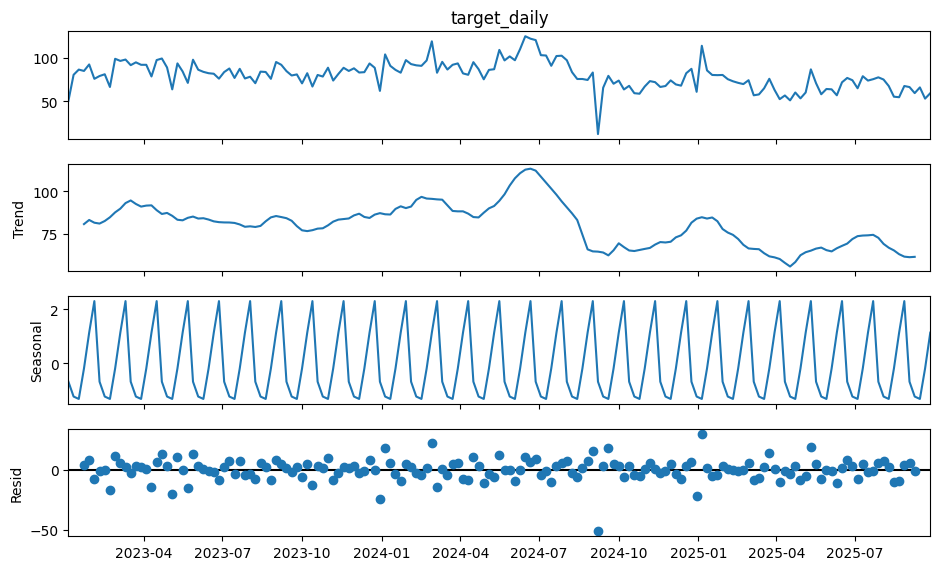
Первой гипотезой было добавить статистическую модель, способную явно выделить сезонность. SARIMA хорошо работает с регулярной сеткой и заранее выбранными периодами, но в нашей панели регулярность нарушают нерабочие дни, а профиль рабочей недели различается между отделениями. Подготовка равномерной сетки и настройка отдельных спецификаций для сотен рядов резко усложняли масштабирование.
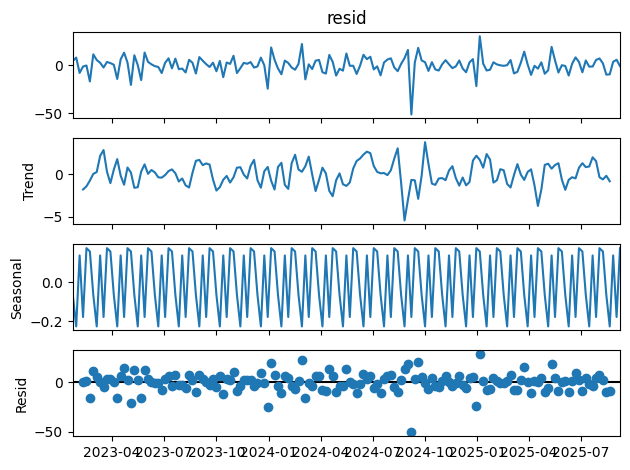
Кроме того, декомпозиция показывала, что после удаления основной недельной компоненты в остатках сохраняется структура. Это означает, что одной сезонности недостаточно: взаимодействуют как минимум недельный и более длинные календарные циклы. Выбранные SARIMA-спецификации давали слишком сглаженные прогнозы и пропускали резкие изменения.
Prophet как декомпозиция времени
Следующим кандидатом стал Prophet — декомпозируемая модель вида
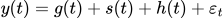
где gt отвечает за тренд, st — за сезонные компоненты, ht — за праздники и события.
Тренд задаётся кусочно-линейной (или логистической, для рядов с насыщением) функцией с автоматически подбираемыми точками излома:
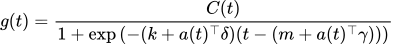
где Ct — несущая ёмкость, k — базовая скорость роста, — поправки в changepoints с разреживающим prior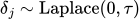 .
Сезонность задаётся рядами Фурье с периодом P:
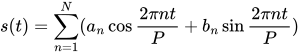
Поэтому в одной модели можно одновременно представить недельные и более длинные циклы — каждая сезонность со своим P и числом гармоник N. Праздники входят как h(t)=Z(t)k, где Z(t) — индикаторы дат с окнами до и после события. Все параметры оцениваются совместно методом MAP через Stan, регулярная сетка наблюдений не требуется.
Для нашей задачи Prophet оказался ценен не только как самостоятельный прогнозировщик. Он возвращает интерпретируемые компоненты — тренд, недельную и годовую сезонность, праздничный эффект и итоговый прогноз. Эти ряды можно использовать как признаки другой модели, передавая ей компактное описание временной структуры.
В дневных экспериментах базовый Prophet показал Valid WAPE 0,245 и MAE 10,66. После настройки Optuna результат улучшился до WAPE 0,170 и MAE 7,85. Передача Prophet-признаков в CatBoost дала близкое качество: WAPE 0,173 и MAE 7,96. Ансамбль нескольких частот оказался слабее — WAPE 0,193 и MAE 8,41. Однако на часовом уровне требовалась архитектура, способная одновременно обработать более 250 признаков и множество связанных рядов.
Temporal Fusion Transformer
Temporal Fusion Transformer, или TFT, специально разработан для многогоризонтного прогноза с разнородными входами. Признаки разделяются на три группы:
-
статические — характеристики отделения, которые не меняются во времени;
-
известные в будущем — календарь, праздники, расписание и компоненты Prophet на горизонте прогноза;
-
наблюдаемые — исторический клиентопоток, доступный только до момента прогнозирования.
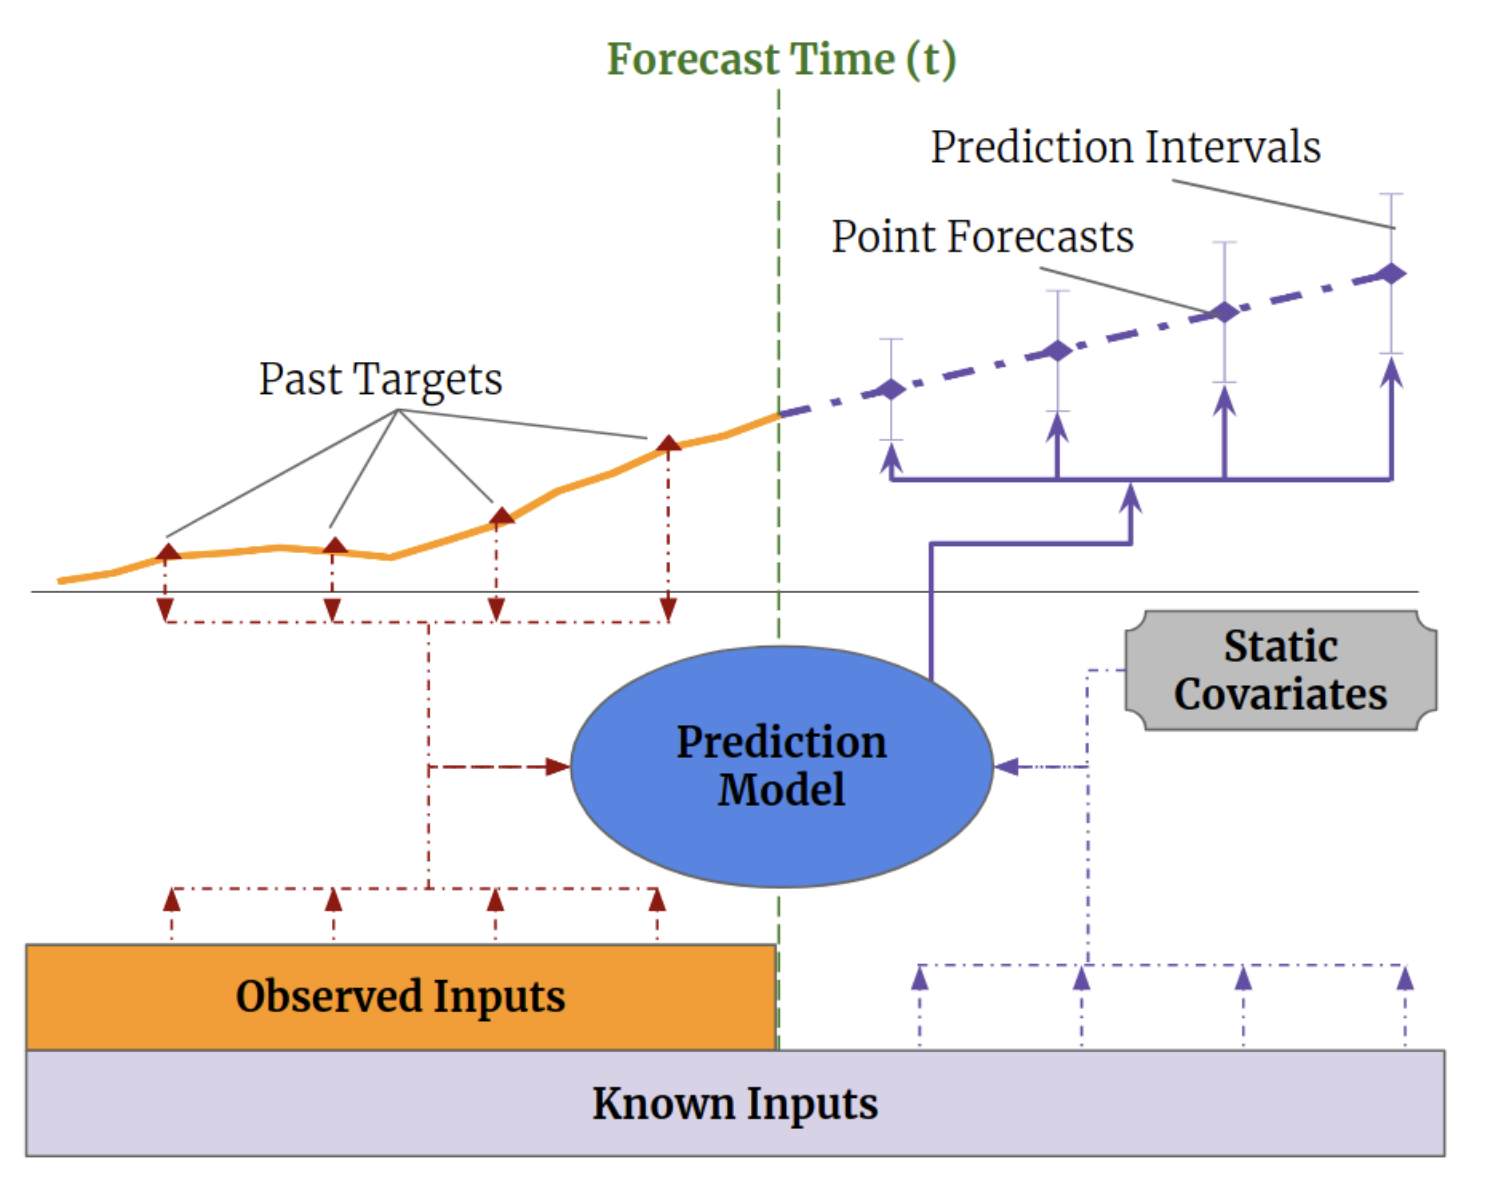
Это разделение практически дословно повторяет нашу постановку: прогноз строится на истории клиентопотока, доступной только до момента t, при этом календарь и праздники известны на весь горизонт вперёд, а характеристики отделения статичны. Модель не приходится подгонять под задачу — она изначально спроектирована под такой набор входов.
Variable Selection Network обучается выбирать полезные признаки для каждого временного шага. LSTM-кодировщик и декодировщик моделируют локальную последовательность, а механизм attention связывает удалённые моменты времени. Выход модели формируется по квантилям; для точечного прогноза использовалась медиана, что соответствует L1-ошибке и хорошо согласуется с MAE.
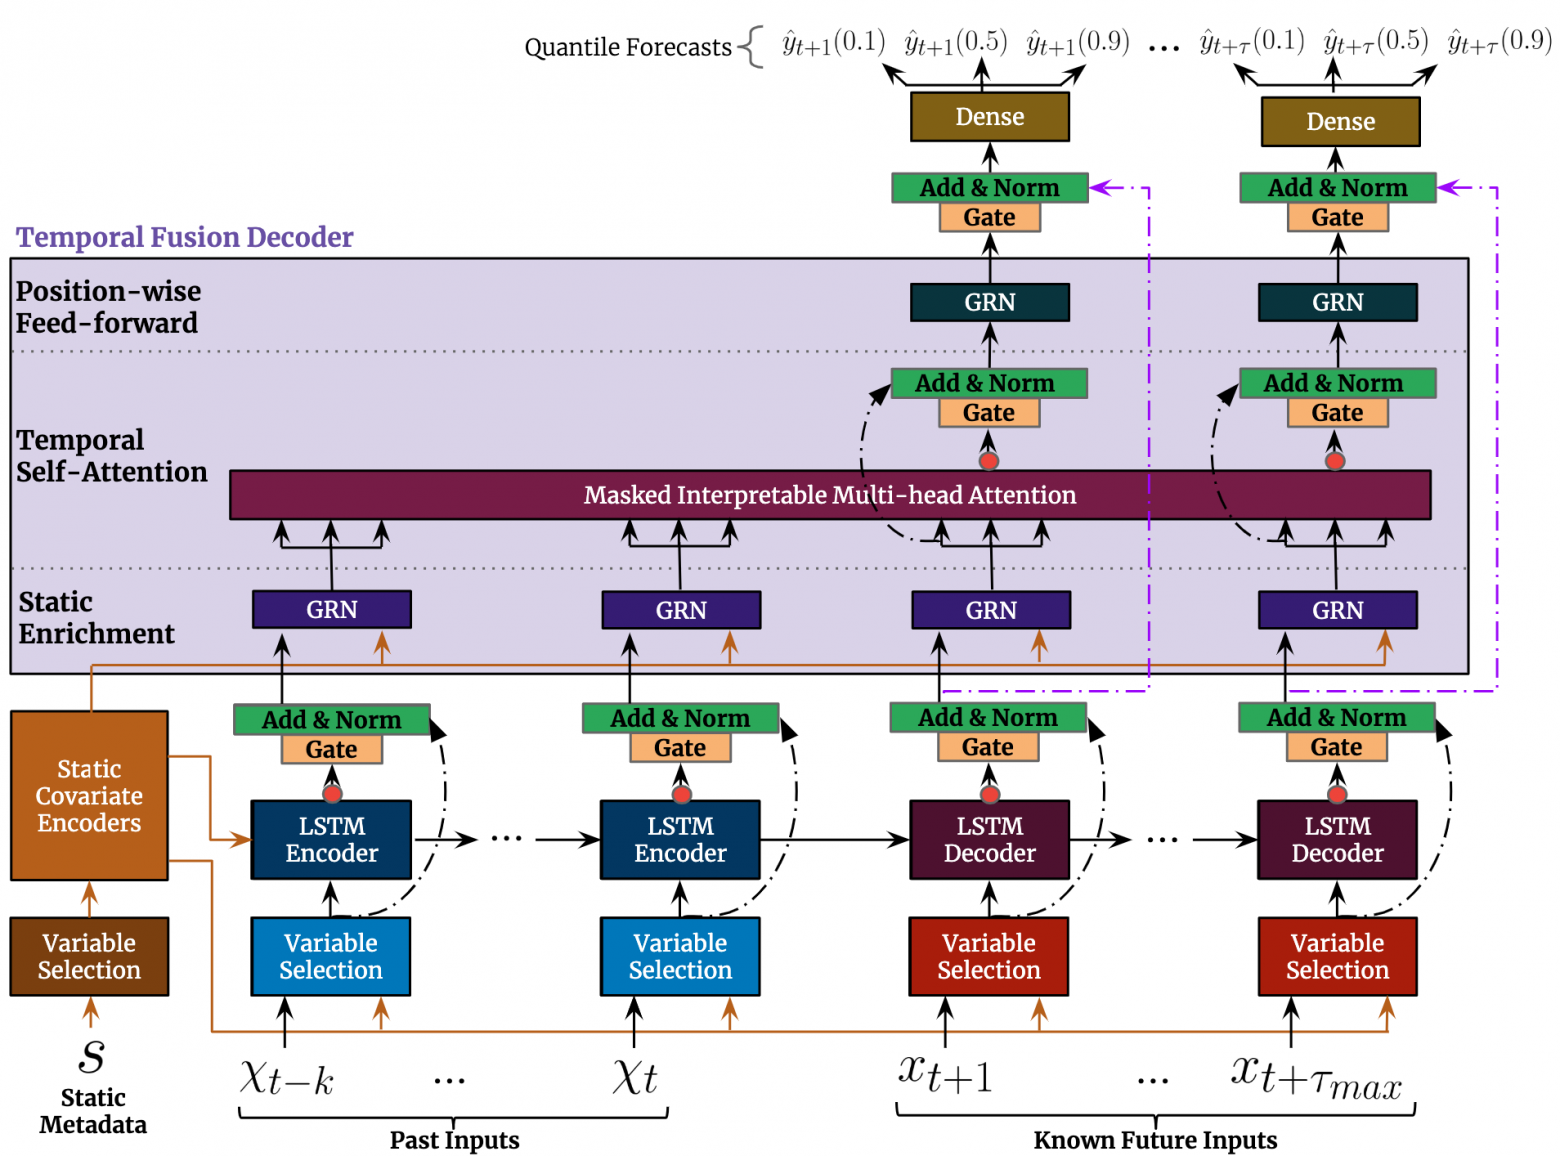
Дальше — несколько деталей нашей реализации.
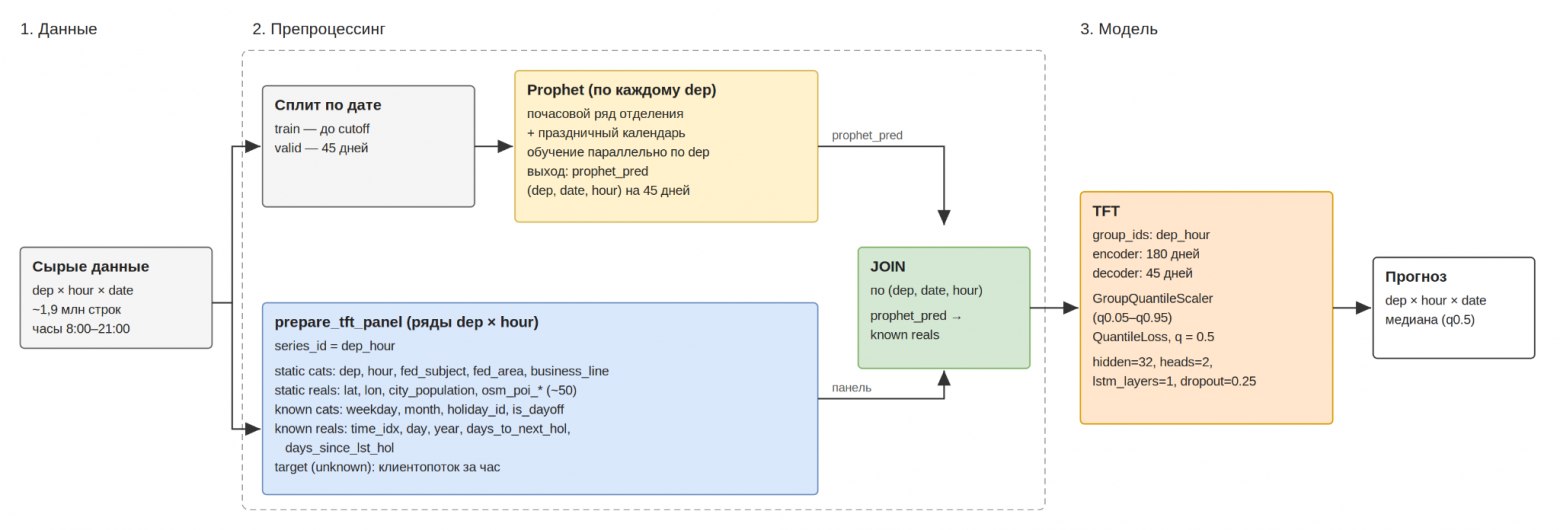
Ряды и ось времени. Каждый ряд — пара «отделение × час». time_idx считаем по рабочим дням, нерабочие в ось не входят, так что пустых шагов в рядах нет. Энкодер видит до 180 шагов истории, то есть 180 рабочих дней. Минимальную длину поставили 90, чтобы отделения с короткой историей тоже попадали в обучение. Отрицательные прогнозы на выходе обрезаем до нуля.
Нормализация. Стандартный GroupNormalizer нормирует по среднему и стандартному отклонению, и одного аномального дня хватает, чтобы растянуть шкалу всему ряду. Поэтому написали свой нормализатор на квантилях: сдвиг — 5-й процентиль ряда, масштаб — расстояние от него до 95-го.
class GroupQuantileScaler(GroupNormalizer):
    def __init__(self, groups=None, eps=1e-8, center=True,
                 quantiles=(0.05, 0.95), transformation=None):
        super().__init__(
            method="standard",  # не используется
            groups=groups,
            center=center,
            transformation=transformation,
        )
        self.quantiles = quantiles
        self.eps = eps

    def fit(self, y, X):
        y = self.preprocess(y)  # Применяем transformation (log, log1p и т.д.)
        df = X[self._groups].assign(y=y)
        q_low, q_high = self.quantiles

        agg = df.groupby(self._groups)["y"].quantile([q_low, q_high]).unstack()
        agg.columns = ["q_low", "q_high"]
        agg["scale"] = (agg["q_high"] - agg["q_low"]).clip(lower=self.eps)

        self.norm_ = agg[["q_low", "scale"]].rename(columns={"q_low": "center"})
        self.missing_ = self.norm_.median().to_dict()
        return self
Кроме fit, в классе переопределены get_norm и обратное преобразование. Там ничего хитрого: (y − center) / scale туда и обратно.
Лосс. QuantileLoss с одним квантилем 0,5, по сути L1. Он согласуется с MAE, а выбросы влияют на него слабее, чем на MSE.
Обучение. Оптимизатор AdamW с weight decay 0,01. Первые 2% шагов learning rate линейно растёт от 3e-4 до 3e-3, дальше по косинусу спадает до 1e-4. Для этого переопределили configure_optimizers, шедулер обновляется на каждом шаге.
Модель небольшая: hidden_size 32, две головы attention, один слой LSTM, dropout 0,25. Batch 64, gradient clipping 0,1, bf16-mixed, до 5 эпох с early stopping по val_loss (patience 2). После каждой эпохи дополнительно смотрели дневные метрики, суммируя почасовой прогноз по отделению и дню: за переобучением по ним следить удобнее, чем по одному лоссу.
Ключевой инсайт: два взгляда на один ряд
Главный результат появился из-за способа группировки. Для TFT отдельный временной ряд задаётся парой dep_hour. Последовательность для 13:00 выглядит как «понедельник 13:00 → вторник 13:00 → среда 13:00». Шаг равен суткам, поэтому модель хорошо видит межсуточные различия и недельную структуру, но почти не наблюдает переход от 12:00 к 13:00 внутри одного дня.
Prophet, наоборот, обучается на уровне dep и идёт по непрерывной временной оси часов: 09:00 → 10:00 → 11:00 и так далее. В дневных экспериментах из раздела 7 Prophet работал на суммарном потоке за день, но для связки с TFT мы перешли на почасовую версию, которая сразу прогнозирует каждый час. Такой Prophet хорошо описывает внутрисуточную форму, но не заменяет TFT в моделировании сложных различий между сериями.
Комбинация закрывает взаимные слепые зоны. На рисунке ниже это видно как пересечение: TFT движется по столбцу (фиксированный час, шаг — сутки), Prophet — по строке (все часы отделения подряд). В ячейке пересечения модель получает оба сигнала сразу.
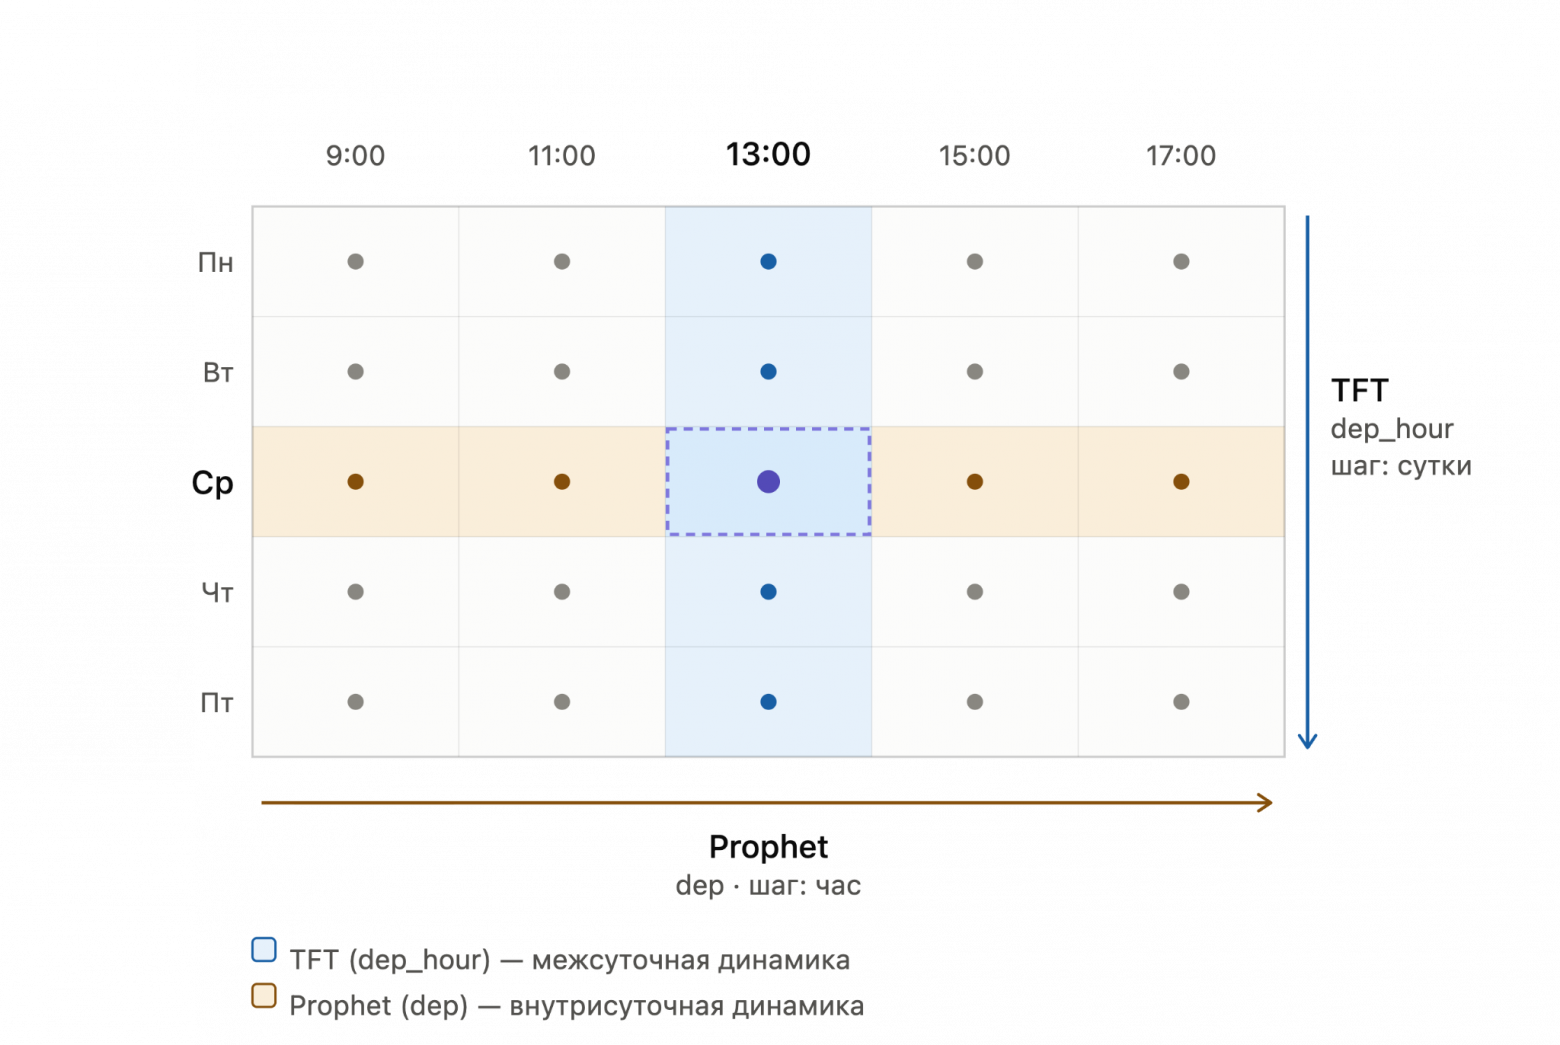
Прогноз Prophet рассчитывается на весь горизонт без доступа к будущему таргету и передаётся TFT как известный вещественный признак (time_varying_known_reals). Prophet сообщает модели, где мы находимся во внутридневном и календарном цикле, а TFT связывает этот контекст с историей конкретной пары «отделение — час».
Финальный пайплайн
-
Для каждого отделения Prophet обучается на доступной истории с учётом праздничного календаря; гиперпараметры подбираются по отложенному периоду.
-
Прогноз и сезонные компоненты Prophet присоединяются к панели по отделению и времени.
-
Для TFT формируются серии
dep_hour, статические признаки, известные будущие признаки и наблюдаемая история. -
TFT использует до 180 дней контекста и строит прогноз на 45 дней.
-
Медианный квантиль преобразуется в почасовой прогноз, который затем может поступать в оптимизатор расписания.
Дополнительно применены три инженерных улучшения. GroupQuantileScaler нормирует каждую серию по 5-му и 95-му процентилям и поэтому меньше реагирует на редкие выбросы. QuantileLoss для q = 0,5 задаёт устойчивую L1-цель. Увеличение batch size в экспериментах стабилизировало градиент на разномасштабных рядах.
Результаты
Сравнение на едином VALID HOURLY MICRO срезе:
-
CatBoost baseline: MAE 1,951; RMSE 2,809; WAPE 0,321; SMAPE 0,376; MAPE 44,3%.
-
Базовый TFT: MAE 1,930; RMSE 2,764; WAPE 0,318; SMAPE 0,372; MAPE 45,7%.
-
TFT с Prophet-признаками: MAE 1,491; RMSE 2,214; WAPE 0,306; SMAPE 0,348; MAPE 43,3%.
-
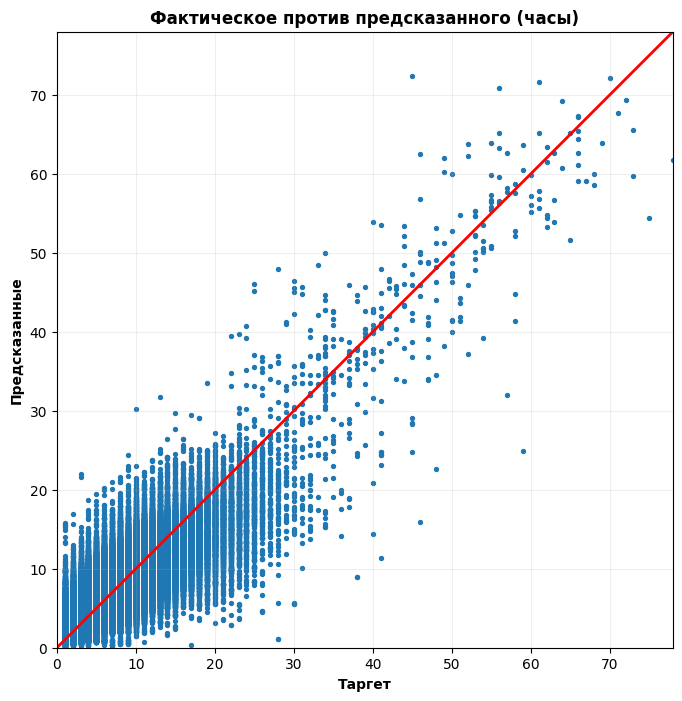
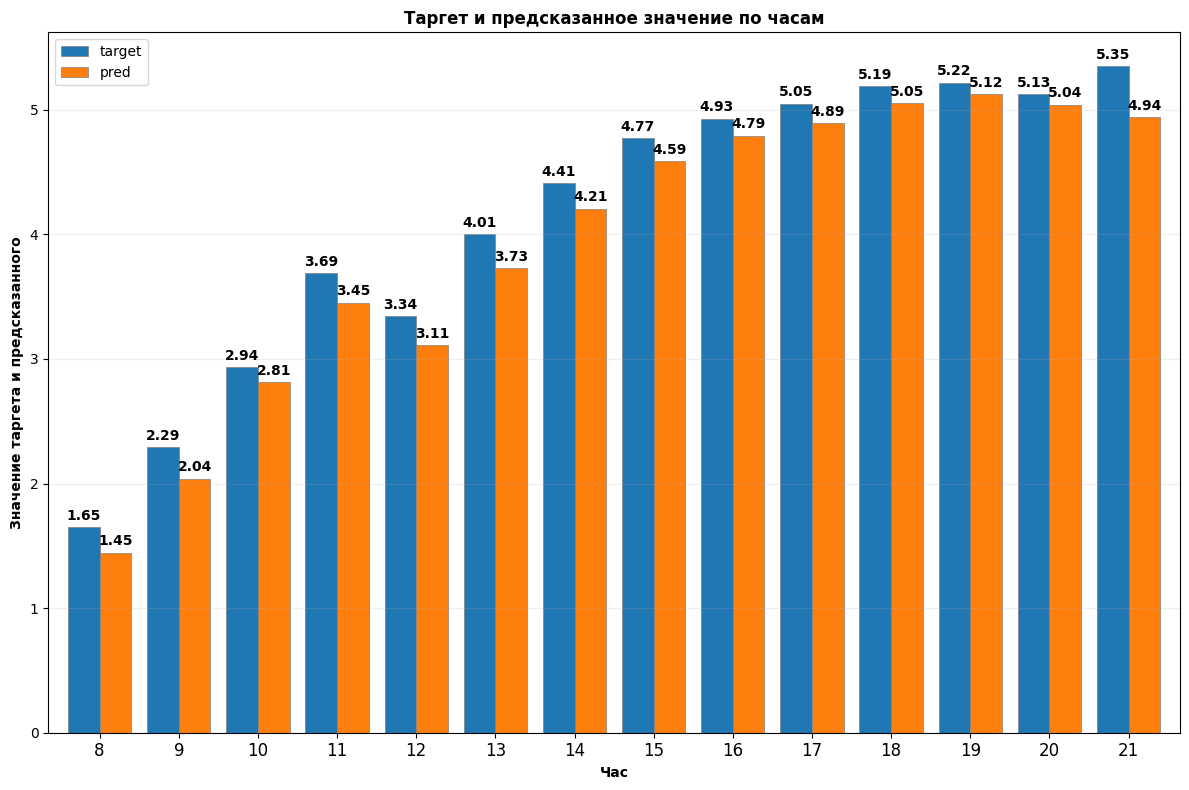
TFT + Prophet + GroupQuantileScaler + L1: MAE 1,478; RMSE 2,260; WAPE 0,303; SMAPE 0,342; MAPE 40,0%.
По сравнению с CatBoost финальная модель уменьшила MAE примерно на 24,2%. WAPE снизился на 1,8 процентного пункта, что соответствует относительному улучшению около 5,6%. MAPE уменьшился на 4,3 процентного пункта. Небольшое ухудшение RMSE относительно варианта TFT + Prophet показывает компромисс: устойчивые настройки улучшили типичную абсолютную ошибку, но не все редкие крупные промахи.
Что не дало устойчивого прироста
-
Погодные признаки в основном добавляли шум. Небольшой локальный выигрыш наблюдался только на коротком горизонте около недели и не переносился на основной горизонт.
-
Ансамбли CatBoost и TFT не улучшили качество: модели систематически ошибались на похожих отделениях, поэтому их ошибки были слишком коррелированы.
-
Лаги таргета полезны на коротком горизонте, но для 45 дней требуют рекурсивно подставлять собственные прогнозы, из-за чего ошибка быстро накапливается.
От прогноза к числу сотрудников
Прогноз клиентопотока — не финальный ответ, а вход оптимизационной задачи. Для каждого интервала прогноз переводится в требуемую трудоёмкость через среднее время обслуживания, производительность, структуру операций и целевой уровень сервиса. Затем оптимизатор выбирает число сотрудников и назначение на рабочие места.
В целевой функции можно одновременно штрафовать дефицит, простой, сверхурочные и нестабильность расписания. Ограничения описывают допустимую длину смены, перерывы, навыки, минимальное покрытие, доступность сотрудников и правила трудового законодательства. На выходе получается не абстрактный прогноз, а план вида «отделение — дата — час — рабочее место — необходимое число сотрудников».
Для надёжности оптимизатору стоит передавать не только точечное значение. Квантильный прогноз позволяет строить несколько сценариев: медианный для обычного планирования и более высокий квантиль для интервалов, где недоукомплектованность особенно дорога. Это связывает неопределённость модели с явным уровнем бизнес-риска.
Ограничения и следующие шаги
-
Провести end-to-end пилот: сравнить не только ошибки прогноза, но и стоимость расписания, SLA, очереди и сверхурочные.
-
Зафиксировать единый протокол валидации для всех моделей и отдельно публиковать micro- и macro-срезы.
-
Добавить мониторинг дрейфа данных, доли пропусков, смещения прогноза и качества по отделениям, месяцам и часам.
-
Проверять устойчивость к закрытиям, переездам, изменению режима работы и другим структурным событиям.
-
Калибровать квантильные прогнозы и стоимость ошибок вместе с владельцами процесса планирования.
-
Оценить стоимость обучения и инференса TFT относительно дополнительного бизнес-эффекта: лучший offline-score должен окупать более сложную эксплуатацию.
Выводы
Двухэтапный CatBoost дал сильный, прозрачный и воспроизводимый бейзлайн: дневная модель оценивает общий масштаб, почасовая — форму рабочего дня, а временная OOF-схема не позволяет дневному прогнозу протечь в обучение второго этапа.
Дальнейший прирост обеспечила не просто замена алгоритма. Ключевым стало соединение двух представлений времени: Prophet видит непрерывную внутрисуточную ось отделения, TFT — межсуточную динамику фиксированного часа. Их комбинация вместе с устойчивой нормализацией и L1-целью снизила часовую MAE примерно на четверть.
Главный практический результат — качественный и заранее доступный сигнал спроса для оптимизатора. Именно связка «прогноз клиентопотока + оптимизация штата + измерение бизнес-метрик» способна экономить время и деньги, снижать перегрузку сотрудников и одновременно поддерживать стабильный сервис для клиентов.
Источники
Автор: romangataullin
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36253
URLs in this post:
[1] обучения: http://www.braintools.ru/article/5125
[2] ошибку: http://www.braintools.ru/article/4192
[3] Taylor S. J., Letham B. Forecasting at Scale (2017).: https://doi.org/10.7287/peerj.preprints.3190v2
[4] Lim B. et al. Temporal Fusion Transformers for Interpretable Multi-horizon Time Series Forecasting (2021).: https://arxiv.org/abs/1912.09363
[5] PyTorch Forecasting: документация TemporalFusionTransformer.: https://pytorch-forecasting.readthedocs.io/
[6] Источник: https://habr.com/ru/companies/alfa/articles/1085676/?utm_campaign=1085676&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.