664 тысячи книг, десятки агентов — и ни одной метрике нельзя верить
Мне нужны собственные каноники книг. Каноник — это одна устойчивая запись «вот этот текст», к которой привязывается всё остальное: файлы в разных форматах, аудиокниги, издания, дубли.
Не потому, что внешние источники плохие. Если мне нужно быстро получить автора, название или идентификатор книги, я вполне могу взять их из существующего каталога. Даже если в каталоге есть мусор, это не катастрофа: мусор можно постепенно исправлять. Проблема в другом — это не мой каталог. Я могу годами накапливать вокруг внешнего идентификатора результаты собственных анализаторов: связывать с ним аудиокниги, находить дубли, определять издания, собирать статистику, строить рекомендации. А потом внешний источник поменяет идентификаторы, структуру или просто исчезнет, и вся накопленная работа повиснет в воздухе.
Поэтому я решил сделать собственный корпус книг. Он тоже будет грязным, и это нормально. Главное, что это мой грязный корпус: я могу его постепенно улучшать, и его идентификаторы контролирую я сам.
В корпусе сейчас около 664 тысяч книг. А задача, ради которой всё это понадобилось, на первый взгляд была совсем простой: взять несколько минут аудиокниги, прогнать через Whisper и найти соответствующую книгу по тексту.
Ну что может быть сложного? Оказалось — примерно всё.
Сначала был обычный поиск по тексту
Идея стандартная: разбить текст на шинглы (несколько слов подряд), построить индекс и искать похожие последовательности. Я начал с MinHash по шинглам.
Быстро выяснилось, что наивный вариант ломается на вполне реальном случае: одна книга целиком лежит внутри другой. Есть небольшой роман и огромное собрание сочинений, в которое он входит. У романа десятки тысяч шинглов, у собрания — миллионы. MinHash оценивает сходство Жаккара: размер пересечения, делённый на размер объединения. А мне нужна вложенность — лежит ли маленькая книга целиком внутри большой. У романа внутри собрания вложенность равна единице, а Жаккар примерно равен отношению их размеров, то есть порядка сотых. В итоге две книги, одна из которых буквально содержит другую, по отпечатку почти не пересекаются.
Я начал экспериментировать с вариантами MinHash и Winnowing, и здесь случилась первая полезная ошибка [1]: я менял несколько параметров одновременно и в какой-то момент решил, что MinHash не подходит вовсе. Позже выяснилось, что я просто не понимал, какой именно параметр испортил результат.
Поэтому я вернулся к MinHash и взял у Winnowing главную идею — локальные минимумы. Отпечаток считается не по всей книге, а по блокам в 300 шинглов, у каждого блока свои минимумы. Блоки романа внутри собрания сильно перекрываются с блоками самого романа, и заметная часть минимумов у них совпадает — размер собрания больше ни на что не влияет. Вторая половина — проверка цепочкой (chaining): кандидат засчитывается, только если в нём нашёлся связный кусок запроса, около десятка слов подряд, а не россыпь случайно совпавших шинглов. Так появился нынешний вариант: блочный MinHash плюс проверка цепочкой.
Он работает достаточно хорошо, чтобы строить на нём остальную систему. Но я не знаю, что он лучший: у меня до сих пор нет датасета, на котором можно честно сравнить варианты. Об этом вся остальная статья.
Найти книгу — ещё не значит понять, что поиск работает
После появления работающего индекса возник естественный вопрос: насколько хорошо он работает? Для нормальной оценки нужен датасет, где заранее известен правильный ответ: этот запрос соответствует книге A, этот — книге B, этот должен вернуть несколько дублей, а для этого правильного ответа в корпусе нет вообще.
У меня такого датасета не было. Маленький корпус бесполезен: на нём не видно, как система ведёт себя в большом поисковом пространстве (ниже будет пример, насколько не видно). Большой корпус вручную не разметить. Поэтому я пошёл по пути, который сейчас кажется одновременно очевидным и довольно безумным: строить датасет из уже имеющихся данных и проверять его LLM-агентами. У меня это параллельные сессии семейства агентов, каждая на своей машине.
Дальше почти каждый новый источник «истины» проходил один и тот же цикл. Сначала: «вот это, кажется, можно использовать для разметки». Потом проверка. Потом: «нет, и это тоже мусор».
Автор и название
Самая очевидная идея — считать две книги дублями, если у них совпадают автор и название. Получилось 17 839 пар. Проверил по текстам: 32.6% этих пар дублями не являются. Одинаковые автор и название ничего не гарантируют: в корпусе есть разные книги под одним названием, разные переводы, издания, сборники и просто ошибки в метаданных.
«Независимая» выборка
Та же история повторилась на аудиокнигах — берём текст аудиокниги и пытаемся найти книгу по нему. Нашли две? Значит дубль. Но и набор пар «аудиокнига — книга» также был кривым, и я собрал новый, «непредвзятый», другим способом — 767 пар. Позже выяснилось, что 682 из них, то есть 88.9%, буквально совпадают со старым набором: оба способа в итоге читали одну и ту же таблицу. Я построил не независимый датасет, я дважды посмотрел на одни и те же данные. И уровень шума, замеренный на «новой» выборке, нёс то же смещение, что и на старой.
Метаданные и поле уверенности
В книгах и аудиофайлах есть названия и авторы, в базе есть внешняя разметка, у других анализаторов есть собственные результаты. Можно использовать всё это — и каждый раз происходит примерно одно и то же: название файла может быть неправильным, метаданные могут быть неправильными, внешняя разметка может быть неправильной, а результаты соседнего анализатора построены на тех же ошибочных данных.
Даже поле, которое выглядит как оценка уверенности, может означать совсем другое. В одном эксперименте я ожидал, что на более надёжных связях (автор-название в метаданных аудиокниги полностью совпадают с автором-названием найденной книги) полнота будет выше. Получилось наоборот: на классе ambiguous (название из метаданных не совпадает с книгой) она была выше на 13.7 процентного пункта, доверительные интервалы не пересекались. Стал искать причину. Оказалось, что поле кодировало не уверенность, а буквальное совпадение названия, и именно при точном совпадении названия проверка неоднозначности отключалась. Класс, который выглядел самым надёжным, оказался самым опасным: примерно четверть его связей вела на книгу другого автора с тем же названием.
С этого момента я отношусь к названиям датасетов с недоверием. Датасет означает то, чем он построен, а не то, как назван. Если не знаешь, как он построен, его название не значит почти ничего.
Правильный ответ не всегда один
Ещё одна вещь, которую я изначально вообще не учитывал. Допустим, я ищу книгу и нахожу три файла: EPUB, FB2 и тот же текст в другом издании. Для дедупликации это три правильных результата, а не один правильный и два ошибочных. А ещё огромный сборник может содержать искомую книгу целиком, и это тоже законный ответ.
Схема «запрос → единственный правильный ID» для моей задачи не подходит: искать нужно не один ответ, а множество связанных текстов. Это ещё одна причина, по которой обычный golden dataset оказалось построить гораздо сложнее, чем казалось.
Тем временем поиск надо было как-то принимать
До проверки цепочкой на полном корпусе голый порог по скору давал от 13 до 29% ложных срабатываний — на случайных запросах, которым в корпусе ничего не соответствует, в зависимости от порога. Проверять такое вручную невозможно, даже если посадить на это агентов. После цепочки ложные упали до долей процента; откуда взялось точное число — отдельная история, она ниже.
Полноценной оценкой качества я это назвать не могу: нормального размеченного набора по-прежнему нет. Но система стала пригодной для дальнейшей работы, и эти две вещи я стараюсь не путать. «Выглядит лучше» — не то же самое, что «доказано, что стало лучше».
Тогда я начал строить метрики
И обнаружил, что численным результатам тоже нельзя доверять.
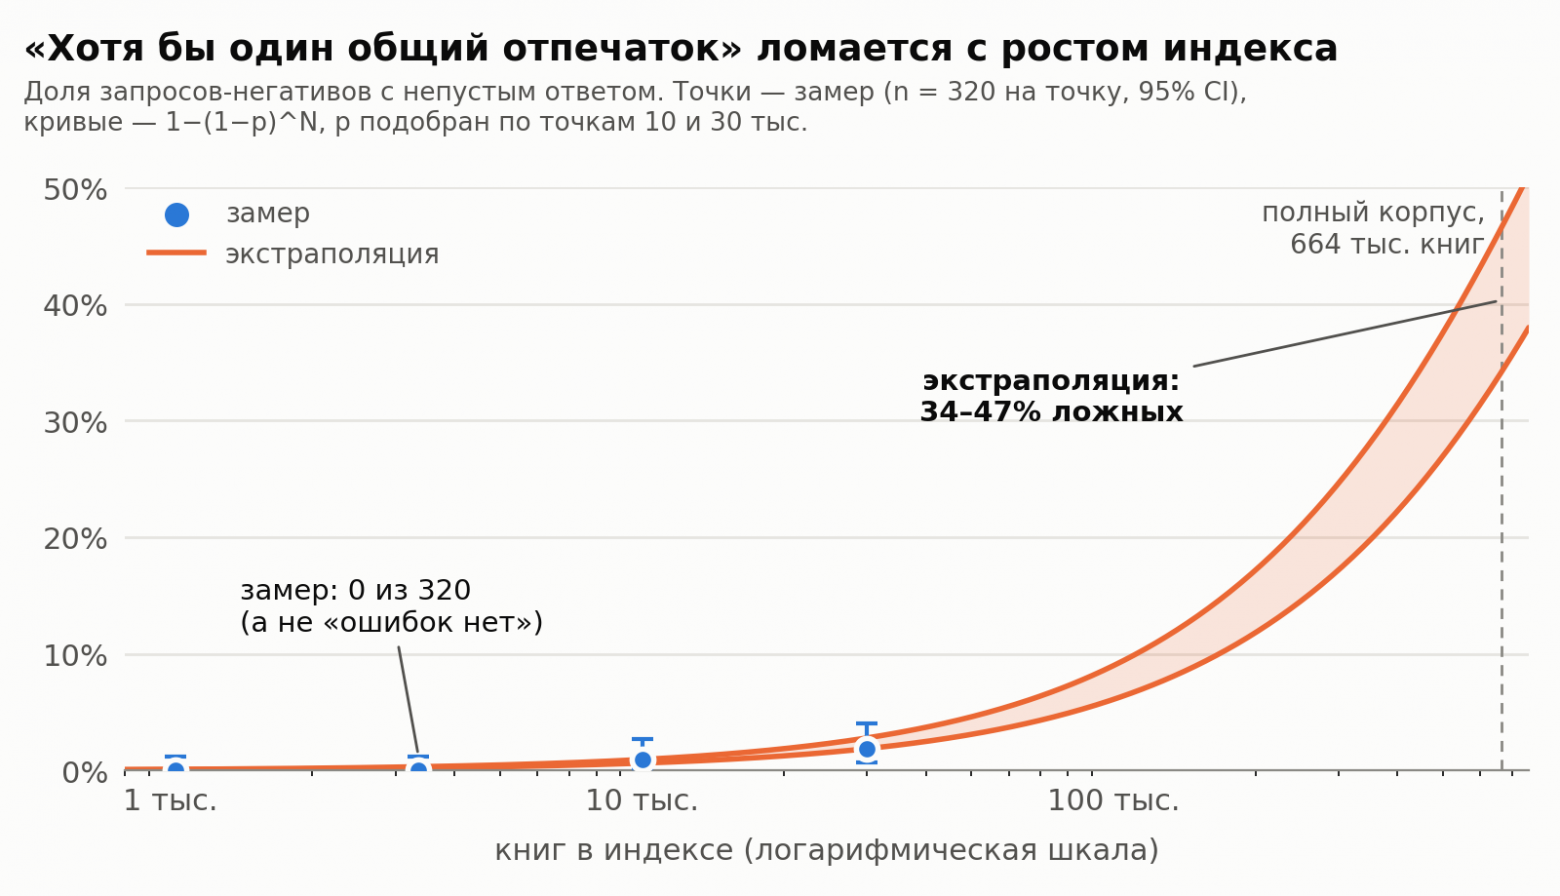
Первая метрика была бинарной: запрос «нашёл» книгу, если у них совпал хотя бы один отпечаток; ложное срабатывание — непустой список кандидатов у запроса, которому ничего не соответствует. Пилот отчитался: ложных — ноль. Проблема в том, что эта метрика не могла показать плохой результат. Общие последовательности слов есть у любых двух книг, и вероятность «хотя бы одного совпадения» растёт с размером корпуса. Поймалось это на дешёвой проверке — кривой ложных срабатываний по размеру индекса:
|
книг в индексе |
ложных срабатываний |
|
1 025 |
0 из 320 (0%) |
|
3 359 |
0 из 320 (0%) |
|
10 025 |
3 из 320 (0.94%) |
|
30 025 |
6 из 320 (1.88%) |
Кривая легла на 1−(1−p)^N, где N — число книг в индексе, а p — почти постоянная вероятность случайного совпадения запроса с одной книгой. Экстраполяция на полный корпус — 34–47% ложных там, где пилот честно видел ноль. Пилот не врал: корпус в двести раз меньше боевого просто не давал проблеме проявиться.
Второй пример. Я сравнивал методы на их собственных рабочих порогах: один вариант работал при одном пороге, другой при другом; я смотрел на получившийся уровень ложных срабатываний и делал выводы о форме кривых. Получилось, что у MinHash кривая ложных принципиально более пологая, чем у соседнего варианта. Потом я пересчитал сравнение при одинаковой полноте, и разница исчезла: я сравнивал две точки на разных кривых. Это был результат выбора порогов, а не сравнения алгоритмов. С тех пор варианты сравниваются только при равной полноте — 0.95, 0.98, 0.99. И несколько вариантов, которые до этого казались бесперспективными, внезапно оказались вполне живыми.
Потом появился красивый ноль
Дважды. Первый раз — мягкий: «ноль ложных на 320 запросах». По правилу трёх это означает всего лишь «меньше 0.94%»: ошибка достаточно мала, чтобы не попасться на такой выборке, и не более того. Но отчёт читался как «ошибок нет».
Второй раз — жёстче. Финальный прогон на полном корпусе: 0 ложных срабатываний на 4060 запросах. Звучит отлично, и выборка уже приличная. Но у нуля надо проверить ещё одно: что все объекты вообще дошли до проверки. Кандидатов после поиска проверяла отдельная часть системы — та самая цепочка. Индекс был построен по полному корпусу в PostgreSQL, а проверка по ошибке ходила за текстами в локальные SQLite-базы с короткой выборкой. Для 85.3% кандидатов (не запросов: у одного запроса их бывает несколько) текста там не было, и проверка фактически не выполнялась. При этом «проверка не выполнялась» выглядело в результатах точно так же, как «кандидат не прошёл проверку».
Поэтому «0 ложных на 4060 запросах» на самом деле означало: до проверки реально дошли 232 запроса, остальные 3828 не рассматривались вовсе. Хитрой причины тут нет: агент взял не ту базу, а я не проверил. После исправления цепочка считалась для всех кандидатов, и результат стал таким: 3 ложных срабатывания на 4060 запросов, 0.074% (95%-й интервал 0.025–0.22%). На специально подобранных похожих книгах — тот же автор или то же название — ложных больше, 0.25–0.35%. Про эти числа я хотя бы понимаю, что происходило внутри.
С тех пор у красивого нуля я спрашиваю две вещи: сколько было испытаний и сколько объектов реально дошло до проверки.
А потом я начал подозревать сами эксперименты
Агент пишет код за минуты, человек на тот же код потратит часы или дни. Агенты работают круглосуточно и параллельно гоняют десятки вариантов на разных машинах. Мне этот подход до сих пор кажется правильным: человек должен думать и анализировать, машина — писать и гонять эксперименты. Но у него есть неприятная цена. Большие прогоны идут долго, вариантов много, меняются версии индекса, датасета, параметров и способа проверки — и в какой-то момент получаешь очень убедительный эксперимент, который измеряет вообще не то.
Однажды латентность запроса на индексе в сто тысяч книг выросла в 137 раз. Мне предложили правдоподобное объяснение — дело в числе шардов, — я его принял и поставил на нём задачу. Опровержение лежало в той же таблице: объём данных, читаемых на запрос, почти не изменился. Настоящая причина была скучнее: индекс перестал помещаться в файловый кэш.
Шарды всплыли ещё раз, в другой истории. Поиск большой книги целиком действительно ходил по всем шардам — но не потому, что шардирование плохое. У большой книги просто столько отпечатков, что она поднимала их все. А искать огромную книгу целиком вообще не обязательно: достаточно нескольких её кусков.
В третьем эксперименте я был уверен, что голосование по десяти отрывкам одной аудиокниги вытянет качество: расчёт молча предполагал, что отрывки — независимые испытания. Замер показал другое: 139 аудиокниг из 709, то есть 19.6%, проваливают все десять отрывков разом, причём одинаково у двух разных конфигураций отпечатка. Отрывки одной книги не независимы: если книга не находится, она не находится вся.
Что в итоге я вообще умею измерять
Здесь начинается самое неприятное.
Корпус против корпуса. Если взять кусок книги, которая точно есть в корпусе, то на 19 428 запросах в 99.17% случаев первой в выдаче стоит книга, которая действительно содержит искомый текст. Но «та самая запись» — только в 58.66%. Ещё в 40.51% первым стоит другой контейнер того же текста: собрание сочинений, антология, другое издание. По-настоящему ложных попаданий, когда текста в книге нет, — 0.37%, ещё в 0.46% выдача пустая. Это прямая иллюстрация к разделу про «правильный ответ не один»: считай я верным только совпадение ID, получил бы «точность 59%» у системы, которая ошибается реже чем в полупроценте случаев.
Аудио против корпуса. Если дать системе фрагмент аудиокниги, распознанный Whisper, картина другая. На 709 аудиокнигах, которым приписана книга из корпуса, хотя бы один из десяти отрывков находит её в 80.4% случаев. И я не называю это recall. Приписка «эта аудиокнига — вот эта книга» сама построена эвристикой по метаданным, той самой, с полем уверенности из начала статьи. Разметки вида «этот аудиофрагмент точно является книгой A, и книга A точно есть в корпусе под таким-то ID» у меня нет.
Оставшаяся пятая часть — те самые 19.6% — пока просто лежит. Разбор провалов показал, что текст таких аудиокниг часто вообще не пересекается с приписанной книгой: начитка по другому изданию, сокращённая версия, другой перевод. Возможно, нужного текста в корпусе нет. Возможно, приписка неверна. Возможно, там есть и ошибки алгоритма. В каких долях — я пока не знаю.
И оговорка в духе всей статьи. После этих замеров я переписал сервис и сменил нормализацию текста. Под новую версию все числа из этого раздела ещё предстоит перемерить; пока это числа прошлой версии.
Что я получил за эти две недели
Не новый алгоритм поиска и не доказанную метрику качества. Я получил работающий прототип. Он умеет искать книгу по книге, книгу по распознанному фрагменту аудиокниги и находить более крупные и более мелкие текстовые сущности — когда одна книга является частью другой. Для текущей задачи этого достаточно, чтобы продолжать разработку.
Но я до сих пор не могу честно сказать: «у моего алгоритма такой-то recall и такой-то precision». Для этого сначала нужно решить отдельную задачу — построить данные, которым можно доверять. И она оказалась почти такой же интересной, как сам поиск.
Самое неприятное, что проблема не в алгоритме. Я могу написать ещё десять вариантов индекса, запустить их на сотне машин, получить красивые графики и попросить агентов объяснить, почему вариант №17 лучше варианта №16. Без нормального способа измерения всё это остаётся словами: «вроде работает» не равно «работает».
Я хотел построить простой поиск по большому корпусу книг. В итоге строю две системы: ту, которая ищет, и ту, которая позволяет понять, насколько хорошо она ищет. Первая у меня уже есть. Вторая в разработке.
Последнее, честности ради. Руками эксперименты по большей части гонял не я, а агенты, и часть ошибок из этого текста буквально их — «взял не ту базу» из раздела про ноль. Но ответственность за всё — моя: выводы делал я. Как из таких сессий собирается работающая R&D-команда — с заказчиком, тимлидом, приёмкой и инцидентами в два часа ночи — отдельная история. Если интересно — напишу, можете подписаться, чтобы не пропустить.
Автор: gleam
Источник [2]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36280
URLs in this post:
[1] ошибка: http://www.braintools.ru/article/4192
[2] Источник: https://habr.com/ru/articles/1088532/?utm_campaign=1088532&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.