Смысловой Embedding, или как доставать смысл из слов
Всем привет. В этой статье мы рассмотрим идею, которая даст возможность нейросетям строить не только эмбеддинги токенов, но и «смысловые» эмбеддинги. Итак, план:
-
Рассмотрим основную проблему нынешних LLM-моделей.
-
Рассмотрим идею «смыслового» эмбеддинга и то, как эта идея теоретически может помочь в обучении [1] нейросетей.
-
Подведем итоги.
Ну что, приступим!
Проблема современных LLM-моделей
Современные LLM-модели являются очень сложной и огромной вероятностной машиной, которая предсказывает следующий токен на основе контекста.
Проблема заключается в том, что LLM-модели не имеют структурного мышления [2], что является большой проблемой (подробнее читайте в этой статье [3]).
Хотелось бы решить эту проблему, не полностью — а частично. Если модель просто принимает на вход токены, подстраивает веса под минимизацию ошибки [4] и после обучения ей подать токен, которого в обучении не было (такое может быть), то она с большей вероятностью начнёт галлюцинировать. Это лишь одна из проблем.
Можно сделать вывод, что просто информации о последовательности и одного Embedding-а (например, Embedding + Attention или RNN/LSTM) недостаточно, так как, как мы говорили выше, если модель получит токен, которого не было в обучающей выборке, но есть в параметрах, — она начнёт галлюцинировать с высокой вероятностью. Или, например, если подать последовательность, сильно отличающуюся от последовательностей, которые были в обучающей выборке, модель начнёт галлюцинировать с большей вероятностью.
А как теоретически можно это частично исправить — рассмотрим далее.
Идея и ее разбор
У нас есть слова. Очень много слов. Какую бы пару мы ни взяли — мы найдём общую связь, пусть даже и косвенную, между каждым словом в этой паре. Давайте разберём на примере. Нам даны слова:
-
Картошка
-
Дверь
-
Человек
-
Батарея
Кажется, просто слова, которые ничем не связаны. Но нет! Смотрите, сколько у них общего:
-
Каждый предмет из вышеперечисленных — физический объект, существующий в реальном мире, имеет изнашивание (гниение, старение и т. п.), является твёрдым телом.
-
Каждое слово — русское, имя существительное, склоняемое по падежам, и является часто используемым словом.
-
Все эти объекты легкоподвижные — картошку можно толкнуть, и она покатится, человека можно толкнуть, и он сдвинется, батарею можно так же, как и картошку, толкнуть, и она покатится, дверь можно легко открыть.
Если искать общие связи — их выйдет очень много. Что я этим хотел показать? А я хотел показать то, что даже в такой группе слов, где кажется, что связей нет, — они есть, хоть и не банальные и косвенные.
Так вот, мы разделим все N слов из словаря модели на K групп, по X слов в каждой так, чтобы на каждую группу (X токенов) приходился 1 вектор размерностью d_model, и суммированное количество слов во всех группах было равно количеству слов в словаре (N). Обязательно сделаем эти группы обучаемыми и убедимся, что слово, которое находится в одной группе, не находится в другой любой группе (ибо потом будем мучиться с вопросом, какую группу брать, если это слово в R группах, что создаст дополнительную сложность).
Ещё хочу добавить одну не менее важную вещь: так как метод смыслового эмбеддинга будет работать не с одним словом, а с группой слов, то смысл слова (научно [5] — способность модели дифференцировать только текущий токен для снижения лосса) теряется, то есть модель полагается только на группу токенов, что может привести к неправильному пониманию контекста. Это можно решить добавлением основного эмбеддинга токенов, который внесёт информацию о токене (научно — позволит модели дифференцировать текущий токен для снижения лосса тоже) и умного обучаемого вентиля.
Обучаемый вентиль — это некий распределитель внимания [6], который распределяет внимание между двумя эмбеддингами — смысловым и основным. Желательно, чтобы он не отдавал всё внимание одному, минуя второй. Так что формула будет:
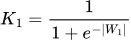
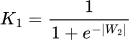
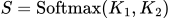
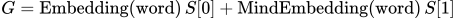
И далее — прогоняем этот G в основной механизм сети.
Позвольте мне объяснить вам, зачем мы берём веса именно по модулю, а не просто веса.
Во-первых, мы поставили себе задачу — чтобы вентиль не насыщал одну позицию и не душил вторую. Если мы будем брать веса по модулю, то минимальное значение при учёте, что вес равен нулю, — 0,5. А если, допустим, один вес уйдёт в -1e9, а второй в 1e9? Без модуля Softmax бы стал One-Hot в пользу второго веса. А так softmax будет выдавать каждому по половинке, что является идеальным вариантом: вентиль хоть и перестаёт учиться, но основные эмбеддинги не перестают.
Допустим, мы учим модель генерировать текст. Слово в обычном эмбеддинге имеет значение только о себе. А в смысловом эмбеддинге одной группы мы получаем связи между словами, в формировании которых участвуют несколько слов, в том числе то слово, которое мы используем на текущем шаге, — вынуждая модель строить связи. То есть наша модель вынуждена выискивать общую зависимость между этими словами для минимизации ошибки.
Итог
Понятно, что без сравнения двух моделей: со смысловым эмбеддингом и без — точного результата мы не получим. Но примерно мы можем сказать, что модель будет вынуждена выучить некие связи и представить эту группу как единое целое. Также это с большой вероятностью смягчит проблему, связанную с тем, что токен, которого нет в датасете, есть в эмбеддинге. Косвенно, через группы некая информация будет, если другие токены в группах были в датасете.
Автор: radmirryan
Источник [7]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36356
URLs in this post:
[1] обучении: http://www.braintools.ru/article/5125
[2] мышления: http://www.braintools.ru/thinking
[3] этой статье: https://habr.com/ru/articles/687646/
[4] ошибки: http://www.braintools.ru/article/4192
[5] научно: http://www.braintools.ru/article/7634
[6] внимания: http://www.braintools.ru/article/7595
[7] Источник: https://habr.com/ru/articles/1089098/?utm_campaign=1089098&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.