Русский текст в Claude Opus 5 стоит в 3,9 раза дороже, чем в GPT-5.5, при одинаковой цене за токен
Цены на API языковых моделей публикуют за миллион токенов, и по этой цифре модели обычно сравнивают. Но «токен» у каждой модели свой. Я прогнал один и тот же русский текст через Claude Opus 5 и GPT-5.5: Opus 5 насчитал в нём в 3,9 раза больше токенов. Значит, при одинаковой цене за токен обработка русского текста на Opus 5 обойдётся почти вчетверо дороже, чем на GPT-5.5, — и это не зависит от того, у кого вы покупаете доступ.
Дело в токенизаторе — алгоритме, который перед подачей в модель режет текст на кусочки-токены. У каждой модели он свой: одни режут русский текст крупными кусками, другие почти по буквам. Поэтому цена за токен сама по себе ничего не говорит о том, сколько вы заплатите за русский текст.
Я прогнал один и тот же русский текст через обе модели. Opus 5 насчитал в нём в 3,9 раза больше токенов, чем GPT-5.5. Значит, при одинаковой цене за токен счёт за русскоязычный продукт на Opus 5 будет почти вчетверо выше, и это не зависит от того, у кого вы покупаете доступ. Никакой ошибки [1] тут нет, просто у разных моделей разные токенизаторы. «Токен» у каждой модели свой, и сравнивать модели по цене за токен без поправки на язык нельзя.
Ниже — замер 11 токенизаторов, за которыми стоят GPT, Claude, Gemini, DeepSeek, Qwen, GLM, Kimi, Grok, GigaChat и YandexGPT. Методика, сырые числа, пересчёт в рубли за тысячу символов и код, чтобы повторить замер на своих текстах.

TL;DR
-
Сколько символов русского текста помещается в один токен, зависит от модели в пять раз: от ~1 у Claude Opus 5 до ~5 у YandexGPT и GigaChat.
-
У GPT-5.x/6, Gemini, Grok и GLM русский текст «весит» на 18–23% больше английского того же смысла. У DeepSeek — на 38%, у Qwen — на 52%, у Kimi — на 86%. У Claude Opus 5 — почти втрое больше.
-
У GigaChat и YandexGPT всё наоборот: русский текст занимает меньше токенов, чем его английский перевод.
-
Сравнивать модели для русскоязычного продукта нужно не по цене за 1M токенов, а по цене за 1 000 символов (или за типичный запрос) на ваших текстах.
-
Не все агрегаторы возвращают настоящий
usage: у одного из проверенных для двух моделей Claude он совпал с подсчётом токенизатором OpenAI до единицы.
Что и как мерил
Тексты для замера
Четыре пары параллельных текстов, русский оригинал и английский перевод одного смысла:
|
Жанр |
Что внутри |
RU, символов |
EN, символов |
|---|---|---|---|
|
tech |
Абзац технической статьи про кэширование промптов |
1 013 |
1 060 |
|
chat |
Диалог клиента и поддержки о двойном списании |
808 |
927 |
|
official |
Деловое уведомление об изменении тарифов по договору |
748 |
744 |
|
code |
Функция на Python с докстрингом и комментариями на соответствующем языке |
745 |
755 |
Тексты я написал сам, специально для замера, и они приложены полностью (ссылка в конце). Набор небольшой. Это осознанное ограничение, о нём ниже, но разброс между жанрами оказался стабильным, и выводы от длины текста почти не зависят.
Открытые токенизаторы — напрямую
Для моделей с открытыми весами токенизатор можно скачать и посчитать токены без всякого API:
-
OpenAI —
tiktoken, кодировкиo200k_base(GPT-4o и новее, включая GPT-5.x и GPT-6) иcl100k_base(GPT-4, GPT-3.5) для сравнения; -
GigaChat 3 —
tokenizer.jsonизai-sage/GigaChat3-10B-A1.8B; -
YandexGPT 5 Lite — SentencePiece
tokenizer.modelизyandex/YandexGPT-5-Lite-8B-instruct; -
DeepSeek V3 и Qwen 3 —
tokenizer.jsonиз официальных репозиториев на Hugging Face.
Закрытые модели — через API и разницу usage
У Claude, Gemini, Grok, Kimi и GLM токенизатор недоступен, поэтому остаётся поле usage.prompt_tokens в ответе API. Проблема в том, что это число включает служебное: шаблон чата, а у некоторых шлюзов и собственный системный промт. В одном из проверенных шлюзов на вопрос из пяти слов засчиталось 1 356 входных токенов, в другом — 3 346.
Поэтому я считал по разнице двух запросов:
токены(текст) = usage(«Ответь одним словом: ок.nn» + текст) − usage(«Ответь одним словом: ок.»)
Всё служебное одинаково в обоих запросах и при вычитании пропадает. Ответ модели не важен, max_tokens=16, так что весь замер обошёлся в копейки.
Проверка метода: для DeepSeek V4 Flash через API разница дала ровно те же числа, что локальный токенизатор DeepSeek V3, а для GPT-6 Sol и GPT-5.6 Luna — ровно числа o200k_base. Значит, вычитание честно убирает служебные токены.
Результаты
Токены: русский / английский. «RU/EN» — во сколько раз русская версия текста длиннее в токенах (по трём прозаическим жанрам, без кода). «Символов на токен» — сколько символов текста приходится на один токен.
|
Модель / токенизатор |
tech |
chat |
official |
code |
RU/EN |
Симв./токен RU |
Симв./токен EN |
|---|---|---|---|---|---|---|---|
|
YandexGPT 5 Lite |
197 / 211 |
170 / 189 |
136 / 150 |
215 / 219 |
0,91 |
5,11 |
4,97 |
|
GigaChat 3 |
215 / 212 |
176 / 186 |
137 / 150 |
202 / 200 |
0,96 |
4,87 |
4,98 |
|
Grok 4.7 |
258 / 209 |
214 / 185 |
162 / 144 |
222 / 211 |
1,18 |
4,05 |
5,08 |
|
OpenAI o200k (GPT-5.x, GPT-6) |
260 / 209 |
208 / 185 |
173 / 145 |
214 / 198 |
1,19 |
4,01 |
5,07 |
|
Gemini 3.7 Flash |
259 / 210 |
208 / 186 |
179 / 144 |
232 / 219 |
1,20 |
3,98 |
5,06 |
|
GLM-5.3 |
270 / 209 |
205 / 185 |
186 / 143 |
216 / 196 |
1,23 |
3,89 |
5,09 |
|
DeepSeek V3 / V4 |
296 / 209 |
250 / 186 |
201 / 145 |
225 / 203 |
1,38 |
3,44 |
5,06 |
|
Qwen 3 |
324 / 209 |
259 / 185 |
237 / 146 |
231 / 196 |
1,52 |
3,13 |
5,06 |
|
Kimi K3 |
382 / 209 |
336 / 186 |
284 / 145 |
245 / 197 |
1,86 |
2,56 |
5,06 |
|
OpenAI cl100k (GPT-4, для сравнения) |
422 / 209 |
377 / 185 |
322 / 143 |
258 / 196 |
2,09 |
2,29 |
5,09 |
|
Claude Opus 5 |
872 / 327 |
830 / 285 |
785 / 228 |
424 / 231 |
2,96 |
1,03 |
3,25 |

Что видно из таблицы:
Английский почти у всех одинаковый. 5,0–5,1 символа на токен у десяти моделей из одиннадцати. Словари токенизаторов в основном учились на английском, и для него все пришли примерно к одному результату.
Русский отличается в пять раз. Лучше всех токенизируют русский модели, которые делали под русский: YandexGPT и GigaChat. У них русский текст даже короче английского перевода. Модели с большим многоязычным словарём (GPT, Gemini, Grok, GLM) проигрывают английскому 18–23%. Китайские модели с меньшей долей кириллицы в словаре — от 38% (DeepSeek) до 86% (Kimi).
GPT-4 → GPT-4o — большой шаг для русского. Переход с cl100k на o200k сократил число токенов на русском почти вдвое: 2,29 → 4,01 символа на токен. Английский при этом не изменился. Если вы считали бюджет на русском по опыту [2] с GPT-4, вы его сильно переоценивали.
Claude Opus 5 — отдельная история. Около одного символа на токен в русском, то есть почти каждая буква — отдельный токен. И даже в английском 3,25 символа на токен против пяти у остальных. На коде разница меньше, всего в два раза: латиница и ключевые слова Python токенизируются привычно, дорожают только русские комментарии и докстринг.
Пересчёт в рубли
Теперь самое практичное: сколько стоит одна и та же тысяча символов входного текста. Цена за 1M токенов — медиана входной цены по сервисам с доступом из России на 27.09.2026, данные взяты из каталога цен AI-Ping [3]. Там же видно, у кого конкретная модель дешевле всего: минимальная цена и медиана иногда расходятся в разы, и для реального бюджета стоит смотреть и на то, и на другое. «Символов на токен» — из таблицы выше, по прозе.
|
Модель |
₽ за 1M входных токенов |
₽ за 1 000 символов RU |
₽ за 1 000 символов EN |
Русский дороже в |
|---|---|---|---|---|
|
DeepSeek V4 Flash |
14,67 |
0,0043 |
0,0029 |
1,47× |
|
GPT-5.6 Luna |
23,63 |
0,0059 |
0,0047 |
1,26× |
|
Gemini 3.7 Flash |
83 |
0,0209 |
0,0164 |
1,27× |
|
Qwen3 Max |
94 |
0,0300 |
0,0186 |
1,61× |
|
GLM-5.3 |
133 |
0,0342 |
0,0262 |
1,31× |
|
DeepSeek V4 Pro |
149,46 |
0,0435 |
0,0296 |
1,47× |
|
YandexGPT 5 Lite |
270 |
0,0529 |
0,0544 |
0,97× |
|
Grok 4.6 |
235,57 |
0,0581 |
0,0464 |
1,25× |
|
Kimi K3 |
285 |
0,1112 |
0,0564 |
1,97× |
|
GPT-5.5 |
552 |
0,1377 |
0,1089 |
1,26× |
|
GigaChat 2 Max |
1 245,9 |
0,2561 |
0,2500 |
1,02× |
|
Claude Opus 5 |
549,31 |
0,5318 |
0,1690 |
3,15× |
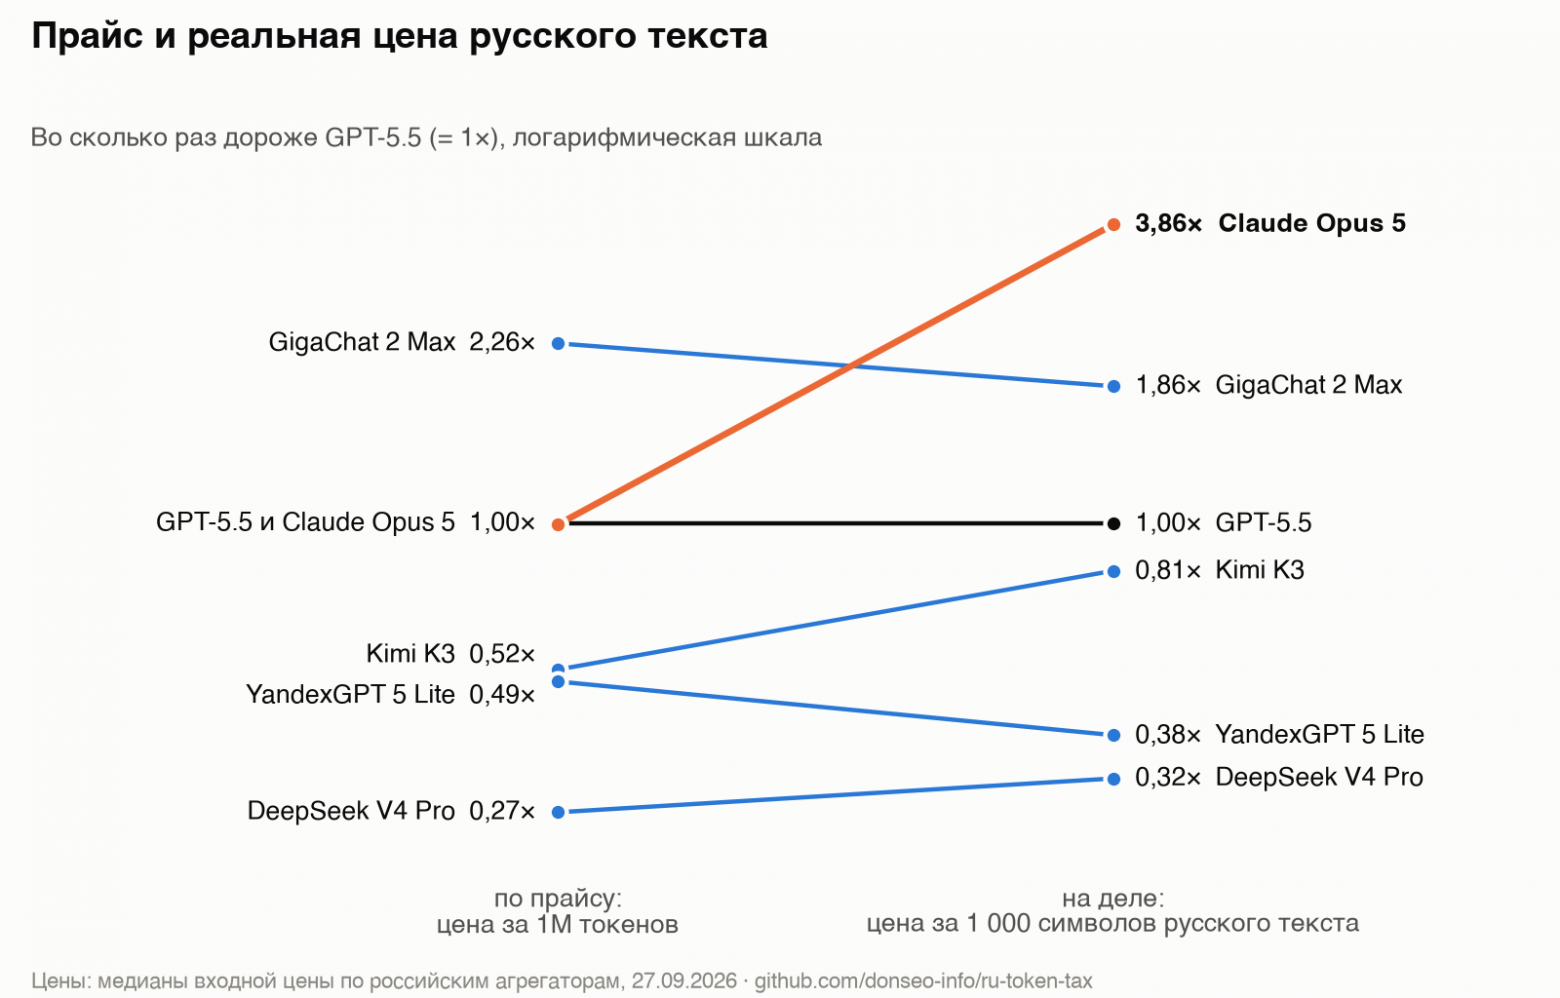
Важная оговорка про цены. Медиана — это не цена, которую заплатите вы. У разных сервисов одна и та же модель стоит по-разному, иногда в десятки раз: на 27.09 за 1M входных токенов Opus 5 стоил 28,5 ₽ у самого дешёвого сервиса и 549 ₽ по медиане, GPT-5.5 — 14,25 ₽ и 552 ₽. Поэтому рубли в таблице — ориентир для сравнения моделей между собой по одному правилу. Для своего бюджета подставьте цену вашего провайдера или официальный тариф разработчика. Множитель токенизатора, то есть сколько токенов займёт ваш русский текст, останется тем же.
Три вывода, ради которых стоило считать.
-
Opus 5 и GPT-5.5 по прайсу одинаковые, а на русском тексте Opus 5 дороже в 3,9 раза (0,53 ₽ против 0,14 ₽ за тысячу символов). Эта цифра — чистый эффект токенизатора: при равной цене за токен Opus 5 просто тратит на тот же текст в 3,9 раза больше токенов. Для англоязычного продукта разница всего 1,55 раза: у Opus 5 и на английском токены «короче».
-
Разрыв между российскими и зарубежными моделями на русском меньше, чем кажется по прайсу. GigaChat 2 Max по цене за токен в 2,3 раза дороже GPT-5.5, а по цене за тысячу русских символов — в 1,9 раза. YandexGPT 5 Lite за токен вдвое дешевле GPT-5.5, а за тысячу русских символов — в 2,6 раза.
-
Kimi K3 по прайсу вдвое дешевле GPT-5.5, а на русском разница сжимается до 1,24 раза.
Одно уточнение для реальных расчётов: токенизатор тот же и для ответа модели. Длинные русские ответы дорожают в той же пропорции, а выходные токены обычно в 3–5 раз дороже входных. Для чат-бота, который много пишет, эффект сильнее, чем в таблице выше.
Побочная находка: usage у агрегатора — не всегда usage модели
При замере через один из агрегаторов claude-sonnet-5 и claude-opus-4-8 вернули prompt_tokens, совпадающие с tiktoken o200k_base до единицы на всех восьми текстах. При этом claude-opus-5 у того же агрегатора вернул совсем другие числа и в ответе были служебные поля Anthropic (claude_cache_creation_5_m_tokens, usage_source: anthropic). У Sonnet 5 и Opus 4.8 таких полей не было.
Объяснений два: либо шлюз для этих моделей пересчитывает токены сам токенизатором OpenAI, либо запросы уходят не в ту модель, что указана. Проверить изнутри нельзя. Оба варианта значат, что числа usage у посредника нельзя считать данными модели, пока вы их не сверили: с локальным токенизатором, где он открыт, или со служебными полями провайдера. По этой же причине в таблице нет Sonnet 5 и Opus 4.8. Честно замерить их через доступные мне шлюзы в день замера не удалось, а у второго шлюза Claude был недоступен.
Как повторить на своих текстах
Для моделей с открытым токенизатором хватит пяти строк:
import tiktoken
from tokenizers import Tokenizer

text = open("my_prompt_ru.txt").read()
gpt = tiktoken.get_encoding("o200k_base")
giga = Tokenizer.from_file("GigaChat3__tokenizer.json")   # из ai-sage/GigaChat3-10B-A1.8B
print(len(text) / len(gpt.encode(text)), "симв./токен у GPT-5.x")
print(len(text) / len(giga.encode(text, add_special_tokens=False).ids), "симв./токен у GigaChat")
Для закрытых моделей — разница двух запросов:
def text_tokens(client, model, text, base="Ответь одним словом: ок."):
    def pt(content):
        r = client.chat.completions.create(model=model, max_tokens=16,
                                           messages=[{"role": "user", "content": content}])
        return r.usage.prompt_tokens
    return pt(base + "nn" + text) - pt(base)
Замеряйте на своих промптах: системной инструкции, типичном вопросе пользователя, документах из RAG. Доля кириллицы, цифр, кода и разметки в реальном трафике сильно влияет на итог. Промпт с JSON-схемой инструментов на английском и короткий русский вопрос дадут совсем другое соотношение, чем чистая русская проза.
Ограничения
-
Текстов мало: четыре пары, около 2 500 символов прозы на язык. Разброс между жанрами у каждой модели небольшой, порядок моделей во всех жанрах один и тот же, но точные коэффициенты на ваших данных будут отличаться на единицы процентов.
-
Токенизатор GigaChat 3 ≠ GigaChat 2. В таблице цен GigaChat 2 Max посчитан по токенизатору открытой GigaChat 3, других открытых нет. Если у GigaChat 2 токенизатор другой, цифра в рублях сдвинется.
-
Grok 4.6 в таблице цен посчитан по токенизатору Grok 4.7, у которого замерен usage. Модели одного семейства, но это допущение.
-
Цены — медианы по агрегаторам на одну дату. Прямые тарифы разработчиков и минимальные цены у отдельных сервисов отличаются, иногда в разы.
-
Usage закрытых моделей получен через шлюзы. Для DeepSeek и GPT я сверил его с открытыми токенизаторами и получил точное совпадение. Для Gemini, GLM, Grok и Kimi сверять не с чем, но числа правдоподобны и стабильны. Для Claude Opus 5 usage подтверждён служебными полями Anthropic.
Что с этим делать
Если продукт русскоязычный:
-
Сравнивайте модели по цене за типичный запрос на своих данных, а не по прайсу за 1M токенов. Сделать замер — полчаса, и он может поменять выбор модели.
-
Закладывайте поправку на язык в бюджет. Для GPT, Gemini, Grok — плюс ~20% к «английским» оценкам, для DeepSeek и Qwen — плюс 40–50%, для Claude Opus 5 — втрое больше.
-
Держите служебную часть промпта на английском, если модель плохо токенизирует русский. Системная инструкция, описание инструментов, схемы JSON дешевле на английском. Пользовательский текст и ответ остаются русскими. Для Opus 5 так можно сократить входные токены системной части почти втрое, но проверьте, не падает ли качество ответов на русском.
-
Не доверяйте
usageпосредника вслепую, особенно если на нём построен ваш биллинг. Сверьте хотя бы раз с открытым токенизатором или с кабинетом разработчика модели.
Полезные ссылки
-
ru-token-tax [4] — тексты, скрипт замера, сырые результаты и графики из этой статьи
-
tiktoken [5] — токенизаторы OpenAI,
o200k_baseиcl100k_base -
Подсчёт токенов в Claude [6] — официальный бесплатный эндпоинт Anthropic, самый надёжный способ посчитать токены Claude
-
GigaChat 3 [8] и YandexGPT 5 Lite [9] на Hugging Face — открытые веса и токенизаторы
-
Цены на API моделей у российских сервисов [3] — откуда взяты цены для пересчёта
Тексты, скрипт и сырые результаты — в репозитории [4]. Если прогоните замер на своих текстах или на моделях, которых здесь нет, особенно Claude Sonnet 5 и GigaChat 2 через официальный API, поделитесь цифрами в комментариях. Дополню таблицу.
Автор: donseo
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36359
URLs in this post:
[1] ошибки: http://www.braintools.ru/article/4192
[2] опыту: http://www.braintools.ru/article/6952
[3] AI-Ping: https://ai-ping.ru/models
[4] ru-token-tax: https://github.com/donseo-info/ru-token-tax
[5] tiktoken: https://github.com/openai/tiktoken
[6] Подсчёт токенов в Claude: https://docs.anthropic.com/en/docs/build-with-claude/token-counting
[7] Подсчёт токенов в GigaChat API: https://developers.sber.ru/docs/ru/gigachat/api/reference/rest/post-tokens-count
[8] GigaChat 3: https://huggingface.co/ai-sage/GigaChat3-10B-A1.8B
[9] YandexGPT 5 Lite: https://huggingface.co/yandex/YandexGPT-5-Lite-8B-instruct
[10] Источник: https://habr.com/ru/articles/1089148/?utm_campaign=1089148&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.