Научил кнопочный телефон 1980-х годов разговаривать с Claude
На старый немецкий кнопочный телефон FeTAp я установил аудиоплату на ESP32 и связал ее со своим ассистентом на Raspberry Pi. Теперь достаточно снять трубку, как на другом конце отвечает ИИ, с которым можно разговаривать почти как по обычному телефону.
За распознавание и синтез речи отвечает ElevenLabs Conversational AI, в роли языковой модели используется Claude. Ассистент говорит по-немецки, помнит предыдущие разговоры и использует ту же базу памяти [1], что и мой Telegram-бот.
Самой простой частью проекта неожиданно оказалась электроника. Основное время ушло на задержки, обработку реплик и попытки сделать разговор достаточно быстрым, чтобы он действительно ощущался телефонным.
Зачем вообще ИИ в старом телефоне
До этого у меня уже постоянно работал ИИ-ассистент на Raspberry Pi, подключённый к Claude. Сам по себе он меня устраивал, но взаимодействие все равно сводилось к переписке с телефона, хотелось чего-то другого.
Идея появилась после похожего проекта, который я увидел в интернете: кто-то подключил старый телефон к ИИ. Я начал искать подходящий аппарат и на барахолке нашeл FeTAp — красный кнопочный телефон, знакомый многим немецким семьям по 1980-м. Совпадение оказалось особенно удачным: именно такая модель стояла у моих родителей, когда я был ребенком. Красный глянцевый пластик, массивные кнопки и звонок, который сложно не услышать.
Концепция получилась очень простой: что, если для разговора с ИИ вообще не нужны экран и wake word? Просто снимаешь трубку – тебе отвечают. Никаких «Привет, Гугл», приложений и отдельных интерфейсов. По ощущениям это должен был быть обычный разговор по стационарному телефону.
Как это выглядит со стороны
Пользователь снимает трубку, затем через короткий сигнал в наушнике звучит:
Hallo, who is it?
После этого начинается обычный разговор, только на другом конце находится Claude с персоной по имени Elliot. Elliot говорит по-немецки, отвечает неформально и старается не растягивать реплики. Можно задать вопрос, получить ответ, поговорить ещё немного и положить трубку.
Отдельно мне хотелось сохранить характерное ощущение старого телефона.
Сразу после снятия трубки в динамике появляется знакомый гудок, однако реальной телефонной сети, естественно, за устройством нет, поэтому сигнал пришлось генерировать программно и самостоятельно отправлять в динамик трубки.
Мелочь, но именно она сильно влияет на восприятие [2] устройства. Весь голосовой pipeline проходит через ElevenLabs Conversational AI: распознается речь пользователя, запрос отправляется языковой модели, после чего ответ преобразуется обратно в голос.
В роли LLM работает Claude. Ответ обычно начинает звучать примерно через секунду. Для телефонного разговора разница между одной и несколькими секундами задержки ощущается гораздо сильнее, чем в текстовом интерфейсе.
У телефона есть и общая память с моим Telegram-ботом, поэтому, если, например, в понедельник рассказать Elliot, что вы были в Таиланде, он сможет вспомнить об этом в следующем разговоре. Причем источник информации [3] не имеет значения: память используется сразу несколькими каналами взаимодействия.
После завершения звонка transcript разговора анализируется отдельно. Из него извлекаются факты, планы и предпочтения, которые имеет смысл сохранить, пользователю не нужно говорить «запомни это», система сама обрабатывает разговор после его завершения и записывает подходящую информацию в базу.
Телефоном пользуюсь не только я. Трубку может снять моя партнерша, дети или пришедший в гости человек, также предусмотрены и тайм-ауты. Если кто-то случайно оставит трубку снятой, разговор не будет продолжаться бесконечно и расходовать баланс.
Из чего все собрано
Архитектура состоит из двух основных вычислительных частей: небольшого контроллера непосредственно внутри телефона и Raspberry Pi, который занимается оркестрацией.
FeTAp
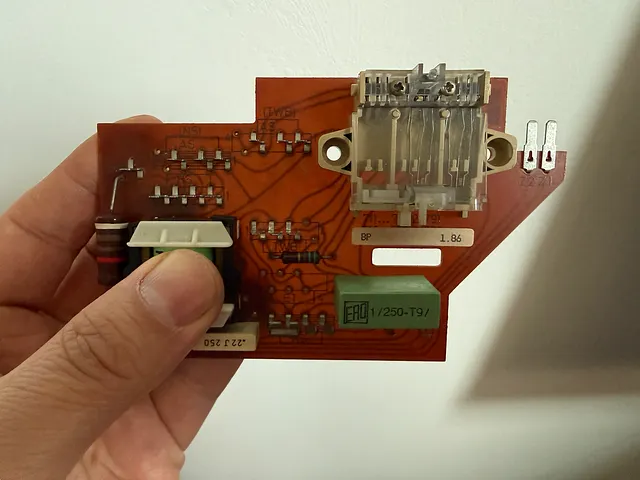
Сам телефон выполняет роль корпуса и интерфейса, в котором я сохранил оригинальную трубку, кнопочную клавиатуру, рычажный переключатель трубки и сам звонок.
Состояние переключателя считывается электроникой, а звук передается через штатную трубку.
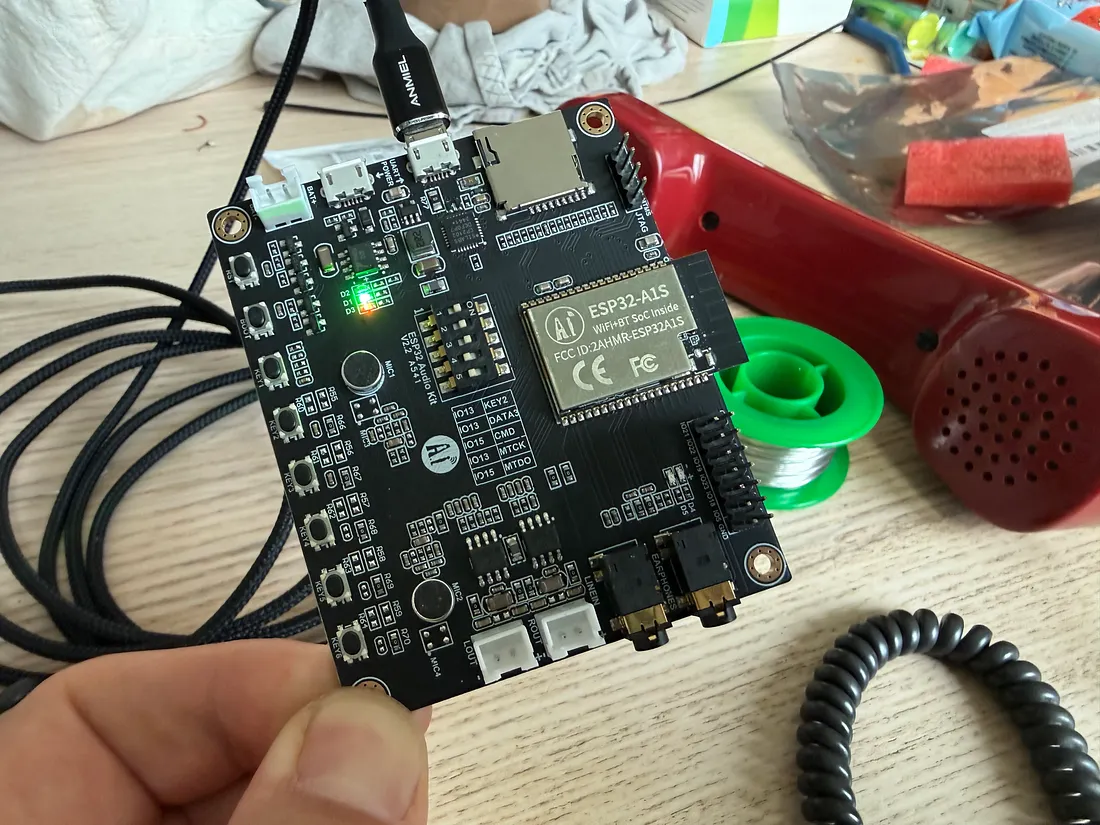
ESP32-A1S Audio Kit
Внутри телефона находится ESP32-A1S Audio Kit, плата которого принимает звук с микрофона, воспроизводит голос через динамик, следит за “положением” трубки и передает аудио по wi-fi на Raspberry Pi.
Никакого ИИ непосредственно на ESP32 не запускается.
Raspberry Pi 5
Основной хост системы, на котором круглосуточно работает телефонный daemon, принимающий аудиопоток от ESP32, а также, который связывает его с ElevenLabs, создает и завершает разговорные сессии и работает с памятью.
Этот же Raspberry Pi уже обслуживал моего Telegram-ассистента, поэтому отдельная машина для телефона не понадобилась.
ElevenLabs Conversational AI
Отвечает за голосовую часть: speech-to-text, text-to-speech, определение границ реплик и управление разговорным агентом. Внутри агента в качестве языковой модели используется Claude.
Claude Haiku 4.5
Для обычных разговоров я выбрал Claude Haiku 4.5.Здесь важны скорость и стоимость; сложного многошагового reasoning в большинстве телефонных реплик не требуется, а задержка должна оставаться минимальной.
Supabase
Это та же PostgreSQL-база, которую уже использует Telegram-бот. Поэтому факты, цели и история доступны независимо от того, через какой интерфейс пользователь общался с ассистентом.
Bun и TypeScript
Daemon написан на TypeScript и работает через Bun. Он занимается передачей аудио и постобработкой разговора, включая извлечение информации для памяти после завершения звонка.
Один телефон, несколько вариантов архитектуры
Телефон не привязан строго к одному голосовому или модельному стеку.
Несколько environment variables определяют какой speech engine использовать, какая модель будет отвечать и каким голосом будет говорить ассистент. В зависимости от конфигурации меняются задержка, стоимость, возможности и уровень приватности.
Единственного «лучшего» варианта здесь нет. В turn-based конфигурациях распознавание речи выполняется через Whisper у Groq — он достаточно быстрый и хорошо работает с немецким. ElevenLabs Conversational AI использует собственный встроенный механизм распознавания.
На практике у меня получились следующие варианты.
Turn-based + CLI
Задержка около 13 секунд, из плюсов – хорошее распознавание немецкой речи, live web search, полное чтение и запись памяти. Главный недостаток – скорость.
Turn-based + API
Задержка снижается примерно до 2–3 секунд. Остается хорошее распознавание речи, лайв веб сёрч и полноценная работа с памятью, но запросы к API уже тарифицируются отдельно.
ElevenLabs Conversational AI
Средняя задержка у меня получилась около 1,2 секунды и тут уже live web search отсутствует, память читается перед звонком и дополняется после него, а расходы идут через кредиты ElevenLabs, отдельного счёта за модель нет. Именно этот вариант в итоге стал основным.
OpenAI Realtime
Задержка ~1 секунда. Используется STT OpenAI, live web search в этой конфигурации также отсутствует. Память работает по схеме чтения перед звонком и записи после завершения разговора, оплата идет через OpenAI, голос при этом можно менять независимо от выбранной «головы». Я использовал либо Google Chirp 3 HD, либо голос ElevenLabs.
Для повседневной работы я остановился на ElevenLabs Conversational AI прежде всего из-за задержки. В телефонном разговоре одна секунда воспринимается нормально, пауза в три секунды уже напоминает ожидание ответа какого-нибудь голосового меню.
При этом аппаратная часть остается той же. Достаточно поменять переменную конфигурации, чтобы тот же физический телефон работал через другой pipeline.
Как проходит один звонок
Архитектуру можно представить как последовательную передачу аудио между несколькими компонентами.
Пользователь снимает трубку → ESP32 видит изменение состояния Gabelschalter и отправляет Raspberry Pi событие pickup → Pi устанавливает соединение с агентом ElevenLabs и перед началом разговора передает ему информацию о пользователе из Supabase → Дальше аудио идет по цепочке:
Трубка→ ESP32 → Respberry Pi → ElevenLabs
Где ElevenLabs распознает речь, Claude формирует ответ, ElevenLabs синтезирует голос, и ответ возвращается:
ElevenLabs → Raspberry Pi→ESP32→динамик трубки
Когда пользователь кладет трубку, положение переключателя снова меняется. Raspberry Pi завершает активную сессию. После этого transcript разговора отдельно анализируется, и полезные сведения отправляются в память.
Для извлечения памяти я использую свою подписку Claude, поэтому отдельной стоимости у этого этапа для меня нет.
Что оказалось сложнее всего
Сам телефон удалось подключить довольно быстро. Провода Gabelschalter я вывел на GPIO ESP32, чтобы отслеживать снятие и возврат трубки. Затем подключил питание и вывел звук на динамик. На пайку и базовую разводку ушел примерно вечер.
Основные проблемы начались уже после того, как аппаратная часть заработала.
От 13 секунд до одной
Первая версия была технически рабочей, но пользоваться ею было практически невозможно. После реплики приходилось ждать около 13 секунд. За это время успеваешь понять, что система зависла, и только потом слышишь ответ.
Изначально Claude запускался через локальный CLI. Для меня этот вариант не требовал дополнительных расходов, поскольку использовалась уже существующая подписка.
Проблема в том, что для каждой реплики приходилось поднимать отдельный процесс. Для интерактивного телефонного разговора это слишком медленно.
Следующим шагом стал прямой вызов API. Задержка сократилась примерно до двух секунд. Разговаривать стало заметно комфортнее, но появилась отдельная тарификация API. После этого я перенёс практически весь pipeline в ElevenLabs Conversational AI. Распознавание речи, управление репликами, LLM и синтез голоса оказались рядом друг с другом. Задержка уменьшилась примерно до 1,2 секунды.
Заодно изменилась схема оплаты: языковая модель стала тарифицироваться через кредиты ElevenLabs, а не отдельный API.
Казалось, что проблема решена, но после этого появилась следующая.
Как один токен лимит сломал весь разговор
После перехода на более дешевую и быструю Claude Haiku Elliot начал отвечать слишком подробно. Для телефонного разговора длинные монологи неудобны, поэтому первым решением было просто ограничить количество генерируемых токенов.
На первый взгляд все заработало, но проблема появлялась примерно после двух реплик. Я говорил что-нибудь в третий раз и не получал ответа. Затем срабатывал idle timeout, и звонок завершался. Причем проблема повторялась практически в каждой сессии.
По аудиодиагностике было видно, что мой голос до системы доходит: пики присутствовали, однако ElevenLabs не создавал transcript очередной реплики. Третий ход как будто исчезал.
Сначала я подозревал механизм определения конца реплики. Потом заметил в логах ответ, обрезанный прямо посреди слова. Причиной оказался установленный мной жёсткий token cap. Когда модель принудительно обрывалась посреди ответа, state machine ElevenLabs не всегда корректно завершала текущий turn. После этого состояние разговора зависало, и следующая реплика пользователя терялась.
Решение оказалось проще, чем сама диагностика: я полностью убрал ограничение по токенам. Длину ответа теперь контролирует системная инструкция:
Всегда отвечай не более чем 1–2 короткими предложениями.
После изменения я получил шесть нормальных реплик подряд: ничего не пропадало и ответы оставались короткими. В данном случае мягкое ограничение на уровне prompt оказалось надежнее жесткого технического лимита.
Сколько все это стоит
Телефон работает на тарифе ElevenLabs Starter за $6 в месяц. В тариф включено 75 минут разговоров.
Обычный звонок продолжительностью около полутора минут расходует примерно 560 кредитов. В эту сумму входят: speech to text, работа языковой модели и text to speech.
Доля Claude небольшая, поскольку используется Haiku. Для моего обычного сценария Starter хватает. Если разговаривать по телефону значительно чаще, потребуется другой тариф.
Остальная инфраструктура почти ничего дополнительно не стоит. Постобработка разговоров через Claude работает в рамках уже оплаченной подписки — дополнительные расходы для меня равны $0.
Supabase использует бесплатный тариф и одновременно обслуживает Telegram-бота.
Электричество для Raspberry Pi обходится примерно в $0,30 в месяц. Плата ESP32 стоила несколько евро и покупалась один раз.
В итоге содержание старого телефона, по которому можно разговаривать с ИИ, обходится мне примерно в $6 ежемесячно. До переделки он просто стоял как декоративная вещь.
Автор: Qwertcoser
Источник [4]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36373
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] восприятие: http://www.braintools.ru/article/7534
[3] источник информации: http://www.braintools.ru/article/8616
[4] Источник: https://habr.com/ru/articles/1089250/?utm_campaign=1089250&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.