Как я собрал винный бенчмарк на 3 266 вопросов руками LLM и где они меня подвели
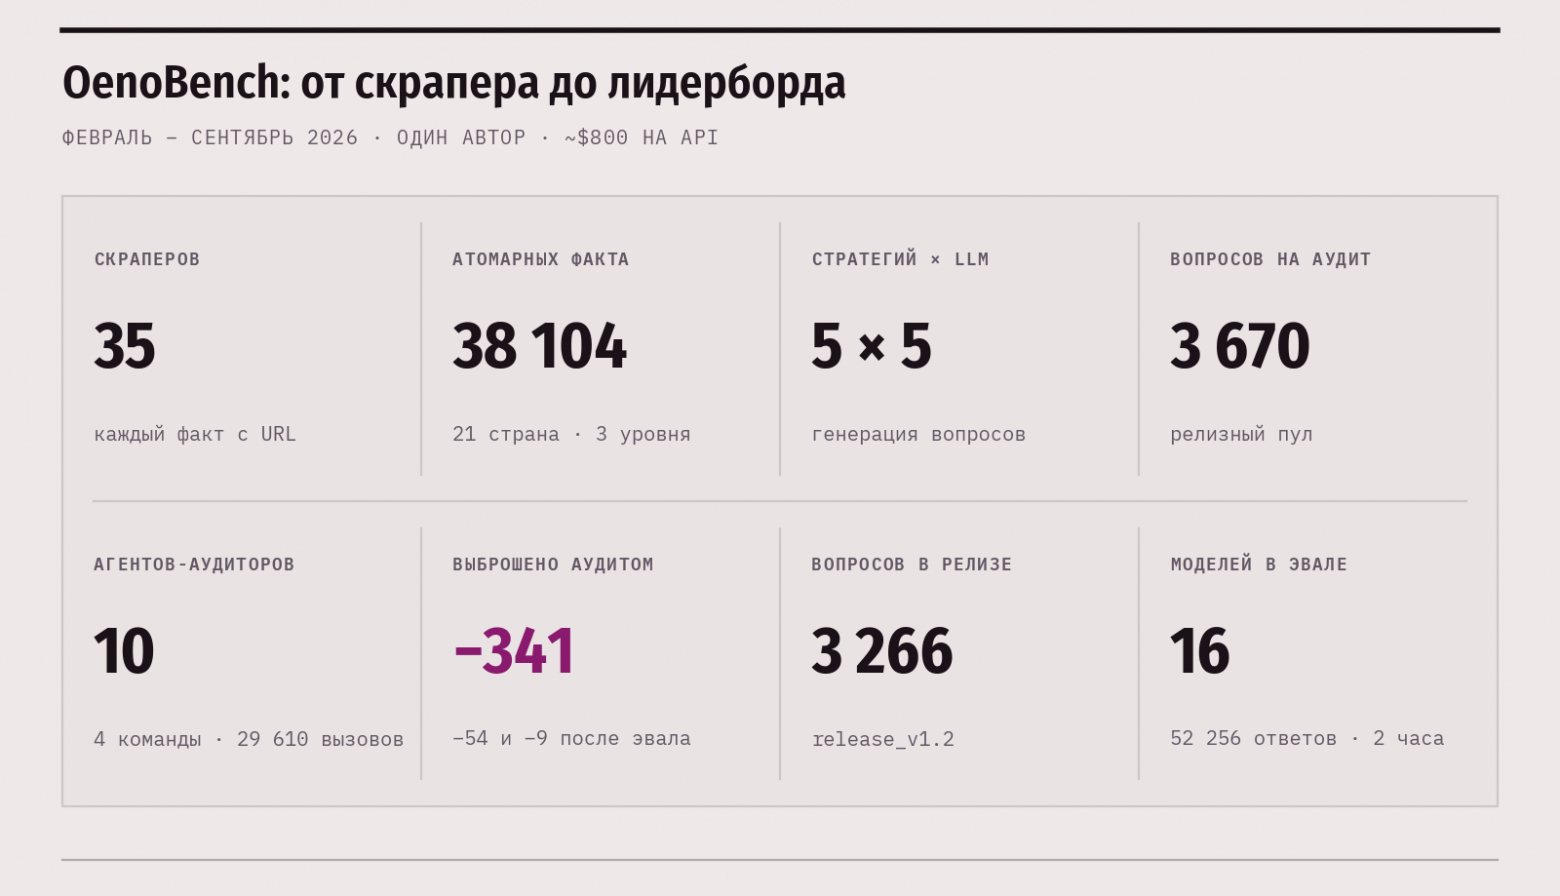
В феврале я решил измерить, сколько языковые модели на самом деле знают про вино. Умеют ли они поддержать разговор о Бордо, мне было неинтересно. Меня интересовало, знают ли они, сколько месяцев Бароло обязано провести в бочке и в каком округе штата Вашингтон лежит AVA Beverly. К сентябрю из этого вышел бенчмарк OenoBench: 38 104 факта, собранных 35 скраперами из открытых источников, 3 266 вопросов с выбором ответа и прогон шестнадцати моделей. Почти всю работу сделали агенты: вопросы генерировали пять моделей, проверяли их десять агентов аудита. Я был единственным человеком в этой схеме и отвечал за то, что агенты проверить не могут: за вино.
Счёт за API за всё время — около $800. Статью по результатам я подал на NeurIPS 2026 в трек Datasets & Benchmarks. Дальше — что именно я делал и зачем, как факт превращается в вопрос, как десять агентов спорят о его качестве, где они меня подвели и что шестнадцать моделей показали на выходе.
Что я делал и зачем
У меня диплом WSET четвёртого уровня (Wine & Spirit Education Trust, британская система винного образования). Это её высшая ступень и обычный порог для поступления на Master of Wine. При этом я много работаю с языковыми моделями, в том числе веду проект про ИИ в винной отрасли. Из этого сочетания растёт неудобный вопрос. Когда модель отвечает про вино, проверить её может только человек, который вино знает. Общие бенчмарки про это молчат: MMLU или GPQA скажут, что модель сильна в физике и праве, но ни слова о том, отличает ли она Бароло от Барбареско. А для отрасли, где ИИ уже пишут описания вин, консультируют покупателей и подбирают пары к блюдам, это как раз главный вопрос.
Вино при этом подходит для бенчмарка лучше, чем кажется. Классификации формализованы: AOC во Франции, DOCG в Италии, AVA в США. Это не вкусовщина, а тысячи страниц регламентов с точными границами, разрешёнными сортами и предельной урожайностью, и у каждого вопроса по ним есть однозначный ответ. Данные открыты: Wikidata под CC0, Wikipedia под CC BY-SA, реестры французского INAO и американского TTB, справочник AVA от Калифорнийского университета в Дэвисе. И проверять факты я мог сам, без найма экспертов.
Замысел был такой. Собрать факты из открытых источников в базу, где у каждого утверждения есть ссылка. Превратить факты в вопросы с выбором ответа, обычно из четырёх вариантов, по шести областям: регионы, сорта, производители, виноградарство, виноделие и винный бизнес. Разложить вопросы по четырём уровням сложности, от базового L1 до уровня Master of Wine на L4. Прогнать через них модели и посмотреть, кто что знает. Целью я поставил 5 000 вопросов и дедлайн NeurIPS в мае. Вот два вопроса из итогового корпуса, чтобы было понятно, о чём речь:
-
L2: Moscato di Scanzo holds Italy’s DOCG status. In which Italian region is this appellation located? Ответ: Lombardy.
-
L4: The regulatory boundaries for which American Viticultural Area are codified specifically within Title 27, section 9.172 of the Code of Federal Regulations? Ответ: West Elks.
Ограничение было одно, и оно определило всю архитектуру: я один. Написать 5 000 вопросов руками эксперт может, но это полгода работы без выходных. Поэтому вопросы должны были генерировать модели, а проверять их должны были другие модели. Мне оставалась роль калибровщика: размечать выборки, считать, где агенты со мной согласны, и решать, кому из них верить.
Общая схема — на рисунке ниже, и разделы статьи идут по ней сверху вниз.
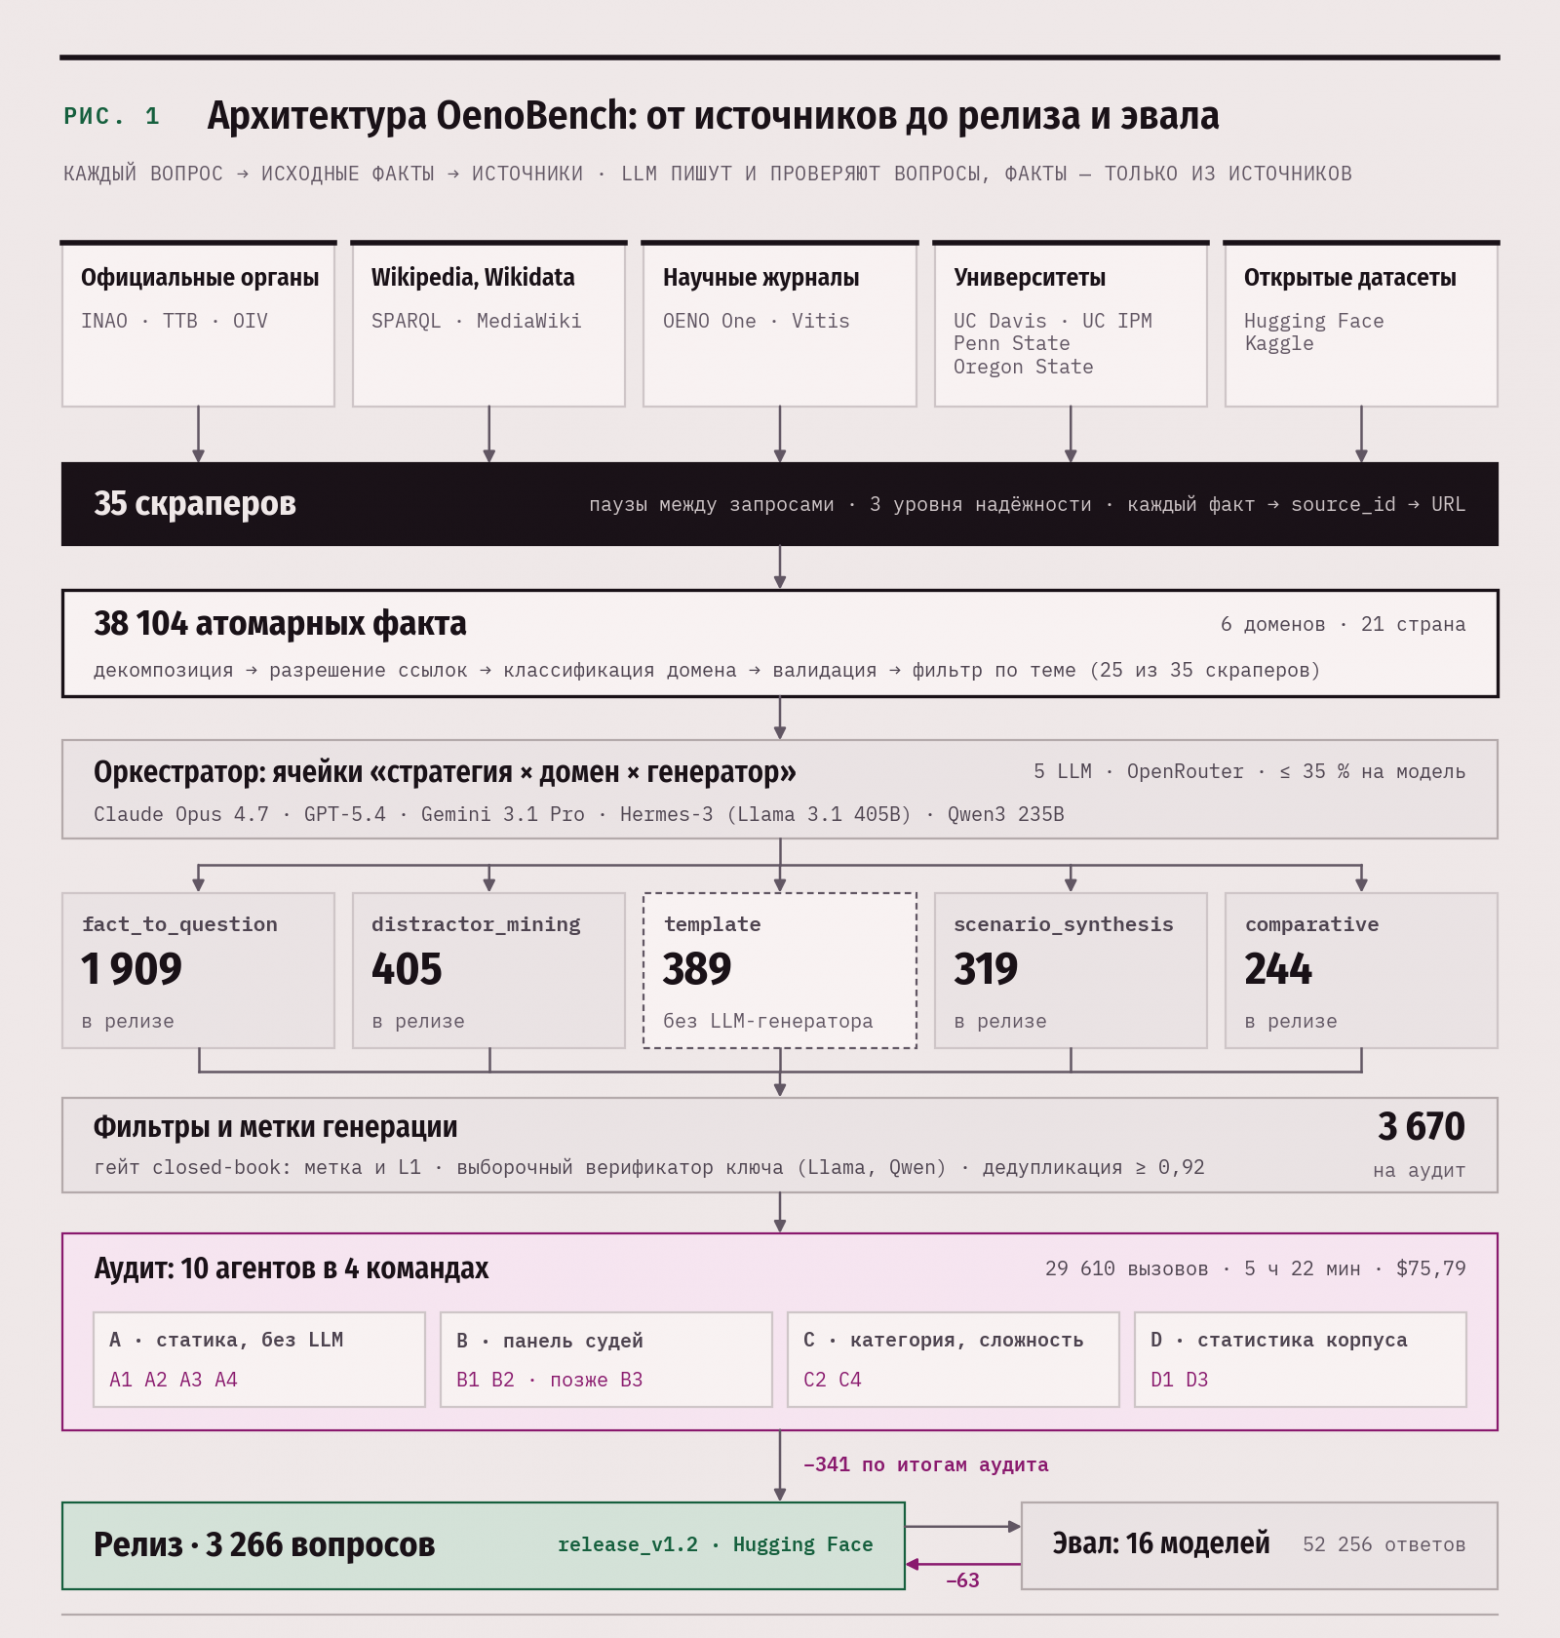
Хронология простая: февраль – апрель ушли на скраперы и факты, апрель – начало мая на генерацию и аудит, 3 мая прошёл финальный прогон шестнадцати моделей, 4 мая я подал статью. Летом добавились прогоны, которые проверяли уже не модели, а сам корпус. Начну с того, что пошло не так первым.
17 скраперов из 35 ничего не скрапили
Первые скраперы я написал в феврале. К началу апреля в базе лежало около 27 тысяч фактов, дашборд показывал зелёные цифры, и я собирался запускать генерацию.
7 апреля я сделал то, что надо было сделать в феврале: прошёл по каждому скраперу с вопросом «а что ты, собственно, скачиваешь». Вот начало файла italy.py в том виде, в каком он лежал в репозитории с 14 февраля:
# ─── Structured DOCG Knowledge Base ──────────────────────────────────────────
# This is the guaranteed fallback: a well-known fixed list of all 77 DOCG
# appellations with structured data compiled from multiple public sources.

DOCG_DATABASE = [
    # ── Piedmont (17 DOCG) ──
    {
        "name": "Barolo",
        "region": "Piedmont",
        "classification": "DOCG",
        "colors": ["red"],
        "grapes": ["Nebbiolo"],
        "grape_pct": "100% Nebbiolo",
        "aging_months": 38,
        "aging_wood_months": 18,
        "riserva_months": 62,
        "yield_tons_ha": 8.0,
        "notes": "Must be aged for a minimum of 38 months, including 18 months in wood.",
    },
    # ... ещё 75 записей
]
«Guaranteed fallback». Ниже в файле был честный HTTP-клиент с паузами между запросами, и он даже ходил на сайт консорциума. Только результат никуда не складывался: факты скрапер всегда строил из этого списка и записывал в базу с пометкой «источник: Federdoc». Список написала модель, когда генерировала код скрапера. Большинство значений верны: Claude действительно знает регламент Бароло. Но ни на одну строку нельзя было дать ссылку, а для бенчмарка знаний моделей это приговор. Если факт взят из памяти [1] модели, то вы измеряете не знания моделей, а эхо.
Таких скраперов, без единого настоящего запроса, оказалось 17. Ещё 8 работали наполовину: шесть мешали списки из памяти модели с настоящим скрапингом, остальные тянули по SPARQL лишнее, складывали в базу неатомарные абзацы или перекашивали домены. С 7 по 11 апреля я перестроил всё:
-
из базы вычищено 12 563 факта, за которыми не стояло ни одного реального HTTP-вызова: 4 702 в первый же день, когда я переписал шесть смешанных скраперов, и ещё 7 861, когда добрался до семнадцати полностью захардкоденных; после второй чистки осталось 16 702;
-
17 скраперов переписаны с нуля на Wikipedia, Wikidata и официальные реестры, 8 починены;
-
три коммита переписывания удалили 31 700 строк и добавили 12 283. Один
europe.pyсжался с 4 846 до 1 010 строк.
После перестройки собралось 38 104 факта, и у каждого есть source_id, указывающий на запись с URL: в базе нет ни одного факта без источника и ни одного источника без ссылки. Первые шесть переписанных скраперов дали примерно на 60 % меньше фактов, чем их «гарантированные» версии, и это правильное число.
|
Источник |
Фактов |
Доля |
|---|---|---|
|
Wikipedia (265 страниц-источников) |
13 083 |
34,3 % |
|
Wikidata (SPARQL) |
11 806 |
31,0 % |
|
Датасеты HuggingFace и Kaggle |
4 739 |
12,4 % |
|
INAO, UC Davis, TTB, журналы, прочее |
8 476 |
22,2 % |
В таблице нет разбивки по странам, а там сидит перекос: 6 176 фактов, 16 % базы, приходятся на Португалию. Причина в Wikidata. Там сотни португальских приходов, freguesias, заведены как винные регионы с указанием площади в гектарах, и SPARQL-запрос честно вытащил их все: «União das Freguesias de Vila Cova e Feitos is a wine region in Barcelos, Portugal», «São Jacinto covers approximately 13.84 hectares». Формально это факты с источником, по смыслу — административная карта Португалии. Дальше это придётся компенсировать в сэмплере.
Урок здесь не про Claude. Захардкоденные данные ничем себя не выдают: это обычные словари, они проходят тесты и попадают в базу с правдоподобной пометкой источника. Если код пишет модель, а результат идёт в исследование, провенанс нужно проверять отдельным шагом; ревью диффов его не заменяет. Я диффы читал. Список из тысячи строк с названием DOCG_DATABASE меня не смутил, потому что выглядел как разумный запасной вариант.
Как абзац из Wikipedia становится фактом
В большинстве скраперов, в 25 из 35, скачанный текст проходит одинаковый путь в _fact_processing.py, и это основное место, где текст источника превращается в то, что лежит в базе:
-
Декомпозиция. Сложное предложение режется по союзам на атомарные; фрагменту, потерявшему подлежащее, оно приписывается обратно. Потолок — 30 слов.
-
Разрешение ссылок. Ведущие «it», «the estate», «he» заменяются на имя сущности из контекста статьи.
-
Классификация домена. Шесть доменов по ключевым словам с приоритетами, чтобы всё не сваливалось в «регионы» по умолчанию.
-
Валидация. Отклоняются факты короче 5 слов, без глагола, с неразрешённым местоимением.
-
Фильтр по теме. Региональные наборы ключевых слов отсекают чужое: австрийские факты в скрапере Бордо появлялись именно так, через транзитивный запрос
P131*в Wikidata.
Один факт в базе выглядит так: «Arlanza is a Spanish Denominación de Origen Protegida (DOP) located in the provinces of Burgos and Palencia, Castile and León, Spain». Одно утверждение, одна сущность, один URL. Если из текста источника нельзя вырезать одно проверяемое предложение, факт не вставляется.
После сборки прошла ещё одна чистка, и она убрала 1 916 фактов из 40 020: 224 почти-дубликата по первым 60 символам, 1 422 пустых «X is a wine region in Y» из португальской ветки Wikidata, 100 обрезанных предложений, 72 факта с местоимением без антецедента (ещё 129 удалось разрешить), 24 длиннее 50 слов и по нескольку десятков маркетинговых штампов и спортивных новостей, попавших в выборку по слову «wine». Факты длиной 31–40 слов получили понижающий коэффициент уверенности 0,8, длиной 41–50 — 0,6. Каждый источник несёт уровень надёжности: первый, официальные реестры, университетские базы и часть Wikidata, дал 19,6 % фактов; второй, Wikipedia, остальная Wikidata и датасеты, — 76,6 %; третий — 3,8 %. Все HTTP-запросы идут с паузой, которая задана для каждого скрапера отдельно, от 1,5 до 10 секунд, чаще всего 5, и с User-Agent, в котором написано, кто мы и зачем.
Генерация: пять стратегий, пять моделей и 99 % брака на входе
Из фактов надо сделать вопросы с вариантами ответа, как правило четырьмя. Чтобы корпус не состоял из вариаций одного промпта, разнообразие я закладывал по двум осям.
Стратегии. Пять генераторов с одним контрактом: на вход факт или несколько фактов и целевая сложность, на выход — pydantic-модель вопроса.
|
Стратегия |
Что делает |
В релизе |
|---|---|---|
|
fact_to_question |
один факт → вопрос с дистракторами |
1 909 |
|
distractor_mining |
ищет «путаемые» сущности (соседняя AOC, родственный сорт) и строит вопрос вокруг них |
405 |
|
template |
48 детерминированных шаблонов без LLM, перефразированных Haiku 4.5 |
389 |
|
scenario_synthesis |
кластер из трёх связанных фактов → прикладной кейс от лица винодела или сомелье |
319 |
|
comparative |
пара фактов, совпадающих по «измерению» (выдержка, урожайность, высота) |
244 |
Модели. Через OpenRouter, с лимитом 35 % на одну модель, чтобы корпус не приобрёл «акцент» одного генератора: Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, Hermes-3 на Llama 3.1 405B и Qwen3 235B. В релизе: Qwen 667 вопросов, Llama 629, Claude 619, GPT 542, Gemini 420, шаблоны 389. Зачем держать в ротации слабые генераторы, станет видно ближе к концу, в разделе про self-preference.
Промпты каждой стратегии несут один и тот же блок, появившийся после третьего пилота аудита. Вот он дословно из _prompts.py:
AVOID WORLD-KNOWLEDGE SOLVABILITY:
- DO lead questions with an OBSERVABLE ATTRIBUTE from the source fact (aging
  months, soil type, yield limit, phenolic threshold, clone name, altitude,
  specific varietal %, regulatory minimum, grape blend percentage) and ask the
  test-taker to infer the entity.
- If the only fact-specific content is a famous entity name with no
  technical/regulatory/attribute detail, output instead:
  {"skip": true, "reason": "Iconic entity without fact-specific technical depth"}
Право ответить «пропускаю» окупилось лучше почти всех остальных правок промптов. До него генератор из факта «Бароло — знаменитое вино Пьемонта» исправно делал вопрос «В каком регионе делают Бароло?», который любая модель решает без всякого источника.
Оркестратор. Работа режется на ячейки «стратегия × домен × генератор»; уровень сложности выбирает сама стратегия. Для каждой ячейки считается квота, сэмплер выбирает факты с весами, обратными доле страны в базе (иначе Португалия с её 16 % фактов заняла бы 16 % вопросов), генератор получает промпт, ответ валидируется схемой, варианты ответа перемешиваются, потому что модели ставят правильный на позицию A заметно чаще остальных, и кандидат сравнивается с уже принятыми по косинусу эмбеддингов в pgvector с порогом 0,92. Всё, что прошло, пишется в базу с полным провенансом: модель, версия промпта, исходные факты.
Три поломки этого слоя, о которых стоит знать заранее. Из 67 ответов, которые на одном из пилотов не удалось разобрать как JSON, 65 пришли от Gemini Pro: он заворачивал JSON в markdown-ограждения вида ```jsonc, которых парсер не ждал. Перефразировщик шаблонов на том же Gemini проваливал каждую вторую попытку, потому что его режим рассуждения съедал бюджет в 300 токенов и в ответе оставалось два символа — { и перевод строки; перефразировку я переехал на Haiku 4.5. И самая тихая: из-за ошибки [2] в распределении квоты 26 из 60 ячеек одного пилота завершились с нулём попыток, а лог при этом честно писал generated=20, потому что печатал бюджет, а не число строк. Я заметил это, только сравнив число строк в базе с числом в логе.
Гейт на «решаемость по памяти». После генерации каждый вопрос уровней L1–L3 отдаётся другой модели без исходного факта. Если она отвечает верно с уверенностью не ниже 0,6, вопрос получает метку closed_book_solvable и принудительно понижается до L1. Модель гейта зависит от уровня: Haiku 4.5 для L1, Sonnet 4.6 для L2, Opus 4.7 для L3. Идея в том, что вопрос второго уровня должен быть не по зубам модели второго уровня. Из четырёх прототипов гейта победил тот, что задаёт вопрос в формате multiple choice: точность 77 %, полнота 94 % против 68 % и 44 % у прототипа, который проверял сам факт.
_GATE_MODEL_DEFAULT_L1 = "anthropic/claude-haiku-4.5"
_GATE_MODEL_DEFAULT_L2 = "anthropic/claude-sonnet-4.6"
_GATE_MODEL_DEFAULT_L3 = "anthropic/claude-opus-4.7"
CONFIDENCE_THRESHOLD = 0.6
CLOSED_BOOK_QUOTA_FRACTION = float(os.environ.get("OENOBENCH_CB_QUOTA", "0.40"))
В итоговом корпусе метку несёт 1 601 вопрос из 3 266, то есть половина. Это много, и ниже будет видно, что она значит для лидерборда.
Верификатор для слабых генераторов. Первая же ручная проверка показала, что Llama и Qwen ставят неверный ключ ответа в 40 % и 29 % случаев, а Claude, GPT и Gemini — в нуле из 31. Для двух слабых генераторов появился шаг, которого нет у сильных: другая модель решает вопрос, видя исходный факт, и при расхождении с ключом вопрос выбрасывается. Работает он выборочно: если гейт уже пропустил вопрос, а генератор оценил свою уверенность не ниже 0,9, проверка пропускается. В сборке релиза так случилось 618 раз.
Сколько кандидатов при этом уходит в брак, показал пилот v8: около 16 000 вызовов LLM, 11,4 часа и 111 принятых вопросов. Примерно 150 вызовов на один вопрос, 99 % брака. После десяти ускоряющих правок, среди которых были уборка time.sleep(1.5) перед каждым вызовом, замена 321 холодного старта подпроцесса на вызовы внутри процесса, кеш решений в Postgres и предохранитель на ячейках, где все попытки проваливаются, пилот v9 дал 46 вопросов за 772 вызова и 18 минут. На последнем пилоте вышло $0,034 за принятый вопрос, а основная сборка корпуса, release_v1 на 2 650 вопросов, обошлась примерно в $160. Ещё 1 062 вопроса в релизный пул пришли из более раннего, отдельно собранного набора.
Здесь же стало ясно, что 5 000 вопросов не будет. Генератор упёрся в базу фактов: у трёх стратегий из пяти сэмплер исчерпал содержательные факты задолго до квоты, две другие упёрлись в лимит проходов, а по виноделию, где химия ферментации лежит в платных журналах, а не в Wikidata, вышло всего 187 вопросов. Я остановился на том, что база позволяла.
Аудит: десять агентов в четырёх командах
Сгенерированные вопросы — сырьё. Чтобы понять, сколько в нём брака и какого, я построил отдельный контур в src/qa/: десять агентов, каждый проверяет одну рубрику и выдаёт pass, warn или fail.
Команда A, статика, без LLM. A1 LexicalHygiene — регулярки на маркетинговые штампы («prestigious», «renowned») и «воду». A2 BiasStats — χ² на позицию правильного ответа и тест Манна–Уитни на длину вариантов. A3 FactEcho — наибольшая общая подпоследовательность между вопросом и исходным фактом, fail при коэффициенте от 0,65 или общей n-грамме от 8 слов. A4 TemplateFingerprint — логистическая регрессия на биграммах частей речи, ловит «слишком шаблонное» звучание.
Команда B, панель судей. B1 TriJudgeAnswer — Claude, GPT-5.4 и Gemini 3.1 Pro отвечают на вопрос, видя источник, но не видя ключа; fail, если большинство расходится с ключом. B2 ClosedBookSolvability — четыре судьи отвечают без источника.
# Three high-capability judges for B1 / D1 — intentionally excludes Llama/Qwen
JUDGE_PANEL = ("claude", "chatgpt", "gemini")
JUDGE_PANEL_B2 = ("claude", "gemini", "llama", "qwen")
Llama и Qwen исключены из B1 не случайно: они же генерируют часть вопросов, и судья не должен оценивать собственную работу. В B2 они, наоборот, добавлены как якорь калибровки: Opus и Gemini знают про вино слишком много, чтобы отвечать за среднего сдающего.
Команда C. C2 CategoryLeak ловит вопрос про красное вино с белыми сортами в дистракторах. C4 DifficultyAudit просит Gemini переоценить сложность; fail при расхождении в два уровня.
Команда D, статистика по корпусу. D1 SelfPreference строит матрицу 5 × 5 «кто генерировал × кто отвечает». D3 SkewAudit — χ² по странам: на первом пилоте одна страна была представлена в 4,46 раза выше своей доли в базе фактов.
Первый пилот аудита на 472 вопросах стоил $8,49 против моей оценки в $130–175 и заблокировал генерацию: 36 % вопросов дословно копировали источник, 28 % решались без него. Дальше были четырнадцать пилотов за две недели, каждый с правкой промптов, порогов и сэмплера.
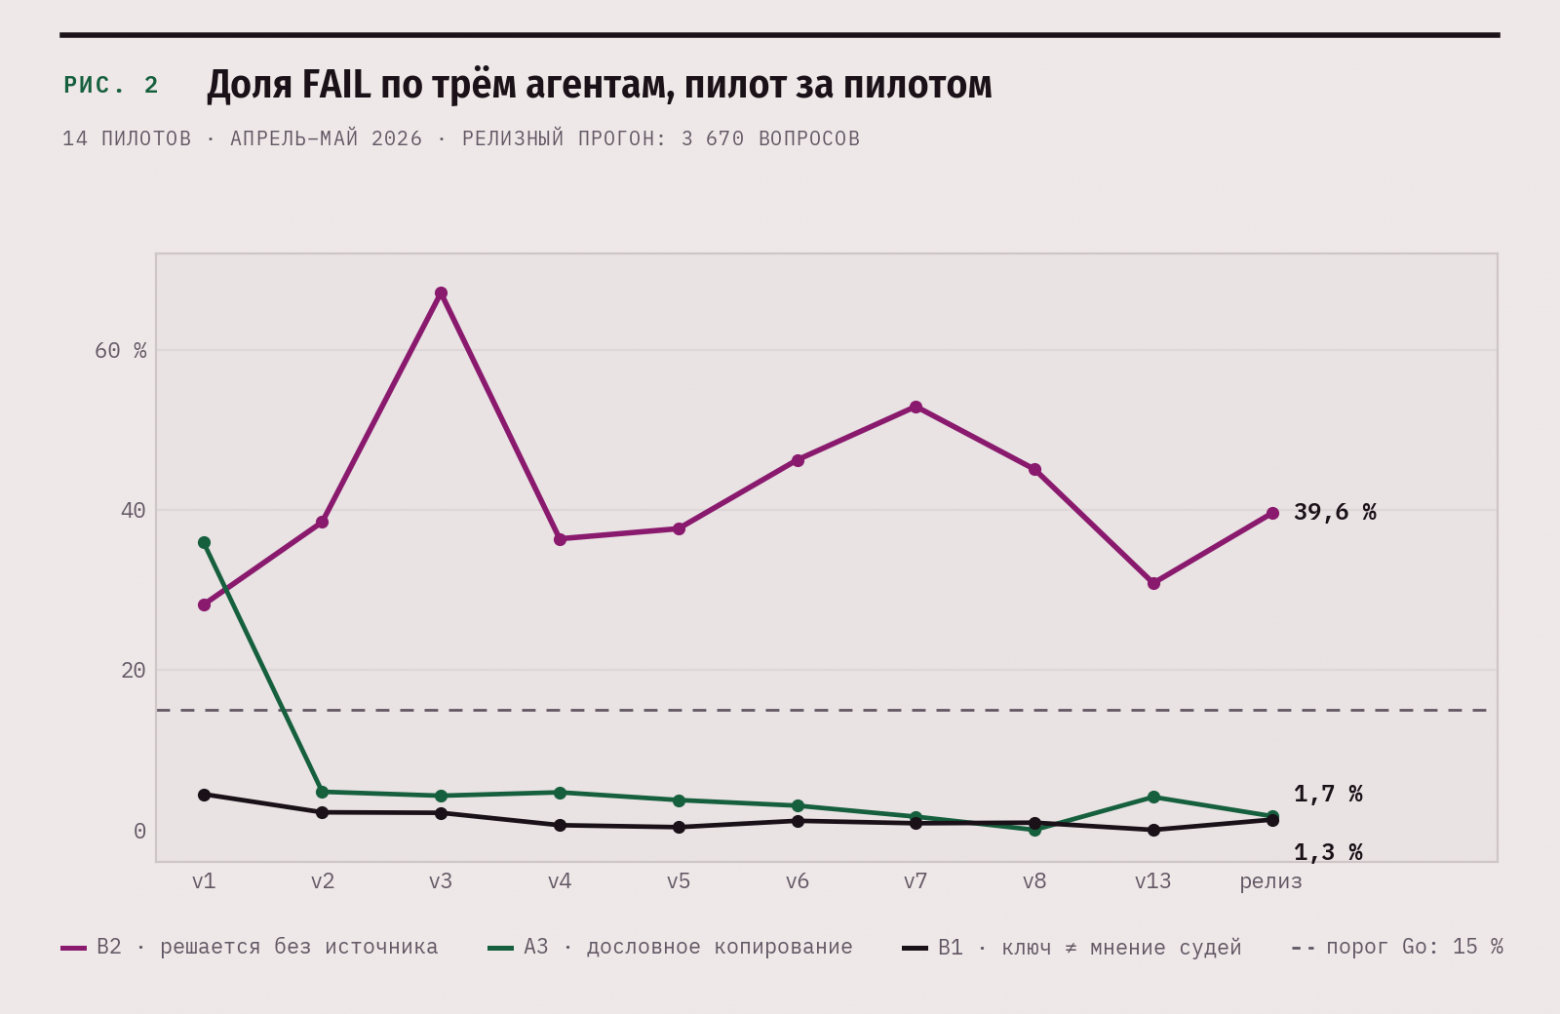
Две линии на графике сходятся к нулю, третья нет. Копирование источника лечится инструкцией «перефразируй» и пост-фильтром на LCS: 36 % → 1,7 %. Неверный ключ лечится верификатором: 4,5 % → 1,3 %. А вот «решается без источника» не упало вовсе: 28 % на первом пилоте, от 31 до 67 % на следующих, 40 % на релизе при пороге Go в 15 %. Ниже я объясню, почему в итоге перестал верить этому агенту, а не корпусу.
Релизный аудит на 3 670 вопросах занял 5 часов 22 минуты, 29 610 вызовов, $75,79. Команда B и C4 идут в восемь потоков; последовательно это было бы около 31 часа.
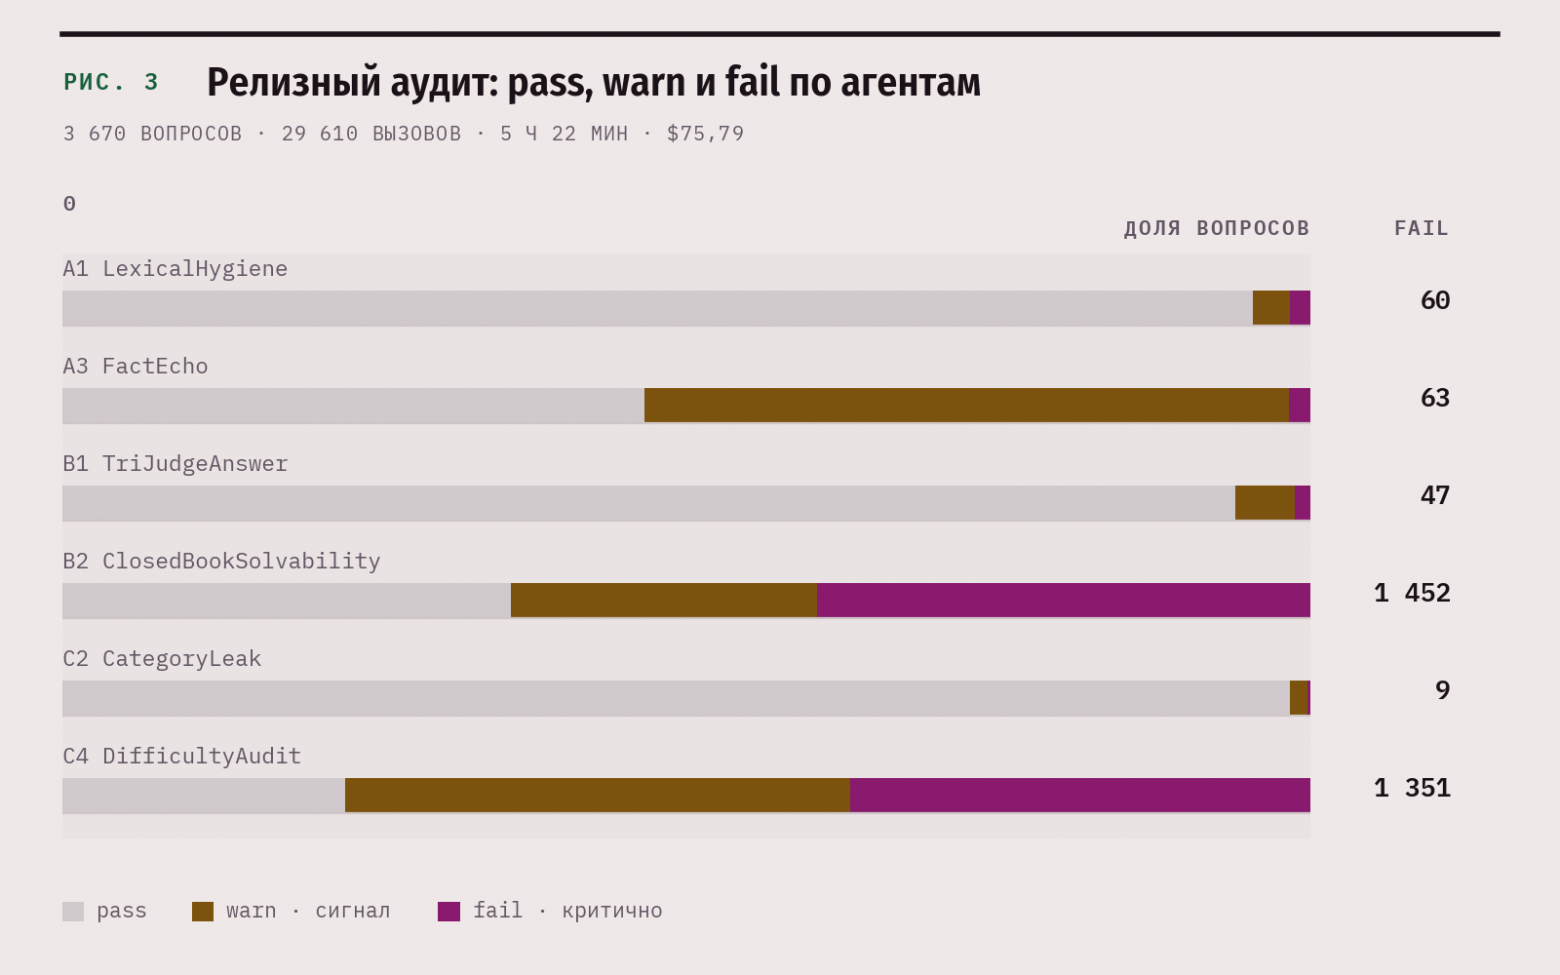
Число за каждой полоской воспроизводится одним запросом к базе:
SELECT agent_id, severity, count(*)
FROM audit_findings
WHERE run_id = '2ba38269-5e66-44aa-aaaf-010dc7ef19d4'
GROUP BY 1, 2
ORDER BY 1, 2;
По итогам аудита выброшен 341 вопрос с fail у A1, A3, B1, C2 и ещё одной поздней, одиннадцатой статической проверки B3 на «вездесущие» сорта: у вопроса «в каком регионе выращивают Каберне Совиньон» полсотни верных ответов. Ещё 1 259 вопросов переразмечены по сложности вслед за C4: доля уровней L3 и L4 выросла с 14 % до 51 %. После разбора вопросов, на которые не ответила ни одна модель, и ручной проверки пограничных случаев осталось 3 266.
Вот как выглядит один настоящий fail от B1, тот случай, когда судьи заметили то, что упустил генератор:
{
  "question": "Which Italian region has only 1 DOCG appellation?",
  "options": ["Emilia-Romagna", "Piedmont", "Sardinia", "Trentino-Alto Adige"],
  "claimed_key": "C",
  "majority_choice": "D",
  "open_book_choices": [
    {"judge": "claude",  "chosen": "D",
     "rationale": "Source fact [5] explicitly states Trentino-Alto Adige has 1 DOCG appellation, though Sardinia (fact [6]) also has 1 DOCG, making both C and D technically correct."},
    {"judge": "chatgpt", "chosen": "C",
     "rationale": "The source fact shows both Sardinia and Trentino-Alto Adige have 1 DOCG, so among the options there is not a unique single best answer."},
    {"judge": "gemini",  "chosen": null}
  ],
  "majority_matches_key": false
}
Два верных ответа в одном вопросе. Оба судьи это увидели, оба написали об этом в обосновании, и вопрос ушёл в дроп. Так это и должно работать. Следующий раздел про то, как часто не сработало.
Судьи ошибаются вместе
Если судьи тоже модели, почему им верить? Я и не верил, я их калибровал. Для этого я размечал стратифицированные выборки по восьми рубрикам, сначала в таблицах, позже в отдельном Flask-приложении с карточками вопросов, и считал κ Коэна между вердиктом судей и своим.
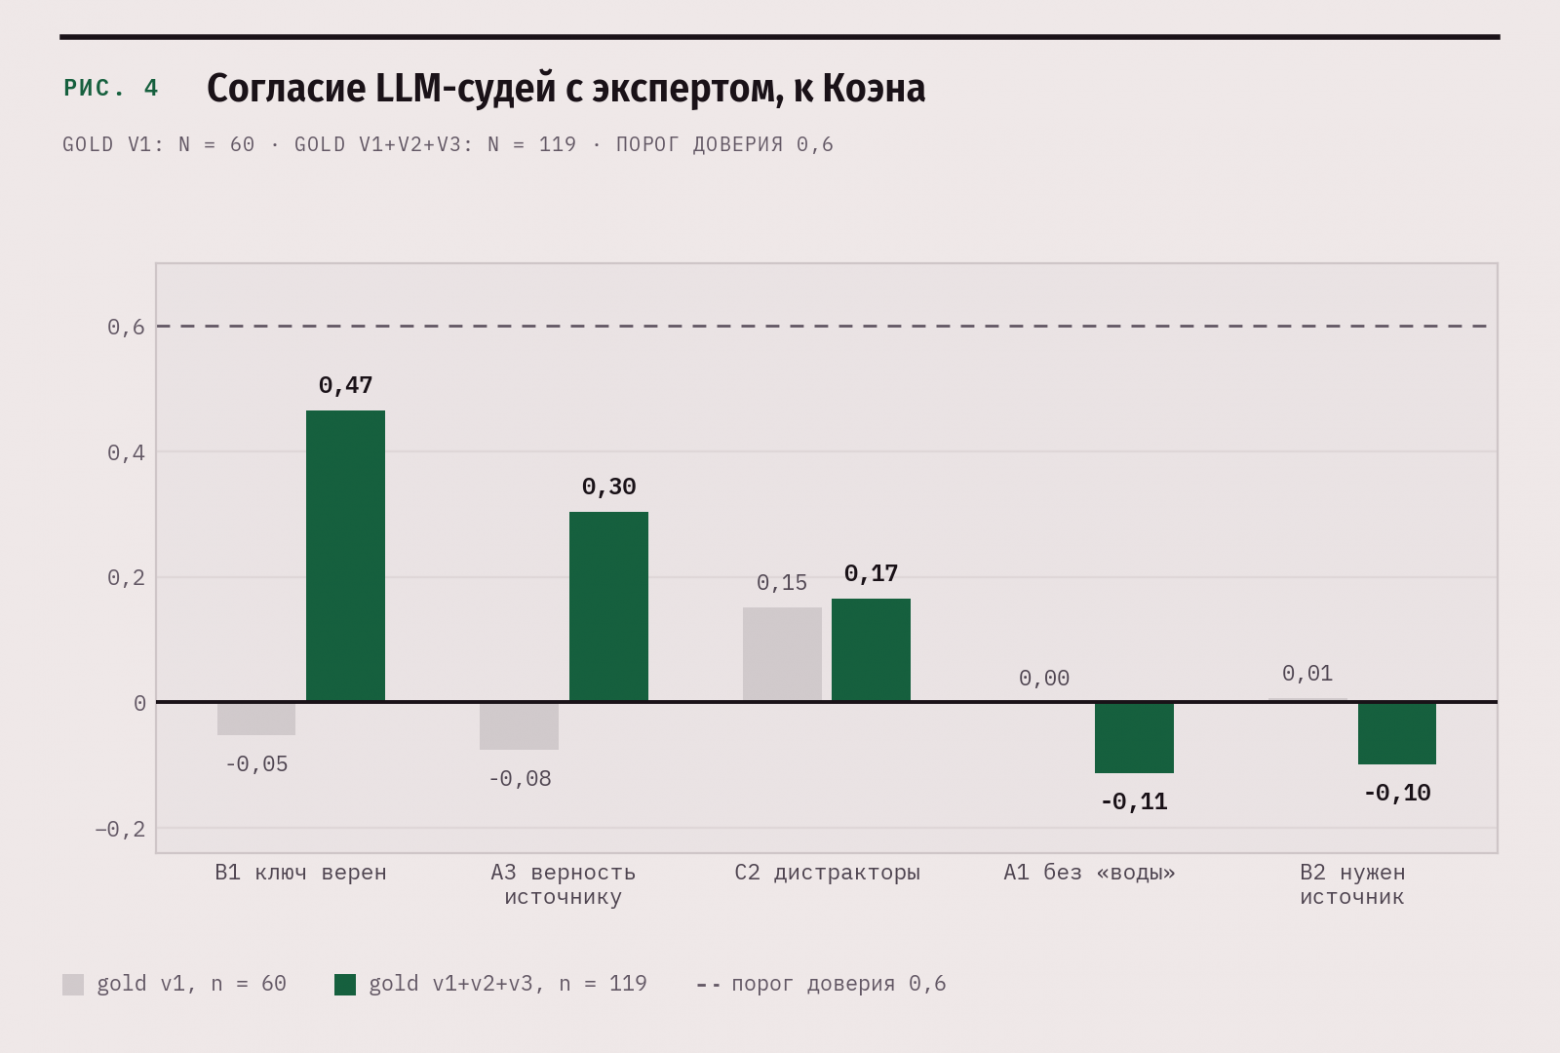
Ни одна рубрика не дошла до порога 0,6, при котором сигналу судей можно доверять без человека. Два провала важнее остальных.
B1 на первой выборке: κ = −0,05. Из 60 вопросов я нашёл шесть с неверным ключом. У всех шести панель B1 стояла majority_matches_key = True. Все шесть были сгенерированы Llama или Qwen. Механизм понятен, когда смотришь на обоснования: генератор написал вопрос с кривой посылкой, и три судьи, рассуждая от той же кривой посылки, сошлись на том же неверном ответе. Три модели трёх компаний согласились друг с другом во всех шести случаях и все шесть раз ошиблись. Пока судьи читают один и тот же дефектный текст, их число ничего не меняет, и четвёртый судья здесь не помог бы. Помог фильтр раньше по конвейеру: верификатор на этапе генерации, который для вопросов от Llama и Qwen перерешивает задачу и выбрасывает вопрос при расхождении с ключом, не дожидаясь голосования. После его появления κ по B1 на объединённых 119 строках выросла до 0,47.
B2: κ = 0,01, потом −0,10. Здесь расхождение в другую сторону. Судьи говорили, что 83 % вопросов решаются без источника. Я говорил, что 12 %. Судьями B2 на той первой выборке были Opus 4.7, GPT-5.4 и Gemini 3.1 Pro (Llama и Qwen добавились в панель позже, как раз после этого разбора), и они знают про вино несравнимо больше, чем человек, сдающий на диплом WSET. Агент измерял не утечку в претрейн, а разрыв между фронтирной моделью и экспертом-человеком, и порог в 15 % для такого измерения не имел смысла. Поэтому fail от B2 перестал быть основанием для дропа. Метку closed_book_solvable ставит гейт на этапе генерации, в релизе она стоит у 1 601 вопроса, а решать, вычитать ли их при сравнении моделей, я оставил пользователю датасета.
16 моделей, 52 256 ответов, два часа
Эвал устроен просто: вопрос, варианты ответа, модель отвечает одной буквой. Шестнадцать конфигураций через OpenRouter, все параллельно, 120 минут. Прогон шёл по 3 329 вопросам; 63 из них после разбора выпали, об этом ниже, и все числа этого раздела пересчитаны по оставшимся 3 266: 52 256 ответов, $98,33. Двенадцать конфигураций в обычном режиме и четыре в режиме с рассуждением, хотя граница между ними, как выяснилось, условная. Одна техническая деталь: max_tokens пришлось поднимать с 5 до 2 000, потому что у OpenAI есть нижняя планка, а у reasoning-моделей скрытые токены рассуждения съедают лимит до первой буквы ответа.
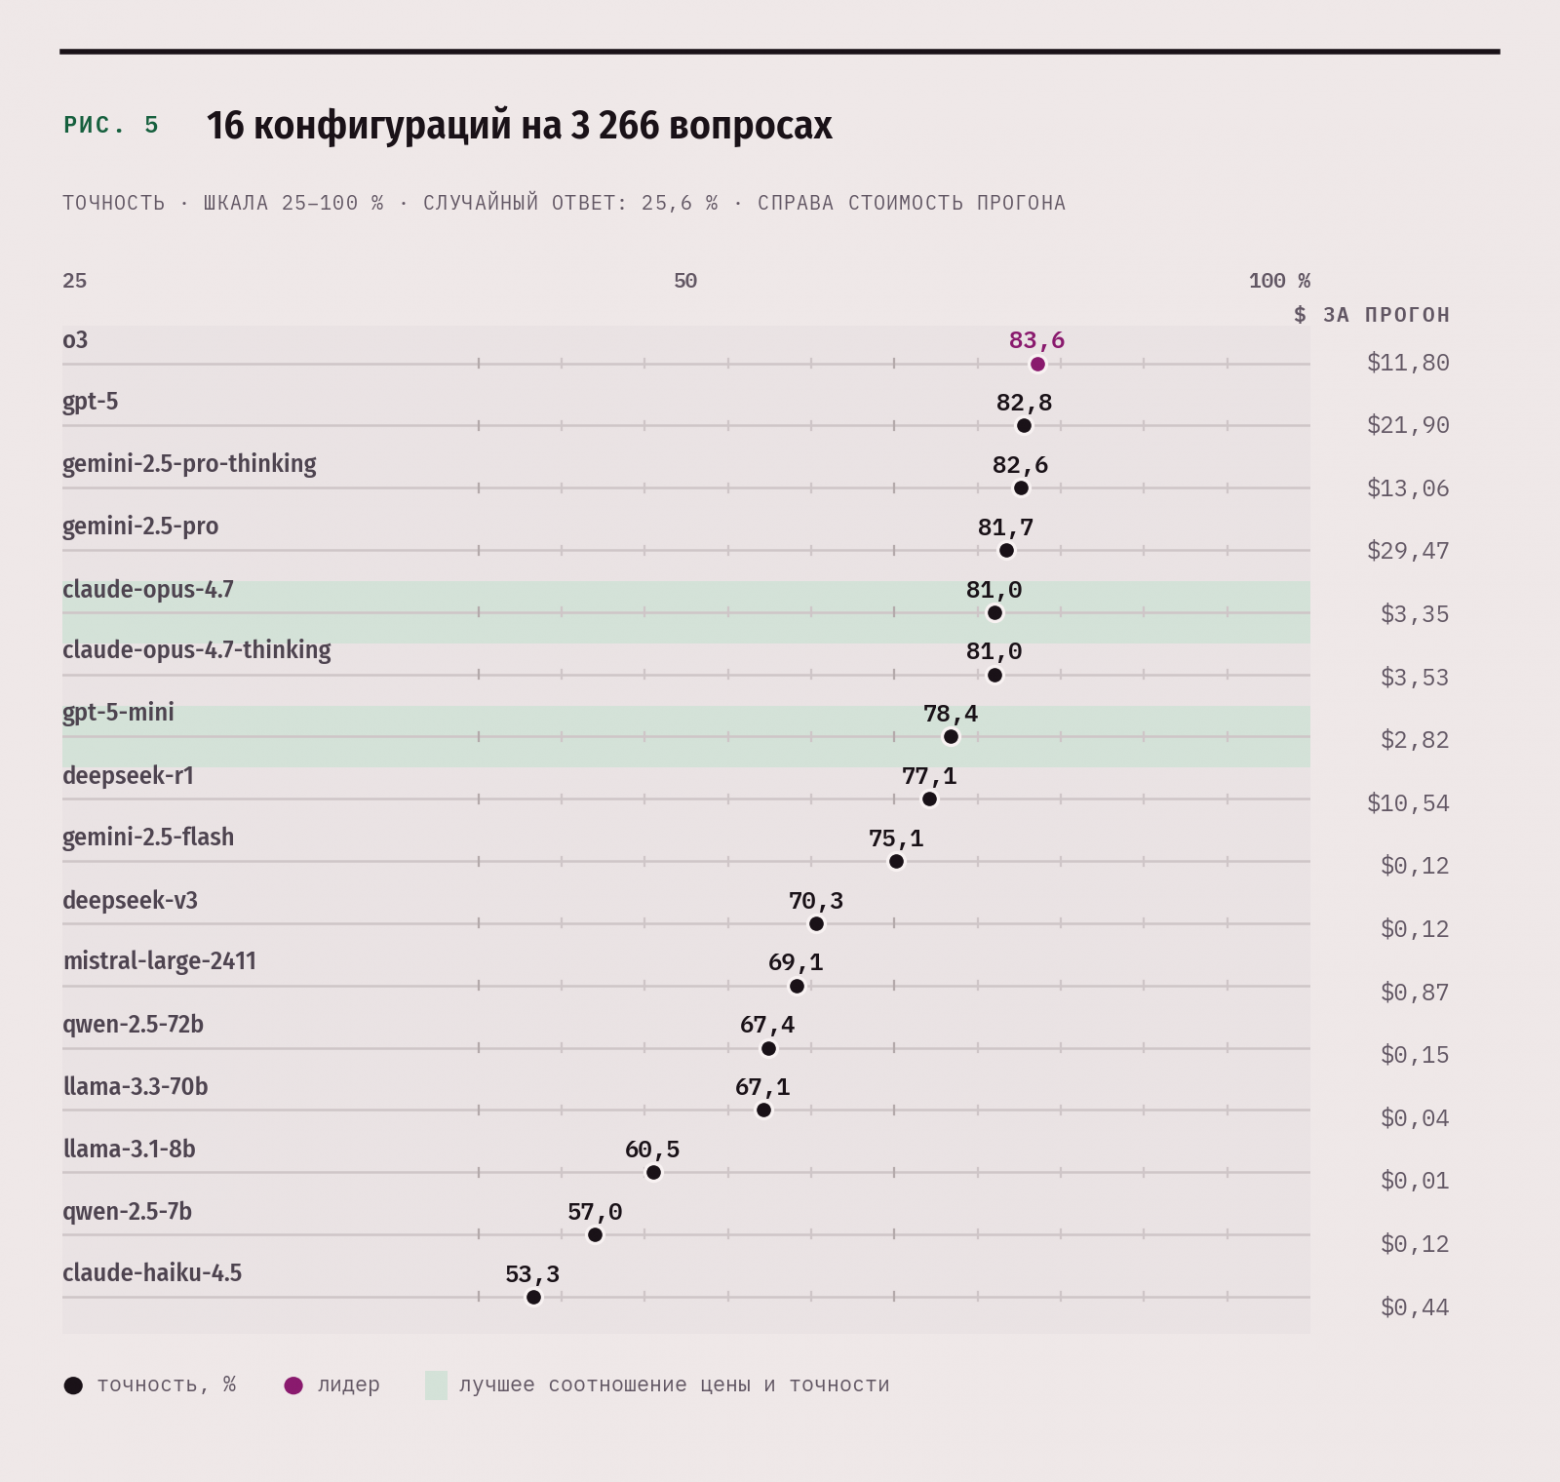
Верх таблицы плотный: o3, GPT-5, Gemini 2.5 Pro и Opus 4.7 в пределах 2,6 п. п. Внизу Haiku 4.5, и это артефакт: 19,7 % её ответов не удалось распарсить в букву, и они засчитаны как ошибки. Несколько результатов, которых я не ждал.
Про режим рассуждения честное сравнение получилось одно. У Opus 4.7 бюджет рассуждения был 512 токенов, и режим фактически не включился: на весь прогон 23 тыс. выходных токенов против 16 тыс. у обычного Opus при той же задержке, отсюда и −0,1 п. п. Gemini 2.5 Pro и GPT-5 рассуждают и в «обычном» режиме, так что пары Gemini (+0,9 [−1,0; +2,8]) и o3 против GPT-5 (+0,8 [−1,0; +2,6]) сравнивают разные бюджеты рассуждения, а не его наличие. Единственная пара, где рассуждение действительно выключено и включено, — DeepSeek-V3 и R1: +6,8 п. п. [+4,6; +8,8]. Дополнительный бюджет модели, которая и так рассуждает, на этом корпусе ничего измеримого не дал.
Самый дешёвый способ получить 81 %. Opus 4.7 без рассуждения: $3,35 за весь корпус против $29,47 у Gemini 2.5 Pro при разнице в 0,7 п. п. GPT-5-mini за $2,82 даёт 78,4 % и при этом лучше всех шестнадцати конфигураций на самом трудном домене, винном бизнесе: 66,3 % против 65,4 % у o3 за $11,80. Домен про регуляторику, акцизы и торговлю оказался самым тяжёлым для всех: среднее по 16 моделям 56,5 %.
Тот же лидерборд, разрезанный по метке closed-book.
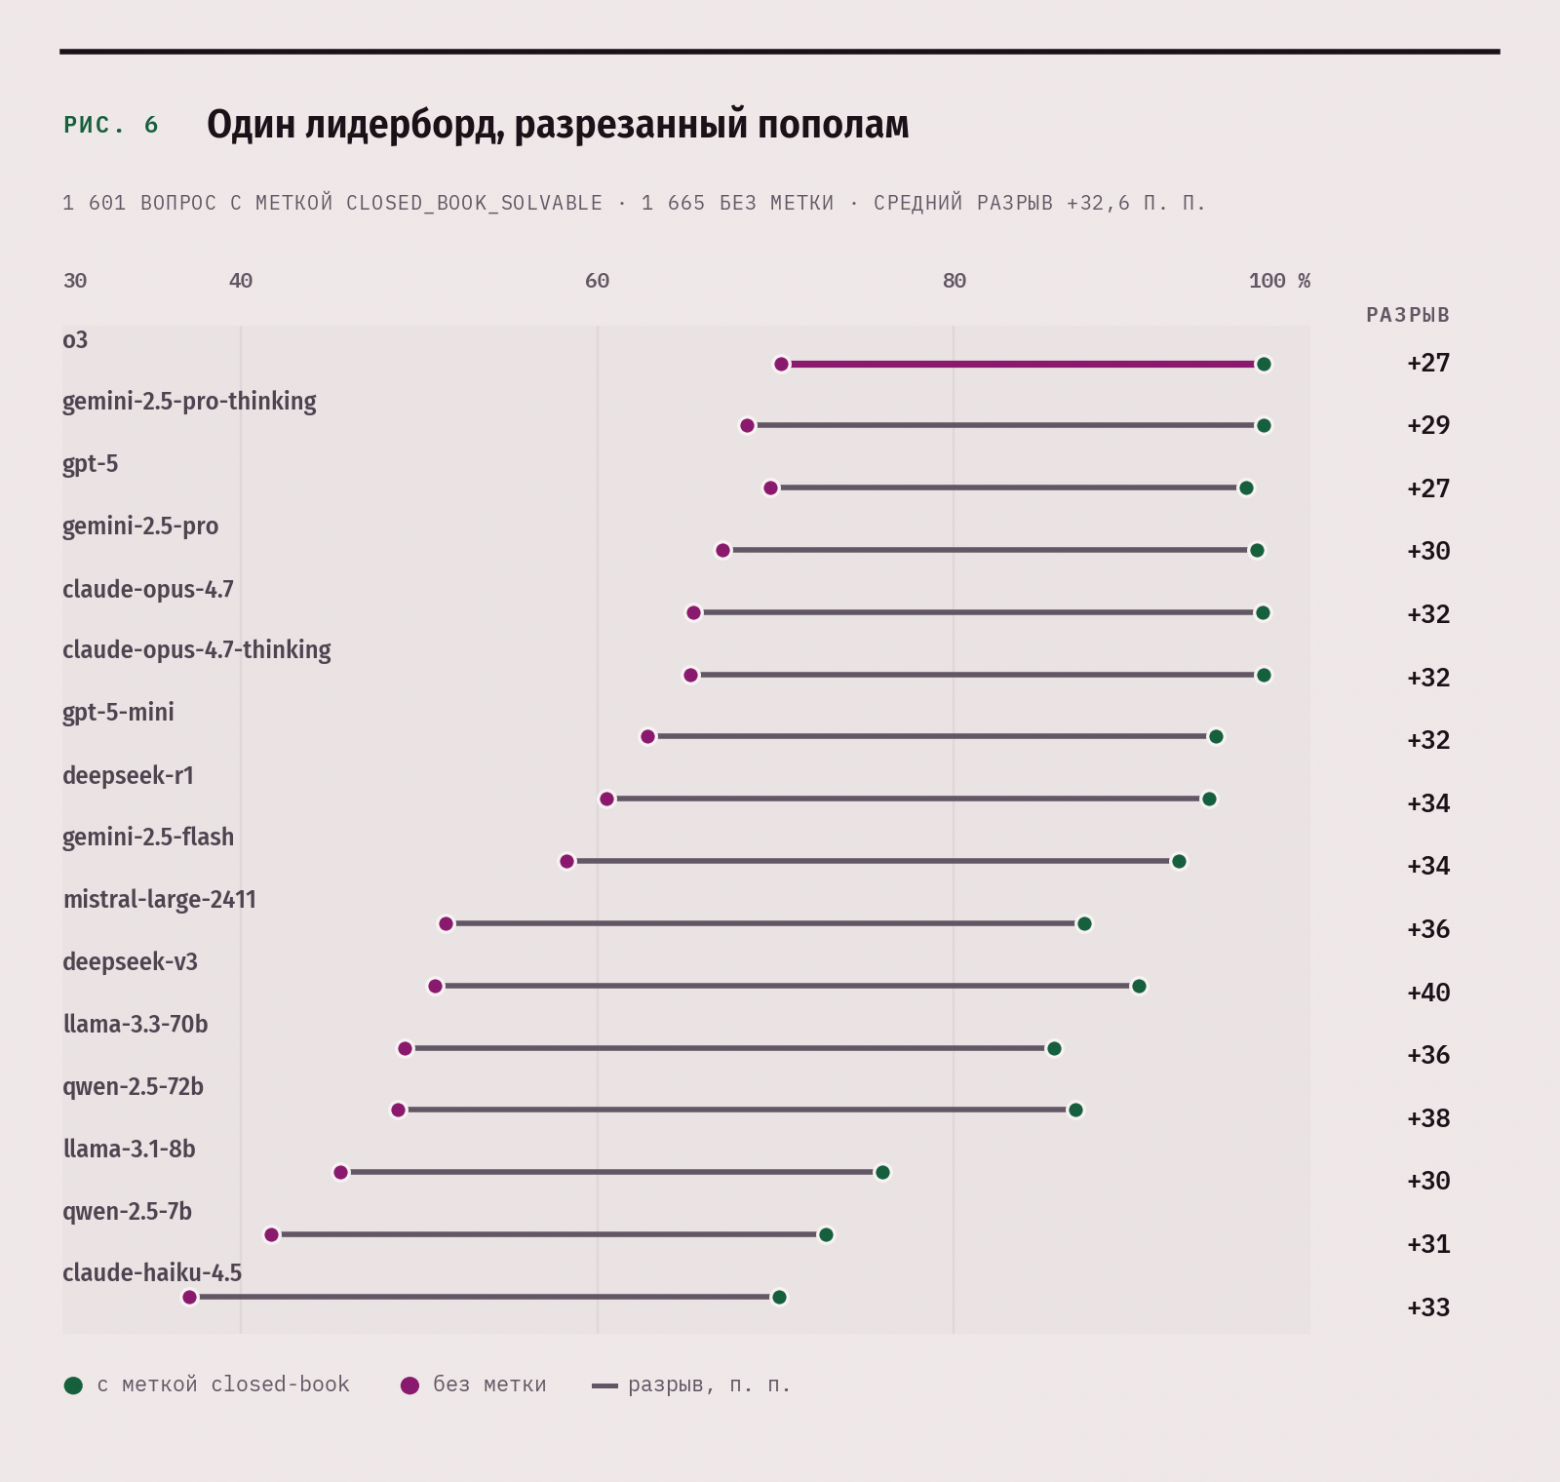
На 1 601 вопросе, которые гейт пометил как решаемые по памяти, фронтирные модели дают 96–97 %. На остальных 1 665 — от 65 до 70 %. Средний разрыв +32,6 п. п., и знак у него один на все шестнадцать конфигураций: от +26,6 у GPT-5 до +39,6 у DeepSeek-V3. Та же проверка на решаемость по памяти, которая в аудите дала отрицательную κ с моей разметкой, на этапе генерации предсказала, где споткнутся шестнадцать моделей. С экспертом она расходится, с моделями сходится, и противоречия тут нет: она мерит, что знают модели, а я размечал, что должен знать человек.
Ещё одно, чего я не ожидал: аудит почти не изменил лидерборд. Уже после сабмита я прогнал на 341 выброшенном вопросе те же модели, кроме Mistral, который к тому времени пропал из OpenRouter. Точность на них 64,1 % против 73,3 % на релизе, а лидерборд без аудита совпал бы с реальным с ρ Спирмена 0,996. Аудит нужен для честности отдельных вопросов, а не для ранжирования моделей: ранжирование устойчиво к девяти процентам мусора.
Self-preference, и где он отрицательный
Разрез лидерборда по семье генератора отвечает на вопрос, ради которого я и держал пять генераторов: легче ли модели отвечать на вопросы, написанные её «родственником»?
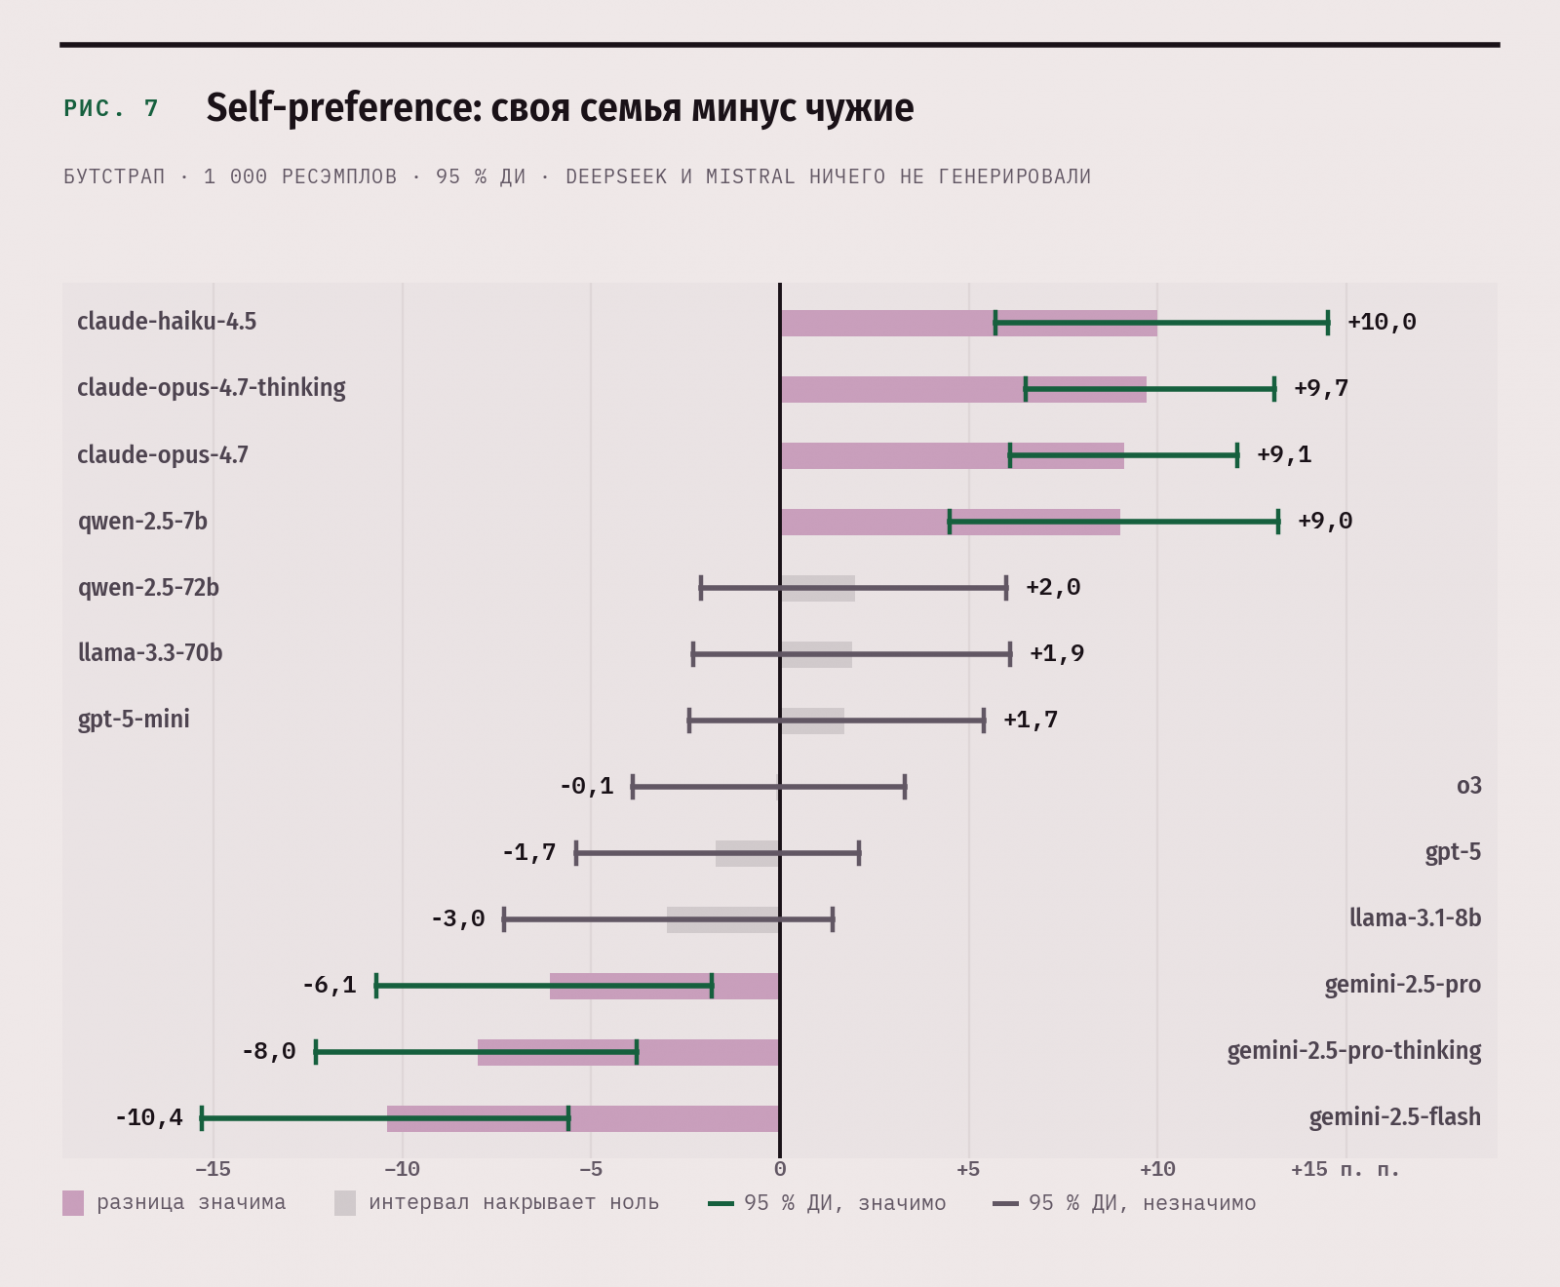
У Anthropic эффект такой, каким его обычно описывают: Opus и Haiku отвечают на вопросы от Claude на 9–10 п. п. лучше, чем на чужие, и интервалы далеко от нуля. У OpenAI и Meta — ноль. А у Google эффект отрицательный: Gemini Flash решает вопросы от Gemini Pro на 10,4 п. п. хуже, чем чужие, Gemini Pro — на 6,1 хуже, а генерировал их его же старший родственник, Gemini 3.1 Pro. Разумная гипотеза: Gemini как генератор тянется к редким деталям, которые Gemini как решатель потом не вытягивает, а Claude-генератор остаётся в зоне паттернов, которые Claude-решатель узнаёт. Проверить это я не могу; после стратификации по сложности и метке closed-book эффект Anthropic сжимается примерно до +3 п. п., так что часть его — состав вопросов, а не стиль.
Практический вывод не зависит от объяснения: если вы генерируете бенчмарк одной моделью и ей же меряете, вы либо завысите её на десять пунктов, либо занизите. Заранее не известно, что именно.
Что эвал рассказал про сам корпус
После прогона я вытащил 97 вопросов, на которые не ответила ни одна из 16 моделей, и разобрал каждый вручную.
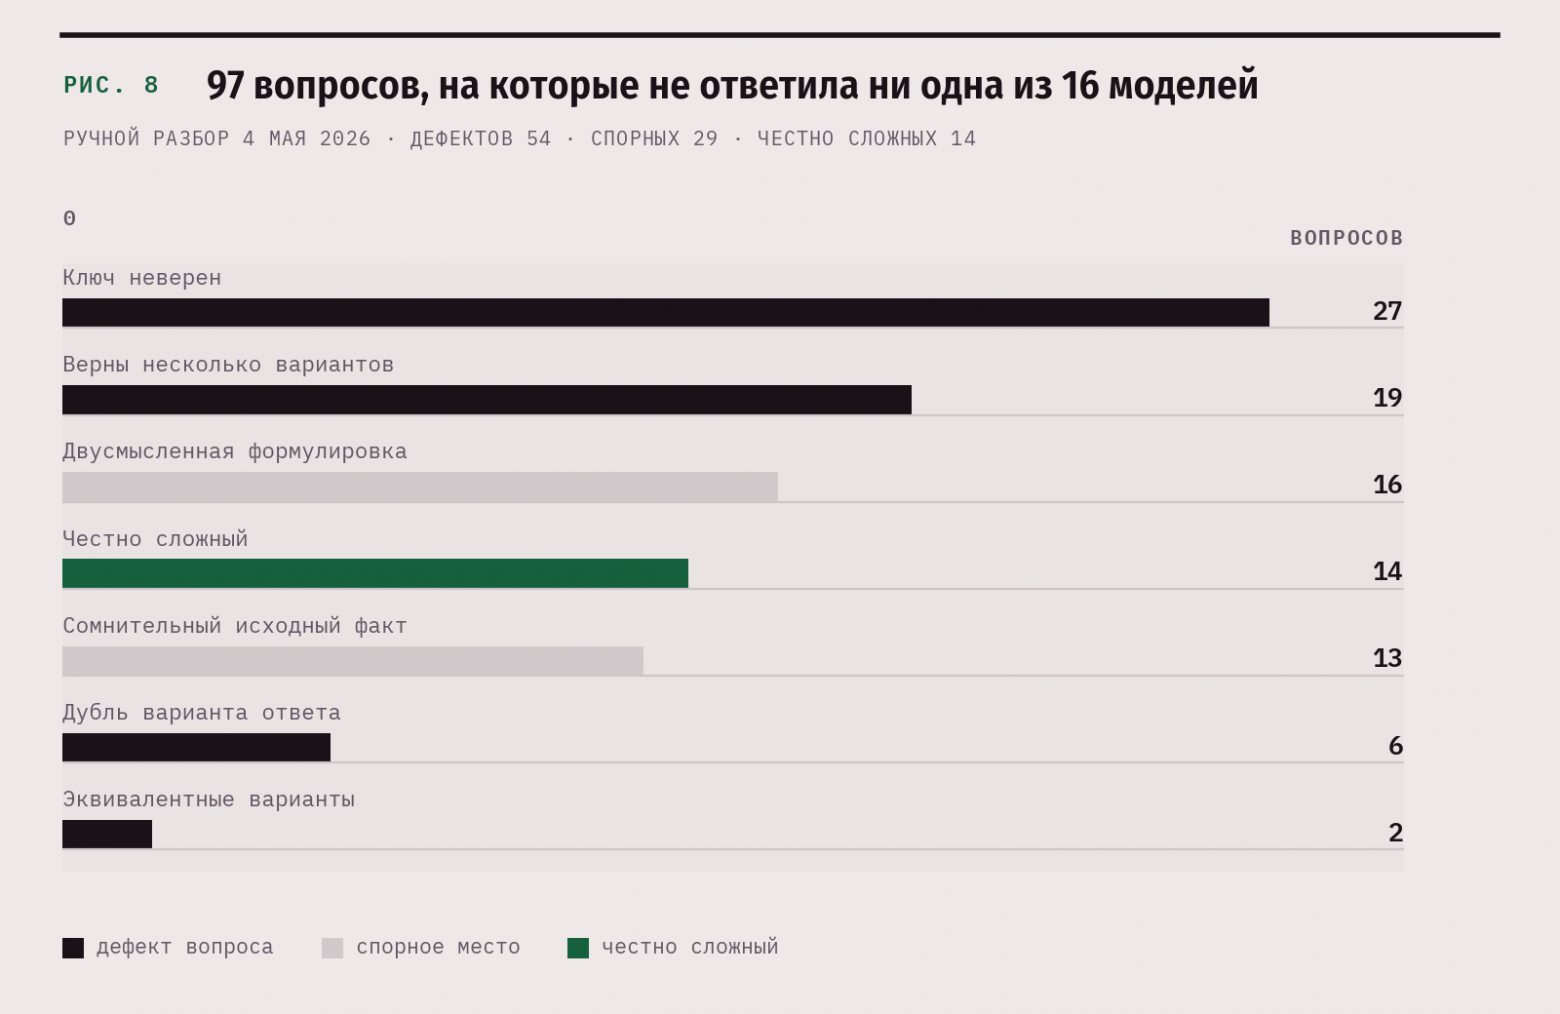
Честно сложных — 14. Остальные 83 — либо дефект, либо спорное место: у 27 неверен ключ, у 19 верны сразу несколько вариантов, у 16 двусмысленная формулировка. Шесть вопросов имели два одинаковых варианта ответа и ключ вида A,D: их породил один генератор, и ни один агент аудита не проверял уникальность вариантов, потому что мне не пришло в голову, что это нужно проверять. 54 вопроса из 97 ушли в дроп сразу, ещё 9 снял ручной разбор 29 спорных; так 3 329 вопросов стали 3 266, а из этих 97 в релизе осталось 34.
С тех пор я исхожу из того, что хвост «самых сложных» вопросов в сгенерированном бенчмарке по построению обогащён дефектами. Если модель не может ответить на вопрос, первое объяснение — вопрос, а не модель. Срез «самые трудные» нельзя публиковать как отдельный бенчмарк без повторного ручного прохода.
Второй разбор я сделал уже после сабмита, чтобы проверить собственный тезис: что вопросы без метки closed-book требуют рассуждения, а не только знаний. Проверка простая. Если сложность в недостатке знаний, то модель, которой положили в промпт исходный факт, ответит верно; если в рассуждении, то не обязательно. Я взял 500 вопросов, положил GPT-5 в контекст факты, из которых каждый вопрос был написан, и переспросил.
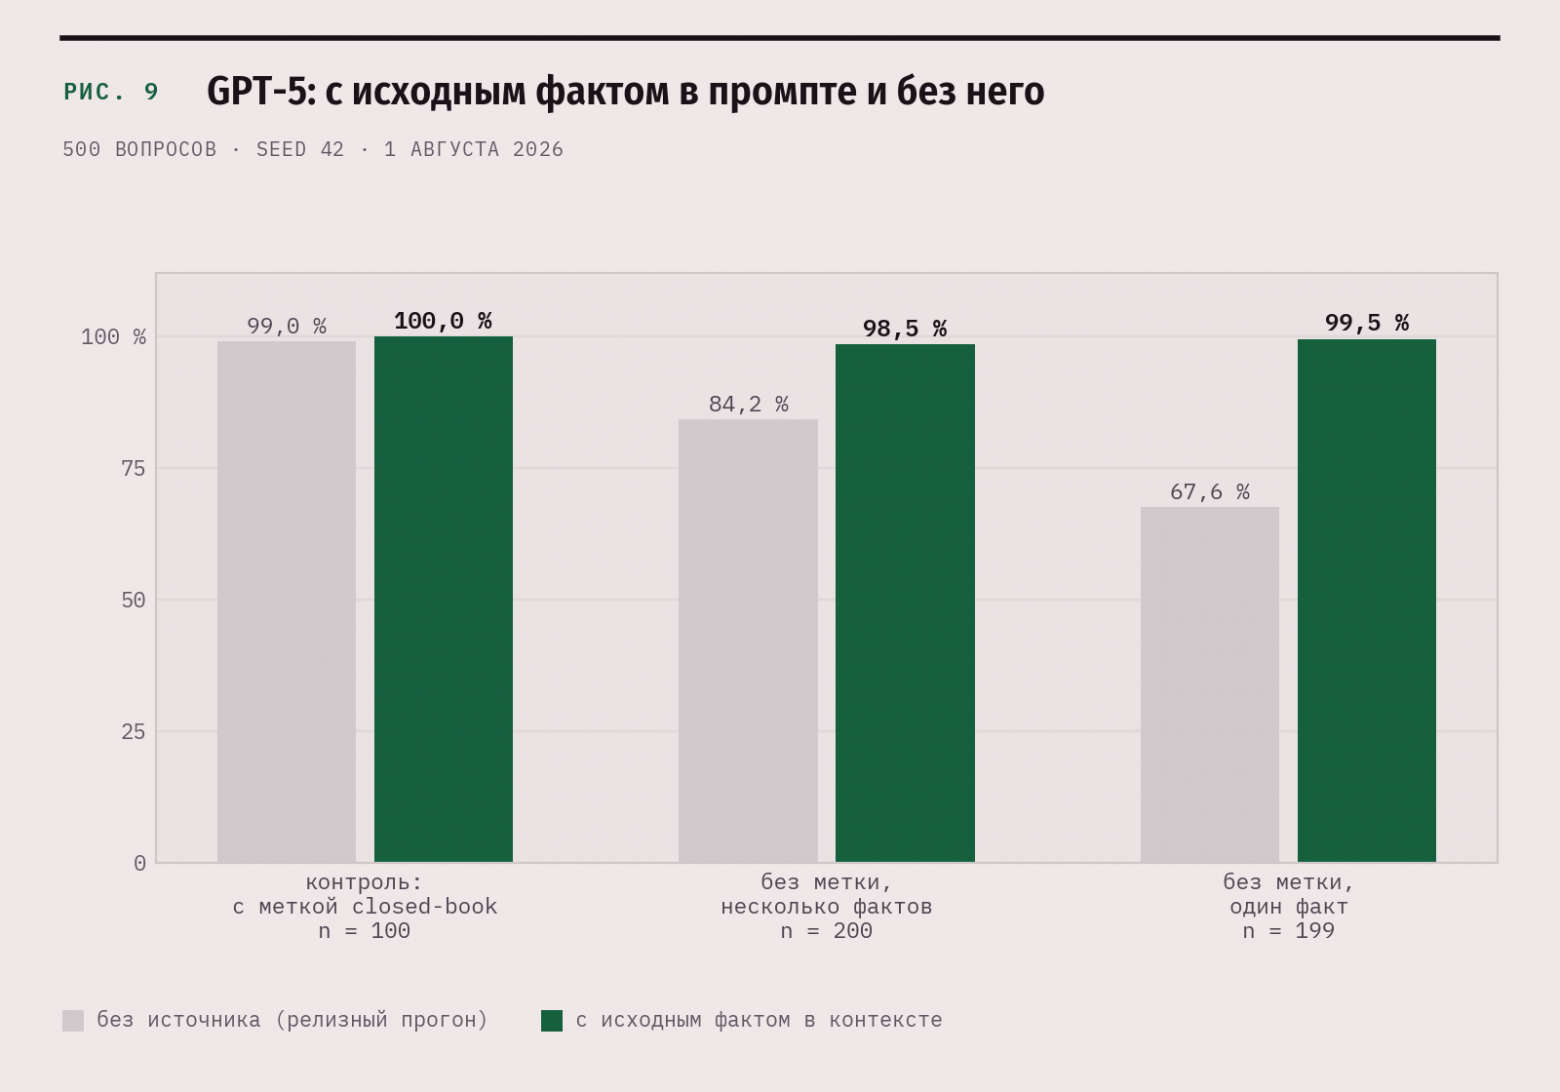
На однофактных вопросах без метки closed-book точность выросла с 67,6 % до 99,5 %. На многофактных, где по идее нужна композиция, — с 84,2 % до 98,5 %. Тезис не выдержал: корпус измеряет доступность знаний, не рассуждение. Четыре оставшиеся ошибки я посмотрел руками, и все четыре оказались дефектами вопросов: у одного исходный факт был «In Serbia it is the most planted grape variety by total area» без антецедента у «it», у другого стем подходил под три DOCG сразу. Побочный результат оказался важнее основного. «Модель не может выбрать ключ, глядя на исходное предложение» — это дешёвый и точный детектор дефектов: 4 срабатывания из 4 оказались настоящими, а стоило это чуть больше доллара на 500 вопросов. Он должен был стоять в конвейере с самого начала вместо половины команды B.
Сколько это стоило
|
Статья |
Сумма |
Откуда число |
|---|---|---|
|
Сборка release_v1, 2 650 вопросов |
~$160 |
статус проекта на 3 мая |
|
Релизный аудит, 29 610 вызовов |
$75,79 |
таблица |
|
15 пилотных прогонов аудита |
$44,27 |
сумма по |
|
Эвал 16 конфигураций |
$98,33 |
отчёт OpenRouter |
|
Пробный эвал на 1 062 вопросах |
$33,03 |
отчёт эвала |
|
Прогоны после сабмита: oracle-эвал, абляции |
~$14 |
три отдельных прогона |
|
Пилоты генерации, прототипы гейта, отладка |
остаток |
не разнесено по статьям |
|
Итого OpenRouter за проект |
~$797 |
$783 по аккаунту на день сабмита плюс ~$14 после |
Первые шесть строк измерены; седьмая — разность, и в ней сидит всё, что не попало в отчёты: пилоты генерации, отдельная сборка тех 1 062 вопросов, четыре прототипа гейта по $0,16–0,61, отладочные прогоны. Инфраструктура, одна VM с Postgres, Elasticsearch, Neo4j и Redis в Docker, в счёт не входит, как и подписка на Claude Code, которая обслуживала не только этот проект. Время: семь месяцев по вечерам, больше 420 коммитов.
Что забрать, если вы не про вино
Вино здесь можно заменить на любую другую предметную область, конвейер от этого не изменится. Вот что я сделал бы иначе, если бы начинал снова.
Право ничего не сгенерировать я дал бы генератору с первого дня. Строка в промпте «если в факте нет ничего, кроме знаменитого имени, верни skip» убрала больше пустых вопросов, чем любой агент аудита после неё. Пока её не было, генератор из любого факта делал какой-нибудь вопрос, и каждый такой вопрос приходилось потом ловить уже за деньги.
Судей я бы с самого начала не считал независимыми только потому, что они от разных компаний. Три модели, которые читают один и тот же кривой вопрос, дружно сходятся на одном и том же неверном ответе, и число судей здесь ничего не меняет. Сработал фильтр раньше по конвейеру: верификатор, который выбрасывает вопрос при расхождении с ключом, не дожидаясь голосования. Правда, в сборке релиза он пропускал вопросы, в которых генератор был уверен, — 618 раз, так что включать его стоит на каждый вопрос.
Детектор дефектов я бы поставил в конвейер сразу, а не после сабмита. Модели показывают предложение, из которого написан вопрос, и просят ответить. Если она и с подсказкой не выбирает ключ, чинить надо вопрос. На 500 вопросов это стоило чуть больше доллара, и все четыре срабатывания оказались настоящими дефектами.
Провенанс я бы проверял отдельным проходом, потому что на ревью кода он не ловится: словарь, который модель написала по памяти, в диффе выглядит так же, как словарь, который она скачала. Теперь у каждого факта в базе есть ссылка на источник, и я проверяю это запросом, а не верой в код.
Мерить моделью вопросы, которые она же и написала, я бы не стал. Разница набегает около десяти пунктов, и в какую сторону, заранее не скажешь. И срез «самых трудных вопросов» я бы не публиковал без ручного прохода. В сгенерированном бенчмарке этот хвост состоит в первую очередь из сломанных вопросов, я убедился в этом на 97 своих.
Датасет со всеми 3 266 вопросами, ссылками на исходные факты и URL источников лежит на HuggingFace, код на GitHub; ссылки ниже. Если найдёте вопрос с неверным ключом, напишите в комментариях его идентификатор: я проверю и обновлю датасет с пометкой о правке.
Ссылки и источники
-
Код: github.com/nikitahudov/oenobench [3]
-
Датасет: huggingface.co/datasets/nikitahudov/oenobench-v1 [4]
-
Препринт: arxiv.org/abs/2608.20106 [5]
-
Wikidata SPARQL: query.wikidata.org [6]
-
Реестр AVA UC Davis: github.com/UCDavisLibrary/ava [7]
-
INAO, реестр AOC: inao.gouv.fr [8]
-
OpenRouter: openrouter.ai [9]
Про агентные системы, оценку моделей и то, что из этого следует для бизнеса, я пишу в телеграм-канале AGI Boardroom [10]. Туда же попадут обновления датасета и разбор вопросов, которые найдут читатели.
Примечание об инструментах. Код проекта преимущественно писал Claude Code; я ставил задачи, читал диффы и принимал результат. Вопросы генерировали и проверяли модели, перечисленные в тексте; все ручные оценки вопросов, на которые опирается статья, — мои. Эту статью Claude Code тоже помогал мне писать: собирал числа из базы и отчётов, строил графики по ним и готовил черновик, который я правил. Числа в тексте взяты из рабочей базы и логов проекта.
Автор: nikitahudov
Источник [11]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36377
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] ошибки: http://www.braintools.ru/article/4192
[3] github.com/nikitahudov/oenobench: https://github.com/nikitahudov/oenobench
[4] huggingface.co/datasets/nikitahudov/oenobench-v1: https://huggingface.co/datasets/nikitahudov/oenobench-v1
[5] arxiv.org/abs/2608.20106: https://arxiv.org/abs/2608.20106
[6] query.wikidata.org: https://query.wikidata.org
[7] github.com/UCDavisLibrary/ava: https://github.com/UCDavisLibrary/ava
[8] inao.gouv.fr: https://www.inao.gouv.fr
[9] openrouter.ai: https://openrouter.ai
[10] AGI Boardroom: https://t.me/AGI_Boardroom
[11] Источник: https://habr.com/ru/articles/1088780/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1088780
Нажмите здесь для печати.