От одного агента к AI-холдингу: масштабирование автономных AI-систем
ИИ ускоряет выполнение отдельных задач, но управление растущим числом процессов и проектов остаётся на человеке. На примере своих экспериментов покажу путь от одного агента к AI-организации и объясню, зачем над несколькими направлениями может понадобиться AI-холдинг.
Я пришёл к другому способу описывать такие системы постепенно, через четыре собственных эксперимента. Каждый следующий шаг отвечал на конкретное ограничение предыдущего:
-
агент для оценки задач (покер планирования) учитывал не весь нужный контекст, поэтому я разделил работу на этапы;
-
для сложной тестовой модели (написание автотестов) понадобился фиксированный workflow;
-
разные функции вокруг одного сайта-блога потребовали AI-организации;
-
перенос на новые блоги показал, что запуск и настройку направлений стоит поднять на отдельный уровень. Так появилась идея AI-холдинга.
Итог я описываю как организацию ролей. У каждой роли есть свой контекст, полномочия, бюджет и критерии результата. Тогда для каждой роли можно отдельно задать требования к качеству, проверить её и настроить, не переписывая один огромный промпт. Дальше я масштабирую эту идею от инженерной команды агентов до AI-организации, которая ведёт отдельное направление. Следующий уровень — AI-холдинг. По замыслу он выбирает направления, формирует под них организации и распределяет между ними ограниченные ресурсы.
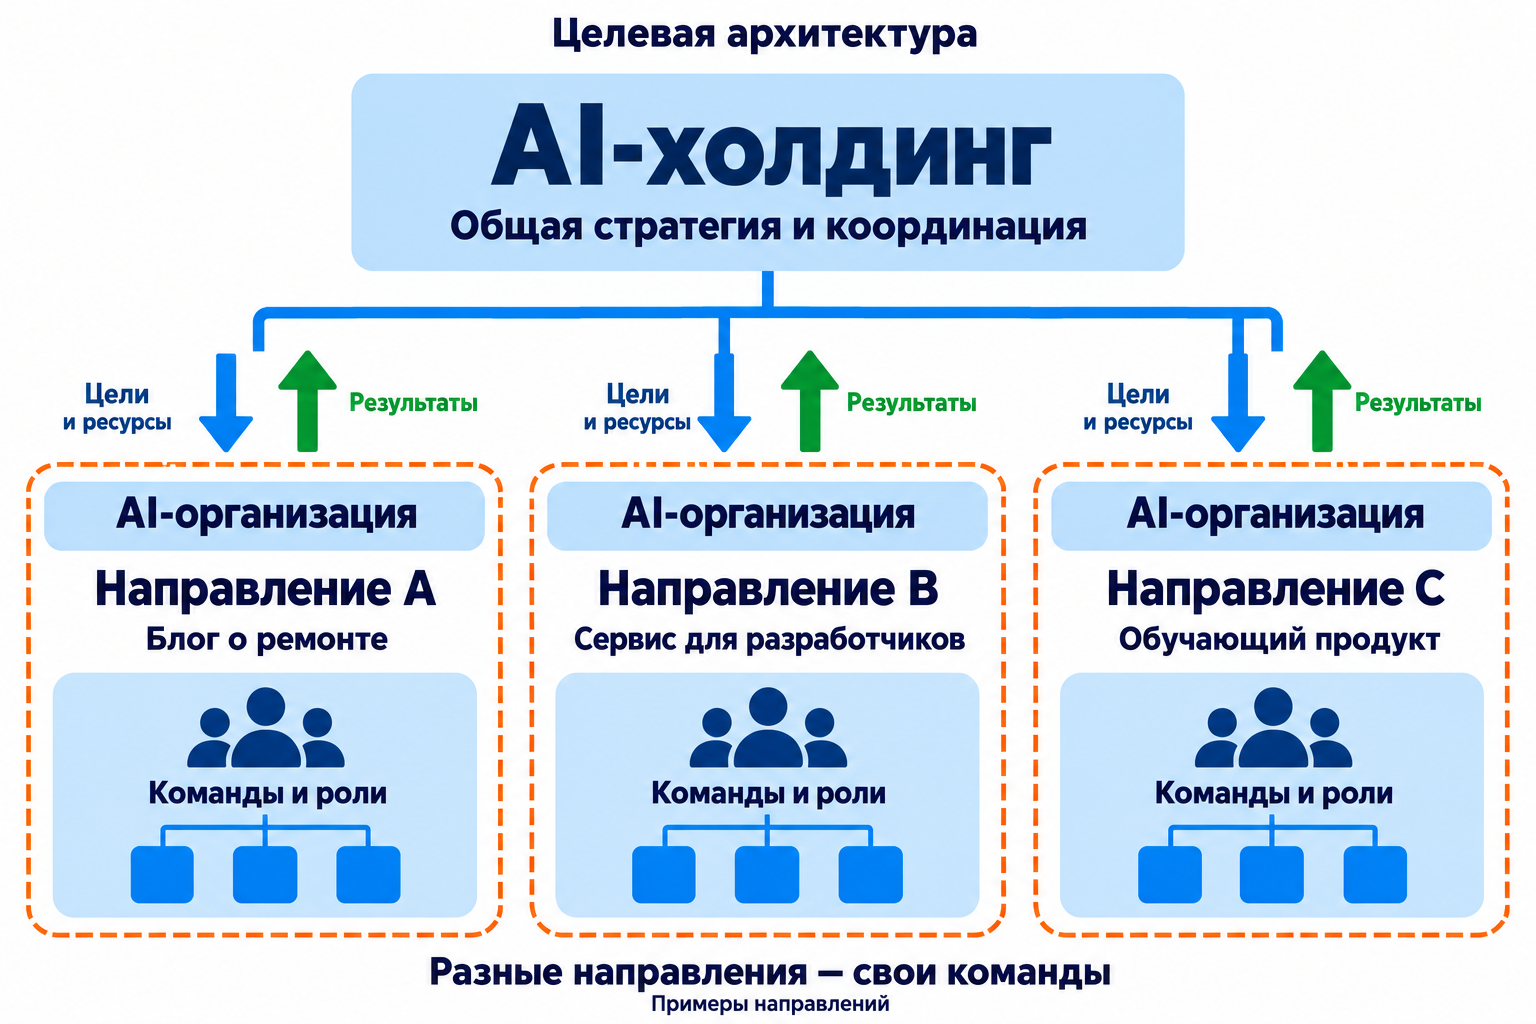
Здесь важно разделять опыт [1] и замысел. Первые три эксперимента — практика, о которой я рассказываю по собственным наблюдениям. Сравнительных измерений по ним в этой статье нет. Четвёртый эксперимент находится на стадии MVP и проработки. Опыт объясняет, откуда взялись архитектурные решения, но не доказывает эффективность всей модели. Механизмы исполняющей системы, описанные ниже, — обобщение и целевая архитектура, а не перечень уже реализованных в моих проектах функций. Сквозной сценарий и псевдокод иллюстративны. В конце статьи разберём, какой уровень организации подходит разным задачам.
Где упирается один агент
Обычный путь усложнения выглядит так. Агенту дают доступ к данным, затем пишут более строгие инструкции, затем добавляют скиллы — подгружаемые по ситуации пакеты инструкций, примеров и инструментов для отдельного класса задач. Каждый шаг какое-то время помогает: агент реже путает форматы, лучше пользуется инструментами и следует принятым правилам.
Сам по себе один агент не обязан быть ограниченным: у него может быть постоянная память [2] и широкий мандат. Трудности возникают, когда в одной роли смешиваются функции и решения разного масштаба. В переписке могут копиться ненужные промежуточные рассуждения, а инструкции маркетинга, аналитики и разработки — конкурировать за внимание [3] модели. Но это возможная проблема, а не закон: рост задачи не обязательно снижает качество. Сильнее мешает другое. Поручение «оцени рынок, предложи продукт и подготовь задачу для разработки» требует трёх разных видов суждения, а если сохраняется только итоговый текст, проверить вклад каждой функции трудно. Для каждой функции трудно отдельно задать критерии, протестировать её и настроить поведение [4], не задев остального.
Я столкнулся с этим на агенте для оценки задач — по сути, автоматизации planning poker. Агент учитывал не весь контекст, который я ожидал. У него было три задачи: найти нужные материалы, продумать реализацию и дать оценку. В разных запусках он делал акцент на разных частях, а иногда терялся и отвечал: «Не могу оценить». Исправить это одними промптами оказалось затруднительно. Тогда я разбил работу на цепочку из трёх агентов:
-
Первый ищет релевантные материалы и контексты.
-
Второй на их основе разбирает трудности и особенности реализации.
-
Третий выставляет оценку.
У каждого этапа своя обязанность, а результат каждого шага можно посмотреть отдельно.
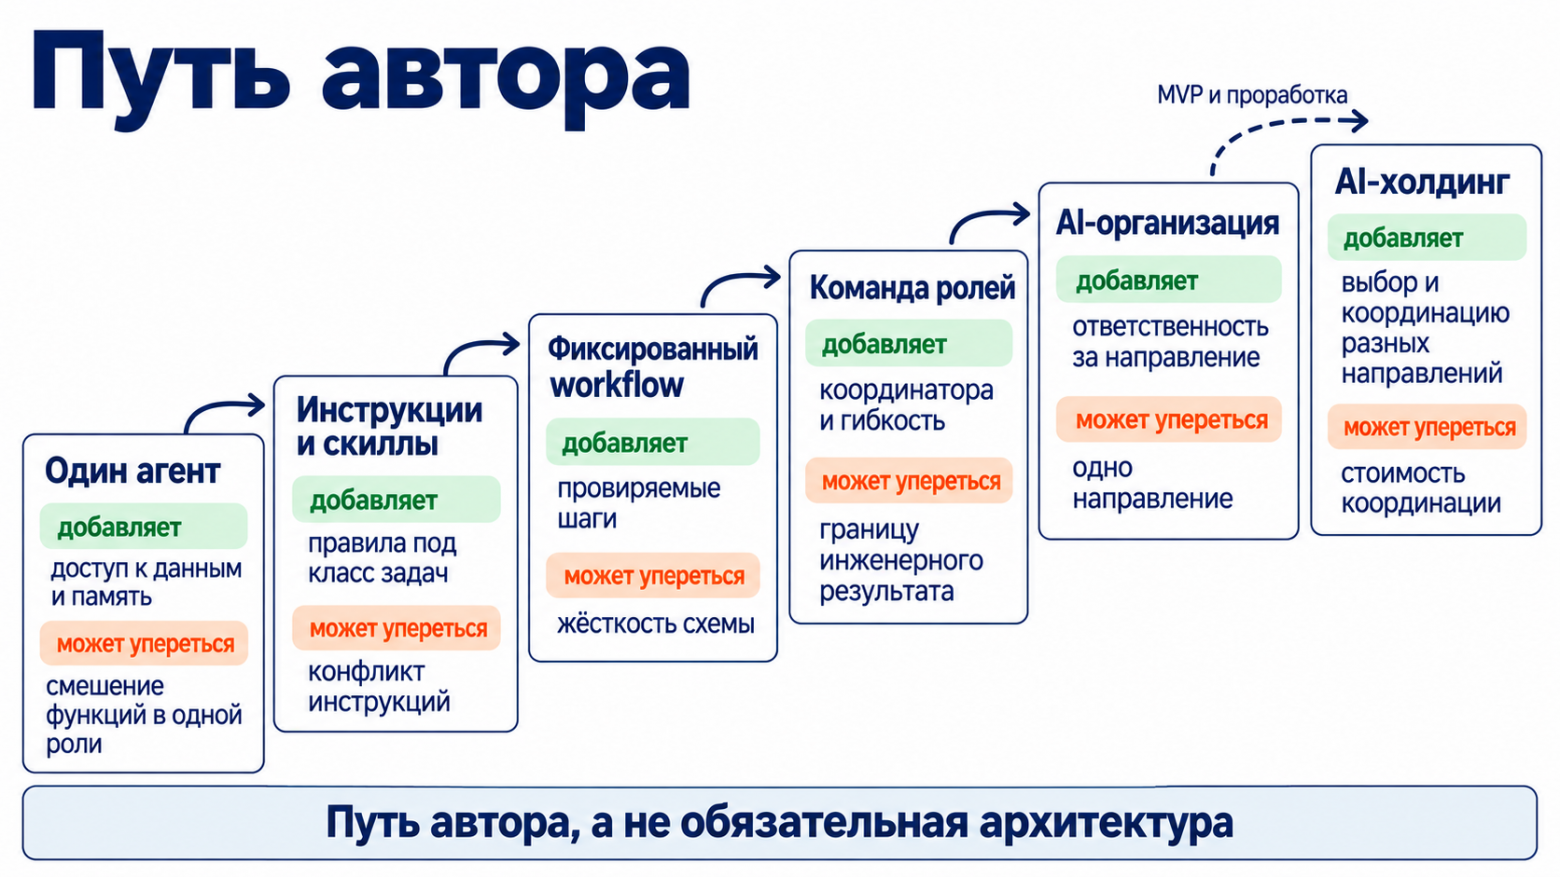
Дальше удобно рассуждать через лестницу подходов: отдельный агент, строгие инструкции и скиллы, фиксированный workflow, команда ролей, AI-организация, AI-холдинг. Лестница объясняет мой путь, но не задаёт обязательную архитектуру. В ней смешаны две независимые оси:
-
способ исполнения — один агент, фиксированный workflow или команда ролей;
-
масштаб ответственности — задача, направление или портфель.
Эти оси комбинируются. Один агент с постоянной памятью может вести направление, а команда ролей — решать одну инженерную задачу. В моих экспериментах менялись обе оси, но жёсткой связи между ними нет. Многим задачам хватает одного агента или workflow.
Фиксированный workflow и контракт передачи
Первый способ вернуть контроль — разбить работу на заранее заданные шаги и закрепить за каждым отдельную роль. Например: сбор данных, анализ, проверка, оформление.
Для написания автотестов сложных сервисов я выстроил фиксированную последовательность шагов. У каждого своя задача, ограниченный контекст и явно заданный результат. Так можно проследить, как исходный кейс превращается в код, и понять, на каком этапе искать ошибку [5].
На вход поступают тест-кейс из Allure, тестовая модель сервиса и примеры базовых сценариев, код сервиса с контрактами зависимостей и контекстом проекта, а также репозиторий автотестов с принятыми паттернами и правилами.
|
Шаг |
Что делает и передаёт дальше |
|---|---|
|
|
Сохраняет исходный кейс для дальнейшей обработки. |
|
|
Фиксирует бизнес-правило, ключевые условия и ожидаемое поведение [6]. |
|
|
Описывает минимальные сущности, данные и связи для сценария. |
|
|
Определяет вызовы зависимостей, аргументы и ответы; объясняет получение результата. |
|
|
Задаёт данные, моки, проверки и необходимые изменения файлов. |
|
|
Реализует спецификацию по правилам репозитория. |
|
|
Отдельная роль проверяет соответствие кода сценарию и качество реализации. |
|
|
Запускает тест и технические проверки, разбирает ошибки, возвращает код на исправление и повторное ревью. |
|
|
Сохраняет изменения в Git и создаёт Merge Request для команды. |
На выходе остаются не только код теста, данные и моки, но и описания сценария, тестового мира и взаимодействий, спецификация, результаты проверок и замечания ревью. Сначала фиксируем смысл и ожидания, затем пишем код. Решения передаются через явные артефакты, автор отделён от проверяющего. Предположения сохраняются явно, а вопросы, требующие продуктового решения, возвращаются человеку. Зелёный тест сам по себе ещё не доказывает, что проверено нужное поведение.
В общем виде каждый шаг workflow можно выполнять отдельным запуском со свежим контекстом исполнения: исполнитель не видит чужой переписки и рассуждений предыдущих шагов. Я исхожу из гипотезы, что такой шаг проще тестировать и настраивать. На него не влияет чужая переписка, и его можно прогнать на наборе типовых входов именно этой роли. Одинаковых ответов на одинаковый вход это не гарантирует. Поведение роли зависит также от версии модели и инструкций, снимка доступной памяти, данных по ссылкам контракта, состояния и ответов инструментов. Эти условия нужно фиксировать, чтобы прогоны были сравнимы. Качество при этом оценивается по нескольким прогонам: LLM может по-разному отвечать на одинаковый вход.
Свежий контекст не означает потерю организационной памяти. Временная переписка исполнителя отделена от постоянных знаний роли, направления и организации. Нужные знания и результаты передаются через явный контракт: что шаг получает на вход и что обязан вернуть. Ниже — иллюстративная схема такого контракта.
# Упрощённая иллюстрация перехода spec → autotest
from: spec
to: autotest
inputs: [спецификация, правила репозитория]
task: реализовать автотест по спецификации
output: [код теста, тестовые данные, моки]
review: self-review — соответствие сценарию и качество реализации
Такой контракт фиксирует, что получает исполнитель и что передаёт проверяющему. Замечания ревью и результаты запуска возвращают работу на исправление; нерешённые продуктовые вопросы — человеку.
Цена такого подхода — жёсткость. Я увидел её, когда хотел применить схему автотестов к другим процессам, например к разработке. Новый workflow приходится отдельно проектировать и настраивать, хотя часть компонентов можно переиспользовать. Если заранее неизвестно, какие шаги понадобятся, фиксированная схема либо пропускает часть работы, либо обрастает ветками.
В моём случае визуальные инструменты вроде Zapier и n8n не снимали эту проблему: всё начиналось с простой цепочки из пяти шагов, а по мере добавления условий и исключений превращалось в паутину, которую трудно читать и контролировать. Дело не в конкретном редакторе: зависимости процесса всё равно приходится проектировать и сопровождать.
Фабрика ролей и её граница
Следующая ступень — команда ролей с координатором. Координатор распределяет работу, решает, кому и что делать дальше, и собирает результат. У каждой роли свои ограничения, скиллы и инструменты. Главное достоинство я вижу в управляемости: для каждой роли можно отдельно задать критерии качества, собрать тестовые задачи и настроить поведение. Если тестировщик систематически пропускает граничные случаи, меняют его инструкции, набор проверок или доступные инструменты, не трогая роль разработчика.
Полной изоляции такая правка не даёт: роли связаны через результаты. Более строгий тестировщик чаще возвращает задачи разработчику, а изменённый формат отчёта может сломать следующий шаг. Поэтому после изменения роли нужны две проверки: на типовых задачах самой роли и на прогоне всей цепочки. Похожее наблюдение есть в статье Anthropic о многоагентной исследовательской системе [7] от 13 июня 2025 года. По описанию авторов, разделение контекста и обязанностей помогает в исследовательских задачах, но увеличивает расходы и усложняет координацию. Кроме того, мелкие изменения координатора могут влиять на поведение исполнителей. Авторы описывают свой класс задач, и переносить эти результаты на любые задачи нельзя.
Эту ступень я разбираю на примерах из открытых источников. Линию активно развивают в инженерной практике. Воркшоп Лорен Тан и Колина Мэтьюза How Cursor Turned AI Agents Into Better Engineers [8] указан на странице мероприятия с датой 12 августа 2026 года. Он посвящён проверке результатов агентов, оценке скиллов, облачным агентам, архитектурным ограничениям и CI. Это ровно те вопросы, которые возникают при переходе от одного агента к управляемой работе нескольких исполнителей. В публикации о pstack и облачных агентах [9] Лорен описывает свою практику: сбор контекста, выбор следующих задач и исполнение через облачных агентов.
Конкретный пример организации инженерной работы — репозиторий lee-to/ai-factory [10]. В его документации о субагентах [11] описаны координаторы планирования и реализации, исполнители, роли ревью и фазовый цикл улучшения. Документация также фиксирует ограничения вложенного делегирования в используемой среде. Дальше я отличаю этот инструмент от общей метафоры: словом «фабрика» или AI Factory я называю инженерную команду нижнего уровня — тимлида, разработчиков, тестировщиков, DevOps.
Граница фабрики определяется масштабом ответственности, а не числом агентов. Её задача — инженерный результат: она отвечает на вопрос «как сделать». Какие направления открывать, как делить между ними ресурсы, когда закрыть проект и как не смешать данные разных проектов, она не решает. Команда ролей как способ исполнения применима и на уровне направления или портфеля, но там у неё другая ответственность. Поэтому в моей модели фабрика становится частью организации и выполняет её инженерную работу.
Организация как программный объект
Выйти за пределы одной команды меня подтолкнул пет-проект — блог о ремонте. Вокруг него я собрал AI-организацию:
-
исследователи искали темы, интересные читателям;
-
отдельные роли следили за стабильностью работы;
-
другие роли готовили требования и занимались реализацией.
Это уже не цепочка шагов под один процесс, а набор разных функций вокруг одного направления. Следующее ограничение проявилось при переносе на новый блог: окружение и роли приходилось поднимать и настраивать заново.
Из этого опыта выросло обобщение, описанное ниже. Описанные в этом разделе декларации ролей, capabilities и трекер как runtime не следует считать перечнем реализованных функций пет-проекта. Это целевое устройство, к которому я пришёл, осмысляя опыт.
AI-организация — это команда независимых AI-ролей, которые работают над общей целью через задачи. Каждая роль отвечает за свой участок работы, получает нужный контекст и действует в пределах своих полномочий. Например, в инженерной части организации руководитель разбивает цель на задачи, разработчик реализует изменения, ревьюер проверяет код, QA проверяет результат, а релизная роль организует выкладку. Исследования и другие функции направления при этом остаются отдельными ролями.
От папки с файлами вроде ceo_prompt.txt такая организация отличается тем, что задачи, состояние, права и ресурсы существуют вне текста инструкций и проверяются исполняющей системой.
В этой модели я разделяю три сущности:
-
Роль — устойчивая позиция с обязанностями, памятью, политиками и инструментами.
-
Модель — настройка роли. Её можно заменить без потери истории и знаний. Но поведение роли при смене модели может измениться, поэтому нужна регрессионная проверка на типовых задачах роли.
-
Запуск — конкретное исполнение роли для конкретной задачи, со свежим контекстом и входом по контракту.
У ролей есть общие возможности и ограничения:
|
Возможности |
Ограничения |
|---|---|
|
Самостоятельно выполнять задачи, сохраняя нужный контекст между запусками |
Своя ответственность, инструкции и набор доступов |
|
Создавать подзадачи, делегировать работу и возвращать её на доработку |
Бюджет и правила выполнения |
|
Читать и обновлять общую базу знаний |
Доступ только к разрешённым областям знаний; контексты разных направлений не смешиваются |
|
Использовать репозитории, инструменты и интеграции |
Только выданные разрешения; зависимости и обязательные проверки нельзя произвольно пропускать |
|
Ждать зависимостей или запрашивать ответ человека |
Критичные действия проходят предусмотренные согласования; завершение подтверждается проверяемым результатом |
Человек задаёт цели и границы. Роли организуют выполнение, проверяют работу друг друга и обращаются к человеку там, где требуется его решение. Сохранение контекста между запусками означает доступ к постоянной памяти и артефактам, а не накопление всей переписки в одном окне.
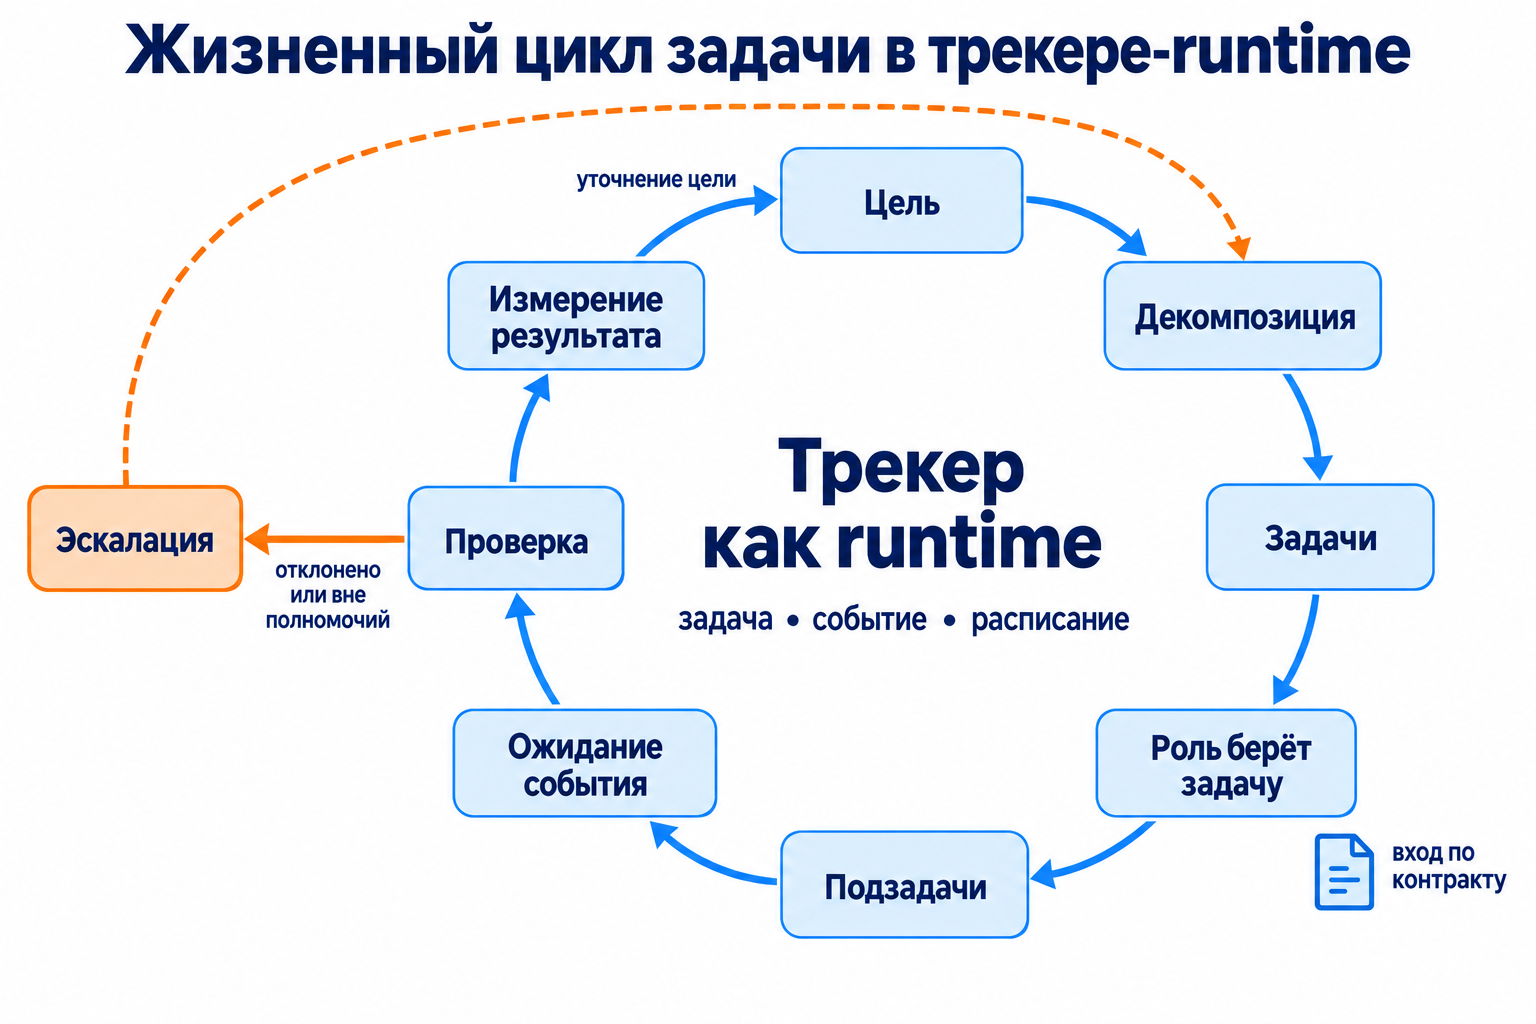
Роль активируется задачей, событием, расписанием или изменением метрики. Например, аналитик направления ежедневно сверяет метрики. При отклонении он ставит задачу ответственной роли. Если та не справляется в срок, аналитик эскалирует вопрос руководителю направления. Так трекер задач становится средой исполнения (runtime) организации. Он хранит поручения, связывает их с целями, ожидает событий, отправляет результаты на проверку и фиксирует итог.
Три уровня ответственности
Повторная настройка каждого нового блога натолкнула меня на мысль вынести запуск и настройку направлений на отдельный уровень. Но если бы задача сводилась к повторному развёртыванию одинаковых блогов, хватило бы шаблона. Известную конфигурацию можно тиражировать без управляющего уровня.
Сложнее, когда идеи разные. Организация настроена под своё направление: роли, знания, процессы, критерии качества. Блогу нужны исследование тем и выпуск материалов. Сервису для бизнеса — исследование клиентов, продажи и разработка. Новая идея может потребовать иного устройства организации, а ресурсов на все идеи не хватит. Шаблоны помогают тиражировать известную конфигурацию. Холдинг по замыслу решает другие вопросы: что создавать, как устроить организацию под новое направление и как управлять разными направлениями при ограниченных ресурсах.
Масштаб решений растёт примерно так: правка кода → компонент → проект или направление → создание и координация разных направлений. Следующий шаг не обязательно требует больше агентов, но меняет вопрос: вместо «как сделать» — «что создавать и сколько в это вкладывать». Моя гипотеза: когда агенты ускоряют исполнение, узкое место смещается к выбору направлений и координации между ними. Это довод в пользу исследования автоматизации управления, а не доказательство рыночного спроса на продукты, которые такой холдинг запустит.
Это мой четвёртый эксперимент, сейчас он находится на стадии MVP и проработки. Целевая схема — холдинг, который управляет несколькими блогами и создаёт новые. Перед запуском нового блога проводятся исследования. Затем направление запускается экспериментально с ограниченным бюджетом, а управление запуском и настройкой переходит на уровень холдинга. Это описание цели, а не работающей полной цепочки. Описанные далее автономный запуск, перестройку и остановку направлений, а также перераспределение бюджета следует читать как требования к целевой архитектуре. Полный состав реализованных возможностей текущего MVP здесь не описывается.
Одно и то же устройство применимо рекурсивно: направление внутри холдинга — тоже организация со своими ролями, памятью и бюджетом. При этом рекурсия не стирает различий между уровнями: на каждом принимаются решения своего масштаба.
В модели я выделяю три уровня, которые различаются масштабом решений.
AI-холдинг выбирает направления и распоряжается общим бюджетом. По замыслу его роли:
-
ищут и первично оценивают перспективные идеи;
-
в пределах мандата формируют под выбранное направление организацию или перестраивают существующую;
-
выделяют направлению ресурсы и контролируют результат.
Остановка направлений и перераспределение ресурсов между ними тоже относятся к целевым полномочиям этого уровня. Для этого холдингу нужен сопоставимый контекст по всем направлениям: затраты, сигналы спроса, риски, прогноз. Детали кода и переписка с отдельными респондентами ему не нужны.
Перестройка организации — изменение её ролей, процессов или критериев — должна быть проверяемой. Новая конфигурация оформляется как версия, проходит проверку на типовых задачах изменённых ролей и на всей цепочке и может быть отменена с возвратом к предыдущей версии. Постоянно переписывать инструкции подчинённых ролей по ходу работы верхний уровень не должен.
AI-организация по направлению управляет только своим направлением. Её роли проводят более глубокие исследования, занимаются маркетингом и другими функциональными задачами, координируют подразделения и команды. Этот уровень не сводится к постановке задач программистам: значительная часть работы направления может вообще не требовать разработки. Ему нужен подробный контекст рынка, клиентов и продукта именно этого направления.
Команда разработки — AI Factory выполняет инженерную работу для своей организации. Тимлид распределяет задачи между разработчиками, тестировщиками, DevOps и другими инженерными ролями. Её контекст — спецификация, репозиторий, окружения и результаты проверок.
Несколько направлений работают параллельно. У каждого своя организация и, если нужно, своя инженерная команда. Делегируется и сама работа, и право её организовывать: создавать подзадачи, временные роли и дочерние команды. Временная роль, например аналитик конкретного регионального рынка, получает срок жизни и удаляется после сдачи отчёта.
Человеческую иерархию при этом не нужно копировать буквально. «Директор направления» — просто удобное название для роли с определённым мандатом. Внутри направления может работать и короткоживущая AI-native конструкция: несколько исследователей, критик, синтез, решение. Каждый лишний уровень координации стоит денег и времени.
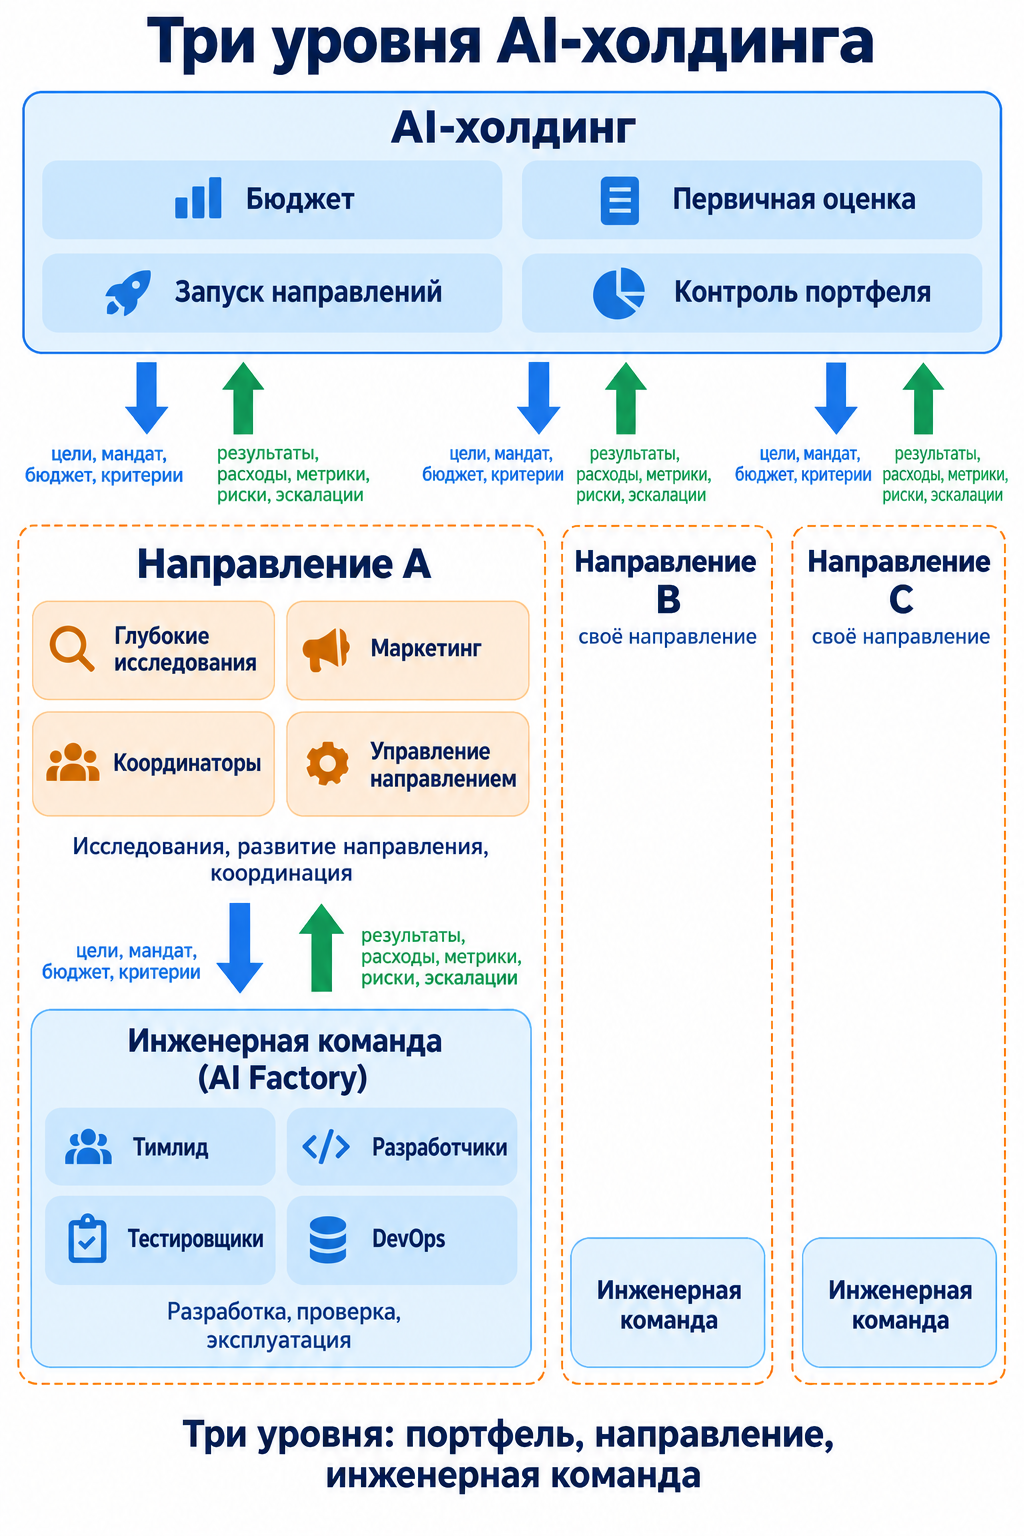
Вниз уходят цели и необходимые данные, вверх — агрегаты: результаты, расходы, метрики, риски, запросы на решения. Чтобы это работало, память разделена по уровням.
|
Слой памяти |
Что хранит |
Срок жизни |
Кто читает |
Кто пишет |
Переживает смену модели |
|---|---|---|---|---|---|
|
Контекст исполнения |
Переписку и рассуждения одного запуска |
Один запуск |
Сам запуск |
Сам запуск |
Не требуется |
|
Память роли |
Накопленные правила, удачные приёмы, разборы ошибок |
Пока существует роль |
Роль и её проверяющий |
Роль по итогам ревью |
Да |
|
Память направления |
Исследования, решения, отброшенные гипотезы, метрики |
Пока существует направление |
Роли направления |
Роли направления по контракту |
Да |
|
Память холдинга |
Сводки по направлениям, решения о портфеле, мандаты |
Постоянно |
Роли холдинга |
Роли холдинга |
Да |
Изоляция направлений бывает логической: отдельные области памяти, данные, клиенты, инструкции и учётные данные. При необходимости её дополняют технической — отдельными окружениями или аккаунтами. Обмен между уровнями идёт через определённые интерфейсы: отчёт по схеме, запрос на ресурсы, эскалацию.
Такая изоляция упрощает закрытие направления без влияния на остальные. Само закрытие выполняет слой исполнения:
-
останавливает запуски, работы и триггеры;
-
отзывает выданные права и ключи;
-
обрабатывает данные направления по установленной политике хранения.
Уже совершённые внешние действия закрытие автоматически не отменяет. Сведения, переданные холдингу или в журнал аудита, хранятся по своим правилам.
Мандат, полномочия и бюджеты
Делегирование без ограничений опасно, поэтому каждой роли выдаётся конкретный набор разрешённых действий — capabilities. Это не «доступ к серверу», а read_logs(service) или create_merge_request(repo). Секреты остаются в слое исполнения, роль получает только результат разрешённого действия. Это применение известных принципов: наименьших привилегий и доступа на основе capabilities.
Ключевой инвариант: подчинённая роль не получает больше, чем есть у делегирующей. Это касается бюджета, данных, API, инфраструктуры и типов действий. Бюджет многомерен: деньги, токены, вызовы платных API, время, число агентов, число задач. Для каждой ветки заранее определено, что происходит при исчерпании лимита: остановка, смена стратегии, запрос на расширение или эскалация.
# Иллюстративный псевдокод, не полный runtime
delegate(parent, request):
    atomically(parent):                       # одна транзакция или блокировка остатка
        for cap in request.capabilities:
            if cap not in parent.capabilities: reject("нет у родителя")
        for dim, amount in request.budget:
            if amount > parent.remaining[dim]:  reject("превышен остаток")
        parent.remaining -= request.budget     # резерв под грант
        return Grant(request.capabilities, remaining=request.budget, parent=parent)
    # при reject или сбое выдачи гранта резерв откатывается, остаток родителя прежний

spend(grant, dim, amount):
    atomically(grant):
        if amount > grant.remaining[dim]: reject("исчерпан грант")
        grant.remaining[dim] -= amount         # из родителя повторно не списывается
Важная оговорка: такие проверки выполняет исполняющая система, а не текст промпта. Фраза «не трать больше лимита» в инструкции — пожелание, которое модель может нарушить. Граница появляется там, где слой исполнения сам считает расход и отказывает в вызове. По той же причине запуск новой роли сам по себе не создаёт границу доступа. Если «новый» агент работает в том же процессе с теми же ключами, он может всё то же, что и родитель.
На этом механизме держится самостоятельный запуск направлений. Человек выдаёт холдингу мандат: цели, допустимые типы действий, общий бюджет, исключения. По замыслу в его пределах роли холдинга сами открывают направления, выделяют им часть бюджета и закрывают их, не запрашивая ручного разрешения на каждый запуск.
Пороги эскалации я предлагаю как вариант реализации, конкретные значения в концепции пока не определены. Эскалацию можно включать, например, в следующих случаях:
-
запрос превышает заданную долю общего бюджета;
-
нужен новый тип действий — договор с внешним подрядчиком, публичная активность от имени компании;
-
запрос выходит за пределы оговорённых исключений.
Автономность можно описать ступенями:
-
роль действует сама и только фиксирует действие в журнале;
-
роль действует сама и уведомляет вышестоящую роль;
-
действие требует согласования вышестоящей роли;
-
действие выходит за мандат и требует решения человека.
Отдельная задача — не дать системе порождать работу ради работы. Создать описание роли и запустить её экземпляр технически просто. Но каждая роль расходует вычисления, инструменты и время проверки, а каждый уровень координации добавляет задержки. Поэтому нужны:
-
лимиты глубины делегирования и числа агентов;
-
обоснование при создании роли;
-
учёт стоимости роли;
-
автоматическое удаление неиспользуемых ролей.
Роли создаются по мере необходимости, а их число и срок жизни ограничиваются полезностью, бюджетом и стоимостью координации.
Проверка, журнал и точечная настройка
Ограничения задают, что система может сделать. Отдельный вопрос — как убедиться, что она сделала это хорошо.
Первый механизм — разделение обязанностей: исследователь, проверяющий и принимающий решение должны быть разными ролями. Для важных вопросов полезны независимые параллельные исследования одной задачи, которые сравнивает отдельная роль. Здесь есть ограничение: проверяющий на той же модели может разделять ошибки исследователя. Это гипотеза, которую стоит проверять. Варианты защиты — другая модель, инструментальная проверка источников, человек на критичных решениях.
Второй механизм — метрики роли вместо оценки «хорошо написал». Для маркетинга это могут быть трафик, стоимость привлечения и конверсия. Для эксплуатации — доступность и инциденты, для исследований — доля подтвердившихся прогнозов. У метрик свои слабости: они запаздывают, шумят, зависят от внешних факторов. Кроме того, роль может научиться улучшать метрику в ущерб цели.
Третий механизм — сквозной журнал: цепочка от цели к решению, задаче, роли, вызову инструмента, результату и согласованию. По нему можно ответить, кто инициировал действие, на каком основании, кто дал право и сколько оно стоило.
{
  "goal_id": "direction-A/validate-demand",
  "task_id": "T-118",
  "role": "demand_analyst",
  "model": "<версия>",
  "granted_by": "research_lead",
  "inputs_ref": "handoff/T-118",
  "tool_calls": ["<поиск>", "<чтение источника>"],
  "cost": { "tokens": "<факт>", "search_calls": "<факт>" },
  "result": "reports/demand-v1",
  "reviewed_by": "research_verifier",
  "decision": "accepted"
}
Журнал помогает расследованию, если вместе с ним сохранены входы, версии и свидетельства проверки: тогда артефакты можно сверить между собой. Причинность сам журнал не доказывает и единственную виновную роль не указывает.
Возьмём иллюстративный случай с классификатором входящих обращений. Исследователи направления выясняют, какие категории нужны клиентам. Координатор переводит эти выводы в требования и передаёт их инженерной команде. Команда реализует классификатор по требованиям. Но при проверке оказывается, что он группирует обращения не так, как нужно пользователям.
Разработчики не обязаны заново исследовать потребности [12] клиентов: им нужен проверенный результат исследования в виде требований. Чтобы найти расхождение, сопоставляем артефакты этой цепочки. Возможны три ситуации:
-
Ошибка исследования. Отчёт об аудитории уже содержал неверные категории, а проверяющий принял его без источников. Настраивают исследователя: требования к источникам, вход с примерами реальных обращений. Проверяющему добавляют критерий «у каждой категории есть свидетельство».
-
Ошибка координации. В исследовании категории были верными, но координатор не перенёс их в инженерную задачу: в контракте передачи не было такого поля. Меняют схему контракта и инструкции координатора.
-
Ошибка реализации. Требование было в задаче, но команда его не выполнила, а тесты этого не поймали. Правят тестировщика и, возможно, разработчика, не трогая исследование.
В каждом из этих диагнозов правка адресная: меняют инструкции, скиллы, инструменты, критерии результата или объём контекста конкретных ролей либо схему контракта. После правки роль проверяют на её типовых задачах, а цепочку — целиком: изменение одной роли могло задеть соседние. Сверка может показать и другое: категории неверны уже в источнике данных или ошибку внесли сразу несколько ролей. Тогда правка одной роли не поможет, и менять придётся источник, контракт или несколько ролей.
Сквозной сценарий: от возможности до проекта
Соберём механизмы на одном вымышленном сценарии. Это не мой кейс с блогами: сценарий иллюстрирует архитектуру и не утверждает, что такая рыночная возможность существует. AI-холдинг ищет направления среди B2B-сервисов и рассматривает сервис обработки входящих обращений для небольших компаний.
-
Сигнал и первичная оценка. По регулярному триггеру роли холдинга собирают сигналы, грубо оценивают спрос, конкуренцию и затраты и выбирают гипотезу. Результат — короткая сводка в памяти холдинга.
-
Запуск направления. В пределах мандата холдинг сам создаёт AI-организацию с ролями под эту гипотезу. Он выделяет ей ограниченный бюджет, набор capabilities, стартовую память и критерии остановки. Запуск означает начало проверки гипотезы и ничего не говорит об успехе бизнеса.
-
Глубокое исследование. Роли направления уточняют аудиторию, продуктовую гипотезу и каналы. Исследование спроса, конкурентов и экономики ведут отдельные роли по контрактам, отчёты проходят проверку.
-
Развилка: есть ли основания для ограниченного эксперимента? Принятый проверяющим отчёт значит лишь, что отчёт аккуратен и опирается на источники. Наличия спроса он не доказывает. Поэтому на этом шаге решается только вопрос о небольшом эксперименте. Возможны три исхода:
-
Нет оснований. Направление останавливается до разработки. Вверх уходит отчёт о затратах, причинах и непроверенных вопросах, и холдинг закрывает направление. Слой исполнения останавливает работы и отзывает доступы, а в бюджет холдинга возвращается свободный остаток после учёта незавершённых операций.
-
Данных недостаточно. Направление дособирает данные в пределах оставшегося бюджета и срока либо закрывается.
-
Основания есть. Начинается ограниченный эксперимент.
-
-
Ограниченный эксперимент. Перед стартом направление фиксирует внешний критерий и срок. Например: доля приглашённых целевых компаний, которые повторно воспользуются прототипом до оговорённой даты. Координатор формирует ограниченную инженерную задачу. AI Factory распределяет разработку, тестирование и DevOps и возвращает прототип вместе со свидетельствами проверок. Прототип показывают целевым пользователям и собирают наблюдаемый сигнал.
-
Оценка и решение о портфеле. Направление собирает отчёт по затратам, внешнему сигналу, качеству, рискам и открытым вопросам. Роли холдинга сравнивают результат с заранее выбранным критерием и с другими направлениями. Затем они решают: продолжить, изменить, расширить или остановить. Расширение допустимо, только если внешний критерий достигнут в срок. Внутренняя оценка агентов наблюдаемого сигнала от пользователей не заменяет.
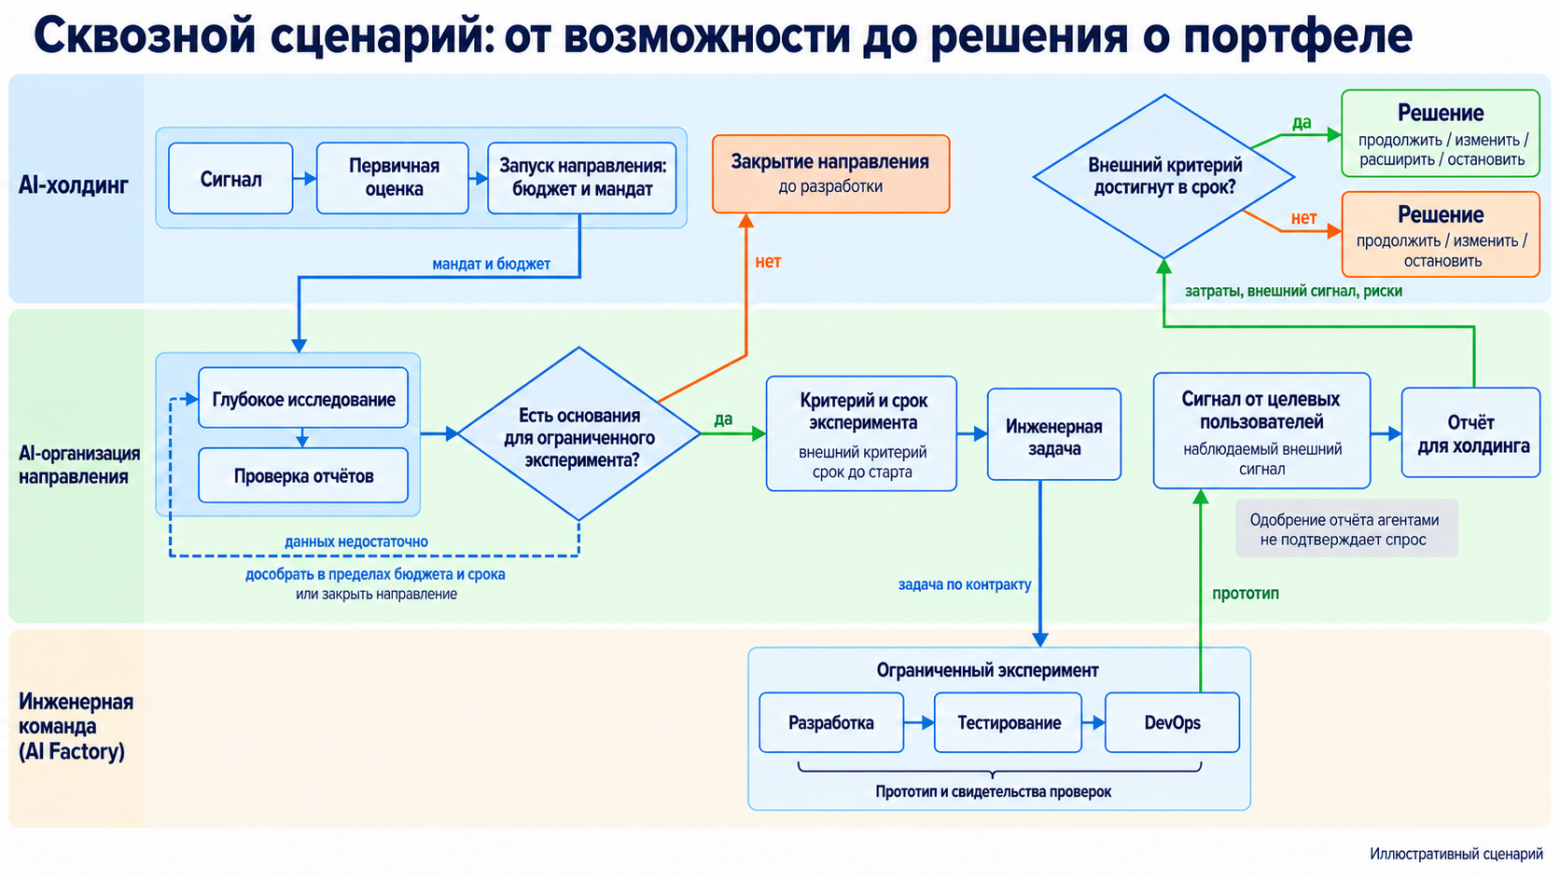
На каждом шаге видно, кто поставил задачу, что получил исполнитель, куда записан результат и кто его проверил. Это помогает сопоставить первичную оценку, исследование и реализацию и искать источник расхождения — в отдельной роли, передаче между ролями или исходных данных.
Чем отличаются подходы и что уже есть рядом
Сравнивать подходы удобнее по двум осям, чем по названиям. Способ исполнения и масштаб ответственности комбинируются; в таблице — иллюстративные примеры сочетаний.
|
Способ исполнения |
Задача |
Направление |
Портфель |
|---|---|---|---|
|
Один агент |
Агент со скиллами исправляет код |
Агент с постоянной памятью и широким мандатом ведёт блог |
Агент распределяет бюджет между проектами по правилам мандата |
|
Фиксированный workflow |
Конвейер написания автотеста |
Регулярный цикл: метрики → отчёт → план публикаций |
Плановый пересмотр бюджетов направлений по заранее заданной формуле |
|
Команда ролей |
AI Factory: тимлид, разработчики, тестировщики |
AI-организация с исследованием, маркетингом и инженерной командой |
AI-холдинг: роли выбирают направления, формируют организации и распределяют ресурсы |
Лестница из начала статьи проходит по этой сетке одним из возможных маршрутов. Выбирать клетку стоит по тому, какие решения нужно делегировать и что вы готовы платить за координацию. Более высокая ступень лестницы сама по себе не лучше.
Многие элементы модели существуют по отдельности: ролевые команды агентов, графы workflow, иерархические агенты с менеджером, принципы наименьших привилегий и разделения обязанностей. Есть и близкие по замыслу проекты. Ниже — короткое сопоставление по первичным источникам. Это не обзор рынка, и я не утверждаю ни уникальности модели, ни приоритета.
|
Источник |
Что описано |
Пересечение с моделью статьи |
Чего источник не подтверждает |
|---|---|---|---|
|
lee-to/ai-factory [10] |
Координаторы планирования и реализации, исполнители, роли ревью, фазовый цикл улучшения, ограничения вложенного делегирования |
Нижний уровень — инженерная команда |
Управление направлениями и портфелем — не предмет документации |
|
Paperclip [13] |
По README: организационная структура, задачи, бюджеты, несколько организаций, полномочия, регулярная работа |
Близкая инфраструктура организационного управления: роли, бюджеты, несколько организаций |
Независимая проверка надёжности; по README не установлено, насколько полно автоматизирован выбор направлений и перераспределение средств между ними |
|
Project Vend, часть 2 [14] (Anthropic, 18 декабря 2025) |
Эксперимент с агентами, ведущими небольшой бизнес, в том числе с управляющей ролью |
Уроки управления бизнес-агентами и добавления управляющего уровня |
Улучшение бизнеса нельзя уверенно приписать появлению менеджера; возникали новые проблемы взаимодействия. Это эксперимент, а не готовый аналог холдинга |
Paperclip ближе всего к инфраструктурной части модели, но не доказывает, что автономное инвестирование между направлениями работает. Project Vend полезен как предупреждение: управляющая роль добавляет не только контроль, но и новые сбои взаимодействия. Моё предложение касается масштаба и ответственности. Фабрику агентов я рассматриваю как нижний уровень AI-организации, а организации — как единицы портфеля AI-холдинга, который по замыслу выбирает направления, формирует под них организации и распределяет ресурсы. Связывают уровни общие инварианты: наследование полномочий и бюджетов, контракты передачи, разделение памяти, независимая проверка и сквозной журнал.
Цена автономности
Дополнительный уровень управления имеет смысл, только если его польза оправдывает расходы. У такой системы я вижу три главных риска:
-
Координация дороже результата. Роли множат задачи и согласования. Нужны бюджеты, ограничение глубины делегирования и понятная причина для каждой новой роли.
-
Внутреннее согласие подменяет внешний результат. Хороший отчёт и одобрение другого агента ещё не подтверждают спрос. Решения о расширении должны опираться на наблюдаемый результат эксперимента.
-
Локальная правка затрагивает всю цепочку. Изменение одной роли может нарушить работу соседних. Проверять нужно и саму роль, и итоговый процесс; участие человека задаётся мандатом и порогами риска.
Проверять стоит не только качество результата, стоимость, время и число вмешательств человека, но и управляемость: насколько проще найти дефект, исправить его и убедиться, что остальные функции не ухудшились. Сравнение с более простой схемой при сопоставимых ресурсах покажет, оправдано ли усложнение. Для холдинга отдельно важны решения по нескольким направлениям при общем ограниченном бюджете.
Какой уровень организации нужен вашей задаче
Устройство системы стоит выбирать по двум вопросам: какой масштаб решений требуется делегировать и что вы готовы платить за координацию. Для коротких и хорошо формализованных задач обычно достаточно одного агента со скиллами. Если агент упускает нужный контекст, первым шагом может стать разделение работы на этапы. Фиксированный workflow уместен, когда процесс повторяется, а отдельные функции нужно настраивать и проверять по отдельности. Стоит заранее учесть, что под другой процесс схему придётся проектировать заново.
Когда достаточно AI-фабрики. Нужно организовать инженерную работу: тимлид распределяет задачи между разработчиками, тестировщиками и DevOps, команда выпускает и проверяет технический результат. Выбор бизнес-направления, исследование рынка и маркетинг остаются за пределами её ответственности.
Когда нужна AI-организация. Требуется вести одно направление целиком: проводить глубокие исследования, развивать продукт, заниматься маркетингом и координировать инженерную работу. У организации есть долгоживущая цель, собственный контекст, выделенные ресурсы и ответственность за результат направления. Такой масштаб задач доступен и одному агенту с постоянной памятью и широким мандатом. Организация ролей имеет смысл, когда отдельные функции требуется независимо настраивать и проверять.
Когда нужен AI-холдинг. Требуется выбирать между разными идеями, формировать или перестраивать под них организации и управлять несколькими направлениями при ограниченных ресурсах. Если нужно лишь тиражировать известную конфигурацию, достаточно шаблона. Дополнительный уровень имеет смысл, если польза решений о том, что создавать и сколько в это вкладывать, оправдывает стоимость координации.
Разделение этапов, фиксированный workflow и организацию ролей вокруг одного направления я уже опробовал на практике. Холдинговый уровень пока находится на стадии MVP и проработки: его пользу ещё предстоит проверить.
Автор: shukhratlead
Источник [15]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36464
URLs in this post:
[1] опыт: http://www.braintools.ru/article/6952
[2] память: http://www.braintools.ru/article/4140
[3] внимание: http://www.braintools.ru/article/7595
[4] поведение: http://www.braintools.ru/article/9372
[5] ошибку: http://www.braintools.ru/article/4192
[6] поведение: http://www.braintools.ru/article/5593
[7] многоагентной исследовательской системе: https://www.anthropic.com/engineering/multi-agent-research-system
[8] How Cursor Turned AI Agents Into Better Engineers: https://maven.com/p/e23d9c/how-cursor-turned-ai-agents-into-better-engineers
[9] публикации о pstack и облачных агентах: https://www.linkedin.com/posts/laurenelizabethtan_cloud-agents-and-cursor-harness-improvements-activity-7495972438262853632-bLQ5
[10] lee-to/ai-factory: https://github.com/lee-to/ai-factory
[11] документации о субагентах: https://github.com/lee-to/ai-factory/blob/2.x/docs/subagents.md
[12] потребности: http://www.braintools.ru/article/9534
[13] Paperclip: https://github.com/paperclipai/paperclip
[14] Project Vend, часть 2: https://www.anthropic.com/research/project-vend-2
[15] Источник: https://habr.com/ru/articles/1090014/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1090014
Нажмите здесь для печати.