А что, если ИИ-слоп не ошибка, а бизнес-модель?
Изначально я хотел написать про узкую тему: ИИ-слоп на таких платформах, как Хабр. Есть ли он, какую долю занимает, как быстро растёт. Пока писал, пересматривал «Прослушку», и в рекламной паузе попался ролик, после которого я представил скорее промпт на 30 слов, чем работу опытного 3D-аниматора. По одному просмотру не поймёшь, как его делали, но впечатление [1] было именно такое.
После этого ограничиваться платформами для статей расхотелось. Здесь про влияние ИИ-контента на интернет в целом: от видосов в тиктоке до карточек на ВБ, от песен с заурядным текстом в стримингах до экспертных постов в LinkedIn и научных публикаций. Насколько глубоко он проник, кому это выгодно и чем может кончиться.
Не весь ИИ-контент я считаю слопом. ИИ-слопом я называю генеративный контент, в котором лёгкость производства подменяет содержательную работу: проверку фактов, отбор материала, собственные наблюдения и ответственность за результат. ИИ-контент может быть полезным и уместным. Само использование нейросети ещё не делает материал мусором.
Из этого определения видно, чем слоп привлекает производителя: дёшево и быстро. Самую сложную часть работы можно пропустить и всё равно получить то, что снаружи похоже на законченный материал.
Статистика
Я искал свежие данные, чтобы не опираться только на своё мнение. Что-то совпало с ожиданиями, что-то порадовало, а кое-что про вкусы общества лучше бы не знать. С цифрами пришлось разбираться: долю новых загрузок легко принять за долю всего контента на площадке.
Использованы материалы, опубликованные до конца сентября 2026 года. Дата публикации исследования и дата наблюдений могут не совпадать: сентябрьский отчёт спокойно может описывать июнь, и выдавать июньские данные за сентябрьские я не буду.
С Хабром не вышло: надёжной открытой оценки доли слопа на этой площадке я не нашёл. Писать «каждый второй текст нейросетевой» только потому, что пара статей показалась подозрительной, я не стану.Для такого вывода у меня нет данных. К тому же на Хабре жёсткие правила по ИИ: там запрещена даже редактура нейросетью, и это должно способствовать сохранению живого текста.
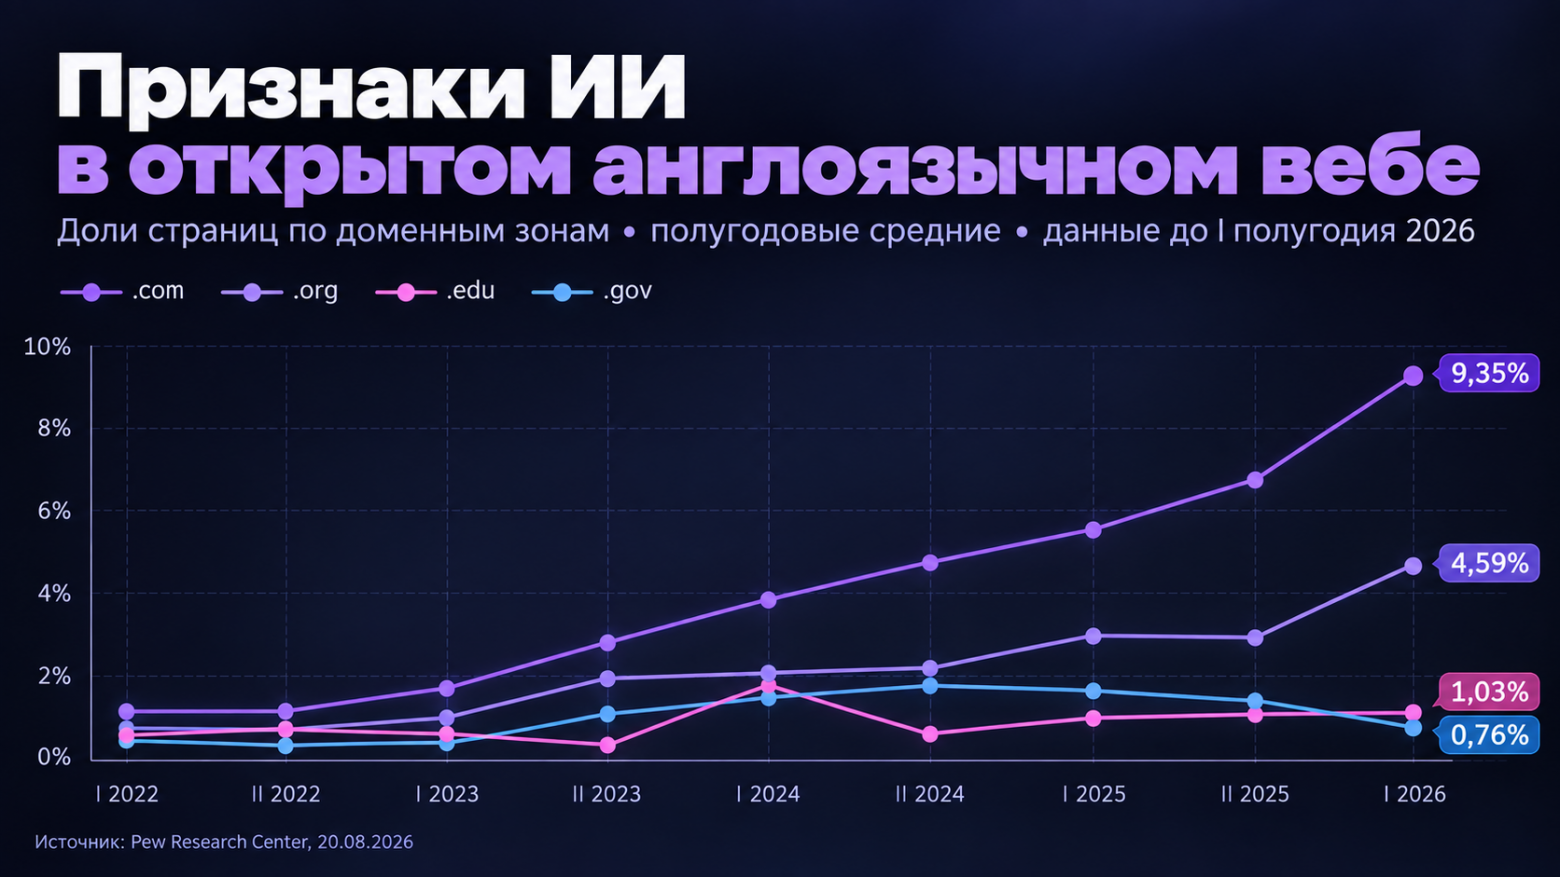
Для общей картины есть исследование Pew Research Center, август 2026. Они проанализировали 490 тысяч англоязычных страниц из разных срезов Common Crawl. В июльской выборке 2026 года около 10% страниц имели существенные признаки написания или редактирования с помощью ИИ. Среди страниц, у которых удалось определить дату публикации после выхода ChatGPT, показатель был выше трети, но это отдельная подвыборка, а не весь интернет. В зоне .com оценка выросла с 1,08% в первом полугодии 2022 года до 9,35% в первом полугодии 2026-го. Детектор мог ошибаться, так что это оценка распространения ИИ-участия, а не доля плохих текстов.
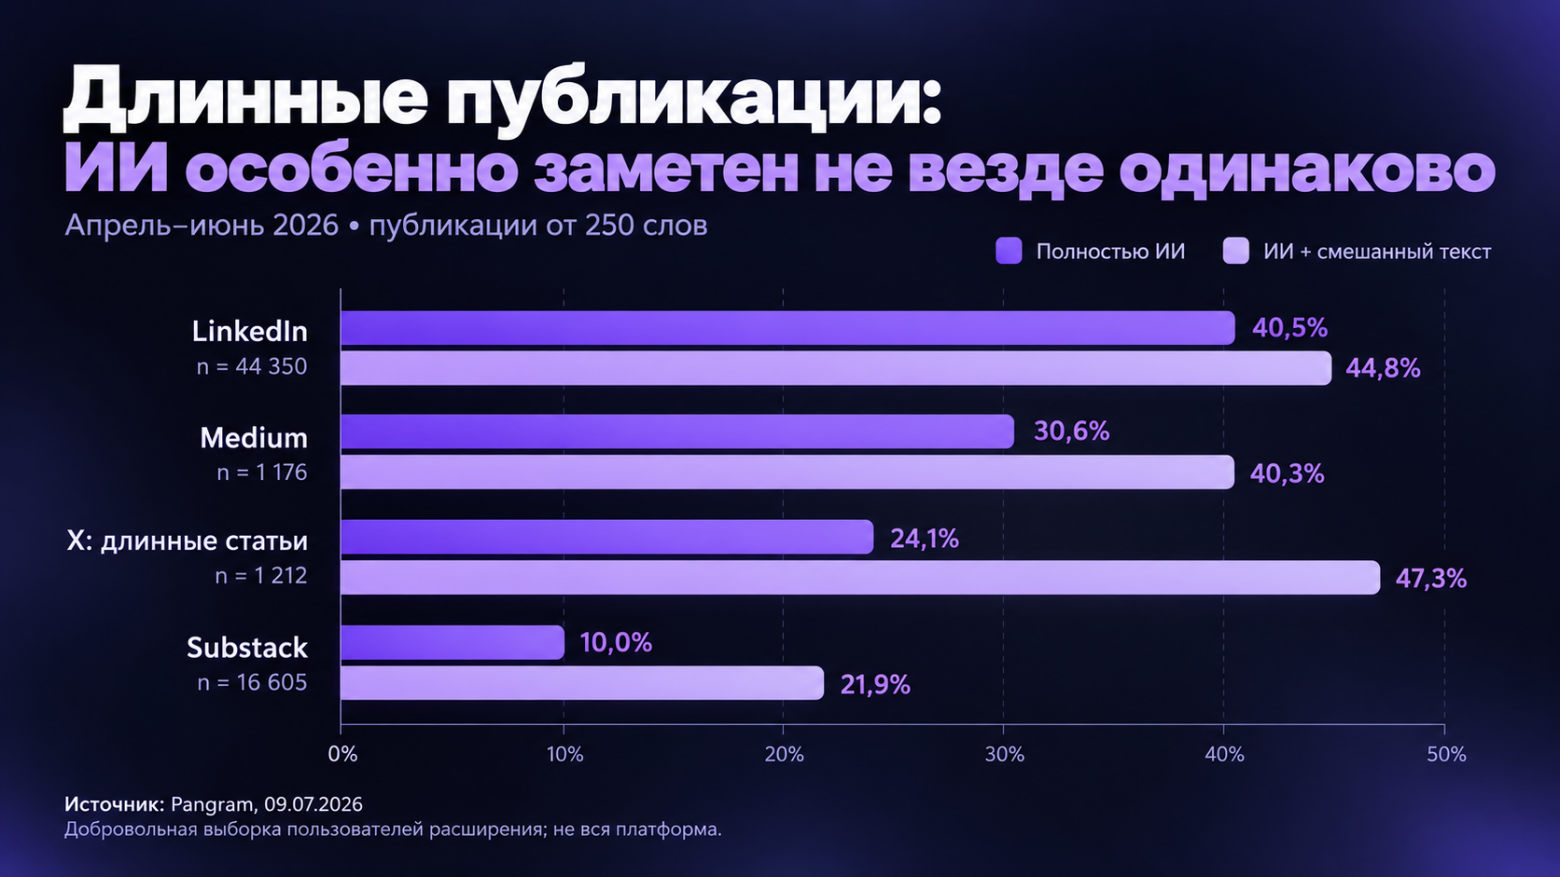
С соцплатформами интереснее. По исследованию Pangram за июль 2026 года, больше 40% проверенных длинных постов в LinkedIn были полностью сгенерированы. На Substack доля длинных публикаций с ИИ-участием, включая смешанные, составила 21,9%. А среди проверенных ответов на Reddit 98,1% классифицированы как человеческие. Данные пришли от добровольцев с расширением Pangram, на всю аудиторию их переносить нельзя. И Pangram сам продаёт детектор, так что интерес [2] у них есть.
У меня тут напрашивается гипотеза: длинный публичный пост люди чаще поручают нейросети, чем ответ в споре. Мне кажется, убедительный пост про свой опыт [3] писать труднее, чем огрызаться в комментариях. Но по приведённым цифрам эту догадку не проверить: сравниваются разные площадки и аудитории, а мотивы авторов исследование не измеряло.
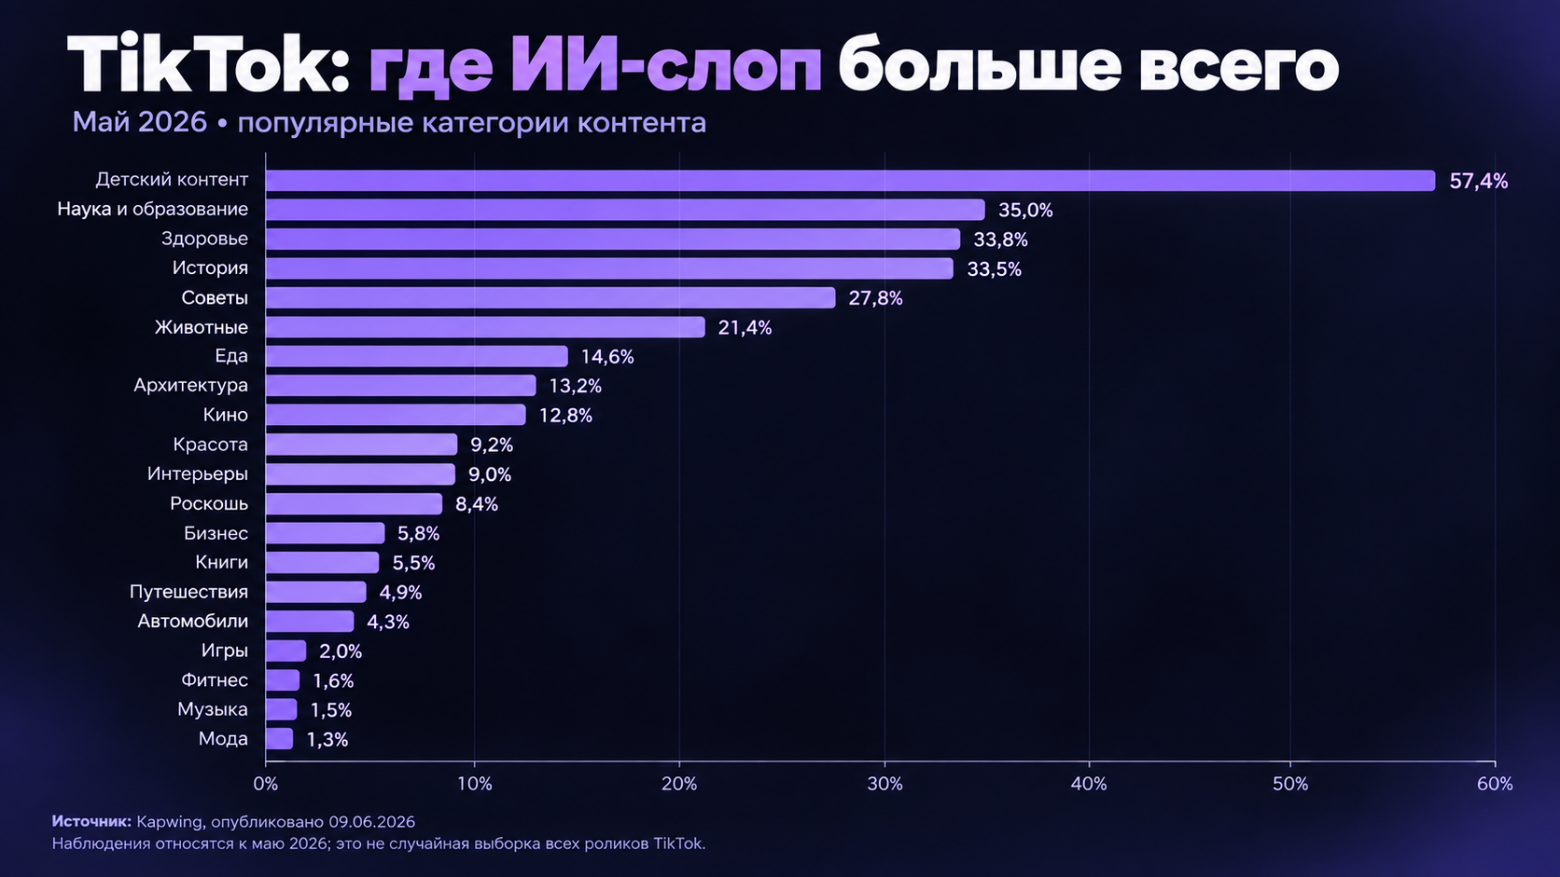
В TikTok к концу сентября промаркировано больше 3 млрд видео как созданных с участием ИИ. Это сообщение самой платформы. Цифра накопленная: ни долю от всего TikTok, ни число за год из неё не получить. Но чтобы понять, насколько там всё грустно, мне хватило пяти минут в ленте. Это уже впечатление, а не данные.
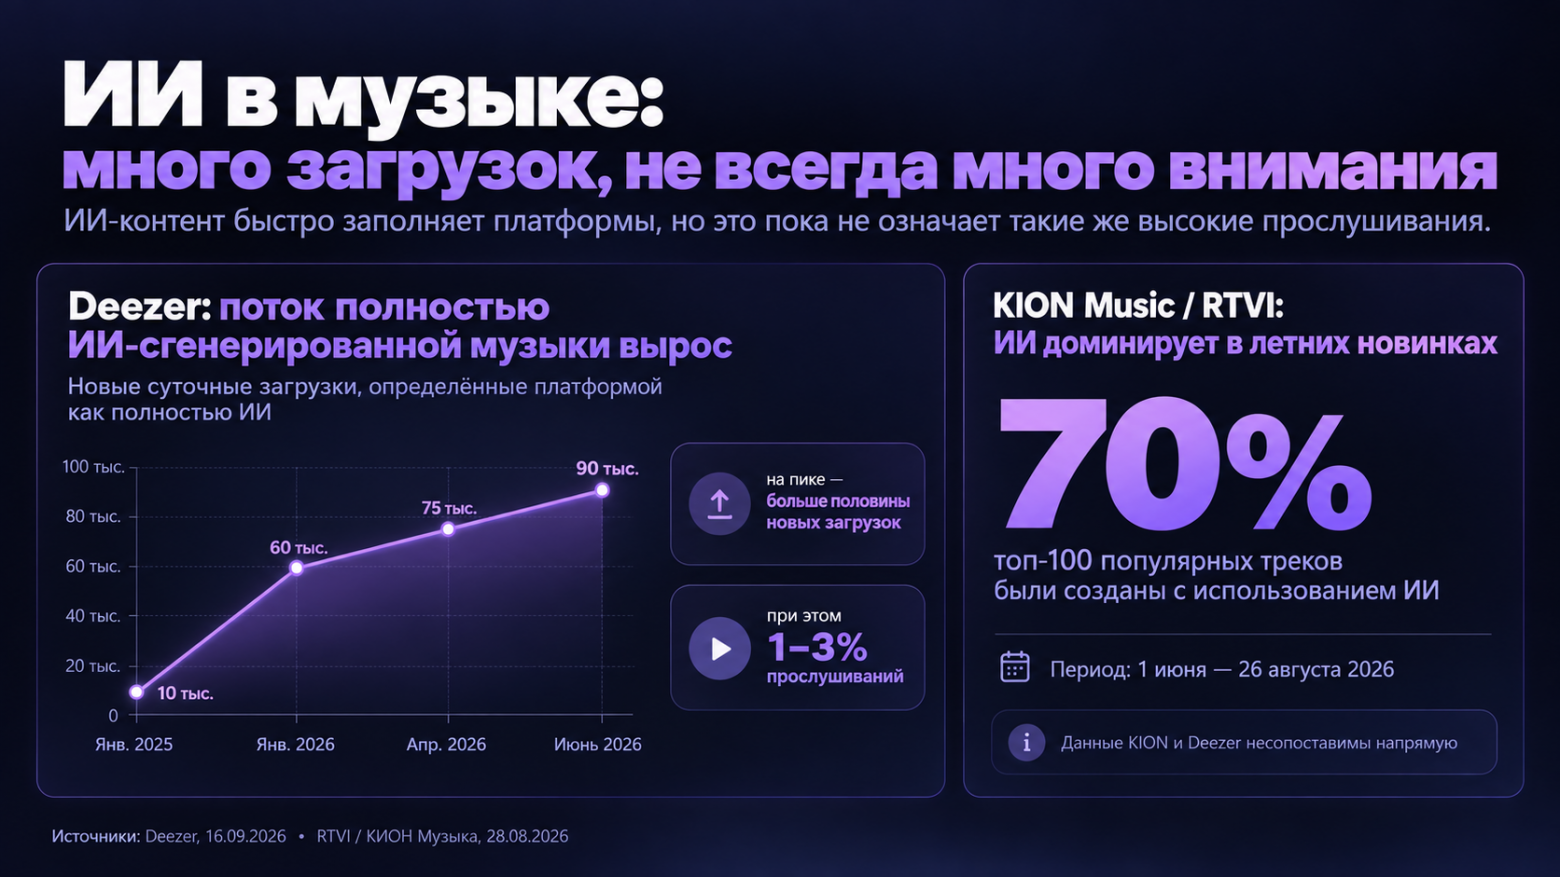
На Deezer ИИ-треки массово загружают, но слушают их мало. В сентябрьском сообщении Deezer говорится, что в июне 2026 года на платформу ежедневно загружали почти 90 тысяч полностью ИИ-сгенерированных треков, на пике это больше половины всех новых загрузок. При этом на такую музыку приходилось только 1–3% прослушиваний. Можно радоваться, что слушатель выбирает людей, но Deezer убирал найденные ИИ-треки из рекомендаций и редакционных плейлистов. Результат во многом определила политика площадки.
Российский пример. По данным «КИОН Музыки» (RTVI, август 2026), около 70% топ-100 среди изученных летних новинок созданы с использованием ИИ. Смотрели релизы с 1 июня по 26 августа. Методику не раскрыли, так что с Deezer это не сравнить. У меня самого в топ-25 Яндекс Музыки нашлись только две очевидные генерации, но это один чарт.
На таких цифрах так и тянет написать «вкусы общества никуда не годятся». Но человек услышал песню, она ему понравилась, он добавил её в плейлист. Изучать историю создания каждого трека он не обязан. Чтобы назвать песню слопом по моему определению, надо объяснить, что с ней не так, кроме происхождения. Хотя сам я такие песни в любимое не добавил бы.
На маркетплейсах генерация встроена в рабочие инструменты. Wildberries позволяет делать нейросетевые описания, фото с моделями и видео по снимкам товара, это прописано в официальных инструкциях для продавцов. Сколько таких карточек и продают ли они лучше, неизвестно.
С наукой [4] тоже осторожно. В исследовании более 15 млн биомедицинских аннотаций оценили, что минимум 13,5% аннотаций за 2024 год обработаны языковыми моделями. Период уже не свежий. Это не значит, что исследования выдуманы: учёный мог просто вычитать текст моделью.
Последнее направление, и мне оно было интереснее всего. По отчёту IAB за июль 2026 года, почти две трети покупателей цифровой видеорекламы уже использовали генеративный ИИ для рекламных материалов, годом раньше было около половины. Здесь считают компании, а не долю роликов.
В рекламных экспериментах ИИ давал и прирост, и падение показателей. В исследовании Picture Perfect ИИ-изображения для рекламы Polestar дали кликабельность 2,04% против 1,37% у обычных. Но модель специально адаптировали под задачу, а мерили клики, не продажи машин. В другой работе, по экспериментам интернет-магазина, дополнение описаний товаров с помощью ИИ подняло выручку на 2,1%, а переписывание заголовков объявлений снизило клики на 10,3% без значимого изменения выручки. Эксперименты шли в разное время, общую эффективность ИИ на сентябрь 2026 из них не вывести.
Я начал с подсчёта ИИ-контента, но сами проценты мало что объясняли. Пришлось смотреть, для чего его делают.
Плюсы и минусы
Дальше мой анализ с изрядной долей имхо, многие могут не согласиться. Я взвесил плюсы и минусы и к каждому пункту искал контраргумент. Плюсы относятся к генеративному ИИ в целом: определить слоп как халтуру и потом объяснять, чем халтура полезна, было бы странно.
Плюс первый: больше людей могут попробовать что-то создать. Не у каждого есть деньги на дизайнера, время на монтаж или смелость написать первый текст. Можно сколько угодно говорить, что настоящий автор должен пройти через трудности, но иногда человеку нужно просто проверить, интересно ли ему это вообще.
Контраргумент: быстро получить результат не значит уметь оценить его качество. Опаснее всего, по-моему, когда человек приносит сырую идею, получает подробный план и пару тёплых слов и воспринимает это как подтверждение собственной гениальности [5]. Склонность моделей соглашаться с пользователем исследовали, в том числе в Anthropic. Модель не всегда поддакивает, но её одобрение не экспертиза. Среди таких начинаний будет много хороших, спорить не буду. Дойдёт ли человек до проверки за пределами чата, вот что важно. Реальный читатель или покупатель вежливым быть не обязан.
Плюс второй: на некоторых задачах ИИ экономит время. В эксперименте MIT с письменными заданиями доступ к ChatGPT сократил время выполнения примерно на 40%, а оценки качества выросли на 18%. Правда, это 2023 год, и задания не требовали той точности и знания контекста, что нужны в реальной работе.
Контраргумент: сэкономленное время легко посчитать раньше, чем работа закончена. Если текст появился за минуту, а потом пришлось искать источники для каждого утверждения, разбираться в терминах и переписывать половину выводов, экономия уже другая. Можно и правда ничего не проверять и закончить за минуту. Тогда часть своей работы автор молча передаёт читателю.
Плюс третий: помощь тем, кому есть что сказать, но тяжело это оформить. Человек может разбираться в ремонте, программировании или узкой научной теме и плохо писать. Не вижу, почему его опыт должен обесцениваться из-за того, что ему помогли с изложением.
Контраргумент: у такой помощи есть граница. Автор написал «у меня сработало», после правки стало «подход доказал эффективность». Оснований столько же, уверенности больше.
Плюс четвёртый: можно быстрее перебирать идеи. Посмотреть несколько вариантов объяснения, оформления или сюжета, прежде чем выбрать один. Особенно полезно, когда застрял и не знаешь, с какой стороны подступиться.
Контраргумента из личного опыта я не подобрал, но пока работал над статистикой, нашёлся неожиданный. В эксперименте, опубликованном в Science Advances в 2024 году, ИИ-подсказки повышали оценки отдельных коротких рассказов, но сами рассказы становились более похожими друг на друга. На всё творчество [6] я бы это не переносил, но сам эффект тревожит.
Теперь минусы.
Минус первый: объём материала, который приходится просеивать. Раньше автор выпускал один непроверенный текст в неделю, теперь может выпускать двадцать в день. Даже если качество каждого не изменилось, для читателя задача другая: плохие тексты встречаются в разы чаще.
Контраргумент: площадка может сделать выпуск мусора менее выгодным. В апреле 2026 года Даниэль Стенберг писал, что после закрытия программы денежных выплат и изменений в работе с отчётами ИИ-слоп перестал быть существенной проблемой для curl. По его оценке, ИИ участвовал почти во всех новых сообщениях об уязвимостях, но качество отчётов заметно выросло. При этом самих отчётов стало больше, и Стенберг предупреждал о перегрузке разработчиков. Получается, улучшить качество входящих материалов можно, но это ещё не гарантирует, что проверяющим станет легче.
Минус второй: доверие. Для меня есть разница между картинкой-иллюстрацией и картинкой, которую выдают за фото события. С карточками товаров так же: заменить фон — одно, а если при генерации изменились материал, форма или детали самого товара — совсем другое. Покупатель получит вещь, которую сделала фабрика, а не ту, что красиво дорисовала модель.
Контраргумент: сам ИИ обман не делает неизбежным. Продавец может проверить изображение, оставить реальные фото и честно написать, что изменено. Автор может пометить художественный вымысел. Мне важно, совпадает ли картинка с обещанием. Впрочем, красивая картинка, не соответствующая реальности, в рекламе существовала задолго до нейросетей.
Есть и обратная крайность. Можно так увлечься поиском ИИ, что подозрительным станет любой аккуратный текст. В исследовании Stanford 2023 года тогдашние детекторы часто принимали английские тексты неносителей языка за сгенерированные. Переносить эти ошибки [7] на инструменты 2026 года нельзя, но пример показывает, почему одного процента на экране мало, чтобы обвинять человека. Отдельно меня рассмешило, как в русскоязычном интернете длинное тире объявили признаком ИИ и фактически отменили знак препинания.
Минус третий: работа и деньги. Компания сообщает, что сэкономила на производстве контента, и для неё это успех. Для подрядчика, который раньше делал эту работу, всё выглядит иначе. Например, Klarna ещё в 2024 году сообщала о сокращении расходов на внешних маркетинговых поставщиков на 25% и уменьшении цикла производства изображений с шести недель до семи дней. Данные самой компании, и экономит тут не каждый.
Контраргумент: у части специалистов благодаря ИИ заказов может стать больше. Удешевление производства позволит клиентам заказывать больше материалов на тот же бюджет, а некоторым исполнителям обслуживать больше клиентов. Но дополнительные заказы не обязательно достанутся тем, кто потерял прежних заказчиков. Если клиенты привыкнут к более низким ценам и коротким срокам, работать на прежних условиях станет сложнее. Поэтому если у человека стало меньше заказов, у него есть причина быть недовольным.
Минус четвёртый: что происходит с самим автором. Можно постепенно привыкнуть принимать предложенный моделью вариант, даже не обдумав его. Сначала просишь поправить абзац, потом добавить аргумент, потом сформулировать вывод. Текст выглядит связным, а понимаешь ли ты сам, почему пришёл к этому выводу?
Контраргумент: это не неизбежно. Можно сначала сформулировать мысль самому, а потом попросить найти слабые места. Можно проверять моделью расчёт, не отдавая ей выбор, что считать. Так что утверждать, что ИИ неизбежно лишает способности думать, я не стану. Он просто даёт возможность пропустить мышление [8] там, где раньше без него нельзя было получить убедительный результат. А люди, как известно, любят злоупотреблять комфортом.
Кому это выгодно
Вернусь к рекламе, с которой для меня расширилась тема. Я смотрел ролик как зритель. Компания, которая его заказала, могла оценивать совсем другое.
Условный пример. Обычное производство рекламы стоит 100 тысяч рублей, с ИИ, включая проверку и правки, 30 тысяч. Расходы на размещение одинаковые. После вычета себестоимости товара и прочих переменных расходов первая кампания приносит 400 тысяч, вторая 370. Результат рекламы во втором случае хуже, но экономия на производстве больше потери. В итоге остаётся 300 тысяч против 340.
Цифры придуманы, чтобы показать механизм. Чтобы ИИ был выгоден компании, реклама не обязана быть лучше прежней. Иногда достаточно сделать её чуть хуже, но намного дешевле. Поэтому мои претензии к качеству ролика вполне уживаются с довольным заказчиком. Иногда плохая реклама даже играет на руку: вокруг неё поднимается шум в интернете.
Дальше появляются другие участники. Сервис генерации получает деньги за подписку или запросы независимо от того, окупилась ли кампания. Рекламная площадка получает плату за доступ к аудитории. Продавец пытается заработать на товаре. Все они могут заработать, даже если зритель получил только ещё одну бесполезную рекламу.
Есть и более прямой способ зарабатывать на слопе. В марте 2026 года NewsGuard сообщала о выявлении более 3 тысяч ИИ-контентных ферм, которые выпускают материалы ради рекламной выручки или пропаганды. NewsGuard продаёт инструменты проверки, так что её интерес тоже надо учитывать. Но механизм понятен: если страница приносит с рекламы больше, чем стоит её создание, низкая ценность содержания владельцу не мешает.
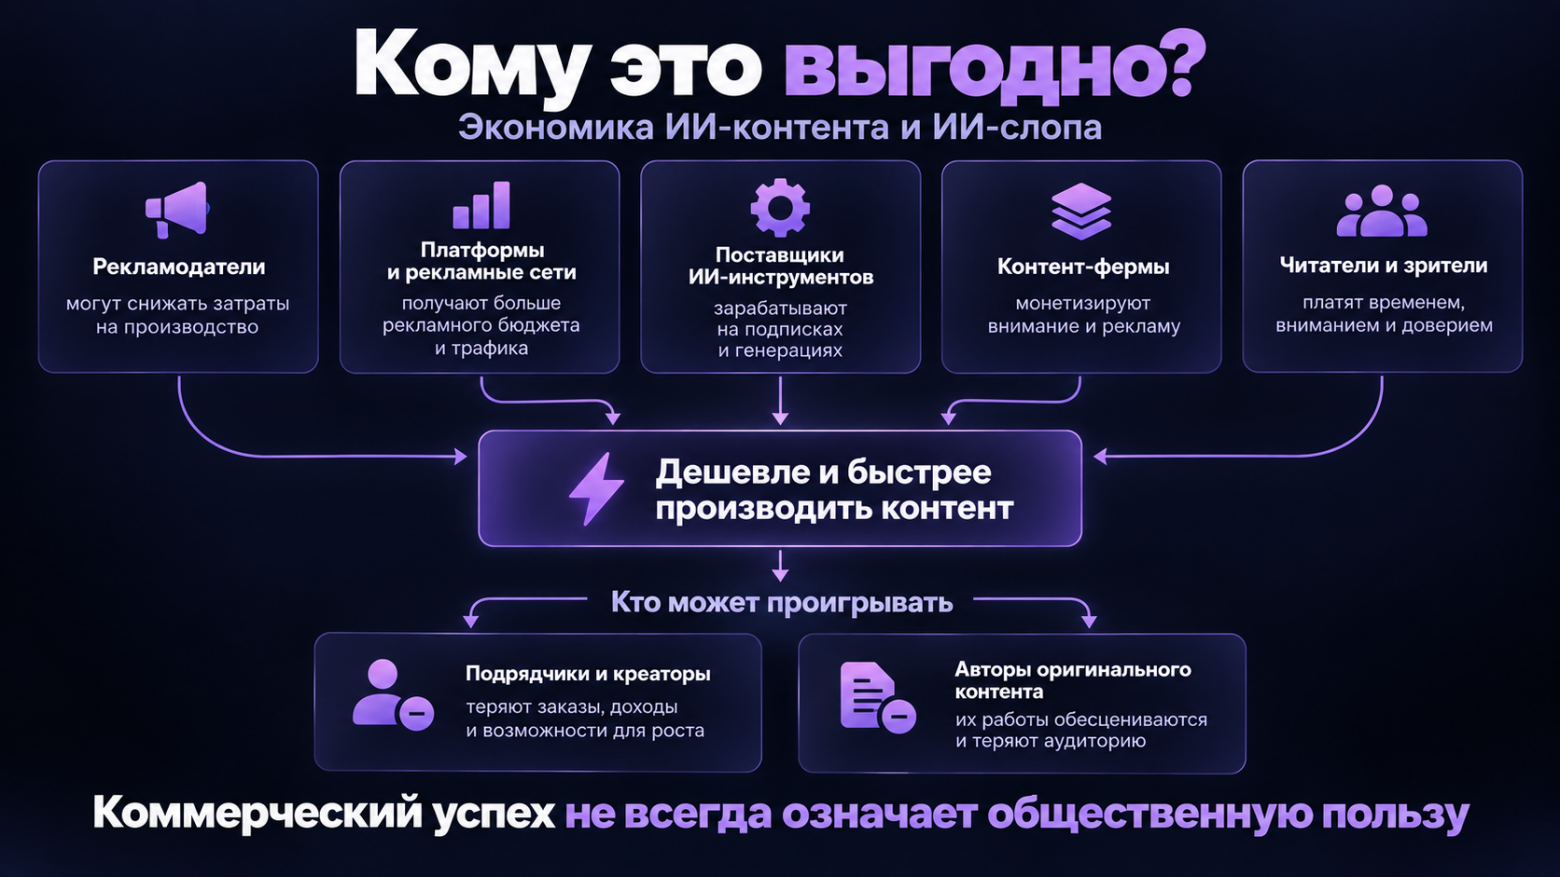
Поэтому прибыль отдельно взятой компании ещё не показывает, стало ли лучше экономике в целом. Если небольшой бизнес смог дёшево объяснить покупателю свойства полезного товара, выигрыш может быть реальным. Две компании могут начать выпускать в десять раз больше рекламы, чтобы переманивать друг у друга тех же покупателей. Но сам по себе рост количества рекламы ещё не означает, что покупателям стало лучше.
Проверять непроверенный текст приходится читателю, и на это тоже уходит время. Допустим, автор сэкономил час на проверке текста, а тысяча читателей потратила по дополнительной минуте, разбираясь с оставленными в нём ошибками. Для автора это эффективность. Суммарно люди потеряли времени гораздо больше.
К какому выводу я пришёл
Я хотел узнать, много ли вокруг слопа. После статистики стало ясно, что одного этого вопроса мало. Даже идеальный детектор происхождения каждого текста, картинки и трека не скажет, полезен ли материал и честно ли его подают.
Я не считаю, что человек обязан отказываться от удобного инструмента ради того, чтобы работа шла дольше. Но мне не нравится, когда удобством инструмента оправдывают отсутствие проверки и собственного понимания. Особенно если результат подаётся как личный опыт, экспертное мнение или исследование. Модели иногда выдумывают факты. Если автор публикует их без проверки, ссылка на нейросеть для меня ничего не оправдывает.
От автора я жду, что он сможет объяснить свои выводы и показать, на чём они основаны. Если описан эксперимент, проводился ли он?
При этом превращать борьбу со слопом в обязательный экзамен для каждого, кто решил что-то опубликовать, не хочется. Ошибаться, писать неровно, делать неудачные первые попытки — нормально. Проблема начинается там, где человек перестаёт отличать попытку от проверенного результата, но требует от читателя одинакового доверия к обоим.
Чего ждать
Дальше мои предположения, не статистика. Участие ИИ в повседневном контенте, думаю, будет всё менее заметным, но охватит всё больше сфер. Когда генерация встроена в редактор карточки, не нужно принимать большое решение «начать пользоваться нейросетями», достаточно нажать доступную кнопку. У Wildberries такие инструменты уже есть.
Но ситуация на разных площадках будет разной. Пример Deezer показывает, что сервис может ограничивать распространение определённого контента при огромном потоке загрузок. История curl показывает, что смена стимулов и порядка работы влияет на качество входящих материалов. Так что будущее зависит не только от возможностей моделей, но и от того, что конкретной площадке выгодно получать.
Возможно, вырастет ценность авторов, которым уже доверяют, и материалов, где можно проверить происхождение информации. Но надпись «сделано человеком» сама по себе ничего не гарантирует. Человек тоже может написать бесполезный текст, а на обещании человеческого авторства можно построить такой же маркетинг, как сейчас на обещании «всё сделано с ИИ».
Ещё беспокоит привычка к тому, что любой материал требует расследования. Открывать инструкцию, обзор или карточку товара и каждый раз сначала выяснять, существовало ли то, о чём тебе рассказывают, мне не хочется. В таком интернете публиковать станет проще, а пользоваться им тяжелее. Меня это волнует прежде всего как пользователя и клиента.
Исходя из этого, я хотел бы, чтобы время экономилось не только на стороне автора. Если благодаря ИИ человек быстрее сделал что-то полезное и мне стало проще разобраться, клеймить это автоматически я не вижу причин. Если же он быстрее нажал «опубликовать», а разбираться с последствиями должен я, у меня к нему достаточно конкретная претензия.
Источники и исследования
-
Хабр — правила и этикет [9]
Правила размещения материалов, в том числе ограничения на использование нейросетей. -
Pew Research Center — How Much of the Internet Is Written With AI? [10]
Исследование 490 тысяч англоязычных веб-страниц и динамики распространения ИИ-контента. -
Pew Research Center — Methodology [11]
Методология исследования ИИ-контента в открытом вебе. -
Pangram — AI Content Is Everywhere on Social Media, Especially LinkedIn [12]
Данные по LinkedIn, Medium, X, Substack и Reddit. -
TikTok — Helping people spot and understand AI-generated content [13]
Официальное сообщение о более чем 3 млрд видео с маркировкой ИИ-контента. -
Deezer — AI Music Detection Wins Billboard Award [14]
Данные о количестве полностью ИИ-сгенерированных треков и их доле в прослушиваниях. -
RTVI — «Руки Вверх!», сын Децла и ИИ-музыка: что слушали россияне летом [15]
Данные «КИОН Музыки» об использовании ИИ в популярных летних новинках. -
Wildberries — создание карточки товара [16]
Официальные инструкции Wildberries для продавцов и встроенные инструменты работы с карточками товаров. -
Wildberries — «Фотостудия» и генерация изображений [17]
Инструменты создания изображений товара с помощью нейросетей. -
Delving into LLM-assisted writing in biomedical publications through excess vocabulary [18]
Исследование более 15 млн биомедицинских аннотаций и признаков использования языковых моделей. -
IAB — Business Outcomes Are Just the Beginning [19]
Исследование использования генеративного ИИ в цифровой видеорекламе. -
Picture Perfect: Engaging Customers with Visual Generative AI [20]
Исследование эффективности ИИ-изображений в рекламе, включая эксперименты с Polestar. -
Generative AI and Sales Productivity: Field Experiments in Online Retail [21]
Полевые эксперименты с ИИ-описаниями товаров, рекламными сообщениями и заголовками объявлений. -
Anthropic — Towards understanding sycophancy in language models [22]
Исследование склонности языковых моделей соглашаться с пользователем. -
MIT News — Study finds ChatGPT boosts worker productivity for some writing tasks [23]
Эксперимент с письменными заданиями: влияние ChatGPT на скорость работы и оценки качества. -
Science Advances — Generative AI enhances individual creativity but reduces the collective diversity of novel content [24]
Исследование влияния ИИ-подсказок на качество отдельных рассказов и общее разнообразие текстов. -
Daniel Stenberg — High-Quality Chaos [25]
Наблюдения разработчика curl об использовании ИИ в отчётах об уязвимостях и изменении их качества. -
Stanford HAI — AI-Detectors Biased Against Non-Native English Writers [26]
Исследование ложных срабатываний детекторов ИИ-текста. -
Klarna — AI helps Klarna cut marketing agency spend by 25% and run more campaigns [27]
Данные компании об экономии на маркетинге и ускорении производства изображений. -
NewsGuard — AI Content Farm Detection Datastream [28]
Данные о более чем 3 тысячах выявленных ИИ-контентных ферм.
Автор: Ziverpup
Источник [29]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36656
URLs in this post:
[1] впечатление: http://www.braintools.ru/article/2012
[2] интерес: http://www.braintools.ru/article/4220
[3] опыт: http://www.braintools.ru/article/6952
[4] наукой: http://www.braintools.ru/article/7634
[5] гениальности: http://www.braintools.ru/article/4566
[6] творчество: http://www.braintools.ru/creation
[7] ошибки: http://www.braintools.ru/article/4192
[8] мышление: http://www.braintools.ru/thinking
[9] Хабр — правила и этикет: https://habr.com/ru/docs/help/rules/
[10] Pew Research Center — How Much of the Internet Is Written With AI?: https://www.pewresearch.org/data-labs/2026/08/20/how-much-of-the-internet-is-written-with-ai/
[11] Pew Research Center — Methodology: https://www.pewresearch.org/data-labs/2026/08/20/methodology-ai-content/
[12] Pangram — AI Content Is Everywhere on Social Media, Especially LinkedIn: https://www.pangram.com/blog/ai-in-your-feed
[13] TikTok — Helping people spot and understand AI-generated content: https://newsroom.tiktok.com/helping-people-in-ireland-spot-and-understand-ai-generated-content-on-tiktok?lang=en-IE
[14] Deezer — AI Music Detection Wins Billboard Award: https://newsroom-deezer.com/2026/09/deezer-ai-detection-billboard-award/
[15] RTVI — «Руки Вверх!», сын Децла и ИИ-музыка: что слушали россияне летом: https://rtvi.com/lifestyle/ruki-vverh-syn-deczla-i-ii-muzyka-chto-slushali-rossiyane-letom/
[16] Wildberries — создание карточки товара: https://seller.wildberries.ru/instructions/ru/ru/material/how-to-create-card
[17] Wildberries — «Фотостудия» и генерация изображений: https://seller.wildberries.ru/instructions/ru/ru/material/virtual-clothes-fitting-by-photostudio
[18] Delving into LLM-assisted writing in biomedical publications through excess vocabulary: https://arxiv.org/html/2406.07016v5
[19] IAB — Business Outcomes Are Just the Beginning: https://www.iab.com/news/business-outcomes-are-just-the-beginning/
[20] Picture Perfect: Engaging Customers with Visual Generative AI: https://journals.sagepub.com/doi/full/10.1177/00222429251356993
[21] Generative AI and Sales Productivity: Field Experiments in Online Retail: https://arxiv.org/html/2510.12049v6
[22] Anthropic — Towards understanding sycophancy in language models: https://www.anthropic.com/research/towards-understanding-sycophancy-in-language-models
[23] MIT News — Study finds ChatGPT boosts worker productivity for some writing tasks: https://news.mit.edu/2023/study-finds-chatgpt-boosts-worker-productivity-writing-0714
[24] Science Advances — Generative AI enhances individual creativity but reduces the collective diversity of novel content: https://doi.org/10.1126/sciadv.adn5290
[25] Daniel Stenberg — High-Quality Chaos: https://daniel.haxx.se/blog/2026/04/22/high-quality-chaos/
[26] Stanford HAI — AI-Detectors Biased Against Non-Native English Writers: https://hai.stanford.edu/news/ai-detectors-biased-against-non-native-english-writers
[27] Klarna — AI helps Klarna cut marketing agency spend by 25% and run more campaigns: https://www.klarna.com/international/press/ai-helps-klarna-cut-marketing-agency-spend-by-25-and-run-more-campaigns/
[28] NewsGuard — AI Content Farm Detection Datastream: https://www.newsguardtech.com/press/newsguard-launches-real-time-ai-content-farm-detection-datastream-to-counter-onslaught-of-ai-slop-in-news/
[29] Источник: https://habr.com/ru/articles/1091306/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1091306
Нажмите здесь для печати.