Усредняющие сети: как ускорить 8-битные сети почти без потери точности
Чтобы распознать документ на смартфоне [1], мало хорошо обучить нейросеть читать текст. Нужно ещё добиться, чтобы она делала это быстро на процессоре самого устройства. При разработке Smart Document Engine, системы распознавания и анализа документов [2], мы решаем именно такие задачи: обработка должна выполняться локально, а вычислительные ресурсы ограничены. Поэтому для нас поиск более экономных способов вычисления нейронных сетей — вполне практическая задача.
Один из привычных способов ускорить нейросеть — квантование. Переход от вычислений с плавающей запятой к 8-битным целым числам позволяет получить более быструю модель с близкой точностью. Можно пойти дальше: ранее мы предложили 4.6-битные сети, сравнимые по скорости с 4-битными, но заметно превосходящие их по точности. Однако уменьшение разрядности — не единственное, что можно изменить в нейросетевых вычислениях. Что, если оставить веса и входные данные 8-битными, а пересмотреть способ накопления результатов умножения?
В этой статье мы расскажем об алгоритме, который вместо точного суммирования использует последовательное усреднение по дереву. Такой подход позволяет дольше сохранять промежуточные результаты в 16-битном формате и эффективнее использовать SIMD-регистры. В наших экспериментах на ARM NEON это позволило сократить время матричного умножения. Разберёмся, какой погрешностью приходится платить за ускорение, как она влияет на точность нейросетей и что удаётся восстановить дообучением.
Немного о 8-битном умножении на ARM NEON
Оптимизированное матричное умножение реализуется с помощью SIMD-инструкций (Single Instruction, Multiple Data), позволяющих одной командой параллельно обрабатывать несколько элементов, загруженных в регистры.
В архитектуре ARMv8-A содержится расширение NEON SIMD, включающее 32 регистра разрядностью 128 бит. Каждый регистр может содержать вектор, состоящий из 16 элементов по 8 бит (int8/uint8), 8 элементов по 16 бит (int16/uint16), 4 элемента по 32 бита (int32/uint32) и т. д.
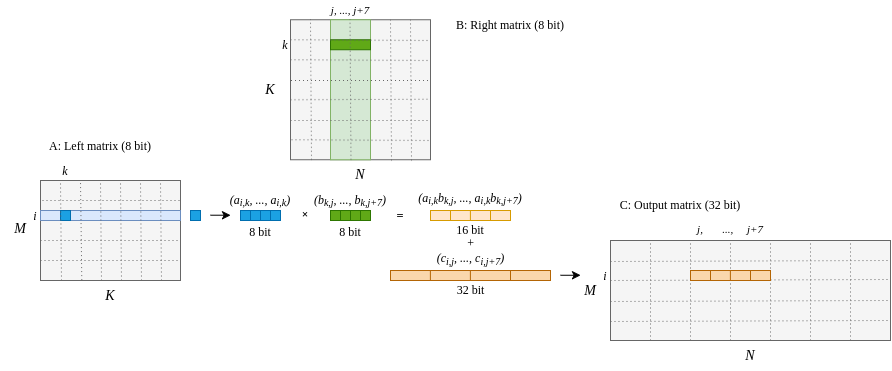
При реализации умножения матриц с использованием SIMD данные могут обрабатываться следующим образом (см. рисунок):
-
Значение
 (один скаляр из левой матрицы) дублируется во всех позициях вектора.
-
Загружается вектор из правой матрицы:
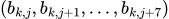 .
-
Выполняется поэлементное умножение двух векторов, в результате чего получается вектор из восьми 16-битных чисел.
-
Эти векторы накапливаются (суммируются) для всех значений
 .
-
Итоговый вектор записывается в элементы
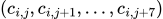 результирующей матрицы.
Если количество столбцов правой матрицы не кратно 8, для обработки оставшегося блока применяется отдельная процедура.
Для быстродействия правая матрица предварительно преобразуется в формат, оптимизированный для работы с кэш-памятью, чтобы минимизировать число промахов кэша при последовательном доступе к памяти [3].
Идея усредняющего умножения
При данной схеме матричного умножения возникает проблема: чтобы избежать переполнения, при суммировании 16-битных результатов умножения необходимо использовать 32-битный аккумулятор. Таким образом, в одном регистре будет помещаться четыре 32-битных элемента вместо восьми 16-битных.
Можно ли остаться в 16-битных значениях аккумулятора без переполнения?
Основная идея алгоритма заключается в использовании операций усреднения при сложении 16-битных чисел, что позволяет не выходить за пределы 16 бит и избежать переполнения. Для получения приближённого среднего значения слагаемые объединяются по схеме, напоминающей дерево или «ёлочку»: на каждом уровне вычисляются средние значения отдельных пар чисел, пока не останутся два значения, а затем — одно. Это устраняет необходимость в 32-битном аккумуляторе и обеспечивает более эффективное использование SIMD-регистров. Для получения приближённой суммы необходимо умножить полученную 16-битную матрицу на величину, соответствующую глубине умножения (количеству слагаемых). На этом этапе результат становится 32-битным.
На рисунке представлена схема такого сложения.
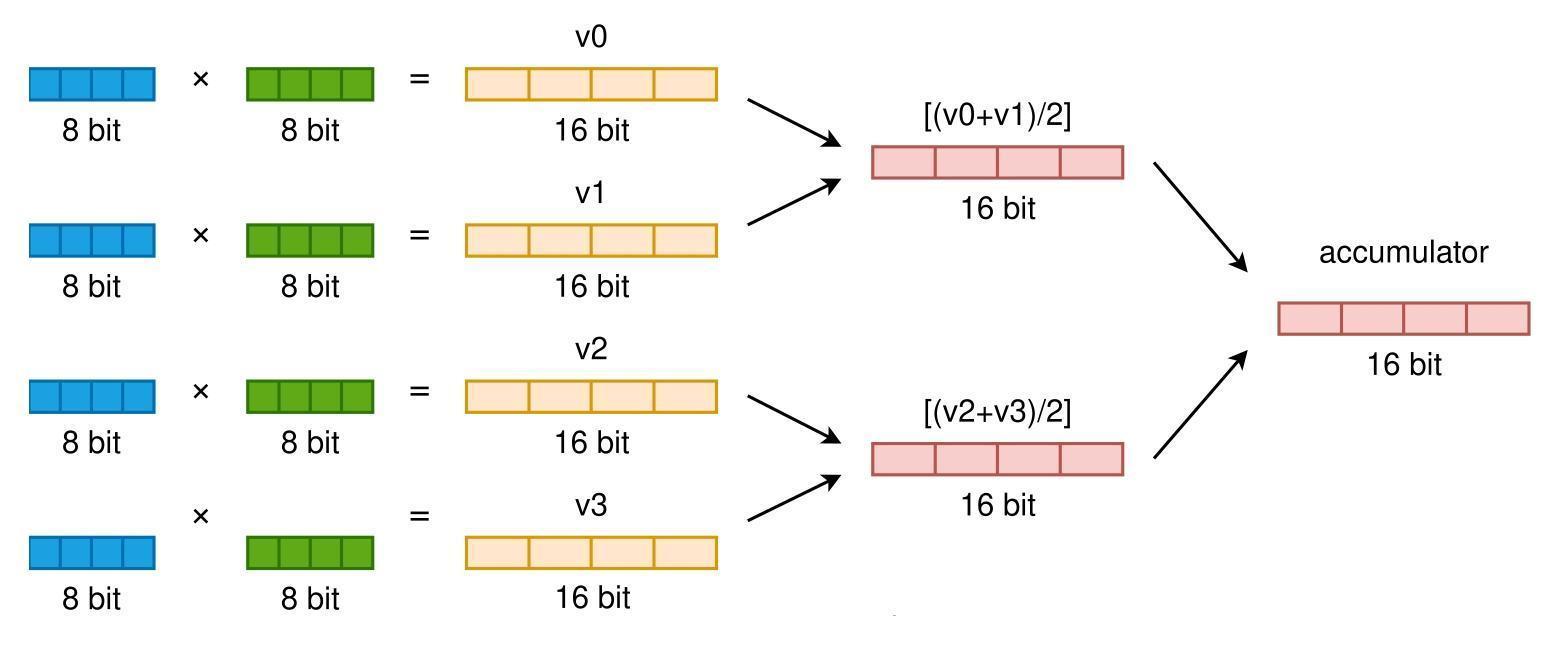
Это простейший случай, когда общее количество слагаемых представляет собой степень двойки.
Если количество слагаемых K не является степенью двойки, K необходимо разложить на сумму степеней двойки. Вычисляются соответствующие частичные деревья, а их результаты суммируются с весами. Дереву, содержащему k элементов, присваивается вес k. При больших значениях K количество операций с плавающей запятой невелико по сравнению с количеством целочисленных операций.
Этот алгоритм позволяет вычислить «целочисленное среднее» 16-битных чисел, при этом каждый регистр содержит не 4 элемента, а 8, что уменьшает в два раза количество операций сложения.
Насколько точным будет полученное среднее?
В каждом узле дерева среднее двух целых чисел вычисляется с округлением вниз:  , поэтому ошибка [4] одной операции усреднения составляет либо
 , либо
 .
Для оценки погрешности предложенного алгоритма предположим, что мы суммируем  скалярных величин
 для
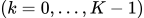 , и пусть
 – их сумма. Обозначим через
 результат работы алгоритма усреднения и определим приближенную сумму как
 .
Утверждение: пусть количество слагаемых равно  . Тогда абсолютная погрешность ограничена следующим образом:
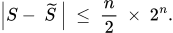
Это утверждение можно доказать методом математической индукции.
Рассмотрим теперь практическую оценку для нейронных сетей. При использовании 8-битного беззнакового квантования рассмотрим значения, сосредоточенные около 128. В таком случае средний результат матричного умножения для глубины  составляет приблизительно
 . Следовательно, оценка относительной ошибки при этих предположениях составляет
 , что при
 составляет менее 0,1%. На практике глубина умножения гораздо меньше, чем
 , поскольку она ограничена для исключения переполнения в стандартных 32-битных аккумуляторах.
Следует отметить, что это оценка ошибки для худшего случая при условии, что каждая операция сложения дает нечетную сумму; на практике такая ситуация вряд ли будет возникать часто.
Какая погрешность получилась на практике?
Для оценки численной точности результатов умножения использовалась метрика среднеквадратичной ошибки (RMSE), позволяющая сравнить результат умножения, полученный стандартным, точным методом, с результатом предложенного метода усредняющего умножения. Также была получена относительная погрешность, рассчитанная как RMSE, делённая на среднее значение элемента матрицы.
Входные матрицы заполнялись случайными значениями, взятыми из нормального распределения со средним значением 128 и малой дисперсией, что более характерно для квантованных весов нейронных сетей в реальных задачах, где нулевое значение веса в квантованном виде часто представляется значением, близким к 128.
Результаты представлены в таблице ниже.
|
Размер матрицы |
RMSE |
μmean × 10⁶ |
Относительная погрешность, % |
|
16×16 |
15,8 |
0,15 |
0,010% |
|
32×32 |
39,52 |
0,32 |
0,012% |
|
64×64 |
94,49 |
0,64 |
0,015% |
|
128×128 |
220,40 |
1,28 |
0,017% |
|
256×256 |
503,55 |
2,55 |
0,020% |
|
512×512 |
1133,44 |
5,11 |
0,022% |
|
1024×1024 |
2519,67 |
10,23 |
0,025% |
|
2048×2048 |
5546,71 |
20,48 |
0,027% |
В рассмотренных экспериментах относительная погрешность матричного умножения не превышала 0,05%. Однако малая погрешность этой операции сама по себе ещё не гарантирует сохранения точности нейросети: её влияние на итоговое качество проверим отдельно.
Также следует отметить, что наблюдаемая средняя погрешность значительно ниже теоретически возможного максимального отклонения, рассчитанного ранее для данного алгоритма.
Как это повлияет на точность нейросетей?
Для оценки влияния предложенного метода на точность нейронных сетей мы реализовали модифицированную версию слоя nn.Conv2d в среде PyTorch. Входные данные и веса масштабировались к диапазону [0, 255], соответствующему беззнаковому 8-битному квантованию, а операция свертки представлялась в виде матричного умножения по алгоритму im2col.
Мы рассматривали сверточные нейронные модели для задач классификации.
Эксперименты проводились с использованием следующих архитектур нейронных сетей:
-
LeNet-5 для датасета MNIST;
-
ResNet-20;
-
DenseNet-40 для датасета CIFAR-10.
Следует отметить, что в квантованных нейронных сетях для обеспечения высокой вычислительной эффективности обычно применяются кусочно-линейные функции активации. В рассматриваемых моделях используются функции активации ReLU.
Мы обучили нейронные модели и выполнили их квантование с использованием метода Straight-Through Estimator. Затем сравнивалась точность моделей при использовании стандартного 8-битного матричного умножения и предложенного алгоритма матричного умножения на основе усреднения по дереву.
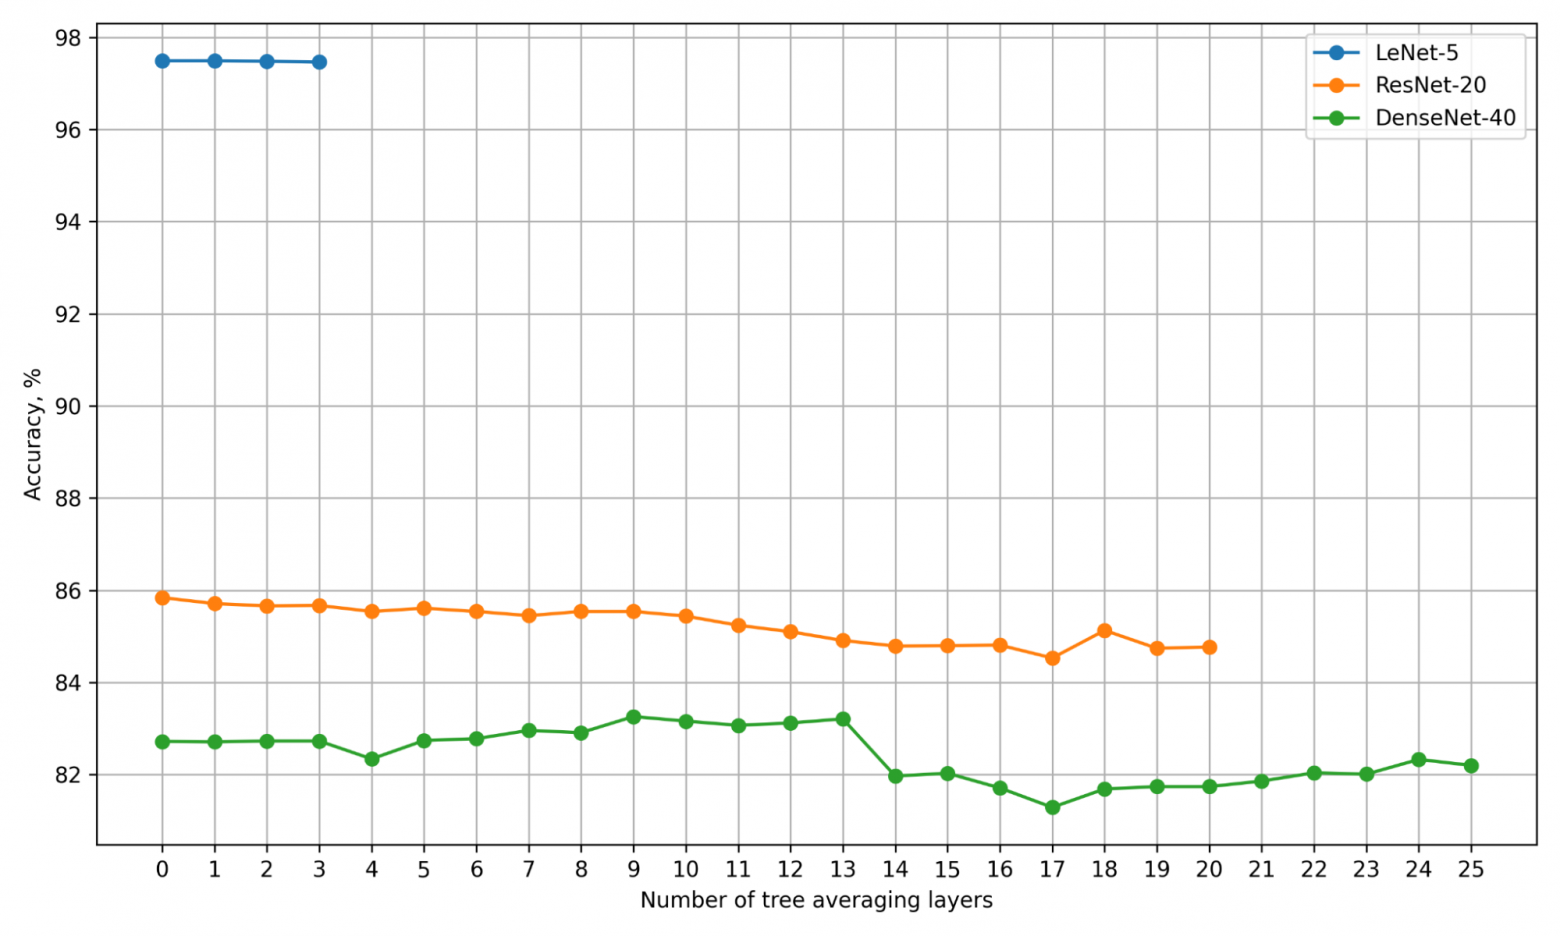
Мы постепенно, слой за слоем, заменяли стандартный свёрточный слой на усредняющий свёрточный слой, пока не заменили все свёрточные слои модели. Эксперимент показал, что итоговая точность модели отличается от начальной не более чем на 1%. На рисунке изображён график точностей этих моделей по мере замены каждого последующего слоя.
Наконец, мы провели эксперимент по дообучению (fine-tuning), чтобы компенсировать снижение точности. При дообучении использовали Straight-Through Estimator (STE). Для моделей LeNet-5, ResNet-20 и DenseNet-40 оказалось достаточно даже одной эпохи дообучения, чтобы восстановить и даже превзойти исходные показатели точности. В таблице представлены значения точности моделей до замены операции, после перехода к матричному умножению на основе усреднения по дереву и после дообучения.
|
Модель |
Датасет |
Стандартное 8-битное умножение, % |
Усреднение по дереву (без дообучения), % |
Усреднение по дереву (после дообучения), % |
|
LeNet-5 |
MNIST |
98,34 |
98,30 |
98,43 |
|
ResNet-20 |
CIFAR-10 |
85,77 |
84,77 |
85,83 |
|
DenseNet-40 |
CIFAR-10 |
82,72 |
82,24 |
83,67 |
Что насчёт ускорения?
Для оценки производительности предложенного алгоритма мы реализовали на C++ с использованием NEON-интринсиков для архитектуры ARM его упрощённый вариант для матриц с глубиной умножения  . Скорость работы сравнивалась со стандартным 8-битным квантованным матричным умножением с накоплением результата в 32-битных регистрах, также оптимизированным с использованием NEON. Для измерения среднего времени работы каждая конфигурация запускалась 30 раз.
|
Размер матрицы |
Стандартное умножение, мс |
Усреднение по дереву, мс |
Ускорение |
|
16×16 |
0,0014 |
0,0010 |
1,41× |
|
32×32 |
0,009 |
0,006 |
1,45× |
|
64×64 |
0,056 |
0,035 |
1,45× |
|
128×128 |
0,36 |
0,27 |
1,28× |
|
256×256 |
2,78 |
2,26 |
1,25× |
|
512×512 |
21,82 |
17,04 |
1,27× |
|
1024×1024 |
174 |
134 |
1,28× |
|
2048×2048 |
1391 |
1077 |
1,29× |
Результаты представлены в таблице выше. Во всех рассмотренных конфигурациях схема с усреднением по дереву и использованием NEON-интринсиков сократила среднее время вычислений по сравнению со стандартной 8-битной реализацией.
Ускорение при использовании предложенного метода в реальных целочисленных нейронных сетях зависит от размеров перемножаемых матриц, способа упаковки и доступа к данным, архитектуры используемого микроядра, а также накладных расходов, возникающих при обработке матриц произвольного размера. Поэтому оценка влияния предложенного метода на производительность полноценного нейросетевого инференса требует дополнительных экспериментов.
Зачем всё это
Усредняющее умножение даёт ещё одну возможность ускорять квантованные нейросети: менять не только разрядность весов и входных данных, но и точность промежуточных вычислений.
Для задач, которые мы решаем в Smart Document Engine [2], смысл подобных исследований вполне конкретен: расширять возможности распознавания в пределах вычислительных ресурсов доступного устройства. Сэкономленное время можно использовать для более сложной обработки документа или просто сократить ожидание пользователя. Поэтому нам важно понимать, где точность промежуточной арифметики действительно необходима для качества распознавания, а где её небольшой частью можно распорядиться с большей пользой. Иногда для следующего шага в ускорении стоит заново посмотреть даже на такую привычную операцию, как сложение.
Автор: SmartEngines
Источник [5]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36703
URLs in this post:
[1] распознать документ на смартфоне: https://smartengines.ru/platform/smart-engines-mobile-ocr-sdk/
[2] системы распознавания и анализа документов: https://smartengines.ru/intelligent-document-recognition/
[3] памяти: http://www.braintools.ru/article/4140
[4] ошибка: http://www.braintools.ru/article/4192
[5] Источник: https://habr.com/ru/companies/smartengines/articles/1092088/?utm_campaign=1092088&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.