Как мы развиваем агентный сервис для работы с аналитическими данными
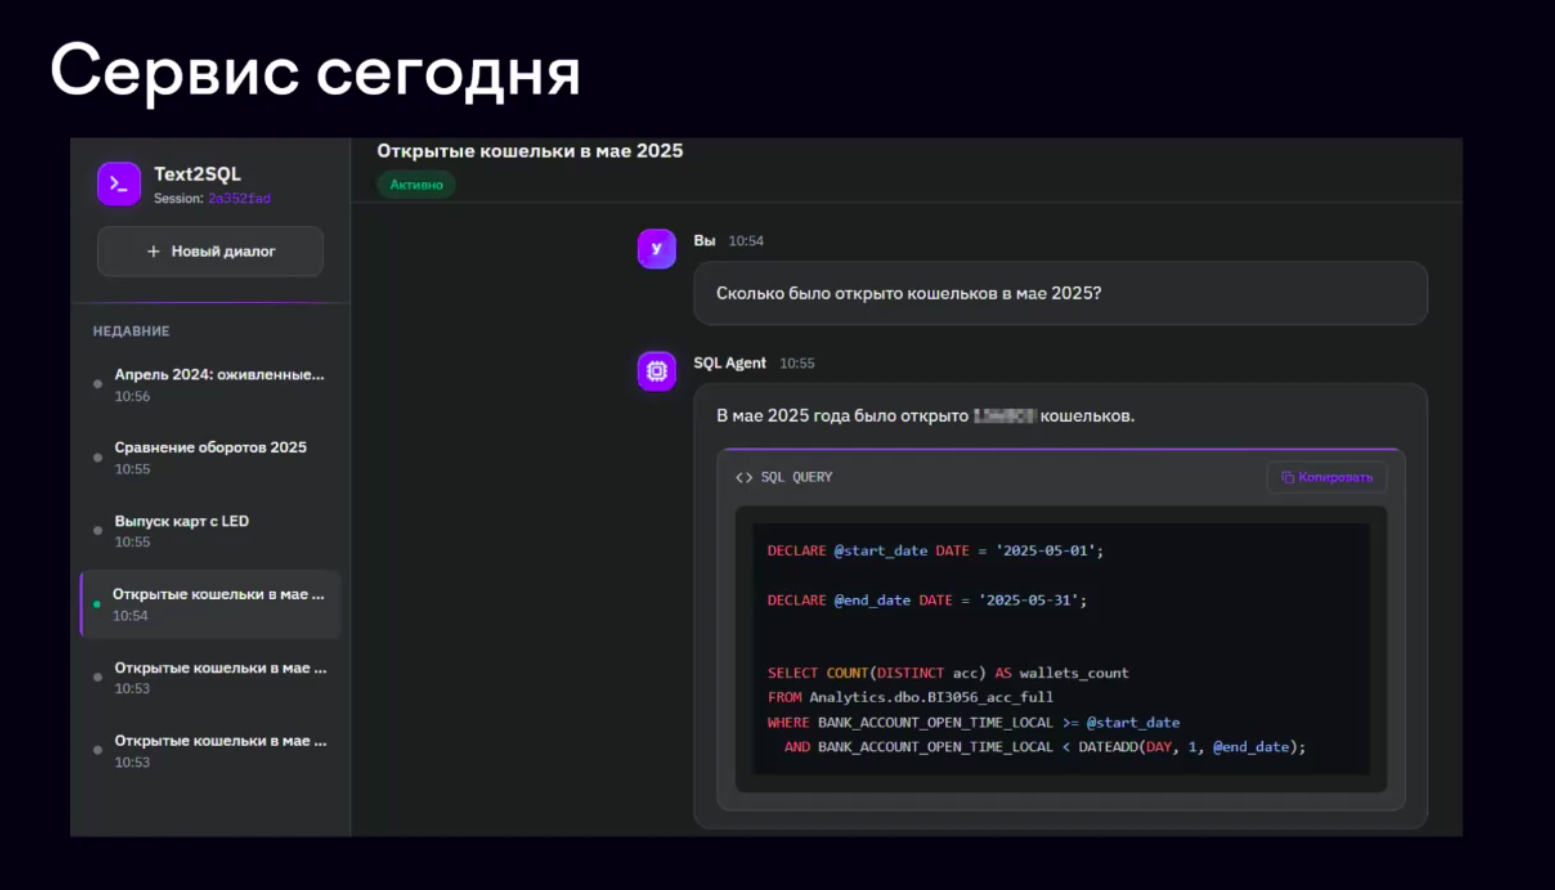
Привет! Меня зовут Артём, я старший аналитик данных в ЮMoney. Расскажу о проекте, который вырос из внутреннего хакатона [1], — Text2SQL-сервисе. В нём пользователь задаёт вопрос на обычном русском языке, а система сама находит нужные данные, пишет SQL-запрос, проверяет и выполняет его, после чего возвращает ответ: текст, таблицу, Excel-файл или график. Идея для бизнеса простая: зачем ждать, пока аналитик освободится, если ответ на типовой вопрос можно получить прямо сейчас?
Материал будет полезен продакт-менеджерам, маркетологам и всем, кто работает с данными, но не хочет погружаться в SQL, а также разработчикам и аналитикам, которые задумываются о подобных инструментах у себя.
Зачем нужен такой сервис
Ситуация знакомая: у аналитиков много задач, а вопросы всё поступают. Взяться за всё сразу невозможно, поэтому растёт очередь. При этом дашборды не всегда дают нужную детализацию. Мы решили пойти другим путём. Пользователь задаёт вопрос, а система сама:
-
понимает, о чём вопрос, с учётом истории диалога;
-
определяет предметную область и нужные таблицы;
-
формирует SQL-запрос и проверяет его до выполнения;
-
выполняет запрос и оценивает результат;
-
возвращает ответ в удобной форме.
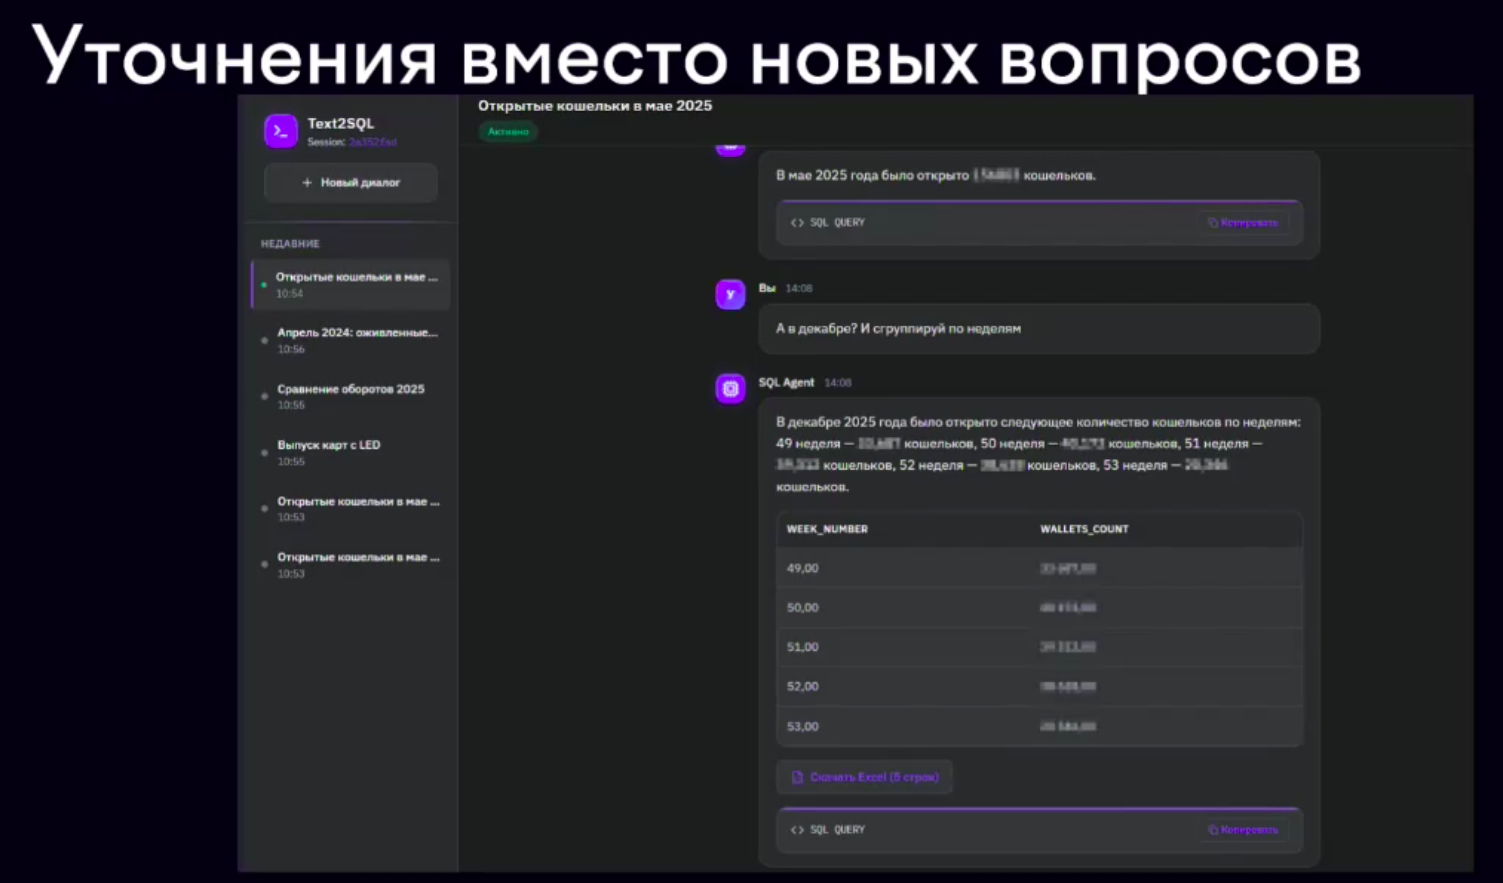
Сервис поддерживает диалоги. Можно спросить, сколько кошельков открыли в мае, а потом уточнить: «А в декабре? И сгруппируй по неделям». Система поймёт, к чему относится уточнение, и сформирует новый запрос. В начале нового диалога пользователь может выбрать режим B2B/B2C или специфичные сценарии, и тогда система будет искать ответ только среди тем этих направлений. По умолчанию включён автоматический режим, но явный выбор тем ускоряет работу пайплайна и уменьшает количество ошибок.
Почему LangGraph
Для реализации мы используем LangGraph. Он даёт главное, что нужно нам на данном этапе: предсказуемый и управляемый процесс вместо свободного агента. Пайплайн — это граф из узлов, через которые проходит единое состояние: вопрос, история диалога, найденные даты, выбранные таблицы, SQL и результат.
Граф нелинейный: в нём есть циклы. Система может вернуться к генерации SQL после ошибки [2], заново подобрать таблицы, если проверка сочла их недостаточными, или остановиться, задать пользователю уточняющий вопрос и после ответа продолжить с того же места. Весь процесс делится на две части: подготовку контекста и генерацию SQL.
У диалога два уровня памяти [3]. После каждого успешного шага сохраняется «снимок» последнего вопроса: тема, переформулированный запрос и выполненный SQL. Раз в несколько сообщений фоновая задача обновляет сжатое саммари всего диалога, включая накопленные фильтры и ключевые сущности.
Сначала нужно понять вопрос
Первый узел — Context Resolver — играет ключевую роль в диалоге. Если передавать модели всю историю общения, она начинает путаться. Поэтому каждый новый вопрос сначала переформулируется в самостоятельный. Например, пользователь спрашивает: «Сколько кошельков открыто в мае 2025?», а затем уточняет: «А в декабре, по неделям?». Resolver превращает уточнение в полноценный запрос, и дальше система работает уже с ним. Так мы сокращаем контекст и можем проверить, правильно ли система поняла пользователя.
С этим связана одна поучительная история. Мы реализовали «петлю доверия»: если новый вопрос почти совпадал с предыдущим (например, менялась только дата), определение темы пропускалось ради скорости. На практике оказалось, что это маскирует скрытые смены темы, а цена такой ошибки выше, чем выигрыш во времени. Поэтому теперь каждый вопрос проходит определение темы заново.
Определяем тему
Система выясняет, к какой предметной области относится вопрос. Темы могут пересекаться: например, вопрос о кошельке нередко затрагивает и карты. Первыми в дело вступают правила: регулярные выражения с ключевыми словами и их весами. Затем подключается LLM-классификатор, и результаты объединяются. Если в выбранном направлении осталась всего одна тема, модель не вызывается вовсе. Если же правила и модель расходятся, система не выбирает наугад, а переспрашивает пользователя. Так же она поступает, когда для диалога выбран режим B2C, а запрос явно относится к B2B.
Нормализация дат
Небольшим LLM сложно единообразно интерпретировать даты, поэтому временной диапазон извлекается из вопроса и приводится к формату ISO ещё до генерации SQL. Модель находит в тексте периоды («май 2025», «прошлый месяц», «с начала года по март»), а Python-код их уточняет: ставит последний день месяца с учётом високосного года, исправляет несуществующие даты (например, 30 февраля), вычисляет «последние N дней» и «прошлую неделю» с понедельника по воскресенье. В итоге на этапе генерации SQL модель получает готовые значения.
Когда вопрос неоднозначен или данных нет
Отдельный узел проверяет, допускает ли вопрос двоякое толкование. Например, на запрос «Сколько карт выпустили пользователи кошелька?» система спросит, что анализировать: карты или кошельки. Переспрашивает она, только если от этого зависит выбор предметной области или бизнес-сущности. Ответить можно номером варианта или свободным текстом. Чтобы диалог не превратился в бесконечные расспросы, после нескольких уточнений подряд система отвечает на основе того, что уже известно.
Неоднозначность не равна нехватке данных. Если на имеющихся данных ответить невозможно, система честно об этом сообщает. Этот сценарий намеренно не зависит от настроек уточнений: иначе при их выключении сервис начал бы выдумывать ответы.
Выбираем таблицы
Определив тему, LLM решает, какие таблицы понадобятся для ответа. Полностью доверять модели нельзя: она может выбрать основную таблицу, но упустить связанные справочники. Поэтому обязательные связи добавляются детерминированно. Если в описании указано, что таблица зависит от базовой, та подтягивается автоматически вместе с ключами для джойнов.
Каждая таблица сопровождается кратким описанием: какие данные она содержит и для чего используется. На выходе получаем список таблиц, связи между ними и поля для выборки, фильтрации и группировки.
Собираем контекст
К вопросу, теме, датам и таблицам добавляются инструкции предметной области и примеры запросов. Первые подсказывают модели, какие поля и фильтры применять, вторые помогают точнее сформировать SQL.
Инструкции по темам занимают сотни строк, хотя конкретному вопросу обычно нужна лишь малая их часть. Поэтому мы сокращаем контекст: оставляем только колонки схемы, нужные по плану выбора таблиц, и правила, относящиеся к вопросу. Делаем это осторожно: колонки с датами и колонки для джойнов со справочниками и другими таблицами сохраняются всегда, а при повторной генерации модель снова получает полную схему.
Генерируем и проверяем SQL
LLM получает подготовленный контекст и возвращает SQL-код с объяснением логики и оценкой уверенности. Затем запрос проходит обязательные проверки, которые не отключаются никакими настройками:
-
приводим SQL к единому формату;
-
проверяем на деструктивные операции (DROP TABLE, DELETE FROM, TRUNCATE, ALTER TABLE, UPDATE) и требуем наличие SELECT;
-
компилируем запрос в MS SQL Server в режиме SET NOEXEC ON: сервер валидирует синтаксис и наличие таблиц и колонок, но ничего не выполняет.
При ошибке запрос вместе с её текстом возвращается SQL-генератору, по умолчанию до трёх попыток. Если бюджет ретраев исчерпан, система по-человечески объясняет пользователю, что пошло не так и как переформулировать вопрос.
Синтаксически верный — не значит правильный
Самый дорогой класс ошибок в Text2SQL — корректный запрос, который отвечает не на тот вопрос. БД не выдаёт ошибку, а пользователь получает правдоподобное, но неверное число. Чтобы ловить такие случаи, мы построили четырёхслойную подсистему валидации:
-
детерминированные проверки текста SQL без обращения к модели: значение фильтра, которого нет в справочнике (самый частый содержательный промах генерации), потерянный период, агрегат без GROUP BY, разбивка «по месяцам» без группировки и так далее;
-
анализ плана: можно ли выбранными таблицами и полями вообще ответить на вопрос. Если нет, замечания возвращаются на этап выбора таблиц;
-
смысловая проверка SQL: отвечает ли запрос на заданный вопрос (при необходимости — по доменному чек-листу правил);
-
контроль фактического результата: пустая выборка, одни NULL, одна строка вместо запрошенной разбивки, размножение строк из-за соединения по неполному ключу, отрицательные суммы там, где их быть не может.
Превращаем результат в понятный ответ
Выполнив запрос, мы получаем датасет, который нужно подготовить для двух адресатов: пользователя и модели, формулирующей ответ. Модели передаётся выборка строк в JSON, а не таблица с выравниванием пробелами: в такой таблице модель регулярно путает, к какой колонке относится число. Вместе с выборкой передаются итоги, минимумы и максимумы, посчитанные по полному набору данных. Значения сразу форматируются по-русски: скопировать готовую строку модель умеет надёжнее, чем отформатировать число сама.
Пользователь видит текст ответа, а в зависимости от вида данных — ещё таблицу в чате (если она укладывается в заданные рамки), ссылку на Excel с полной выгрузкой и график. Если ответ — одно число, достаточно текста.
Графики
Тип графика и раскладку колонок по осям определяют правила, а если они не справились, подключается языковая модель. Типовые случаи вроде динамики по датам или топа по категориям обходятся без LLM, нестандартные тоже получают визуализацию.
Ключевой момент: значения на графике берутся только из результата запроса, ни правила, ни модель в формировании чисел не участвуют. Ошибка подбора может дать неудачный график, но никогда — неверные цифры. Если модель ссылается на несуществующую колонку, её ответ отклоняется ещё на этапе проверки.
Основные принципы:
-
номера месяцев, недель и кварталов распознаются как периоды: метрикой они быть не могут, зато становятся лучшей осью X. Без этого самый частый запрос «сумма по номеру месяца» остался бы без графика;
-
идентификаторы и коды не суммируются, иначе получился бы график «сумма id по месяцам»;
-
метрики разного порядка не смешиваются на одной оси; у каждого типа графика свой лимит точек, а при обрезке интерфейс честно пишет «показаны первые N из M»;
-
график строится параллельно с текстовым ответом, не добавляет задержки и при сбое не роняет его: оформление не повод терять суть.
На фронтенде графики рисуются через Chart.js.
Как мы наблюдаем за процессом
Пользователь видит ход обработки в реальном времени — вертикальную трассу шагов с длительностью каждого. Разработчикам доступен Langfuse: сгенерированный SQL, объяснение модели, уверенность, число повторных попыток, ошибки валидации, финальный ответ. Но трассировки вызовов моделей оказалось недостаточно. В пайплайне десятки мест, где результат может незаметно потеряться: эвристика не подобрала график, список примеров оказался пустым, колонка данных отброшена. Снаружи всё выглядит одинаково — «график не построился», а причин может быть десять, и ни одна не записана.
Поэтому мы добавили след решений — структурированную запись каждой точки возможного тихого сбоя. Фиксируем четыре типа событий:
-
ветвление — код пошёл по ветке, которая изменила результат или привела к его отсутствию;
-
подавленное исключение — ошибка перехвачена и не уронила запрос, но раньше бесследно уходила в except: pass;
-
отбраковка данных — строка или колонка не прошла проверку и была исключена;
-
замер — сколько строк, токенов, миллисекунд.
Каждая запись уходит сразу в три места: в обычный лог, в трейс Langfuse и в ответ тестового прогона. Но в дерево трейса отправляется не всё: замеры и отбраковка дублировали бы там существующие спаны — у генерации и так есть длительность и токены. В трейс попадают только ветвления и подавленные ошибки — то, чего в спанах нет.
Запросы, которые внешне прошли успешно, но содержат подавленные ошибки, помечаются отдельным тегом. По нему в один клик находятся все «тихие» проблемы за период — иначе пришлось бы открывать каждый трейс вручную.
Самая большая боль: тестирование
Тестирование Text2SQL по-прежнему остаётся одной из самых трудоёмких частей проекта. Раньше мы просто сверяли результаты выполнения с эталонными парами «вопрос — SQL», а спорные случаи отдавали LLM-судье. Теперь это переросло в самостоятельный инструмент.
Мы добавили отдельный контур экспериментов. Специальный эндпоинт позволяет на один прогон подменить поведение [4] подсистем (включить слои валидации, сменить режим графиков) или содержимое ресурсов (промпты, инструкции, схемы, примеры, параметры моделей). Можно даже подключить «виртуальную» тему и проверить новую предметную область до того, как файлы попадут в репозиторий.
Поверх этого работает тестовый набор:
-
сравнение с эталоном по результату, а не по тексту SQL. Имена и порядок колонок не важны, лишняя справочная колонка допустима, а вот разбивка по дням вместо итога — уже другой ответ. Числа нормализуются (3 700 и 3700 — одно значение), но большие счётчики не склеиваются округлением;
-
негативные вопросы, на которые правильный ответ — честный отказ, и отдельная проверка на выдуманные числа;
-
LLM-судья для спорных случаев. Если его вердикт расходится с автоматической сверкой, кейс уходит в очередь ручной разметки. Ручной вердикт меняет итоговую метрику, а закрыть провал без комментария нельзя;
-
многошаговые сценарии с уточнениями. Ответы на уточняющие вопросы хранятся в банке и переиспользуются между прогонами. Кейсы, ожидающие ответа, не засчитываются ни в верные, ни в неверные. «Верно сразу» и «верно после уточнения» — разное качество, а доля уточнений — отдельная метрика;
-
матрицы экспериментов: один набор вопросов прогоняется при разных конфигурациях, промптах и инструкциях, а отчёт показывает, какие сочетания работают лучше.
Полностью убрать человека из процесса пока не удаётся, да мы к этому и не стремимся: часть результатов всё ещё проверяется вручную. Но теперь ручная работа сосредоточена на действительно спорных случаях.
Что дальше
Мы видим три направления, и каждое логично [5] вытекает из уже построенного:
-
Удешевление добавления новых областей. Сейчас под каждую новую тему вручную готовятся таблицы, инструкции, примеры и тестовые вопросы. Виртуальные темы упростили проверку, но не подготовку. Поэтому мы смотрим в сторону дата-каталога и истории тикетов в Jira: там накоплено много бизнес-знаний вместе с готовыми SQL. В идеале система сама найдёт похожий тикет, адаптирует параметры и отправит результат аналитику на ревью.
-
Точечная автономность вместо свободного агента. Например, если данные не нашлись, агент ищет другие таблицы или выявляет пробелы в описаниях. Другой сценарий — сложная аналитика поверх готовой выгрузки: пользователь получил таблицу и просит посчитать отклонение или построить прогноз, а агент, как мини-аналитик, пишет для этого Python-код.
-
От «ответа на вопрос» к «решению задачи». Конечная цель — дата-агент, который справляется не с одним простым вопросом, а с многоэтапной аналитической задачей.
Всё это мы будем внедрять постепенно и только там, где сможем честно проверить результат: измерить, прогнать через тесты и убедиться, что ответы действительно стали точнее. Добавить агента несложно — сложно понять, стало ли от этого лучше. Если ответить на этот вопрос нечем, такой агент нам не нужен, как бы современно это ни выглядело.
Автор: AMyrkin
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37085
URLs in this post:
[1] внутреннего хакатона: https://habr.com/ru/companies/yoomoney/articles/874242/
[2] ошибки: http://www.braintools.ru/article/4192
[3] памяти: http://www.braintools.ru/article/4140
[4] поведение: http://www.braintools.ru/article/9372
[5] логично: http://www.braintools.ru/article/7640
[6] Источник: https://habr.com/ru/companies/yoomoney/articles/1095462/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1095462
Нажмите здесь для печати.