Как я собрал модель для определения стадии диабетической ретинопатии на бесплатном Colab
Предыстория
Я собрал двухпоточную модель: она смотрит на снимок глазного дна и одновременно получает клинические показатели пациента. На отложенном тесте первый запуск дал QWK 0.834. Потом я стал разбираться, за счёт чего, и оказалось, что клинические признаки в моих данных содержат ответ. Я поставил три контрольных эксперимента, в том числе обучил отдельную модель только по снимкам. У неё QWK 0.713. Ниже весь пайплайн и способы, которыми такая утечка находится.
Анализ
В RetinaMNIST есть только снимки, анализов там нет. Я сгенерировал их по формуле, в которую входила истинная стадия болезни, и сеть научилась читать эту подсказку. Результаты на тесте из 400 снимков:
|
Модель |
QWK |
Macro AUC |
|---|---|---|
|
Логистическая регрессия только по синтетическим признакам, без снимка |
0.8163 |
0.8823 |
|
Двухпоточная сеть, признаки с утечкой |
0.8340 |
0.8588 |
|
Двухпоточная сеть с обнулённым табличным входом (неверный baseline) |
0.4502 |
0.7774 |
|
EfficientNet-B2, обученный отдельно только на снимках |
0.7129 |
0.8070 |
Регрессия, не видевшая ни одного пикселя, почти догоняет двухпоточную сеть по QWK и обгоняет её по AUC. По снимкам модель на самом деле даёт QWK около 0.71.
Зачем второй поток
Врач не оценивает снимок в отрыве от пациента: он смотрит на гликированный гемоглобин (HbA1c), стаж диабета, давление. Кроме того, фундус-камеры дают неравномерную засветку, а без карты внимания [1] непонятно, на что отреагировала сеть: на экссудат или на пылинку на объективе. Отсюда план: препроцессинг, который подчёркивает сосуды и очаги, второй вход для клинических данных и Grad-CAM для объяснения.
Сам план нормальный. Подвели данные, на которых я его проверял.
Данные
Я взял RetinaMNIST из MedMNIST: 1600 снимков глазного дна из соревнования DeepDRiD, пять стадий по шкале ICDR, версия 224×224 с готовыми сплитами.
-
DR 0: признаков ретинопатии нет
-
DR 1: лёгкая непролиферативная
-
DR 2: умеренная непролиферативная
-
DR 3: тяжёлая непролиферативная
-
DR 4: пролиферативная
Сплиты: train 1080, validation 120, test 400. Классы несбалансированы: в тесте 174 снимка DR 0 и всего 20 снимков DR 4.
pythonfrom medmnist import RetinaMNIST

train_data = RetinaMNIST(split="train", download=True, size=224)
val_data   = RetinaMNIST(split="val",   download=True, size=224)
test_data  = RetinaMNIST(split="test",  download=True, size=224)
from medmnist import RetinaMNIST train_data = RetinaMNIST(split="train", download=True, size=224) val_data = RetinaMNIST(split="val", download=True, size=224) test_data = RetinaMNIST(split="test", download=True, size=224)
В ноутбуке перед этим стоит попытка загрузить APTOS 2019 через kagglehub. В моём запуске она не сработала, код перешёл на RetinaMNIST, и все цифры в статье получены на нём.
Препроцессинг: Бен Грэм и CLAHE
Чтобы убрать неравномерную засветку, из снимка вычитается его же копия, размытая гауссовым фильтром. Этот приём использовал победитель соревнования Kaggle Diabetic Retinopathy Detection:
textI_enh = 4 * I - 4 * G_sigma(I) + 128I_enh = 4 I - 4 G_sigma(I) + 128
Плавный градиент яркости уходит, а сосуды, геморрагии и экссудаты остаются. Потом CLAHE по каналу яркости в пространстве LAB:
pythondef apply_ben_graham_preprocessing(image_np, size=224, sigmaX=10):
    img = cv2.resize(image_np, (size, size))
    mask = np.zeros((size, size), dtype=np.uint8)
    cv2.circle(mask, (size // 2, size // 2), int(size * 0.46), 255, -1)

    blurred = cv2.GaussianBlur(img, (0, 0), sigmaX)
    enhanced = cv2.addWeighted(img, 4, blurred, -4, 128)

    lab = cv2.cvtColor(enhanced, cv2.COLOR_RGB2LAB)
    l, a, b = cv2.split(lab)
    clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
    l = clahe.apply(l)
    enhanced = cv2.cvtColor(cv2.merge((l, a, b)), cv2.COLOR_LAB2RGB)
    return cv2.bitwise_and(enhanced, enhanced, mask=mask)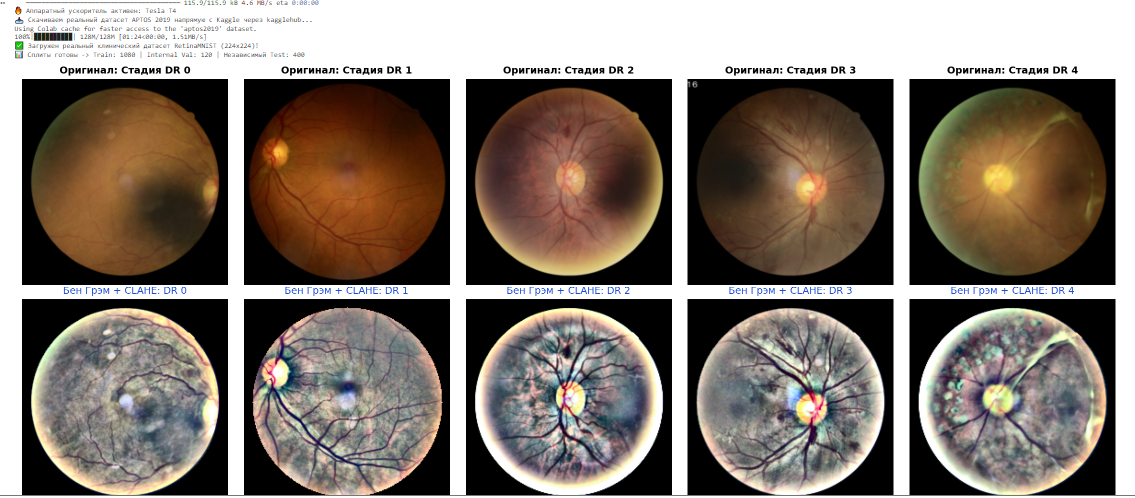
На стадиях DR 2–4 после фильтра на сером фоне видны тёмные кровоизлияния и светлые очаги экссудации.
Первая версия: двухпоточная сеть
Визуальный энкодер — efficientnet_b2 из timm. Табличная ветка переводит четыре нормализованных показателя (HbA1c, стаж диабета, систолическое давление, возраст) в 32-мерный вектор. Перед классификатором вектор снимка (1408 признаков) склеивается с табличным, получается 1440. На conv_head повешены хуки для Grad-CAM, в листинге ниже я их опустил.
pythonclass RetinaTwoStreamNet(nn.Module):
    def __init__(self, backbone_name="efficientnet_b2", num_classes=5, tabular_dim=4):
        super().__init__()
        self.backbone = timm.create_model(backbone_name, pretrained=True,
                                          num_classes=0, global_pool="")
        vision_dim = self.backbone.num_features  # 1408
        self.pool = nn.AdaptiveAvgPool2d(1)

        self.tabular_net = nn.Sequential(
            nn.Linear(tabular_dim, 32), nn.BatchNorm1d(32), nn.SiLU(),
            nn.Dropout(0.2), nn.Linear(32, 32), nn.SiLU()
        )
        self.classifier = nn.Sequential(
            nn.Linear(vision_dim + 32, 256), nn.BatchNorm1d(256), nn.SiLU(),
            nn.Dropout(0.35), nn.Linear(256, num_classes)
        )

    def forward(self, img_tensor, tab_tensor):
        v_emb = self.pool(self.backbone(img_tensor)).flatten(1)
        t_emb = self.tabular_net(tab_tensor)
        return self.classifier(torch.cat([v_emb, t_emb], dim=1))
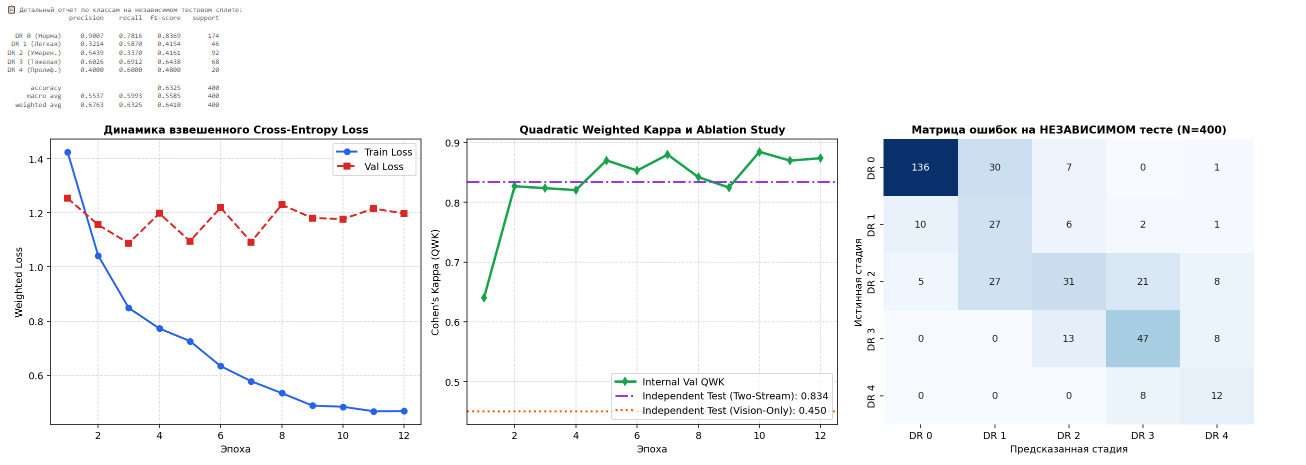
Обучение [2]: веса классов обратно пропорциональны их частоте в train, label_smoothing=0.05, AdamW с раздельными шагами (бэкбон 3e-4, табличная ветка и голова 1.2e-3), косинусное расписание, AMP FP16, аугментации Albumentations (повороты до 180°, флипы, яркость и контраст). 12 эпох на Tesla T4 заняли 184.9 секунды. Лучший чекпоинт выбран по валидационному QWK: 0.8844 на 10-й эпохе.
На тесте: QWK 0.8340, Macro AUC 0.8588, accuracy 0.6325.
.
Что не сходилось
Четыре числа на входе табличной ветки давали сети больше, чем 1408 визуальных признаков. Когда я обнулял табличный вход, QWK падал с 0.83 до 0.45. В реальной клинике HbA1c и стаж диабета связаны с риском ретинопатии, но текущую стадию по ним не определить: она видна на снимке. Столь большой вклад четырёх чисел выглядел странно, и я вернулся к тому, как эти числа получены.
Откуда взялись «анализы»
Клинических данных в RetinaMNIST нет, поэтому датасет генерировал их сам:
pythondef _sample_clinical_ehr(self, stage, idx):
    rng = np.random if self.is_train else np.random.RandomState(idx + 5000)
    hba1c    = np.clip(5.9 + stage * 0.85 + rng.normal(0, 1.15), 4.5, 14.5)
    duration = np.clip(2.5 + stage * 3.1  + rng.normal(0, 3.8),  0.0, 35.0)
    sys_bp   = np.clip(122 + stage * 6.5  + rng.normal(0, 12.0), 90.0, 200.0)
    age      = np.clip(46 + stage * 3.5   + rng.normal(0, 9.5),  20.0, 88.0)
    return torch.tensor([(hba1c - 6.0) / 5.0, duration / 20.0,
                         (sys_bp - 120.0) / 40.0, (age - 50.0) / 25.0])
На вход функции подаётся stage, то есть истинная метка, а признаки получаются из неё линейно с добавлением гауссова шума. Я хотел «реалистичную корреляцию со стадией», а получил утечку метки. Причём на тесте тоже: тестовые признаки строятся по тестовым меткам. Сети не нужно учиться по снимку, ей достаточно прочитать четыре числа.
На train шум к тому же пересэмплируется при каждом обращении к примеру, потому что там используется глобальный np.random. Получается аугментация табличных признаков, и сеть учится вытаскивать стадию из любой зашумлённой версии подсказки.
Три контрольных эксперимента
1. Логистическая регрессия только по синтетическим признакам
Если снимок не нужен, модель без снимка должна дать сопоставимый результат. Признаки генерируются по тем же формулам, тестовые с теми же сидами idx + 5000:
pythonclf_leak = LogisticRegression(max_iter=500)
clf_leak.fit(X_tab_train, y_train)
leak_preds = clf_leak.predict(X_tab_test)
leak_probs = clf_leak.predict_proba(X_tab_test)

leak_qwk = cohen_kappa_score(y_test, leak_preds, weights="quadratic")
leak_auc = roc_auc_score(y_test, leak_probs, multi_class="ovr", average="macro")
clf_leak = LogisticRegression(max_iter=500) clf_leak.fit [3](X_tab_train, y_train) leak_preds = clf_leak.predict(X_tab_test) leak_probs = clf_leak.predict_proba(X_tab_test) leak_qwk = cohen_kappa_score(y_test, leak_preds, weights="quadratic") leak_auc = roc_auc_score(y_test, leak_probs, multi_class="ovr", average="macro")
QWK 0.8163, Macro AUC 0.8823. Линейная модель по четырём числам почти равна двухпоточной сети по QWK и выше неё по AUC. Других доказательств утечки уже не требуется.
2. Обнуление табличного входа
QWK 0.4502, AUC 0.7774. Сначала я считал это «качеством без анализов», и это была ошибка [4]. Модель обучалась с табличным входом, и нулевой вектор для неё — вход из другого распределения. Так измеряется сломанная модель, а не качество по снимкам.
3. Отдельная модель только по снимкам
Правильный baseline: тот же efficientnet_b2 с весами ImageNet, стандартная голова timm (пулинг и линейный слой), табличной ветки нет. Препроцессинг, аугментации, веса классов и label_smoothing те же, но learning rate один, 3e-4, с косинусным расписанием на 12 эпох.
pythonclass HonestVisionOnlyNet(nn.Module):
    def __init__(self, backbone_name="efficientnet_b2", num_classes=5):
        super().__init__()
        self.backbone = timm.create_model(backbone_name, pretrained=True,
                                          num_classes=num_classes)

    def forward(self, img_tensor):
        return self.backbone(img_tensor)

optimizer = torch.optim.AdamW(honest_model.parameters(), lr=3e-4, weight_decay=1e-2)
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=12)
criterion = nn.CrossEntropyLoss(weight=class_weights, label_smoothing=0.05)
class HonestVisionOnlyNet(nn.Module): def init(self, backbone_name="efficientnet_b2", num_classes=5): super().__init__() self.backbone = timm.create_model(backbone_name, pretrained=True, num_classes=num_classes) def forward(self, img_tensor): return self.backbone(img_tensor) optimizer = torch.optim.AdamW(honest_model.parameters(), lr=3e-4, weight_decay=1e-2) scheduler = torch.optim.lr [5]_scheduler.CosineAnnealingLR(optimizer, T_max=12) criterion = nn.CrossEntropyLoss(weight=class_weights, label_smoothing=0.05)
Обучение заняло 199.1 секунды. Лучший валидационный QWK 0.7555, на тесте QWK 0.7129, Macro AUC 0.8070, accuracy 0.5775.
Результаты модели по снимкам
|
Стадия |
Precision |
Recall |
F1 |
Support |
|---|---|---|---|---|
|
DR 0 (норма) |
0.8456 |
0.7241 |
0.7802 |
174 |
|
DR 1 (лёгкая) |
0.2933 |
0.4783 |
0.3636 |
46 |
|
DR 2 (умеренная) |
0.4444 |
0.3913 |
0.4162 |
92 |
|
DR 3 (тяжёлая) |
0.6349 |
0.5882 |
0.6107 |
68 |
|
DR 4 (пролиферативная) |
0.2188 |
0.3500 |
0.2692 |
20 |
Macro F1 0.4880, weighted F1 0.5942.
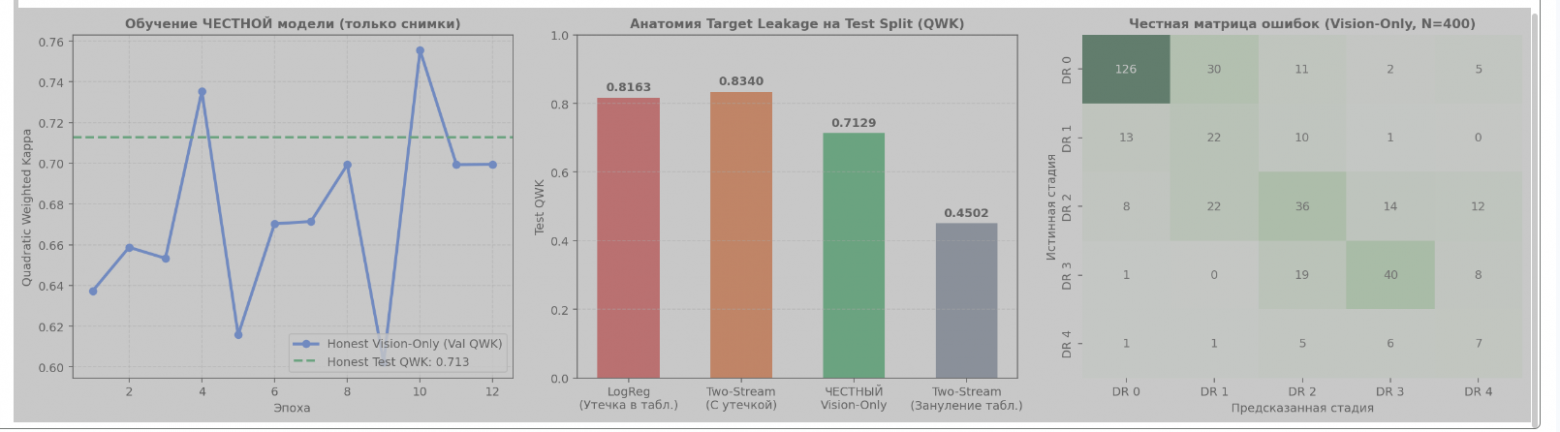
Норму и тяжёлую стадию сеть различает сносно. Хуже всего с пограничными и редкими стадиями: F1 у DR 1 всего 0.36, у DR 4 около 0.27. На 224×224 микроаневризма занимает несколько пикселей, так что многого здесь ждать не стоит.
Для ориентира: в бенчмарке MedMNIST+ на RetinaMNIST 224×224 при полном дообучении ResNet-18 получает accuracy 61.5% и AUC 0.832, EfficientNet-B4 — 52.4% и 0.738, лучший в таблице VGG16 — 64.2% и 0.878 (среднее по трём сидам). QWK авторы не приводят, а как усреднён AUC, не уточняют, поэтому сравнение приблизительное. Мои 57.75% и 0.807 попадают в этот диапазон, не выше.
Что из этого можно выводить, а что нельзя
Нельзя писать, что анализы «добавили 0.12 к QWK». Разница между 0.834 и 0.713 — это размер утечки: модель получила подсказку, которую я сам заложил в данные. Показательно, что по AUC двухпоточная сеть (0.8588) уступает регрессии по четырём числам (0.8823): при наличии подсказки снимок только мешал.
Можно писать, что на этом датасете EfficientNet-B2 с препроцессингом Бена Грэма даёт QWK около 0.71 по снимкам.
Ограничения эксперимента
-
Каждая модель обучена один раз, сиды PyTorch не зафиксированы. Двухпоточная сеть обучалась в другой ячейке ноутбука, и её цифры вписаны в сводную таблицу вручную.
-
Валидация из 120 снимков очень шумная: валидационный QWK честной модели скачет по эпохам от 0.60 до 0.76, поэтому выбор лучшей эпохи по нему во многом случаен. Тестовый QWK 0.7129 ниже лучшего валидационного 0.7555.
-
Классы DR 1 (46 снимков) и DR 4 (20 снимков) слишком малы, их метрики неустойчивы. Для серьёзных выводов нужны бутстреп-интервалы по тесту.
-
Baseline сравним с двухпоточной сетью не полностью: у него другая голова и один learning rate. Поэтому весь разрыв нельзя списать только на отсутствие таблицы, хотя первый эксперимент показывает, что основную часть даёт утечка.
-
Датасет маленький, метки отражают разметку конкретного набора. На другие камеры и популяции выводы не переносятся.
-
Демо-интерфейс на Gradio в ноутбуке до сих пор использует двухпоточную модель и подписан «Test QWK = 0.8340». Его тоже нужно переделать.
Как не повторить мою ошибку
-
Всегда считайте baseline только по таблице. Если он почти догоняет мультимодальную модель, второй поток подсказывает ответ, а не добавляет информацию.
-
Читайте код генерации признаков. Если в функцию передаётся метка, это утечка, как бы правдоподобно ни выглядели числа.
-
Не используйте обнуление входа как ablation. Для честного сравнения обучите отдельную модель без этого входа.
-
Перемешайте табличные признаки между пациентами на тесте. Если метрика мультимодальной модели резко падает, она опирается на таблицу как на подсказку.
-
С подозрением относитесь к слишком большому приросту. Скачок QWK с 0.45 до 0.83 из-за четырёх чисел должен был насторожить меня сразу.
Что дальше
-
Реальные парные данные, где снимок и клинические показатели относятся к одному пациенту. Из открытых наборов подходят бразильские BRSET (16 266 снимков от 8 524 пациентов: возраст, пол, стаж диабета, приём инсулина, стадия по ICDR) и mBRSET (5 164 снимка с портативных камер от 1 291 пациента с диабетом: возраст, пол, стаж диабета, инсулин, гипертензия [6]). HbA1c в описании их полей я не нашёл, а в BRSET стаж диабета заполнен только для пациентов с диабетом.
-
Разрешение 512×512, чтобы микроаневризмы на границе DR 1 и DR 2 занимали больше нескольких пикселей.
-
Порядковый лосс (CORAL или регрессия с порогами): стадии упорядочены, и обычная кросс-энтропия это не учитывает.
-
Бутстреп-интервалы и несколько сидов.
-
Grad-CAM для модели по снимкам: хуки на
conv_headуже написаны для двухпоточной сети, их нужно перенести вHonestVisionOnlyNet.
Прототип не является медицинским изделием и не должен использоваться для диагностики.
Вывод
Красивая метрика мультимодальной модели оказалась артефактом данных. Модель по снимкам даёт QWK 0.71 и слабо работает на пограничных стадиях. С этой цифры и стоит начинать следующие эксперименты, а не с 0.83. Если кому-то интересно поделюсь блокнотон
Автор: X_ray_ml
Источник [7]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37100
URLs in this post:
[1] внимания: http://www.braintools.ru/article/7595
[2] Обучение: http://www.braintools.ru/article/5125
[3] leak.fit: http://leak.fit
[4] ошибка: http://www.braintools.ru/article/4192
[5] torch.optim.lr: http://torch.optim.lr
[6] гипертензия: http://www.braintools.ru/article/3465
[7] Источник: https://habr.com/ru/articles/1095572/?utm_campaign=1095572&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.