Почему сэмплеры 4+ порядка взрываются в диффузии, и как мы это починили: история создания Flow-WLS
Любой, кто когда-либо открывал список сэмплеров в ComfyUI или WebUI, наверняка замечал странное единообразие. В выпадающем меню присутствуют Euler, Heun, DPM++ 2M, изредка DPM++ 3M — и на этом список порядков заканчивается.
Возникает закономерный вопрос: почему численные методы дифференциальных уравнений, развивавшиеся в прикладной математике [1] столетиями, в генеративных нейросетях застряли на втором и третьем порядке? Неужели нельзя взять метод Адамса-Башфорта 5-го, 6-го или 8-го порядка и получить сверхточную траекторию за меньшее число шагов?
Когда мы попытались напрямую реализовать многошаговые сэмплеры высших порядков для современных моделей Flow Matching (в частности, Anima DiT), генерация сразу же сломалась двумя разными способами: холст сначала выжигался в 90% белого цвета, а затем распадался на несвязный цифровой шум.
В этой статье подробно разберем:
-
Какая скрытая ловушка ждет разработчиков при переносе классических формул диффузии (EDM) на архитектуры Flow Matching.
-
Почему точная полиномиальная интерполяция Лагранжа порядка 5+ неизбежно разрушает латент.
-
Как мы применили идеи фильтрации Савицкого-Голея и взвешенных наименьших квадратов, создав метод Flow-WLS, генерирующий изображения за 10 шагов и 11 секунд на потребительской видеокарте.
1. Ловушка координат: почему экран становился белым
Первая же попытка запустить кастомный многошаговый сэмплер на модели Anima DiT привела к аномалии: VAE декодировал результат как равномерный белый прямоугольник с едва различимым силуэтом вверху.
Причина крылась в различии математических оснований между классическими моделями диффузии (Stable Diffusion 1.5, SDXL, EDM) и современными генераторами непрерывного потока (Flow Matching / DiT).
Классический EDM:
В моделях типа Karras EDM масштаб дисперсии данных  , а параметр времени выражается через логарифмическое отношение сигнал/шум:

Flow Matching (comfy.model_sampling.CONST):
В моделях выпрямленного потока дисперсия распределена линейно:

Спрямленное время выражается через логит:
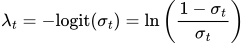
Во многих библиотеках для выпрямления траектории применяется замена переменной:

На старте диффузии ( ) коэффициент
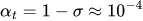 . При делении начального тензора гауссова шума на
 амплитуда значений в латенте мгновенно умножалась в 10 000 раз. К 30-му шагу латенты уходили в глубокое насыщение, классификатор CFG усиливал дисбаланс, а VAE честно транслировал экстремальный клиппинг в белый цвет (255, 255, 255).
Решение:
Уравнение траектории Flow Matching уже изначально является прямолинейным в пространстве скоростей:
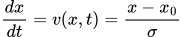
Оно не требует вспомогательных нормировок через  . Достаточно интегрировать векторное поле напрямую:
def compute_velocity(x: torch.Tensor, denoised: torch.Tensor, sigma: float) -> torch.Tensor:
    safe_sigma: float = max(sigma, 1e-4)
    return (x - denoised) / safe_sigma
После перехода на прямое интегрирование поля скоростей пересвет полностью исчез.
2. Развал высоких порядков: почему Адамс-Башфорт 6-го порядка рухнул в шум
Устранив клиппинг, мы построили прямое многошаговое интегрирование Адамса-Башфорта на неравномерной сетке шагов для порядков от 2 до 6.
Казалось бы, чем выше порядок интерполяционного полинома, тем меньше локальная ошибка [2] усечения ( ). Однако метрики сравнения с эталоном показали обратное:
|
Сэмплер |
Порядок ( |
SSIM |
LPIPS ( |
Качество генерации |
|---|---|---|---|---|
|
|
2 |
0.7453 |
0.4638 |
Стабильно, четкие формы |
|
|
3 |
0.7461 |
0.4639 |
Оптимум классической схемы |
|
|
4 |
0.7447 |
0.4664 |
Стабильно |
|
|
5 |
0.7264 |
0.5256 |
Заметные артефакты геометрии |
|
|
6 |
0.1341 |
0.8043 |
Полный коллапс в шум |


Начиная с 5-го порядка генерация резко деградировала, а 6-й порядок разрушил изображение до состояния несвязного шума.
В чем причина коллапса?
-
Деление на степени шага: Разделенные разности
 -го порядка делятся на произведение расстояний между узлами сетки
 . При шаге
 знаменатель для порядка
 составляет порядка
 . Малейшая нелинейность отклика нейросети умножается в миллионы раз.
-
Знакопеременность весов Лагранжа: Веса квадратурной формулы для неравномерной сетки вычисляются через интегралы базисных полиномов:
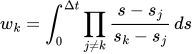
При шаге  веса для разных порядков ведут себя следующим образом:
-
Порядок 2:
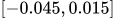 (сумма модулей
 )
-
Порядок 3:
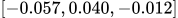 (сумма модулей
 )
-
Порядок 6: веса начинают хаотично осциллировать со сменой знаков (
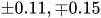 ), а сумма их модулей вырастает до
 .
Интегратор превращается в резонатор высокочастотного дребезга (классический феномен Рунге). Точная полиномиальная интерполяция на диффузионных траекториях имеет жесткое ограничение: порядки  математически неустойчивы.
3. Метод Flow-WLS: регуляризация Савицкого-Голея
Мы поставили вопрос: как задействовать информацию за 5–8 предыдущих шагов, не создавая осциллирующий полином высокой степени?
Решение пришло из спектрального анализа и цифровой обработки сигналов — фильтр Савицкого-Голея (Savitzky-Golay).
Вместо интерполяционного полинома степени  , который обязан строго пройти через каждую точку истории, Flow-WLS аппроксимирует траекторию жестко стабилизированной параболой 2-й степени методом взвешенных наименьших квадратов (WLS) по
 предыдущим точкам с коэффициентом затухания памяти [3]
 :
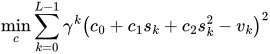
Что дает этот переход:
-
Физическая невозможность осцилляций: Парабола (
 ) не имеет дополнительных степеней свободы и не способна изгибаться волнами.
-
Сжатие нормы весов: При росте истории с 3 до 6 шагов сумма модулей весов у Flow-WLS падает с
 до
 (у классического полинома она возрастала до
 ).
-
Фильтрация шума: Увеличение глубины памяти
 теперь не накапливает ошибки экстраполяции, а сглаживает скачки скорости нейросети на жестких участках траектории.
Реализация расчета эффективных весов на произвольной сетке:
def compute_wls_weights(
    dt: float,
    past_dts: list[float],
    deg: int = 2,
    gamma: float = 0.85,
) -> list[float]:
    length: int = 1 + len(past_dts)
    degree: int = min(deg, length - 1)

    nodes: list[float] = [0.0]
    accumulated_time: float = 0.0
    for step_size in past_dts:
        accumulated_time -= step_size
        nodes.append(accumulated_time)

    nodes_array: np.ndarray = np.array(nodes)
    weights_diagonal: np.ndarray = np.array([gamma**idx for idx in range(length)])
    weight_matrix: np.ndarray = np.diag(weights_diagonal)

    design_matrix: np.ndarray = np.column_stack(
        [nodes_array**power for power in range(degree + 1)]
    )
    normal_matrix: np.ndarray = design_matrix.T @ weight_matrix @ design_matrix
    pseudoinverse_matrix: np.ndarray = np.linalg.pinv(normal_matrix)
    projection_matrix: np.ndarray = pseudoinverse_matrix @ design_matrix.T @ weight_matrix

    integral_vector: np.ndarray = np.array(
        [(dt ** (power + 1)) / (power + 1) for power in range(degree + 1)]
    )
    effective_weights: np.ndarray = integral_vector @ projection_matrix
    return [float(weight) for weight in effective_weights]
4. Результаты экспериментов
Тестирование проводилось на модели Anima DiT (anima_aestheticV11) в разрешении  на видеокарте Nvidia RTX 5060 без компиляторов и сторонних оптимизаций.
4.1. Стандартный бюджет (30 шагов)
|
Сэмплер |
Конфигурация |
SSIM |
LPIPS ( |
CLIP Score |
Оценка |
|---|---|---|---|---|---|
|
|
Встроенный ComfyUI |
0.7459 |
0.4677 |
27.35 |
Стандартный baseline |
|
|
|
0.7461 |
0.4639 |
26.47 |
Оптимум интерполяции |
|
|
|
0.7451 |
0.4648 |
26.65 |
Базовый уровень |
|
|
|
0.7488 |
0.4632 |
26.78 |
Улучшение деталей |
|
|
|
0.7541 |
0.4594 |
26.91 |
Лучший результат среди ОДУ |


Там, где классический полином cab_6 рухнул в шум с SSIM 0.1341, сэмплер flow_wls_8 превзошел встроенный uni_pc по всем трем метрикам.
4.2. Экстремальный режим: 10, 12 и 15 шагов
Главная ценность численного интегратора в генеративном пайплайне — способность удерживать геометрию при малом числе обращений к нейросети (Low-NFE):
|
Шагов |
Сэмплер |
SSIM |
LPIPS ( |
CLIP Score |
Визуальная оценка |
|---|---|---|---|---|---|
|
10 |
|
0.7665 |
0.4261 |
27.31 |
Базовая композиция |
|
10 |
|
0.7850 |
0.4214 |
27.17 |
Высокая резкость |
|
10 |
|
0.8003 |
0.4299 |
27.27 |
Максимальная точность (~11 сек) |
|
10 |
|
0.7517 |
0.4367 |
26.77 |
Заметны микроартефакты |
|
12 |
|
0.7780 |
0.4180 |
27.40 |
Высокий контраст |
|
15 |
|
0.7737 |
0.4486 |
27.08 |
Корректная анатомия пальцев |

При сокращении шагов до 10 метрика SSIM выросла до 0.8003, а время генерации составило 11 секунд.
5. Синергия трех уровней: как получить 8 секунд на кадр
Сэмплер Flow-WLS ускоряет генерацию во временном измерении (сокращая число шагов с 30 до 10). Однако его можно объединить с оптимизациями в других измерениях:
-
Временная ось:
flow_wls_4на 10 шагах. -
Пространственно-спектральная ось: нода SPEED (Spectral Progressive Diffusion). Первые 50% шагов DiT-трансформер вычисляется на половинном пространственном разрешении с последующим DCT-расширением, что ускоряет внимание [4] Attention в несколько раз.
-
Архитектурная ось: TeaCache, кэширующий медленно меняющиеся слои внимания между соседними шагами.
Итоговый замер:
-
Базовый пайплайн (30 шагов, стандартный сэмплер): ~34 секунды.
-
Связка Flow-WLS (10 шагов) + SPEED + TeaCache: 8 секунд на изображение 720×1280 на RTX 5060 при сохранении полноценного CFG 5.0 и работе любых сторонних LoRA.
Заключение
Эксперименты подтвердили два важных принципа:
-
Для генеративных моделей прямого потока (Flow Matching) опасна высокая степень интерполяционного полинома, но полезна глубокая ретроспективная выборка при низкой степени аппроксимации.
-
Взвешенные наименьшие квадраты обращают классическое поведение [5] многошаговых методов: увеличение глубины истории подавляет шум и монотонно повышает метрики качества генерации.
Код кастомной ноды открыт и доступен на GitHub, а препринт зарегистрирован в международной научной базе Zenodo:
-
Репозиторий: github.com/YakovSava/research-unipc-dpmpp [6]
-
DOI: 10.5281/zenodo.23337579 [7]
Автор: YakovSava
Источник [8]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37239
URLs in this post:
[1] математике: http://www.braintools.ru/article/7620
[2] ошибка: http://www.braintools.ru/article/4192
[3] памяти: http://www.braintools.ru/article/4140
[4] внимание: http://www.braintools.ru/article/7595
[5] поведение: http://www.braintools.ru/article/9372
[6] github.com/YakovSava/research-unipc-dpmpp: https://github.com/YakovSava/research-unipc-dpmpp
[7] 10.5281/zenodo.23337579: https://doi.org/10.5281/zenodo.23337579
[8] Источник: https://habr.com/ru/articles/1096762/?utm_campaign=1096762&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.