Из хаоса закладок — в галерею визуализаций: история создания DataDrops
Если вы работаете с данными или просто любите графики и карты, то наверняка знаете то самое чувство. Увидели классную визуализацию, захотели сохранить, кинули в закладки или переслали себе в чат. А через пару недель она либо потерялась, либо вы уже не помните, зачем вообще её сохраняли.
У меня было ровно так же. Моя личная коллекция датавиза выглядела как хаос из закладок в браузере, сохранённых постов в LinkedIn и случайных ссылок в Notion Obsidian. Найти что-то конкретное спустя время было почти невозможно.
Поэтому в какой-то момент из всего этого хаоса появился DataDrops [1], мой небольшой пет-проект, который представляет собой галерею визуализаций данных. Это рассказ о его создании, а ещё о том, как я полтора года делал платформу, а потом за месяц почти полностью пересобрал её.
Как всё началось
Проблема с закладками была только половиной истории. Параллельно меня мучил другой вопрос. Я ведь и сам время от времени делаю графики и карты. Куда бы их выкладывать, чтобы ими можно было просто и удобно поделиться?
Я перебирал разные варианты, но… GitHub явно не для картинок: работу там найдёт только тот, кто уже знает, где искать; соцсети не дают никакой структуры: всё превращается в ленту, и через сутки пост уже никто не увидит; Behance и Dribbble больше про дизайн, чем про данные: там никого не интересует, откуда взяты цифры; а Pinterest хорош для вдохновения, но там у картинки нет контекста: ни источника данных, ни кода, ни нормального автора.
Так появилась мысль о галерее датавиза. Условный “Pinterest для аналитиков”: место, где можно хранить свои работы, вдохновляться чужими и постепенно собирать портфолио.
Признаюсь, эта идея крутилась у меня в голове несколько месяцев и никак не отпускала. Но одно дело — придумать идею, и совсем другое — сесть и сделать полноценный сервис, учитывая, что я программист только отчасти (прежде всего, занимаюсь аналитикой данных, но порой приходится и в коде копаться).
От идеи к первому коммиту
В какой-то момент я наконец решил перестать прокручивать идею в голове и просто начать делать. В качестве основы выбрал Django как наиболее простой и понятный мне инструмент. Плюс заручился поддержкой ИИ-агентов. Хотя, честно говоря, в конце апреля 2025 года, когда в проекте появился первый коммит, они были совсем на другом уровне.
Почти все вечера и выходные у меня уходили на DataDrops: интерфейс, логика [2] публикаций, пользовательские сценарии. Мне хотелось сделать не просто хранилище картинок, а инструмент именно под визуализацию данных. Поэтому с самого начала я заложил три основных принципа:
-
в центре внимания [3] — сами визуализации, а не интерфейс вокруг них;
-
у каждой работы есть контекст: описание, источник данных, теги для поиска;
-
платформа работает и как галерея для вдохновения, и как место для своих работ, то есть портфолио.
Правда, одно дело заложить принципы, а другое — их соблюдать. Если бы можно было описать стиль моего программирования (да и любого созидания), то это было бы что-то в духе творческого перфекционизма-анархизма. Сначала делаю одно. Потом понимаю, что надо бы доделать ещё это, и то, и вот это. А потом и вовсе всё переделываю, потому что понимаю: изначально надо было делать по-другому.
Тем не менее, 1 сентября 2025 года DataDrops открылся для всех. Технически это было классическое веб-приложение: авторизация, база данных, загрузка изображений, лайки, комментарии и подписки. Выглядело действительно как я задумывал!
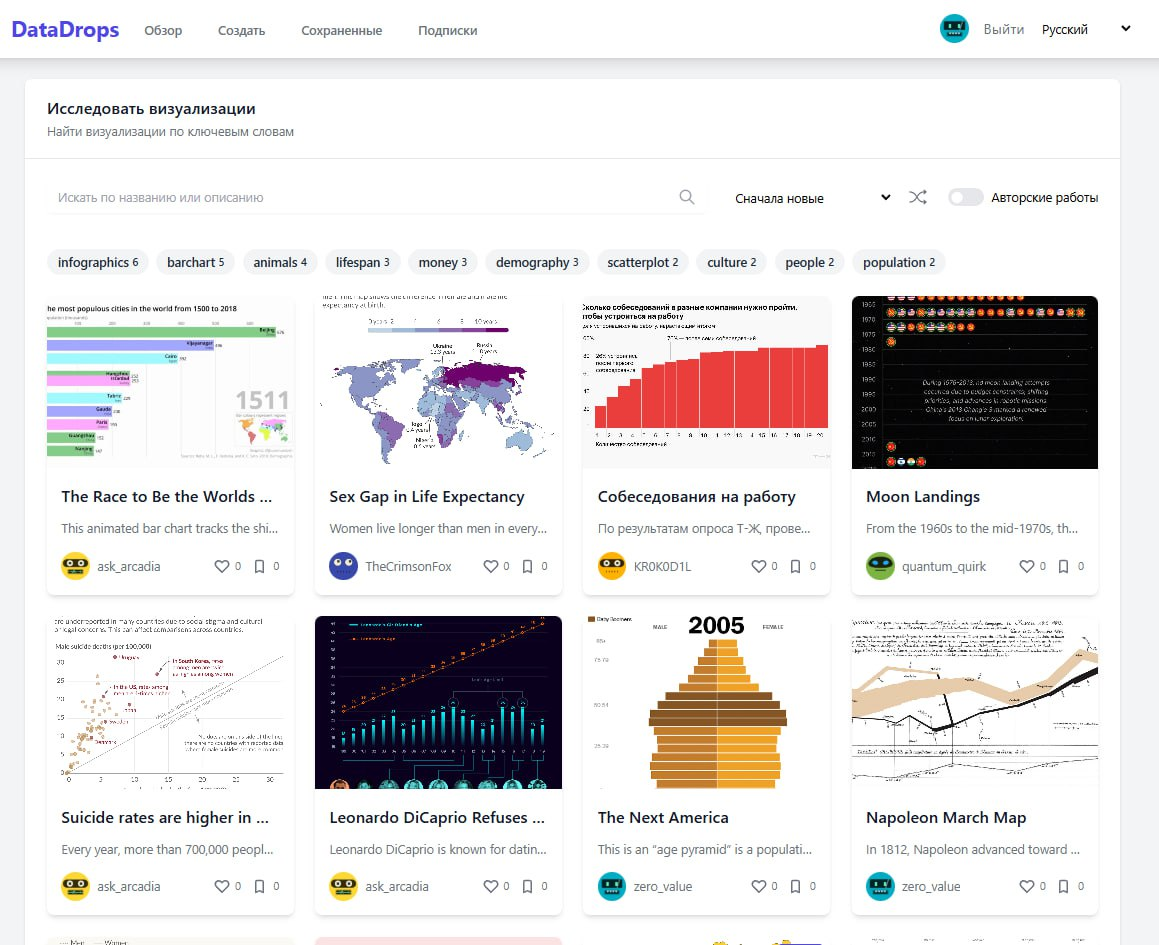
А потом наступил ноябрь, и я решил ещё добавить отдельную страницу для #30DayMapChallenge. В том челлендже я участвовал впервые и сделал все 30 карт, так что делал её в каком-то смысле для себя :)
Почему пришлось многое пересобрать
Потом наступила долгая пауза длиной почти в год. Отчасти из-за работы над другими проектами, отчасти из-за того, что я так и не научился продавать то, что делаю.
А когда этой осенью я вернулся к DataDrops и посмотрел на него свежим взглядом, стало понятно, что многое надо переделывать: лента выглядела довольно олдскульно: работы подписывались на разных языках, и половина ленты превращалась в красивые картинки с непонятными подписями (а ведь сайт-то мультиязычный!); а главное, галерею нужно было наполнять, и делать это только руками у меня не всегда получалось. В итоге за сентябрь и октябрь я пересобрал почти всё.
Для кого это всё
Я делал проект для аналитиков и дата-сайентистов, дизайнеров визуализаций, дата-журналистов, студентов и всех, кто участвует в #30DayMapChallenge или #TidyTuesday. В общем, для всех, кто делает графики и карты или просто любит на них смотреть. Проект полностью бесплатный и таким останется (до тех пор, пока у меня будут деньги его поддерживать).
Что вообще такое DataDrops
Если коротко, это галерея визуализаций данных:
-
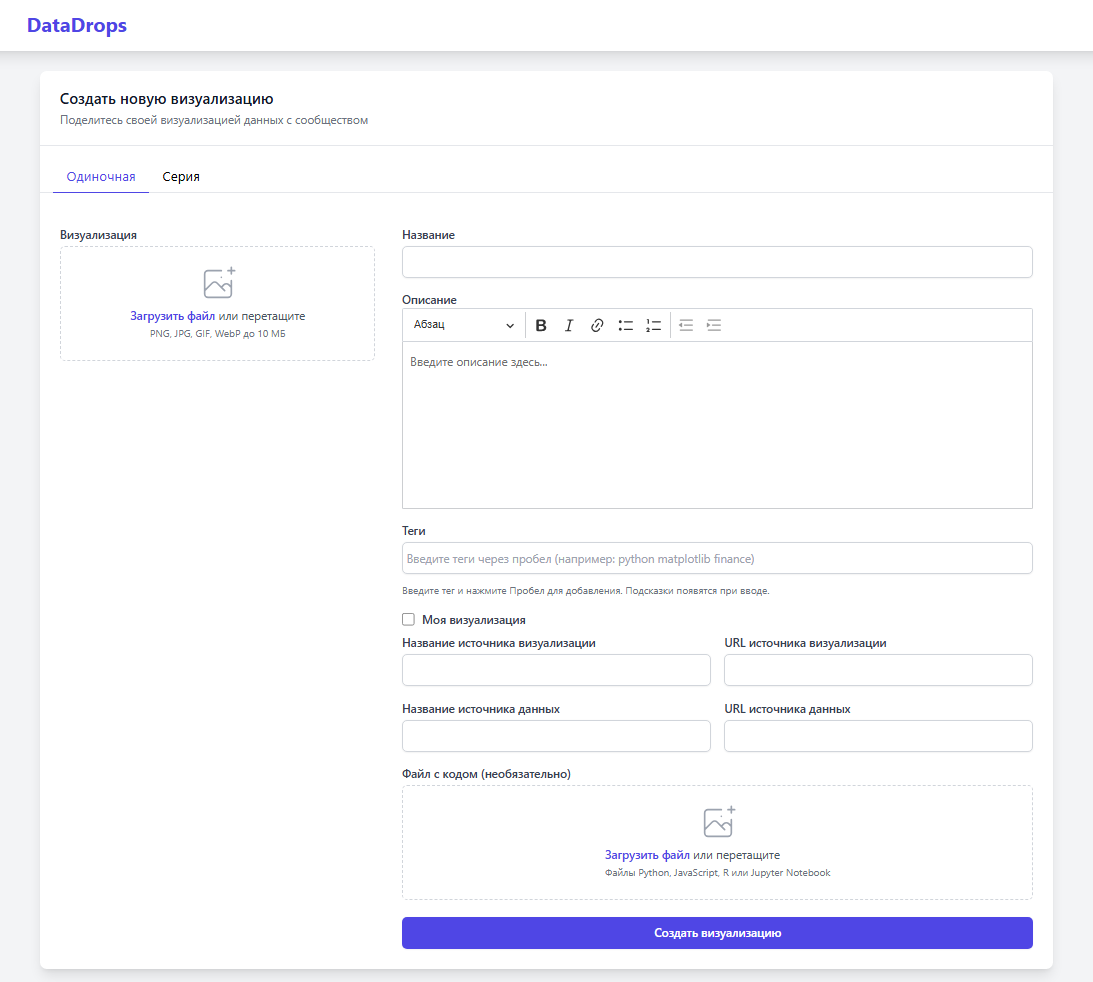
выложить можно картинку, а к ней по желанию ещё и файл с кодом (.py, .R, .js, .ipynb), а также добавить источник данных и описание;
-
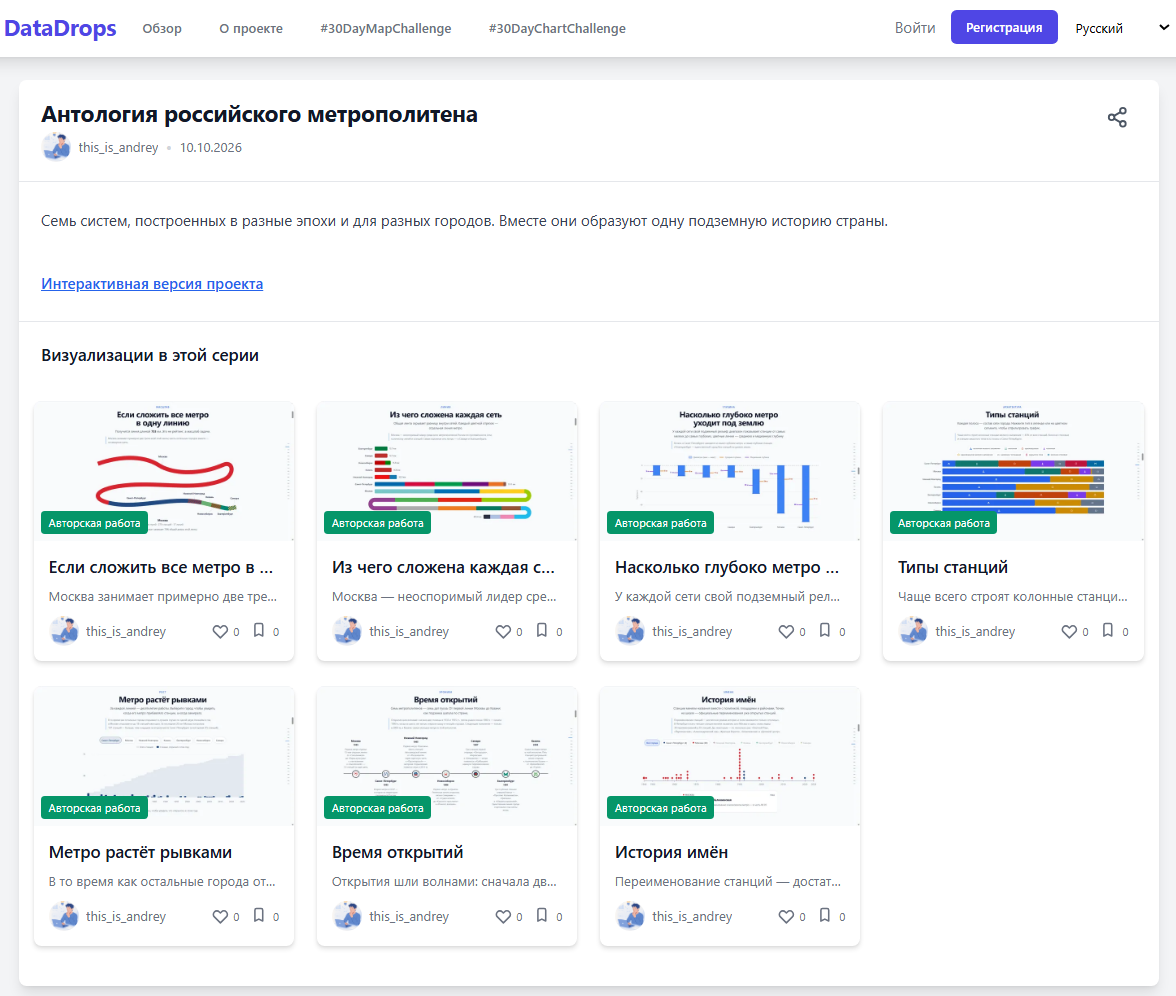
можно выложить одну работу или целую серию;
-
можно и чужую, если указать автора и ссылку, а свои помечаются бейджем “Оригинал”;
-
есть лайки, сохранения, комментарии и подписки на авторов, а профиль работает как портфолио;
-
есть отдельные страницы для #30DayMapChallenge и #30DayChartChallenge.
Стек довольно базовый, но это был осознанный выбор: Python, Django, PostgreSQL, Redis, JS и Tailwind. Картинки лежат в Backblaze B2 и раздаются через свой домен. Один сервер, gunicorn и nginx. Кажется, оптимальное сочетание для пет-проекта.
Проблема пустой галереи
У любой новой галереи одна и та же болезнь: в ней пусто. Никто не хочет выкладываться туда, где ничего нет, а без публикаций ничего и не появится. Классическая проблема курицы и яйца.
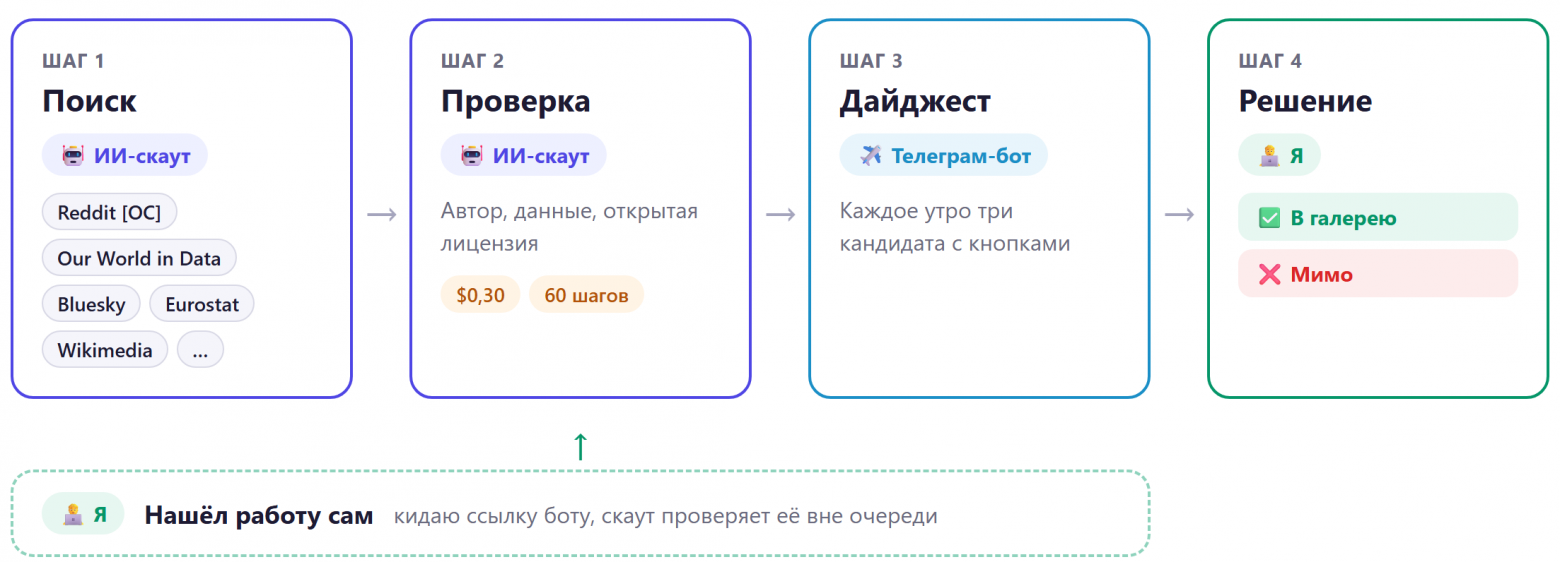
Сначала я, конечно, собирал хорошие работы руками. Вытаскивал работы из своих закладок и сохранёнок, загружал свои визуализации. Это работает, но съедает несколько часов в неделю. Поэтому этой осенью я сделал скаута — ИИ-агента, который ищет визуализации за меня, а мне остаётся роль редактора: определить, хочу ли я поделиться этой визуализацией.
Как он устроен. Это агент с инструментами, работает через OpenRouter. Инструменты простые: поиск в интернете, открыть страницу, посмотреть на картинку (модель мультимодальная), уточнить детали, предложить кандидата и отметить ссылку как неудачную. Поиск отдан модели подешевле (GPT 6 Luna), а основная думает и разглядывает графики (Claude Haiku 4.5).
Где ищет. Reddit r/dataisbeautiful (через RSS и только авторские посты с тегом [OC]), Our World in Data, Bluesky по тегам #30DayMapChallenge, #30DayChartChallenge и #TidyTuesday, Visual Capitalist, Eurostat, Всемирный банк, избранные карты Wikimedia Commons, FlowingData, Datawrapper, The Pudding, Information is Beautiful, Nightingale, Observable и Tableau Public. Из русскоязычных — “Если быть точным”.
Правила. Они написаны обычным текстом в markdown-файле, как инструкция для нового сотрудника, а не зашиты в код. Работа должна что-то сообщать, а не просто быть красивой. У неё должны быть известны автор и источник данных, а лицензия — позволять показ. Поэтому издания с жёсткой политикой перепечатки (NYT, FT, Economist, Reuters, Bloomberg) скаут пропускает. Сгенерированные ИИ картинки, рекламу и мемы отклоняет. Да, ИИ-агент, которому запрещено приносить картинки, сгенерированные ИИ, — это немного иронично 🙃
Бюджет. Вот это, пожалуй, важный пункт. Агенты любят ходить по кругу, и без ограничений один неудачный запуск может стоить как месяц работы. Поэтому у каждого запуска жёсткий лимит: $0,30 и 60 шагов, и проверяется он перед каждым вызовом инструмента, а не по итогам. Плюс не больше трёх поисков за шаг. А старые тексты страниц и картинки вырезаются из истории диалога, иначе контекст, а вместе с ним и цена, растут с каждым шагом. Каждый запуск пишется в лог: шаги, стоимость, итоговый отчёт. Если что-то упало, мне сразу приходит сообщение в Телеграм.
Человек в контуре. Скаут ничего не публикует сам. Кандидаты приходят в приватный телеграм-бот с кнопками: опубликовать, отклонить, переключить язык, поправить. Каждое утро в 10:00 прилетает дайджест из трёх кандидатов, и разбираю я его обычно в течение дня, когда мне удобно. А если сам наткнулся на хорошую работу, просто кидаю боту ссылку, и в течение часа скаут делает из неё карточку. Одобренное публикуется от системного аккаунта с указанием автора и источника. Была идея сделать множество “фейковых аккаунтов”, но всё же от этой идеи я решил отказаться.
Локализация
Как я уже писал, раньше в ленте рядом оказывались карта с подписью на английском, график на французском и дашборд на русском. Интерфейс был на трёх языках, а сами работы — на каком угодно.
Перевод. Теперь заголовок и описание каждой работы переводятся на три языка через LLM (по умолчанию Claude Haiku), с температурой 0 и ответом в JSON. Оригинал всегда в один клик. Перевод идёт по крону раз в пять минут. Чтобы не платить за одно и то же дважды, от текста берётся хеш, и переводится только изменённое. А после трёх неудач подряд работа больше не переводится, чтобы одна кривая запись не жгла деньги вечно.
Определение языка. Вот тут было весело. Сначала я определял язык оригинала библиотекой langdetect, и она быстро показала характер: фразу “GDP growth” она с уверенностью 0,86 считала польской 🥲 Короткие тексты из терминов и названий стран — вообще худший случай для таких библиотек, а у визуализаций почти все заголовки такие. В итоге langdetect я теперь верю только при уверенности от 95% (и с фиксированным сидом), а окончательный ответ даёт та же LLM, которая переводит: язык оригинала она возвращает вместе с переводом.
Поиск и лента. Поиск ищет и по переводам: спрашиваете по-русски — находятся работы на английском и французском. В профиле можно отметить до пяти «своих» языков (из шестнадцати). Если ничего не выбирать, DataDrops ориентируется на язык сайта и браузера. Работы на других языках в рекомендациях не прячутся, а ранжируются так, будто опубликованы на три дня раньше: чуть ниже, но не исчезают.
Лента, или проблема обрезанных графиков
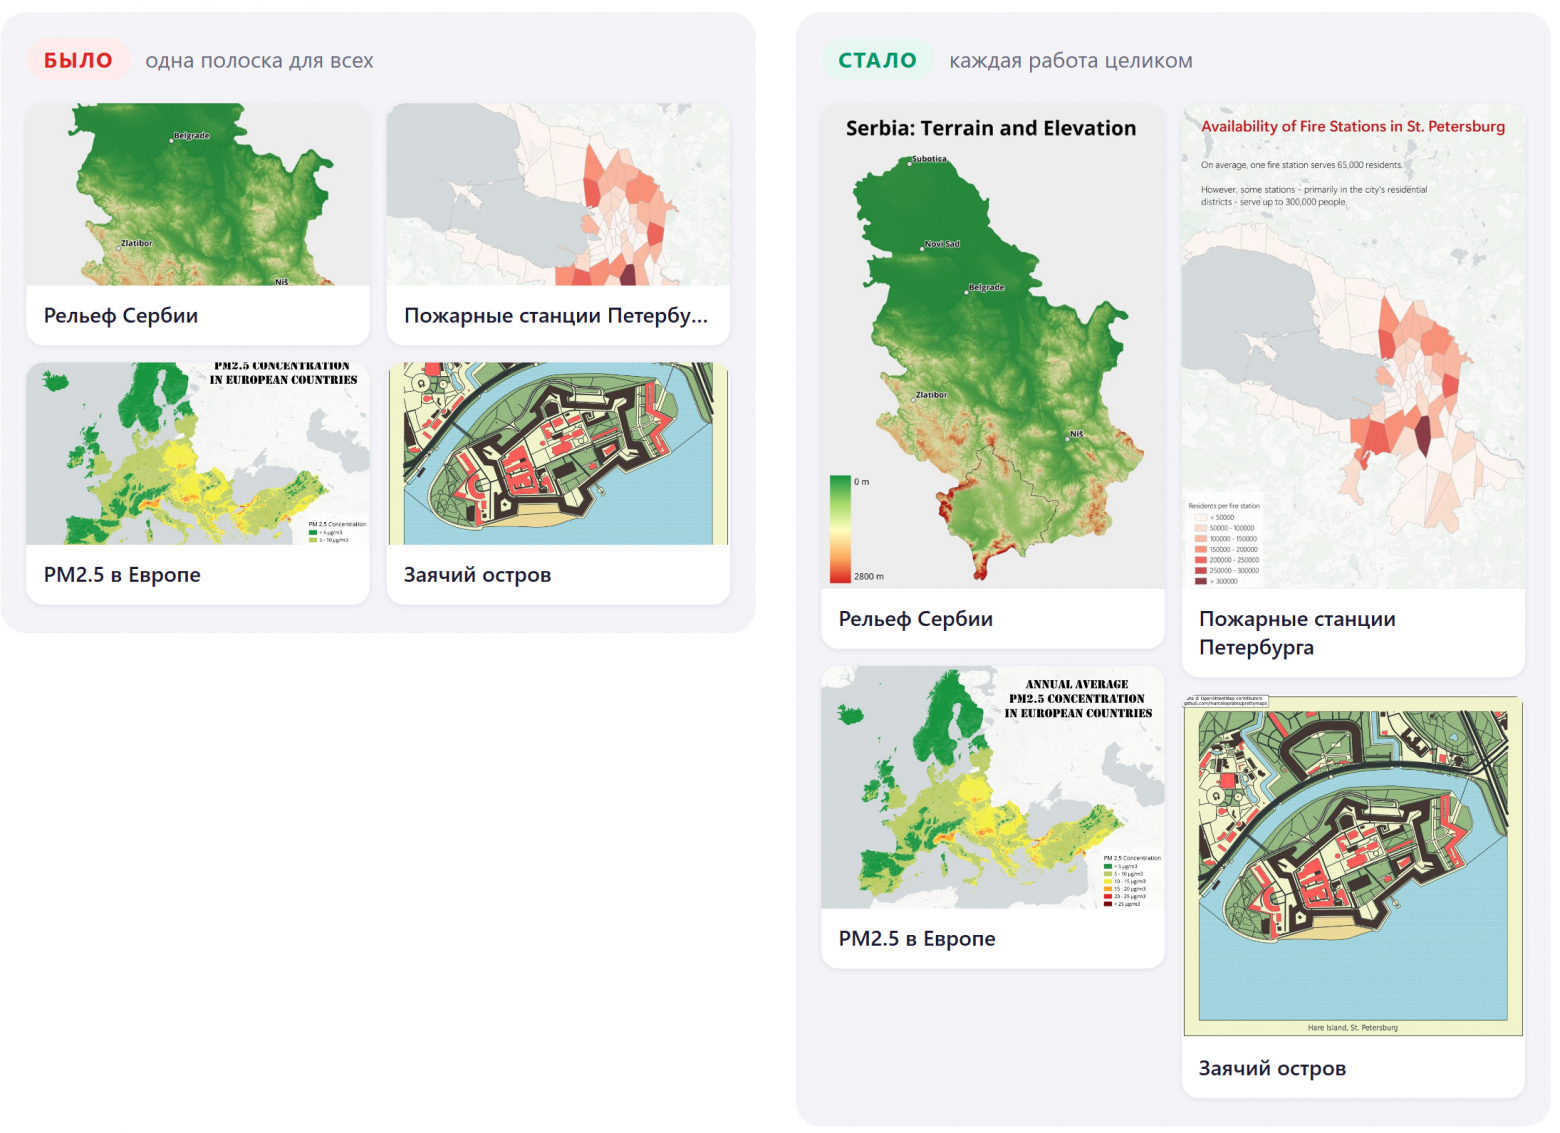
В первой версии DataDrops карточки обрезали каждую работу до одной универсальной полоски. Для фотографий это нормально, а для графиков — катастрофа: подписи, легенда и источник обычно как раз по краям. Для платформы, которая про визуализации, так себе история. Поэтому теперь лента выложена плиткой, и каждая работа видна целиком, в своих пропорциях.
Челленджи и часовые пояса
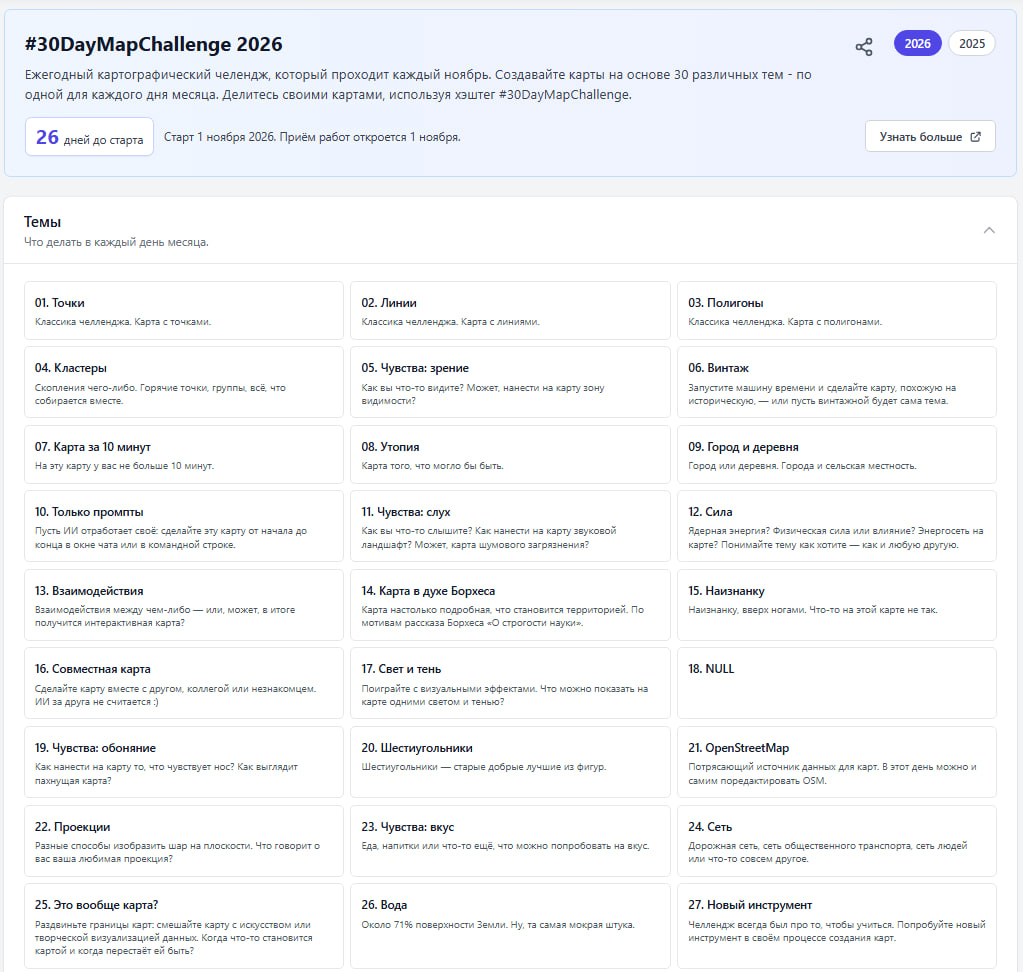
Отдельная любовь — #30DayMapChallenge: 30 карт за 30 дней ноября, на каждый день своя тема. После прошлогодних 30 карт я знаю по себе: было тяжело, местами очень тяжело, но это был один из самых классных месяцев за год. Поэтому страницы челленджей при перезапуске я переделал почти первыми.
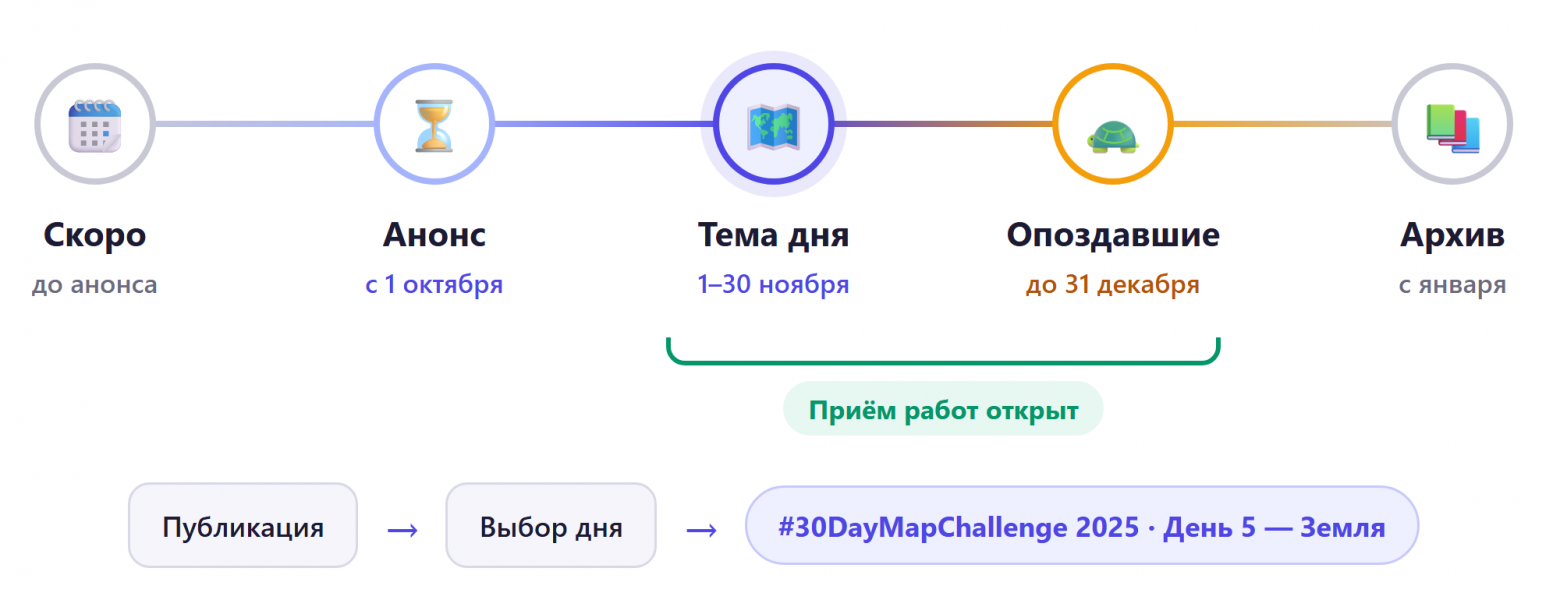
И тут вылезла неожиданная задача. Участники могут жить по всему миру, и “первое ноября” у них наступает в разное время. Поэтому день открывается в 00:00 по UTC +14 (самый ранний пояс на Земле) и закрывается в 23:59:59 по UTC −12 (самый поздний). А для опоздавших есть время до конца следующего месяца.
Страница челленджа живёт по годовому циклу:
Кстати, темы этого года уже на сайте.
Вайб-кодинг и безопасность
Сейчас много говорят о том, что вайб-кодинг — это прямая дорога к дырам в безопасности. И, по правде говоря, это справедливо. ИИ-агент пишет код, который работает. Но “работает” и “работает безопасно” — это совсем не одно и то же. Агент, который делает фичу, думает о том, как её сделать, а не о том, как её сломать.
Поэтому к безопасности я подходил отдельно и комплексно. Несколько раз просил агента провести именно ревью безопасности: не написать код, а посмотреть на уже написанный глазами атакующего. И с каждым разом проект становился заметно лучше. Признаюсь, кое-что из найденного меня, мягко говоря, удивило 🥲
Первый заход — ещё летом 2025-го. Появились CSP, ограничение частоты запросов, блокировка подозрительных IP и большой набор тестов безопасности для API.
Второй — перед перезапуском этой осенью. И вот тут нашлось то, что даже сотни тестов пропустили. Например, через API любой залогиненный пользователь мог отредактировать или удалить чужую работу. Эндпоинт остался с ранних версий, а проверка владельца была только в обычных формах.
Третий — когда появился ИИ-скаут. Агент, который ходит по произвольным страницам, — отдельная поверхность атаки. Страница может попытаться направить его во внутреннюю сеть сервера, поэтому каждый запрос и каждый редирект проверяются: хост должен резолвиться только в публичные IP. Токены и пароли прокси не попадают в логи, там остаётся только тип ошибки [4]. И главное: агент в принципе не может ничего опубликовать, только предложить.
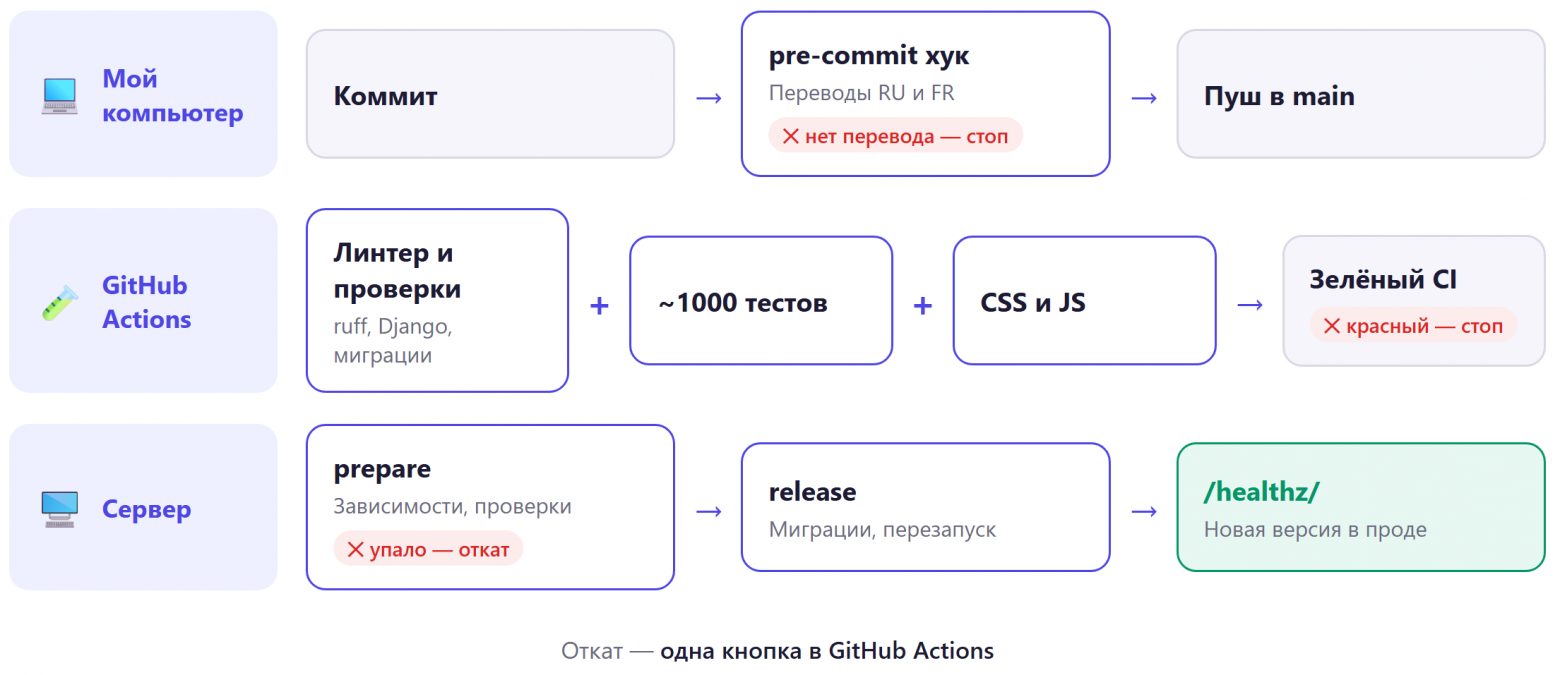
Чтобы найденное не вернулось, на каждую дыру есть тест. А так как деплой идёт только после зелёных тестов, случайно откатиться к дырявой версии не получится.
Так что ИИ-агент действительно может написать дырявый код, но он же отлично находит дыры, если попросить его об этом отдельно. Если что, это не призыв к действию по поиске уязвимостей на сайте 🙃
Мелочи, каждая из которых стоила как минимум одного отдельного вечера
-
Заблокированные сервисы. Те, кто делает проекты в России, меня поймут. OpenRouter отказывает некоторым странам, а Телеграм кое-где заблокирован. Поэтому запросы сначала идут напрямую, а при ошибке соединения, 403 или 451 перебирают прокси, и заблокированный хост запоминается на час. Если 403 приходит и через прокси, это уже защита сайта от ботов, и прокси тут не помогут. Из последнего — в какой-то момент я захожу на сайт, а на нём не отображается ни одна картинка. Оказалось, РКН заблокировал BackBlaze B2. Пришлось делать дополнительную обёртку через свой сервер.
-
Деплой только после тестов. Кажется, я тут немного упоролся, но скрипт обновления каждый раз сначала прогоняет на сервере весь набор тестов (а их около тысячи), и если что-то упало, откатывает код. Поэтому, надеюсь, баги должны быть редки.
-
Переводы интерфейса. Pre-commit хук не даёт закоммитить новую строку интерфейса без русского и французского перевода. Потому что “потом переведу” — это никогда, надо всё делать сразу.
Бонус: промо-ролик, которого не касалась рука человека
Напоследок — просто потому, что было весело. Промо-ролик на странице “О проекте” не смонтирован, а написан кодом с помощью Claude Opus 5.5. Скрипт гонит headless Chrome кадр за кадром и отдаёт кадры в ffmpeg. Музыку синтезирует отдельный скрипт, сэмпл за сэмплом, а такты подогнаны так, чтобы раскрытие галереи попало ровно на сильную долю.
Я бы мог сказать, что монтировал ролик, но на самом деле я весь вечер кидал ИИ-агенту правки. В такие моменты я понимаю, насколько удивителен тот мир, в котором мы живём!
Вместо заключения
1 ноября стартует #30DayMapChallenge. Если участвуете, выкладывайте карты на DataDrops [1] (пожалуйста): у каждого дня своя страница, а через месяц у вас будет готовое портфолио. Не обязательно все 30 дней: главный принцип челленджа — участие, и даже одна классная карта уже считается.
И буду очень рад критике, особенно от тех, кто сам делает визуализации: чего не хватает и что мешает выложить туда свою работу. Пишите в комментариях 👇
А о том, как делаются DataDrops и другие мои проекты про данные и карты, я пишу в телеграм-канале online ergo sum [5].
Автор: akolomatskiy
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37246
URLs in this post:
[1] DataDrops: https://datadrops.space
[2] логика: http://www.braintools.ru/article/7640
[3] внимания: http://www.braintools.ru/article/7595
[4] ошибки: http://www.braintools.ru/article/4192
[5] online ergo sum: https://t.me/online_ergo_sum
[6] Источник: https://habr.com/ru/articles/1093448/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1093448
Нажмите здесь для печати.