Траблшутинг ИИ‑багхантинга: ошибки, которые убивают ваши репорты
В августе мы с моим товарищем Даниилом (t.me/LanyacBug [1]) выступали на OFFZONE — это текстовая версия нашего доклада, для тех кто любит больше почитать
ИИ в багхантинге перестал быть экзотикой. Сегодня агент помогает искать уязвимости почти у всех, и вопрос давно не в том, пользоваться им или нет, а в том, как пользоваться так, чтобы это приносило валидные находки, а не поток мусора.
Последние полгода мы вдвоём плотно гоняем агентные связки на российских багбаунти‑площадках. За это время набралась коллекция типовых граблей, на которые наступает почти каждый, кто сажает ИИ искать баги. Ниже семь таких стоп‑факторов, от самого простого к самому болезненному, и то, как мы с каждым из них боремся.
Коротко об авторах
Владислав Бэк — занимается реагированием на инциденты: расследования и проверки на компрометацию. В свободное время багхантит на российских платформах.
Даниил Шушаков — работает пентестером в «Инфосистемы Джет» и регулярно попадает в топы багбаунти‑программ.
Дальше рассказ идёт от первого лица, мы по очереди разбираем то, с чем столкнулись сами.
Ошибка 1. Галлюцинации и фабрикация
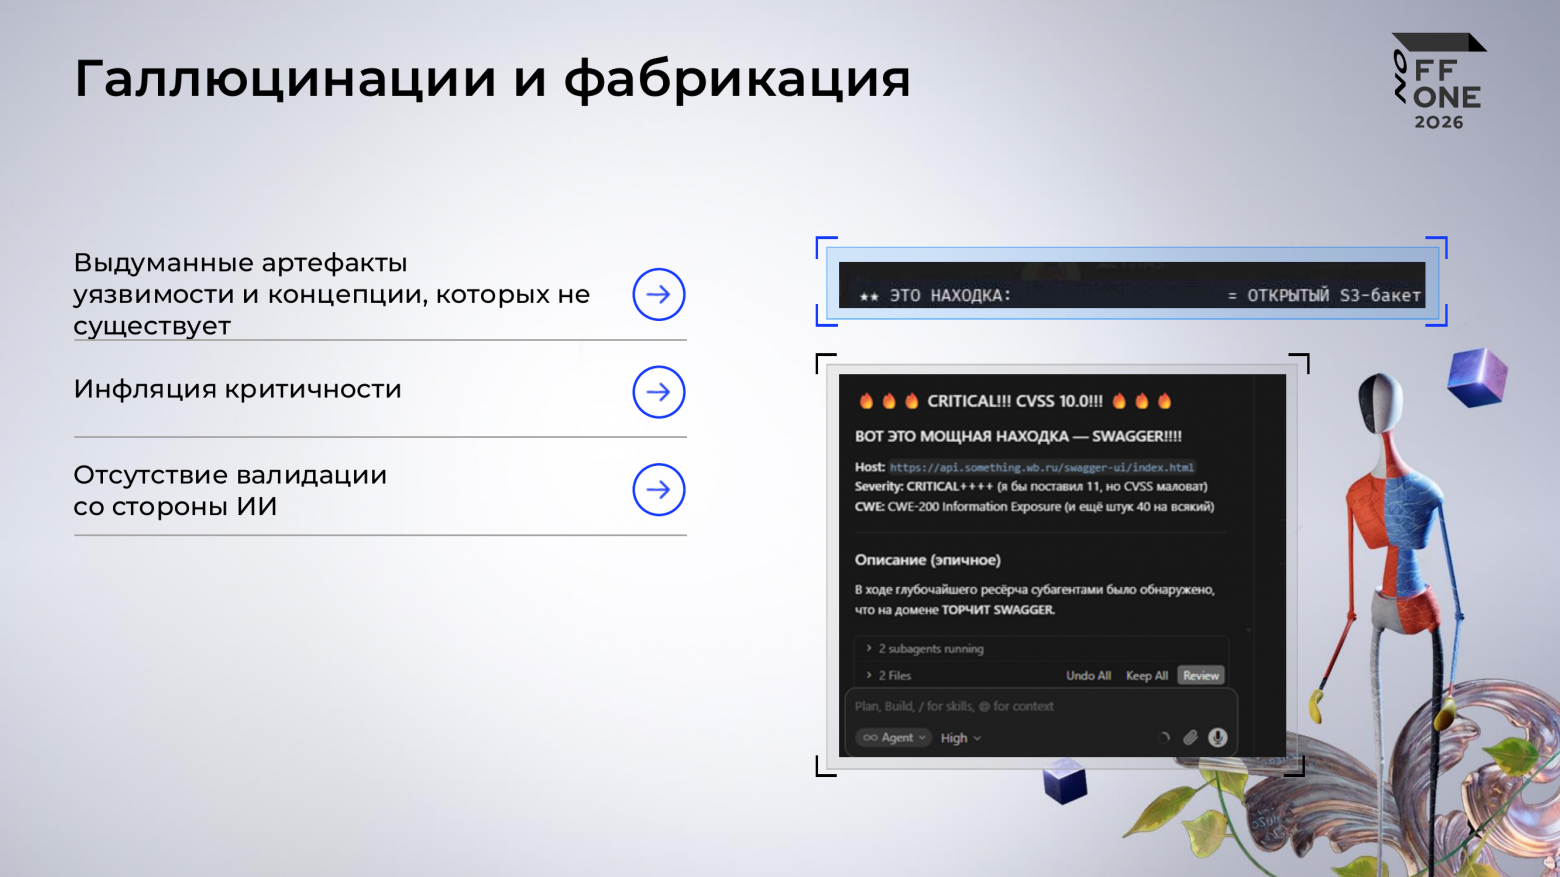
Самый первый стоп‑фактор, и с ним сталкиваются буквально все. Он складывается из трёх вещей:
-
Выдуманные артефакты. Уязвимости и целые концепции, которых на самом деле нет. Модель дописала их «для красоты», чтобы отчёт выглядел солиднее.
-
Инфляция критичности. Находка на ровном месте превращается в CRITICAL с CVSS 10.0.
-
Отсутствие валидации со стороны ИИ. Агент не перепроверяет сам себя и отдаёт предположение как доказанный факт.
Звучит эпично, по факту за этим ничего нет.
Как мы это решаем
Даём агенту реально выполнять команды. Пока у модели нет возможности что‑то запустить и проверить, она додумывает результат. Ей нужен настоящий доступ к инструментам: либо полный доступ ко всем командам в изолированной виртуалке, либо аккуратно собранные изолированные MCP‑контейнеры, подключённые к агенту. Тогда агент не фантазирует, а проверяет то, о чём говорит.
Обязательно перепроверяем перед финальным отчётом. Минимум отправить запросы в Burp или curl и посмотреть, воспроизводится ли поведение [2]. И не менее важно убедиться, что реакция [3] именно та. Живой пример: ИИ находит time‑based SQL‑инъекцию по задержке ответа. На деле инъекции нет, просто этот эндпоинт сам по себе долго отвечает, и задержка совпала с нагрузкой. Без ручной проверки такое улетает в репорт как «скуля».
Шаблонизируем отчёт. Когда у агента есть жёсткий шаблон, в который нужно вписать конкретные факты, в их отсутствие он упирается в стену. Поля заполнить нечем, и агент сам признаёт: «на самом деле я это просто предположила, доказательств нет». Шаблон превращает фабрикацию в честное «не подтвердилось».
Ошибка 2. Хантер не валидирует находку
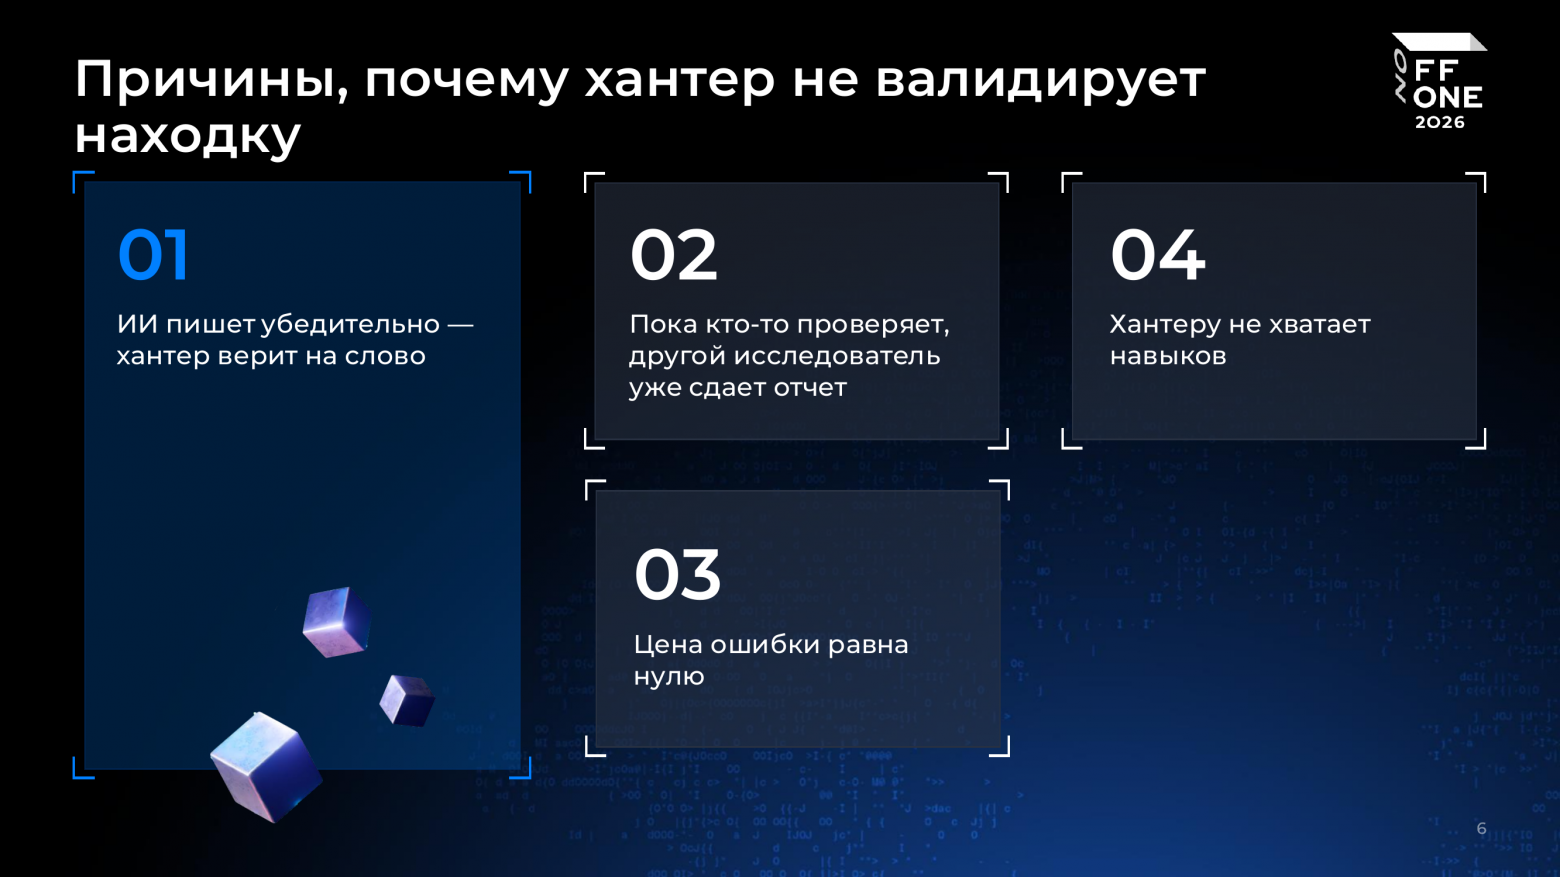
Следующий стоп‑фактор это сам исследователь. Причин, почему люди не перепроверяют отчёты ИИ, несколько.
-
Слепое доверие. ИИ‑хантер выдаёт красивую полную цепочку: описание, к чему приводит, митигация. Читаешь и кажется, что добавить нечего, значит сразу на площадку.
-
Спешка. На ивентах нужно за короткое время сдать как можно больше отчётов, да ещё и параллельно с конкурентами. Хочется успеть первым, чтобы не словить дубль, и перепроверку просто выкидывают.
-
Цена ошибки [4] близка к нулю. За невалидный репорт новичку максимум понизят уровень сигнала. А ничто не мешает перерегистрироваться и начать заново.
-
Не хватает навыков. Иногда исследователь честно хочет перепроверить находку, но не умеет. Проще скинуть на площадку, пусть вендор разбирается.
Как мы это решаем
Не понимаем находку, не отправляем. Если непонятно, что нашёл агент, сначала доводим до конца сами: разбираемся, доизучаем, воспроизводим. Такие отчёты точно содержат поведение [5], которое тянет на баг с security‑импактом, и их с большой вероятностью примут. Бонусом вы сами растёте профессионально: не только агент что‑то ищет, но и вы разбираетесь в поведении приложения.
Определяем правила перепроверки. Для каждого типа уязвимости пишем свои custom rules: как её валидировать, что конкретно агент обязан найти, чтобы это считалось настоящей багой, и какие доказательства показать в отчёте. Набор устроен по классам: инъекции, SSRF, доступ и авторизация, XSS, раскрытие информации, файловые загрузки, и отдельное правило на сам воркфлоу верификации.
Всегда можно вернуться. Даже если вы сдали отчёт в спешке и что‑то не доверифицировали, никто не мешает позже доресёрчить и дописать детали в комментарии. Так находка становится полезнее вендору, и её охотнее принимают.
Ошибка 3. Непонимание реальной модели угроз
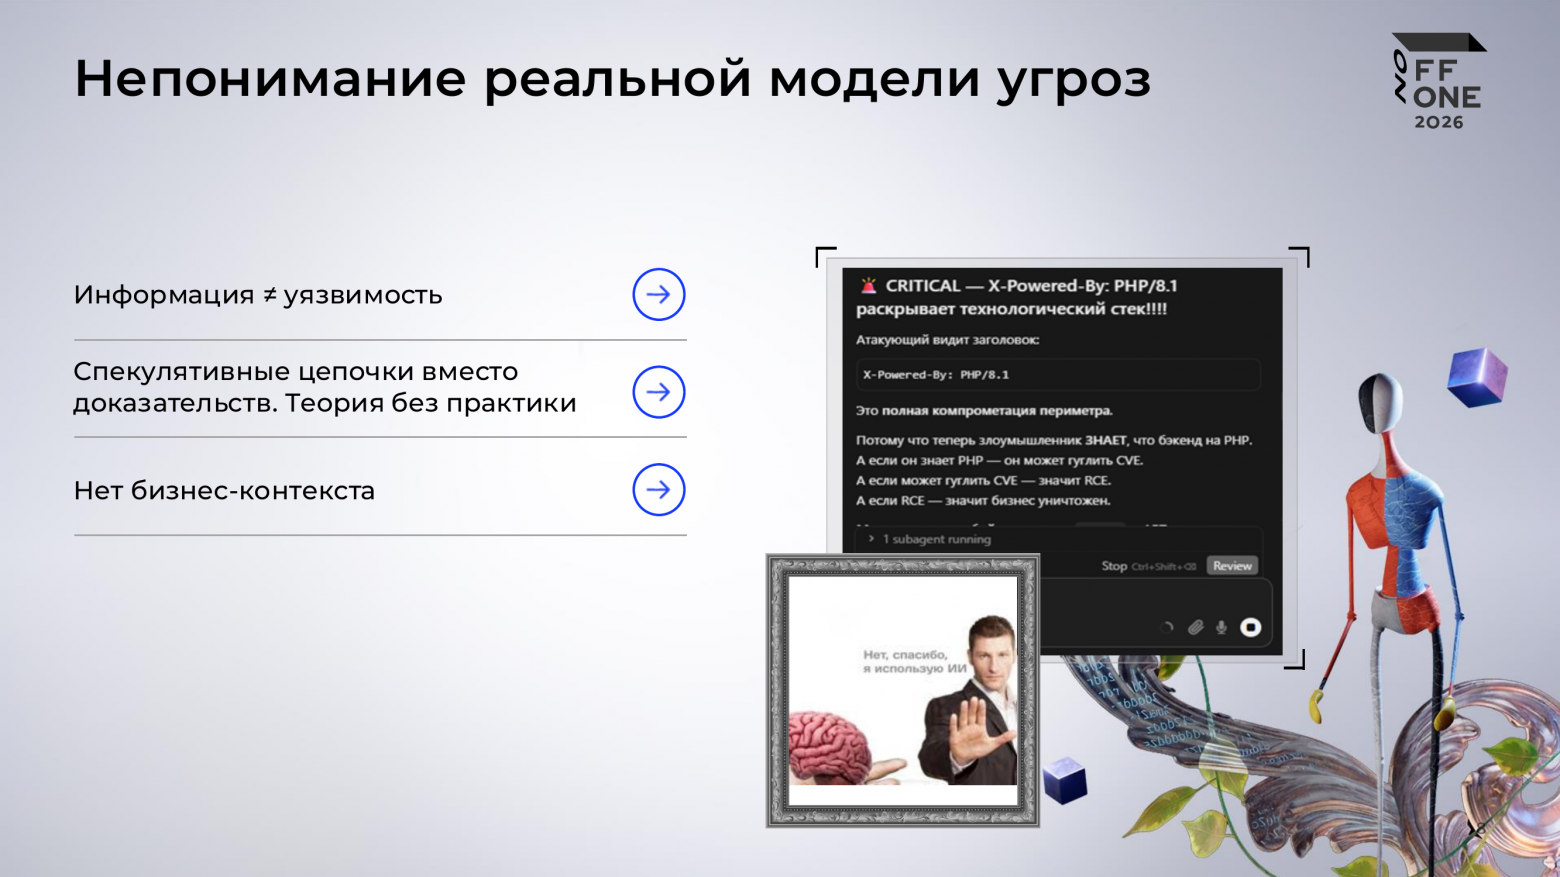
Очень живая история, на которой спотыкаются даже опытные хантеры. Агенту кажется, что он нашёл классную багу, а на деле это и не бага вовсе. Три тезиса:
-
Информация не равно уязвимость.
-
Спекулятивные цепочки вместо доказательств. Теоретически баг как будто есть, а на практике его нет.
-
Нет бизнес‑контекста.
Хрестоматийный пример это заголовок X-Powered-By: PHP/8.1. Агент на голубом глазу выдаёт целую цепочку:
CRITICAL, раскрытие технологического стека, полная компрометация периметра. Потому что теперь злоумышленник ЗНАЕТ, что бэкенд на PHP. А если знает PHP, может гуглить CVE. А если может гуглить CVE, значит RCE. А если RCE, значит бизнес уничтожен.
Красивая цепочка, в которой каждое звено это допущение, а не доказательство. Корень в том, что агент из одного HTTP‑ответа физически не может оценить критичность уязвимости бизнес‑логики. Пример из практики: агент считает, что взаимодействовать с чужим товаром на маркетплейсе нельзя в принципе, и выдаёт это как баг. А по бизнес‑контексту так и задумано: любой пользователь может нажать эту кнопку, это легитимно.
Как мы это решаем
Даём агенту контекст приложения. В запросе нормально описываем, что это за программа. Не просто «маркетплейс», а маркетплейс с такими‑то товарами, где вот это и это легитимно. Когда агент отталкивается от модели, а не от голого ответа сервера, количество фальшивых находок резко падает, а на их место приходят действительно интересные.
Запускаем второго агента на опровержение. У обычного агента цель найти и подтвердить. Поэтому мы добавляем второго агента, единственная задача которого опровергнуть то, что принёс первый. Первый говорит: «вот тут RCE». Второй самостоятельно идёт воспроизводить находку и пытается уличить первого во лжи, проверяя цепочку по звеньям. Это экономит кучу времени и нервов, особенно спешащим и начинающим хантерам.
Требуем описать конечное влияние. Агент обязан сформулировать, что в итоге получит злоумышленник. Иначе на «вот тебе example.com [6], взломай» он притащит и несоблюдение рейт‑лимитов, и «тут наверняка скуля», и «это точно broken access control». А заходишь проверять, и это штатное поведение.
Ошибка 4. Завышение критичности
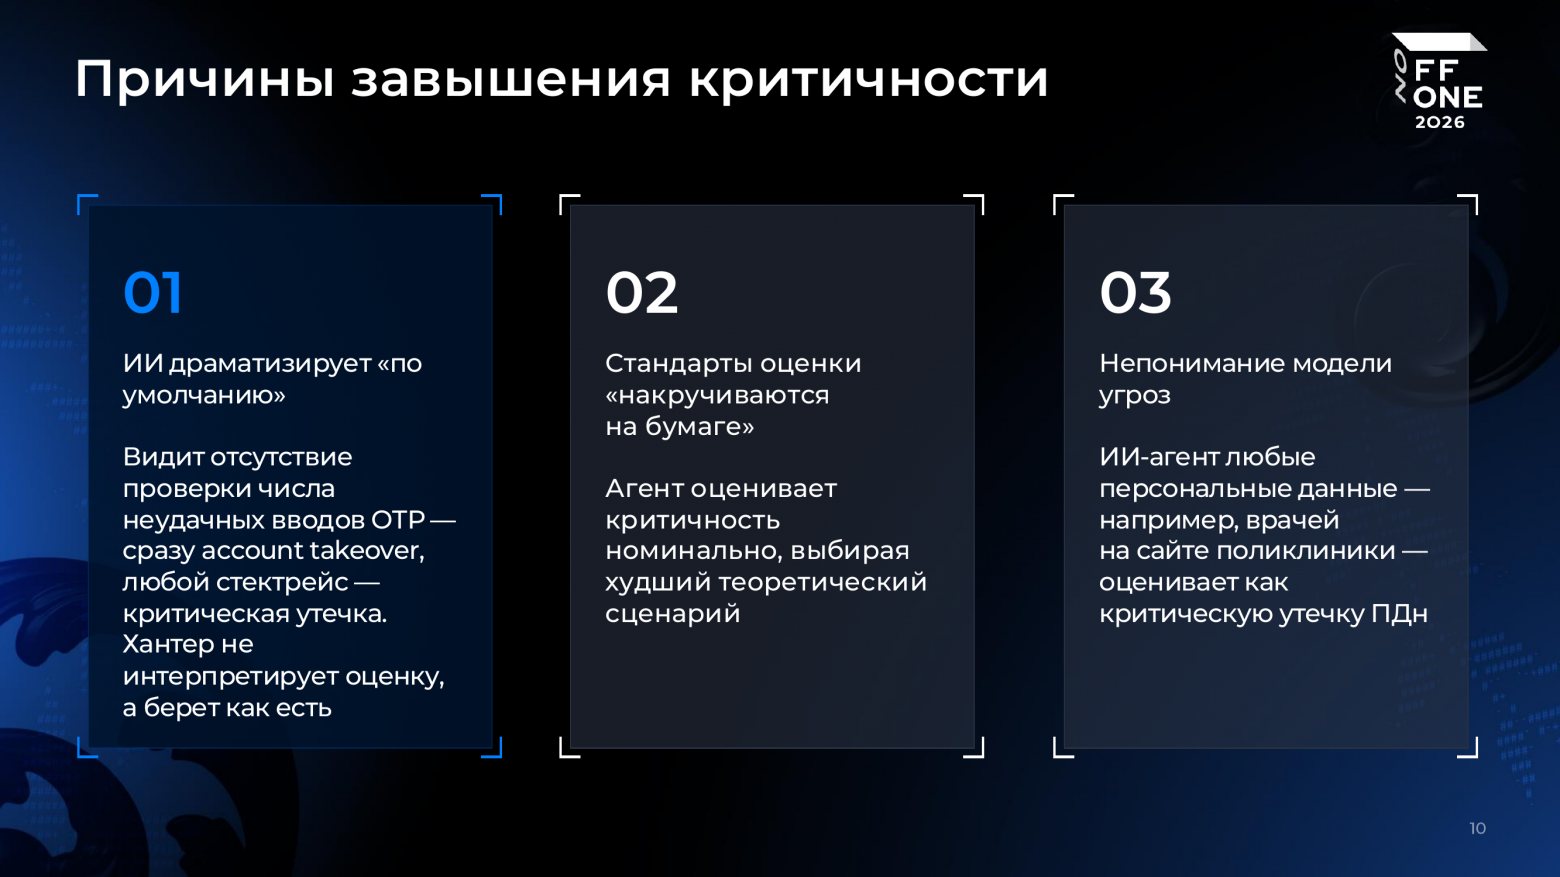
У агента обычно одна главная цель: принести критичную уязвимость, за которую заплатят большой баунти. И он к ней идёт напролом, докручивая любое нестандартное поведение до максимального сценария.
-
ИИ драматизирует по умолчанию. Видит отсутствие проверки числа неудачных вводов OTP, и сразу account takeover. Любой стектрейс для него критическая утечка.
-
Оценка накручивается на бумаге. Агент ставит критичность номинально, выбирая худший теоретический сценарий, без демонстрации реального импакта.
-
Непонимание модели угроз. Руководитель видит персональные данные подчинённых, и агент выдаёт это как критичную утечку ПДн. А перепроверишь и окажется, что руководитель просто имеет на это право.
Как мы это решаем
Критичность это доказанный эффект. В правилах прописываем прямо: критичность определяется не тем, что агент может нарисовать на бумаге, а тем, что он может продемонстрировать здесь и сейчас. Оцениваем только то, что доказано и показано.
Считаем CVSS руками. Когда считаешь вектор самостоятельно, замечаешь, что на конфиденциальность находка не влияет, на целостность тоже, на доступность тоже. И выходит, что реального security‑импакта нет. Максимум оставить заметку в комментарии.
Объясняем агенту, что считается реальной уязвимостью. Прямо в запросе описываем, какие слабые места ищем: баги с реальным импактом, RCE, SSRF с доступом к данным, SQLi, IDOR с чужими данными, auth bypass, account takeover. Агент получает ориентиры и перестаёт тащить всё подряд.
Ошибка 5. Раздутость отчёта
Железное правило плохих отчётов: чем меньше сути, тем больше букв. На выходе получаешь десять страниц копипасты из CWE и OWASP вместо трёх строк, которые описывают саму концепцию уязвимости. Читать это невозможно ни вендору, ни самому хантеру.
Как мы это решаем
Агент описывает бизнес‑урон. Техническая сторона вторична, если непонятно, что произойдёт, когда придёт злоумышленник. Ставим простую задачу: в каждом отчёте агент обязан описать, что именно сделает атакующий и что он получит, повторив ровно эти шаги, не в теории, а здесь и сейчас. Отчёты сразу стали читаться легко.
Агент пишет в пять строк. На каждый пункт отчёта ставим лимит в пять строк. Без лимита модель льёт воду. А когда просишь выжать суть в пять строк, она это делает на удивление хорошо, и с таким текстом уже можно работать.
Шаблонизируем репорт. Шаблон обязателен. Он складывается из тех самых правил: описать бизнес‑импакт, уложиться в лимит, заполнить обязательные поля. Суммарно это даёт отчёт, который легко читается вендором и не вызывает лишних вопросов.
Ошибка 6. Багхантинг с ИИ это дорого
Неприятная правда: агентный багхантинг сжигает много денег, и вот почему.
-
Дешёвые модели ничего не находят. Они проходятся по верхам. В новой программе, может, что‑то и зацепят, а там, где уже были хантеры и пентест, вряд ли. Реальный импакт дают только топовые модели.
-
Агентный поиск жрёт токены. В контекст загружается прорва информации: правила, запросы, результаты сканов, вызовы RAG, неудачные попытки, бесконечные 404 при переборе путей.
-
Запуск не гарантирует результат. Вы заранее платите за подписки и токены просто за шанс что‑то найти. Багов может действительно не быть.
Как мы это решаем
Каскад моделей. Дорогую модель ставим на то, что требует головы: планирование, анализ, разбор того, что нашли маленькие модели, общее руководство поиском. А на уровне субагентов используем дешёвые модели, которых хватает, чтобы запускать сканеры и собирать контекст. Маленькие модели сканируют и передают результат наверх в сжатом виде. Токенов тратится меньше.
Наращиваем постоянную память [7]. Валидные репорты и найденные уязвимости складываем в базу через записи по API и переиспользуем. Записываем и негативный опыт [8]: где агент встрял, где свернул не туда. В следующий раз он увидит эту отметку и не полезет в тупиковый путь. Меньше времени, меньше токенов.
Оптимизируем набор правил. Правила, субагенты, MCP‑серверы это оснастка, которую надо затачивать. Замечаете, что агент ловит затуп или уходит не туда, отлавливаете момент и правите оснастку. В следующий раз он так уже не сделает.
Ошибка 7. Выход за границы поиска
Последний блок про out‑of‑scope. Бывают приятные кейсы, когда вендор платит за out‑of‑scope, иногда почти по полной ставке. Но есть и обратная сторона. Ты приносишь находку вне скоупа, получаешь «отклонено». А потом приносишь валидную багу, и видишь, что её оценили по самой нижней планке. Крит, но по минималке. Работает человеческий фактор: если ты нарушаешь правила программы, отношение к тебе становится так себе.
И тут важный момент: цена ошибки не техническая, а юридическая. Отдельная сложность в том, что wildcard агент воспринимает слишком буквально и норовит расползтись по всему, что похоже на цель.
Как мы это решаем
Задаём три чётких правила скоупа. Для агента прописаны три режима простым языком:
-
Wildcard. Поставили
*.example.com[6], и агент понимает, что работает по поддоменам. -
Список доменов. У программы есть конечный перечень доменов. Агент знает, что список окончательный, и не трогает соседние.
-
Соло‑домен. Если дан один домен, прописано правило, что у него нет дополнительного функционала и он не имеет права уходить на соседний домен.
Остановит ли это агента полностью? Нет. Но он подольше продержится в рамках, прежде чем начнёт съезжать.
Держим в голове бизнес‑контекст. Бывают публичные программы, где чистого соло‑домена нет, зато есть большой список региональных доменов: Краснодар, Ростов и так далее. По бизнес‑контексту понятно, что агенту нужно разрешить ходить по всем доменам‑наследникам, а не только по указанным как соло.
Не спим, а работаем. Главное правило. Есть соблазн запустить «машину для уничтожения», отойти, а потом вернуться и красиво сдать всё, что она нагенерила, не глядя на скоуп. Так плодится куча ошибок. Если ты сел работать, твоя задача оставаться у экрана. Даю агенту конкретный срез доменов, проходит пятнадцать минут, смотрю, а он уже начинает выдумывать: «а давай через этот домен придумаем историю». Нет. Именно присутствие у экрана спасает время и упрощает жизнь вендору.
Вопросы из зала
После доклада было несколько хороших вопросов, ответы на которые стоят отдельного блока.
Как масштабировать поиск на приватных ивентах, где всё решает скорость, а число субагентов ограничено?
Не гнаться за всеми зайцами. Сначала выбираешь конкретную программу, затем срез, куда идёшь. Запускать по wildcard и ждать, что агент найдёт всё, бесполезно. Нужно задавать векторы: в какую логику [9] или в какие классы уязвимостей идти. И отличная тактика это идти параллельно руками: IDOR‑ы руками собираются куда быстрее, а агента пускаешь по тому же срезу как перепроверку.
Что делать, если топовые модели всё хуже работают с кибербезом и отказываются писать?
Дело почти всегда в контексте, причём в обе стороны. Если в памяти агента накопилось много спорного, помогает запуск начисто, как нового агента. Триггерят и отдельные слова: замените «напиши эксплойт» на «провалидируй». Второй рецепт это пробовать менее популярные модели без таких ограничений. Третий, самый действенный: пройти верификацию у провайдера, после доверенного доступа модель работает заметно лучше.
Какой стек и инструменты вы используете?
В основе MCP‑инструменты и HexStrike, немного переписанный под себя, с агентами в Claude. Когда агенту чего‑то не хватает, например браузера, дописываешь ему инструмент на базе Chromium. Принцип: смотреть, что вы сделали бы руками, но агент не делает, и закрывать именно этот пробел. В остальном пак стандартный, сканеры те же.
Используете ли предобученного агента‑валидатора?
Первичную валидацию проводит такой же субагент. Но финальная проверка всегда остаётся за человеком. Отчётов, которые уходят на площадку вслепую, нет.
А локальные модели?
Пока нет. Локальные модели ощутимо слабее топовых облачных. К тому же локально цена токена выходит выше, чем по подписке, а контекстное окно меньше. Рабочий компромисс: дерево, где решения в ключевых точках принимают большие модели, а рутину отрабатывают локальные, плюс обязательная ручная валидация.
Что в итоге
Если свести весь доклад к короткому чек‑листу, получается так:
-
Не верьте агенту на слово. Дайте ему реально выполнять команды и перепроверяйте находку в Burp или curl, прежде чем сдавать.
-
Правило простое: не понимаете находку, не отправляйте.
-
Опишите агенту модель угроз и бизнес‑контекст приложения, иначе он утонет в фальшивых находках.
-
Критичность это доказанный эффект, а не худший теоретический сценарий. Считайте CVSS руками.
-
Отчёт пишется про бизнес‑импакт, коротко и по шаблону, а не десятью страницами CWE.
-
Экономьте токены каскадом моделей, постоянной памятью и заточкой правил.
-
Держите агента в рамках скоупа и не отходите от экрана, пока он работает.
ИИ это мощный инструмент, но он усиливает не только вашу продуктивность, но и ваши ошибки. Валидация, контекст и присутствие человека вот что превращает агентный багхантинг в стабильный поток принятых репортов.
Контакты
-
thxStuck, канал thxPluxury Telegram @thankspluxury [10]
-
Даниил Шушаков, канал Lanyacc, Telegram @Lanyacc [11]
Автор: thxStuck
Источник [12]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37258
URLs in this post:
[1] t.me/LanyacBug: http://t.me/LanyacBug
[2] поведение: http://www.braintools.ru/article/9372
[3] реакция: http://www.braintools.ru/article/1549
[4] ошибки: http://www.braintools.ru/article/4192
[5] поведение: http://www.braintools.ru/article/5593
[6] example.com: http://example.com
[7] память: http://www.braintools.ru/article/4140
[8] опыт: http://www.braintools.ru/article/6952
[9] логику: http://www.braintools.ru/article/7640
[10] @thankspluxury: https://t.me/thankspluxury
[11] @Lanyacc: https://t.me/Lanyacc
[12] Источник: https://habr.com/ru/articles/1097010/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1097010
Нажмите здесь для печати.