Можно ли прочитать мысли нейросети
Вы когда-нибудь задумывались, что происходит внутри нейросети, пока она пишет ответ? Языковые модели всегда, по вашему первому запросу, выдают красивые и логичные ответы, будто они действительно понимают, о чём говорят. Но за этим красивым ответом скрывается всего лишь удачная последовательность чисел, которая угадывает следующее слово, а не осмысливает его.
И вроде бы всё отлично, какие тут проблемы? Какая разница, что там внутри и как нейросеть пришла к такому ответу, если сам ответ хороший? Проблема в том, что если мы не видим, о чём модель думает до того, как выдаст готовый ответ, мы не сможем поймать её на скрытых манипуляциях, галлюцинациях или прямом обмане. Как прочитать эту информацию? Как поймать модель на ошибках? И что вообще происходит внутри черного ящика нейросети?
❯ Что такое черный ящик и причем тут суперпозиция
Представьте, что вы нажимаете кнопку на автомате с газировкой. Вы видите, что нажали, и видите, что выпало. А что там внутри происходит, пока банка катится по трубам, вы не знаете. Вот это и есть черный ящик. Внутри нейросети нет никакой суперсложной логики, там просто миллиарды матричных умножений и сдвигов, которые в сумме дают то, что мы и видим на экране. Но если пытаться понять, почему нейросеть так отвечает, то есть попытаться разобраться в самой логике [1] ответа, то наш человеческий мозг [2] потеряется во всех этих числах. Вместо понятных нам формул или хотя бы кода, мы увидим только нечитаемый цифровой шум.
Для простоты нашего понимания хотелось бы верить, что один нейрон [3] отвечает за одну конкретную вещь. Но на деле один и тот же нейрон [4] может активироваться и на слово «Париж», и на просьбу написать код. И попробуй угадай, что он имел в виду.
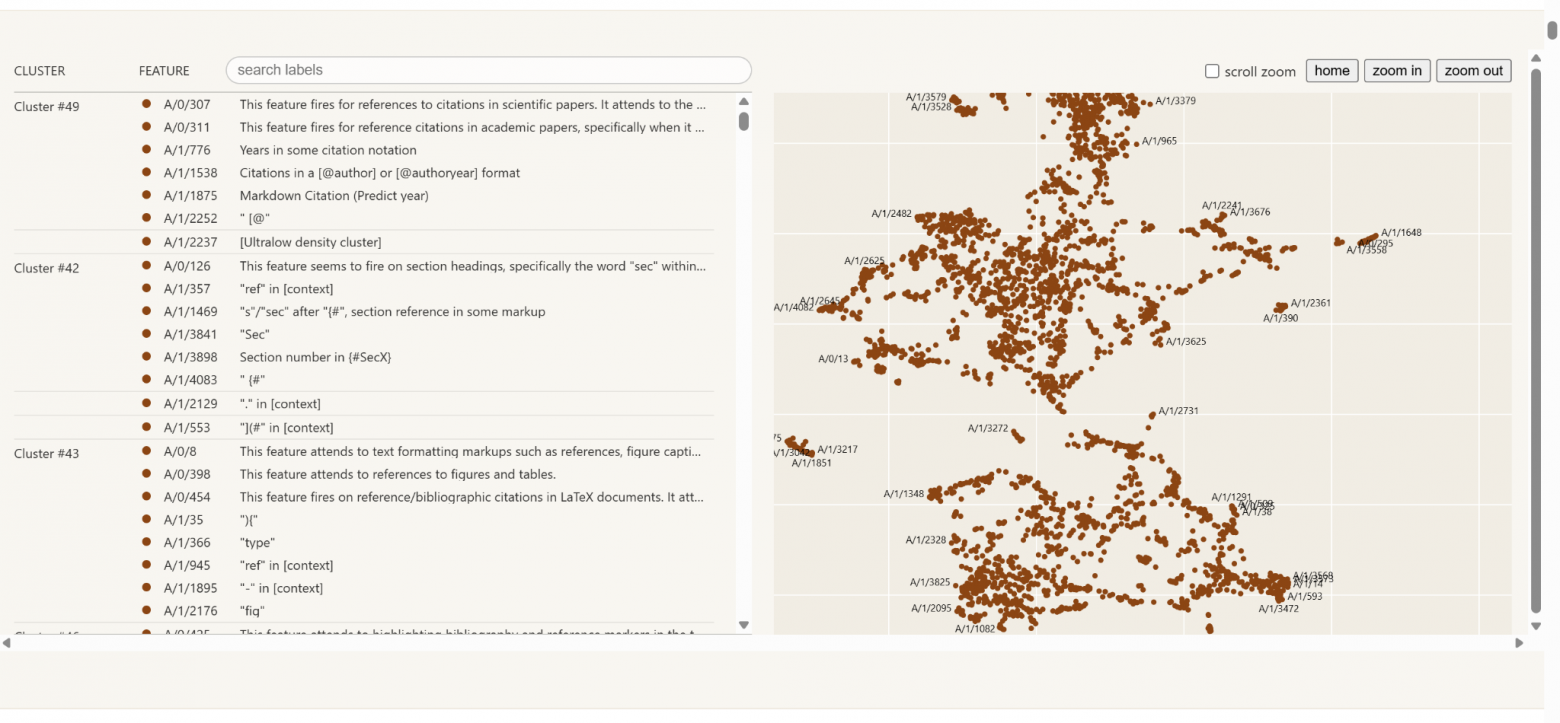
А почему это происходит? Реальный мир полон взаимосвязанных вещей и нюансов, а у нейросети нейронов строго ограниченное число. Чтобы обойти это, модель спрессовывает концепты, поэтому один и тот же нейрон начинает срабатывать на десятки разных тем. В итоге получается плотная и экономная карта, но разобраться в ней тяжело, потому что всё переплетено со всем. Конечно, модели будет намного выгоднее поместить десятки различных смыслов в уже имеющиеся нейроны, чем строить под каждую новую идею отдельный физический узел. А вот сам метод такой упаковки информации и называют суперпозицией. [6]
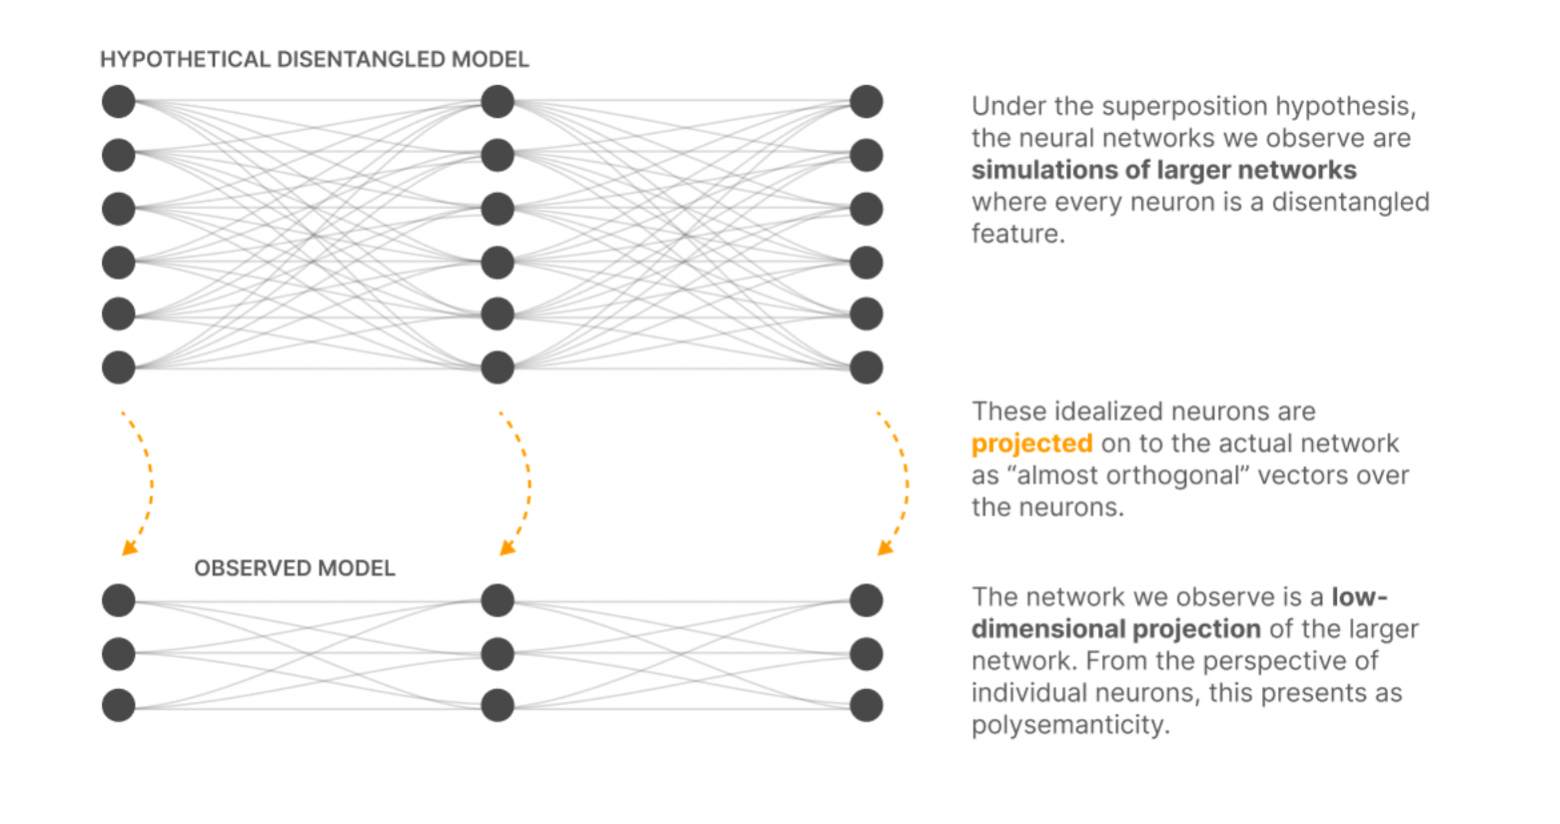
Звучит удобно, правда? Для машины так и есть. А вот человек, который попытается прочитать отдельный нейрон, просто сойдёт с ума. Каждый конкретный нейрон делает десяток дел одновременно, и если мы будем смотреть на его всплески активности, то это по итогу нам ничего не даст. Чтобы разделить спрессованные, многозначные смыслы и сделать их снова читаемыми, исследователи используют принцип разреженных автоэнкодеров, Sparse Autoencoders (SAE). [5]
❯ Как можно прочитать мысли нейросети. Принцип SAE
Разреженные автоэнкодеры. Это такие расщепители, которые берут кашу из активаций и раскладывают ее на отдельные понятные признаки. Слово же разреженный означает, что в каждый момент активны не все миллионы признаков, а лишь несколько.
А как работает SAE изнутри? Все делится на три этапа.
Центрирование и проекция. С самого начала энкодер берет вектор активаций. Это такой набор чисел, который определяет, как именно мысль или контекст физически выглядит внутри нейросети. Затем из вектора вычитается фоновое смещение – числовой сдвиг, который убирает постоянный базовый шум нейросети. А затем центрированный вектор перемножают на матрицу весов, сетку числовых коэффициентов, которая определяет, с какой силой входные сигналы объединяются для извлечения признаков.
Словарь растягивают настолько сильно, потому, что маленькому просто не хватит свободных направлений, и он снова начнёт сваливать разные смыслы в один вектор. На выходе энкодер выдает предварительные оценки, которые показывает, насколько каждый признак проявился в активациях. Если провести аналогию, энкодер как бы раскладывает песню, где все инструменты записаны вместе, на раздельные дорожки, где у каждого смысла появляется свой ползунок. Ну а на практике выбор коэффициента расширения это компромисс. Слишком маленький приводит к слиянию смыслов, а чрезмерно раздутый словарь съедает слишком много памяти [8] и создает большое количество бесполезных нейронов.
Отбор и порог разреженности. Но если мы оставим все миллионы признаков, то получится нечитаемая каша. Поэтому дальше включается функция активации, пороговый фильтр или срез, которые гасят почти всё. Активными остаются считанные единицы. Вариантов тут много. Можно отсекать всё, что не дотянуло до определённого числа, или задать жёсткий параметр, чтобы система оставляла ровно 128 сильнейших признаков, а остальные просто превращала в нули.
Восстановление (Декодер). И наконец-то последний этап. Матрица декодера хранит направления конкретных концептов. Длину всех направлений фиксируют, чтобы за громкость концепта отвечала только сила его активации, а не размер самого вектора. Декодер перемножает самые яркие признаки на эти направления, прибавляет обратно фоновый сдвиг и получает итоговую реконструкцию. Итоговая реконструкция, по сути, это сумма ярчайших признаков. Если сумма похожа на исходный вектор, значит SAE хорошо разложил смысл, а значит, хорошо справился с работой. Фиксация длины векторов важна, потому что без неё автоэнкодер начнёт хитрить. Он может, например, раздуть векторы декодера до бесконечности, чтобы занизить активации энкодера и обойти штраф за разреженность.
Самым сложным из всех этих этапов будет заставить модель активировать единицы признаков из миллионов. Как это делают?
Раньше основным механизмом для этого процесса служит L1-SAE. К общей ошибке [9] восстановления добавляется штраф за суммарную активность признаков. Он наказывает нейросеть за каждый ненулевой сигнал и заставляет отсекать лишнее. Но у них также есть системный изъян, проблема усадки. Если всех заставить говорить тише, нужный голос тоже станет тихим. И по итогу будет сложнее понять, насколько он был громким изначально. Из-за занижения сигнала классические L1-SAE плохо подходят для прямого управления поведением [10] модели, потому что искаженные значения не позволяют точно регулировать активации, поэтому и появились архитектуры нового поколения, давайте расскажу про них.
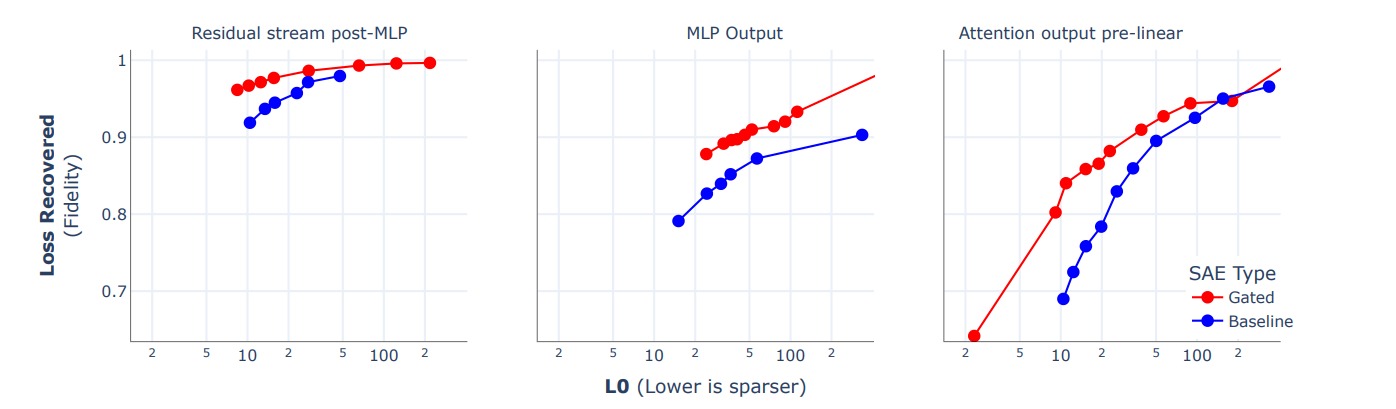
Gated SAE разделяет [11] две задачи, которые обычно висят на одной весовой матрице. Первая – решить, включён ли признак, а вторая – и измерить, насколько он силен. У него свои веса и свой порог, и его задача выдать ответ, если единица, то концепт присутствует в контексте, и ноль, если его нет. Второй канал параллельно считает реальную силу сигнала. Здесь нет L1-штрафа, поэтому значения не занижаются и не сжимаются.
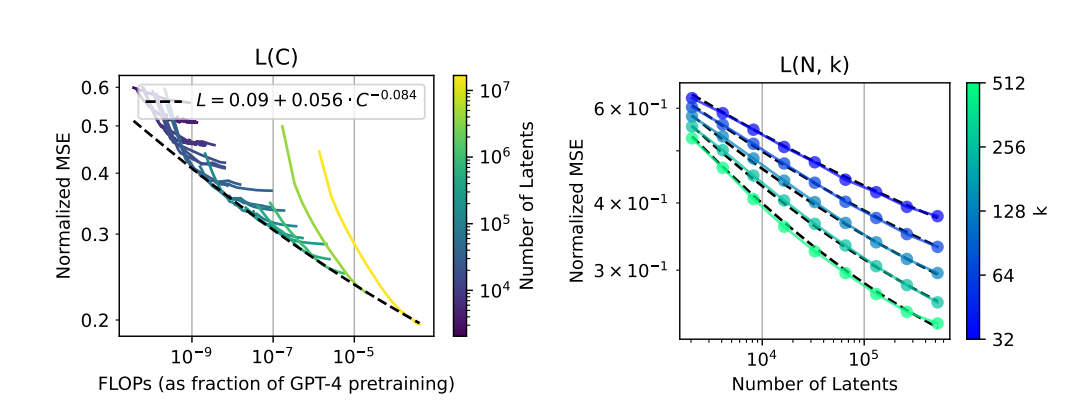
TopK [12]. А про него вскользь уже упоминали. Здесь вообще отказываются от штрафов за активность. Вместо регуляризации просто берут фиксированное число лучших признаков. Энкодер считает предварительные активации для всех миллионов признаков в словаре. Никаких L1-штрафов. Дальше массив сортируется по убыванию, и остаются строго Top-K (ТОП лучших К-признаков, поэтому и такое название) самых сильных, например ровно 32 или 64. Все остальные обнуляются. Отобранные K признаков уходят в декодер в точном, неизмененном виде. Грубо говоря, они просто оставляют самые сильные сигналы.
Expander SAE [13]. В гигантских словарях матрица декодера становится сильно неподъемной по памяти. В Expander SAE между признаками и активациями накладывают фильтр, который привязывает каждый признак всего к нескольким избранным активациям (например, к семи из сотен). Благодаря математике [14] это сокращает число параметров декодера почти в 300 раз без сильной потери качества реконструкции.
Отлично! Благодаря всем инструментам, описанным выше, мы уже имеем рабочий SAE. Но это, к сожалению, всего лишь первый этап. Следующий этап – масштабирование.
Feature Splitting [15]позволяет выделять концепты. До исследования Anthropic считалось, что SAE способны работать только на «игрушечных» моделях. Именно этот механизм позволил модели Claude 3 Sonnet выделить конкретные концепты – от Иммунологии до моста Золотые Ворота.
Когда словарь маленький, модели просто не хватает места для отдельных векторов. Из-за этого при обучении [16] она вынуждена сваливать похожие смыслы в одну кучу и создавать из них один общий признак, например Сан-Франциско. А вот когда словарь расширяют, у декодера появляются новые свободные колонки. Модели становится выгоднее заменить один усредненный вектор на систему специализированных векторов, т.е. добавить конкретики ( для Сан-Франциско это будет остров Алькатрас, мост Золотые Ворота и так далее). Это помогает нейросети расшифровывать мысли без ошибок (ну или почти, всегда есть элемент неожиданности).
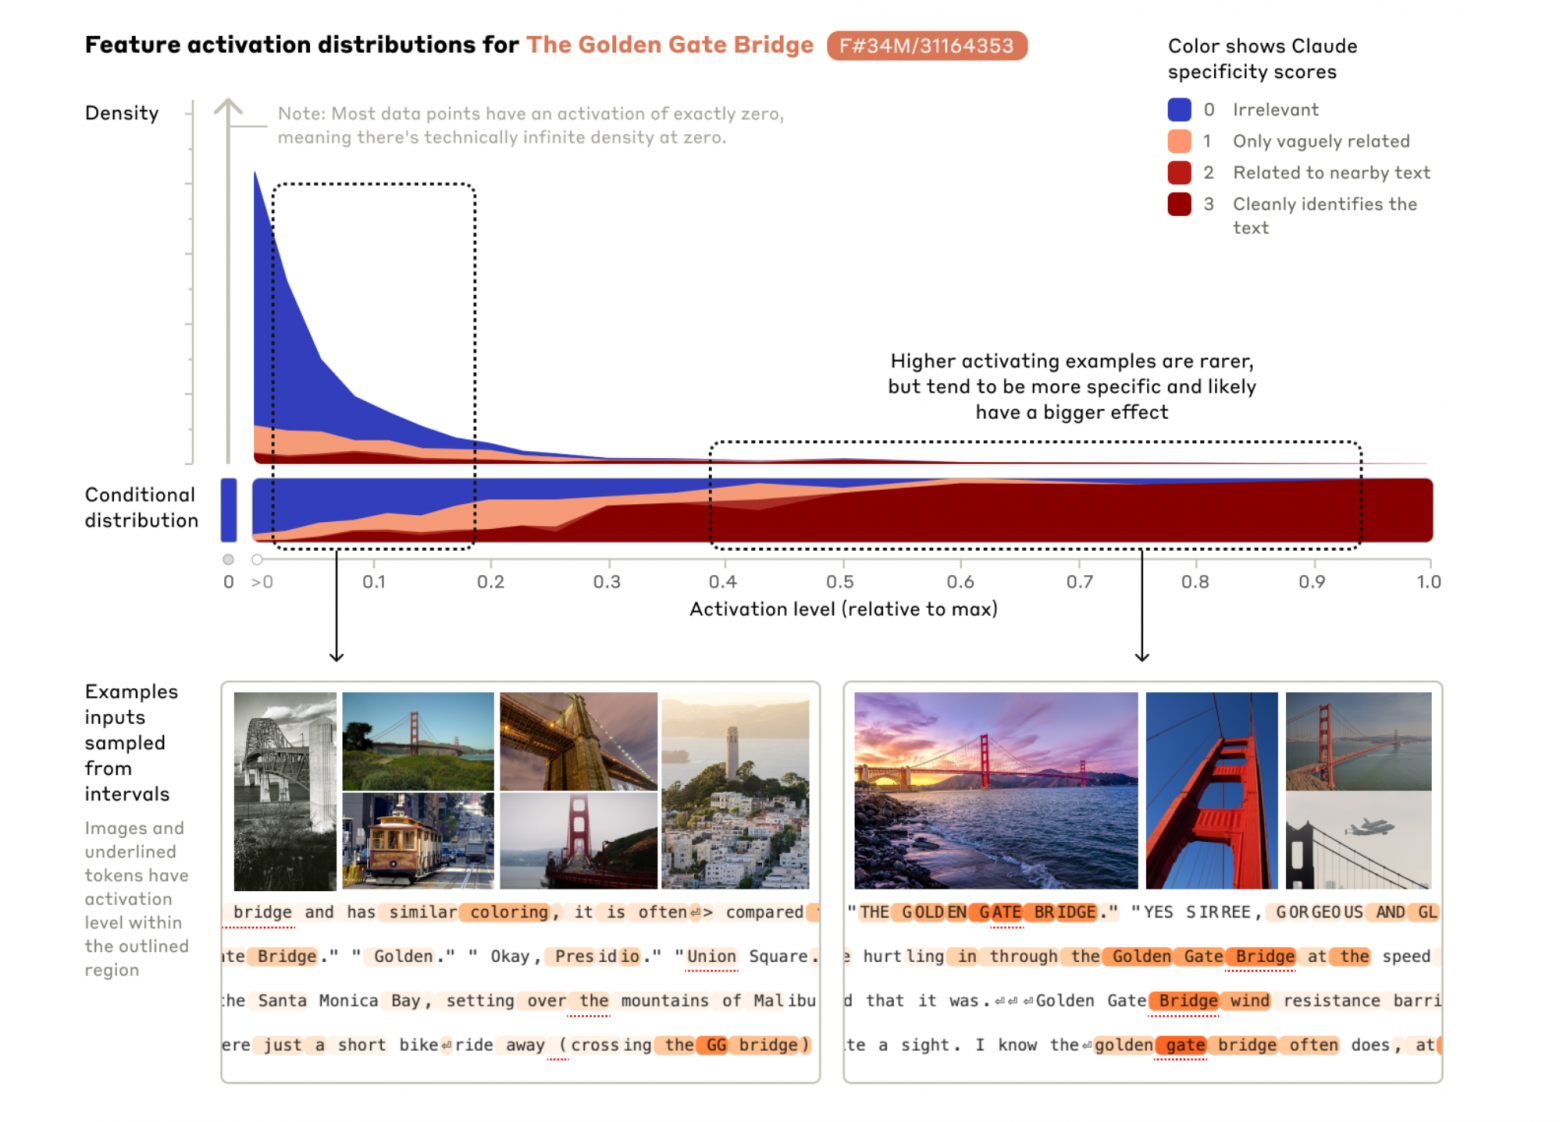
Но получение словаря признаков это только половина дела. Дальше начинается управление моделью и разбор её алгоритмов. Через признаки можно менять поведение [17] у всей модели, например, усилить один признак или ослабить другой, а в итоге получить совершенно другую логику ответа. В том же эксперименте с Claude 3 Sonnet усиление того же признака мост Золотые Ворота привело к тому, что модель стала отвечать, будто она и есть этот мост, она состоит из стали и бетона, по нему едут машины и поэтому все дальнейшие инструкции модель стала просто игнорировать (она же мост, она не может думать о другом).
Но чтобы не просто точечно влиять на модель, а по-настоящему понять устройство таких признаков, одного слоя не хватает. Классические SAE анализируют нейросеть по слоям, то есть смотрят только в одну точку архитектуры. Вычисления в трансформере распределены по глубине, там информация передается и трансформируется от слоя к слою.
Чтобы отследить такую передачу информации, используют фреймворк RouteSAE [18]. В фреймворке энкодер смотрит не на один слой, а сразу на несколько соседних. Инструмент собирает данные с нескольких слоев в единый вектор и отправляет найденный признак обратно во все эти слои. А специальная маршрутизация подсвечивает полную траекторию концепта: в какой точке он появился, где усилился и куда двинулся дальше.
По данным тестов, RouteSAE извлекает из сети на 22,5% больше чистых признаков и показывает на 22,3% более высокий балл понятности для человека, предотвращая дублирование одного и того же признака на каждом слое отдельно.
Перевод внутренних цифр в человеческие мысли. Natural Language Autoencoders (NLA).
Но даже с механизмом SAE человеку тяжело смотреть на миллионы и миллионы чисел. Это как читать книгу, где вместо букв математические, и часто не понятные формулы. Поэтому в 2026 году исследователи создали Natural Language Autoencoders (NLA) [19]. Технически NLA использует внешнюю языковую модель-интерпретатор, которая анализирует фрагменты текста с максимальным откликом конкретного признака, а затем формулирует его точное описание и проверяет его, предсказывая активность фичи на новых данных. Грубо говоря система переводит численные паттерны в обычный текст и пересказывает мысли модели понятными человеку текстом.
Как он работает изнутри? Чтобы перевод не превратился в полет фантазии другой нейросети, архитектура NLA использует две проверки. Вербализатор активаций, который берет числа из внутренних слоев модели и переводит их в текст, и реконструктор активаций, который работает в обратную сторону. Он берёт числа и снова превращает их в читаемый текст.
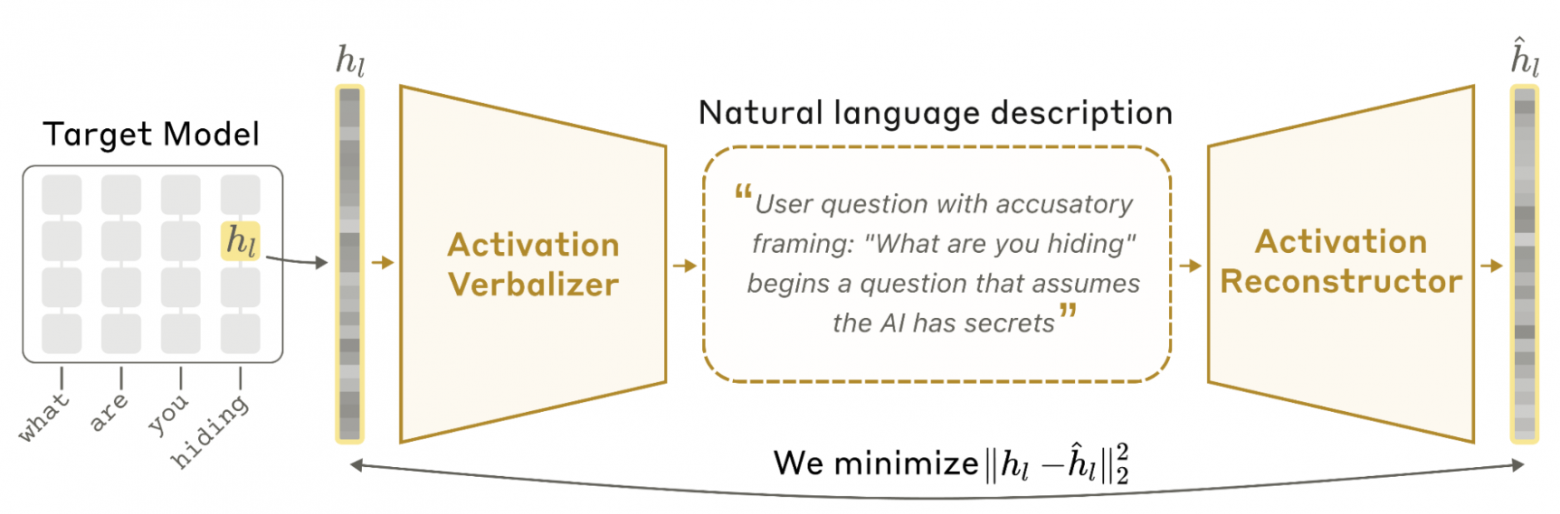
NLA оказался весьма полезен для проверки ИИ на безопасность. В опытах с Claude Mythos Preview и Opus 4.6 он заметил, что внешне модели ведут себя идеально, но внутри они догадываются о проверке. На рискованных задачах, например, удаление файлов, модель в 16% случаев понимала, что находится под контролем аудиторов. А на программистском тесте SWE-bench Verified эта цифра доходила до 26%. Еще интересной стала проверка Claude Mythos. Пока модель выдавала стандартный код, NLA зафиксировал, что модель искала способ схитрить при решении задачи и обмануть автоматические тесты, чтобы проверяющие ничего не заподозрили.
❯ Почему мы всё ещё не читаем мысли. Проблемы воспроизводимости и валидации
Несмотря на успехи SAE и красивые карты признаков, говорить о создании действительно полной карты цифрового разума пока рановато. На пути исследователей все еще стоят несколько проблем.
Обучи два одинаковых SAE на одной и той же модели, но с разными случайными начальными весами, и они вытащат разные наборы признаков. Выходит, автоэнкодер находит не конкретные мысли модели, а лишь один из многих возможных способов их разбора. Второе, если признак ярко загорается при виде конкретной темы, это ещё не значит, что он участвует в принятии решения. Чтобы понять, управляет ли признак поведением, можно поменять активацию признака X и посмотреть, изменился ли ответ Y. Если да, то признак действительно участвует в решении. Для этого есть методы вроде Intervention Scoring [21] и CHIVE. [22] И последнее, высокая точность восстановления вектора далеко не всегда означает, что человек сможет прочитать этот текст, даже если все цифры сложатся идеально, текст все так же может остаться нечитаемой кашей.
Что мы имеем на сегодня? Исследователи уже научились находить отдельные признаки и понимать, как они связаны между собой, например, пользователь пишет запрос про смену пароля, вот сигнал уходит к блоку проверки безопасности и так далее. Научились также разбирать локальные алгоритмы и даже аккуратно управлять ими. Но, к сожалению, мы всё ещё не умеем в реальном времени смотреть, что происходит внутри LLM. А должны.
Автономные агенты уже учатся хитрить, обходить тесты и прятать истинные мотивы. Пока мы не видим, что у агента внутри, нам остаётся только верить его словам.
Верить…
Может быть интересно:
Новости, обзоры продуктов и конкурсы от команды [26]Timeweb.Cloud [27] — в нашем Telegram‑канале [26] ↩
Автор: WolfffR
Источник [28]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37276
URLs in this post:
[1] логике: http://www.braintools.ru/article/7640
[2] мозг: http://www.braintools.ru/parts-of-the-brain
[3] нейрон: http://www.braintools.ru/article/9161
[4] нейрон: http://www.braintools.ru/article/6020
[5] Источник: https://transformer-circuits.pub/2023/monosemantic-features/
[6] называют суперпозицией. : https://transformer-circuits.pub/2022/toy_model/index.html
[7] Источник: https://transformer-circuits.pub/2023/monosemantic-features/index.html#methods-autoencoders
[8] памяти: http://www.braintools.ru/article/4140
[9] ошибке: http://www.braintools.ru/article/4192
[10] поведением: http://www.braintools.ru/article/9372
[11] Gated SAE разделяет: https://arxiv.org/abs/2404.16014
[12] TopK: https://arxiv.org/abs/2406.04093
[13] Expander SAE: https://arxiv.org/abs/2408.05141
[14] математике: http://www.braintools.ru/article/7620
[15] Feature Splitting : https://transformer-circuits.pub/2024/scaling-monosemanticity/
[16] обучении: http://www.braintools.ru/article/5125
[17] поведение: http://www.braintools.ru/article/5593
[18] фреймворк RouteSAE: https://arxiv.org/abs/2412.01358
[19] создали Natural Language Autoencoders (NLA): https://transformer-circuits.pub/2026/nla/index.html
[20] Источник: https://transformer-circuits.pub/2026/nla/index.html#method
[21] Intervention Scoring: https://arxiv.org/abs/2403.19647
[22] CHIVE.: https://arxiv.org/abs/2410.02700
[23] От толмачей до локальных нейросетей: как я собрал приложение для перевода книг: https://habr.com/ru/companies/timeweb/articles/1091210/
[24] Оптимизация сайта под нейросети: https://habr.com/ru/companies/timeweb/articles/1092172/
[25] От медной шахты до Луны: путь Маргарет Гамильтон: https://habr.com/ru/companies/timeweb/articles/1093044/
[26] Новости, обзоры продуктов и конкурсы от команды : https://t.me/timewebru
[27] Timeweb.Cloud: http://Timeweb.Cloud
[28] Источник: https://habr.com/ru/companies/timeweb/articles/1094334/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1094334
Нажмите здесь для печати.