Терминал, которого нет: я научил модель на 360M параметров изображать bash, vim и tmux
Коротко: я дообучил языковую модель на 360 млн параметров работать терминалом. Никакого шелла и файловой системы за ней нет: на вход идёт каждое нажатие клавиши, а модель предсказывает, как изменится экран. Она умеет создавать файлы, запускать vim и tmux, играть в змейку и обычно помнит, что вы написали несколько команд назад. Больше всего дали два приёма: научить модель исправлять собственные ошибки [1] и декодировать строки экрана параллельно. Попробуйте в браузере (208 МБ) [2] и наберите pythoon, чтобы убедиться, что это не настоящий шелл.
Демо рассчитано на десктопный браузер с WebGPU и физическую клавиатуру. Лучше всего открывать в Chrome или Edge. На современном телефоне оно тоже должно работать, но мучительно медленно.
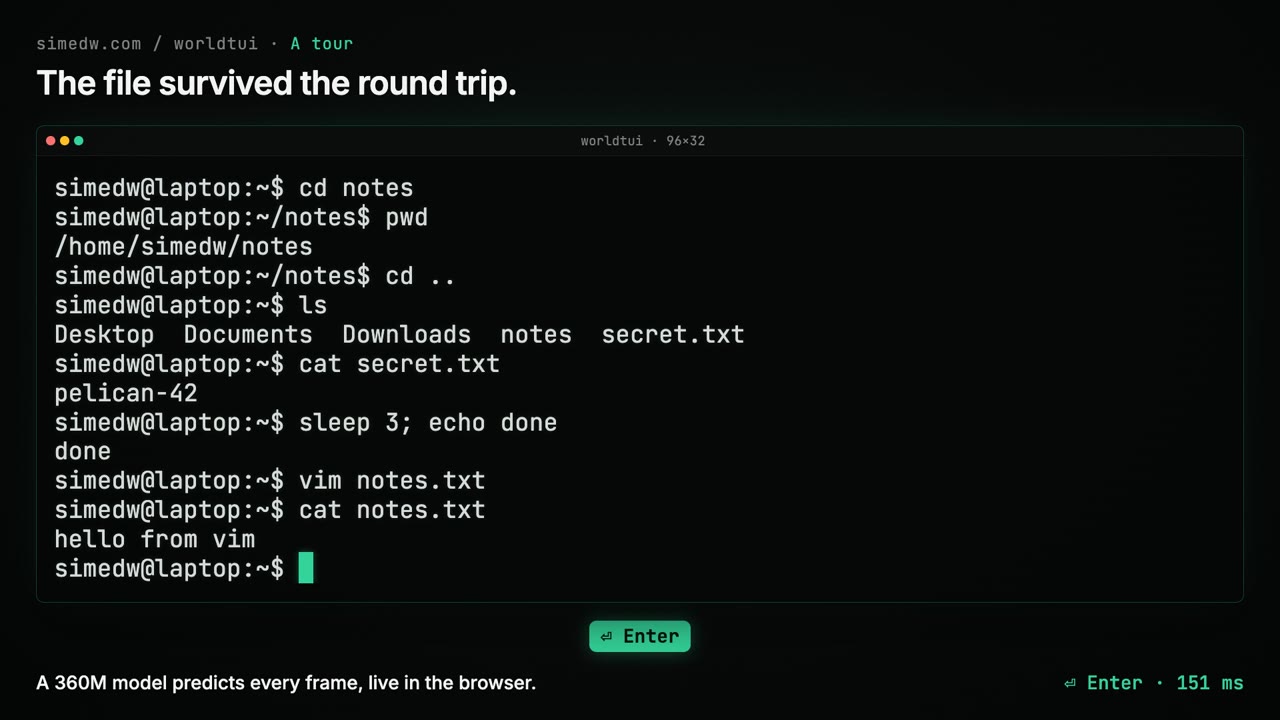
Когда в прошлом году я увидел Genie 3 [3], я начал представлять будущее, в котором приложения не пишут кодом, а обучают. Вместо игрового движка, который рисует сцену, модель предсказывает самый вероятный следующий кадр по действиям пользователя.
Разумеется, мне захотелось обучить собственную модель мира. Но у меня нет ни огромного GPU-кластера, ни горы видео, так что амбиции пришлось урезать: вместо игрового мира — терминал.
Терминал оказался удачным выбором. Это просто сетка символов вместо пикселей, и идеально размеченных обучающих данных можно нагенерировать сколько угодно, запуская настоящие шеллы. К тому же предобученная языковая модель уже неплохо представляет, что должны печатать ls или cat.
Больше всего мне хотелось понять, сможет ли модель поддерживать согласованный мир или будет просто генерировать правдоподобный вывод терминала.
Итоговая модель основана на Qwen2.5-Coder-0.5B и дообучена на сессиях терминала, записанных с настоящих программ внутри Docker.
Как модель видит терминал
Обычная LLM получает промпт и дописывает в конец токены, по одному. На терминал это ложится плохо. Одно нажатие клавиши может само по себе что-то сделать, как esc в vim, а вывод не всегда появляется внизу: clear стирает экран и отправляет курсор наверх. Поэтому вместо потока текста нужно предсказывать изменения экрана.
Я представляю терминал как сетку символов, по одному на ячейку [1]. Саму сетку модель напрямую не видит: она получает последовательность токенов, которые описывают содержимое экрана и изменения в нём.
Сессия
Каждая сессия начинается со снимка: размер экрана, его содержимое и положение курсора.
Размер тоже подаётся на вход, он не зашит как 32×96. В демо при создании своего стартового экрана можно задать число строк и столбцов.
BOS SCREEN_START 32 96
ROW_0 0 'simedw@laptop:~$ '
CURSOR 0 17 1
SCREEN_END
Так можно начать и с середины работы приложения. Дайте модели приглашение bash, буфер vim или партию в змейку, и она попробует продолжить с этого места. (Из bash у неё получается лучше.)
Дальше каждое нажатие клавиши подаётся в виде тех же байтов, которые отправил бы настоящий терминал. Буквы — это сами буквы, Enter — r, Escape — 0x1b, стрелка влево — ESC [ D и так далее.
INPUT_START 'l' INPUT_END
Модель отвечает, какие строки переписать и где окажется курсор:
OUTPUT_START
ROW_0 17 'l'
CURSOR 0 18 1
OUTPUT_END
Словами: в строке 0, начиная со столбца 17, написать l, затем поставить курсор в строку 0, столбец 18. Последняя 1 значит, что курсор видим: полноэкранные приложения иногда его прячут.
Предварительно ничего не стирается. Новые символы просто рисуются поверх старых.
Новые токены для символов мне не понадобились. В Qwen уже есть токены для всех 256 значений байта, и я использую их для символов, координат и других небольших чисел. Поэтому координата вроде 17 занимает всего один токен.
Время тоже подаётся на вход. Если ничего не нажато, модель получает вместо клавиши токен WAIT с длительностью. Так змейка продолжает ползти сама.
Копирование строк
Когда вы доходите до нижнего края окна терминала и нажимаете Enter, все строки должны сдвинуться на одну вверх. Можно было бы просить модель заново вывести каждую строку на новом месте, но это около 3000 токенов на одно нажатие.
Поэтому я добавил операцию COPY:
ROW_0 COPY 1
ROW_1 COPY 2
ROW_2 COPY 3
...
Каждая операция копирует строку с предыдущего экрана. В этом примере старая строка 1 становится строкой 0, строка 2 — строкой 1 и так далее.
Прокрутка теперь стоит три токена на строку вместо примерно 96.
Тот же приём покрывает очистку экрана, вставку и удаление строк в vim и листание man-страниц. Можно также скопировать строку, а потом переписать её часть.
Всего модель использует крошечный словарь из 333 токенов: 256 байтовых токенов, 64 токена строк и горстка специальных операций. Декодирование ограничено грамматикой, поэтому каждое предсказание — допустимое обновление экрана.
Этот крошечный словарь ещё пригодится позже, когда я буду втискивать модель в браузер.
Генерация обучающих данных
Сначала я поискал готовые наборы записей терминала, включая asciinema, но не нашёл ни одного с точным соответствием «нажатие — экран», которое мне было нужно.
К счастью, сделать свой оказалось не так сложно.
Идея была в том, чтобы генерировать правдоподобные сессии терминала, запуская настоящие команды в Docker-контейнерах и записывая каждое нажатие и экран после него.
Рецепт синтетики был такой:
-
Случайные имена пользователей, имена хостов, стили приглашения, размеры терминала.
-
Случайные каталоги и файлы на основе вымышленной персоны (разработчик, сисадмин и т. п.).
-
От 6 до 24 занятий, выбранных с весами (правка файлов, vim, python, tmux и т. д.).
-
Отслеживание состояния, чтобы сессии в основном открывали существующие файлы.
-
Печать как у человека: по одной клавише, с автодополнением по Tab и прочим. Частоту опечаток я поставил 1,2%, и это мне льстит.
-
35% сессий начинаются с середины, чтобы модель училась работать из любого состояния.
Размер терминала в основном был 32×96, иногда 24×80 и 40×120, чтобы модель не переобучилась под один размер.
По мере того как модель становилась способнее, я расширял набор данных и в итоге дошёл до 336 тысяч эпизодов, это примерно 2 млрд токенов. Для сравнения: базовая модель за время обучения [4] увидела около 18 трлн токенов.
Обучение
За основу я взял Qwen2.5-Coder-0.5B. Мне нужна была маленькая модель, чтобы приблизиться к работе в реальном времени. А раз это модель для кода, она уже видела много работы в командной строке.
Начал я с обычного дообучения с учителем: даётся история экрана и нажатие клавиши, нужно предсказать изменение экрана, которое выдал настоящий терминал.
Обычный набор текста модель выучила быстро: буква появляется, Backspace её удаляет, курсор двигается.
Но в длинных сессиях ошибки начинали накапливаться: ошибка в имени файла тянулась через всю оставшуюся сессию.
Учиться на своих ошибках
Чтобы с этим справиться, я позаимствовал идею у DAgger, где модель учится и на состояниях, в которые попадает сама, кроме идеальных демонстраций [2].
Для каждого обучающего примера:
-
Выбираем точку в записанной сессии, обычно рядом с командой, которая порождает вывод.
-
Даём модели предсказать следующие 1–4 события.
-
Сравниваем получившийся экран с настоящим записанным экраном.
-
Если разница достаточно мала, строим поправку, которая на следующем нажатии чинит экран модели.
-
Продолжаем обучение на исправленном кадре и нескольких следующих настоящих событиях.
Дельта переводит неверный экран модели в правильный следующий экран. По сути, модель учится «чинить» свои ошибки.
Есть одно важное ограничение: у модели должно хватать информации, чтобы вывести поправку. Любые слова, которые появляются в поправке, должны были встречаться на одном из прошлых настоящих экранов или во вводе пользователя. Собственных предсказаний модели для этого мало.
Например, если модель исказила имя файла, которое уже встречалось, я могу научить её это исправлять. Но если она выводит в списке файл, которого никогда не видела, требовать от неё правильного ответа нельзя.
Обучение на таких примерах фактически поощряло бы галлюцинации, а их мне и так хватает.
Примерно треть выбранных сессий дала полезные примеры поправок. Я повторил это в три раунда, каждый раз собирая ошибки свежей модели.
Самокоррекция оказалась одним из самых действенных изменений в обучении. Вместе с дополнительными данными она подняла результат на PresetBench (о нём ниже) с 24/47 до 38/47 в int4.
Всего обучение модели и её последующие доработки заняли около 75 GPU-часов на RTX 4090.
Проверка
Я использую три теста. ShellBench — 106 команд в 24 вручную написанных bash-сессиях, оценка по точному совпадению вывода. PresetBench — 47 заскриптованных случаев, собранных из сбоев, на которые я натыкался в демо. Ни того, ни другого нет в обучающих данных.
Тест памяти [5] состоит из 32 миров. В каждом два случайных значения пишутся в два файла, а затем читаются обратно в отдельных сессиях. Мир засчитывается, только если оба чтения точные, всего получается 64 чтения. Имена и значения в обучающих данных не встречаются [3].
Сколько даёт дообучение?
|
Модель [4] |
ShellBench, из 106 |
Чтения файлов, из 13 |
|---|---|---|
|
Qwen2.5-Coder-0.5B с промптом |
52 |
2 |
|
Qwen3-0.6B с промптом |
60 |
3 |
|
WorldTUI |
80 |
9 |
Сильнее всего разница видна в памяти: WorldTUI правильно прочитала 9 файлов из 13, а модели с промптом — 2 и 3.
До надёжной файловой системы ей всё ещё далеко. Знакомые команды она обрабатывает довольно хорошо, но новые их сочетания легко всё ломают. Например, после echo green >> colors команда cat colors часто не показывает дописанную строку.
Ускорение
Какое-то время я вообще обходил авторегрессионные модели стороной. Полная перерисовка — это около 3000 токенов, и генерировать их по одному казалось безнадёжным для штуки, которая должна ощущаться как терминал.
Но они просто работали намного лучше альтернатив, которые я пробовал, и я сдался. При генерации по одному токену набор текста ощущался нормально, около 38 мс на клавишу, но всё, что перерисовывает весь экран (vim test.txt, man, clear), занимало на моей RTX 4090 до 12 секунд, ровно как я и боялся. Масса времени, чтобы подумать, так ли мне нужен этот мануал. А я хотел, чтобы всё работало на моём Mac почти в реальном времени.
Строки параллельно
Я упустил из виду, что большинство строк в кадре не зависят друг от друга, так что генерировать их одну за другой незачем. Я запускаю по одному элементу батча на строку. Каждый получает одну и ту же историю (включая KV-кэш), но генерирует только своё обновление.
Это меняет стоимость декодирования с суммы по всем строкам, до 3000 шагов, на длину самой длинной строки, примерно 100 шагов.
Курсор становится отдельным шагом в конце, который видит весь набор обновлений строк.
Для этого понадобилась соответствующая маска внимания [6] при обучении, но прирост скорости того стоил. Задержка p95 на больших кадрах упала с 6,7 с до 0,87 с (RTX 4090).
Строки, которые не могут договориться
Звучит слишком хорошо, чтобы быть правдой, и так оно и было. Раз строки независимы, они не могут координироваться. Из-за этого vim открывался со строки 3 вместо строки 0, а в змейке еда появлялась в нескольких строках сразу.
Решением стало спекулятивное декодирование.
Обычно в спекулятивном декодировании маленькая модель набрасывает черновик токенов, а большая его проверяет. Благодаря каузальному вниманию несколько токенов можно проверить за один прямой проход.
Здесь я использую одну и ту же модель для обеих ролей: параллельные строки дают черновик, а затем модель проверяет его последовательно.
Проверяющий проход оставляет токены до первого расхождения. С этого места он генерирует свою поправку и заново предлагает оставшуюся часть черновика.
В браузере на моём M4 Mac ввод одного символа занимает около 60 мс. Обновление побольше, вроде man test, занимает 2,5 с последовательно или 0,9 с с параллельным черновиком и проверкой [5].
Уменьшение
Я начинал с Qwen2.5-Coder-0.5B, в которой примерно 494 млн параметров. Мне очень хотелось веб-демо, так что модель надо было ужать. Таблица эмбеддингов для словаря из 151 936 токенов — это 136 млн параметров. Мне нужны только мои 333 токена [6], поэтому почти всю таблицу можно выбросить, и модель уменьшается с 494 млн до примерно 360 млн параметров (990 МБ → 716 МБ).
Затем я квантовал её в int4, и она стала весить 208 МБ.
Браузерное демо использует собственную реализацию декодера Qwen на JavaScript с вычислительными шейдерами на WGSL, которые запускаются через WebGPU. Шейдеры распаковывают 4-битные веса прямо во время инференса. Активации и кэш внимания хранятся в 32-битных числах с плавающей точкой. Весь инференс идёт локально во вкладке.
Дистилляция
Попытка дистиллировать модель в меньшее число слоёв кое-что показала о том, от каких слоёв зависит память. Учителем был более ранний чекпойнт, который набирал 78/106 на ShellBench. Если просто убрать один слой, с индексом 7 (нумерация с нуля), без дообучения, точность предсказания следующего токена почти не менялась: с 99,3% до 98,9%. Но точные чтения в тесте памяти падали с 64/64 до 0/64. В этих тестах на вход подавалась настоящая история, так что сбой не был вызван накоплением ошибок.
Мой первый дистиллированный ученик сохранял все чётные слои, но вместо 22-го брал последний, 23-й. Он по-прежнему писал правдоподобный вывод терминала, но возвращал правильное значение только в 31 чтении из 64. Он всегда печатал одно из двух записанных значений, но примерно в половине случаев выбирал не то. Это уровень случайного угадывания, и после 480 млн токенов обучения лучше не стало.
Этот ученик выбросил слои 1, 7, 15 и 22. Ученик из 16 слоёв, который сохранил эти четыре, прошёл все 32 мира теста памяти, 64/64 точных чтения. И даже в 4-битном виде, при размере около 138 МБ, всё ещё проходил все 32 мира. Но в другом месте пришлось заплатить: на ShellBench он правильно выполнил 65 команд против 78 у учителя. Ученик может выглядеть нормально и при этом незаметно потерять память.
В итоге от дистилляции я отказался.
Что она умеет
Память
Это интересовало меня больше всего. Сгенерировать убедительный листинг каталога легко. Я хотел другого: создать файл, отредактировать его, уйти заниматься чем-то ещё и, вернувшись, найти его неизменным.
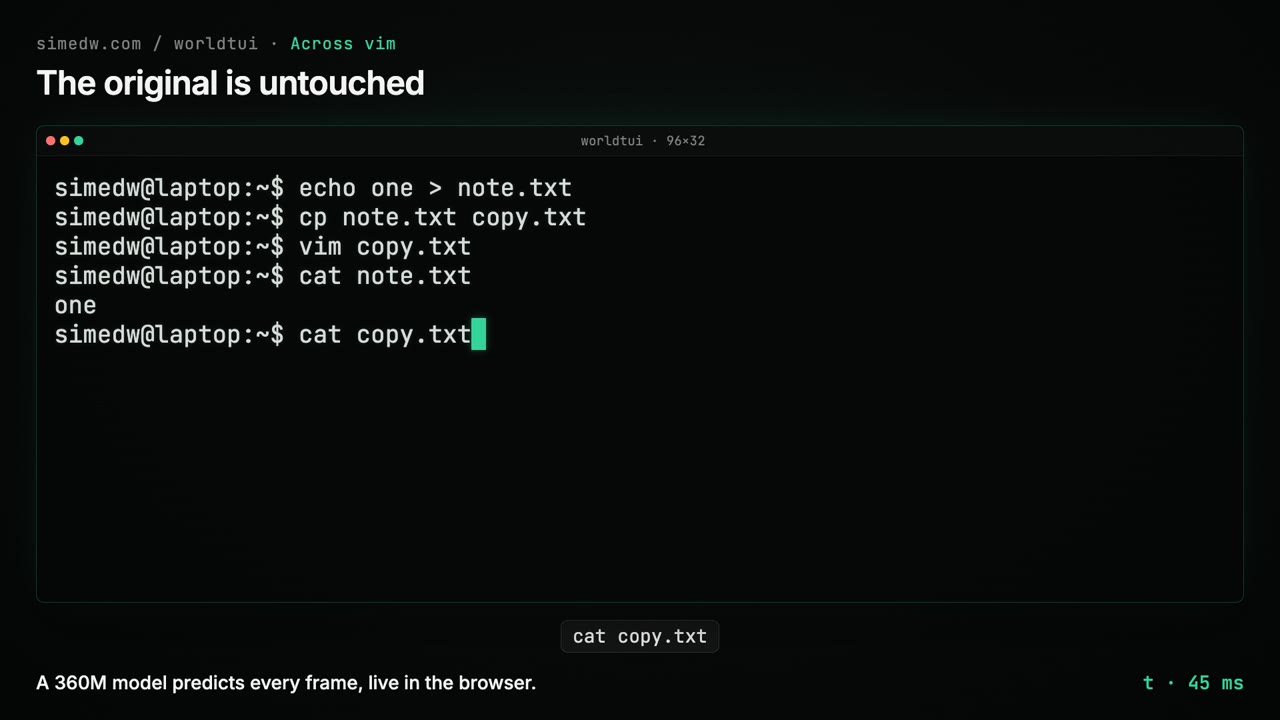
Когда я впервые запустил tmux, открыл файл в vim, изменил его, сохранил, а затем в другом окне tmux прочитал обновлённое содержимое через cat, я почувствовал себя доктором Франкенштейном: оно живое!
Другие приложения
Мне было очень важно, чтобы всё работало не только в приглашении bash, поэтому я обучал модель на vim, python, man-страницах, змейке и даже tmux.
В vim она обрабатывает переключение режимов по esc и даёт сохранить файл, выйти или вернуться в режим вставки.
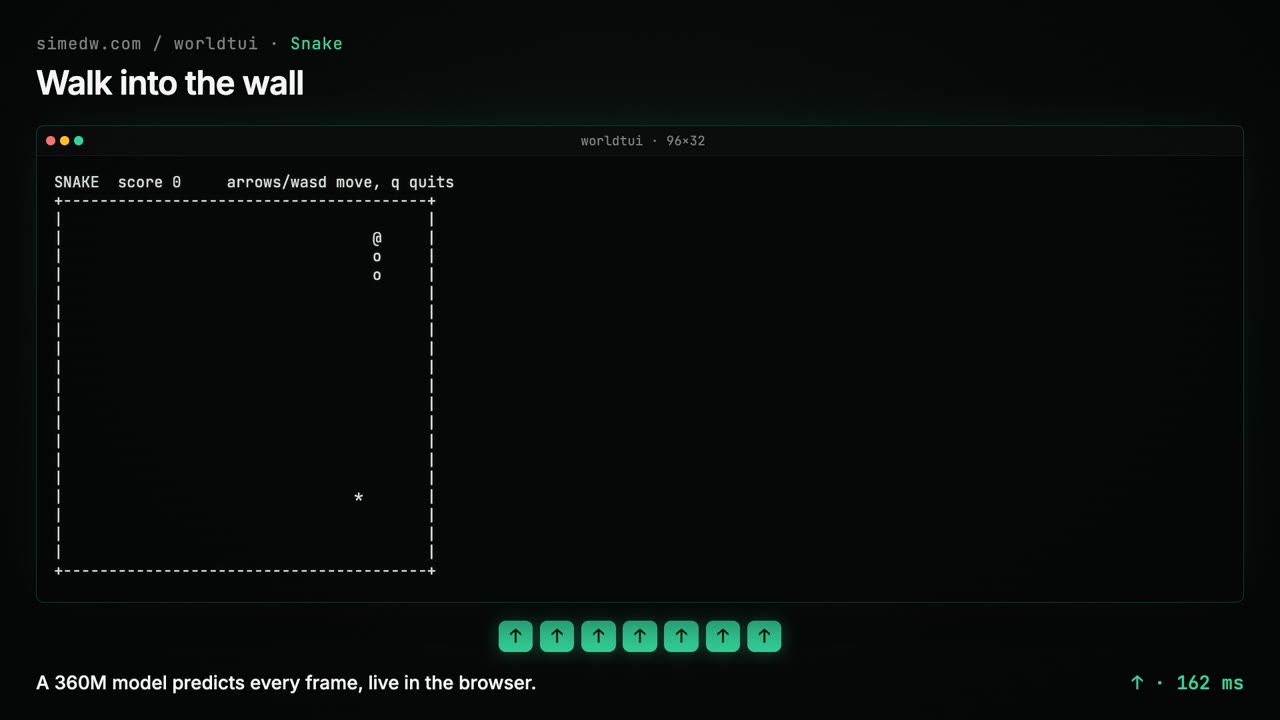
Что меня по-настоящему поразило, так это tmux: можно создать несколько панелей, делать что-то в каждой и прыгать между ними. Не идеально, но это маленькая модель.
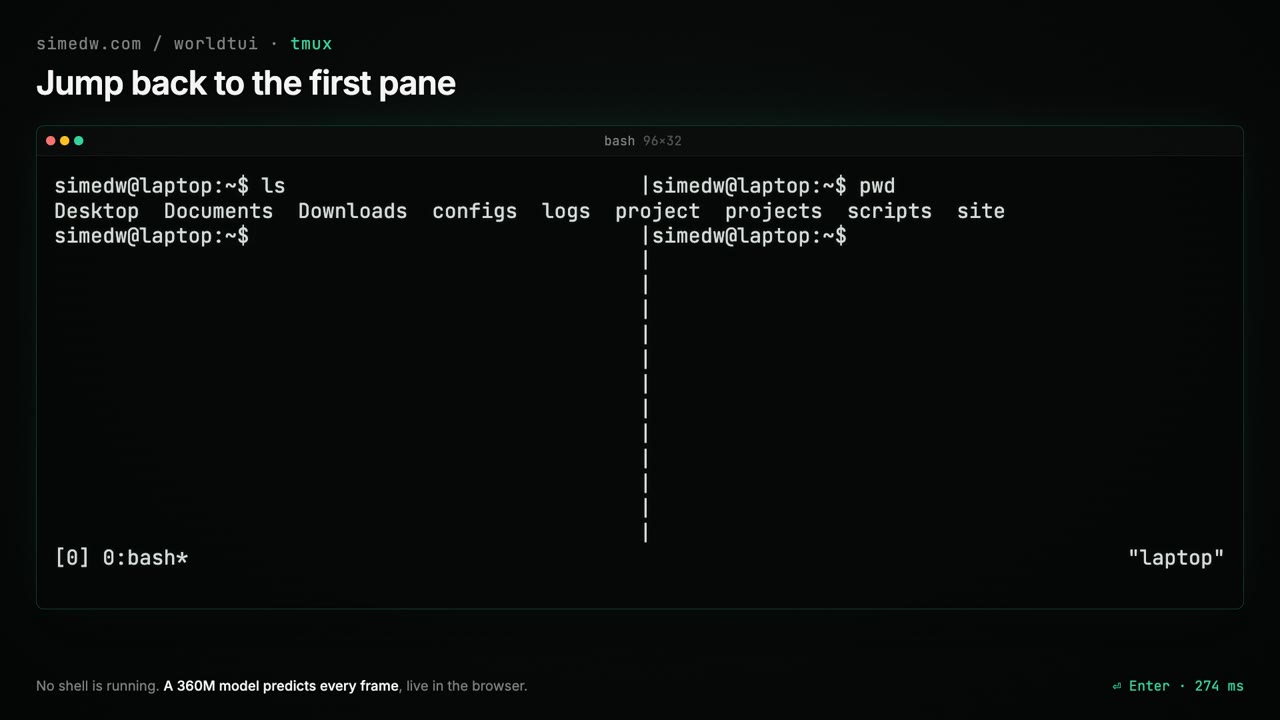
Она даже справляется с переменными окружения и их подстановкой.
Python
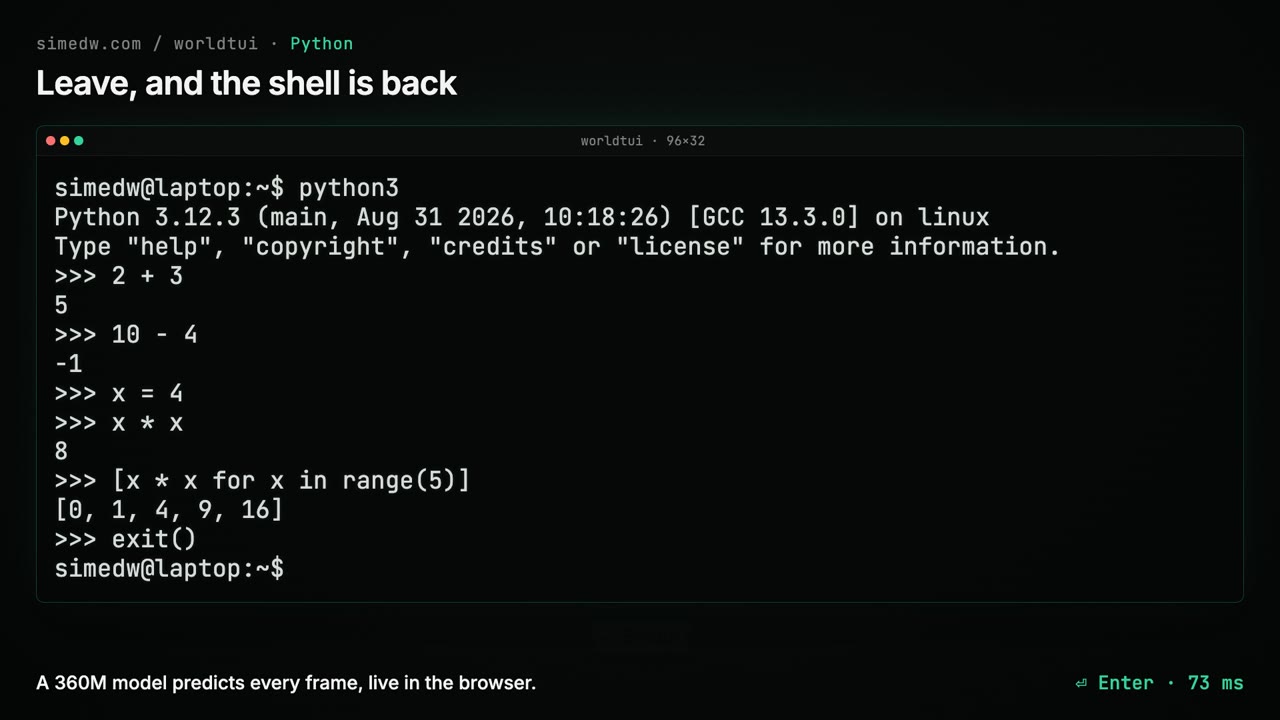
Раз базовая модель обучена на коде, мне было любопытно, как она поведёт себя в REPL Python. Попытка достойная: простые сложения обычно верны, а генераторы списков возвращают список, хотя часто с неправильным содержимым. Ещё она немного прощает опечатки: pythoon запускает Python, а ython — нет.
Что не работает
Docker-контейнерам я не давал доступа в интернет, так что инструменты вроде lynx довольно скучны. Python справляется с очень простыми операциями, но всё посложнее даёт ответы, которые напоминают галлюцинации эпохи GPT-3.
Иногда, когда я создаю вложенные каталоги, модель теряется, и я внезапно оказываюсь в другом пути. Над согласованностью явно есть куда работать.
В моих тестах демо в Firefox работало примерно в 20 раз медленнее, чем в Chrome. В обоих используется WebGPU. Причину я так и не установил.
Похожие работы
Как всегда с такими проектами, я сначала пытался решить задачу сам и только потом посмотрел, как к ней подходили другие.
Ещё в 2022 году люди просили ChatGPT изображать Linux-терминал [7]. Позже GameNGen [8] симулировал Doom с помощью диффузии, а NeuralOS [9] взялся за графический рабочий стол.
WorldTUI ближе к тому первому трюку с ChatGPT, только обучена именно на нажатиях клавиш и обновлениях экрана, включая полноэкранные приложения вроде vim и tmux.
Итог
Делать это было огромным удовольствием. Полезно ли это? Не особенно. Но для модели на 360 млн параметров, которая работает во вкладке браузера, результат намного лучше, чем я ожидал.
Больше всего меня занимает то, что ей удаётся поддерживать более-менее согласованный мир, не реализуя правил, лежащих в его основе.
Это, конечно, довольно слабая модель мира, и мне было бы интересно посмотреть, как далеко можно зайти с этим подходом при лучшей согласованности и другом способе генерации обновлений экрана, например с диффузией вместо авторегрессионного декодирования.
Следующий эксперимент, который я хочу попробовать, — обучение на тысячах случайно сгенерированных приложений, у каждого из которых свои управление и правила. Идея в том, чтобы проверить, научится ли модель предсказывать поведение [10] приложения, которого никогда не видела, если дать ей достаточно контекстных подсказок.
Демо здесь [2]. Это загрузка на 208 МБ, всё работает локально, лучше всего в Chrome. Попробуйте её сломать и расскажите, что нашли.
Веса скоро выложу и добавлю сюда ссылку на скачивание.
Примечания
-
Экран монохромный: только символы, без цветов и стилей текста. Символы Юникода, включая псевдографические рамки tmux, перед кодированием переводятся в ASCII, так что для рамок не нужны многобайтовые токены.
-
Похоже на scheduled sampling из моего поста про MIDI [11].
-
Это тесты с коротким разрывом, 0–1 команда между записью и чтением. ShellBench проверяет и сохранность состояния на протяжении 18 команд.
-
Обе модели с промптом получили по три разобранных примера. Они предсказывают вывод команды целиком, без отдельных обновлений экрана, так что задача у них не совсем та же.
-
На 4090 спекулятивное декодирование даёт гораздо больший прирост, чем на моём M4. Подозреваю, что узкое место смещается между вычислениями и пропускной способностью памяти, но как следует я это не исследовал.
-
Дополненные до 384, чтобы порадовать GPU.
Автор: opium
Источник [12]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37373
URLs in this post:
[1] ошибки: http://www.braintools.ru/article/4192
[2] Попробуйте в браузере (208 МБ): https://simedw.com/projects/worldtui
[3] Genie 3: https://deepmind.google/models/genie/
[4] обучения: http://www.braintools.ru/article/5125
[5] памяти: http://www.braintools.ru/article/4140
[6] внимания: http://www.braintools.ru/article/7595
[7] просили ChatGPT изображать Linux-терминал: https://www.engraved.blog/building-a-virtual-machine-inside/
[8] GameNGen: https://gamengen.github.io/
[9] NeuralOS: https://neural-os.com/
[10] поведение: http://www.braintools.ru/article/9372
[11] поста про MIDI: https://simedw.com/2026/08/20/midi-autocomplete/
[12] Источник: https://habr.com/ru/articles/1098116/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1098116
Нажмите здесь для печати.