Чат на сайте не должен врать: почему наш ассистент иногда честно отвечает «точного ответа нет»
Представьте: посетитель интернет-магазина спрашивает в чате, сколько дней на возврат. Бот бодро отвечает: «30 дней, без вопросов». На сайте при этом написано 14. Через три недели покупатель приходит с товаром и скриншотом переписки. Спорить с ним бесполезно: «ваш же консультант сказал».
Мы делаем для сайтов ассистента. Это чат, который отвечает на вопросы о магазине или компании — доставка, оплата, условия, контакты, статус заказа — и зовёт живого оператора, когда сам не справляется. Когда собирали первую версию, быстро стало понятно: «не знаю» — далеко не худшее, что может сказать такой чат. Худшее — уверенная неправда. Языковая модель прекрасно умеет звучать убедительно. А вот отличать «знаю» от «похоже на правду» у неё получается гораздо хуже.
Ниже расскажу, как мы развели в ответах разговор и факты, где решение принимает код, а не модель, и где мы до сих пор верим модели на слово. Код на Python, но идея переносится на любой стек.
Два вида ответов: поговорить и утвердить
Если посмотреть на реальные реплики в чате сайта, они делятся на две кучи.
Первая — разговор. «Здравствуйте», «вы бот?», «спасибо», «не понял, можно подробнее». Здесь модель хороша: поздороваться, переспросить, поддержать беседу она умеет лучше любых шаблонов. Ошибиться тут почти не в чем.
Вторая — факты. Сколько стоит доставка в Казань, можно ли вернуть товар без чека, во сколько закрывается пункт выдачи, какой у вас телефон. Каждая такая фраза — обещание от имени компании. И именно здесь модель охотнее всего додумывает. Если в справке ничего не сказано про Казань, она вполне может «логично» вывести цену из московской.
Отсюда правило, вокруг которого построено всё остальное: разговаривать можно, утверждать — только со ссылкой на источник. Нет источника — нет факта.
Звучит очевидно. Сложность в том, чтобы правило соблюдалось не потому, что модель вежливо попросили, а потому, что иначе ответ просто не дойдёт до посетителя.
Факт — только с номером источника
Сначала ассистенту нужно, откуда брать факты. Справку мы собираем с самого сайта: главная, sitemap.xml, справочные страницы, условия, контакты. Каждая запись — заголовок, текст и адрес страницы. Для нашего собственного сайта получилось 82 справочные страницы и около 170 записей.
На вопрос посетителя поиск по справке находит несколько кандидатов. В промпт попадают только те, что прошли порог похожести, и идут они пронумерованными:
Источники:
[0] Доставка: По Москве — на следующий день, 300 ₽...
[1] Возврат: Вернуть товар можно в течение 14 дней...
Ответ модель возвращает не текстом, а JSON по схеме:
LLM_SCHEMA = {
    "type": "object",
    "properties": {
        "intent": {"type": "string",
                   "enum": ["question", "read", "product", "order", "operator", "smalltalk"]},
        "answer": {"type": "string"},
        "source": {"type": "integer"},
        "product_query": {"type": "string"},
        "fixed": {"type": "string"},
    },
    "required": ["intent", "answer", "source", "product_query", "fixed"],
}
Главное поле здесь — source, номер записи, из которой взят ответ. А в системном промпте правило записано так (дословно):
Разговаривать можно свободно: поздороваться, сказать, кто вы, переспросить, если непонятно, чего хотят, поддержать беседу — тогда source = -1. <…> Факты о сайте, компании, контактах, ценах, тарифах, сроках, условиях — ТОЛЬКО из источников ниже, source — номер источника; если такой вопрос, а ответа в источниках нет — answer пустой, source = -1, не выдумывайте.
Почему номер, а не ссылка или цитата? Номер нельзя красиво придумать. Ссылку модель может сочинить правдоподобную — какую-нибудь /delivery/kazan, которой не существует. Цитату — слегка «улучшить». А номер либо указывает на одну из записей, которые мы сами положили в промпт, либо нет. Это проверяет код. И ссылку под ответом подставляет тоже код — из записи, а не из текста модели.
Скажу честно: номер источника не гарантирует, что модель пересказала запись точно. Он гарантирует другое. У каждого фактического ответа есть адрес, по которому посетитель может проверить сказанное, а мы — разобрать ошибку [1]. Это совсем другой уровень ответственности, чем «бот так сказал».
Последнее слово за кодом!
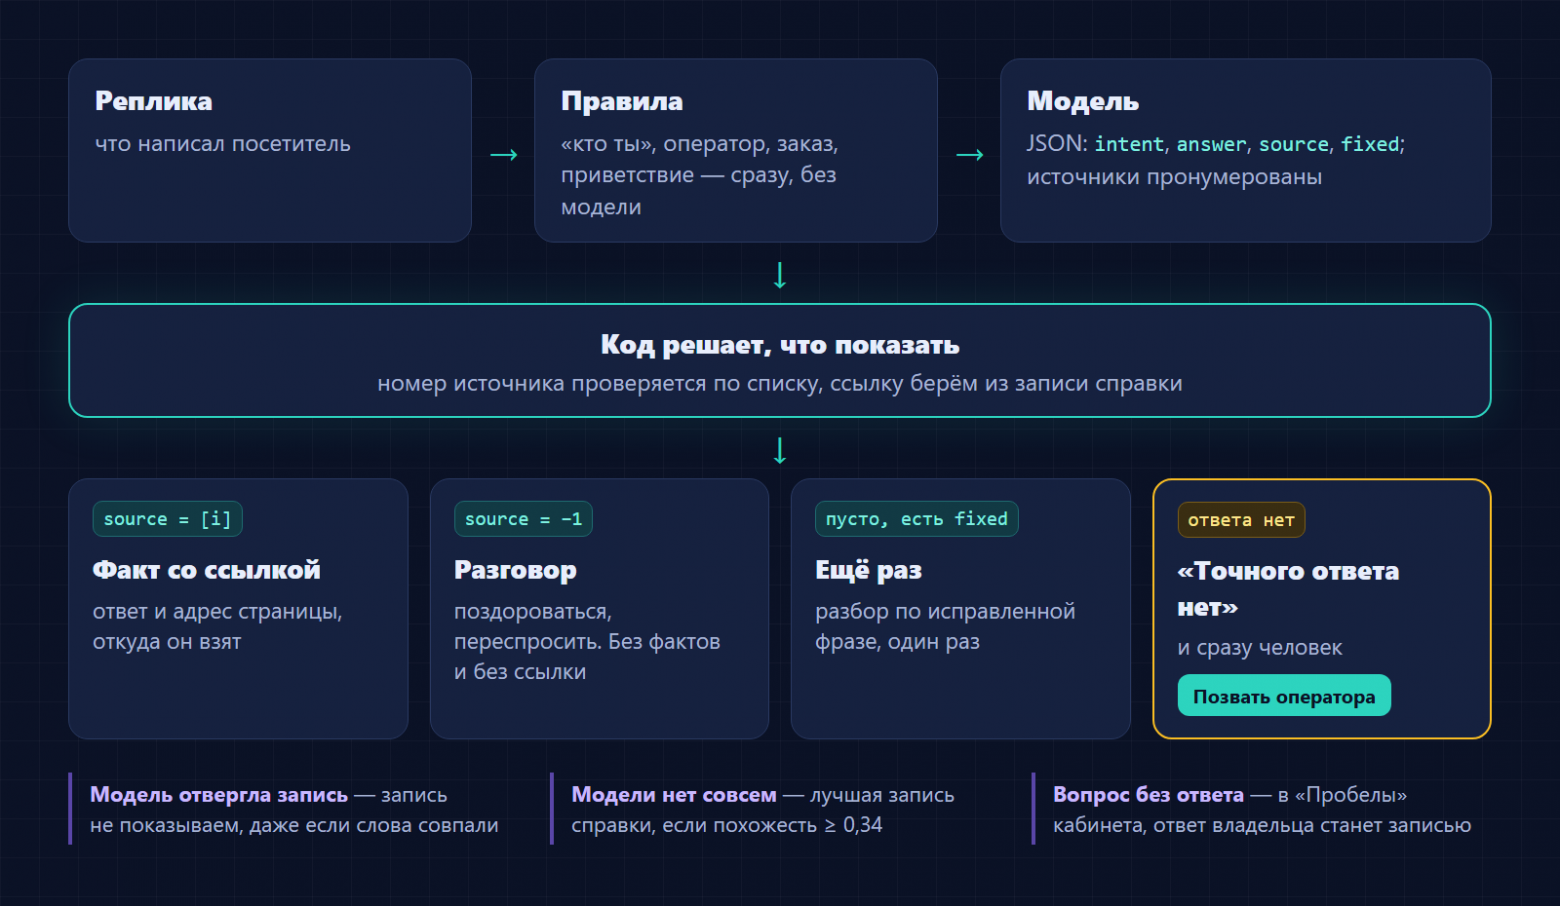
После ответа модели код проходит короткую цепочку. Упрощённо она выглядит так:
# 1. Ответ по источнику: номер есть, и он из нашего списка
if ai and ai["answer"] and 0 <= ai["source"] < len(sources):
    src = sources[ai["source"]]
    return reply(ai["answer"], links=[src["url"]])

# 2. Ответ без источника — это разговор: поздороваться, переспросить.
#    Ссылки нет, потому что фактов в нём быть не должно.
if ai and ai["answer"] and intent != "product":
    return reply(ai["answer"])

# 3. Модели нет вовсе (не настроена или недоступна) —
#    показываем лучшую запись справки, если она достаточно похожа на вопрос
if not ai and top and top["score"] >= MATCH:
    return reply(short(top.answer), links=[top.url])

# 4. Ничего не нашлось — не выдумываем
msg = "К сожалению, точного ответа у меня нет."
if handoff_enabled:
    msg += " Пригласить оператора? Он во всём разберётся."
return reply(msg, buttons=["Позвать оператора"])
Здесь важны две вещи.
Первая — четвёртый шаг. «Не знаю» у нас не тупик, а развилка: рядом сразу кнопка «Позвать оператора». Разговор уходит человеку вместе со всей перепиской, и посетителю не нужно пересказывать вопрос заново. Без кнопки честное «не знаю» раздражает. С кнопкой оно выглядит как нормальный сервис: этого не знаю, сейчас позову того, кто знает.
Вторая — третий шаг и то, чего в нём нет.
Не подсовывать то, что модель отвергла
Поиск по справке находит записи по словам и по смыслу. Иногда совпадение чисто словесное. Наш собственный пример: на «ты кто?» поиск находил запись «Кто ещё видит проект» — про доступы в кабинете. Слово «кто» совпало, смысла ноль.
Модель такую запись видит, понимает, что она не о том, и источник не указывает. Но дальше срабатывал запасной путь: «ответа нет, зато вот самая похожая запись справки». И посетитель на вопрос «ты кто?» получал текст про права доступа.
Теперь запасной путь работает, только когда модели не было вовсе. Если модель видела запись и не взяла её, запись не показывается: её отказ — тоже ответ. Со статьями так же. Без модели мы показываем «На эту тему есть материалы» по совпадению слов. С моделью — только если она сама на них сослалась.
Опечатка — не повод говорить «не знаю»
У честного «не знаю» есть обратная сторона: его легко сказать зря.
Посетитель пишет «как поткючить оплату». Поиск по справке на «поткючить» ничего толкового не находит: ни основы слов, ни вектора такую опечатку не вытягивают. Модель получает пустые или случайные источники и честно возвращает пустой answer. Формально всё правильно. По факту посетитель не получил ответ, который в справке есть.
Для этого в схеме поле fixed — реплика посетителя с исправленными опечатками. Если ответа не нашлось, а исправленная фраза отличается от исходной, мы один раз повторяем [2] весь разбор уже по ней:
fixed = (ai.get("fixed") or "").strip()
if retry and not ai.get("answer") and fixed and fixed.lower() != text.lower():
    return answer(chat, fixed, history, retry=False)
retry=False нужен, чтобы не уйти в цикл, если модель на втором круге «исправит» что-то ещё. Повтор стоит одного лишнего вызова модели и случается только тогда, когда иначе пришлось бы сказать «не знаю».
Правила раньше нейросети
Есть два ответа, которые чат может дать по ошибке, и оба дорогие.
Ложное «зову оператора»: человек спросил про товар, а чат дёрнул живого сотрудника. Оператор отвлёкся, посетитель ждёт, все недовольны. Ложное «подскажите номер заказа»: человек хотел подобрать товар, а у него просят номер заказа, которого нет.
Эти случаи мы решаем не моделью, а правилами — регулярными выражениями, которые срабатывают до любого вызова LLM. Это быстро, бесплатно и, главное, предсказуемо: одна и та же фраза всегда идёт по одному пути.
Порядок такой: «кто ты» → оператор → заказ → приветствие → «спасибо» → «почитать» → вопрос о покупке (доставка, оплата, возврат, гарантия) → товар. Всё, что не подошло, считается вопросом.
Самое неочевидное здесь — оператор. Первая мысль: есть в реплике «менеджер» или «оператор» — зовём человека. Но в каталогах полно «костюмов для менеджера», «кабелей для соединения» и «трековых светильников». Поэтому человека зовут, только если рядом есть глагол:
_PERSON = r"(человек|оператор|менеджер|сотрудник|консультант|специалист)(а|ом|ов|и|ами)?b"
RX_OPERATOR = re.compile(
    r"(поговорить|связаться|соединw*|свяжw*)s+(меняs+)?сs+(живымs+)?" + _PERSON + "|"
    r"b(нужw*|дайте|хочу|позовw*|позвать|пригласиw*)s+(живогоs+|реальногоs+)?" + _PERSON + "|"
    r"техподдержк|bжалоб",
    re.I,
)
Это сокращённая версия, в рабочей вариантов больше. «Соедините с менеджером» — оператор. «Костюм для менеджера» — товар. «Ты живой человек?» — вопрос о самом чате, а не просьба позвать человека. Поэтому правило «кто ты» стоит раньше оператора и отвечает от имени ассистента вообще без модели.
С приветствием похожая история. «Добрый вечер, есть ли доставка?» — это не приветствие, а вопрос о доставке. Правило отрезает «добрый вечер» и решает по остатку.
Модель при этом не выключена. Если правила сочли реплику обычным вопросом, а модель уверена, что человек просит оператора или спрашивает про свой заказ, мы её слушаем. Правила защищают от ложных срабатываний, а пропущенные случаи подбирает модель.
Как мы поняли, что правила работают
Глазами такое не проверить: поправил регулярку под одну фразу — сломал три других. Поэтому у правил есть эталон, и прогоняется он после каждой правки.
В эталоне две части. Первая — 84 фразы, какие пишут в чат сайта: просьбы позвать оператора, вопросы о заказе, товары-ловушки вроде того же «костюма для менеджера», вопросы о доставке и оплате, приветствия. Здесь нужен стопроцентный результат.
Вторая — русские фразы из открытого датасета MASSIVE от Amazon (лицензия CC BY 4.0). Это реплики людей голосовому помощнику: про будильники, погоду, музыку и что угодно ещё. К сайтам они отношения не имеют, и именно этим полезны. Ни одна из них не должна уйти оператору или в «где мой заказ». Это проверка на чужом тексте, который мы не подгоняли под свои правила.
До переписывания правил было 58 из 84 на своих фразах и 95 ложных срабатываний на MASSIVE. После — 84 из 84 и ни одного ложного на 386 фразах.
«Не знаю» — это тоже данные
Каждое «точного ответа нет» означает вопрос, на который на сайте нет ответа. Посетитель уже сообщил, чего ему не хватает, и выбрасывать это обидно.
Поэтому такие вопросы собираются у владельца сайта в кабинете, в разделе «Пробелы». Похожие склеиваются по основам слов, чтобы десять вариантов одного вопроса не превращались в десять строк. Туда же попадают разговоры, которые ушли оператору. А ответы операторов, которых нет в справке, предлагаются как новые записи: человек один раз ответил — ассистент в следующий раз ответит сам.
Ответ, который владелец пишет на пробел, становится записью справки — поправкой. Чтобы поправка не проигрывала старой записи на ту же тему (возможно, именно той, из-за которой и вышла путаница), при поиске она получает небольшой перевес:
FIX_BONUS = 0.06   # перевес поправки над записью на ту же тему
MATCH = 0.34       # ниже — «не нашёл»
Второй инструмент — условия. Это короткие правила владельца, которые дописываются в системный промпт. Работают они, понятно, только когда модель подключена.
Модель при этом не переобучается. Мы ничего не дообучаем и не храним никаких «весов клиента»: меняется только справка и несколько строк в промпте. Любую правку видно, её можно откатить, и действует она со следующей же реплики.
Где мы всё ещё верим модели на слово
Было бы нечестно закончить на том, что всё схвачено. Слабых мест три.
Ответ без источника. Мы разрешили модели разговаривать свободно, и это правильно, иначе чат превращается в автоответчик. Но то, что в таком ответе нет фактов, держится только на просьбе в промпте. Если модель решит по-дружески добавить «у нас обычно доставляют за два дня» и поставит source = -1, код это пропустит. Ссылки под таким ответом не будет, но сам текст до посетителя дойдёт. Напрашивается простая страховка — не пропускать ответ без источника, если в нём есть цифры, суммы или сроки. У неё есть очевидный минус: под подозрение попадут и безобидные фразы. Пока такой страховки у нас нет, и это честно открытый вопрос.
Неточный пересказ. Модель может взять правильную запись и пересказать её неточно. «14 дней» превратить в «две недели» — ещё нормально. В «месяц» — уже нет. Ссылка под ответом позволяет это проверить, но не предотвращает.
Ошибки самого сайта. Если в справке на сайте написано неправильно, ассистент честно повторит неправильное. Он не может быть честнее сайта, с которого читает. Зато вопросы, на которых он спотыкается, часто и показывают, где справку пора переписать.
Вместо заключения
Для чата на сайте «не знаю» — не провал. Провал — уверенный неправильный ответ, за который потом отвечает живой менеджер.
Рецепт у нас простой и, по-моему, подходит для любого чата, который отвечает по документам. Разделить разговор и факты. Требовать от модели номер источника. Оставить последнее слово коду. И сделать так, чтобы за «не знаю» всегда стояла кнопка «позвать человека».
Ассистент работает вживую на aisse.ru [3] — можно спросить у него то, чего на сайте нет, и посмотреть, что он ответит.
А как вы боретесь с выдумками в своих чат-ботах? Проверяете ответ вторым вызовом, режете по цифрам, что-то третье? Пишите в комментариях, почитаю с удовольствием.
Автор: Haimi
Источник [4]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37380
URLs in this post:
[1] ошибку: http://www.braintools.ru/article/4192
[2] повторяем: http://www.braintools.ru/article/4012
[3] aisse.ru: https://aisse.ru
[4] Источник: https://habr.com/ru/articles/1098152/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1098152
Нажмите здесь для печати.