Few-shot: пристрелочная для ИИ-агента
Я регулярно использую GLM как рабочую модель — «молотилку», которой можно отдавать большой объём реализации. Смысл понятен: не каждая задача требует самой дорогой frontier-модели. Если архитектура определена, требования собраны, а результат можно проверить, основную работу должна выполнять более дешёвая модель.
Для этого мы уже используем GRACE [1]. Методология хранит не просто документацию, а модель проекта: требования и ограничения, граф модулей и потоков данных, активные изменения, утверждения и верификацию. В коде остаются семантические контракты с назначением модуля, областью ответственности, входами, выходами, зависимостями и связями с требованиями.
Это действительно помогает агентам ориентироваться в проекте. Но периодически возникает другая проблема: модель понимает, что требуется сделать, и всё равно полдня ходит кругами вокруг реализации. Повторяет один тип ошибки [2], переписывает рабочие части, меняет формат ответа, чинит компиляцию и снова ломает контракт.
Дешёвая модель, которая несколько часов не может дойти до проходящего результата, уже не такая дешёвая. Она расходует токены, контекст, машинное время и, главное — человеческое внимание [3].
Когда я читал канал Владимира Иванова AI Projects [4], у меня появилась гипотеза: GRACE хорошо передаёт модели семантику, но, возможно, в данной конкретной реализации не хватает еще одного постоянного слоя — проверенных примеров реализации. Не добавлять их вручную в каждый промпт, а встроить few-shot в саму методологию.
Мы провели небольшой контролируемый эксперимент. Результат не доказывает, что идея универсальна, но показывает: тема рабочая и заслуживает развития.
Что уже даёт GRACE — и чего может не хватать
В GRACE 4 долговременная модель проекта находится в .grace:
-
contextхранит требования, технологии, принципы и ограничения; -
graphописывает модули, их связи и потоки данных; -
changesхранит спецификацию и план конкретного изменения; -
verificationсвязывает утверждения с командами, сценариями и доказательствами проверки.
На уровне кода семантические якоря и контракты помогают агенту быстро ответить на вопросы: зачем существует этот модуль, чем он владеет, от чего зависит и какие требования реализует.
Но знание смысла ещё не гарантирует правильную форму реализации.
Контракт может сказать: «собери React-артефакт из валидированной спецификации, не добавляй новых фактов, сохрани evidence ID и пройди компиляцию». Модель поймёт задачу. Но даже правильно поняв задачу, модель может ошибиться в исполнении: отступить от структуры, пропустить обязательные элементы или оформить результат так, что его нельзя использовать.
Здесь и возникает место для few-shot.
💡 Хозяйке на заметку Zero-shot — модель получает только инструкцию. One-shot — инструкцию и один готовый пример. Few-shot — несколько примеров того, как должен выглядеть правильный результат. Модель при этом не переобучается: примеры работают только внутри текущего контекста и помогают ей быстрее уловить нужный паттерн.
Во всю ширинуСкопировать как изображениеОткрыть на весь экран
|
Слой |
Что он сообщает агенту |
|---|---|
|
Семантика GRACE |
Что меняем, зачем, где границы и какие инварианты нельзя потерять |
|
Few-shot |
Как в этом проекте выглядит правильная реализация похожего решения |
|
Верификация |
Получился ли допустимый результат на самом деле |
Контракт задаёт смысл, пример показывает способ реализации, а пригодность результата подтверждают тесты.
Откуда взялась гипотеза
В посте о небольших моделях [5] Владимир Иванов описывает SLM прежде всего как чувствительные детекторы паттернов: длинное объяснение для них может быть менее полезно, чем несколько правильно выбранных демонстраций.
Существует распространённый миф: младшая модель того же вендора якобы лучше работает со старшей только потому, что они принадлежат к одному семейству и производителю. Убедительных подтверждений этому нет. Зато хорошо виден другой эффект: worker-модель быстро подстраивается, когда получает готовый контекст и рабочие примеры — то есть фактически few-shot.
Если мы сознательно отдаём исполнение более простой и прямолинейной модели, одного технического задания ей может быть недостаточно. Вместе с задачей стоит сразу передать рамку: структуру решения, ограничения и несколько правильных образцов. Тогда worker не пытается заново изобрести способ реализации, а работает по лекалам, подготовленным более сильной моделью.
Для GRACE отсюда следует интересный вопрос. Если методология уже умеет находить нужный модуль, требования, изменение и проверку, почему бы планирующей модели не подбирать ещё и несколько подходящих примеров?
Не весь репозиторий. Не случайные файлы из поиска. Один-два проверенных образца, которые показывают нужный паттерн и связаны с теми же семантическими узлами.
Простая проверка
В полевом тесте локальных моделей Avenex [6] модель должна была превратить валидированную семантическую спецификацию в самостоятельный React-компонент.
Обе группы получали одинаковую спецификацию и одинаковый контракт:
-
вернуть только исполняемый React-код в заданном формате;
-
использовать 4–6 полноэкранных разделов;
-
не подключать внешние библиотеки и ресурсы;
-
не придумывать факты, числа, людей, даты и рекомендации;
-
сохранить идентификаторы доказательств;
-
уложиться в ограничение по размеру программы.
После генерации обычный код проверял результат: разобрался ли формат ответа, компилируется ли JSX, рендерится ли компонент, верно ли число разделов, присутствуют ли evidence ID, не появились ли новые числа и внешние ресурсы.
Разница между условиями была одна. В zero-shot модель видела контракт и спецификацию. В экспериментальном условии она дополнительно получала небольшой рабочий React-компонент с прямой инструкцией: копировать дисциплину реализации, а не его факты.
То есть мы не сравнивали «плохой промпт» с «хорошим». Семантика, ограничения и проверки уже были зрелыми. Мы изолировали вклад одного реализационного примера поверх них.
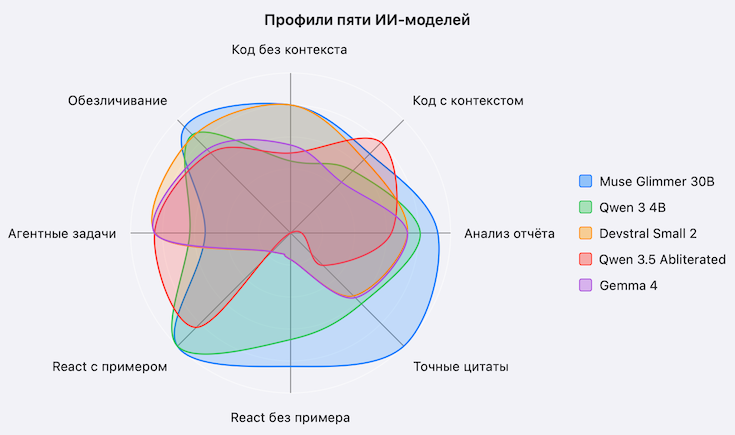
Это не академическое доказательство и не рейтинг моделей. Но для инженерной гипотезы сигнал сильный: при неизменной семантической спецификации, контракте и проверках один небольшой пример заметно изменил поведение [7] двух слабых моделей и улучшил сильную.
Как встроить few-shot в протокол агента
Минимальная конструкция состоит из трёх элементов.
1. Реестр примеров
Каждый проверенный пример получает стабильный идентификатор и краткое описание:
-
какой паттерн он демонстрирует;
-
для каких задач и компонентов подходит;
-
когда его использовать нельзя;
-
какие файлы служат образцом;
-
какими тестами или проверками подтверждена его корректность.
2. Подбор примеров под задачу
Перед началом работы протокол определяет границы изменения, затронутые компоненты, ограничения и критерии приёмки. По этим признакам он подбирает один-два наиболее близких примера и передаёт их агенту вместе с задачей.
Ключевой принцип — минимальность. Большая свалка кода создаёт шум. Нужны только те примеры, которые снимают конкретную неопределённость реализации.
3. Проверка результата, а не сходства
Агент не обязан буквально копировать образец. Он должен использовать показанный способ реализации и при этом выполнить требования текущей задачи. Источником истины остаются спецификация, критерии приёмки и автоматические проверки.
ℹ️ Практический пример В GRACE этот подход уже оформлен в PR #63 «few-shot examples from spec to verification» [8]. Общие правила дополняются контрастными примерами ожидаемого поведения [9], а каждый принятый пример связывается с задачей, тестом, командой и доказательством проверки. Так пример становится частью инженерного контракта, а не одноразовой вставкой в промпт.
Ещё одна проверка на коде
После React-эксперимента мы сделали ещё одну проверку: к локальным моделям добавили GLM-5.3 и Claude Haiku 4.5. Задача и примеры были простыми, поэтому заметной разницы я вообще не ждал. Но она появилась.
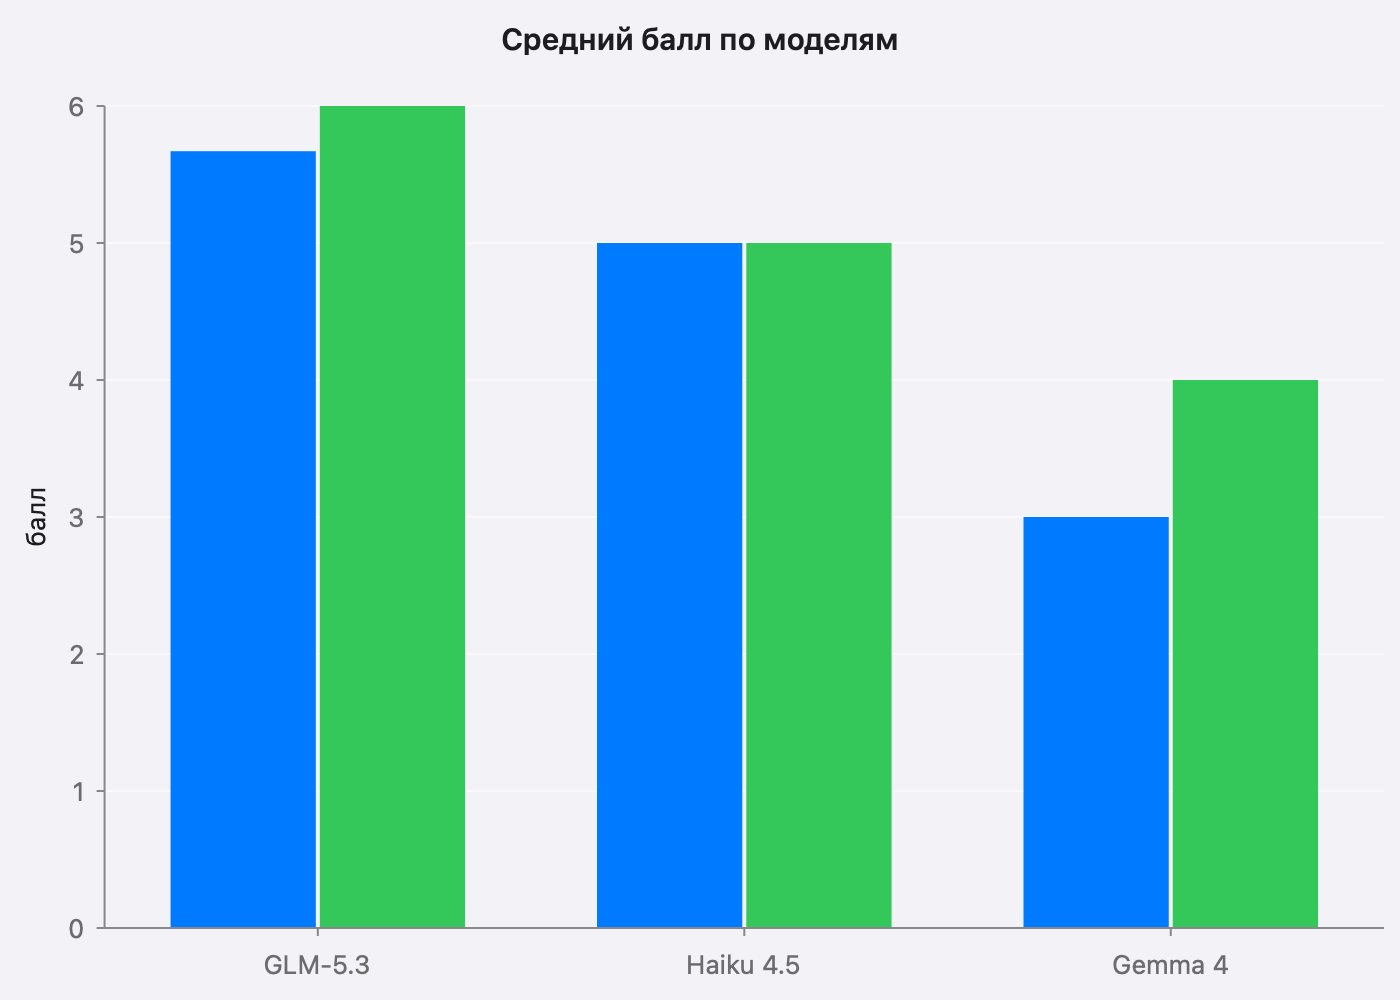
Небольшая и не у всех моделей, зато в отдельных тестах модели стали проверять то, что раньше пропускали. Это не академический эксперимент: одна задача, мало прогонов. Но сигнал есть. Не знаю, как вы, а я few-shot в своих проектах теперь точно буду активно тестировать.
Почитать:
Автор: Xronofag
Источник [16]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37555
URLs in this post:
[1] GRACE: https://github.com/osovv/grace-marketplace/
[2] ошибки: http://www.braintools.ru/article/4192
[3] внимание: http://www.braintools.ru/article/7595
[4] AI Projects: https://t.me/turboproject
[5] посте о небольших моделях: https://t.me/turboproject/2135
[6] полевом тесте локальных моделей Avenex: https://avenex.xronocode.com/ru/guides/local-model-choice/
[7] поведение: http://www.braintools.ru/article/9372
[8] PR #63 «few-shot examples from spec to verification»: https://github.com/osovv/grace-marketplace/pull/63
[9] поведения: http://www.braintools.ru/article/5593
[10] AI Projects: рабочий код как few-shot для worker-модели: https://t.me/turboproject/4712
[11] AI Projects: контекст frontier-модели для worker-модели: https://t.me/turboproject/5308
[12] AI Projects: разработка Turbo Planner: https://t.me/turboproject/1271
[13] Штатный ИИ: Математические модели для бизнеса: https://t.me/ai_headcount/14
[14] Brown et al., Language Models are Few-Shot Learners: https://proceedings.neurips.cc/paper_files/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
[15] Min et al., Rethinking the Role of Demonstrations: https://aclanthology.org/2022.emnlp-main.759/
[16] Источник: https://habr.com/ru/articles/1099792/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1099792
Нажмите здесь для печати.