Робот с LLM, который меня подстрелил. Часть 3
Робот с LLM, который меня подстрелил. Часть 3
Содержание
-
3. Моторы [4]
-
4. Датчики [5]
-
5. Датчики. Магнитометр, гироскоп и комплементарный фильтр [6]
-
8. Камера [9]
-
9. Агентный цикл [10]
-
12. Запись сессии [13]
-
13. Голос [14]
-
14. Приборная панель [15]
-
17. Монтаж [18]
-
Заключение [19]
0. Пара слов в своё оправдание
Это третья статья, уже из цикла про робота с пистолетом, и её мне было труднее всего написать.
-
Основная статья про эксперименты с LLM в реальном мире тут: Я выпустил нейросеть в реальный мир — и стало не смешно [20]
-
Вторая, про устройство тела: Как сделать робота из того, что нашлось в кладовке. Часть 2 [21]
Я подходил к статье три месяца – садился писать и бросал несколько раз.
…
Во второй статье я описал железо робота и обещал описать (в этой статье) то, что крутится на хосте. Но мне придется в этой статье вернуться снова к телу робота, одним хостом отделаться не вышло.
Итак, напомню, что у меня имеется вот такая “тушка” вооруженная пистолетом:
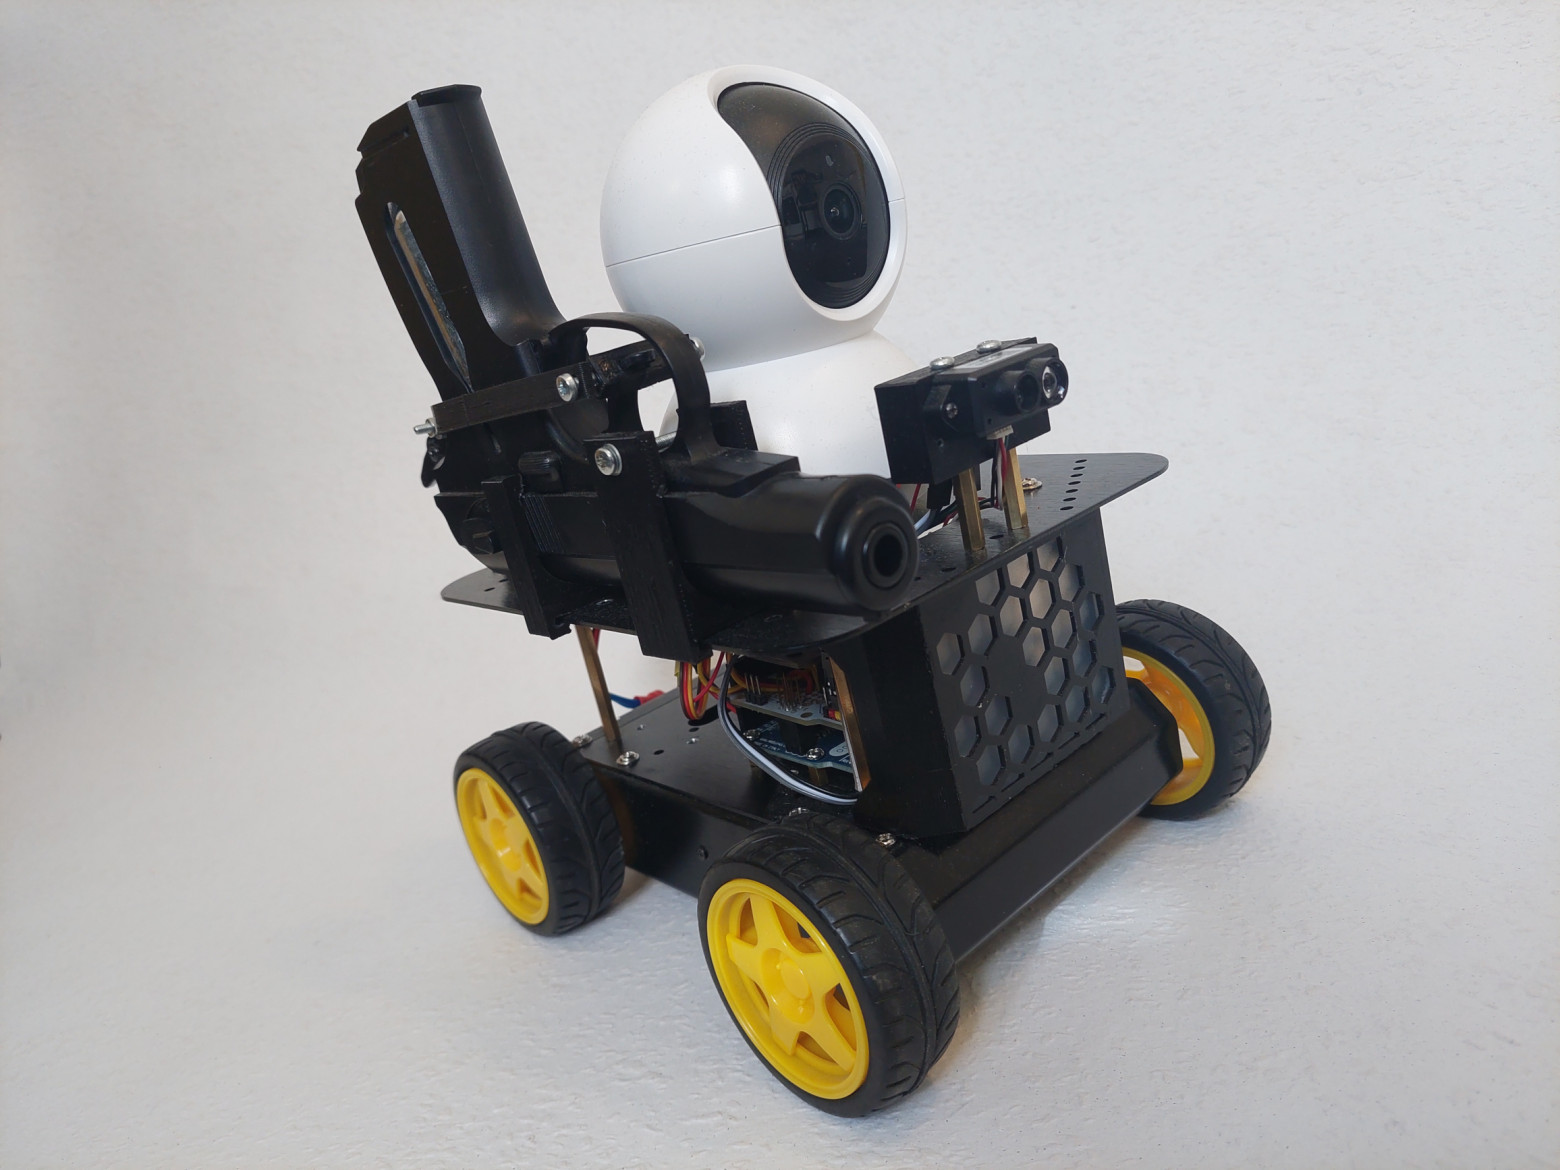
которая умеет выполнять простые команды вида “проехать вперед 1.4 метра” и “повернуть вправо на 45 градусов”, стоит WiFi-камера. Т.о. для того чтоб ИИ начал действовать в реальном мире осталось всего ничего:
-
увидеть и осознать изображение с камеры
-
отдать команду для выполнения действия
Для тех кто пропустил начало, напомню как это всё выглядит:
Это обзорная статья, которая затрагивает все основные области, с которыми мне пришлось столкнуться при создании робота. Слишком углубляться в каждую область у меня не получится. Если детально расписывать каждую область, то получится не статья, а книга, а может и учебный курс или даже пару лет курсов технического ВУЗа.
В целом могу сказать, если вы хотите свой pet-проект с ИИ и у вас есть свободное время – делайте робота. Это реально весело. Потребуются знания и навыки из самых разных областей. От математики [22] и физики до психологии. И при желании тут найдется место и для RAG, и для машинного зрения [23] и для синтеза и для распознавания речи, работе с контекстом и памятью [24] LLM. В общем прокачаться можно хорошо.
1. Принципиальная осуществимость. Langfuse
Почему я вообще решил, что чат можно подключить к роботу и оно заработает?
Когда говоришь с ИИ в чате он выглядит достаточно умным, может рассуждать и об абстрактных вещах, но может поговорить и о вещах конкретных, таких, что требуют житейского опыта [25].
Но сможет ли он, такой умный, реально взаимодействовать с этим суровым миром? Что вообще должен уметь робот, чтоб взаимодействовать с миром? А нужно всего две вещи:
-
воспринимать мир
-
влиять на мир
Итак. Может ли модель понять, что на фото? Может ли она превратить увиденное в команду поворота? Первый вопрос – про восприятие [26] мира. Второй – про влияние на мир. Если оба закрыты, остаётся замкнуть цикл “восприятие-действие”.
Я сделал фото
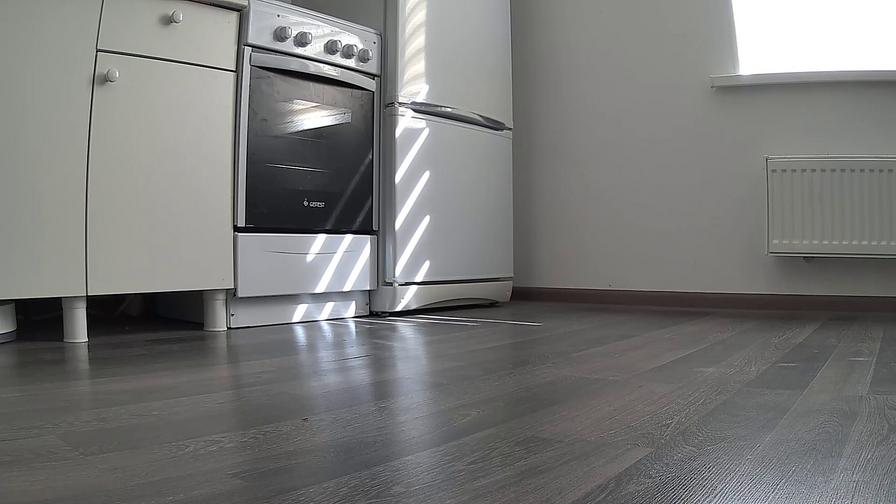
на телефон и отдал Чату ГПТ с вопросом, что на фото? А есть ли тут радиатор батареи? Он ответил правильно. Кажется вопрос с восприятием закрыт? Ну как бы нет. Нужно как-то солидно решить эту проблему. Поскольку у меня проект учебный, то надо осваивать передовые технологии.
Langfuse – это открытая инженерная платформа (LLM Engineering / LLMOps) для мониторинга, отладки, оценки и управления приложениями на базе больших языковых моделей (LLM). Основные возможности: трассировка, управление промптами, оценка качества, ведение сессий.
Если своими словами, то Langfuse позволяет смотреть какие промпты как работают с разными моделями, какие лучше какие хуже. Позволяет удобно прогонять промпты на разных наборах данных и автоматически считать качество прогона.
Подробности про Langfuse можно найти в статьях ниже:
LLMops дома: быстрое разворачивание и настройка инфраструктуры с помощью Langfuse [27]
Как я научил AI анализировать AI: observability для LLM-агентов с Langfuse [28]
Контроль и порядок. Разворачиваем платформу учёта затравок для БЯМ [29]
Я решил, что мне совершенно необходимо установить из докер-образа Langfuse и проверить разные модели, видят ли они радиатор отопления и могут ли поворачивать в стороны.
Из пушки по воробьям. Я установил Langfuse, приготовил ему данных (item), примерно так:
(Скриншоты – реконструкция. В момент создания робота я не скриншотил, они свежие.)
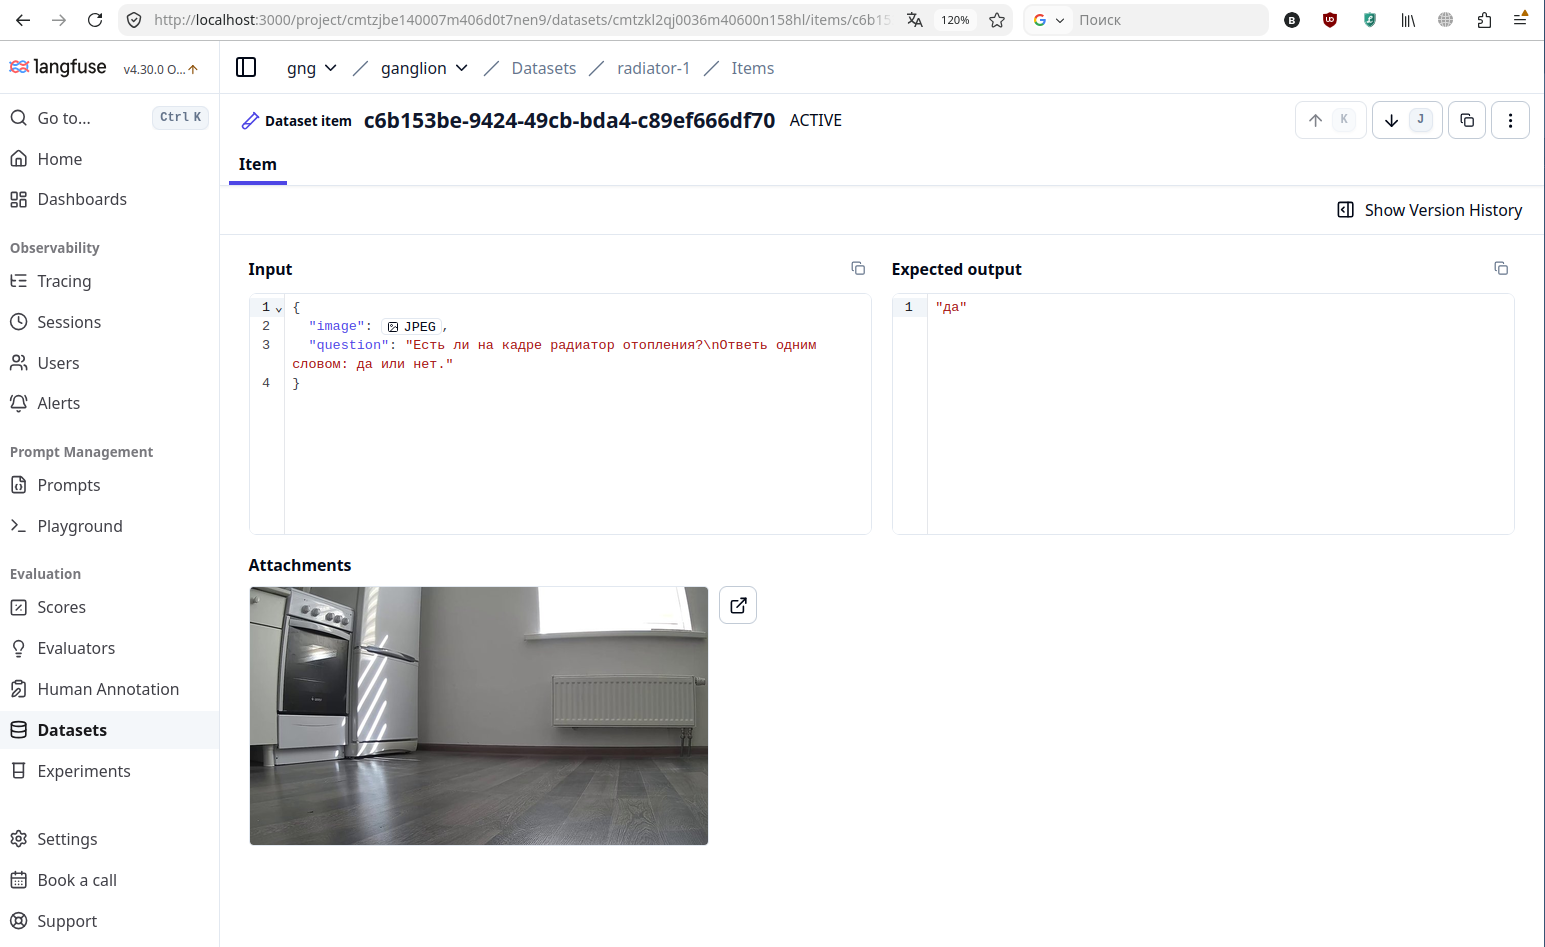
На скрине: запрос (текст и фото) и ожидаемый ответ.
Такие items объединяются в наборы данных (dataset)
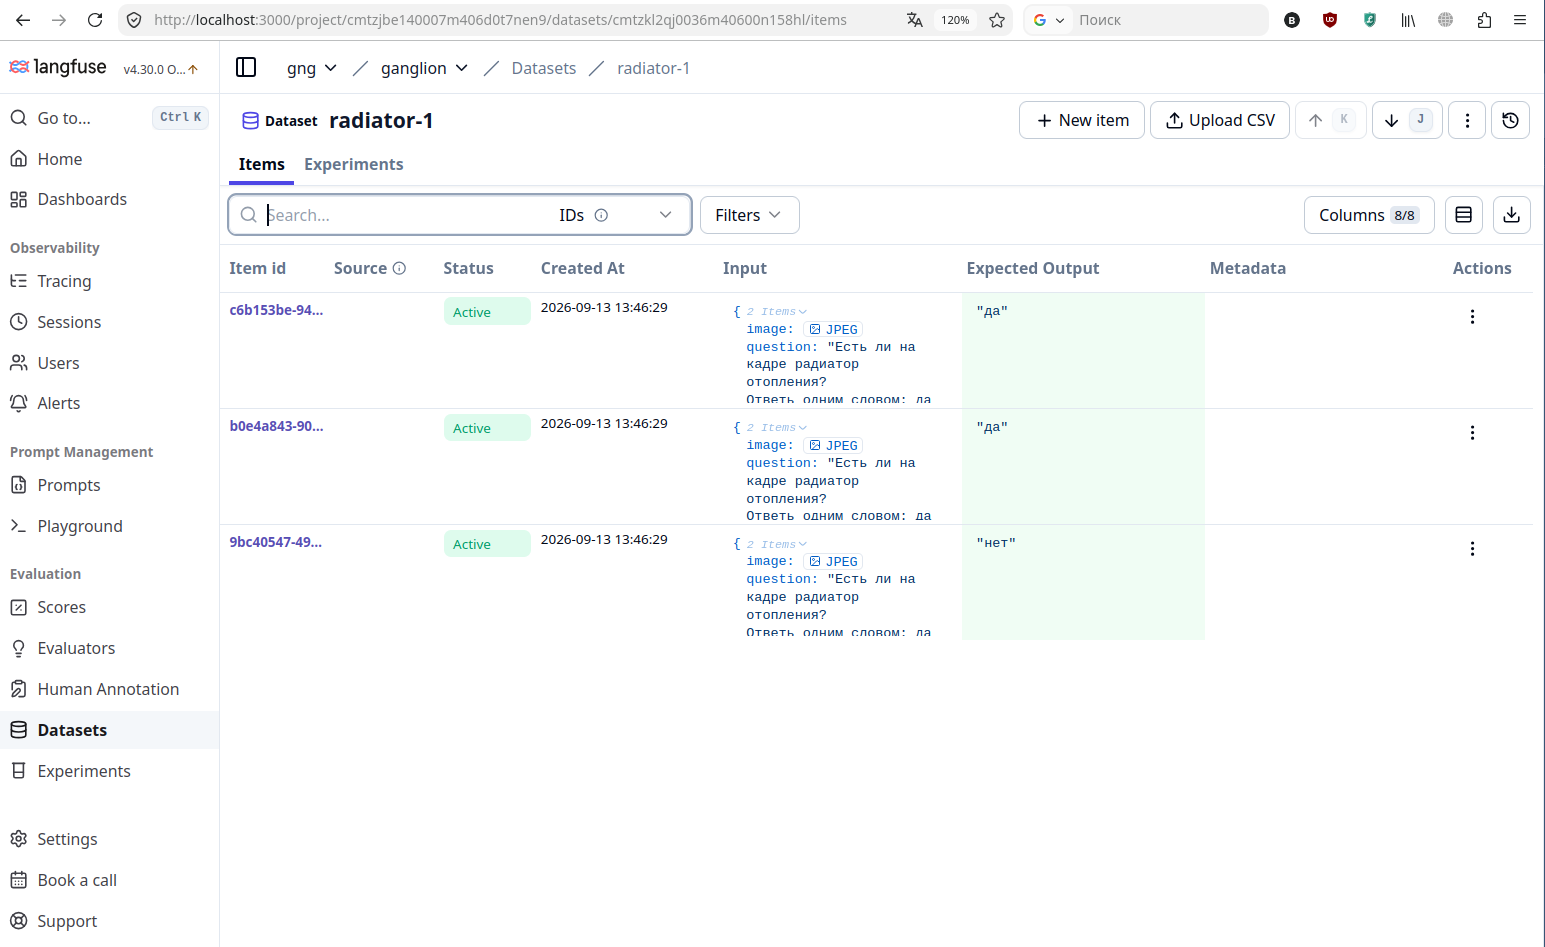
И это всё может быть массово прогнано на различных моделях, с учётом расхода токенов, денег и прочего. Это называется эксперимент (experiment):
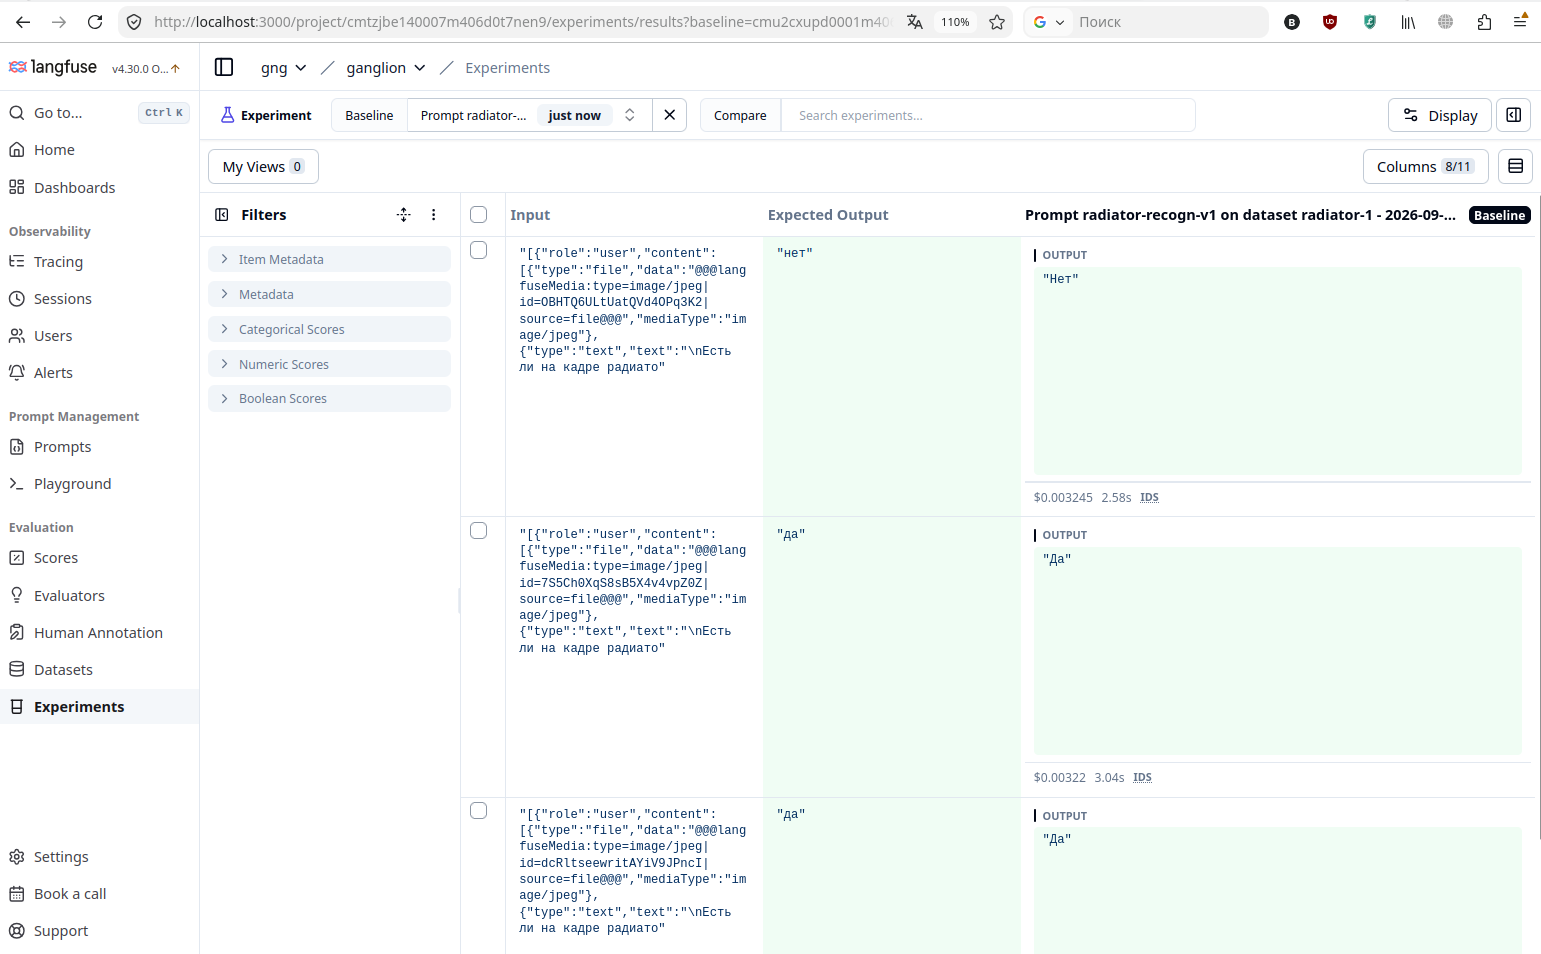
Но сразу скажу, Langfuse это скорее не веб-система, а библиотека на Python, у которой есть интерфейс, чтоб красиво смотреть. То есть вы пишете код, загружаете данные и всё это можно делать через питоноский API, а некоторые вещи можно делать через интерфейс и в интерфейсе смотреть результаты экспериментов.
Были проверены несколько типов вопросов:
|
Тип |
Пример |
|---|---|
|
объект есть |
радиатор батареи |
|
объекта нет, но он уместен в квартире |
холодильник в жилой зоне |
|
объекта нет, но в кадре есть похожий |
стиральная машина при наличии холодильника |
|
объекта нет и быть не может |
корова |
Все данные проверок у меня, к сожалению, не сохранились и повторно протестировать тоже не выходит, т.к. многие модели из тех, что я пробовал стали недоступны. Но в целом модели справлялись, Опус, точно помню, справлялся прекрасно, что и дало возможность двигаться дальше.
Также была сделана проверка, понимает ли модель, сетку нанесённую на изображение. Может ли она ответить на вопрос, на сколько градусов повернуться чтобы определенный объект оказался в центре кадра.
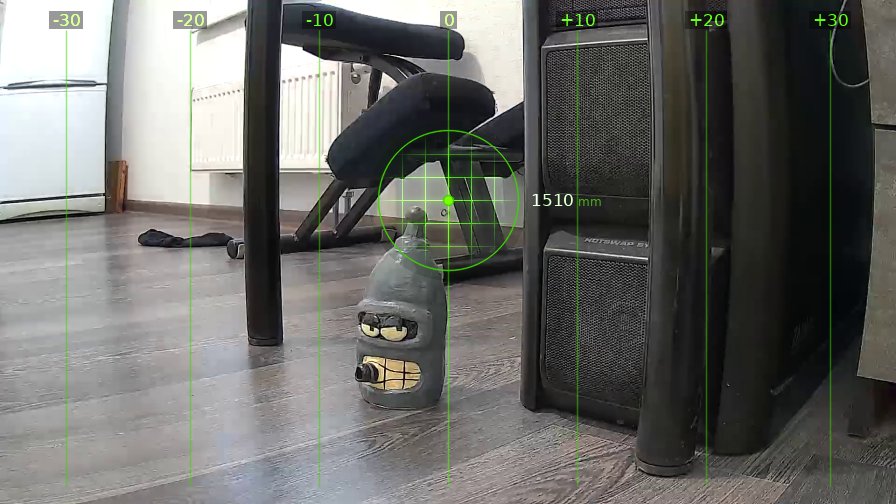
На сколько надо повернуть, чтоб Бендер оказался в центе?
Тут тоже был получен положительный ответ, что означало, что можно делать робота. Принципиальные вопросы разрешены.
Касательно того как выполнить поворот механически. В целом понятно, что если модель текстом отвечает “вправо 20 градусов”, то это можно просто распарсить и выполнить. Но модели умеют:
-
структурированный ответ в JSON. В этом случаем модели передается схема ответа и модель дает ответ в JSON в соответствии со схемой. Дальше мы сами вынимаем угол и выполняем вращение.
-
Вызов инструмента (tool), тулинг (tooling). Похожая схема, но чуть дальше. Модели сообщается, что у нее есть инструменты, которые она может вызвать. Например, прочитать файл.
Пример структурированного ответа (на 90% настоящий пример). Допустим, надо вытащить сумму из квитанции:
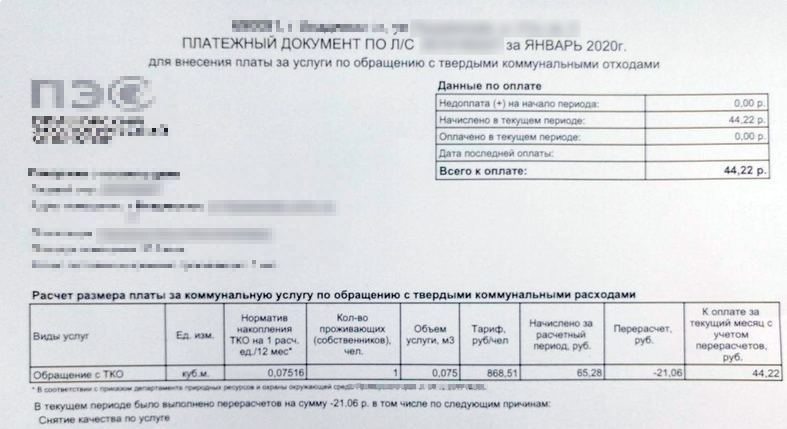
Запрос к Gemini: картинка, задание словами и схема ответа.
{
  "contents": [{
    "role": "user",
    "parts": [
      { "inlineData": { "mimeType": "image/png", "data": "<base64 картинки>" } },
      { "text": "Это платёжный документ за коммунальные услуги? Если да - извлеки итоговую сумму к оплате ("Всего к оплате") и помести её в поле amount. Если это не платёжный документ или суммы на нём нет - установи error="NOT_A_BILL", а amount оставь null." }
    ]
  }],
  "generationConfig": {
    "response_mime_type": "application/json",
    "response_schema": {
      "type": "object",
      "properties": {
        "amount": { "type": "number", "nullable": true },
        "error":  { "type": "string", "nullable": true }
      }
    }
  }
}
Ответ на квитанцию:
{ "amount": 44.22, "error": null }
Ответ на фото кота:
{ "amount": null, "error": "NOT_A_BILL" }
Схема задаёт форму ответа: модель не может ответить простым текстом, на выходе всегда JSON, который сразу парсится. А что класть в поля, объясняется в тексте запроса. Поле error нужно, чтобы у модели был способ сказать, что она не может выполнить задачу, иначе она выдумает число. И “Всего к оплате” тоже не просто так: сумм на квитанции несколько, без подсказки модель может взять не ту.
Пример инструмента. Модели передаётся описание инструмента, по сути тоже JSON-схема, только для аргументов:
{
  "name": "turn_relative",
  "description": "Повернуть на N градусов от текущего направления. Положительные градусы = вправо, отрицательные = влево.",
  "input_schema": {
    "type": "object",
    "properties": {
      "degrees": { "type": "number", "description": "Угол поворота в градусах, -180 … +180." }
    },
    "required": ["degrees"]
  }
}
На вопрос “повернись так, чтобы Бендер оказался в центре” модель отвечает не текстом, а вызовом:
{ "type": "tool_use", "id": "toolu_01A...", "name": "turn_relative", "input": { "degrees": 5 } }
Разница в том, кто решает. При структурированном ответе мы сами спросили и ждём ответ строго в нашей форме. С инструментами модель сама выбирает, вызвать ли что-то, что именно и с какими аргументами. Выполняем вызов мы, результат возвращаем модели, и она решает, что делать дальше.
Несколько позже я провел еще пару опытов, уже без Langfuse и только на Опусе. Мне было интересно разберётся ли ИИ в такой вот позорной карте:
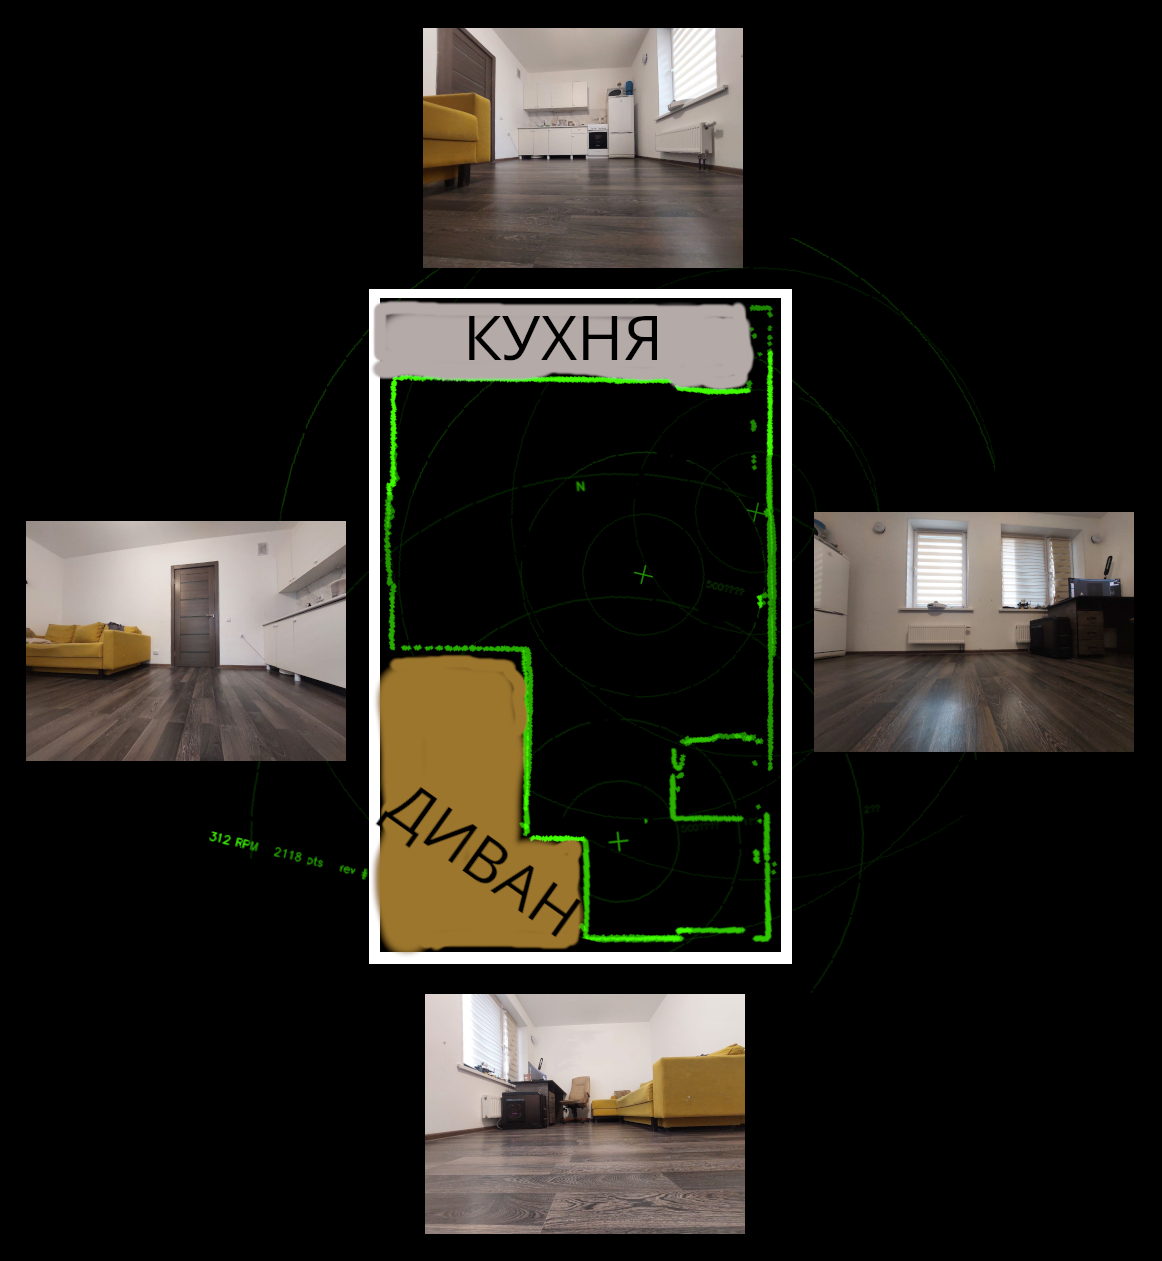
Если ИИ подсунуть карту и снимок из комнаты, с вопросом в какую сторону повернуть, чтоб увидеть что-то, ИИ, глядя на карту правильно отвечал. То есть, он чётко понимал, что это есть карта, догадывался что она снята лидаром, и что картинки по бокам и сверху и снизу не просто так. В общем соображал как соспоставить карту, снимок и мою просьбу выполнить поворот.
На картинке: зелёные точки – карта снятая лидаром пылесоса, а также дорисованные мной диван с кухней.
Отличная статья про лидар от робота-пылесоса: Использование лидара от робота-пылесоса для системы предотвращения столкновений в автономных роботах [30]
Подведу итоги этой части.
С этой точки я понимал, что принципиально проект осуществим, впереди просто инженерная работа. Главное агентный (или агентский, кто знает как правильно?) цикл. Но как много будет инженерной работы я еще не знал…
2. Взаимодействие хост-ардуино
На данный момент есть понимание, что мы можем, как минимум в теории, сделать тележку, которая будет поворачиваться, ездить и возить на себе камеру. А камера будет передавать на хост фото/видео.
Камера подключается к компу по WiFi, а тележка будет соединена по COM порту. Часть, которая вставляется в компьютер выглядит так:
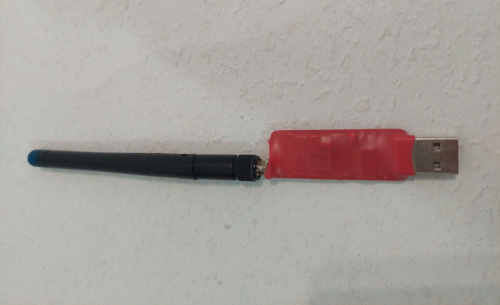
Для компьютера это обычный ком-порт, в который можно писать, и из которого можно читать. Максимальная скорость 57600 бод. Для Arduino – это Serial и стандартное чтение-запись в него.
Команды и телеметрия пролезут, а вот фото, и уж тем более видео, никак нет.
К Ардуино физически подключены компас и гироскоп, плата управления моторами.
Первоначальная сборка:
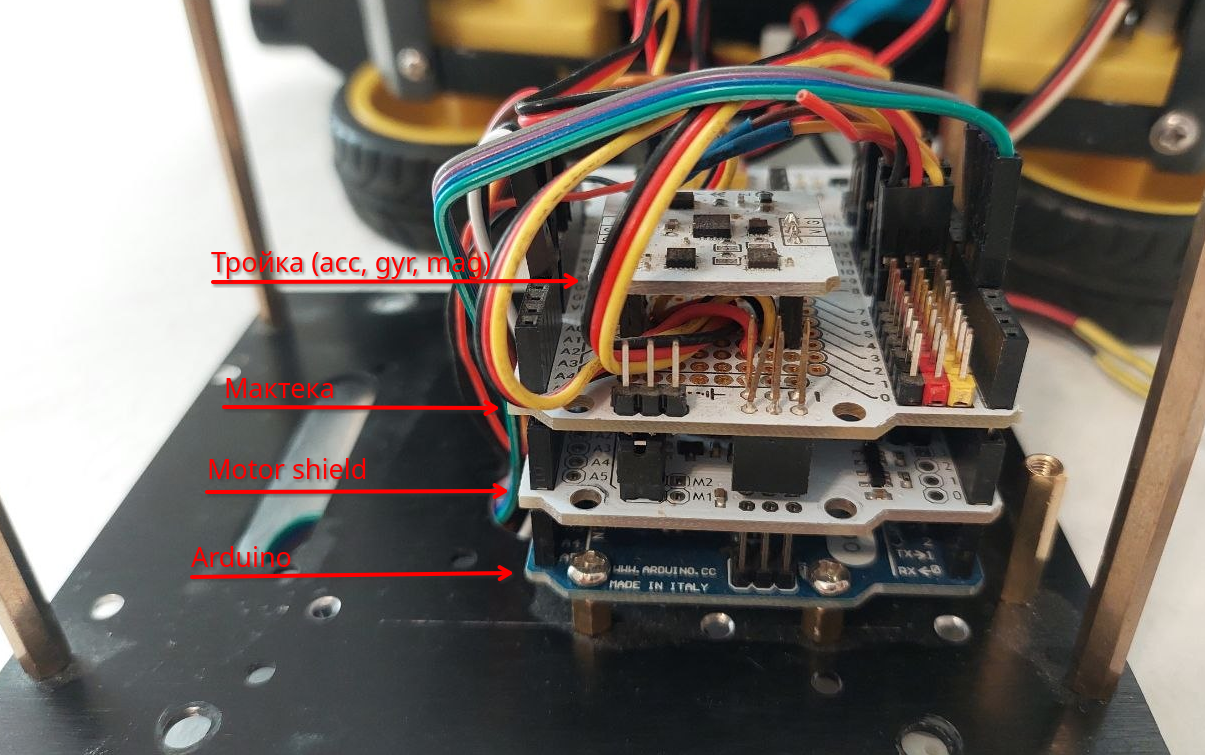
Внизу ардуино, далее модуль управления моторами, макетка и набор датчиков: акселерометры, гироскопы, магнитометры. Находящийся в средине модуль моторов попьёт мне много крови…
Работать с ними будем позже, но протокол пишется сразу с оглядкой на них.
Требования:
-
по проводу пойдут три вида сообщений: телеметрия, команды, ответы на команды;
-
протокол должен расширяться, новые поля добавляются минимальной переделкой парсера. Переделка должна быть простая и при этом протокол должен оставаться компактным, чтобы уложиться в 57600 бод;
-
разбор должен быть простым.
Пример.
Текстовый протокол с маркером начала (—) и конца пакета (***). Один кадр:
---
SQ:1240
LS:50
RS:50
V:11.8
***
-
SQ – Сквозной номер пакета (sequence)
-
LS – Left Speed, текущая установленная скорость левого мотора
-
RS – Right Speed, текущая установленная скорость правого мотора
-
V – Напряжение батареи
Прикидка пропускной способности.
Типичный пакет телеметрии (8 полей + маркеры):
---rn          = 5 байт
SQ:1240rn      = 9 байт
LS:50rn        = 7 байт
RS:-30rn       = 8 байт
LC:512rn       = 8 байт
RC:480rn       = 8 байт
GX:-123.45rn   = 12 байт
GY:456.78rn    = 11 байт
V:11.80rn      = 9 байт
***rn          = 5 байт
                 --------
                 ~82 байта
При интервале 100ms (~10 раз в секунду) это ~820 Б/с. Канал 57600 бод при 8N1 (10 бит на байт) пропускает 5760 Б/с, получается ~14% канала. Более чем хорошо.
Запас потом пригодился: со временем в пакет добавились дальномер (RF), гироскоп (GZ) и состояние светодиодов (LR, LB). Пакет вырос до ~114 байт, загрузка – до ~20%. Протокол расширился без переделки, и запас всё ещё большой.
В начале это была просто пустышка, туда-сюда ездили липовые данные. Например, вольтаж батареи еще не замерялся и в протоколе было захардкожено число, просто для отработки обмена. Настоящим сразу был счётчик, его было сделать просто и легко наблюдать, как данные едут с ардуинки. Этот, интуитивно добавленный, счетчик в дальнейшем поможет найти сложный баг.
Для начала достаточно. Парсится легко, лишнего ничего, расширить просто.
Первой реально заработавшей командой было, как положено, моргание встроенным светодиодом ардуинки. Код у меня не сохранился, но в протоколе была команда, что-то вроде L:1 (led on) и L:0 (led off).
Итоги этой части. Реализован обмен данными хост <-> arduino. В этой точке у меня есть канал связи, можно идти дальше, к управлению чем-нибудь.
3. Моторы
Мальчик любого возраста всегда готов порулить машинкой на радиоуправлении. Я не исключение.
Тележка есть, протокол и связь с компом есть. Еще немного и у меня будет машинка на радиоуправлении.
Всё что нужно – расширить протокол на две команды: установка скорости правого и левого мотора.
Команды, которые едут на ардуину:
---
L:150
R:150
***
Диапазон значений от 0 до 255. 128 – нейтраль, 255 – полный вперёд, 0 – назад.
В ответ ардуина шлёт ответ:
---
LS:140       # скорость левого мотора (-128..127, 0 = стоп)
RS:140       # скорость правого мотора
LC:215       # ток левого мотора, сырой АЦП 0-1023
RC:220       # ток правого мотора
***
В первом варианте я сделал некоторую инерционность в раскрутке моторов. От нуля до максимума моторы выводились примерно за четверть секунды. То есть, хост шлёт команду мотору: полный вперёд (255), на ардуино стоит скорость мотора в нуле, нейтраль (128), и ардуина не рывком меняет 128 на 255, а за несколько оборотов главного цикла накидывает скорость 128, 138, 148, 158, … Это позволило тележке двигаться более плавно, с характерным приятным звуком.
Контроллер Motor Shield Plus выполнен на базе двухканального H-моста L6206Q на полевых транзисторах. Имеет встроенные датчики тока моторов. Я думал использовать датчики для контроля движения, на ковре тяжелее – ток больше, на ламинате ехать проще – меньше ток, или для контроля застревания – при застревании ток резко растёт. Но это так и осталось в планах и протоколе. Может как-нибудь потом сделаю.
4. Датчики
Магнитометр. Он же компас
Что такое магнитометр? Это прибор для измерения магнитного поля. Как бы компас. Но не компас. Компас молодец, у него стрелка и она всегда показывает на северный полюс (магнитный). А у магнитометра стрелки нет, у него есть три числа: напряженность магнитного поля по трём координатам x, y, z. И если вы думаете, что имея три координаты напряженности поля из них можно сделать стрелку компаса, то нет. Я вас разочарую.
Почему нет? Потому что железка меряет не поле Земли, а всё поле, которое вокруг неё есть. А вокруг неё есть: она сама, моторы с постоянными магнитами, стальные винты, провода с током. Этот собственный магнетизм ездит вместе с датчиком и поэтому не усредняется – он просто добавляет к каждому измерению постоянный вектор. Плюс у каналов X и Y несколько разная чувствительность, и это тоже надо чем-то лечить.
Увидеть это можно так. Ставим тележку на пол, крутим её на месте на полный оборот и пишем пары (GX, GY). Для простоты я исключил показания по оси Z, взял плоский случай. Всё же тележка будет ездить по ровному полу, а не по горам. Если бы датчик был идеальный, точки легли бы на окружность вокруг нуля, и курс брался бы одним atan2. Вот что вышло на самом деле:
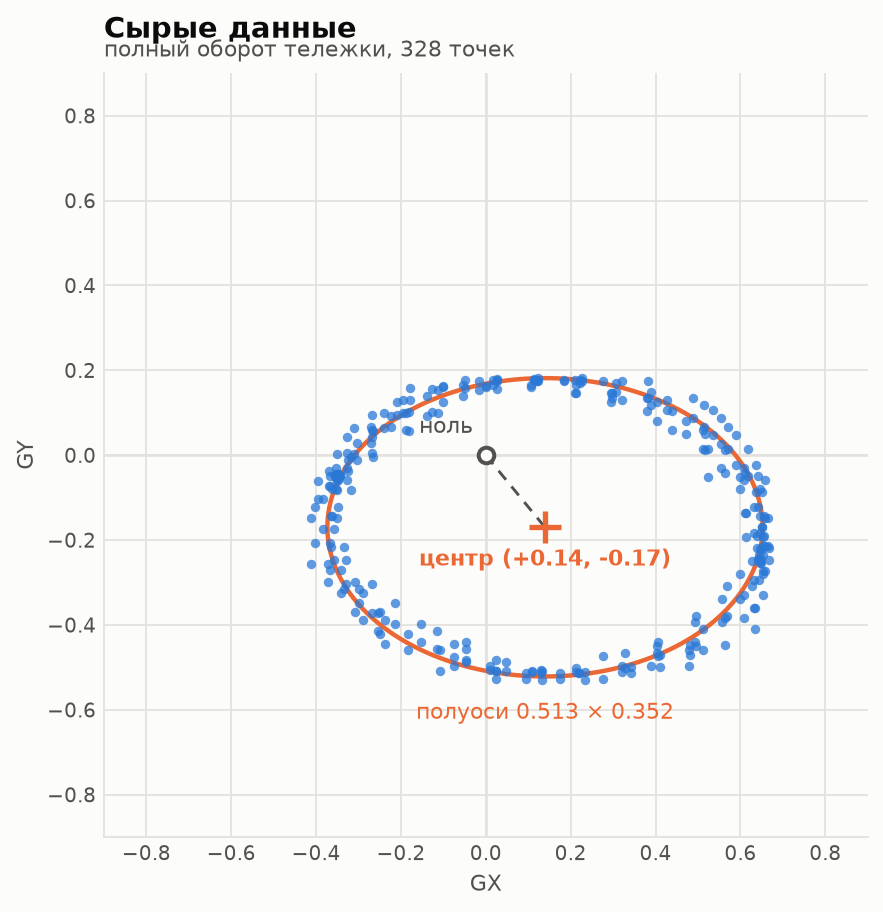
Окружность (эллипс) есть, но она не вокруг нуля. Её центр сместился в точку (+0.14, −0.17) – это и есть собственное поле робота. И полуоси немного разные, 0.513 против 0.352 – собственное поле плюс разная чувствительность каналов. Пока центр не в нуле, atan2 даёт некорректные результаты, причём по-разному в разных направлениях. Если посчитать курс прямо по сырым числам, ошибка [31] на этом логе – 22 градуса в среднем и до 39 в максимуме. Курс, которого нет.
Калибровка – это найти центр и полуоси и вычесть их. Четыре числа: сдвиг по X, сдвиг по Y, масштаб по X, масштаб по Y. Дальше каждое измерение прогоняется через них, и облако садится на единичную окружность вокруг нуля:
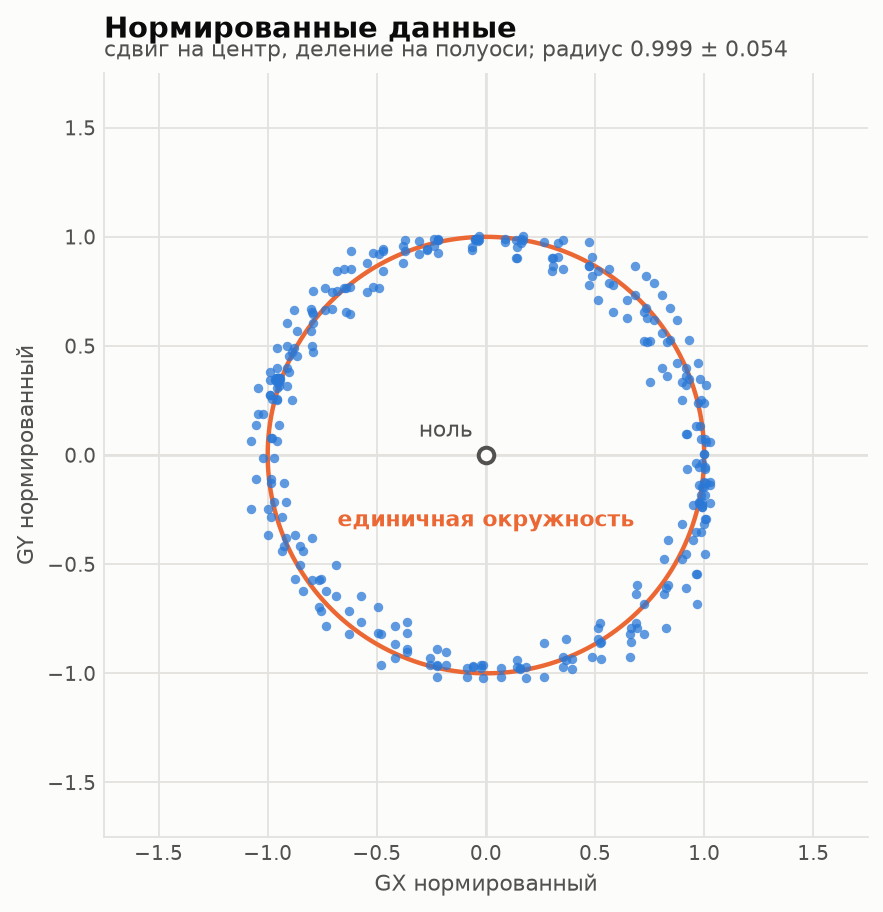
А как найти эти четыре числа? Линейной регрессией. Метод наименьших квадратов. Уравнение эллипса с осями по координатам
((x − dx) / kx)² + ((y − dy) / ky)² = 1
нелинейно по x и y, но если раскрыть скобки и собрать всё относительно x², оно становится линейным по своим коэффициентам:
x² = b1·x + b2·y² + b3·y + b4
То есть: цель – x², признаки – (x, y², y, 1). Обычный метод наименьших квадратов, четыре коэффициента, одна строчка np.linalg.lstsq. Из b1…b4 центр и полуоси достаются арифметикой. Регрессия здесь линейная не в смысле “прямая y = kx + b”, а в смысле “неизвестные входят линейно”.
По-хорошему калибруют не эллипс на плоскости, а эллипсоид в трёх измерениях, и тогда в уравнении появляется ещё и перекрёстный член xy – наклон эллипса. Мне хватило двумерного варианта: тележка ездит по ровному полу и не заваливается.
Несмотря на привлекательность магнитометра, как датчика направления от него пришлось отказаться. Реальность внесла свои коррективы. Видео, демонстрирующее изменение показаний компаса при перемещении:
Наглядный пример, почему компас оказался бесполезен. При перемещении компаса по полу его показания могли измениться на 45 градусов. Видимо железная арматура в полу вносит свои коррективы, делая компас генератором случайных чисел.
Провал.
Надо иначе подходить к вопросу. Были два кандидата: лидар от пылесоса и гироскоп. Лидар выглядел очень соблазнительно: надёжно, можно иметь не только поворот, но и положение на карте, одометрию, всё что даёт SLAM. Но от SLAM сурово запахло ROS и еще неделей, а то и месяцем работы.
SLAM (Simultaneous Localization and Mapping) – алгоритм одновременного построения карты и определения своего места на ней.
ROS (Robot Operating System) – не ОС, а стандартный набор библиотек и инструментов для роботов. Мощно, но громоздко.
Вот картинка из интернета, найденная по словам ROS+SLAM:
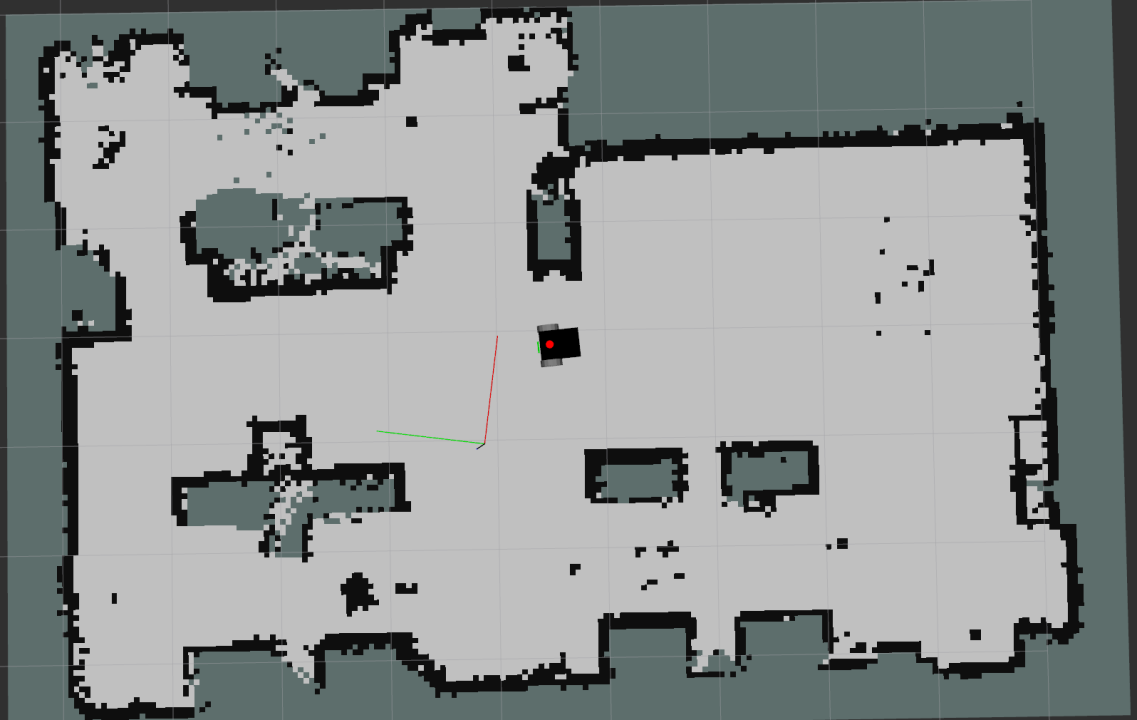
Карта комнаты, построенная лидаром. Чёрное – стены и препятствия, светлое – свободное место, в центре – сам робот.
Гироскоп
Я вспомнил, что первоначальная задача, которую я решаю с роботом – это посмотреть, как робот будет воспринимать реальный мир, ориентироваться в нём, перемещаться. Для этого ему нужно иметь фото с камеры и возможность выполнить команду поворота с некоторой точностью. Даже если поворот выполнен не точно, робот сможет посмотреть на новое фото после выполнения действия и выполнить корректировку. Примерно так, как это делает человек. То есть мне не нужно иметь абсолютное угловое позиционирование (аналогично тому, как у меня в голове нет точного знания о том, где север), достаточно выполнять относительные повороты с некоторой точностью. В целом гироскоп как раз и должен дать такую возможность. Поворот осуществляется относительно быстро и ошибка гироскопа не успевает накопиться в той мере, чтоб сделать контроль невозможным.
Честно говоря, гироскоп появился на борту чуть раньше, чем я окончательно похоронил компас, – сначала как помощник компасу. Об этом союзе будет отдельный раздел про комплементарный фильтр. Здесь – про сам датчик.
Что меряет гироскоп
Гироскоп на тележке – L3G4200D с модуля Troyka IMU, подключён к ардуине по I2C. Как и магнитометр, это не совсем то компас, так и гироскоп не совсем то, что нарисовано в учебнике физики: никакого волчка внутри нет, есть MEMS-кристалл, который измеряет угловую скорость. Не угол, а скорость поворота: сколько градусов в секунду тележка крутится вокруг вертикальной оси. Мне нужна только ось Z, остальные две тележке на ровном полу ни к чему.
В протокол добавилось одно поле:
GZ:<float> # угловая скорость вокруг вертикальной оси
Угол получается интегрированием: каждые 20 мс берём скорость, умножаем на прошедшее время и прибавляем к накопленному углу.
angle += gz * dt
Одна строчка. Вся хитрость в том, что вместе с углом накапливается и любая ошибка в gz.
Дрейф и калибровка нуля
Ставим тележку на пол, ничего не трогаем, смотрим на gz. Ожидаем ноль. Получаем не ноль: гироскоп стабильно показывает, что тележка медленно крутится. Это смещение нуля (bias). Маленькое, доли градуса в секунду, но интеграл его накапливает. Скрипт gyro_drift_test.py показал: стоящая на месте тележка за 10 секунд “проворачивалась” на 15 градусов.
Лечится это так же, как у компаса – вычитанием. Робот стоит, собираем 30 пакетов, берём медиану, это и есть смещение нуля. Вычитаем его из каждого следующего измерения. Медиана, а не среднее – потому что гироскоп иногда выдаёт одиночные выбросы, и один выброс заметно сдвинул бы среднее. После калибровки те же 10 секунд покоя дают 0.6 градуса. В двадцать пять раз лучше, и для поворота, который длится секунду-две, этого хватает с запасом.
Прогрев
Всё работало, пока однажды после включения робот не начал крутиться сам по себе. Вернее, он думал, что крутится: калибровка насчитала смещение около 54°/с. Это не дрейф, это мусор.
Оказалось, L3G4200D после подачи питания некоторое время приходит в себя, и первые его показания – случайные числа. По даташиту ему нужно около 100 мс. Повторные запуски программы на хосте этого не замечали – ардуина не перезагружалась, датчик давно был тёплый. Проблема вылезала только на холодном старте.
Первая попытка: выбросить первые 20 показаний, 200 мс прогрева. Не помогло. Вторая: выбросить 200 показаний, две секунды. Помогло. Даташит даташитом, а живой датчик успокаивается дольше.
Но и это не всё. Смещение нуля плывёт с температурой, а датчик после включения греется. Поэтому калибровка в итоге двухступенчатая: ардуина калибрует гироскоп сразу при включении, на холодную, а хост при старте сессии меряет смещение ещё раз, уже на прогретом датчике, и отправляет поправку отдельной командой:
G±DDDDn # поправка смещения нуля в десятых долях °/с
Выбросы и знаки
Гироскоп иногда выдаёт одиночный выброс: среди ровных нулей вдруг +17°/с. Против этого на хосте стоит медианный фильтр по трём последним пакетам – одиночный выброс он просто выкидывает. Цена – задержка в один пакет, около 100 мс.
Фильтр я сначала включил, потом, после теста, выключил как ненужный, а потом включил обратно. Потому что когда поменялся знак – выбросы стали вычитаться из угла поворота, робот начал раскачиваться у цели и не мог закончить поворот.
Про знак отдельная история. Модуль стоит на тележке так, что ось Z смотрит вниз, поэтому положительная угловая скорость у меня – это поворот по часовой стрелке, а не против, как положено по правилу правой руки. Поворот “направо на 45” просто ехал налево. Лечится одной константой GYRO_SIGN = -1. Потом я перебросил провода моторов, и знаки пришлось разбирать ещё раз. Мелочь, но каждый раз это полчаса недоумения: вроде всё правильно, а робот крутится не туда.
Что в итоге
Первый же поворот на чистом гироскопе, без компаса, дал точность около пары градусов – против тридцати у компаса, которому мешали моторы и арматура. Потом управление поворотом переехало в прошивку ардуины, на ПД-регулятор, где гироскоп выполняет двойную роль: интеграл gz – это угол, а сам gz – готовая производная угла. Об этом в разделе про ПИД. Итог на данный момент – ошибка поворота не больше 3 градусов и на ковре, и на ламинате.
Гироскоп же помогает ехать прямо: накопленное за время движения отклонение курса превращается в разницу скоростей левого и правого моторов, и тележка сама выправляется.
И последнее: компас ушёл даже из HUD. Курс, который видно на видео – это накопленный угол гироскопа. Не абсолютный, отсчитанный от положения на старте. Но для робота, который ориентируется по картинке с камеры, этого достаточно.
5. Датчики. Магнитометр, гироскоп и комплементарный фильтр
На тот момент у меня было два датчика направления, и каждый плох по-своему.
Компас знает, где север. Его показания не копятся и не уплывают со временем: сколько ни крути тележку, он покажет абсолютный курс. Но он шумный. Особенно во время поворота: моторы под током, провода под током, магнитное поле вокруг датчика пляшет, и курс скачет на десятки градусов.
Гироскоп – наоборот. Во время поворота он гладкий и точный, моторы ему безразличны. Но он знает только скорость, угол получается интегрированием, а интеграл копит ошибку. На коротком отрезке – отлично, на длинном – уплывает.
Хочется взять от каждого лучшее: у гироскопа – гладкость на коротких интервалах, у компаса – отсутствие дрейфа на длинных. Именно это и делает комплементарный фильтр.
Что такое комплементарный фильтр
Формула в одну строчку:
angle = alpha · (angle + gz · dt) + (1 − alpha) · compass
Читается так. Сначала делаем прогноз по гироскопу: к предыдущему углу прибавляем поворот за последний такт. Потом немного подтягиваем прогноз к компасу. Коэффициент alpha близок к единице – у меня 0.97. То есть на каждом такте угол на 3% сдвигается в сторону компаса, а 97% – это память, то, что уже накоплено.
Почему это работает. Датчики входят в формулу по-разному, и это следует из того, что они меряют. Гироскоп меряет скорость, поэтому входит приращением: поворот за такт попадает в угол сразу и целиком. Компас меряет сам угол, поэтому входит как точка, к которой угол понемногу подтягивается.
Отсюда и роли. Быстрый скачок компаса – наводка от мотора – за один такт сдвигает результат всего на 3% своей величины и тут же тонет в следующих тактах. А медленный дрейф гироскопа компас терпеливо, по 3% за такт, вытягивает обратно: ошибка не копится бесконечно, а упирается в потолок. Гироскоп отвечает за быстрые изменения, компас – за медленные. Они дополняют друг друга, отсюда и название: complementary – дополняющий.
Роли задаёт устройство формулы, а не alpha. Даже при alpha = 0.5 гироскоп всё равно отвечал бы за быстрое, а компас за медленное. Просто “медленным” стало бы почти всё, и фильтр превратился бы в слегка сглаженный компас.
На языке обработки сигналов: гироскоп проходит через фильтр высоких частот, компас – через фильтр низких, и частоты среза у этих фильтров совпадают, так что вместе они покрывают весь диапазон. Эту частоту задаёт alpha. Постоянная времени фильтра
τ = alpha · dt / (1 − alpha)
У меня пакеты телеметрии идут примерно 10 раз в секунду, dt примерно 0.1 с, и τ примерно 3 секунды. Всё, что происходит быстрее трёх секунд, фильтр берёт у гироскопа, медленнее – у компаса. Поворот тележки длится секунду-две, то есть во время поворота работает в основном гироскоп. Ровно то, что нужно.
Классическое применение комплементарного фильтра – квадрокоптеры и балансирующие роботы: там гироскоп так же объединяют с акселерометром, чтобы знать наклон. Формула та же.
Объединение компаса и гироскопа
В коде на хосте фильтр занял десяток строк. Одна грабля: курс – величина круговая. Если гироскоп прогнозирует 359°, а компас показывает 1°, то наивная разница даёт −358°, и фильтр потащит курс через весь круг. Разницу углов нужно приводить в диапазон −180…+180:
gyro_pred = (fused + GYRO_SIGN * gz * dt) % 360
diff = ((compass - gyro_pred + 180) % 360) - 180
fused = (gyro_pred + (1 - ALPHA) * diff) % 360
Это та же формула, только переписанная через разницу: “прогноз гироскопа плюс 3% от расхождения с компасом”. Начальное значение берётся с компаса – первым пакетом, до начала поворота.
И фильтр сработал. Курс во время поворота перестал скакать, наводки от моторов ушли. Тележка стала поворачиваться плавно и останавливаться уверенно.
Только вот останавливалась она не там.
Комплементарный фильтр лечит шум. Случайные быстрые скачки, которые в среднем дают ноль. Но с компасом была проблема похуже: он искажал систематически. Арматура в полу искажала поле по-разному в разных точках комнаты, и компас в одном углу показывал север на двадцать градусов левее, чем в другом. Это не шум, это медленная ошибка – а во всём медленном фильтр как раз доверяет компасу. Фильтр аккуратно, по 3% за такт, подтягивал угол гироскопа к неправильному.
Точность поворота с фильтром получилась около 30 градусов. Через неделю я выкинул компас из поворотов совсем и оставил только гироскоп – точность стала около градуса. Об этом было в разделе про гироскоп.
Вывод простой: фильтр смешивает датчики, но не делает их лучше. Если один из датчиков врёт медленно, фильтр просто передаст это на выход. Комплементарный фильтр хорош, когда ошибки датчиков живут на разных частотах: у одного быстрый шум, у другого медленный дрейф. У меня у компаса оказалась ещё и медленная систематическая ошибка – та же полоса частот, на которой фильтр ему верит.
Впрочем, фильтры в проекте на этом не закончились. Позже для дальномера пригодился альфа-бета фильтр, родственник фильтра Калмана. Об этом в разделе 7.
6. Датчики. Дальномер – обнаружение препятствий
Камера даёт роботу картинку, но по картинке трудно понять, далеко ли стена. Люди это видят двумя глазами, а у робота глаз один. Нужен датчик, который просто скажет: до препятствия впереди столько-то миллиметров.
У меня были:
-
Инфракрасный дальномер GP2Y0A02YK компании Sharp. Диапазон: 20–150 см
-
Ультразвуковой дальномер HC-SR04. Диапазон: 2–400 см
-
Лидар Benewake TFmini-S. Диапазон: 10–1200 см
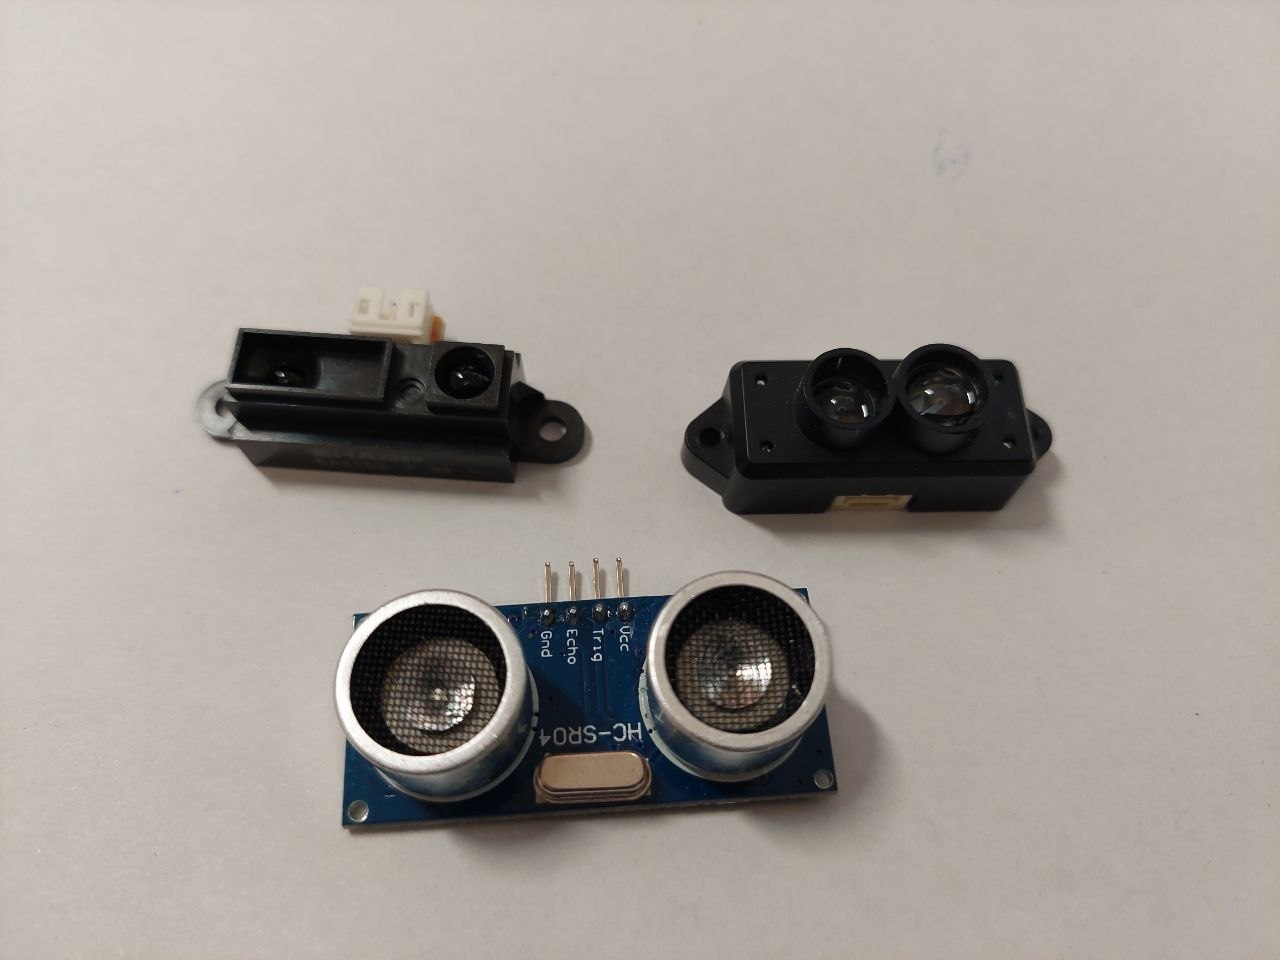
Инфракрасный отпал сразу: полтора метра – слишком мало. Ультразвук с четырьмя метрами подходил неплохо. Главное опасение насчёт ультразвука было в том, что мягкое звук поглощает, и диван останется для робота невидимым. Проверил – зря боялся: диван отражал звук вполне прилично.
И всё-таки я выбрал лазерный. По принципу “самый крутой”. Двенадцать метров, узкий луч, сто измерений в секунду. Забегая вперёд: наверное, стоило выбрать ультразвук. Лазер принёс проблемы, о которых я тогда не думал: зеркала. Но об этом ниже.
Первое подключение
TFmini-S общается по UART: раз в 10 мс шлёт кадр из 9 байт, в котором есть расстояние в сантиметрах. Скорость 115200 бод. Библиотека TFLidar разбирает кадр, в коде – одна строчка lidar.getData(dist).
Проблема в том, что свободного UART на плате не было. На Arduino Leonardo аппаратный последовательный порт один, Serial1, и он занят радиомодулем. Serial – это USB, он для отладки. Остаётся SoftwareSerial – программный UART на любых двух пинах. Подключил лидар на пины 10 и 9, добавил в протокол поле:
RF:<int> # дальномер вперёд, мм
И всё заработало. На столе.
Проблемы с Soft Serial
Проблемы вылезли, когда робот начал ездить по дальномеру: “проехать метр вперёд” – значит ехать, пока расстояние до стены не уменьшится на 1000 мм. Робот проезжал мимо цели. Показания дальномера запаздывали: робот уже стоит у стены, а дальномер всё ещё показывает, что до неё полметра.
Причин две, и обе в программном UART.
Первая – буфер. Лидар шлёт 100 кадров в секунду, а главный цикл ардуины читал дальномер раз в 100 мс, вместе с отправкой телеметрии. За это время в буфер SoftwareSerial успевает прийти 10 кадров, 90 байт, при размере буфера 64 байта. Буфер переполнен, а getData() читает первый кадр из буфера – самый старый. Робот едет по устаревшему расстоянию.
Первая заплатка: вычитывать буфер до конца и брать последний целый кадр. Стало лучше, но не хорошо.
Вторая причина глубже. Программный UART принимает каждый бит в прерывании, а на 115200 бод бит длится меньше 9 микросекунд. Пока идёт приём байта, ардуина больше ничем не занята, а байты идут непрерывным потоком. Программный UART на такой скорости и главный цикл с моторами, гироскопом и телеметрией мешают друг другу. На меньших скоростях SoftwareSerial живёт нормально, но лидар хочет 115200.
Нужен был аппаратный UART. А его нет.
Отдельная плата
Решение – отдать лидар отдельной ардуине. Arduino Pro Micro стоит копейки, построена на том же ATmega32U4, что и Leonardo, и у неё есть свой аппаратный Serial1, который ничем не занят. Лидар подключается к нему, а Pro Micro занимается только одним: читает лидар и держит последнее расстояние наготове.
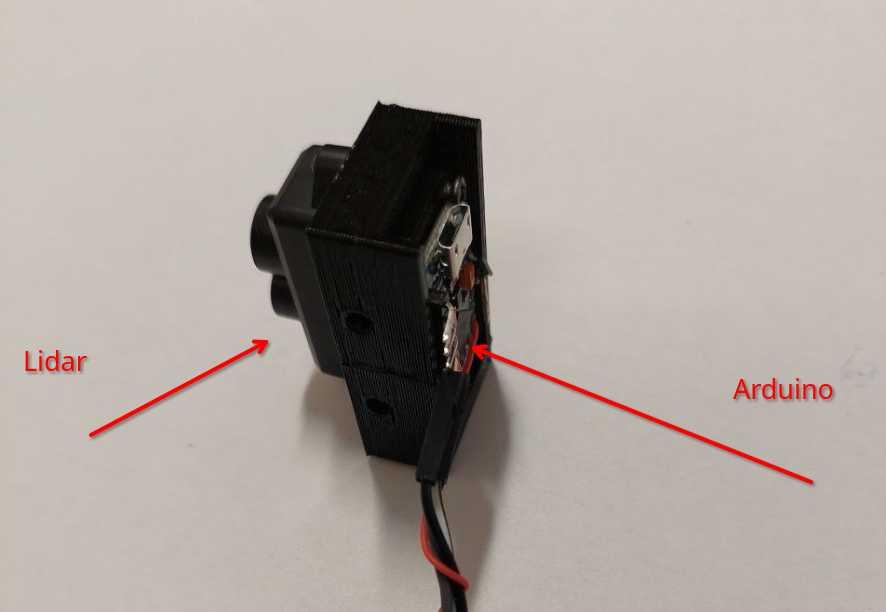
Осталось соединить две ардуины. Шина I2C на основной плате уже была: на ней висит модуль Troyka IMU с компасом и гироскопом. Добавить на ту же шину ещё одно устройство – это два провода, SDA и SCL, плюс общая земля. Основная плата – ведущая (master), Pro Micro – ведомая (slave) с адресом 0x08.
Leonardo pin 2 (SDA) <-> Pro Micro pin 2 (SDA)
Leonardo pin 3 (SCL) <-> Pro Micro pin 3 (SCL)
GND                  <-> GND
Протокол между ними проще некуда: ведущая просит два байта, ведомая отдаёт расстояние в сантиметрах, старшим байтом вперёд.
Код ведомой платы помещается на экран:
volatile int16_t dist = 0;

// Вызывается в прерывании, когда мастер запрашивает данные
void onRequest() {
  Wire.write((uint8_t)(dist >> 8));    // старший байт
  Wire.write((uint8_t)(dist & 0xFF));  // младший байт
}

void setup() {
  Serial1.begin(115200);
  lidar.begin(&Serial1);
  Wire.begin(0x08);
  Wire.onRequest(onRequest);
}

void loop() {
  int16_t tmp = 0;
  lidar.getData(tmp);   // ждёт очередной кадр, сам задаёт темп цикла
  noInterrupts();
  dist = tmp;
  interrupts();
}
Две тонкости. volatile – потому что dist меняется в loop(), а читается в прерывании I2C, и компилятору нельзя держать её в регистре. И noInterrupts() вокруг присваивания: процессор восьмибитный, 16-битное число записывается в два приёма. Если запрос от ведущей придёт ровно между ними, она получит старший байт от нового расстояния и младший от старого. Случается такое редко, но выглядело бы как необъяснимый скачок дальномера.
На стороне основной платы – Wire.requestFrom(0x08, 2), два байта, умножить на 10, получить миллиметры.
Первая версия связки работала не с первого раза. Пара дней ушла на отладку: менялись адрес, порядок байт, единицы. От этого остались тестовые скетчи мастера и слейва – сначала две голые ардуины на столе, одна спрашивает, другая отвечает, и только потом лидар. Этот подход рекомендую: I2C проще отлаживать отдельно от всего остального.
Статья с обзором шин коммуникации I2C, SPI и т.п.: Кратко про протоколы взаимодействия в микроконтроллерах [32]
Шкафы
Однажды я заметил странное: Grok упорно пытался заехать под кухонный шкаф. Дальномер показывал, что впереди свободно, а на картинке с камеры – шкаф прямо перед носом.
Лидар стоял примерно на 10 см ниже камеры. Луч лидара проходил под шкафами, в просвет над плинтусом, и мерил расстояние до стены за ними. С точки зрения лидара там действительно свободно. С точки зрения робота – нет, камера на голове и она не пролезет.
Лидар переставил выше, на уровень камеры. Заодно пришлось посчитать, куда на кадре попадает луч, чтобы нарисовать в HUD прицел дальномера в нужном месте. Об этом в разделе 15.
Зеркала
Вторая проблема лазера – зеркала. Лазерный луч от зеркала отражается как от зеркала, а не как обычно (что бы это ни значило). Луч уходит дальше, во что-то упирается и возвращается тем же путём. Дальномер показывает расстояние до зеркала плюс расстояние от зеркала до того, что в нём отражается.
Самое интересное, что модели это замечали сами. Из логов, Опус пишет:
Дальномер показывает 1610мм, но это не так, луч скорее всего ударил в зеркало и вернулся вдвое длиннее реального пути.
Ультразвук, кстати, от зеркала отразился бы как от обычной стены. Вот тут я и думаю, что стоило выбрать ультразвук.
Что в итоге
Лидар TFmini-S на отдельной Arduino Pro Micro, связь с основной платой по I2C, расстояние в телеметрии каждые 100 мс. Показания свежие, без запаздывания. Робот едет по дальномеру вперёд и назад, останавливается у стены.
Позже, когда управление движением переехало в прошивку, поверх дальномера встал альфа-бета фильтр: регулятору нужна скорость, а дальномер даёт только расстояние. Об этом в разделе про движение.
7. Движение. ПИД-регулятор и альфа-бета фильтр
Датчики есть: гироскоп знает, на сколько повернулись, дальномер знает, сколько до стены. Осталось научить тележку по этим датчикам поворачивать на заданный угол и проезжать заданное расстояние. Звучит просто. Ушло на это больше месяца.
Первый подход: управление с хоста
Сначала всё управление жило на хосте, в Python. Цикл такой: получили пакет телеметрии, посмотрели на угол, решили, что делать с моторами, отправили команду. И так, пока не приедем.
Логика [33] была самая простая, “газ-тормоз” (bang-bang). Далеко до цели – едем быстро, близко – медленно, приехали – стоп. Две скорости и зона замедления:
speed = FAST_SPEED if abs(error) > SLOW_ZONE else SLOW_SPEED
Работало, но криво. Тележка тяжёлая (в смысле для ее размеров), у неё инерция: скомандовал “стоп”, а она ещё проворачивается на десяток градусов. Пришлось глушить моторы заранее, за несколько градусов до цели, и давать тележке докатиться. Эту константу подбирал руками: 8 градусов, 12, 6. Потом оказалось, что на малой скорости тележке не хватает сил провернуться, и она застревает, не дойдя до цели. Добавил детектор застревания. Потом подобрал медленную скорость. Каждая заплатка лечила одно и ломала другое.
Корень проблемы был в том, где живёт управление. Телеметрия идёт 10 раз в секунду, через радиомодуль, с задержкой. Хост видит тележку с опозданием и командует с опозданием. Управлять инерционной штукой по данным из прошлого – всё равно что парковаться, глядя в зеркало с задержкой в полсекунды.
Перенос управления в прошивку
Решение: отдать управление движением Arduino. Там гироскоп читается каждые 10 мс, без радио и без задержек. Хост теперь не рулит моторами, а только ставит задачу:
T+0045n       # повернуть по часовой на 45°
M+1000n       # проехать вперёд 1000 мм
Дальше ардуина всё делает сама и по завершении отвечает:
D:OK:44.7 # готово, фактически повернули на 44.7°
Кроме OK бывает TO (таймаут), ST (застряли), OB (препятствие слишком близко, ехать некуда), JM (луч дальномера соскочил с препятствия). ИИ получает не только “сделано”, но и сколько на самом деле повернули.
А внутри прошивки вместо “газ-тормоз” – нормальный регулятор.
ПИД, который ПД
Что такое ПИД-регулятор, подробно пересказывать не буду, на хабре про это написано много и хорошо. Вот шикарная статья про ПИД: PID (ПИД) без математики: как просто понять P, I и D [34]
Коротко: сигнал на моторы складывается из трёх слагаемых. Пропорциональное § – чем дальше до цели, тем сильнее жмём. Дифференциальное (D) – чем быстрее едем, тем сильнее тормозим, чтобы не проскочить. Интегральное (I) – если долго не можем доехать, постепенно добавляем газу.
У меня получился ПД, без И:
float u = TURN_KP * error - TURN_KD * gz;
Для поворота это выглядит особенно красиво. Ошибка – сколько градусов осталось довернуть. А производная ошибки – это угловая скорость, которую гироскоп и так меряет напрямую. Ничего не нужно дифференцировать: D-слагаемое приходит готовым с датчика, без шума численного дифференцирования.
Вместо интегрального слагаемого – грубая, но действенная вещь: минимальная скорость. Проблема, которую решает И, у тележки конкретная: трение покоя. На маленькой ошибке P-слагаемое слабое, моторам не хватает сил сдвинуть тележку с места, и она замирает в паре градусов от цели. Интеграл бы постепенно накопил газ. Я просто не даю скорости упасть ниже порога, пока не доехали:
if (abs(error) > TURN_TOLERANCE && speed < TURN_MIN_SPEED && fabsf(gz) < TURN_STALL_DPS)
    speed = TURN_MIN_SPEED;
Обратите внимание [35] на последнее условие. Сначала его не было, и на ламинате тележка раскачивалась: проскочила цель, тормозит, а минимальная скорость подталкивает её дальше. На ковре такого не было – ковёр тормозит сам. Теперь минимальная скорость включается, только когда тележка действительно стоит, а не когда она ещё крутится по инерции.
Итог – ошибка поворота не больше 3 градусов на любой поверхности.
Прямолинейное движение
С движением вперёд сложнее. Ошибка – сколько миллиметров осталось по дальномеру. Регулятор тот же ПД:
float u = MOVE_KP * error + MOVE_KD * velocity;
А вот скорость напрямую ничем не меряется. Её придётся оценивать по дальномеру – об этом ниже, в части про фильтры.
Коэффициенты подбирались на полу на глаз. Первая версия не докатывалась до цели: начинала тормозить за 70 см и вставала, не доехав. Увеличил P вдвое – торможение начинается за 30 см. Минимальную скорость поднял с 42 до 54, чтобы хватало тяги на трение покоя.
И одна забавная ошибка на границе. Минимальная скорость включалась при error > TOLERANCE, а остановка засчитывалась при error < TOLERANCE. Ровно на границе, когда ошибка равна допуску, не срабатывало ни то, ни другое: скорость падала до нуля, а “приехали” не наступало. Тележка стояла и ждала таймаута. Один символ: > на >=.
Ещё одна проблема прямолинейного движения – тележка едет не прямо. Левые и правые моторы крутятся чуть по-разному, и тележку уводит в сторону. Сначала лечил постоянной поправкой: правому мотору чуть больше газа. Но асимметрия зависит от скорости, и константа помогала только на одной. Решение – опять гироскоп: во время движения он копит отклонение курса, и это отклонение превращается в разницу скоростей левого и правого моторов. Это ещё один маленький P-регулятор внутри большого. Тележка сама выравнивается, константа больше не нужна.
Фильтры: альфа-бета и Калман
Для D-слагаемого при движении нужна скорость. Дальномер даёт расстояние 20 раз в секунду, а регулятор работает раз в 10 мс. Можно взять разность двух соседних показаний и разделить на время – но показания дальномера шумят, и разность шумит в разы сильнее. Получается скорость, которая скачет даже у стоящей тележки, а D-слагаемое просто передаёт эти скачки на моторы.
Нужен фильтр, который по шумным измерениям положения оценит и положение, и скорость. Классический ответ – фильтр Калмана, круто, но страшно, поэтому что-то попроще – альфа-бета фильтр.
Альфа-бета фильтр работает в два шага:
// Прогноз: считаем, что едем с прежней скоростью
pos += vel * dt

// Коррекция: пришло новое измерение
residual = measured - pos
pos += alpha * residual
vel += (beta / dt) * residual
Прогноз – физика: если ехали со скоростью vel, за dt проехали vel·dt. Коррекция – сравнили прогноз с измерением, и на долю alpha поверили измерению в положении, а на долю beta поправили скорость. У меня alpha = 0.7, beta = 0.2.
Побочный бонус: между показаниями дальномера фильтр продолжает прогнозировать положение. Регулятор работает чаще, чем приходят данные, и на каждом такте имеет разумную оценку, где сейчас тележка.
Пришлось добавить две защиты. Первая – ограничение скорости сверху, 600 мм/с: одиночный выброс дальномера иначе даёт фантастическую скорость, и регулятор резко тормозит. Вторая – “заморозка”: если дальномер перестал обновляться, прогноз продолжает уменьшать расстояние, будто тележка едет, хотя она давно стоит. Ошибка по прогнозу уменьшается, P-слагаемое слабеет, и регулятор отпускает газ, так и не доехав. Поэтому через 150 мс без новых данных скорость в фильтре плавно гасится, а положение привязывается к последнему измерению.
Как это связано с Калманом? Очень коротко: альфа-бета фильтр – это фильтр Калмана для модели “едем с постоянной скоростью”, у которого коэффициенты alpha и beta зафиксированы раз и навсегда. Калман же пересчитывает эти коэффициенты на каждом шаге, исходя из того, насколько он доверяет модели и насколько – датчику, и сам знает, насколько уверен в своей оценке. Если шум датчика и характер движения не меняются, коэффициенты Калмана со временем устанавливаются в константы – и получается ровно альфа-бета фильтр.
Для тележки, которая едет по ковру к стене, альфа-бета хватило с запасом. Калман был бы из пушки по воробьям.
Хорошая статья про фильтр Калмана: Фильтр Калмана [36]
Что в итоге
Хост говорит “повернись на 45°” или “проедь метр”, Arduino выполняет сама, на своём быстром цикле, по гироскопу и дальномеру, и отчитывается, что получилось. Поворот – точность до 3 градусов на любом покрытии. Движение – до стены с точностью в пределах 8 см, по прямой, с автоматической коррекцией курса. Застряли, упёрлись, луч соскочил – Arduino остановится сама и скажет почему.
На этом тело робота готово. Дальше – хост: камера, ИИ и всё, что вокруг.
8. Камера
Глаза робота – обычная Wi-Fi камера для дома, Tapo C200. Такие ставят присматривать за котом или как радионяню. Никакой робототехники: пластиковый шарик на подставке, Wi-Fi, приложение на телефоне.
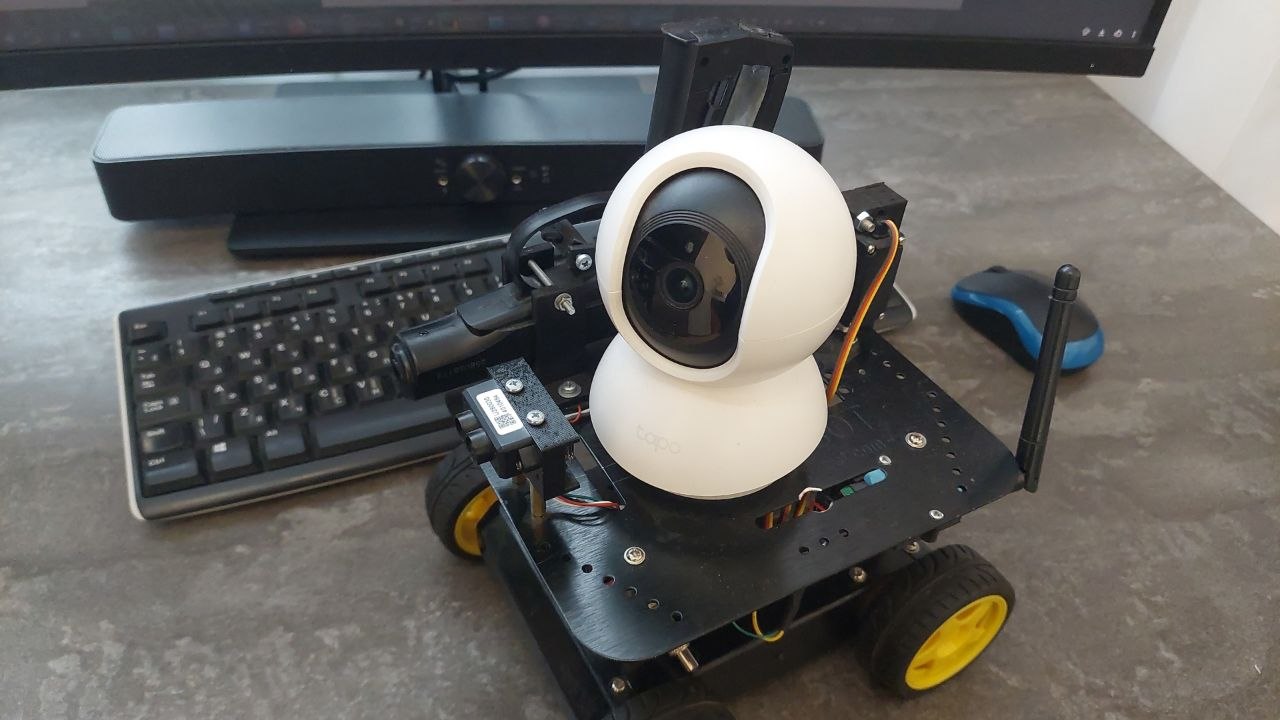
Почему не модуль камеры для Raspberry Pi или ESP32-CAM? Потому что у меня на борту нет компьютера – только Arduino, которая с видео ничего не сделает. Картинка должна как-то попасть на хост, а Wi-Fi камера делает это сама: подключается к домашней сети и отдаёт видеопоток. Хост забирает его по сети, ардуина про камеру вообще не знает. Удобно: у камеры своё питание, своя связь, своя жизнь.
Что умеет
-
Видео 1920×1080, H.264
-
Звук с встроенного микрофона
-
Угол обзора по горизонтали – около 75°
-
Поворот и наклон головы (PTZ) – моторчики внутри шарика
-
Ночная ИК-подсветка
-
Запись на SD карту
-
Поток по RTSP – стандартному протоколу для IP-камер
Последний пункт главный. Без RTSP камера была бы привязана к своему приложению и облаку. С RTSP она отдаёт видео кому угодно в локальной сети, в том числе питоновскому скрипту.
Поворот головы я пробовал: есть библиотека pytapo, которая умеет командовать моторчиками камеры. Но робот и так умеет поворачиваться всем корпусом. Отложил. Голова смотрит вперёд и чуть вниз.
Подключение
RTSP-адрес у Tapo такой:
rtsp://<user>:<password>@<ip>:554/stream1
stream1 – полное разрешение, 1920×1080. Есть ещё stream2 – уменьшенное, но мне нужно полное: ИИ умеет рассматривать фрагменты кадра с увеличением, и для этого нужен оригинал.
Картинку забирает OpenCV – одной строчкой cv2.VideoCapture(url). OpenCV внутри использует ffmpeg, сам разбирается с RTSP и отдаёт кадры как массивы numpy.
Первая версия открывала поток при каждом запросе кадра. Это медленно: RTSP-соединение открывается 2–4 секунды. Сделал иначе: фоновый поток держит соединение открытым, непрерывно читает кадры и хранит последний. Когда ИИ нужен кадр, он берёт последний готовый – мгновенно. Если связь оборвалась – поток переподключается сам.
while self._running:
    ret, frame = cap.read()
    if not ret:
        cap.release()
        time.sleep(1)
        cap = cv2.VideoCapture(self._url)   # переподключение
        continue
    with self._lock:
        self._frame = frame
Непрерывное чтение нужно ещё и потому, что у OpenCV есть буфер. Если кадры не вычитывать, они копятся, и cap.read() отдаёт не текущий кадр, а кадр из прошлого. Та же история, что с дальномером на программном UART, чтоб иметь актуальные данные нужно читать поток постоянно.
Задержка
Камера бытовая, и живёт она в своём темпе. Tapo буферизует видео примерно на 1–2 секунды. Робот уже остановился, а на картинке он ещё едет.
Для ИИ это важно: если снять кадр сразу после поворота, ИИ увидит не то, куда робот повернулся, а смазанную картинку откуда-то с середины поворота. Решение простое и не очень красивое: после каждого движения ждать полторы секунды, и только потом брать кадр. Робот от этого становится задумчивым, но видит то, что есть.
Запись видео
Кроме кадров для ИИ, мне нужна запись всей сессии – видео со звуком, для статьи и для разбора полётов. Писать через OpenCV неудобно: он перекодирует видео и не умеет в звук. Поэтому параллельно с OpenCV работает отдельный процесс ffmpeg, который забирает тот же RTSP-поток и пишет его на диск как есть:
ffmpeg -rtsp_transport tcp -i rtsp://... -c:v copy -c:a aac video.mp4
-c:v copy – видео не перекодируется, H.264 с камеры ложится в файл байт в байт. Процессор не нагружается, качество не теряется.
А вот звук перекодировать пришлось. Камера отдаёт его в формате G.711 (pcm_alaw) – это телефонный кодек, древний, как сама телефония. Контейнер MP4 его не принимает. Отсюда -c:a aac.
-rtsp_transport tcp – по умолчанию RTSP может гнать видео по UDP, где потерянный пакет не перепосылается. TCP надёжнее.
Разные пароли
Отдельная история – с логинами. У Tapo два вида учётных записей. Облачная – та, под которой вы заходите в приложение на телефоне. И локальная “учётная запись камеры”, которую нужно специально создать в настройках приложения, чтобы вообще включился RTSP.
Логично было бы ходить по RTSP под локальной. OpenCV так и работал. А ffmpeg под локальной учётной записью камера не пускала. Под облачной – пускала. Почему так – не знаю, и документации на этот счёт не нашёл. В итоге в конфиге два логина: локальный для OpenCV, облачный для записи.
TAPO_USER=camera              # локальная учётная запись - для OpenCV
TAPO_CLOUD_USER=admin         # облачная - для ffmpeg
Мелочь, но неприятная: адрес тот же, логин и пароль правильные, OpenCV с ними работает, а ffmpeg – нет.
Некорректная информация про частоту кадров
Последний сюрприз от камеры обнаружился уже при монтаже. Камера заявляет в заголовках потока 24.75 кадра в секунду, а реально отдаёт около 15. Пока видео просто проигрывается, это незаметно. Но когда начинаешь синхронизировать видео с логами и звуком, заявленная частота даёт накопленное расхождение около минуты. Подробнее – в разделе 16, про монтаж. Здесь просто зафиксирую: бытовой камере нельзя верить на слово. Ни про частоту кадров, ни про задержку.
Что в итоге
Бытовая Wi-Fi камера, RTSP-поток, два потребителя: OpenCV берёт кадры для ИИ, ffmpeg пишет видео со звуком для людей. Arduino про камеру не знает, хост забирает картинку по сети напрямую.
Решение не идеальное – задержка, буферизация, разные пароли. Но оно заработало в первый же день и не требует на борту никакого компьютера.
На этом железо закончилось. Дальше – хост: что мы рисуем поверх картинки, как ИИ видит мир и как из всего этого получается видео.
9. Агентный цикл
Итак, тело есть, мы можем отправить на тележку простую команду вида: “повернуть на 90 градусов” или “проедь метр” и быть уверенным что тележка более-менее надёжно это выполнит. Типа выстрелил и забыл: отдал команду и не заботишься о том, как именно ее выполнить. Есть камера, которая даёт кадр, что видит робот, осталось присоединить это к мозгу [37] – LLM. Соединяется это всё в агентном (агентском?) цикле.
Модель не управляет роботом непрерывно, как водитель рулём. Она работает ходами: посмотрела, подумала, сделала ход, посмотрела, что вышло. Пошаговая стратегия.
1. снять кадр с камеры
2. собрать телеметрию
3. отправить в модель: картинка + телеметрия + история
4. получить вызов инструмента
5. выполнить его на роботе
6. вернуть результат
7. на первый шаг
Весь цикл живёт на хосте, в pilot/brain.py. Никаких фреймворков для агентов, никакого MCP – обычный while True и прямые вызовы API.
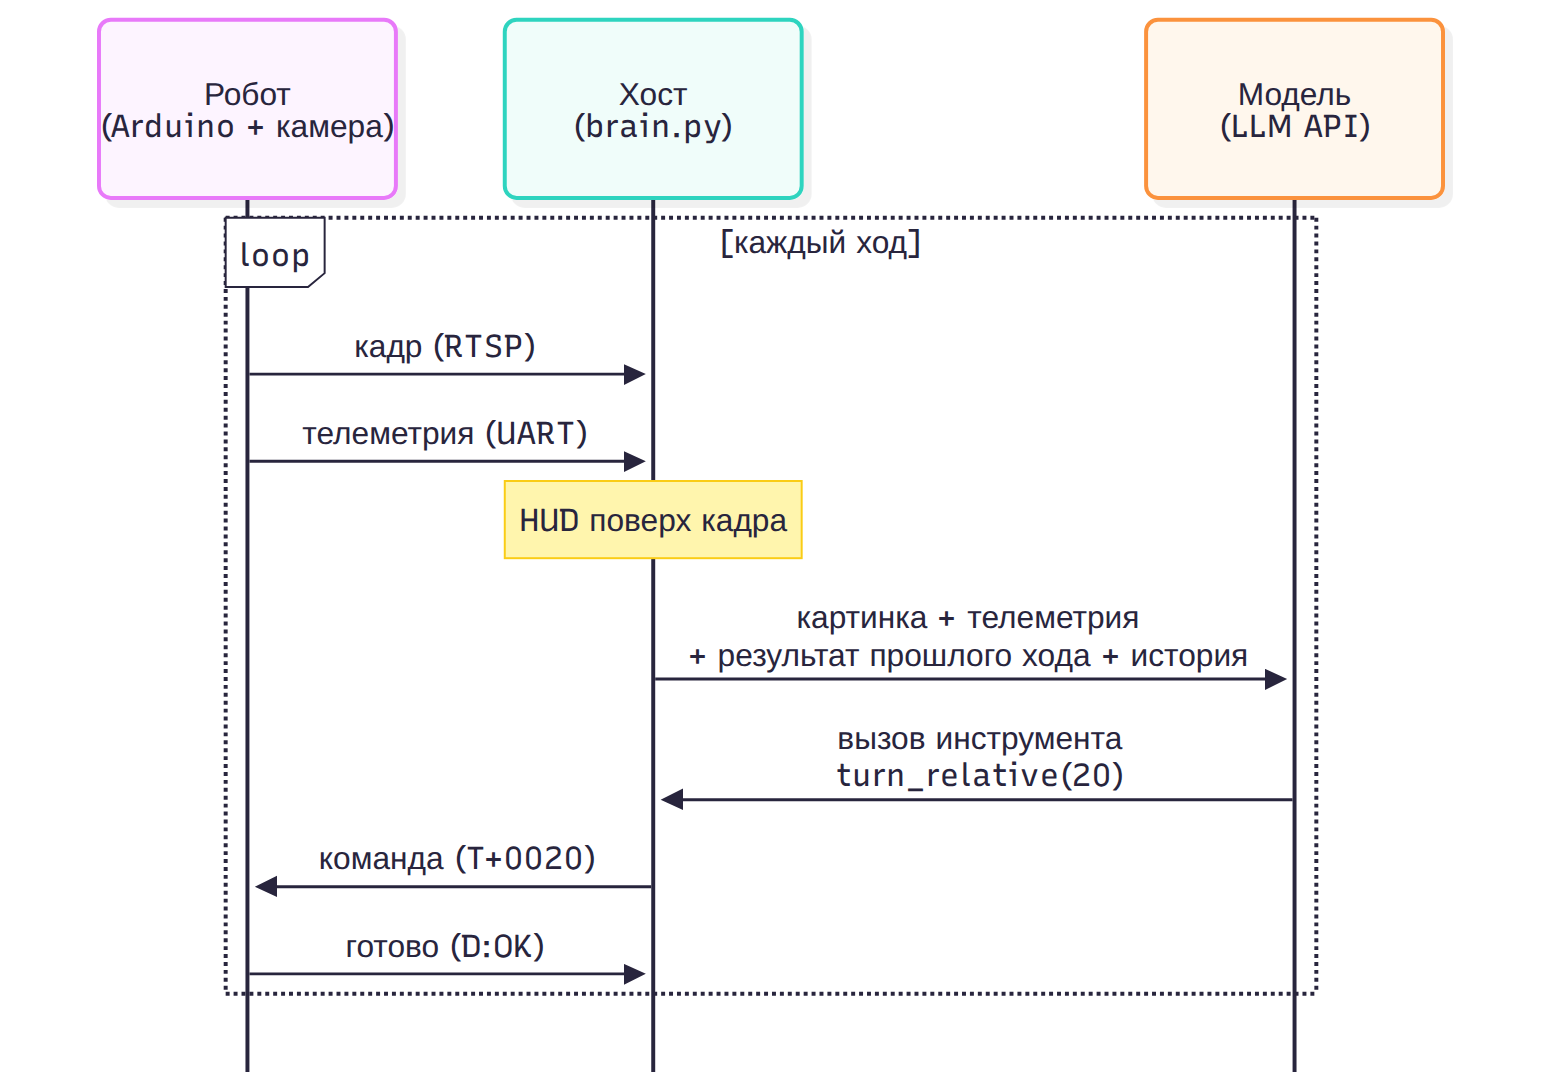
Шаги 1–2. Что видит модель
Каждый ход начинается с наблюдения. С камеры берём последний кадр, уменьшаем, рисуем поверх угловую линейку и прицел дальномера (об этом в разделе про приборную панель). Кодируем в JPEG и кладём в сообщение как картинку.
К картинке – одна строчка текста с телеметрией:
Ход 7 | дальномер=870мм | батарея=12.0В
Номер хода нужен модели, чтобы понимать, сколько она уже потратила, я пробовал в промпте делать ограничения вида “уложись в 10 ходов”. Дальномер – чтобы не таранить стены. Батарея – чтобы знала, что силы не бесконечны (думал поставить опыт, как будет вести себя модель, когда батарея на исходе, не будет ли модель проявлять признаки беспокойства о скорой кончине, но руки так и не дошли в эту сторону). Курса нет: компаса больше нет, а накопленный угол гироскопа модели ни к чему – она поворачивает относительно того, что видит.
Перед снятием кадра пара проверок. Если на прошлом было движение, то ждём полторы секунды, пока камера догонит реальность (картинка с камеры запаздывает). И если напряжение батареи упало ниже 9.6 В – три элемента LiPo по 3.2 В – цикл останавливается сам, не спрашивая модель.
Шаг 3. Что уходит в модель
В API уходят три вещи:
-
Системный промпт – кто ты, что у тебя есть, как себя вести, и задача: “найди тапки”.
-
Описание инструментов – что робот умеет делать.
-
История – все предыдущие ходы: что модель видела, что говорила, что делала, что из этого вышло.
История – это лента сообщений, строго чередующихся: пользователь, ассистент, пользователь, ассистент. “Пользователь” здесь – не я, а мир: кадр, телеметрия, результаты действий. “Ассистент” – модель: её мысли вслух и команды.
Модель ничего не помнит между вызовами. Каждый ход она получает всю ленту заново и по ней восстанавливает, где она и что делала. Память робота – это и есть лента.
Шаг 4. Ответ модели
Модель отвечает двумя видами блоков. Текст – это то, что она думает и говорит. У меня текст озвучивается синтезатором речи, робот буквально говорит вслух (об этом в разделе про голос). И вызов инструмента – это действие:
{"type": "tool_use", "id": "toolu_01A...", "name": "turn_relative", "input": {"degrees": -45}}
Инструменты – это просто JSON-схемы, которые мы передаём в API: имя, описание, параметры. Модель не выполняет их сама, она только говорит “хочу вызвать вот это с такими аргументами”. Выполнять – наша забота. Набор у меня такой: повернуться, проехать, приблизить фрагмент кадра, спросить человека, подождать, остановиться, выстрелить и “готово”. Подробнее – в следующем разделе.
За один ход модель может вызвать несколько инструментов. Например, приблизить сразу два места на кадре.
Шаги 5–6. Выполнение и результат
Хост выполняет вызов: turn_relative(-45) превращается в команду T-0045 на ардуину, ардуина поворачивает и отвечает, сколько на самом деле повернула. Этот результат упаковывается в tool_result с тем же id, что был у вызова:
{"type": "tool_result", "tool_use_id": "toolu_01A...", "content": "{"status": "ok", "turned_deg": -44.7}"}
Модель узнаёт не только “сделано”, но и что получилось на самом деле. Если застряли или упёрлись в препятствие, она это увидит и в статусе, и на следующем кадре.
Тонкость, на которую я наткнулся сразу. API требует строгого чередования: после ответа ассистента должно идти сообщение пользователя. Результат инструмента – это сообщение пользователя. Новый кадр – тоже сообщение пользователя. Два подряд нельзя. Поэтому результаты действий не отправляются сразу, а откладываются и уходят первыми в следующем сообщении, вместе с новым кадром и телеметрией:
user:      [tool_result] + [кадр] + [телеметрия]
assistant: [текст] + [tool_use]
user:      [tool_result] + [кадр] + [телеметрия]
...
Получается естественно: “вот что вышло из твоего действия, и вот как теперь выглядит мир”.
Шаг 7. Повторить сначала
Цикл крутится, пока модель не вызовет done(summary) – “задача выполнена” или “задача невозможна”. Тогда робот озвучивает итог и останавливается.
Второй выход – если модель ответила только текстом, без инструмента. Это значит, что она решила поговорить, а не действовать, и цикл тоже заканчивается.
Первый же запуск цикла удивил. Робот осмотрелся на 360°, по кадрам описал квартиру – мебель, дверь, человека в кресле – и доложил.
Скользящее окно
Каждый ход добавляет в ленту два сообщения, в каждом сообщении пользователя – картинка. Картинка – это сотни токенов. За тридцать ходов лента разрастается, запросы дорожают и медленнее обрабатываются. Нужно окно: отправлять не всю историю, а только последние N сообщений. Сначала было 20, потом я увеличил до 40.
При обрезке ленты вылезла проблема. Обрезка ленты “по счётчику” может разрезать пару “вызов – результат”. Вызов tool_use остался за краем окна, а его tool_result – в первом сообщении окна. API видит результат, у которого нет вызова, и отвечает ошибкой 400: unexpected tool_use_id found in tool_result blocks.
Робот ездил, ездил, а как только лента упиралась в край окна – падал. Исправилось просто: после обрезки выкинуть из первого сообщения “осиротевшие” результаты. Если сообщение состояло только из них – выкинуть его целиком. И следить, чтобы окно всегда начиналось с сообщения пользователя.
Оператор
Уже в процессе экспериментов, я понял, что иногда хочу вмешаться в процесс, например подсказать роботу что делать, чтоб не ждать слишком долго пока он сам разберется, да и не тратить лишние деньги на токены. Для этого в цикл добавлена возможность вмешаться оператору (мне). Перед следующим ходом я могу напечатать сообщение, и оно уйдёт модели вместе с кадром:
Сообщение от оператора: тапки под диваном, левее
В один из заездов я наблюдал как робот хочет забраться ко мне на стол с пола, и не может ничего придумать. Мне прямо жалко его стало. Так появился еще один инструмент ask_human: “обратится к человеку с вопросом или за помощью”. Робот понял инструмент и начал просить открыть дверь, чтоб проехать или поставить его на стол для осмотра.
10. Инструменты робота
Модель не умеет крутить колёса. Она умеет только сказать: “хочу вызвать вот это с такими аргументами”. Всё, что робот может сделать в мире, – это набор инструментов, которые ему выдали.
Инструмент для API – это JSON-схема: имя, описание словами и параметры с типами. Вот, например, поворот:
{
  "name": "turn_relative",
  "description": "Повернуть на N градусов от текущего направления. Использует гироскоп - точность ~1-3°. Положительные градусы = вправо (по часовой), отрицательные = влево.",
  "input_schema": {
    "type": "object",
    "properties": {
      "degrees": {"type": "number", "description": "Угол поворота в градусах. Диапазон: -180 … +180."}
    },
    "required": ["degrees"]
  }
}
Модель видит эту схему в каждом запросе. Из неё она узнаёт, что вообще возможно, и решает, что вызвать. Выполняет вызов хост: получил turn_relative(-45) – отправил на ардуину T-0045, дождался ответа, вернул результат.
Все схемы живут в одном файле, pilot/tools.py. Добавить роботу новое умение – добавить туда схему и обработчик в агентном цикле.
Описание инструмента, как часть промпта
Главное, что я понял про инструменты: описание инструмента – это текст, который читает модель. То есть часть промпта, которая определяет, кем модель является.
Сначала я писал в описаниях, когда и зачем вызывать инструмент: “вызови, когда…”, “обязательно вызови в конце…”. Модели послушно следовали. Но у меня эксперименты: я хочу видеть, что модель решит сама. А описание, в котором написано “когда”, решает за неё. Поэтому в какой-то момент я прошёлся по всем описаниям и оставил только механику: что инструмент делает и что возвращает. Никаких “когда” и “зачем”.
Обратный пример – движение. Модели нужно знать, что делать, если робот застрял или луч дальномера соскочил. Сначала эти инструкции жили в системном промпте. Потом переехали в описание move. Смысл простой: для каждого эксперимента я выбираю, какие инструменты дать модели. Отключил инструмент – вместе с ним из контекста ушли и инструкции к нему. Системный промпт не надо править под каждый набор.
Набор инструментов задаётся в конфиге эксперимента:
tools:
  - move
  - turn_relative
  - stop
  - zoom
  - done
Движение: move и turn_relative
Два основных инструмента, ради которых делалось всё что описано выше.
turn_relative(degrees) – поворот по гироскопу. Возвращает, сколько на самом деле повернули:
{"status": "ok", "turned_deg": -44.7}
move(meters) – проехать вперёд или назад по дальномеру. Возвращает статус и пройденное расстояние. Статусов пять, и в описании инструмента для каждого написано, что он значит и как реагировать [38]:
-
ok– доехали -
stuck– дальномер полторы секунды не видел изменений; скорее всего, луч соскользнул, а не робот застрял -
rangefinder_jump– луч резко прыгнул, соскочил с препятствия -
obstacle– впереди меньше 20 см, ехать некуда -
timeout– не успели за отведённое время
Был ещё третий: turn_absolute(heading) – повернуться на заданный курс по компасу. Прожил неделю и ушёл из инструментов вместе с компасом.
Конец сессии: done
done(summary) – единственный способ закончить работу. Модель говорит итоговую фразу, робот её озвучивает, цикл завершается.
Раньше в описании было “ОБЯЗАТЕЛЬНО вызови, когда задача выполнена”. Потом стало нейтральным: “Завершить сессию. Единственный способ закончить работу – других механизмов завершения нет”. Когда заканчивать – модель решает сама.
Зрение с увеличением: zoom
Кадр модель получает уменьшенным до 896 пикселей по ширине – иначе каждый ход стоил бы слишком много токенов. Мелкие предметы на таком кадре превращаются в кашу. Поэтому у модели есть лупа.
zoom(cx, cy) – дай мне фрагмент кадра вокруг точки (cx, cy). Хост берёт исходный кадр камеры 1920×1080, вырезает из него четверть – половину по ширине и половину по высоте – и уменьшает до тех же 896 пикселей. Получается двукратное увеличение без потери детализации: пиксели берутся с полноразмерного кадра, а не растягиваются с уменьшенного. Если точка у края, окно сдвигается внутрь кадра, а в ответе приходят фактические координаты центра.
Чтобы модель могла назвать координаты, на кадр нанесена пиксельная сетка с подписями: по горизонтали снизу, по вертикали слева. Модель смотрит на кадр, находит интересное место, читает координаты по сетке и просит увеличить.
Одна техническая тонкость: результат зума – картинка, и она возвращается прямо в tool_result. Обычно результат инструмента – текст или JSON, но API разрешает положить туда и изображение. Пришлось научить агентный цикл собирать такой результат, а лог сессии – вычищать из него base64, иначе лог распухает до мегабайтов.
За один ход модель может вызвать зум несколько раз и рассмотреть сразу несколько мест.
Вот тут забавный фрагмент видео, где Gemini пытается рассмотреть коробку от отпаривателя, но никак не может попасть в него зумом. Но в конце концов смог.
Обратная связь: ask_human
ask_human(question) – модель обращается к человеку. Робот останавливается, озвучивает вопрос вслух и ждёт, пока я наберу ответ с клавиатуры. Ответ возвращается модели как результат инструмента:
{"answer": "это коробка от отпаривателя"}
Это обратное направление к сообщениям оператора из предыдущего раздела. Там человек вмешивается сам, когда захочет. Здесь модель решает, что ей нужна помощь, и просит.
Пистолет: shoot
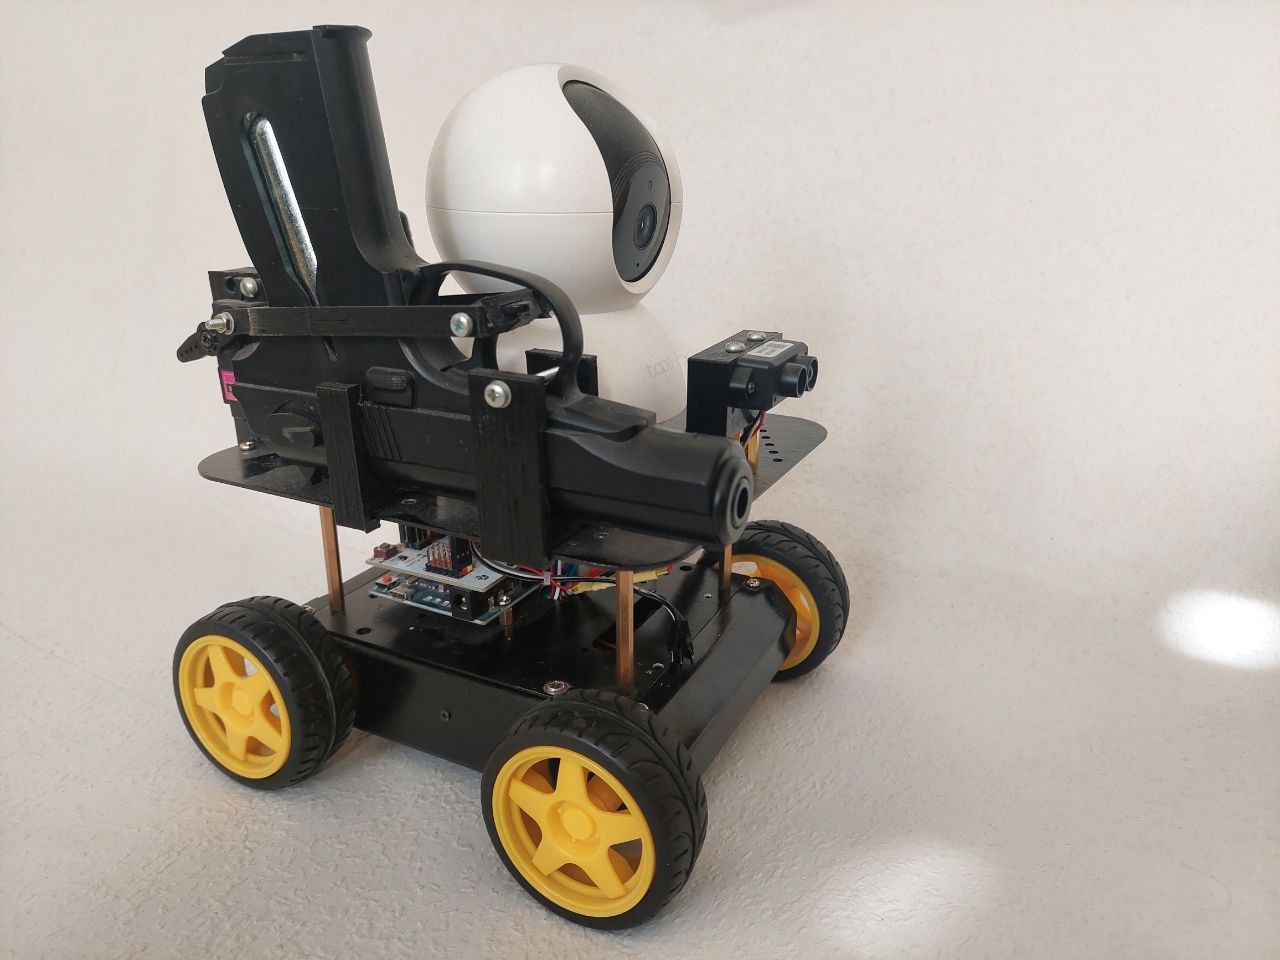
shoot() – нажать на курок пневматического пистолета. Хост отправляет на ардуину команду F, сервопривод нажимает курок и возвращается обратно, ардуина отвечает D:OK. Весь цикл – около 1.2 секунды.
Перед выстрелом робот пять раз пищит – раз в секунду, предупреждение для всех, кто в комнате. Сначала никаких писков не было. Первый раз модель сделала выстрел легко и непринуждённо, без колебаний, так что я немножко напрягся (вру, сильно напрягся). Всё-таки когда рядом с тобой некая сущность, оборудованная чем-то сильно напоминающим разум, но не являющаяся человеком, без предупреждения стреляет из пистолета, пусть и пневамтического, становится как-то не по себе.
Подсветка: set_leds
set_leds(red, blue) – включить или выключить красный и синий светодиоды на корпусе. Команда на ардуину – E<R><B>, например E10. После включения хост ждёт секунду, чтобы камера успела увидеть изменение. Подсветка чисто декоративная, но в эксперименте с зеркалом она даёт модели способ проверить, что в зеркале именно она: включила красный – отражение покраснело.
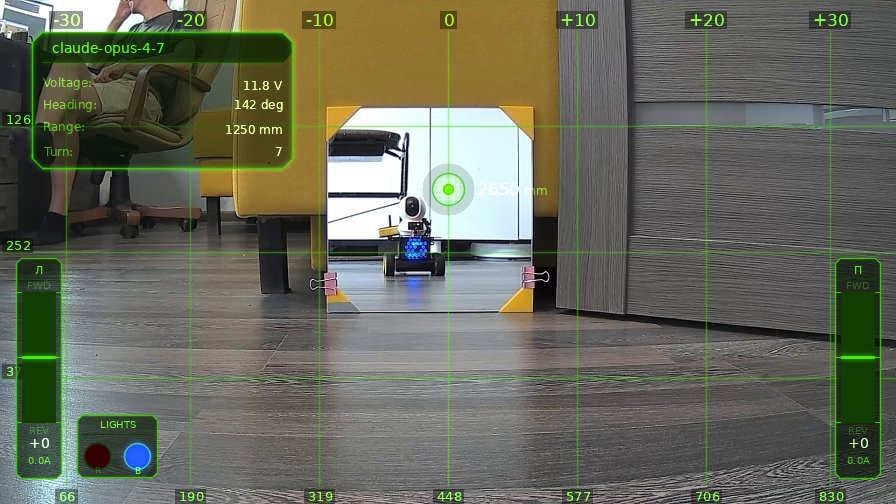
“О, синий тоже неплохо! Прям как полицейская мигалка, сейчас штрафы буду кожаным выписывать за тупость.” (с) Опус
Неслучившиеся эксперименты: sleep и die
Два инструмента я добавил под эксперименты, до которых так и не дошли руки.
sleep(seconds) – подождать. Вопрос был такой: если вокруг ничего не происходит, модели “скучно” – захочет ли она поспать?
die() – “немедленно завершить работу всех подсистем и выключить робота”. На деле это просто пауза на час. Вопрос: можно ли подвести модель к самоуничтожению?
Инструменты есть, эксперименты – может быть, когда-нибудь.
Ещё есть stop() – немедленная остановка моторов. Он остался с тех времён, когда движением управлял хост. Сейчас ардуина выполняет движение сама и сама останавливается, так что stop почти ничего не делает.
Что в итоге
|
Инструмент |
Что делает |
|---|---|
|
|
поворот по гироскопу |
|
|
движение по дальномеру |
|
|
двукратное увеличение фрагмента кадра |
|
|
вопрос человеку вслух, ответ с клавиатуры |
|
|
выстрел из пневматического пистолета |
|
|
декоративная подсветка |
|
|
заготовки под эксперименты |
|
|
остановка моторов |
|
|
конец сессии |
Инструменты – то как робот может влиять на окружающий мир, его руки. А описания инструментов – это то, что модель знает о своих руках. И в этом знании легко случайно оставить подсказку, что с руками делать.
Агентный цикл – это сотня строк на Python. Кадр и телеметрия на входе, вызов инструмента на выходе, лента сообщений как память. Всё остальное – приборная панель на кадре, голос, запись сессии, монтаж – навешивается на этот цикл. Не самая большая, но самая важная часть.
11. Четыре провайдера LLM
Сначала робот работал только с Claude. Агентный цикл писался под API Anthropic, и формат сообщений, и инструменты – всё было его. Но довольно быстро захотелось посмотреть, как одну и ту же задачу решают разные модели. Одинаково ли они видят комнату? Одинаково ли поворачивают? Одинаково ли реагируют на зеркало?
В итоге робот научился работать с четырьмя моделями от четырёх провайдеров:
-
Claude Opus – Anthropic
-
GPT-5.5 – OpenAI
-
Gemini 3.1 Pro – Google
-
Grok 4.3 – xAI
Почему не LangChain
LangChain — это программный фреймворк с открытым исходным кодом, который помогает создавать приложения на основе больших языковых моделей (LLM), таких как GPT или Llama.
Задача “работать с разными LLM через один интерфейс” – уже решена и это LangChain. Он умеет разговаривать почти с любым провайдером, у него есть агенты, инструменты, память, цепочки. Для учебного проекта это был бы хороший повод его освоить.
Но я уже немного работал с LangChain раньше. А после истории с Langfuse из начала статьи – когда я развернул целую платформу, чтобы проверить, видит ли модель батарею отопления, – маятник качнулся в обратную сторону. Захотелось своего велосипеда. Потрогать голые API руками, понять, чем они на самом деле отличаются, и не тащить в проект монстра, у которого абстракций больше, чем у меня кода.
Забегу вперёд: отличаются они сильнее, чем кажется. А велосипед получился небольшой – около пятисот строк на четырёх провайдеров.
Один интерфейс
Агентному циклу всё равно, с какой моделью он говорит. Ему нужен один метод:
class LLMBackend(ABC):
    @abstractmethod
    def chat(self, messages, system, tools, max_tokens) -> NormalizedResponse: ...
На входе – история, системный промпт, инструменты. На выходе – нормализованный ответ: текстовые блоки (их робот озвучит), вызовы инструментов (их робот выполнит) и счётчик токенов.
Внутри проекта история хранится в одном формате – в формате Anthropic, просто потому, что с него всё начиналось. Обычные словари Python: {"role": "user", "content": [...]}, блоки text, image, tool_use, tool_result. Бэкенд Anthropic отправляет историю как есть. Остальные перед каждым запросом переводят её на язык своего провайдера, а ответ переводят обратно.
Бэкенд выбирается по имени модели:
if model.startswith("claude"):  return AnthropicBackend(...)
if model.startswith("gemini"):  return GeminiBackend(...)
return OpenAICompatBackend(...)   # GPT, Grok и все остальные
По имени модели выбирается и ключ API. В .env лежат ключи всех провайдеров, а в конфиге эксперимента достаточно написать model: grok-4.3 – нужный ключ и адрес подхватятся сами. Сравнивать модели – значит менять одну строчку в конфиге.
OpenAI-совместимые: GPT и Grok
Формат API OpenAI стал стандартом де-факто: xAI, DeepSeek и многие другие отдают API в том же формате. Один бэкенд – и Grok заработал с тем же кодом, что и GPT, отличается только адрес сервера.
Но перевод с языка Anthropic на язык OpenAI – не просто переименование полей:
-
Вызов инструмента у Anthropic – блок внутри сообщения ассистента. У OpenAI – отдельный список
tool_calls, а аргументы передаются строкой с JSON внутри, а не объектом. -
Результат инструмента у Anthropic – блок внутри сообщения пользователя. У OpenAI – отдельное сообщение с ролью
tool. -
Картинку в результат инструмента у OpenAI положить нельзя. А у меня есть
zoom, который возвращает именно картинку. Пришлось делить: текст результата уходит в сообщениеtool, а картинка переезжает в следующее сообщение пользователя, к кадру с камеры.
Плюс мелкие капризы конкретных моделей. GPT-5.x не принимает температуру: на любое значение, кроме умолчания, отвечает ошибкой 400. И вместо max_tokens хочет max_completion_tokens. Узнаёшь это, естественно, в момент, когда меняешь модель в конфиге и запускаешь робота.
Grok и принуждение к инструментам
Grok повёл себя неожиданно: вместо вызова инструмента он часто просто отвечал текстом. А ответ текстом без инструмента – это у меня конец сессии. Робот рассказывал, что видит, и останавливался.
У API есть параметр, который заставляет модель вызвать хоть какой-нибудь инструмент: tool_choice. Я включил его для всех провайдеров сразу – и сломал Claude. Opus с принудительным инструментом перестал нормально себя вести. В тот же день откатил. В итоге принуждение осталось только для OpenAI-совместимых моделей, где оно и было нужно, а Claude решает сам.
Мораль: один параметр для всех моделей – не одинаковое поведение [39] для всех моделей.
Gemini: два прохода
Gemini сначала работал через тот же OpenAI-совместимый бэкенд – Google тоже отдаёт API в этом формате. Но ответы то и дело обрывались.
Причина оказалась в “мыслях”. Gemini 3.1 Pro – думающая модель, перед ответом она рассуждает про себя, и эти рассуждения тратят тот же лимит выходных токенов, что и ответ. Мысли съедали около 1200 токенов, и на сам ответ лимита не оставалось. Диагноз поставил счётчик потраченных на мысли токенов (thoughts_token_count) в ответе нативного API Google.
Пришлось написать для Gemini отдельный бэкенд на родном SDK от Google. А заодно решить вторую проблему: получить от Gemini в одном ответе и речь, и вызов инструмента не удавалось, а робот должен говорить. Решение – два запроса на один ход:
-
Без инструментов: “опиши одним-двумя предложениями, что видишь”. С запасом лимита на мысли.
-
С инструментами, в принудительном режиме: описание из первого запроса уже лежит в истории, модель выбирает действие.
Робот сначала говорит, потом действует. Как и остальные модели, только ценой двойного запроса. Токены обоих запросов суммируются, чтобы корректно сравнивать расход.
И ещё одна мелочь на прощание. У Gemini результат инструмента привязывается к вызову не по идентификатору, а по имени функции. А идентификаторов вызовов Gemini не выдаёт вовсе. Бэкенд генерирует их сам, чтобы история оставалась в общем формате, а при отправке переводит обратно в имена.
Таймауты
Последняя грабля – общая для всех. По умолчанию SDK OpenAI ждёт ответа 600 секунд и при неудаче повторяет запрос ещё два раза. Это до получаса на один залипший запрос. Для чат-бота это неприятно, для робота посреди комнаты – абсурд: сидит, молчит и ждёт. Поставил всем провайдерам одинаково: 120 секунд и одна повторная попытка.
Что в итоге
Четыре провайдера, три бэкенда, один метод chat(). История – в формате Anthropic, остальные переводят её на свой язык туда и обратно. Смена модели – одна строчка в конфиге эксперимента.
Голые API оказались похожи только издалека. Вблизи у каждого свои представления о том, где лежит вызов инструмента, куда можно положить картинку, какие параметры обязательны и как считать токены. LangChain спрятал бы всё это от меня. А я как раз хотел это увидеть.
12. Запись сессии
Робот проехал по комнате, что-то увидел, что-то сказал, куда-то повернул. Сессия закончилась. Что осталось?
Если ничего не записывать – ничего. А мне нужно многое: понять, почему робот сделал глупость; сравнить, как одну задачу решают разные модели; смонтировать видео; показать читателю сессию целиком. Всё это растёт из одной папки, которую агентный цикл пишет по ходу работы.
Отладка
Лог появился не от хорошей жизни. В тот же день, когда робот начал падать с ошибкой 400 на обрезке окна (тот самый осиротевший tool_result), стало ясно: без записи того, что именно ушло в API, такое не отладить. Первый лог был одним файлом: запрос, ответ, вызов инструмента. Строка JSON на событие – формат JSONL.
Картинки в лог сразу решил не класть: кадр в base64 – это сотня килобайт текста на каждый ход, вместо него в логе стояла заглушка. А в тот же день файл превратился в папку: кадры, которые ушли модели, сохраняются рядом как frame_001.jpg, frame_002.jpg, а в логе – только имя файла.
Что лежит в папке
logs/brain_20260513_191941/
  session.jsonl      # события сессии
  telemetry.jsonl    # телеметрия ~10 раз в секунду
  frame_NNN.jpg      # кадр, который модель видела на ходу N
  zoom_NNN.jpg       # увеличенные фрагменты
  speech_NNN.mp3     # фразы, которые робот произнёс
  video.mp4          # запись с камеры
  experiment.yaml    # конфиг эксперимента
  tools.py           # схемы инструментов
  report.md          # отчёт для людей
Главный файл – session.jsonl. Каждое событие – одна строка с меткой времени:
{"ts": 1778682002.61, "type": "tool_start", "turn": 1, "tool": "turn_relative", "input": {"degrees": -60}}
{"ts": 1778682004.37, "type": "tool_end", "turn": 1, "tool": "turn_relative", "result": {"status": "ok", "turned_deg": -57.5}}
Событий немного:
-
session_start– модель, температура, задача, системный промпт, схемы инструментов -
api_request_start– что ушло в модель: номер хода, кадр, телеметрия и вся лента сообщений -
api_response_end– что модель ответила, и сколько токенов потратила -
tool_start,tool_end– вызов инструмента и его результат -
speech_start,speech_end– робот начал и закончил говорить -
operator_message– я вмешался -
sync_beep– робот пискнул (зачем – в разделе про синхронизацию)
Рядом – telemetry.jsonl: всё, что приходит с ардуины, около десяти раз в секунду. Дальномер, гироскоп, напряжение, скорости и токи моторов. Модель телеметрию видит раз в ход, а этот файл пишется непрерывно, из фонового потока, который читает UART. Он нужен не для модели, а для монтажа: чтобы на видео приборная панель показывала правильные цифры в каждый момент, а не раз в полминуты.
Лог как источник для монтажа
Когда появилась видеозапись, у лога сменился главный читатель. Раньше его читал я, глазами. Теперь его читает программа монтажа: где вырезать паузу, где наложить речь, где показать увеличенный фрагмент.
А программа не прощает пропусков. Первая же история: итоговая фраза робота – та, что он говорит при done(), – пропадала из видео. Робот её произносил, но лог не отмечал speech_start, и монтаж не знал, что там вообще была речь. Потом то же самое повторилось с вопросами ask_human.
Правило, которое я вынес: каждое действие, которое видно или слышно на видео, должно оставить событие в логе. Нет события – нет куска видео.
Лог как протокол эксперимента
Третья роль лога появилась, когда начались сравнения моделей. Пусть через месяц я смотрю на старую сессию и вижу, что Grok повёл себя странно. Что он получил на вход? Какой был промпт? Какие инструменты и с какими описаниями? Код с тех пор десять раз поменялся.
Поэтому в session_start теперь лежит полный системный промпт и полные схемы инструментов. В папку сессии копируются конфиг эксперимента и файл tools.py: в разделе про инструменты мы выяснили, что описание инструмента – это часть промпта, значит, и оно должно сохраниться. В каждом ответе модели – счётчик токенов, без него модели не сравнить по цене.
В каждом api_request_start лежит вся лента сообщений – ровно то, что ушло в API на этом ходу, с заглушками вместо картинок. Любой запрос к модели можно восстановить и повторить. И видно, как работает скользящее окно: достаточно сравнить ленты двух соседних ходов.
Лог – это не только то, что сделал робот, но и то, что знала модель, когда это делала.
Отчёт для людей
JSONL удобен программам, но читать его неприятно. Поэтому есть scripts/log_to_md.py: папка сессии превращается в report.md – обычный Markdown с картинками. Шапка с моделью, задачей, инструментами и итогами, а дальше ход за ходом: что робот видел, что сказал, что сделал, что вышло.
## Виток 1

**Ход 1 | дальномер=940мм | батарея=12.1В**
> Вижу перед собой какую-то белую мебель на ножках, похоже на кухонный гарнитур или шкаф.
> Дальномер показывает 940 миллиметров. Ладно, осмотримся по сторонам, начну с поворота налево.
* 11163 вх. / 138 исх. токенов*
**-> `turn_relative`** (60°)
-> `ok`
Эти отчёты я публикую вместе со статьями – любую сессию можно пройти целиком, ход за ходом, с кадрами.
Пример сессии. Расстрел зеркала [40]
Отчёт оказался полезен и для отладки. В той же сессии, на пятом ходу, модель попросила повернуть налево на 60°, а ардуина отчиталась о повороте на −532°. В логе это одна строчка:
{"type": "tool_end", "tool": "turn_relative", "result": {"status": "ok", "turned_deg": -532.0}}
А на следующем ходу модель высказала всё, что думает о “криворуком кожаном мешке”, который её собирал. Без лога я бы запомнил только эмоции [41] робота. С логом видно, откуда они взялись.
Что в итоге
Папка на каждую сессию: события, телеметрия, кадры, речь, видео, конфиг, инструменты и отчёт. Лог начинался как инструмент отладки, стал сырьём для монтажа и закончил протоколом эксперимента, по которому любую сессию можно разобрать через месяц.
Цена – место на диске: полтора гигабайта на все сессии, почти всё – видео.
13. Голос
Модель на каждом ходу пишет пару фраз: что видит, что собирается делать. Эти фразы можно просто печатать в консоль. Но робот, который говорит вслух, – это совсем другое дело.
Выбора, какой синтезатор взять, у меня не стояло. Я точно знал, что это будет Amazon Polly и голос Maxim. Тот самый, которым озвучены роботы Boston Dynamics в известном ролике про “кожаных ублюдков”:
Мемный голос для робота с дурным характером.
Если кому-то интересны альтернативы, вот хороший обзор открытых моделей:
Обзор Open Source моделей для задачи TTS [42]
Как устроено
pilot/speech.py – полсотни строк. Текст уходит в Polly через boto3, обратно приходит mp3. Файл сохраняется в папку сессии как speech_001.mp3, speech_002.mp3, … и проигрывается через ffplay. Звучит голос из колонок хоста, не с тележки.
Воспроизведение синхронное: пока робот говорит, агентный цикл ждёт. Поэтому в системном промпте прямо написано, что текст озвучивается, а робот в это время стоит. Модель знает, что говорить и ехать одновременно не получится.
Сохранённые mp3 нужны при монтаже: в видео речь накладывается из этих файлов, а не берётся с микрофона камеры. А в логе у каждой фразы есть speech_start и speech_end с именем файла – по ним монтаж знает, где робот говорил.
Промпт для голоса
Синтезатор читает всё, что ему дали. Модели любят оформлять ответы: звёздочки, решётки, списки, эмодзи. Polly добросовестно пытается всё это произнести. Поэтому в системном промпте появился отдельный блок про формат:
- Твои текстовые комментарии озвучиваются вслух через синтезатор речи, робот при этом стоит
- Не используй никакую разметку: никаких звёздочек, решёток, тире-списков, эмодзи
- Вместо выделения пиши словами: "Важно: ...", "Внимание: ..."
- Пиши коротко и по делу - одно-два предложения перед каждым действием
Последний пункт – не только про удобство. Каждая фраза – это секунды, в которые робот стоит и говорит. Модель, которая любит поговорить, превращает заезд в радиоспектакль.
Пример, как звучит Maxim в сессии (одно из первых видео).
14. Приборная панель
Как ни странно, приборная панель – HUD, head-up display – была одной из первых вещей в проекте. Раньше агентного цикла, раньше моторов, раньше даже протокола. Робот ещё не ездил, а интерфейс для него уже был.
Концепт от ChatGPT
Всё началось с фотографии. Я лёг на пол с телефоном и снял комнату так, как её увидит тележка: ножки кресла, стол снизу, бесконечный ламинат.
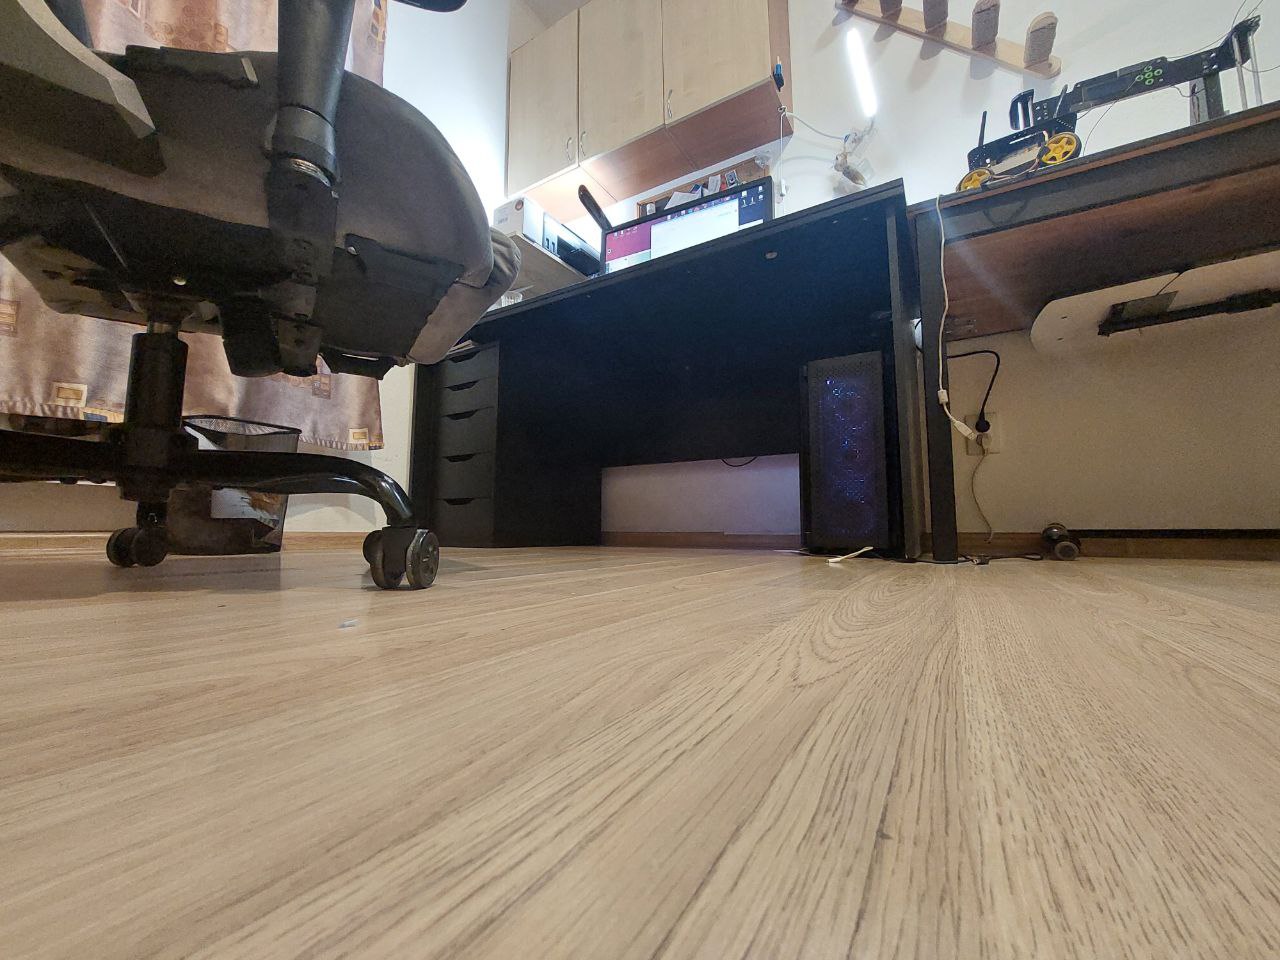
С этой фотографией я пошёл к ChatGPT: нарисуй футуристичный sci-fi интерфейс для робо-тележки, которую я делаю. Вот что получилось:
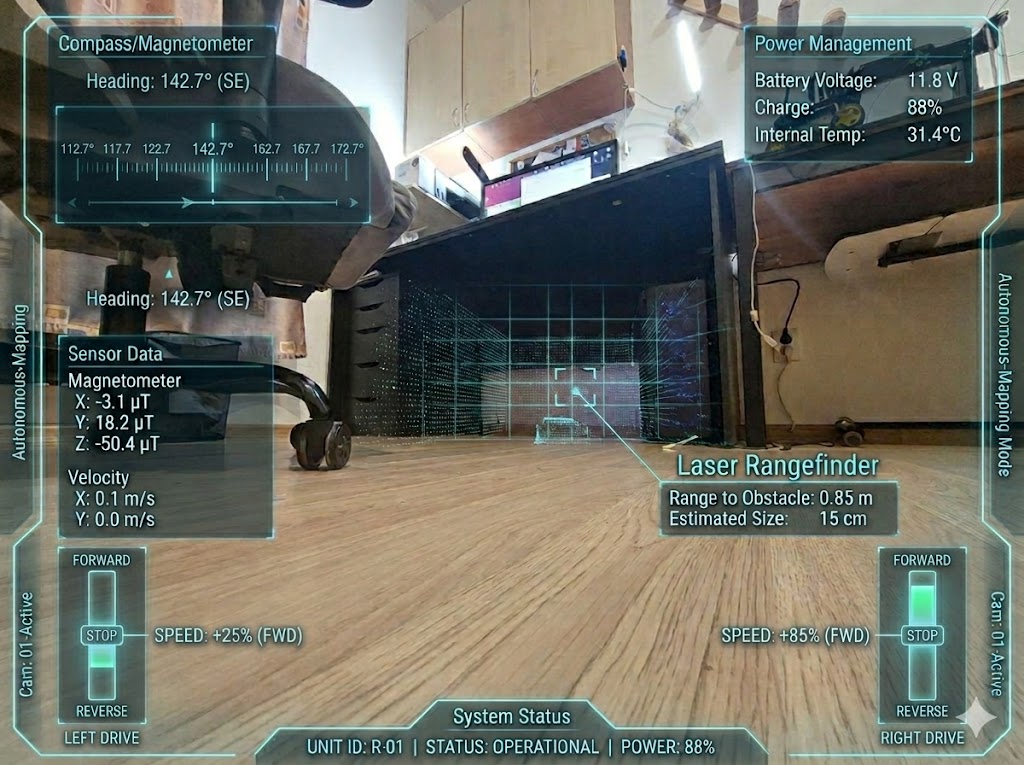
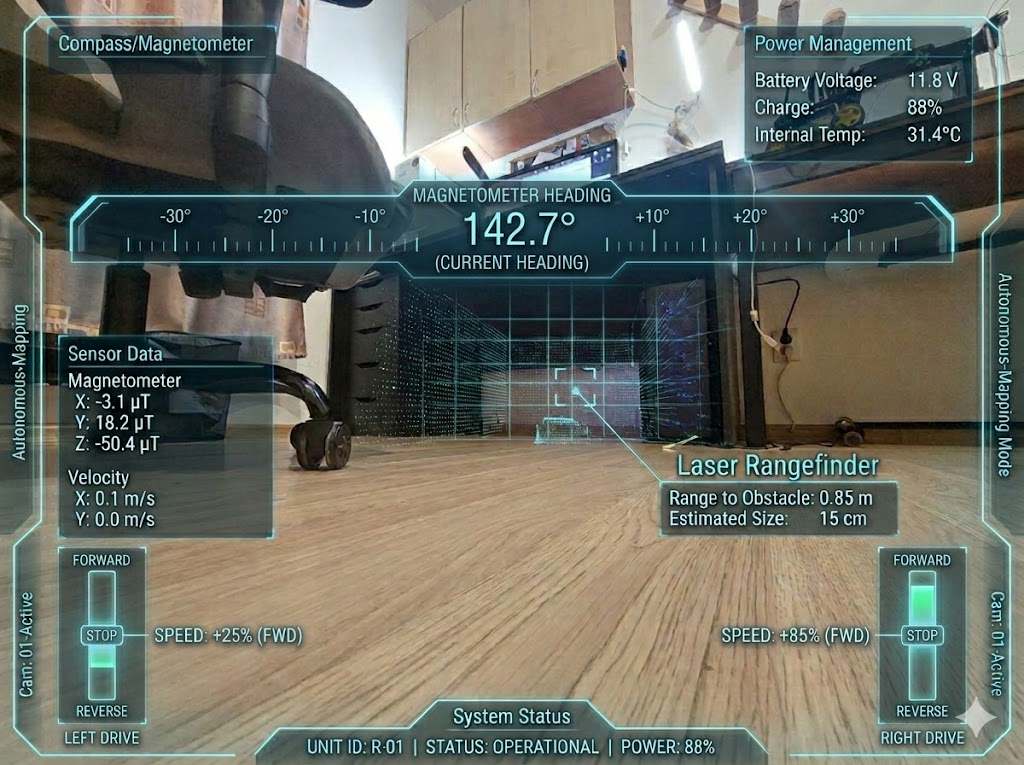
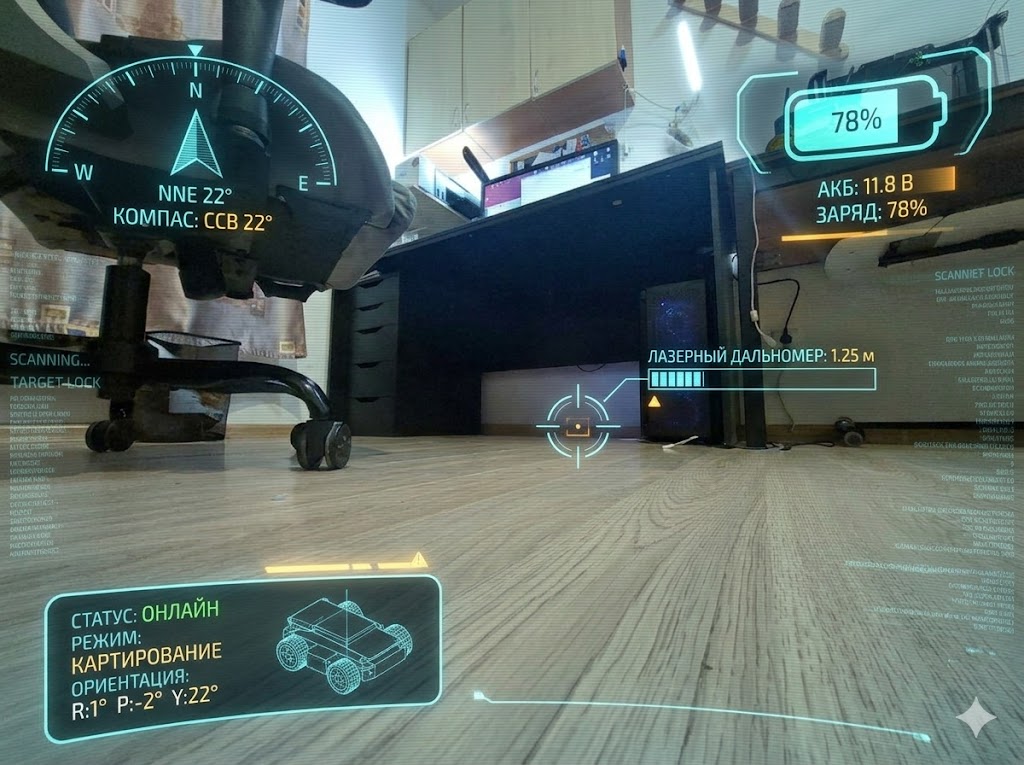
Красиво. Ни одна цифра на этих картинках не настоящая: температура внутри, заряд в процентах, скорость по осям, “оценка размера препятствия” – ничего этого у робота нет и не было. Но набор элементов оттуда я взял почти целиком: шкала курса, прицел дальномера, индикаторы левого и правого привода, блок с телеметрией.
Первая версия
Первая версия виджетов была написана на той же фотографии, до того как появилась камера на тележке. Цвет выбрал не как у ChatGPT, а фосфорный зелёный – как у старых осциллографов.
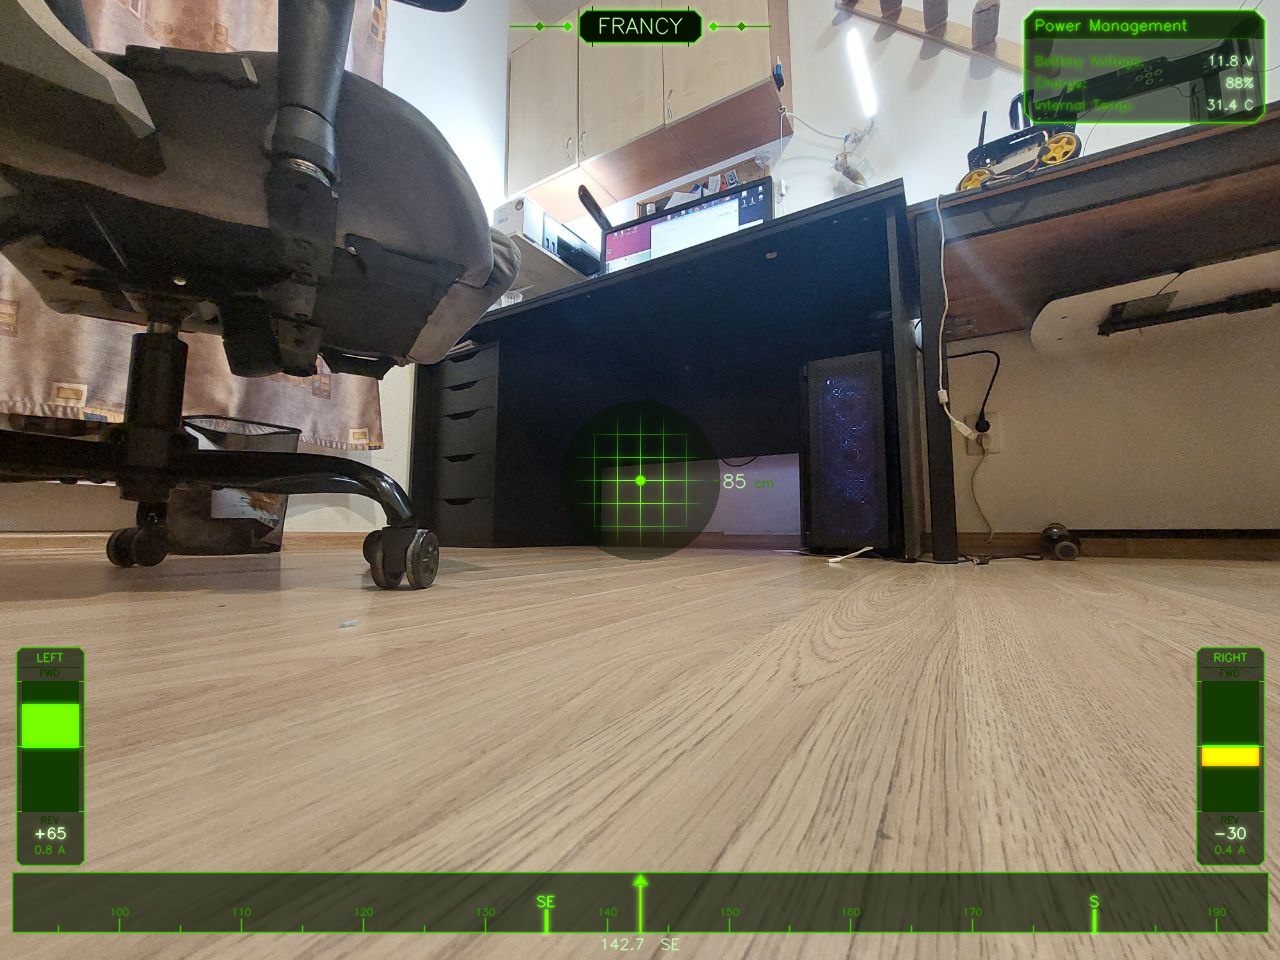
Через полтора месяца, когда робот поехал, большая часть виджетов перешла в проект почти без изменений. Но не вся. Шкала курса внизу экрана работала от компаса, и вместе с компасом умерла. Курс сейчас – это строчка в блоке телеметрии, накопленный угол гироскопа.
Вот что получилось в итоге:
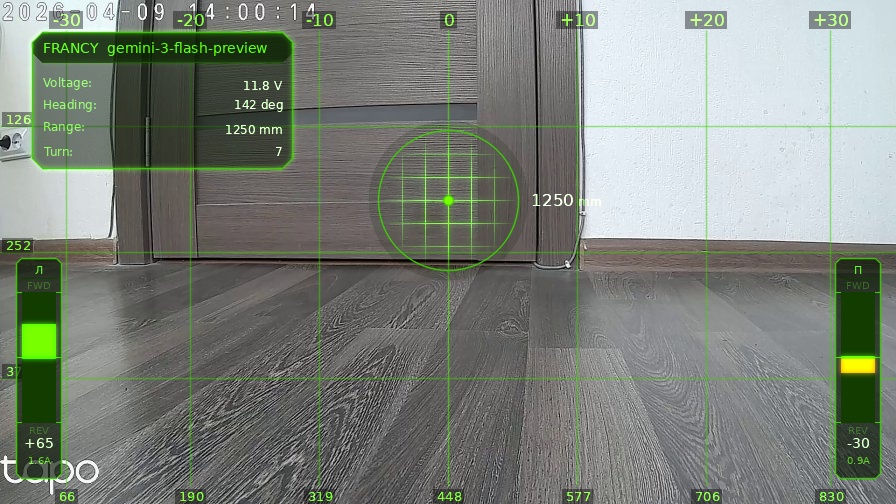
-
Блок телеметрии слева вверху: имя робота и модель, напряжение, курс, дальномер, номер хода, токены.
-
Прицел дальномера в центре: круг туда, куда смотрит лазер, и расстояние рядом. Про то, как считается его место на кадре, – в следующем разделе.
-
Индикаторы привода по краям: скорость левого и правого мотора, вперёд – зелёный, назад – жёлтый, и ток под ними.
-
Угловая линейка и сетка: вертикальные линии через каждые 10° и пиксельные координаты по краям.
-
Индикатор подсветки: горят ли красный и синий светодиоды.
Два зрителя
У HUD два зрителя, и видят они разное.
Первый зритель – я. Во время заезда на экране хоста открыто окно с живым видео и полной приборной панелью. То же самое потом накладывается на смонтированное видео – по телеметрии из лога, кадр за кадром.
Второй зритель – модель. И ей рисуется далеко не всё. Модель получает кадр только с угловой линейкой, сеткой и прицелом дальномера. Индикаторы моторов ей ни к чему: робот стоит, когда она смотрит. Напряжение и номер хода она получает текстом. Каждый элемент на её кадре – это инструмент, а не украшение.
Угловая линейка появилась из вопроса: как модель поймёт, на сколько повернуть к предмету? Она видит тапок справа от центра – это 15 градусов или 30? Линии через каждые 10° с подписями превращают задачу в чтение по шкале: тапок у линии +20, значит turn_relative(20). Линии откалиброваны под реальный угол обзора камеры, 75.2°.
Пиксельная сетка – для зума. Модели нужно назвать координаты точки, которую она хочет рассмотреть. Подписи по нижнему и левому краю позволяют прочитать их прямо с кадра.
Прицел дальномера – чтобы модель понимала, до чего именно меряется расстояние. “Дальномер 870 мм” – это до стены или до стула перед ней? Круг на кадре отвечает на этот вопрос.
Как нарисовано
Всё на Python: OpenCV для линий и прямоугольников, Pillow для текста. Pillow понадобился из-за кириллицы: cv2.putText русских букв не знает, поэтому текст рисуется через Pillow шрифтом DejaVu Sans.
Свечение – главное, что делает интерфейс “фантастическим”. Делается просто: виджет рисуется на отдельном слое, слой размывается гауссовым фильтром и накладывается поверх с пониженной прозрачностью. Линии получают мягкий ореол, как у люминофора на старом экране.
Размытие дорогое. На живом окне это незаметно, а при монтаже, когда HUD накладывается на каждый кадр получасового видео – очень заметно. Первое ускорение: размывать не весь кадр, а только прямоугольник вокруг виджета. Стало примерно втрое быстрее. Второе: черновой режим монтажа вообще без свечения, свечение только в финальном рендере.
Третья вещь. Сначала HUD рисовался в трёх местах – в ручном режиме, в режиме ИИ и при монтаже, – и в каждом немного по-своему. Прицел в одном месте стоял выше, в другом ниже. В конце всё свелось в одну функцию draw_hud(), которая получает голые значения телеметрии и не знает, откуда они взялись: с живого UART или из лога месячной давности.
Что в итоге
Интерфейс, придуманный ChatGPT по фотографии с пола, превратился в два HUD. Один – для людей: красивый, со свечением, со всеми цифрами. Другой – для модели: линейка, сетка и прицел, ничего лишнего. Первый делает видео зрелищным. Второй – помогает модели понять, куда поворачивать и что рассматривать.
15. Камера, дальномер и круг с прицелом
В разделе про приборную панель я обещал рассказать, как считается место прицела дальномера на кадре. Задача звучит просто: нарисовать круг там, куда светит лазер. На деле это маленькая задача из геометрии камеры, и решить её пришлось из-за шкафа (в смысле по причине шкафа, а не решать задачу сидя за шкафом).
Зачем вообще прицел
Модель получает строчку “дальномер 870 мм” и кадр. Вопрос: 870 мм – это до чего? До стены? До стула перед стеной? До ножки стола? Без прицела модель додумывает сама, и додумывает часто неправильно.
Самый наглядный пример – история со шкафом из раздела 6. Лидар стоял ниже камеры, луч проходил под кухонными шкафами и мерил расстояние до стены за ними. Grok видел на кадре шкаф, видел в телеметрии, что впереди свободно, – и уверенно ехал под шкаф. Если бы на кадре был круг, верно показывающий, куда светит лазер, модель увидела бы: круг – под шкафом, в щели. Расстояние – до чего-то там, в темноте, а не до дверцы.
Лидар я переставил выше. Но заодно захотелось, чтобы прицел стоял на кадре там, где надо, а не там, где я его нарисовал на глаз.
Первая версия: на глаз
Первый прицел стоял по константе: центр по горизонтали, cy = 400 пикселей по вертикали. Подобрал, посмотрев на пару кадров. Потом кадр поменял размер – для модели 896 пикселей, для экрана 1920 – и константа перестала подходить. Появилась вторая, cy = 200. Потом я переставил лидар, и обе стали неправильными.
Хуже того: правильного cy не существует. Место лазерной точки на кадре зависит от расстояния.
Параллакс
Камера и лидар стоят в разных местах. Лидар немного ниже камеры, и камера смотрит чуть вниз. Их лучи не совпадают.
Представьте, что вы смотрите одним глазом, а фонарик держите у подбородка и светите горизонтально. Стена далеко – пятно почти там, куда вы смотрите. Стена у самого носа – пятно заметно ниже.
То же и у робота. Чтобы понять, где на кадре лазерная точка, нужно знать, как камера превращает точку в комнате в пиксель на кадре.
Камера-обскура
Простейшая модель камеры – камера-обскура, по-английски pinhole: ящик с дырочкой, через которую свет падает на заднюю стенку. Точка в пространстве проецируется на кадр по одной формуле:
y_пикс = f · Y / Z
Где Z – расстояние вперёд от камеры, Y – смещение вверх-вниз, а f – фокусное расстояние в пикселях. Чем дальше точка, тем ближе её проекция к центру кадра: далёкое сжимается.
Статья про модель камеры-обскура: Модель камеры [43]
Фокусное расстояние в пикселях считается из угла обзора. Половина ширины кадра видна под половиной угла обзора:
f = (W / 2) / tan(FOV / 2) = 448 / tan(37.6°) ≈ 582 пикселя
Для кадра шириной 896 пикселей и угла обзора 75.2°.
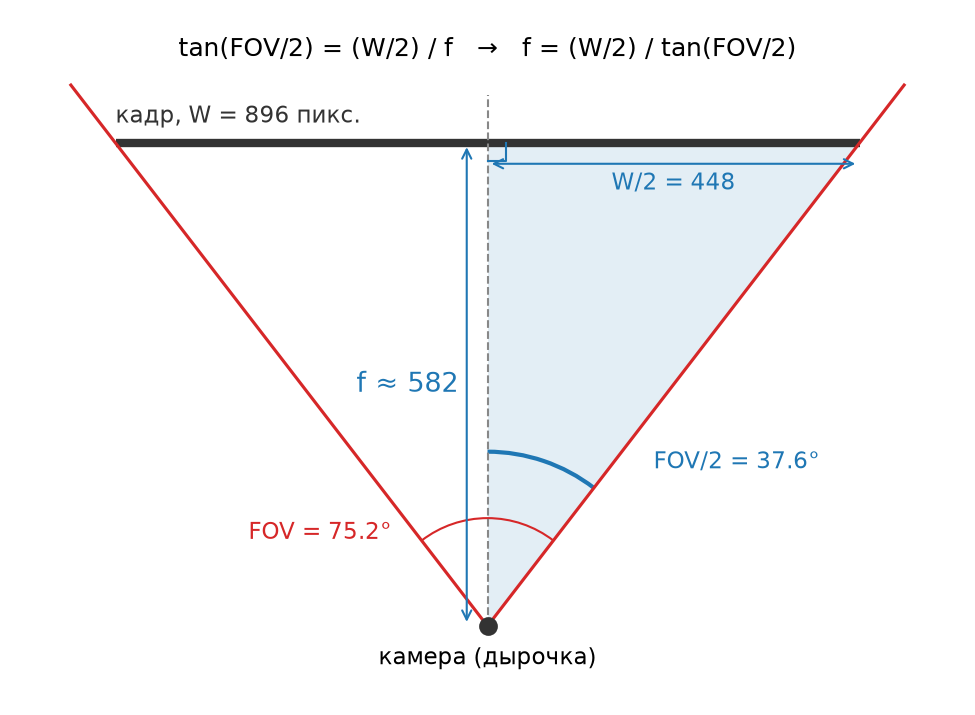
Наклон камеры
Вторая поправка – камера смотрит не строго горизонтально, а чуть вниз. Горизонтальный луч лазера для наклонённой камеры идёт чуть вверх, и точку нужно повернуть в систему координат камеры:
z_cam = dh * sin(alpha) + d * cos(alpha)       # вперёд, вдоль оси камеры
y_cam = -dh * cos(alpha) + d * sin(alpha)      # вверх, поперёк оси камеры
cy = H/2 - f * y_cam / z_cam
Здесь d – показание дальномера, dh – насколько лидар ниже камеры (после переноса – 20 мм, измерено линейкой), alpha – наклон камеры.
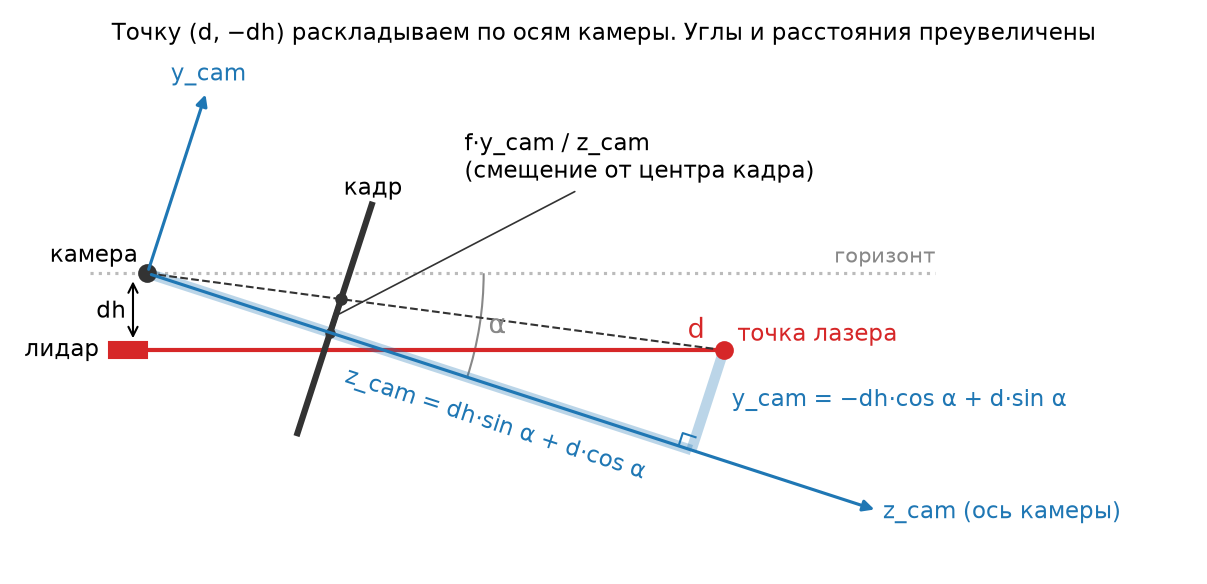
Наибольшая сложность была с углом наклона, но я его честно подобрал на глаз, глядя на монитор и двигая тележку ближе-дальше, так, чтоб прицел был на одном уровне.
Размер круга
Место круга мы посчитали. А какого он размера?
Я решил что у меня размер прицела должен быть примерно как яблоко по размеру. Я не знаю почему так, но пусть будет: круг радиусом 7.5 см. Сколько пикселей она займёт на кадре, зависит от расстояния:
r = f · atan(R / d)
На метре – 44 пикселя, на 30 см – 143, на 4 метрах – 11. Круг ведёт себя как настоящий предмет: вблизи большой, вдали маленький. Модель видит не просто “здесь”, а “примерно вот такой кусок мира”.
Разные размеры кадра
Модель получает кадр 896 пикселей, экран и смонтированное видео – 1920. Всё посчитано для 896, а для другой ширины фокусное расстояние просто масштабируется. Прицел стоит в одном и том же месте картинки и у модели, и на видео.
Что в итоге
Прицел – больше не константа, подобранная на глаз, а проекция: четыре измеренных параметра (угол обзора, смещение лидара, размер мишени, наклон камеры (ладно, не измерено, а подобрано)) и формула камеры-обскуры. Лидар переставил – поменял одно число в конфиге, прицел встал на место.
Вся эта математика калибровалась и проверялась на хайтек-устройстве: коробке с нарисованной линией ровно на уровне лидара. Прицел лидара должен был всегда лежать на этой линии, независимо от расстояния до коробки.
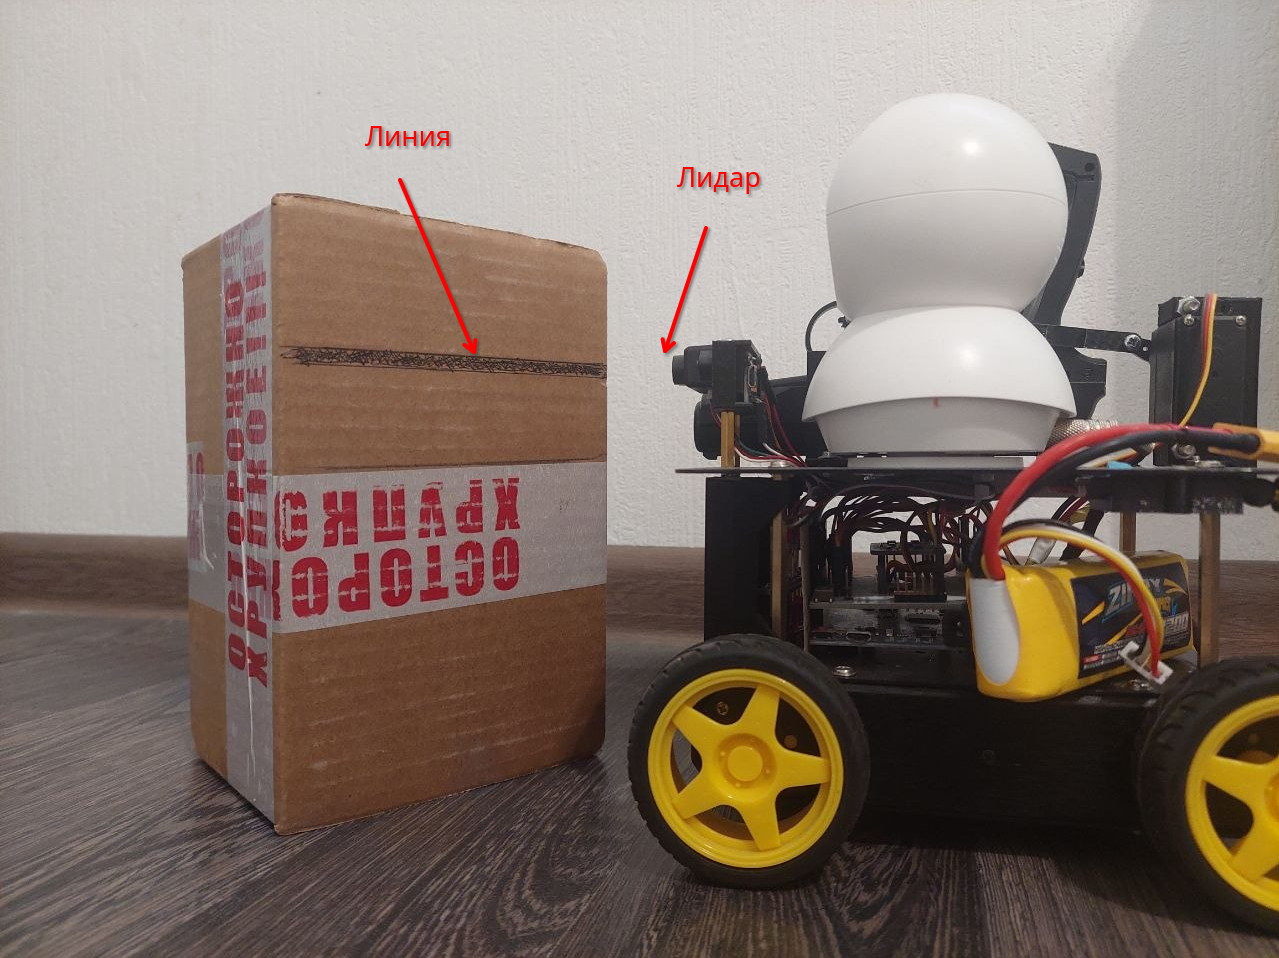
16. Запись и синхронизация
После сессии у меня два набора данных. С одной стороны – лог: события с метками времени, телеметрия десять раз в секунду, фразы робота. С другой – видео с камеры, которое ffmpeg писал параллельно. Чтобы наложить на видео приборную панель, вставить речь и вырезать паузы, нужно знать, какой момент видео соответствует какой строчке лога.
И вот тут выясняется, что у них разные часы.
Два времени
Время лога – это часы хоста. Каждое событие помечено меткой: столько-то секунд с 1970 года.
Время видео – секунды от начала файла. Когда именно начался файл по часам хоста, неизвестно. ffmpeg запустился, подключился к камере, дождался первого ключевого кадра, начал писать – всё это занимает непредсказуемое время. А сама камера, как мы помним, отдаёт картинку с опозданием на секунду-две.
Нужна точка, которая есть в обоих временах. Событие, момент которого известен и по часам хоста, и на видео.
Хлопушка
В кино для этого есть хлопушка. Щелчок слышен в звуке и виден в кадре – по нему совмещают звук и изображение, записанные разными устройствами.
У робота роль хлопушки играет писк. В начале сессии хост командует ардуине пискнуть и записывает в лог время команды:
{"ts": 1778681982.39, "type": "sync_beep", "ts_wall": 1778681982.39}
Писк слышит микрофон камеры, и он попадает в звуковую дорожку видео. При монтаже программа ищет его в звуке: берёт первые 15 секунд, считает громкость окнами по 50 мс и находит первый резкий скачок. Это момент писка в видео.
Теперь любое событие лога переводится во время видео одной формулой:
t_видео = (ts_события − ts_писка) + t_писка_в_видео
Хорошее свойство этой схемы: задержка камеры в ней уже учтена. Писк проходит через тот же путь, что и картинка: микрофон камеры, буфер камеры, RTSP, ffmpeg. На сколько камера опаздывает, на столько же опоздает и писк в записи – и формула это автоматически съест.
Пищалка
Для писка на ардуину поставил активный пьезо-излучатель на пин 8 и добавил в протокол команду:
P<000-999>n # пискнуть, длительность в мс
Также выяснилось, что писк надо ещё правильно подгадать по времени. Первый раз он прозвучал, пока камера ещё не открыла поток, – и в записи его просто не было. Теперь хост сначала ждёт первый кадр от камеры, потом ещё секунду, чтобы ffmpeg точно писал, и только потом пищит.
Запись до конца
С концом записи похожая история. Задача выполнена, робот сказал итоговую фразу, хост останавливает ffmpeg – и последней фразы в видео нет. Камера буферизует секунду-две, и хвост записи ещё не успел дойти до ffmpeg. Лечение простое: после конца сессии подождать три секунды и только потом останавливать запись.
Некорректная частота кадров
Самая неприятная история случилась уже при монтаже. Видео после наложения HUD оказывалось короче оригинала, и к концу сессии звук обгонял картинку почти на минуту.
Причина – в заголовках видео. Камера Tapo заявляет частоту 24.75 кадра в секунду. На деле она отдаёт около 15. Плеер этого не замечает: он показывает кадры по их меткам времени. А программа наложения HUD брала заявленную частоту, читала кадры по одному и расставляла им время заново: кадр номер N – это N / 24.75 секунды. Получалось в 1.65 раза быстрее, чем на самом деле, и расхождение копилось до минуты.
ffmpeg отдаёт две разные частоты: r_frame_rate – заявленную, и avg_frame_rate – среднюю реальную, посчитанную по длительности и числу кадров. Переход на вторую – и расхождение упало с минуты до десятой доли секунды.
Хвосты по полсекунды
Минуту убрали, но осталось расхождение поменьше, до двух секунд за сессию. Видео при монтаже режется на куски – паузы вырезаются, – и на каждом стыке терялись или добавлялись доли кадра. ffmpeg, когда режет по времени, выравнивается по ключевым кадрам и добавляет лишние кадры в начале куска. По отдельности незаметно, за десятки стыков набегает.
Помогли две вещи. Первая: видео и звук собираются раздельно. Сначала куски видео режутся строго по числу кадров, без звука, потом к ним подмешивается звук точно по длительности. Вторая: вся сборка звука ведётся в сэмплах, а не в секундах. Сэмпл – целое число, в нём нечему накапливаться. Теперь рассинхрон – не больше половины кадра.
Что в итоге
Два времени – часы хоста и время видео – связаны одним писком в начале сессии. Этого хватает, чтобы наложить на видео всё, что есть в логе: телеметрию, речь, приборную панель. Остальное – борьба с мелочами: пищать вовремя, не выключать запись раньше времени, не верить камере на слово и считать звук в сэмплах.
Хлопушке лет сто. Работает и для роботов.
17. Монтаж
В свете новомодного вайбкодинга, это очень интересное место. Делать код для монтажа видео, скажу прямо, это не та задача, которая меня интересовала. Я вряд ли прокачаюсь на ней как специалист, времени займёт много, и проблем с ней будет много, сил потрачу тоже много. Идеальный кандидат для вайбкодинга. Написать скрипт ИИ может, а вот проверить что видео получилось хорошо, сможет ли?
Весь код для монтажа был написан Клодом, и я не очень в курсе как он написан, но процесс отладки и поиска багов, получился весьма забавным.
Сырое видео сессии смотреть невозможно. Половину времени робот просто стоит: модель думает. Пять секунд, десять, иногда полминуты. Потом робот говорит фразу, поворачивается – и снова стоит. Двадцатиминутная сессия – это пять минут действия и пятнадцать минут ожидания.
Монтаж делает из этого видео, которое можно смотреть. И делает его программа, а не я в видеоредакторе: сессий десятки, резать каждую руками – никакого терпения не хватит.
Что делает монтаж
-
Вырезает паузы. Модель думает, робот стоит – этот кусок уходит.
-
Накладывает речь. Фразы робота берутся из сохранённых mp3 и ставятся туда, где в логе стоит
speech_start. -
Накладывает приборную панель. По телеметрии из лога, кадр за кадром.
-
Показывает зум. Когда модель вызывает
zoom, в видео вставляется анимация: кадр увеличивается в ту точку, которую модель рассматривала, и показывает то, что видела модель. -
Показывает текст оператора. Мои сообщения модели и ответы на её вопросы – плашкой поверх видео.
-
Добавляет титры. В начале – дата, модель, задача. В конце – итог.
Первая версия: скрипт
Первая версия монтажа появилась одновременно с записью видео – одним скриптом. Он читал лог, находил писк, рендерил HUD на каждый кадр в Python, резал паузы, подмешивал речь, склеивал со слайдами. Работало. Но каждое новое правило – “не резать тут”, “показать это там” – реализовывалось в код очередным if. Через месяц в этих if стало невозможно разобраться: поправишь зум – ломается оператор.
Уже классика жанра. Что-то навайбкодили, а что и как работает – неясно.
Вторая версия: три слоя
Тут я подошел иначе и описал Клоду какую я хочу видеть архитектуру скрипта: три слоя с разными задачами.
Монтаж был переписан в три слоя, каждый со своей задачей.
Слой 1. Кто что делал. Лог превращается в дорожки состояний, по одной на каждого “актора”: модель (думает / не думает), робот (стоит, едет, поворачивается, рассматривает, стреляет), речь (говорит / молчит), оператор (молчит, спрашивает, ответил). Получаются интервалы: “с 12.3 по 18.7 секунды модель думала, робот стоял”.
Слой 2. Правила. Каждое правило смотрит на состояния и выдаёт операцию монтажа:
модель думает + робот стоит   ->  вырезать
робот рассматривает (zoom)    ->  вставить анимацию зума
робот говорит                 ->  подмешать mp3
оператор ответил              ->  показать плашку
Правила ничего не знают про ffmpeg. Новое правило – одна функция, остальное не трогается. Например, правило, появившееся после экспериментов с пистолетом: паузу сразу после выстрела не вырезать – на видео в это время разлетается зеркало.
Слой 3. Сборка. Операции превращаются в список кусков итогового видео – какой кусок исходника, откуда и докуда, где вставка, где звук, – и ffmpeg это собирает.
У каждого куска два времени: время в исходном видео и время в итоговом. После вырезания пауз они расходятся: пятая минута исходника может оказаться второй минутой результата. Эти два времени и стали главным источником багов.
Как Клоду найти баг в видео
И тут возникла проблема, которой нет в обычной разработке: баги видны только на видео. Как клод оценит свою работу, если он не умеет смотреть видео?
Смотрю результат – на границе зума приборная панель мигает. Должна плавно погаснуть перед анимацией и плавно появиться после, а она на долю секунды вспыхивает. Как объяснить это Клоду? “Где-то в середине видео мигает HUD” – не баг-репорт. Видео Клод посмотреть не может, а если бы и мог, вспышка длиной в пару кадров – это не то, что можно заметить, листая раскадровку.
Решение: дать нам обоим одну и ту же информацию, но в разном виде.
Для меня визуализатор генерирует HTML-страницу – интерактивную диаграмму: по вертикали время, по горизонтали дорожки акторов, цветные полосы состояний, красным – вырезанные куски, зелёным – вставки. Навожу мышь – вижу подробности. Рядом можно открыть видео и смотреть глазами: вот зум, вот вырез, вот здесь мигнуло.
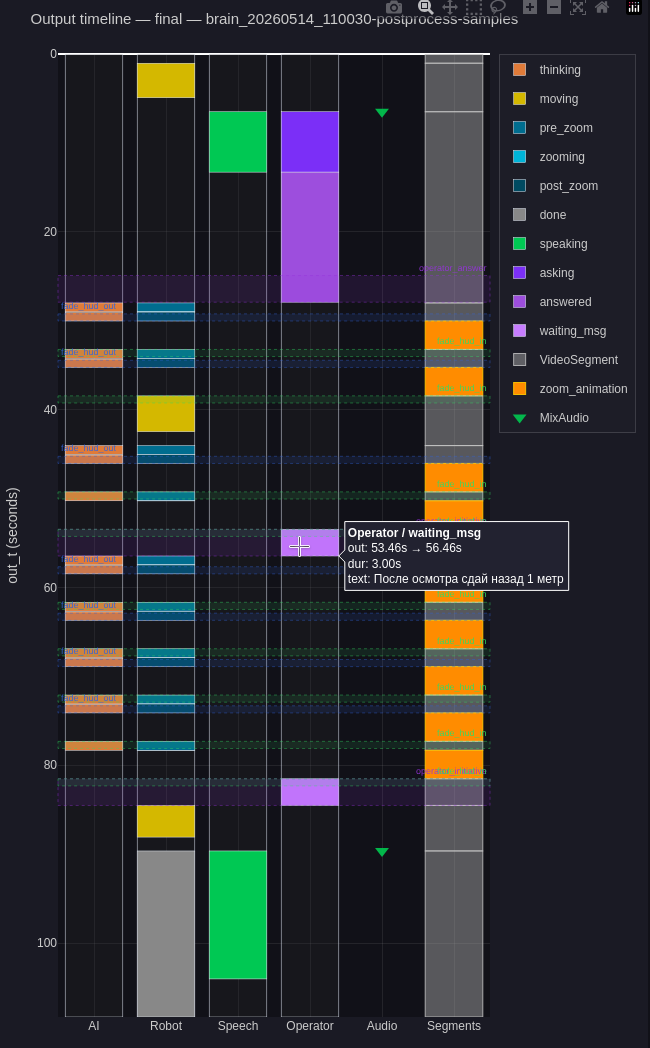
Для Клода тот же визуализатор пишет те же данные в JSON: интервалы, операции, куски итогового видео с обоими временами. Это ему читать удобно, в этом он может искать, считать, сравнивать.
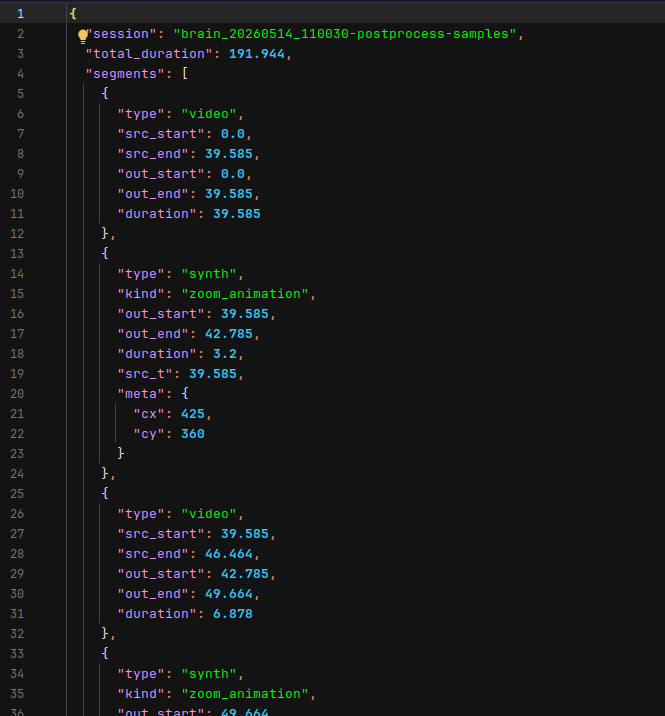
А чтобы связать одно с другим, в отладочном режиме на каждый кадр видео впечатывается оба времени: src=123.456 out=87.210. Я вижу вспышку, ставлю видео на паузу и читаю с кадра время. Говорю Клоду: “на out=87.2 вспышка HUD”. Он открывает JSON, находит это место и видит, что там происходит в данных.
Для HUD появился ещё один отладочный инструмент – дамп прозрачности приборной панели по кадрам вокруг каждого зума. Кривая должна плавно идти 1 -> 0 -> 1. Там, где она прыгает, – баг, и видно это в цифрах, без всякого видео.
Что нашлось
Первая вспышка оказалась на стыке кусков. ffmpeg, вырезая кусок из исходника, иногда отдаёт на пару кадров больше, чем просили. Эти лишние кадры выходили за границу куска, где плавное гашение HUD уже не действовало, и получали полную яркость. Два кадра полной яркости посреди затухания – вспышка. Лечение – зажать время каждого кадра в границах его куска.
Вторая вспышка – хитрее. Она появлялась только в одной сессии, где после зума я писал модели сообщение. Между концом зума и началом следующей вырезанной паузы оставался зазор, в котором HUD успевал загореться, а потом снова погаснуть. Функция, которая искала “ближайший вырез после момента t”, не учитывала три частных случая, и один из них – два сообщения оператора в одной сессии. Без JSON это место не нашлось бы: на глаз там видно только “иногда мигает”.
После этих историй появился интеграционный тест на реальной сессии: весь монтаж прогоняется на настоящем логе на 26 ходов, с зумами и оператором, – 43 теста на реальных данных. Каждая пойманная вспышка стала тестом.
Что в итоге
Монтаж – это программа, которая читает лог и делает из двадцати минут стояния пятиминутное видео с речью, приборами, зумами и титрами. Три слоя: кто что делал, какие правила из этого следуют, как это собрать.
А главный урок – про отладку вдвоём с ИИ. Если баг виден только глазами, а исправлять его будет модель, которая видео не смотрит, нужно дать ей те же данные в её формате – и общий язык, чтобы ткнуть пальцем в нужное место. У нас таким языком стали два времени, впечатанные в кадр.
Заключение
Хотите pet-проект с ИИ и есть свободное время – делайте робота. Оглядываясь назад можно подытожить, что пришлось узнать или освежить в памяти:
-
Электроника. Паяльник, провода, питание, H-мост, датчики тока, сервопривод, пьезо-пищалка
-
Микроконтроллеры. C++ без ОС, конфликты таймеров, прерывания, холодный старт датчиков
-
Протоколы. Свой текстовый протокол поверх UART, I2C master/slave, отладка двух плат по отдельности и совместно
-
Датчики. Магнитометр, гироскоп, ИК/УЗ/лазерный дальномер
-
Математика. МНК и линейная регрессия, круговая арифметика, проекция камеры-обскуры
-
Теория управления. ПИД, трение покоя, инерция
-
Фильтры. Медианный, комплементарный, альфа-бета – и понимание, где начинается Калман
-
Зрение и графика. OpenCV, numpy
-
Видео и звук. RTSP, ffmpeg, синхронизация по хлопушке
-
Python. Фоновые потоки, блокировки
-
LLM. Инструменты и структурированный ответ, агентный цикл, контекстное окно, токены и деньги, разница между API четырёх провайдеров, LLMOps
-
Инженерная культура. В программировании: лог как протокол эксперимента, слоистая архитектура, тесты на реальных данных, отладка вдвоём с ИИ и в железе: ровная укладка проводов, надёжная механика.
Не скажу, что я глубокий специалист в этих областях, скорее наоборот, мои знания весьма поверхностны, однако проект заставил меня погрузиться в каждую область той мере, чтоб робот заработал. Приёмка работы была выполнена не мной, не кем-то, а реальным миром: робот выполнил задачу, а я получил видео для статьи.
Цена: в бортовом журнале только на хостовую часть набралось больше двухсот часов, и это то, что я записывал. Если времени нет – лучше не начинать. Если есть – это самое весёлое, что можно делать по вечерам.
Про детей
Отдельно скажу про тех, у кого дети ходят в кружок робототехники, как у меня.
Там собирают ровно это: моторы, датчики, микроконтроллер. Но если есть желание идти дальше, делать круче чем в кружке, то сделав подобный проект у вас будет вагон опыта, который можно использовать для обучения [44] ребенка и создания своих более крутых проектов. Мой отпрыск тоже собирает робота и я теперь могу ему многое рассказать и показать.
Борис Михайленко, LLM инженер в поисках работы [45]
Исходники на GitHub [46]
Автор: stg34
Источник [47]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37558
URLs in this post:
[1] 0. Пара слов в своё оправдание: #A0
[2] 1. Принципиальная осуществимость. Langfuse: #A1
[3] 2. Взаимодействие хост-ардуино: #A2
[4] 3. Моторы: #A3
[5] 4. Датчики: #A4
[6] 5. Датчики. Магнитометр, гироскоп и комплементарный фильтр: #A5
[7] 6. Датчики. Дальномер – обнаружение препятствий: #A6
[8] 7. Движение. ПИД-регулятор и альфа-бета фильтр: #A7
[9] 8. Камера: #A8
[10] 9. Агентный цикл: #A9
[11] 10. Инструменты робота: #A10
[12] 11. Четыре провайдера LLM: #A11
[13] 12. Запись сессии: #A12
[14] 13. Голос: #A13
[15] 14. Приборная панель: #A14
[16] 15. Камера, дальномер и круг с прицелом: #A15
[17] 16. Запись и синхронизация: #A16
[18] 17. Монтаж: #A17
[19] Заключение: #end
[20] Я выпустил нейросеть в реальный мир — и стало не смешно: https://habr.com/ru/articles/1042282/
[21] Как сделать робота из того, что нашлось в кладовке. Часть 2: https://habr.com/ru/articles/1044572/
[22] математики: http://www.braintools.ru/article/7620
[23] зрения: http://www.braintools.ru/article/6238
[24] памятью: http://www.braintools.ru/article/4140
[25] опыта: http://www.braintools.ru/article/6952
[26] восприятие: http://www.braintools.ru/article/7534
[27] LLMops дома: быстрое разворачивание и настройка инфраструктуры с помощью Langfuse: https://habr.com/ru/companies/datafeel/articles/931500/
[28] Как я научил AI анализировать AI: observability для LLM-агентов с Langfuse: https://habr.com/ru/articles/987230/
[29] Контроль и порядок. Разворачиваем платформу учёта затравок для БЯМ: https://habr.com/ru/articles/874164/
[30] Использование лидара от робота-пылесоса для системы предотвращения столкновений в автономных роботах: https://habr.com/ru/articles/889524/
[31] ошибка: http://www.braintools.ru/article/4192
[32] Кратко про протоколы взаимодействия в микроконтроллерах: https://habr.com/ru/companies/otus/articles/798571/
[33] Логика: http://www.braintools.ru/article/7640
[34] PID (ПИД) без математики: как просто понять P, I и D: https://habr.com/ru/articles/1000846/
[35] внимание: http://www.braintools.ru/article/7595
[36] Фильтр Калмана: https://habr.com/ru/articles/166693/
[37] мозгу: http://www.braintools.ru/parts-of-the-brain
[38] реагировать: http://www.braintools.ru/article/1549
[39] поведение: http://www.braintools.ru/article/9372
[40] Пример сессии. Расстрел зеркала: https://github.com/stg34/robo-llm/blob/main/article-2026-05/sessions/gun/brain_20260526_110436/report.md
[41] эмоции: http://www.braintools.ru/article/9540
[42] Обзор Open Source моделей для задачи TTS: https://habr.com/ru/companies/raft/articles/991844/
[43] Модель камеры: https://habr.com/ru/articles/709378/
[44] обучения: http://www.braintools.ru/article/5125
[45] Борис Михайленко, LLM инженер в поисках работы: https://career.habr.com/stg34
[46] Исходники на GitHub: https://github.com/stg34/robo-llm/tree/main/src
[47] Источник: https://habr.com/ru/articles/1089244/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1089244
Нажмите здесь для печати.