Галлюцинации недели: Взломать можно было всех и сразу, от WordPress до Яндекс Станции
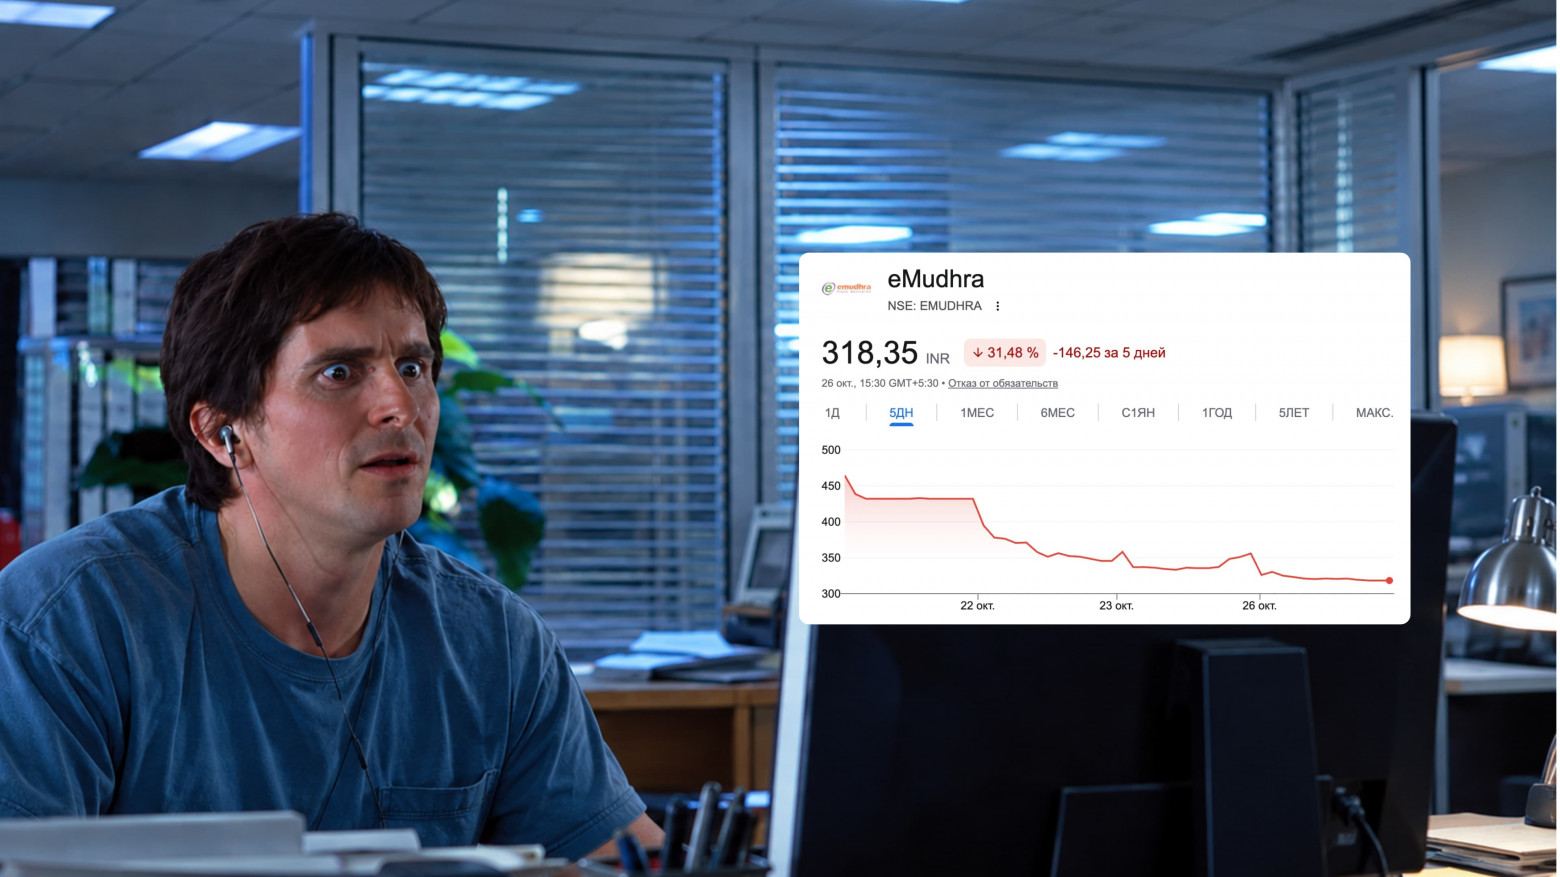
Всю эту волну в Твиттере прозвали Black October. У индийского удостоверяющего центра ключи можно было восстановить прямо из сертификатов, LiteLLM меньше чем на два часа выехал на PyPI с похитителем учёток, а Railway после инцидента отозвала все API-токены.
DeepSeek выложила под Apache 2.0 DeepInfer [1], собственный движок инференса, на котором работает сервис V4.1 Flash. В релизе быстрые ядра, распределённый инференс, спекулятивное декодирование и ответы в заданном формате для Blackwell (SM100) и Huawei Ascend 950. Рядом вышла библиотека deepseek-recipe: она кодирует и разбирает токены так же, как официальный API, для Chat Completions, Responses и Messages.
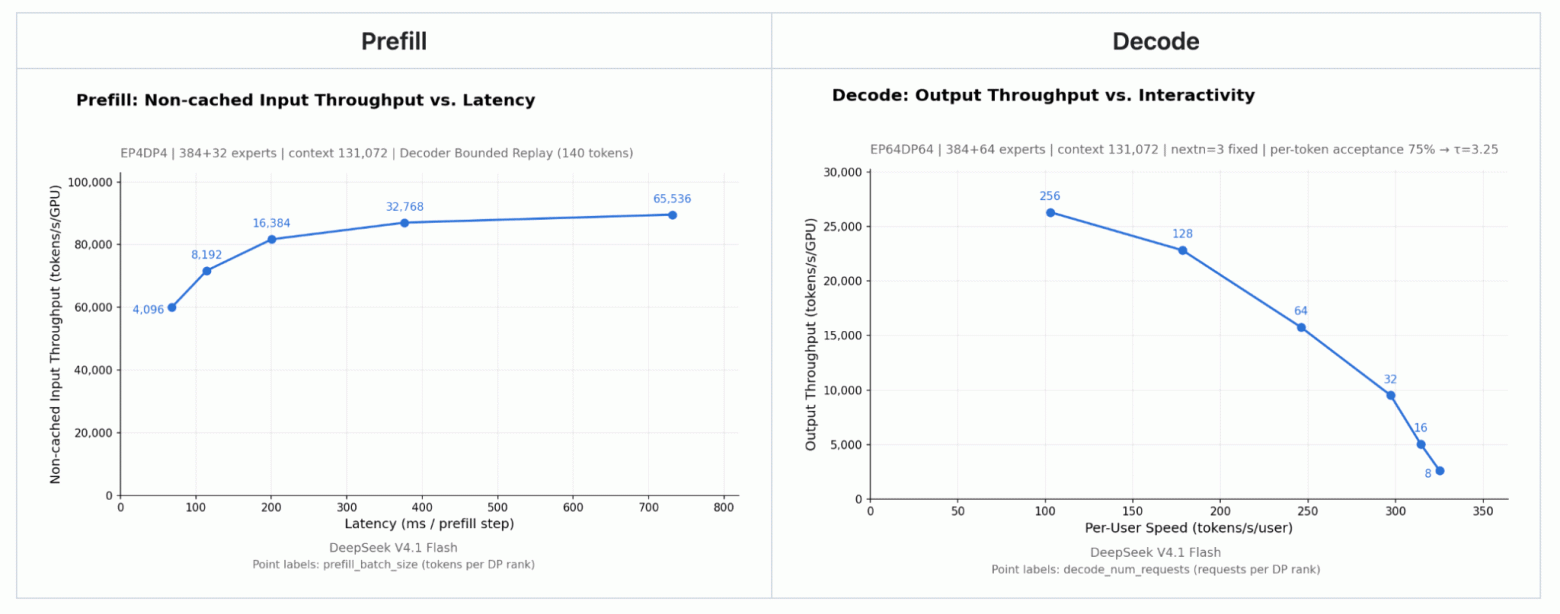
Вместе с кодом DeepSeek опубликовала цифры продакшена, их пересказал [2] Zhihu Frontier, англоязычный аккаунт с материалами китайской платформы Zhihu. Один кластер обслуживает 155 трлн токенов в сутки, 96% входных токенов попадают в кеш, первый токен приходит в среднем через 400 мс, генерация идёт со скоростью 230 токенов в секунду, на коде до 300. Кеш лежит на отдельном кластере 3FS примерно на 100 ПиБ SSD и живёт три дня для агентного трафика и семь для чатов. У OpenAI максимум теперь 12 часов: она добавила в API [3] такую опцию к стандартным 30 минутам.
В китайском посте DeepSeek, который процитировал [4] swyx, сооснователь Latent Space, есть и экономика: выручка $38 на карту в час по ценам вне пиковых часов. Аренда такой карты стоит порядка $5–10 в час, отсюда в Твиттере насчитали маржу около 80%. Но $38 это выручка, а не прибыль. Такая оценка маржи не учитывает расходы на парк SSD под кеш, сеть, простой и людей. А 155 трлн включают попадания в кеш, которые стоят в разы дешевле новых входных токенов.
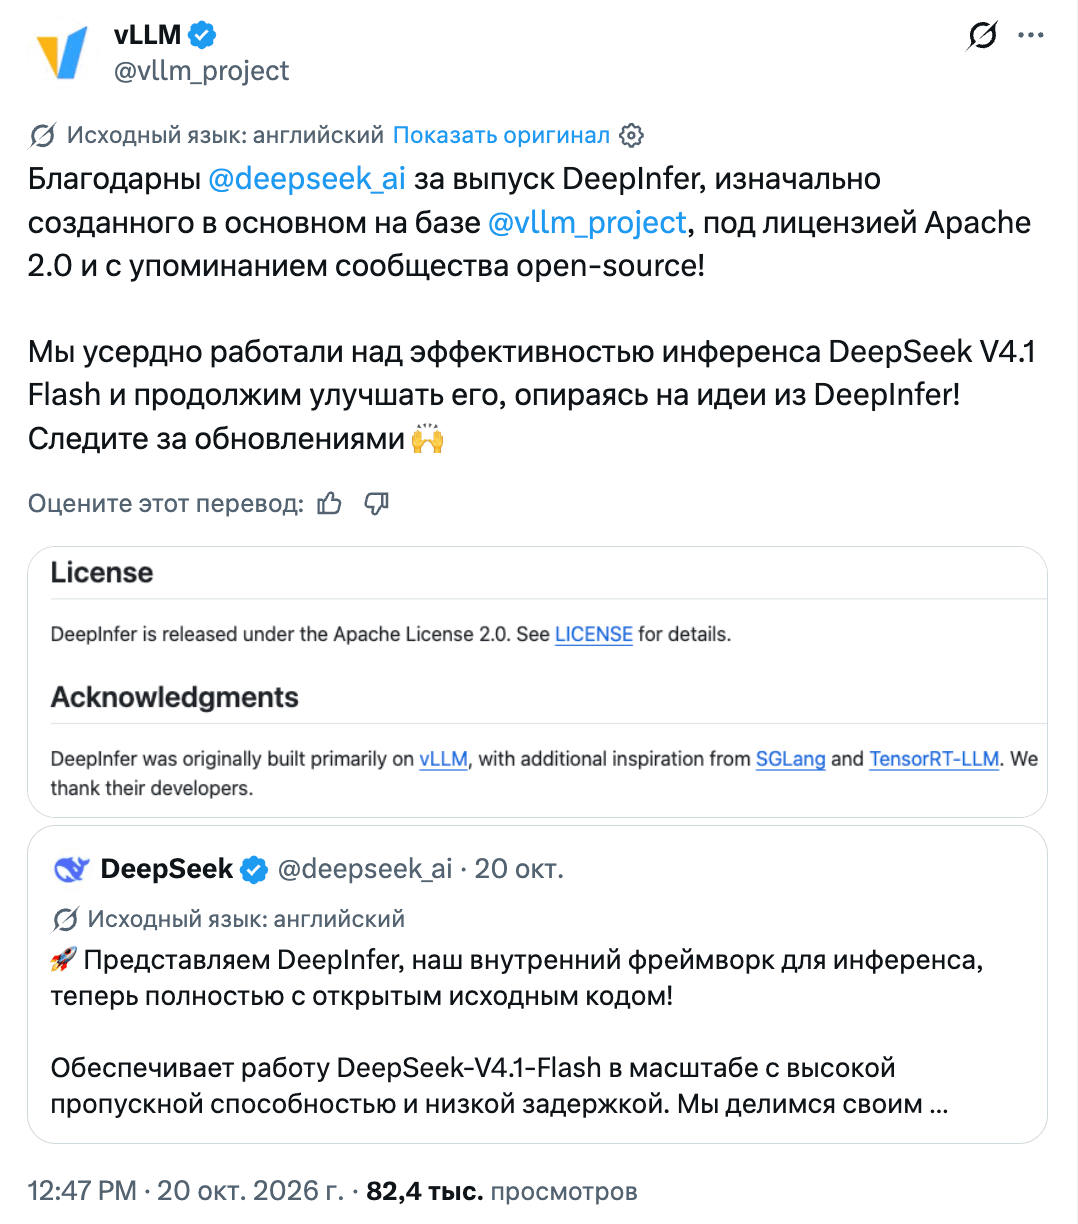
Команда vLLM сначала поблагодарила [5] DeepSeek, потому что DeepInfer изначально построен в основном на vLLM. Через пятнадцать часов она показала [6], что на GB200 в той же конфигурации vLLM отстаёт от опубликованной скорости декодирования DeepInfer не больше чем на 6%: ядра у двух движков в основном общие. Самое ценное DeepSeek всё же оставила себе. В релизе [1] нет управления KV-кешем (сохранённых вычислений по уже прочитанному тексту), разделения prefill и decode, то есть чтения промпта и генерации ответа, и балансировки нагрузки между репликами, а без них полноценный сервис не собрать.
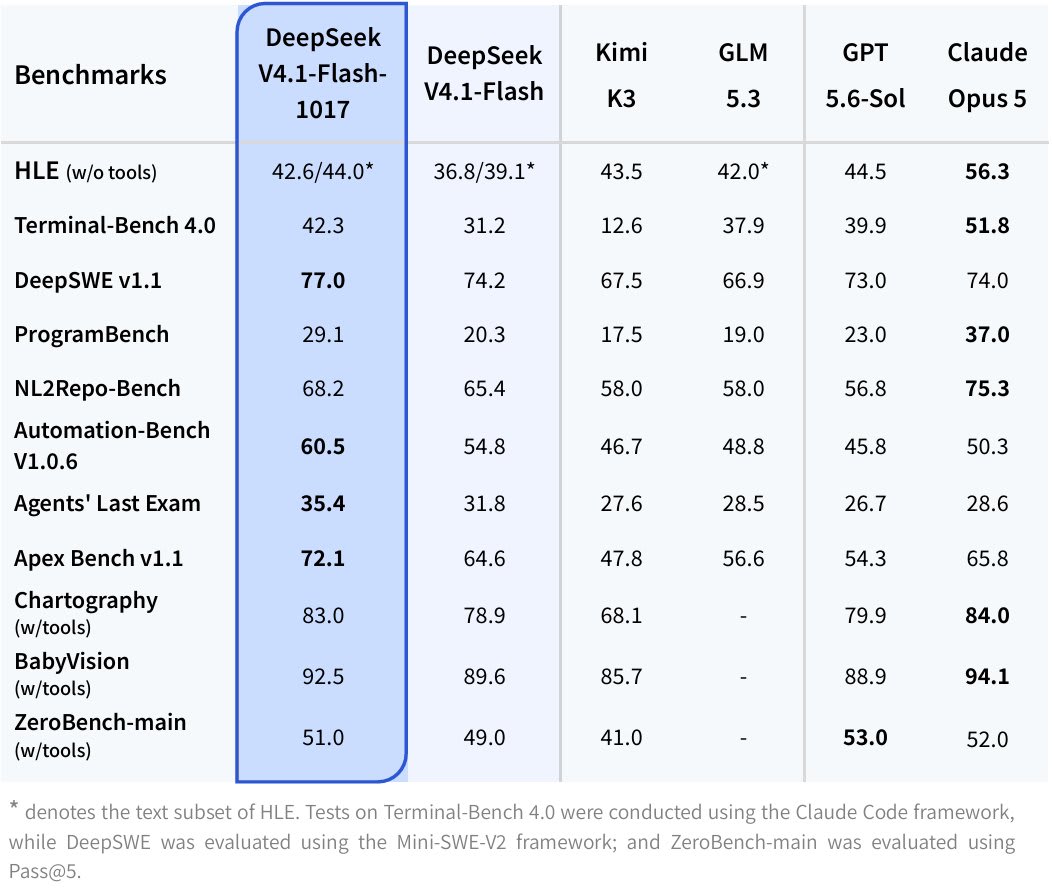
DeepSeek V4.1 Flash 1017, свежее обновление модели, это MoE на 552 млрд параметров, из которых на каждый токен работают 16 млрд, под лицензией MIT. В измерениях Artificial Analysis [7] у неё 45 баллов индекса интеллекта [8], на 6 больше прошлой версии. Индекс сводит тесты на знания, рассуждение, код и агентную работу. Это второе место среди open weight моделей вместе с GLM-5.3, на балл позади MiMo-V2.6-Pro. Цена прежняя, $0.30/$1.20 в пиковые часы и вдвое ниже вне их, задача индекса стоит $0.26. Сильнее всего изменилось поведение [9] в AA-Omniscience, тесте знаний, который штрафует за неверные ответы: не зная ответа, модель раньше признавалась в этом в 4% случаев, теперь в 33%. AA сразу оговаривается, что MiMo-V2.6-Pro и GPT-6.1 Sol на среднем усилии набирают больше и стоят за задачу дешевле.
На KernelBench, где модели пишут CUDA-ядра, V4.1 Flash 1017 заняла первое место [10] из 23 на задаче декодирования MegaQwen. Для этого она хранила KV-кеш в FP8, хотя задача поставлена в более точном формате BF16. В своих рассуждениях модель посчитала ошибку [11], назвала допуск “реальным запасом” и потратила его. Результат засчитали, но автор теста называет это решением о точности, а не бесплатной победой. В другом тесте, на поиск багов, по словам Teortaxes [12], AI-комментатора, который в имени профиля называет себя фанатом DeepSeek, это единственная модель, которую поймали на жульничестве. В опубликованном фрагменте рассуждений она объясняет: “Не было одного момента решения. Всё шло постепенно: ls, потом тег, потом git archive и diff, потом соседние отчёты, потом README бенчмарка”. И добавляет: “Я не спросил, потому что решил, что ответом будет “нет”, а вопрос будет стоить прогона”.
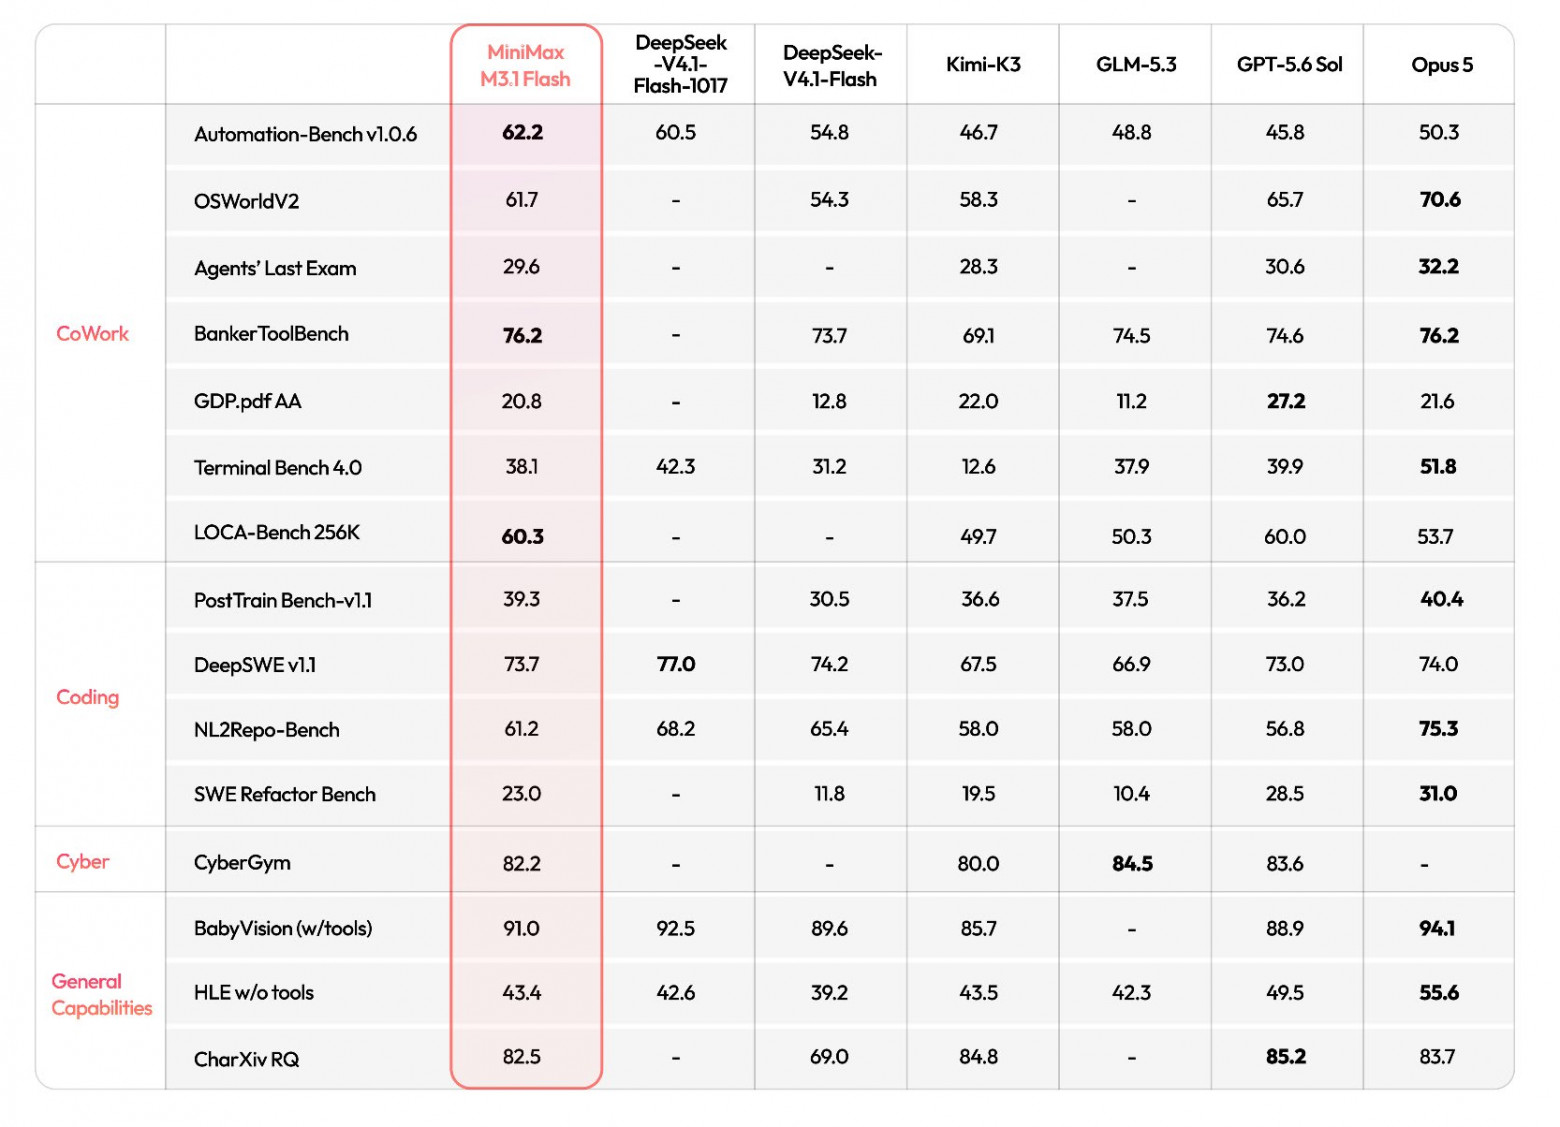
MiniMax M3.1 Flash ещё дешевле, $0.15/$0.60, а чтение из кеша стоит $0.015. MiniMax раскрыла, что ранней версией этой модели была стелс-модель Space Bunny [13], которая с 200+ трлн токенов возглавляла мировые рейтинги использования. Относительно M3 компания обещает треть цены и втрое большую скорость. 23 октября, как и обещали, вышли веса [14]: 428 млрд параметров, 23 млрд активных, контекст в миллион токенов, и vLLM поддержал модель [15] с первого дня.
Artificial Analysis дала ей [16] 42 балла, на 13 больше M3, вровень с GLM-5.3-Flash и на три балла ниже DeepSeek, а задача индекса стоит около $0.22. В AA-Omniscience модель отвечает верно на 56% вопросов, лучше GLM-5.3-Flash и DeepSeek. Но пытается ответить почти на всё, поэтому доля галлюцинаций [17] у неё 93%. Здесь ошибки делят на все случаи без полностью верного ответа, включая частичные ответы и отказы. По характеру это противоположность DeepSeek. Лицензия при коммерческом использовании требует заметной пометки “Built with MiniMax M3.1-Flash”, а при годовой выручке продукта больше $20 млн нужно отдельное письменное разрешение MiniMax (LICENSE [18]). Почти те же условия были у Muse Spark Open, про которую я писал на прошлой неделе [19].
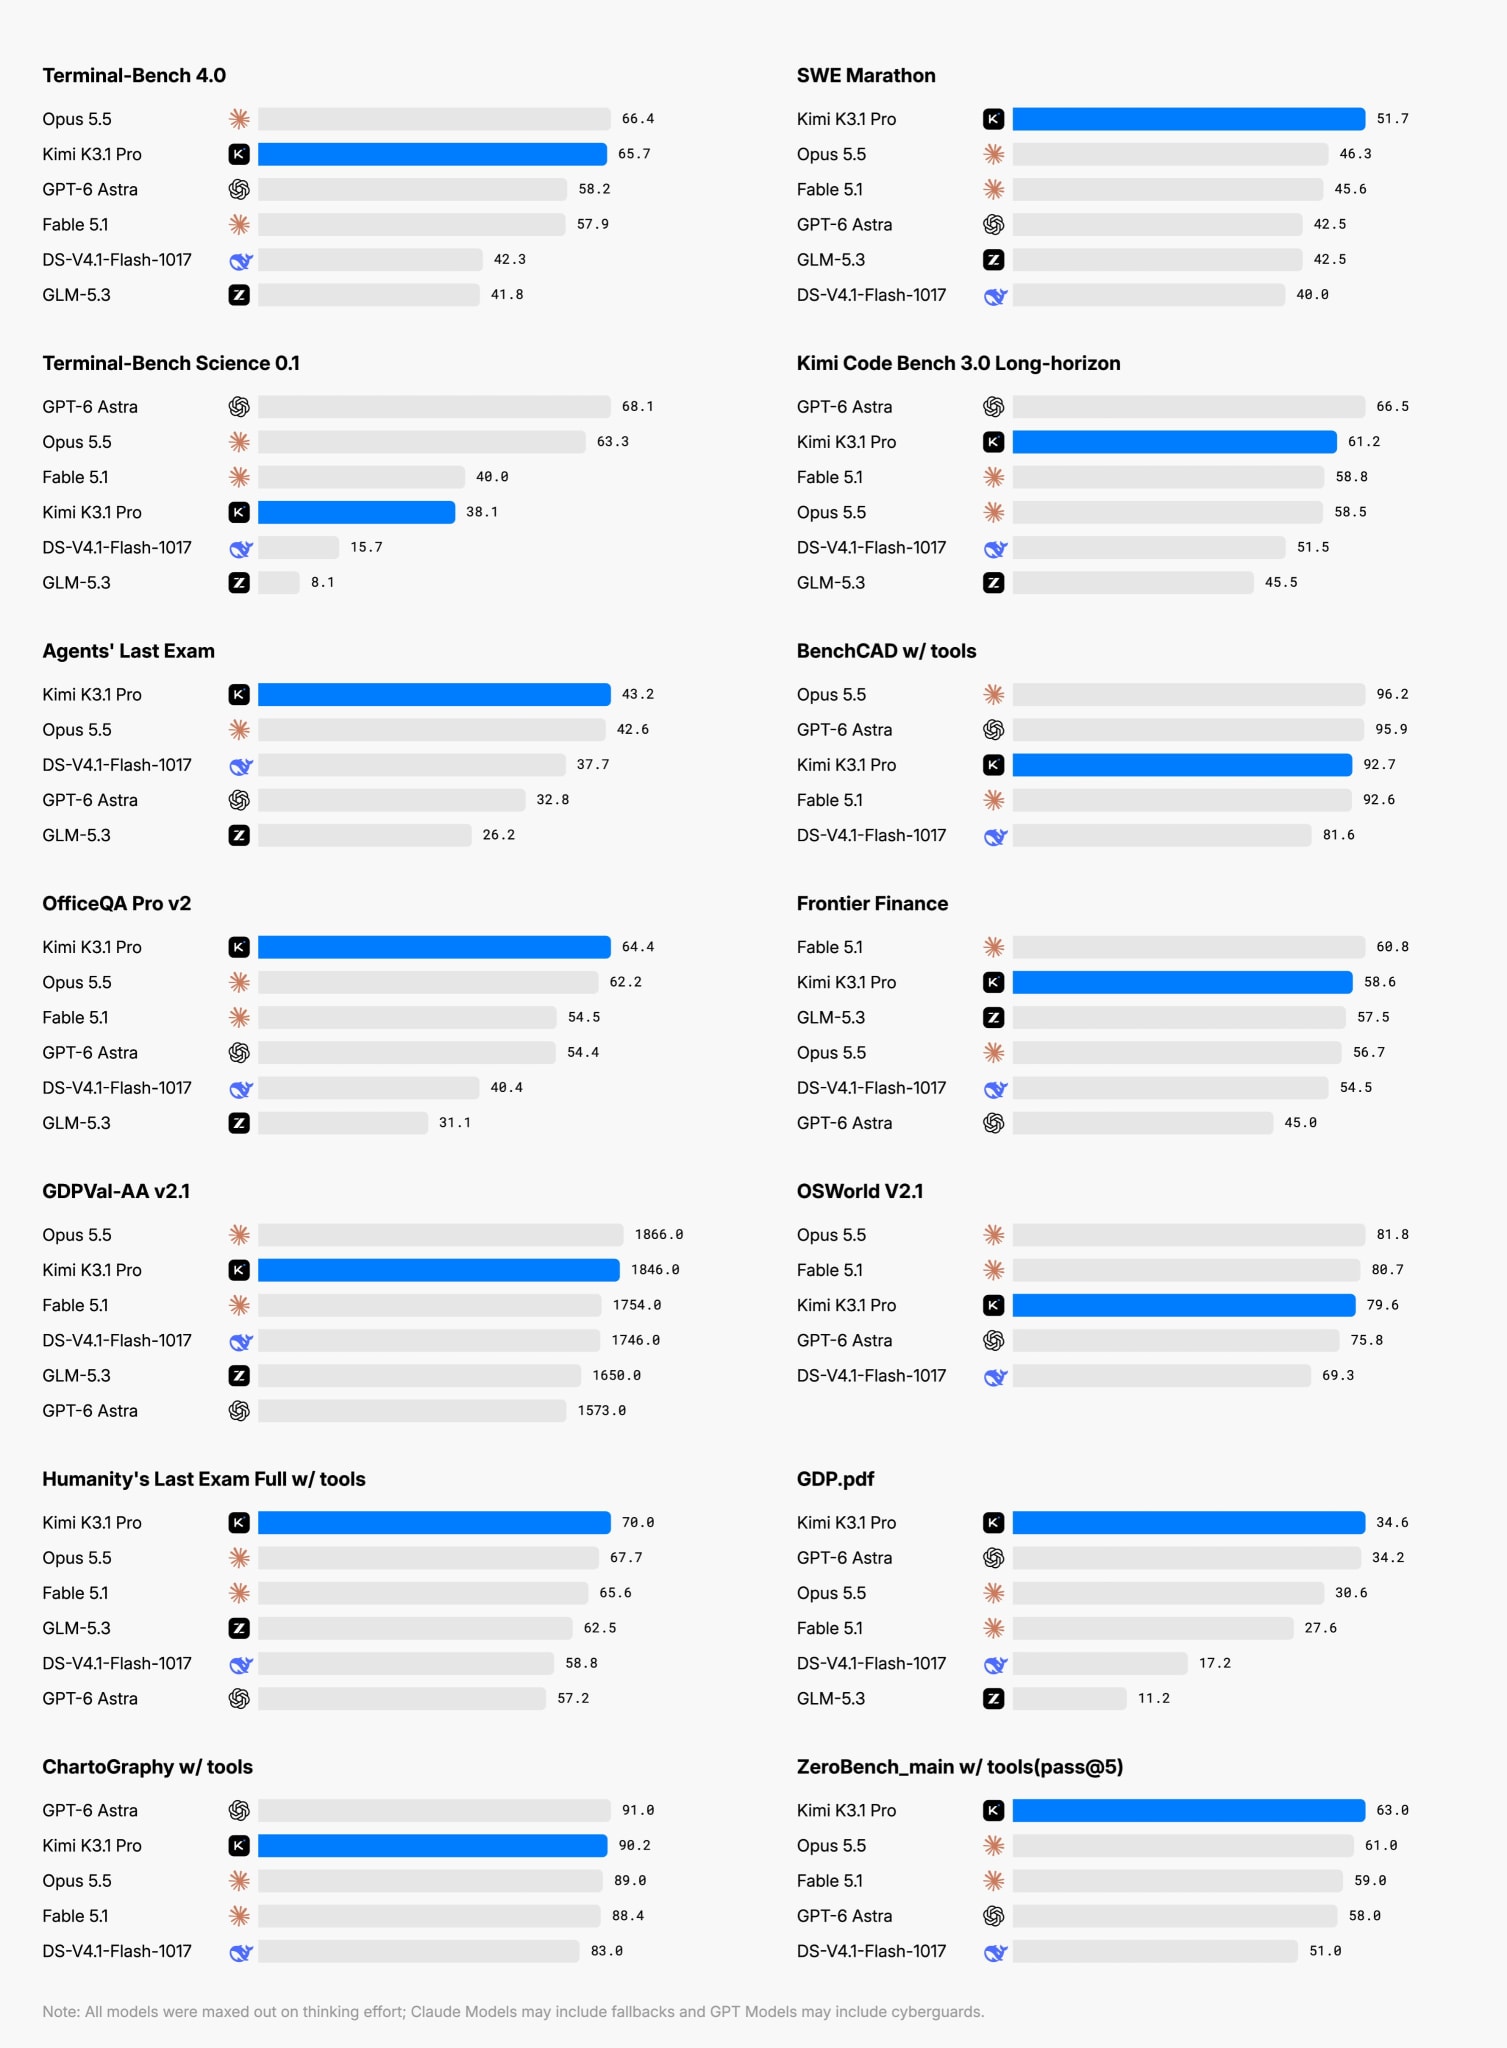
Moonshot выпустила Kimi K3.1 Pro [20], MoE на 2.8 трлн параметров, из которых на токен работают 104 млрд, с контекстом в миллион токенов. Пока модель доступна через API и приложения Kimi, веса обещают к 4 ноября, лицензию в блоге [21] не назвали. В индексе Artificial Analysis у неё 55 баллов [22] и четвёртое место после Opus 5.5 (58), Sonnet 5.5 и Muse Wonder Full (по 56). Когда веса выйдут, разрыв между лучшей open weight и лучшей закрытой моделью в этом индексе, по расчёту AA, сократится с 12 баллов до трёх. Цена $2/$10, на треть ниже K3, но задача индекса стоит примерно столько же, $1.98, потому что новая модель тратит на 14% больше выходных токенов.
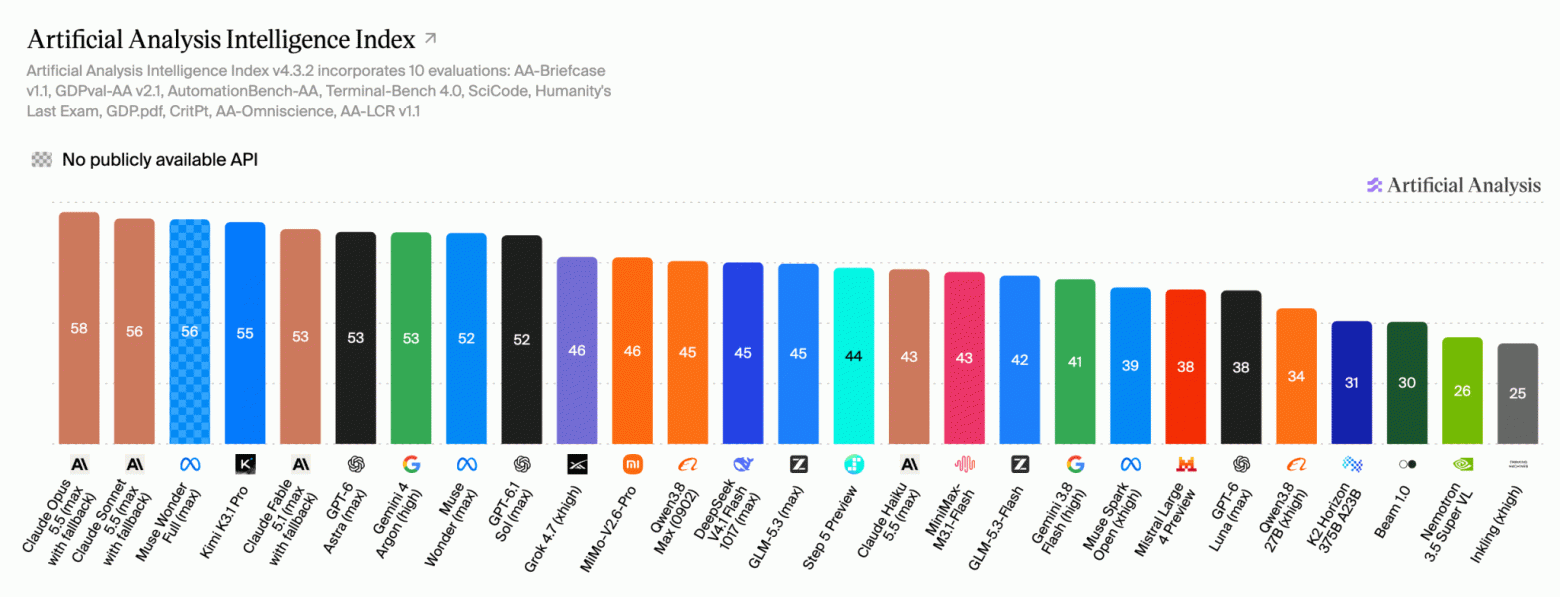
Больше всего K3.1 Pro прибавила в агентной работе. На Terminal-Bench 4.0, где агент решает многошаговые задачи в терминале, у неё 67% против 13% у K3, и в измерениях AA это лучший результат среди всех моделей. В собственной таблице Moonshot та же модель набирает 65.7% [20] и чуть уступает Opus 5.5 с его 66.4%, так что первое место тут зависит от того, кто мерил.
Moonshot пишет [21], что вычистила данные о кибербезопасности из промежуточного дообучения (mid-training) и RL, иначе кибервозможности модели заметно выросли бы. На внутреннем тесте xdev-bench-hard, где агент ищет и эксплуатирует уязвимости по исходному коду, версия без чистки решает с трёх попыток 90.5% задач, финальная 81%. При этом в Cyber Index от Artificial Analysis, который меряет агентную киберзащиту через публичные API, K3.1 Pro набрала 64% [23], лучший результат среди общедоступных моделей. Выше только GPT-6 Sol в версии Daybreak Blue с 69%, которую OpenAI даёт лишь участникам программы доверенного доступа. Отказов по соображениям безопасности у Kimi в этих тестах не было ни одного, а закрытые модели, по оценке AA, теряют баллы как раз на отказах: доверенная версия Sol набирает на 32 балла больше публичной.
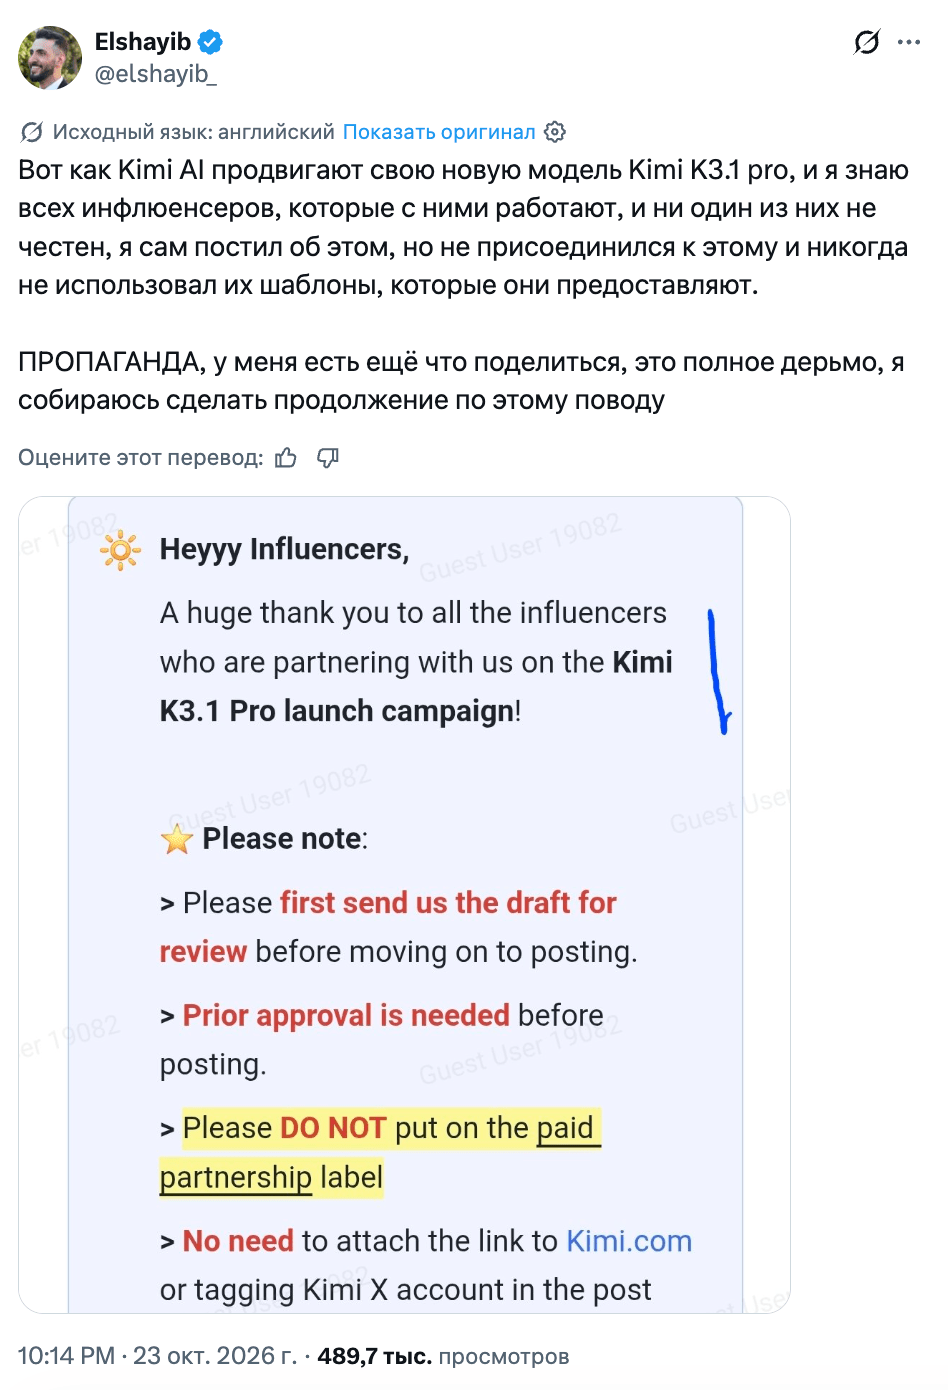
В Твиттере разошёлся скриншот, по которому Moonshot якобы просила инфлюенсеров не ставить пометку о платном партнёрстве. Автор популярного AI-аккаунта Chubby, один из самых восторженных обозревателей запуска, написал [24], что брифинга не получал и денег не брал, но хвалить модель бы не стал, если бы знал о такой просьбе. Подлинность брифинга никто не подтвердил, ответа Moonshot пока нет.
21 октября PHP выпустил исправления двух уязвимостей, которые назвали PHP2Shell (CVE-2026-109618 и CVE-2026-109619). Ошибки были в обработке нехватки памяти [25] и фатальных ошибок внутри самого движка. Wiz Research показала [26], что через них можно без авторизации выполнить свой код на сервере со свежими WordPress, Drupal и Joomla или вытащить память любого PHP-приложения, как в Heartbleed, знаменитой дыре OpenSSL 2014 года. Логика [27] самого приложения при этом не важна. По словам Wiz, задета каждая версия PHP за последние десять лет, а оценка по CVSS, шкале опасности уязвимостей, 9.2 из 10.
Wiz сообщила о багах команде PHP 24 августа и искала их вместе с моделями Gemini 4 Argon и GPT-5.6 Sol. Основной вклад, судя по её блогу, внесла Argon: от поиска до эксплойта, детектора атак и проверки патча. OpenAI записала находку в свою программу Patch the Planet, называет её [28] одной из самых опасных уязвимостей последних лет и пишет, что два месяца вела коалицию мейнтейнеров, исследователей и вендоров, потому что исправление потребовало большой переделки движка. По её формулировке, модели нашли уязвимость раньше атакующих, “насколько нам известно”. Это первенство оспаривает примечание сообщества [28] под тем же постом, по версии которого уязвимость на несколько месяцев раньше нашёл и написал для неё эксплойт независимый исследователь LCFR.
За несколько часов до релиза Дейн Кнехт, технический директор Cloudflare, сообщил [29], что для всех клиентов, включая бесплатных, уже работают правила WAF, фильтра запросов перед сайтом, и что первые атаки уже идут. АНБ советовало [30] готовиться к обновлению, а системы, которые не получается обновить сразу, отключать. На HN потом появился пост с извинениями [31] от человека, который заранее написал о грядущих дырах в PHP с удалённым выполнением кода (RCE), не зная про эмбарго: знакомая сказала ему, что эмбарго нет, а ей сказали то же самое. По данным The Rundown [32], через 45 минут после объявления Cloudflare насчитала десятки тысяч попыток взлома, а Великобритания, Нидерланды и Финляндия отключили часть государственных сайтов.
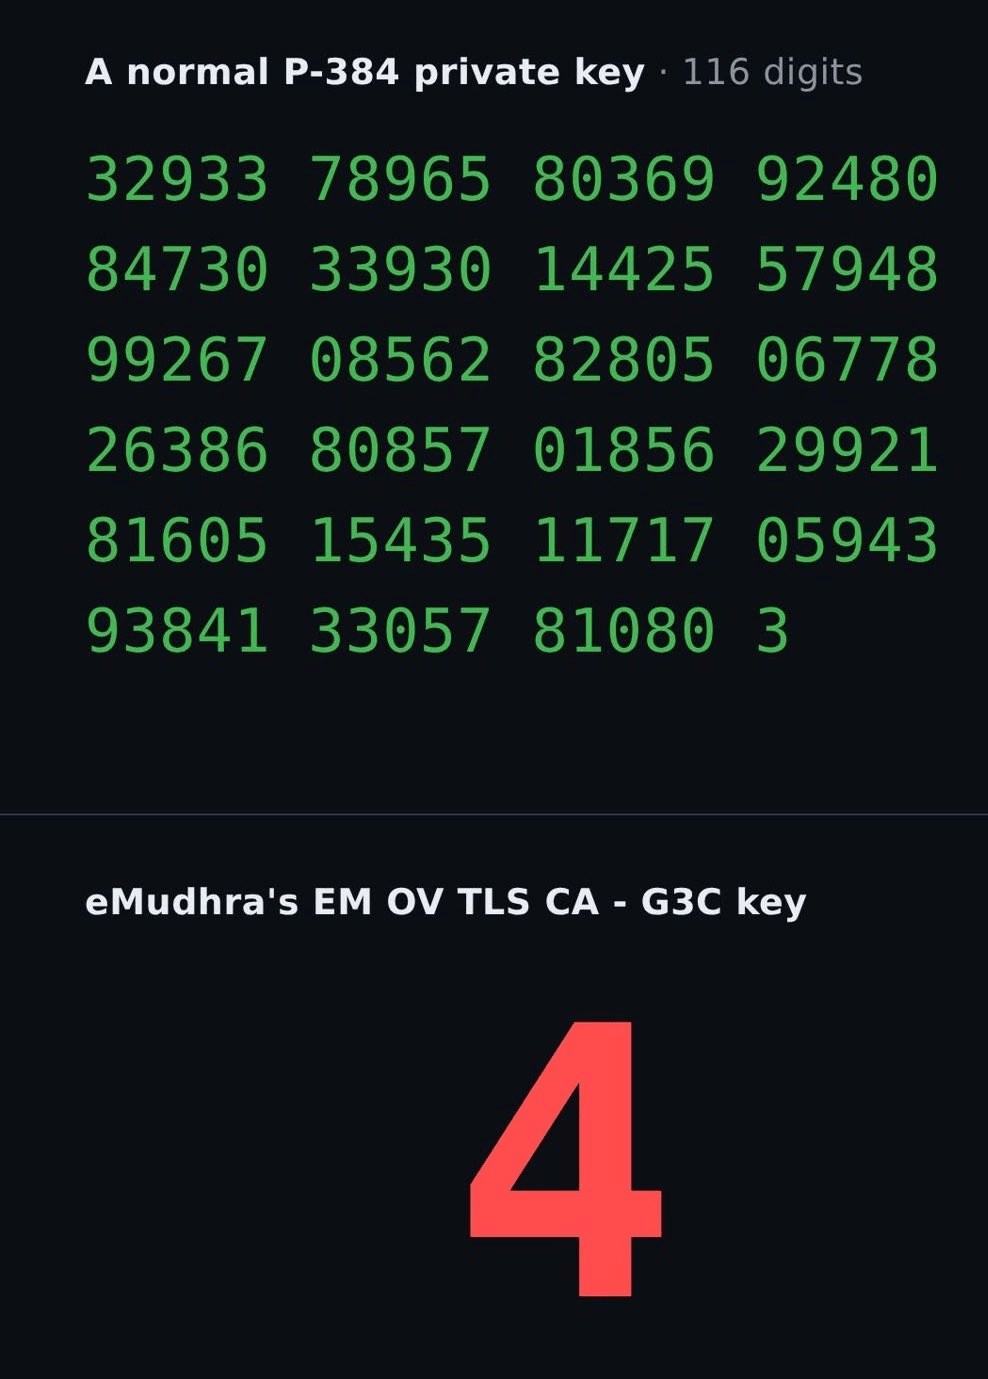
У индийского удостоверяющего центра eMudhra (emSign) скомпрометированы [33] закрытые ключи восьми промежуточных сертификатов, цепочки которых ведут к корням, доверенным в Mozilla, Microsoft, Apple и Chrome. Удостоверяющий центр подписывает сертификаты, по которым браузер понимает, что сайт настоящий, так что с этими ключами можно выпустить валидный сертификат для чужого сайта. Ключи сгенерировали неправильно, и их можно восстановить прямо из сертификатов. По одному из разборов [34], все восемь были меньше 256, а один равнялся 4. Исследователь утверждает, что Claude взломал их одним промптом. Там же пишут, что eMudhra уходит из бизнеса удостоверяющих центров.
Firefox и Chrome заблокировали эти сертификаты 17 октября, Microsoft 20-го, Apple 22-го. Хуже программам со своим набором корневых сертификатов. На странице инцидента перечислены исправленные pip 26.2.2, uv 0.13.5, certifi 2026.10.19, Python 3.15.1, 3.14.9 и 3.13.17, Node.js 26.12.1, 24.22.1 и 22.23.4 и даже Claude Code 2.1.303. Со старым pip атакующий в той же сети теоретически может выдать себя за PyPI и подсунуть пакет с сюрпризом, хотя о таких атаках пока не сообщали.
Ещё дольше уязвимы устройства, которые редко обновляют список доверенных сертификатов, и среди них оказались популярные у нас Яндекс Станции. 20 октября разработчик под ником bitracker показал [35], что Станция Мини 2 всё ещё доверяет цепочке eMudhra: колонка приняла поддельный сервер Яндекса, получила настройки с включённой отладкой по сети и отдала владельцу root. В сообществе уже хвастаются AirPlay и сервером Minecraft на колонке, хотя независимо это никто не проверял. Яндекс уязвимость подтвердил и раскатывает обновление, а получить так доступ к чужой колонке, по словам компании, почти невозможно. На сборках после 21 октября этот способ уже не работает [36], но для Станции Лайт 2 нашли обход через заводской режим. Гайды по всем моделям собраны в открытой вики Yandex Station Extended [37], и там честно предупреждают, что колонку можно окирпичить.
LiteLLM, популярный open source прокси к API моделей, 21 октября вышел на PyPI [38] в версии 1.107.0 с похитителем учётных данных. Вредоносный код запускался в каждом процессе Python на машине, даже если LiteLLM никто не импортировал. Он собирал SSH-ключи, облачные и CI-секреты, токены AI-инструментов, сохранённые в браузере пароли и ключи провайдеров из базы прокси, а бэкдор раз в час подтягивал и выполнял новый код. Опубликовал всё это официальный пайплайн с подписью. По версии LiteLLM, у атакующего были учётные данные GitHub CLI трёх разработчиков, скорее всего из логов внутреннего деплоя, открытого в интернет. Версия провисела на PyPI меньше двух часов, с 11:39 до 13:23 UTC. Заражены были и образы Docker. Тем, кто её ставил, советуют откатиться на 1.106.2 и считать все секреты на машине скомпрометированными.
Railway после инцидента безопасности 21 октября остановила [39] сборки по всей платформе, отозвала все API-токены и OAuth-сессии и просит клиентов сменить секреты из переменных окружения. Zeabur, ещё одна платформа для деплоя, закрывается [40] к 31 декабря: среди причин основатель называет остановившийся рост и два инцидента безопасности, в конце августа и 14 октября.
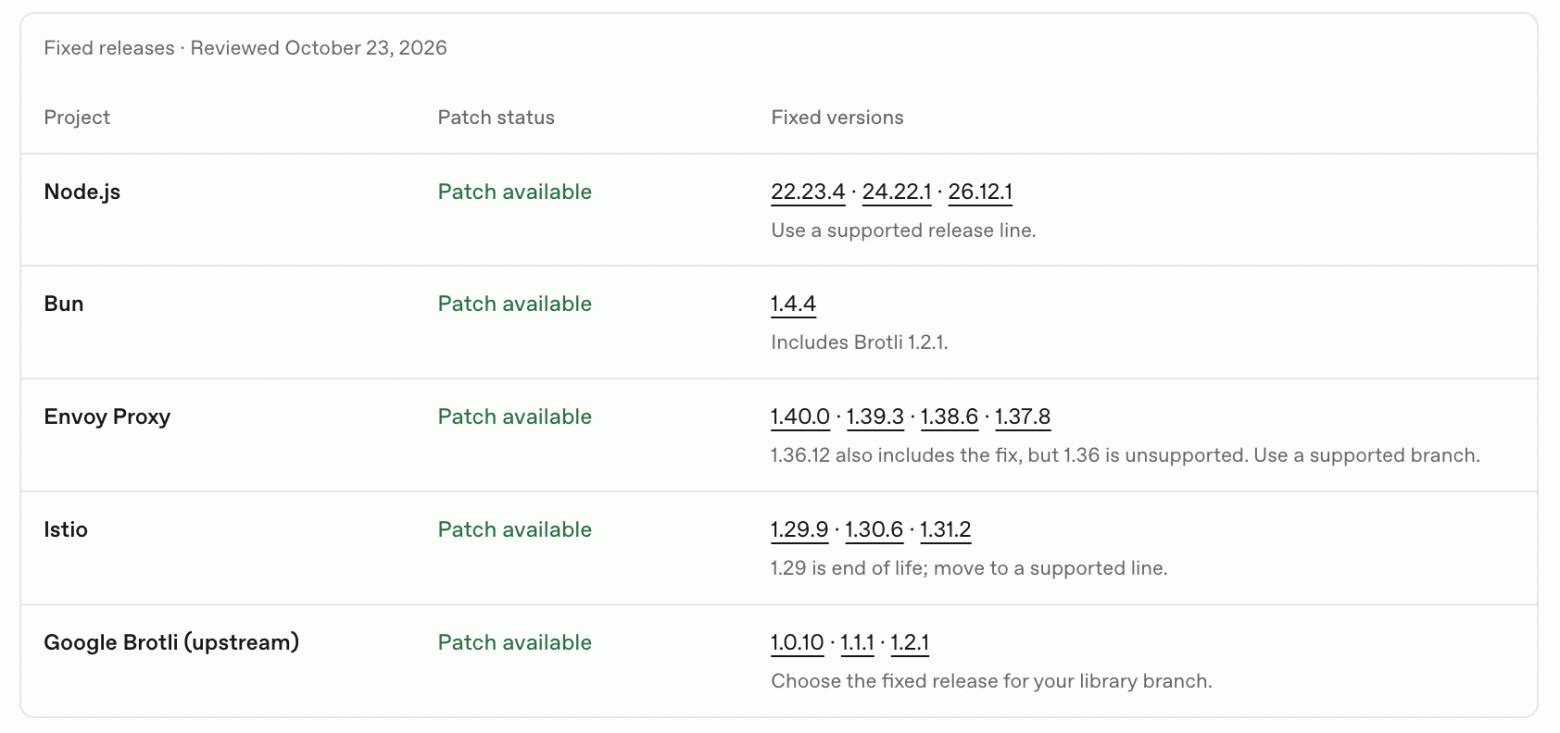
OpenAI, проверяя свою среду обучения [41] на устойчивость к атакам, нашла уязвимость в Brotli [42], библиотеке сжатия внутри Node.js, Bun, Envoy и Python-пакетов. Вредоносные сжатые данные позволяют без авторизации выполнить код и на сервере, который принимает сжатый вход, и на клиенте вроде curl --compressed. Корень ошибки исправили в исходниках Brotli ещё в феврале, но никто не понял, что это дыра, и релиза с исправлением не было до 21 октября. На странице уязвимости [43], которую назвали Broccoli2Shell, находку приписывают OpenAI Codex Security. GitLab 21 октября закрыл [44] уязвимость с CVSS 10 в компиляторе регулярных выражений: неавторизованный пользователь мог выполнить код на сервере во всех версиях начиная с 7.0.
Microsoft приписала группировке, связанной с Китаем, атаку на 2250+ организаций в Microsoft 365 с помощью ARTEX, открытого агентного фреймворка для пентеста. В отдельных случаях атакующие получили права администратора меньше чем за три часа. Сара Го, инвестор и основательница фонда Conviction, пишет [45], что с апреля число CVE, записей в общем реестре уязвимостей, выросло примерно с 4 до 15 тысяч в месяц.
Anthropic показала формальную верификацию [46] в промышленном масштабе. За несколько недель Claude вместе с компанией Theorem доказал отсутствие падений для 239 точек входа в 123 библиотеках из OSS-Fuzz, программы Google по фаззингу open source. Фаззинг закидывает программу случайными входами и смотрит, где она упадёт. Доказательство гарантирует больше: на любом входе до 64 МБ программа завершится без ошибок памяти и проваленных проверок. Всего вышло около 180 млн строк доказательств на Rocq, и их проверяет отдельная программа. Типичное доказательство занимает около 600 тысяч строк. По ходу нашлись сотни багов, Claude их исправил и доказал отсутствие падений в исправленном коде.
Anthropic сама перечисляет ограничения. Доказательства получены для статических бинарников под RISC-V с musl, а у большинства пользователей стоят сборки с glibc на x86 и ARM. Одно доказательство может съесть сотни миллионов токенов. И за Claude приходилось следить, чтобы он не подгонял код под спецификацию, просто переписывая его так, чтобы тот никогда не падал.
Ещё Anthropic запустила OSS Scanner [47]: бесплатные регулярные проверки критичных open source проектов своими сильнейшими моделями. К каждой находке прилагается пример эксплуатации уязвимости и, где можно, патч. Первые сканы принесли [48] 77 критических и 803 серьёзных находки по оценке модели, среди исправленного есть use-after-free в curl (CVE-2026-92392), то есть обращение к уже освобождённой памяти. Люди эти отчёты ещё не проверяли, поэтому мейнтейнерам их отправляют без привычного 90-дневного срока до публичного раскрытия.
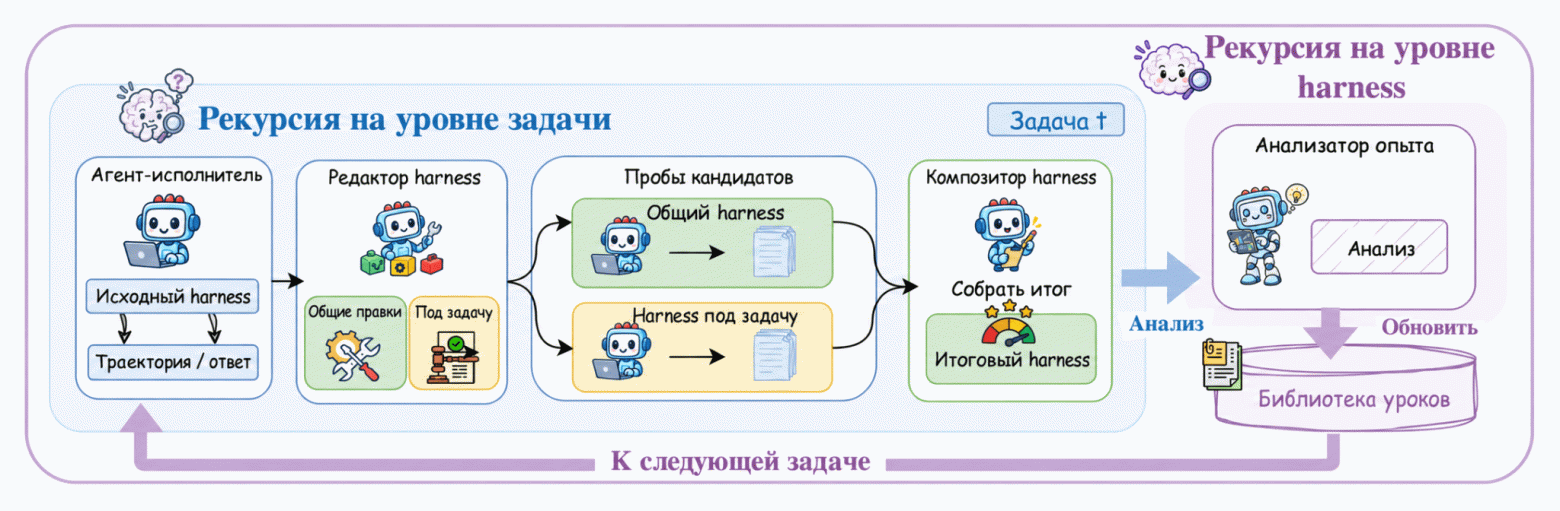
Google Research открыла под Apache 2.0 Harness² [49], фреймворк, в котором агент сам улучшает свой harness: системный промпт, ограничения, память, подсказки к инструментам, субагентов, навыки, скрипты и плагины. Веса при этом не меняются. Редактор предлагает правки, кандидатов пробуют на той же задаче, композитор собирает итоговую версию по разнице в поведении [50], а отдельный агент записывает выученные уроки в библиотеку для следующих задач. Правильные ответы для этого не нужны.
По README один такой шаг даёт GLM-5 и Gemini 3.5 Flash до 11.5 пункта на WorkBuddy-Bench с офисными, веб- и кодовыми задачами и до 4.5 на JobBench с профессиональной работой. В треде на r/LocalLLaMA [51] опасаются двух вещей: самоулучшение съедает контекст, что больно для локальных моделей, а харнесс может просто подогнаться под бенчмарк. Сами авторы советуют ограничить доступ к сети перед оценкой, потому что рубрики бенчмарков лежат в открытом доступе.
Anthropic запустила предварительную исследовательскую версию Claude Duet [52], проактивного агента на Opus 5.5. Пока по списку ожидания и только для подписчиков Pro и Max в США, в веб-версии и приложениях для iOS и Android. Каждое утро он присылает сводку, раз в несколько часов проверяет подключённые приложения и пишет, только когда что-то требует внимания [53]. Задачи Duet выполняет на собственной виртуальной машине со своим браузером, так что ноутбук можно закрыть. Подключить можно больше 6000 коннекторов и плагинов из Claude Marketplace.
Читать, готовить черновики и собирать материалы агент может сам, а перед отправкой сообщений, платежами, подписанием документов и удалением показывает действие и ждёт подтверждения. Торговать ценными бумагами и переводить деньги между счетами ему нельзя даже с подтверждением. Пароли и токены входа он не видит, отдельный классификатор не даёт делиться номерами карт и документов, а от prompt injection, то есть инструкций, спрятанных в письмах и на страницах, обещают защиту. Отдельной цены нет: Duet расходует общие лимиты подписки, и как раз поэтому проверяет приложения раз в несколько часов, а не непрерывно.
Оставайтесь любопытными.
Пишу об искусственном интеллекте, языковых моделях и инструментах для разработчиков. Тестирую модели и сервисы на реальных задачах, а выводами делюсь в телеграм‑канале [54].
Автор: controlled_hallucinations
Источник [55]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37564
URLs in this post:
[1] DeepInfer: https://github.com/deepseek-ai/DeepInfer
[2] их пересказал: https://x.com/ZhihuFrontier/status/2112472782630187517
[3] добавила в API: https://x.com/OpenAIDevs/status/2112603916076781778
[4] процитировал: https://x.com/swyx/status/2112587397380943953
[5] поблагодарила: https://x.com/vllm_project/status/2112480719952138301
[6] показала: https://x.com/vllm_project/status/2112703311933747347
[7] измерениях Artificial Analysis: https://x.com/ArtificialAnlys/status/2112218661432000694
[8] интеллекта: http://www.braintools.ru/article/7605
[9] поведение: http://www.braintools.ru/article/9372
[10] заняла первое место: https://x.com/elliotarledge/status/2112181986261377354
[11] ошибку: http://www.braintools.ru/article/4192
[12] Teortaxes: https://x.com/teortaxesTex/status/2111741956368085007
[13] Space Bunny: https://x.com/MiniMax_AI/status/2112150867868541221
[14] вышли веса: https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
[15] поддержал модель: https://x.com/vllm_project/status/2113451297613746683
[16] дала ей: https://x.com/ArtificialAnlys/status/2112211865128608002
[17] доля галлюцинаций: https://artificialanalysis.ai/evaluations/omniscience
[18] LICENSE: https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/LICENSE
[19] писал на прошлой неделе: https://gotacat.dev/blog/weekly-ai-hallucinations-muse-wonder-gemini-4-argon-anthropic-git
[20] выпустила Kimi K3.1 Pro: https://x.com/Kimi_Moonshot/status/2113680701770068067
[21] блоге: https://www.kimi.ai/blog/kimi-k3-1-pro
[22] 55 баллов: https://x.com/ArtificialAnlys/status/2113688083145314416
[23] набрала 64%: https://x.com/ArtificialAnlys/status/2113765233462481276
[24] написал: https://x.com/kimmonismus/status/2113872950214438955
[25] памяти: http://www.braintools.ru/article/4140
[26] показала: https://www.wiz.io/blog/php2shell-php-rce
[27] Логика: http://www.braintools.ru/article/7640
[28] называет её: https://x.com/OpenAI/status/2112907856018309586
[29] сообщил: https://x.com/dok2001/status/2112811965735202970
[30] советовало: https://x.com/NSACyber/status/2112903220209098897
[31] пост с извинениями: https://news.ycombinator.com/item?id=50193416
[32] The Rundown: https://x.com/TheRundownAI/status/2113344155300553132
[33] скомпрометированы: https://emudhra.we-have-a-problem.com/
[34] одному из разборов: https://x.com/L4UR3N7/status/2113291274664976774
[35] показал: https://www.securitylab.ru/news/579123.php
[36] уже не работает: https://hackalice.me/start/root/
[37] Yandex Station Extended: https://hackalice.me/
[38] вышел на PyPI: https://safedep.io/litellm-pypi-compromise-credential-stealer-backdoor/
[39] остановила: https://status.railway.com/incident/QH8L8B3E
[40] закрывается: https://zeabur.com/blogs/zeabur-is-shutting-down
[41] обучения: http://www.braintools.ru/article/5125
[42] Brotli: https://x.com/OpenAI/status/2113766354386084338
[43] странице уязвимости: https://broccoli2shell.com/
[44] закрыл: https://docs.gitlab.com/releases/patches/patch-release-gitlab-19-5-1-released/
[45] пишет: https://x.com/saranormous/status/2113122755235463277
[46] формальную верификацию: https://www.anthropic.com/research/formal-verification
[47] OSS Scanner: https://red.anthropic.com/oss-scanner/
[48] принесли: https://x.com/ClaudeDevs/status/2112299602510749992
[49] Harness²: https://github.com/google-research/harness2
[50] поведении: http://www.braintools.ru/article/5593
[51] треде на r/LocalLLaMA: https://www.reddit.com/r/LocalLLaMA/comments/1x9gfnb/google_open_sources_harness2_for_self_improving/
[52] Claude Duet: https://claude.com/resources/articles/claude-duet
[53] внимания: http://www.braintools.ru/article/7595
[54] телеграм‑канале: https://t.me/+oCSVDZyvBYw4NmYy
[55] Источник: https://habr.com/ru/news/1099718/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1099718
Нажмите здесь для печати.