Когда LLM должна сказать «Я не знаю»?
В RAG недостаточно найти документы на нужную тему: они должны содержать сведения, из которых можно обосновать ответ. Разберём три способа исследовать эту границу — от внешнего оценщика контекста до анализа активаций модели и испытаний на противоречивых свидетельствах.
Когда найденных документов недостаточно?
Вопрос пользователя проходит через поиск, система извлекает несколько документов и передаёт их языковой модели. Допустим, в полученных фрагментах встречаются нужные имена и термины, но факта, который связывает их и позволяет ответить на вопрос, нет. Генератор всё равно может выдать законченную фразу: например, дополнить пробел наиболее вероятной связью или обратиться к знаниям, усвоенным при обучении [1]. Результат может оказаться верным, но извлечённые документы его не обосновывают.
Здесь важно различать несколько вещей. Релевантность говорит о связи документа с вопросом, но даже очень близкий по теме текст может не содержать ответа. Достаточность относится к паре «вопрос — контекст»: хватает ли имеющихся сведений, чтобы построить ответ? Это не то же самое, что способность конкретной модели правильно ими воспользоваться. Наконец, даже ответ, согласующийся с контекстом, может быть фактически неверным, если сам источник ошибается.
LLM обучена продолжать текст; правдоподобная формулировка сама по себе не свидетельствует о наличии проверенных оснований. Самооценка уверенности тоже может отражать склонность модели к определённому ответу, а не качество найденных источников. Поэтому в системе, которая обязана опираться на предоставленные документы, нужен ещё один возможный результат: не только ответ, но и воздержание — сообщение о нехватке сведений, запрос уточнения или повторный поиск. При этом также плохо – если система будет отказываться отвечать на вопросы, знаний для ответов на которые достаточно.
Рассмотрим три исследования этой проблемы, посвященные разным ее аспектам. Joren и соавторы предлагают оценивать достаточность самого контекста и использовать её вместе с уверенностью модели. Lavi и соавторы ищут сигнал невозможности ответа во внутренних представлениях LLM. Zhang и Wu проверяют, как модели меняют поведение [2] при пяти типах свидетельств — от полного подтверждения до противоречия.
Три подхода к границе ответа
1. Что такое достаточный контекст?
В работе Sufficient Context [3] объект оценки — не документ сам по себе, а вопрос  вместе с контекстом
 . Авторы называют контекст достаточным, если существует правдоподобный ответ
 , который можно получить из предоставленной информации:
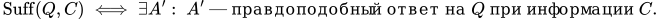
Здесь «правдоподобный» означает в том числе подходящий по типу: если спрашивают место рождения, ответом должно быть место. На практике оценщик проверяет, хватает ли контекста для определённого ответа, в том числе при необходимости связать несколько фактов. Если говорится, что мать Боба родилась в Нью-Йорке, это ещё не позволяет заключить, что там родился и Боб. Недостающую связь нельзя просто додумать.
В отличие от проверки логического следования для заранее заданного ответа, здесь сначала спрашивают, существует ли подходящий ответ. Эталон на входе оценщику не нужен. Такой критерий можно применять во время работы RAG, когда правильный ответ заранее неизвестен. Но у него есть следствие: текст способен достаточно ясно поддерживать ошибочное утверждение. Достаточность контекста не равна истинности источника и не гарантирует, что сгенерированный ответ совпадёт с эталоном. Неоднозначный вопрос или взаимно противоречащие сведения также могут сделать контекст недостаточным для определённого ответа.
Как оценить достаточность автоматически
Авторы построили оценщик на основе LLM: ему передают вопрос и контекст и просят определить, достаточно ли сведений для ответа. Для проверки собрали 115 сложных пар из нескольких бенчмарков и разметили их с участием людей, не используя эталонные ответы при назначении меток. Gemini 1.5 Pro с одним примером в инструкции достиг 93% accuracy на этой выборке. Это результат на небольшой специально составленной проверке, а не гарантия того же качества для произвольного корпуса.
Более дешёвый оценщик FLAMe также показал полезное качество, но из-за ограниченного окна контекст делили на фрагменты по 1600 токенов. Всю пару считали достаточной, если хотя бы один фрагмент признавался достаточным. У такого приближения есть понятная слабость: факты, которые становятся достаточными только вместе, могут оказаться в разных фрагментах. И наоборот, общую противоречивость нескольких фрагментов правило «хотя бы один достаточен» может не отразить. Оценщик — отдельная модель с собственными ошибками, а не оракул.
Что происходит с ответами
Разделение примеров по достаточности помогает локализовать сбой. На исследованных наборах крупные модели, в том числе Gemini 1.5 Pro, GPT-4o и Claude 3.5, обычно хорошо отвечали при достаточном контексте, но при недостаточном нередко выбирали ответ вместо отказа. Более слабые в исследовании модели, включая Mistral и Gemma, ошибались или отказывались и тогда, когда нужная информация присутствовала. Улучшить поиск важно, но одного поиска недостаточно, если генератор не умеет использовать найденное.
Не всякий ответ при недостаточном контексте неверен. На рассмотренных основных бенчмарках модели давали правильный ответ на 35–62% случаев, размеченных как недостаточный контекст; на специально подобранной сложной выборке результаты были иными. Авторы обсуждают несколько причин: знание, полученное при обучении, полезная частичная подсказка, удачное разрешение неоднозначности и ошибки [4] оценщика. Это не доказывает обоснованность каждого правильного ответа документами. Для приложения, где требуется строгое подтверждение источниками, политика может запрещать неподкреплённый ответ даже тогда, когда он совпадает с эталоном.
Выбор между ответом и отказом
Жёсткое правило «отказывать при любом признаке недостаточности» потеряет часть правильных ответов. Вместо этого авторы рассматривают селективную генерацию. Её измеряют двумя величинами: охватом — долей вопросов, на которые система ответила, — и селективной точностью — долей правильных среди выданных ответов. При уменьшении охвата можно отбрасывать самые рискованные ответы; задача — сделать это так, чтобы ошибки уходили чаще, чем полезные ответы.
Для решения берут два сигнала: бинарную оценку достаточности от FLAMe и самооценку уверенности генератора. Уверенность получали двумя способами: в варианте  модель оценивает сэмплированные ответы, а в
 — вероятность правильности собственного ответа; выбор зависел в том числе от стоимости многократных запросов. Логистическую регрессию обучают на размеченных примерах предсказывать риск ошибки, затем порогом определяют, какие ответы пропустить пользователю. Это небольшой внешний классификатор: он не обязан менять веса генератора, но требует данных для обучения и настройки порога.
Почему сочетание может помочь? Самооценка характеризует отношение модели к собственному ответу, а оценщик добавляет другой признак — наличие необходимых сведений в источниках. Если сигналы дополняют друг друга, ранжирование ответов по риску улучшается. На HotpotQA авторы получили заметный выигрыш по селективной точности для Gemma 27B и Gemini 1.5 Pro в отдельных областях охвата; на MuSiQue для Gemma прироста от дополнительного сигнала не обнаружили. В аннотации указан прирост на 2–10% для рассмотренных Gemini, GPT и Gemma, но он не одинаков для всех сочетаний модели, данных и порога.
Другое испытанное решение — дообучение модели на примерах с отказом. Для Mistral-7B-Instruct-v0.3 увеличение доли таких примеров относительно варианта дообучения без отказов повышало склонность отказываться, но не обеспечило устойчивого уменьшения ошибок по сравнению с исходной RAG-моделью. Например, на MuSiQue доля верных ответов снизилась с 28,8% до 23%, а ошибок выросла с 59,4% до 74,8% для приведённого авторами варианта обучения. Учить модель произносить «не знаю» и научить её выбирать правильные случаи для отказа — разные задачи.
Место для иллюстрации: схема «вопрос и документы → оценка достаточности + самооценка ответа → порог → ответ или отказ». Можно нарисовать самостоятельно по разделу 5.1 Joren и соавторов [3]; важно показать, что оценка и классификатор могут ошибаться.
2. Можно ли распознать невозможность ответа по активациям LLM?
Во второй работе объект исследования — сама модель. Lavi и соавторы [5] рассматривают extractive QA: дан текст и вопрос, а нужно определить, содержит ли текст сведения для ответа. Они ищут в пространстве скрытых состояний направление, связанное с невозможностью ответа по данному контексту. Это гипотеза о полезном линейном сигнале в конкретных моделях, а не утверждение, что понятие полностью хранится в одном векторе.
Кандидаты и проверка вмешательством
Для размеченных примеров модель обрабатывает контекст и вопрос. На каждом слое  и в рассматриваемой позиции токена
 авторы собирают скрытое состояние
 . Затем вычисляют разность средних состояний двух классов:
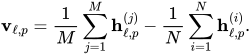
 и
 — числа примеров без ответа и с ответом соответственно. Вектор направлен от среднего состояния второго класса к среднему состоянию первого. По отдельному вектору получается для каждой пары слоя и позиции; разность средних сама по себе ещё не доказывает причинную роль направления.
Авторы исследуют все слои и позиции токенов шаблона чата после инструкции, перед ответом модели: в этих состояниях уже доступна информация из обработанных вопроса и контекста. Конкретную пару выбирают экспериментально на отдельной валидационной выборке. В их настройках выбранные слои оказались близки к середине сетей: слой 16 из 32 у Llama-3-8B-Instruct и слои 26–27 из 48 у Gemma-3-12B-IT. Это наблюдение для двух моделей, а не универсальный номер слоя.
Чтобы выбрать направление, авторы поочерёдно добавляют каждый кандидат к состоянию на соответствующих слое и позиции:
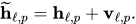
После этого вычисления продолжаются, а исследователи смотрят на распределение следующего токена. В инструкции модели предписано использовать слово unanswerable для отказа. Поэтому авторы измеряют логарифм отношения вероятности первого токена этого слова к суммарной вероятности остальных токенов и усредняют результат по валидационным примерам. Это приближение к склонности отказаться: вероятность первого токена не равна вероятности полного корректного отказа. Выбирают кандидата с наибольшим таким показателем.
От проекции к решению
Выбранный вектор нормируют: 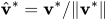 . Для новой пары берут состояние
 в выбранной точке сети и вычисляют скалярное произведение:
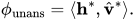
Это координата состояния вдоль найденного направления: чем она выше, тем сильнее сигнал невозможности ответа по выбранному правилу. Значение не является вероятностью. Чтобы получить бинарную классификацию, на размеченной валидационной выборке строят ROC-кривую и выбирают порог  , ближайший к идеальной точке: полнота обнаружения неотвечаемых вопросов равна единице, доля ложных срабатываний — нулю. При
 пример относят к неотвечаемым. Порог определяет компромисс между пропущенными случаями и ненужными отказами.
Тот же вектор используют для вмешательства в генерацию: 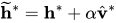 , где
 задаёт силу изменения. Добавление направления повышало частоту отказов, а удаление компоненты вдоль него подталкивало модель отвечать. Но сильное воздействие повышало отказы и на отвечаемых вопросах: управление поведением [6] не равнозначно его правильной калибровке. Связь с отказом подтверждается вмешательством, но проекция не удостоверяет фактическую истинность будущего ответа.
Сравнение и перенос
Авторы проверили Llama-3-8B-Instruct и Gemma-3-12B-IT на SQuAD 2.0, RepLiQA, Natural Questions и MuSiQue. Сравнивали направление с обычным промптом, промптом с учетом воздержания и обучаемым линейным классификатором по активациям. На том же наборе, где получали направление, обучаемый классификатор был несколько сильнее: средний macro-F1 составил 86,5% против 83,7% для Llama и 87,8% против 82,4% для Gemma. Macro-F1 усредняет F1 двух классов и показывает качество их распознавания.
При переносе на другие наборы направление во многих случаях обобщалось лучше классификатора, но на MuSiQue преимущество было у последнего. Дополнительная настройка порога на размеченной валидационной части целевого набора улучшала перенос, однако это уже не применение без данных целевого распределения. Авторы также проверили примеры неотвечаемости, связанной с субъективностью и отсутствием научного консенсуса; эти результаты не снимают ограничений двух исследованных моделей и выбранных тестов.
Для практического применения нужны доступ к активациям, подходящая реализация инференса и разметка для построения направления и порога. Обычный API, возвращающий только текст, не предоставляет необходимых скрытых состояний. Даже при доступе к весам сигнал может зависеть от модели, шаблона инструкции и распределения данных.
3. Как LLM ведут себя при разной достаточности сведений?
Третья работа предлагает не механизм управления моделью, а способ её испытывать. Zhang и Wu [7] строят Evidence Sufficiency Benchmark (ESB): для одного вопроса меняют качество предоставленных свидетельств и проверяют, соответствует ли решение модели условию задачи.
|
Уровень |
Что получает модель |
Ожидаемое поведение в ESB |
|---|---|---|
|
L1 — полное подтверждение |
Контекст полностью поддерживает ответ. |
Ответить. |
|
L2 — частичное подтверждение |
Поддержка ослаблена, но ответ по конструкции теста всё ещё выводим. |
Ответить. |
|
L3 — нерелевантные сведения |
Передан текст, не содержащий нужных свидетельств. |
Воздержаться. |
|
L4 — нет контекста |
Внешних свидетельств не предоставлено. |
Воздержаться. |
|
L5 — противоречивые сведения |
Контекст содержит конкурирующие или противоречащие утверждения. |
Воздержаться. |
Граница в протоколе проходит между L2 и L3. «Частичное» в названии L2 не означает автоматическую невозможность ответа: согласно замыслу бенчмарка оставшейся информации достаточно. Пять уровней — удобная схема оценки, но не универсальная шкала: противоречие L5 отличается по природе от отсутствия текста L4, а не просто содержит меньше информации.
Исследователи взяли по 100 вопросов из SQuAD и HotpotQA, составили для каждого пять условий и использовали три вида инструкции. Обычная инструкция просила отвечать по контексту; вторая явно разрешала отказ при нехватке сведений; третья просила сначала оценить достаточность. Получилось 3000 основных запросов на модель, плюс отдельные проверки перестановки конфликтующих фрагментов. Исследовали семь моделей пяти семейств. Авторы вручную проверили 200 стратифицированных примеров; автоматическая классификация ответов и небольшая исходная выборка остаются важными ограничениями.
Что измеряет бенчмарк
Помимо точности на отвечаемых L1–L2, авторы считают долю отказов, долю ответов там, где по протоколу следует отказаться, и долю воспроизведения заведомо неверного варианта из конфликтующего фрагмента. Для точности на L1–L2 знаменатель включает все примеры этих уровней: необоснованный отказ тоже уменьшает показатель. Ответы сопоставляли с эталоном по строке без учёта регистра, поэтому допустимые переформулировки и сложные ответы могут оцениваться несовершенно.
Кривая достаточности показывает долю отказов на каждом уровне. Идеальная для этого протокола линия близка к нулю на L1–L2 и к единице на L3–L5. Её сводная метрика — поведенческая ожидаемая ошибка калибровки B-ECE:
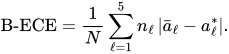
Здесь  — число примеров уровня
 ,
 — общее число примеров,
 — наблюдаемая доля отказов,
 — целевая доля: 0 для L1–L2 и 1 для L3–L5. Меньше — ближе к заданному поведению. Это не обычная вероятностная ECE: метрика не сравнивает заявленную уверенность с частотой правильных ответов. Она также не гарантирует правильности ответа на L1–L2 и зависит от принятой политики отказа.
Почему конфликт сложнее пустого контекста
При отсутствии текста недостаток свидетельств заметен; при конфликте [8] перед моделью оказываются фразы, каждая из которых похожа на источник готового ответа. По аннотации работы, в условиях L5 доля ответов, которые протокол считает избыточными, составила примерно 65–91% у семи исследованных моделей. Речь о конкретной выборке и определении правильного поведения: некоторые из этих ответов могли совпасть с эталоном, но выбор одной стороны без разрешения противоречия нарушал правило теста.
Инструкция влияла на результат неодинаково. Для Gemini 2.5 Flash доля отказов при L5 выросла с 5,2% при обычном промпте до 55,2% при предварительной оценке достаточности; для Claude Sonnet 4.6 — с 7,2% до 11,2%. На этих данных просьба рассуждать о достаточности помогала одним моделям намного сильнее, чем другим, и не решала проблему надёжно для всех.
Порядок тоже имел значение. При перестановке правильного и противоречащего фрагментов авторы обнаружили статистически значимую зависимость от позиции у шести из семи моделей; максимальная абсолютная разница составила 20,5 процентного пункта. В системе с повторяющимися, устаревшими или конфликтующими документами порядок выдачи может стать частью причины ответа, а не случайной деталью интерфейса.
Высокая точность на L1–L2 измеряет работу с достаточными свидетельствами и не показывает, будет ли модель отказываться на L3–L5. Сопоставление этих показателей помогает проверять полезность и поведение при нехватке сведений отдельно. Конкретные значения для отдельных моделей в разделе 6.5 публикации требуют дополнительной сверки с рисунком 7 и исходными данными.
Место для иллюстрации: кривая доли отказов по L1–L5, рис. 3 Zhang и Wu [7]. Перед воспроизведением сверить данные и условия лицензии; альтернативно построить собственную схему без представления её как экспериментального графика.
4. Сравнение трёх подходов
|
Критерий |
Joren и соавторы: достаточность контекста |
Lavi и соавторы: направление в активациях |
Zhang и Wu: ESB |
|---|---|---|---|
|
Основная задача |
Разделить сбои, связанные с контекстом и его использованием; улучшить выборочный ответ. |
Определить, можно ли ответить по тексту, и изучить связь внутреннего сигнала с отказом. |
Измерить, соответствует ли решение об ответе качеству свидетельств. |
|
Что анализируется |
Пара «вопрос — контекст», самооценка генератора и правильность ответа. |
Скрытые состояния выбранных слоёв и позиций токенов. |
Ответы и отказы при пяти сконструированных условиях, разных инструкциях и порядке фрагментов. |
|
Основной метод |
LLM-оценщик достаточности; логистическая регрессия по этому сигналу и уверенности. |
Разность средних активаций, выбор направления через вмешательство, проекция и порог. |
Контролируемый бенчмарк, кривая отказов и поведенческие метрики. |
|
Доступ к внутренним состояниям модели |
Для генератора не обязателен, если доступны ответы и нужная самооценка. |
Обязателен для извлечения и изменения активаций исследуемой модели. |
Не обязателен: достаточно задавать вопросы и получать ответы. |
|
Преимущества |
Отдельный сигнал о контексте; настраиваемый компромисс между охватом и точностью. |
Позволяет исследовать и использовать внутренний сигнал; в ряде тестов переносится лучше базового классификатора. |
Разделяет типы нехватки сведений и показывает сбои, скрытые общей точностью. |
|
Ограничения |
Ошибки оценщика; нужны размеченные данные и настройка; достаточность не равна истинности. |
Нужны доступ к активациям, разметка и калибровка |
Небольшая исходная выборка, автоматическая оценка и искусственно заданная политика; есть несогласованности в публикации. |
|
Практическая применимость |
Внешний компонент для локального генератора или API при доступности нужных сигналов. |
Прежде всего локальные модели с открытыми весами и управляемым инференсом. |
Тестовый набор и протокол для локальных моделей и API; сам по себе не улучшает генератор. |
Разница начинается с того, что именно принимается за сигнал. Оценщик в первой работе получает те же внешние сведения, что и генератор, и выносит отдельное суждение об их достаточности. Во второй сигнал извлекают из состояния самого генератора после обработки входа; это оценка возможности ответа по представлению модели, а не независимая проверка источника. В третьей работе свойства контекста задаются при создании теста, после чего измеряется реакция [9] моделей. Поэтому ESB может использоваться для диагностики системы с внешним оценщиком или другим механизмом отказа, но рассмотренные статьи не сообщают о прямом сравнении этих комбинаций.
Для локальной модели доступны все три направления работы, если среда действительно позволяет читать и изменять скрытые состояния. Это открывает пространство для исследования, но требует вычислений, воспроизводимой конфигурации и собственной валидации. С API, выдающим только ответы, можно построить внешний оценщик и проверить поведение на сценариях ESB; воспроизвести метод активаций без соответствующего доступа нельзя. Возможность реализовать первую схему также зависит от того, можно ли получить выбранную самооценку: одни поставщики раскрывают необходимые вероятности или допускают дополнительные запросы, другие ограничивают интерфейс.
Наконец, политика зависит от продукта. Если приложение отвечает только по внутренним документам, правильный ответ из параметрической памяти [10] без подтверждения может считаться нарушением требований. В более свободной системе он может быть полезен, если явно отделён от сведений из источников. Сравнивая методы, следует заранее определить, считается ли успехом совпадение с эталоном, подтверждение ответом из документов или корректный отказ — и измерять эти свойства раздельно.
Что учитывать при разработке RAG-систем?
Исследования показывают, что LLM не всегда надёжно распознают границу между достаточными и недостаточными сведениями. Модель может ошибиться при хорошем контексте, правильно ответить без достаточного подтверждения или выбрать одну версию из противоречивых фрагментов. Поэтому ни наличие ответа, ни его уверенный тон, ни совпадение с эталоном по отдельности не показывают, что решение было обосновано доступными документами.
Внешняя оценка достаточности вместе с самооценкой может улучшить выбор ответов при заданном охвате. Сигнал во внутренних состояниях позволяет классифицировать неотвечаемые примеры и исследовать механизм отказа, хотя требует доступа к модели и настройки. Контролируемый набор условий показывает, где именно система отвечает лишнего или отказывается зря. Каждый подход измеряет свою часть задачи и имеет собственные источники ошибок.
Для разработчика RAG практический вывод — проверять не только качество поиска и общую точность генерации. Нужны примеры с частичными, нерелевантными, отсутствующими и противоречивыми документами; отдельно следует измерять неверные ответы и потерянные полезные ответы. Порог отказа стоит выбирать под цену этих двух ошибок, а после изменения корпуса, модели или инструкции перепроверять его на данных, похожих на реальные запросы.
Исследования
-
Hailey Joren и соавторы. Sufficient Context: A New Lens on Retrieval Augmented Generation Systems [11], ICLR, 2025.
-
Maor Juliet Lavi, Tova Milo, Mor Geva. Detecting (Un)answerability in Large Language Models with Linear Directions [5], EACL, 2026.
-
Hantian Zhang, Wentai Wu. Do LLMs Know When Evidence is Insufficient? An Evidence Sufficiency Benchmark for Answer-Abstention Calibration in Retrieval-Augmented Generation [12], Computers, Materials & Continua, 2026.
Автор: im11211
Источник [13]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37733
URLs in this post:
[1] обучении: http://www.braintools.ru/article/5125
[2] поведение: http://www.braintools.ru/article/9372
[3] Sufficient Context: https://arxiv.org/html/2411.06037
[4] ошибки: http://www.braintools.ru/article/4192
[5] Lavi и соавторы: https://aclanthology.org/2026.eacl-long.29/
[6] поведением: http://www.braintools.ru/article/5593
[7] Zhang и Wu: https://www.techscience.com/cmc/v89n1/68467/html
[8] конфликте: http://www.braintools.ru/article/7708
[9] реакция: http://www.braintools.ru/article/1549
[10] памяти: http://www.braintools.ru/article/4140
[11] Sufficient Context: A New Lens on Retrieval Augmented Generation Systems: https://arxiv.org/abs/2411.06037
[12] Do LLMs Know When Evidence is Insufficient? An Evidence Sufficiency Benchmark for Answer-Abstention Calibration in Retrieval-Augmented Generation: https://doi.org/10.32604/cmc.2026.086343
[13] Источник: https://habr.com/ru/articles/1101200/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1101200
Нажмите здесь для печати.