Свои GPU плюс облако: как LLM-шлюз живёт в продакшене — ноды, отказы, ключи, обновления
В прошлой статье [1] я рассказывал про маршрутизацию и деньги в Keystone. The Model Switchboard. (KTMS), нашем open-source LLM-шлюзе на Go. Эта статья про эксплуатацию: как подключить свои видеокарты, что происходит, когда отказывает каждая зависимость, как менять ключи шифрования, как проверять, что вы скачали именно наш релиз, и как обновляться без простоя.
Часть 1. Свои GPU в общем пуле
Зачем
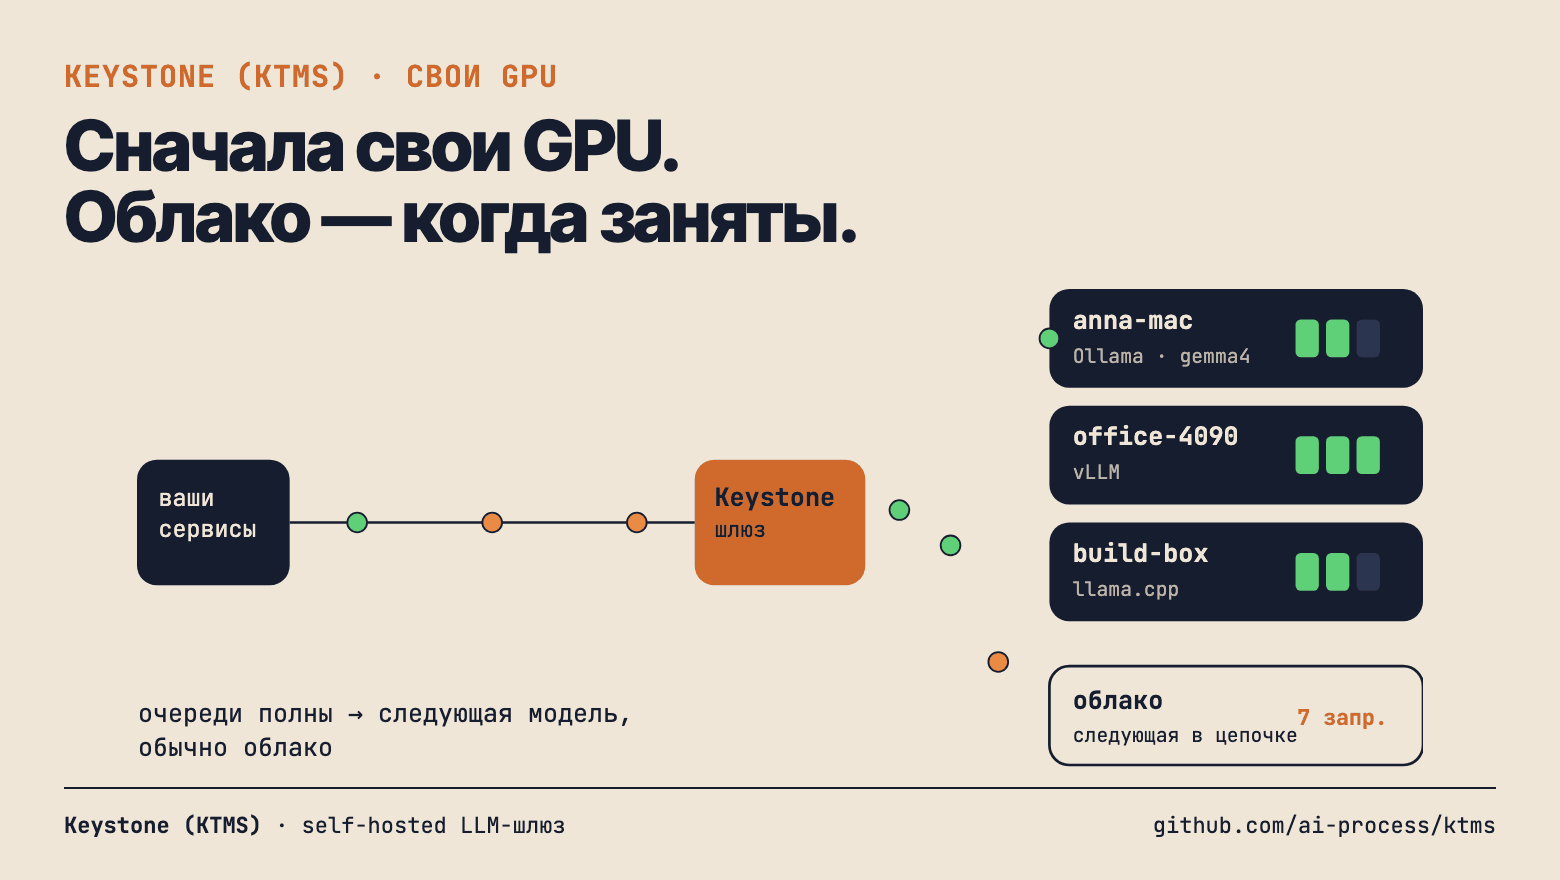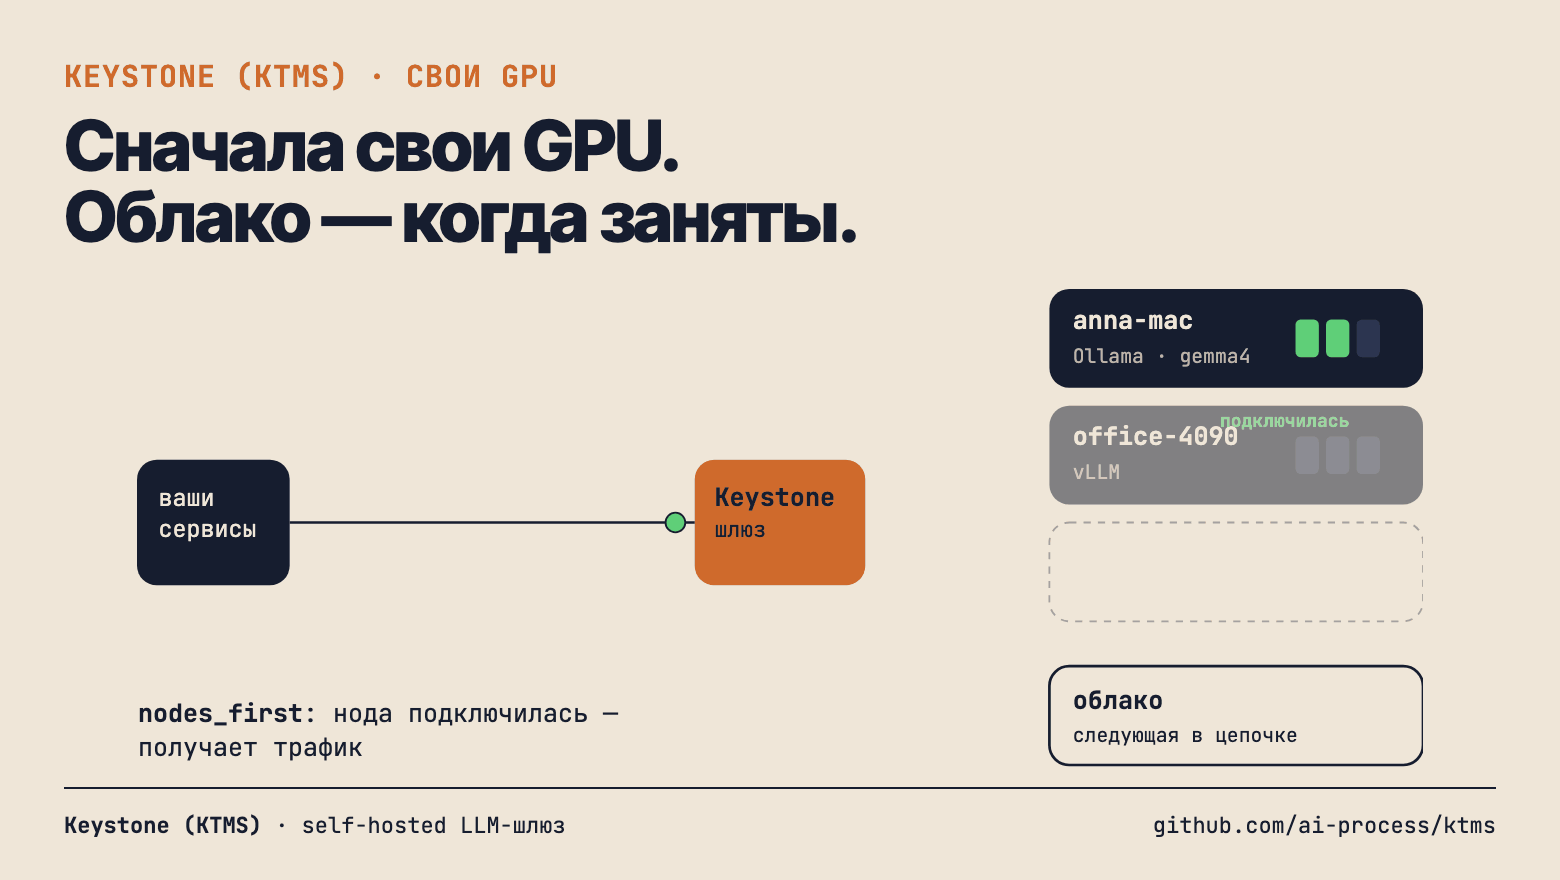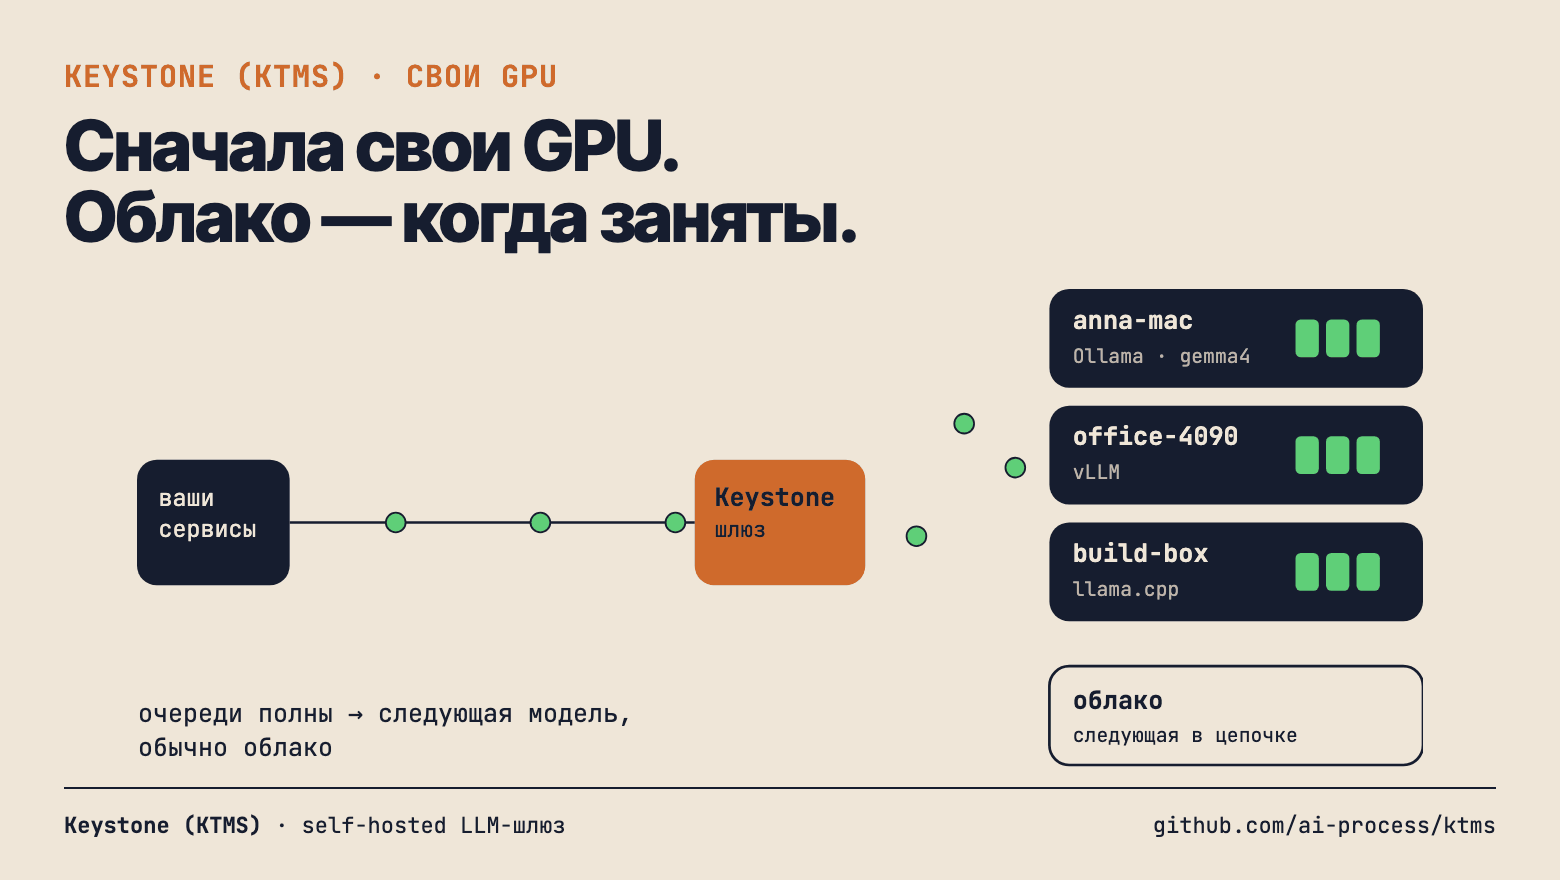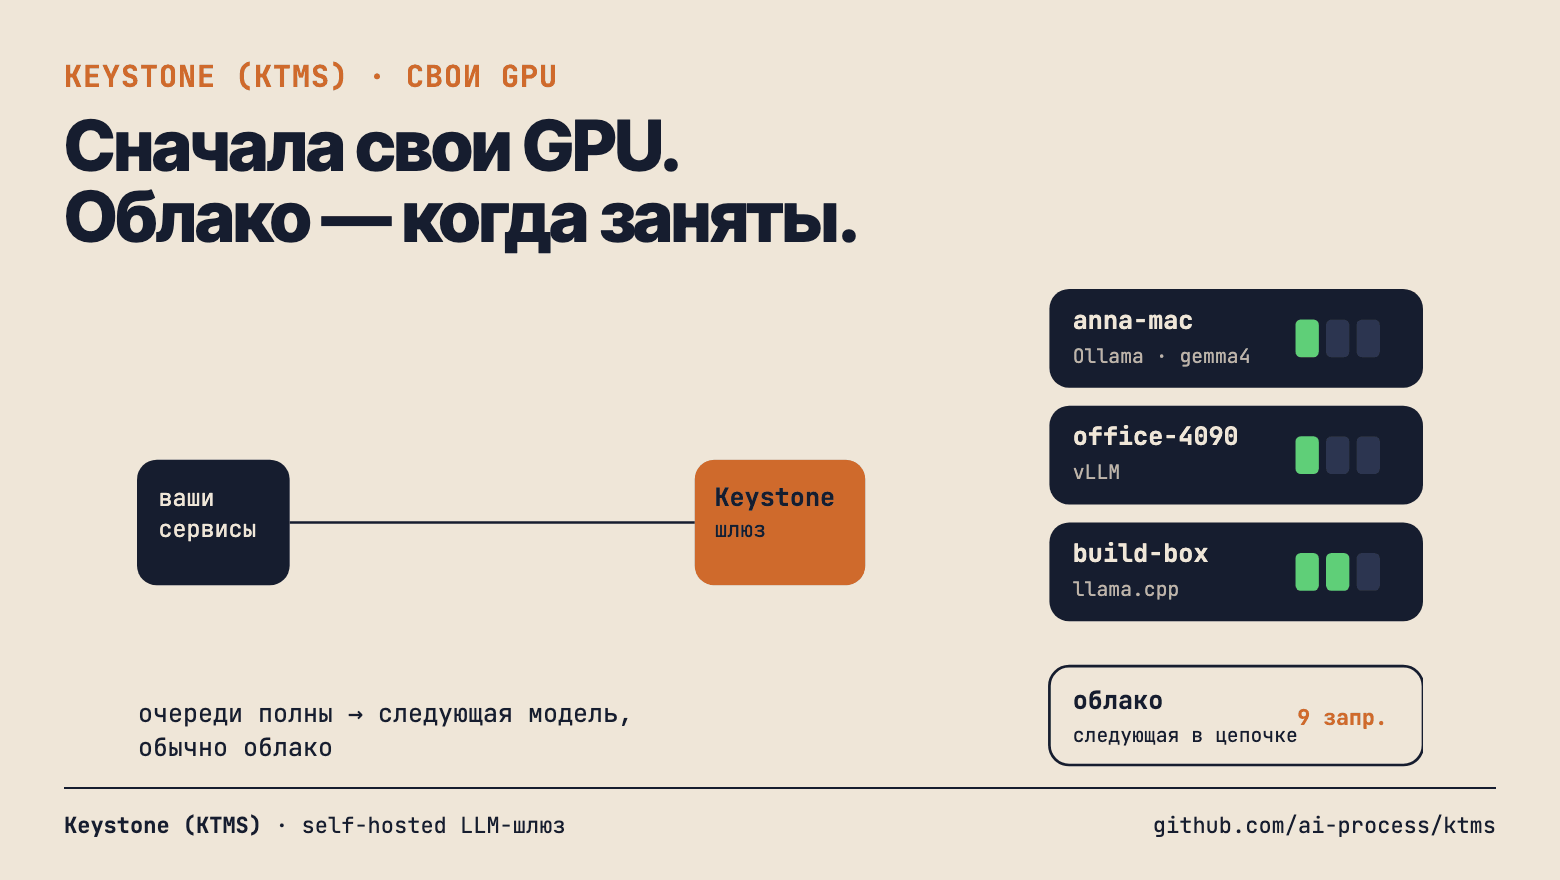
У многих команд есть Mac Studio или Linux-машина с хорошей картой, которая половину времени простаивает, и счёт за облачные запросы, на которые локальная модель ответила бы не хуже. Идея: дать шлюзу эти машины как ещё одного «вендора» (local) и отправлять на них запросы в первую очередь, а облако использовать, когда ноды заняты.
Подключение ноды одной командой
Администратор шлюза выдаёт ключ ноды, привязанный к её идентификатору, и регистрирует модель с vendor: "local" ($G — grpcurl с админским ключом, как в README):
$G "$ADMIN" -d '{"name":"anna-mac","node_id":"anna-mac"}'
  proxy.example.com:443 ktms.v1.AdminService/MintNodeKey      # ключ показывается один раз

$G "$ADMIN" -d '{"model":{"id":"gemma4:26b-a4b-it-qat","vendor":"local",
  "efforts":["EFFORT_LOW","EFFORT_MEDIUM"],"capabilities":["no_thinking"],
  "queue_timeout_ms":2000,"enabled":true}}'
  proxy.example.com:443 ktms.v1.AdminService/UpsertModel
На самой машине — одна команда:
curl -fsSL https://raw.githubusercontent.com/ai-process/ktms/v1.0.0/scripts/install-node.sh | sh -s --
  --proxy proxy.example.com --node-id anna-mac --model gemma4:26b-a4b-it-qat
Скрипт ставит Ollama, модель и агента ноды, запускает их как фоновые сервисы, не даёт машине уснуть и ждёт, пока нода зарегистрируется. На macOS не нужны права администратора. Повторный запуск обновляет только то, что изменилось, а новый агент, который не стартовал, откатывается. Если что-то не так, тот же скрипт с --doctor говорит простыми словами, что именно: Ollama не отвечает, модель не загружена, Ollama работает на CPU через Rosetta, неправильный --tls, ключ от другой ноды.
Шлюз сам ходит к ноде, поэтому нода должна быть доступна. Агент умеет поднять для этого быстрый туннель Cloudflare (--expose=cloudflared) и шлюз перед движком, который пропускает только POST /v1/chat/completions и GET /v1/models: скачать или удалить модель через него нельзя. Поддерживаются Ollama, vLLM, TGI и llama.cpp.
Как шлюз выбирает ноду
Агент каждые 5 секунд шлёт хартбит: загруженные модели, метрики GPU и собственную очередь движка — сколько запросов выполняется и ждёт (из /metrics у vLLM, TGI и llama.cpp; у Ollama такого API нет). Дальше для каждого запроса:
-
Фильтр. Остаются ноды, у которых есть модель, свободный слот и хватает контекстного окна для входа плюс
max_output_tokens. Сначала здоровые ноды, подозрительные — только если здоровых нет. Если у кого-то модель уже в памяти [2], рассматриваются только «тёплые» ноды. -
Вес. Эффективный вес ноды = базовый вес × штраф за загрузку × поправка на скорость. Штраф растёт квадратично с занятостью слотов. Поправка считается по скользящим средним скорости генерации (TPS, вес 0,7) и времени до первого токена (TTFT на 1000 входных токенов, вес 0,3) относительно медианы по всем нодам с этой моделью.
-
Выбор. Smooth weighted round-robin, тот же алгоритм, что в nginx.
Скорость меряется прямо в роутере, поэтому балансировка по скорости работает даже без сервиса учёта.
Допуск по очереди
Самое неприятное в локальных нодах — запрос, который встал в очередь и ждёт там дольше, чем ответило бы облако. Поэтому шлюз оценивает ожидание по закону Литтла: глубина очереди (свои занятые слоты плюс то, что движок сообщил как ожидающее сверх них) на ожидаемую длительность. Если ожидание больше queue_timeout_ms модели, запрос сразу идёт к следующей модели цепочки, обычно облачной. Для интерактивных клиентов ожидание ограничено 250 мс, чтобы не страдало время до первого токена.
Слот — это атомарная аренда в Redis, которая продлевается, пока идёт вызов, обычный или потоковый. Длинная генерация не освобождает слот, который нода ещё занимает.
Политики размещения
Политику задают заголовком, полем запроса или суффиксом модели: model: "auto:nodes-only:high".
Часть 2. Что происходит, когда отказывает зависимость
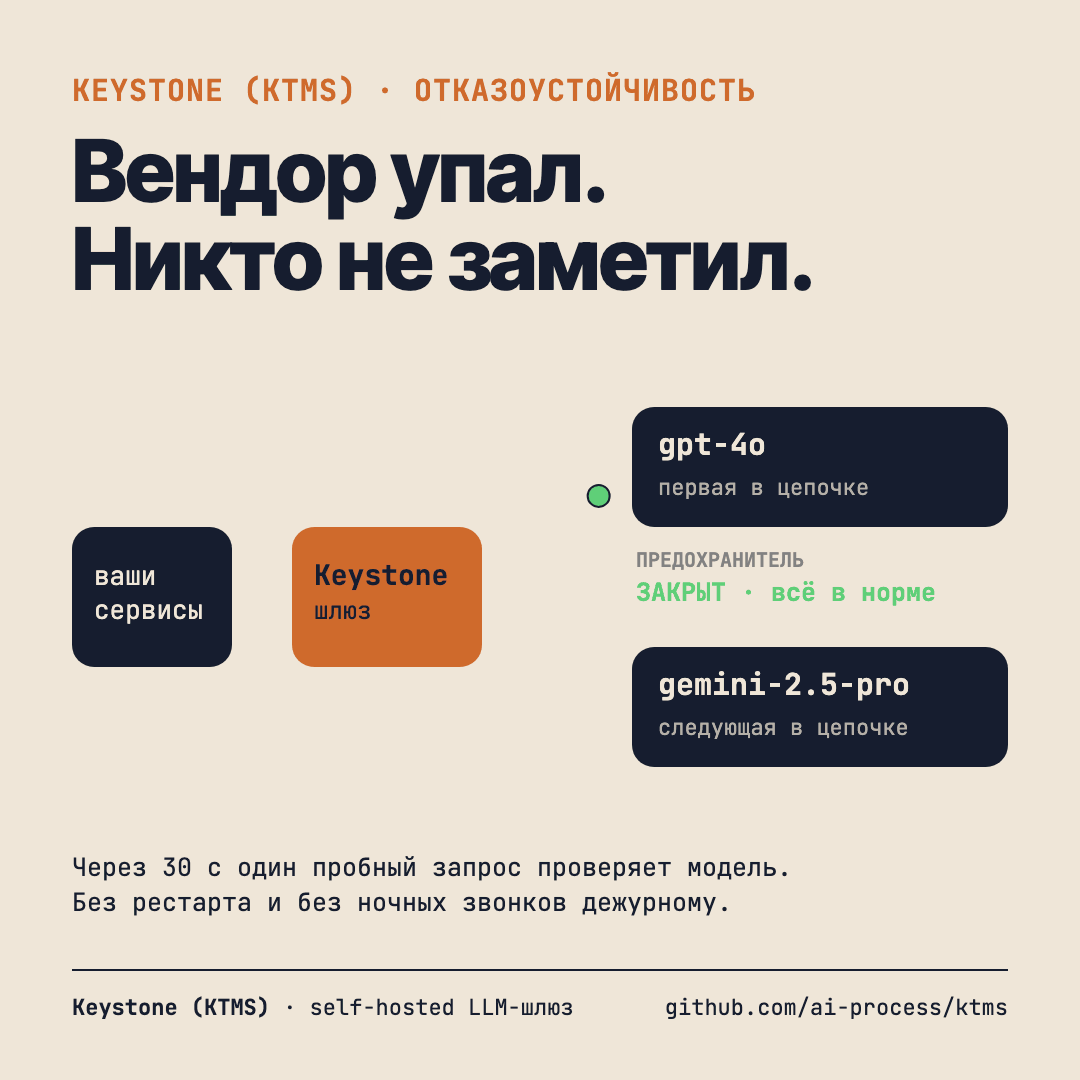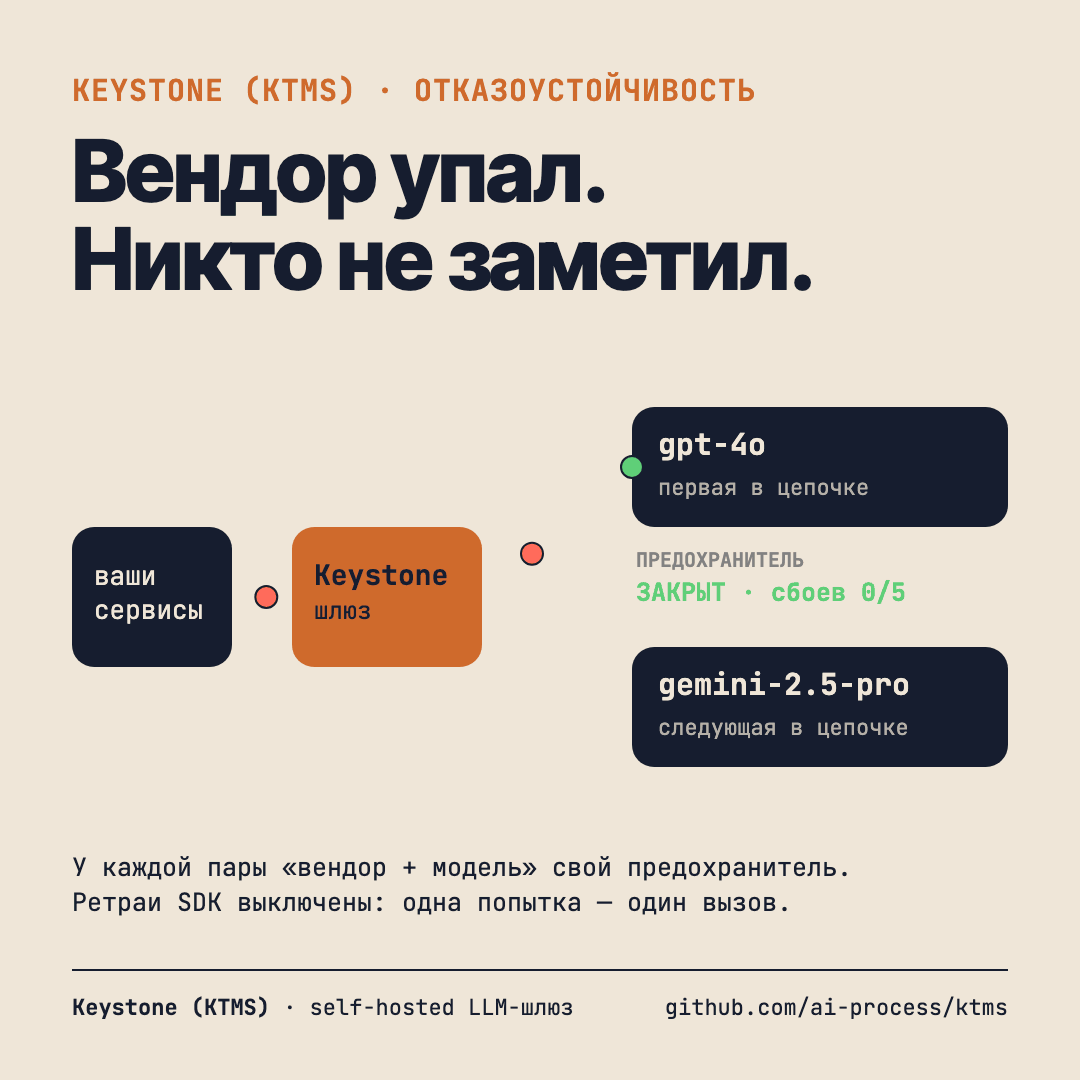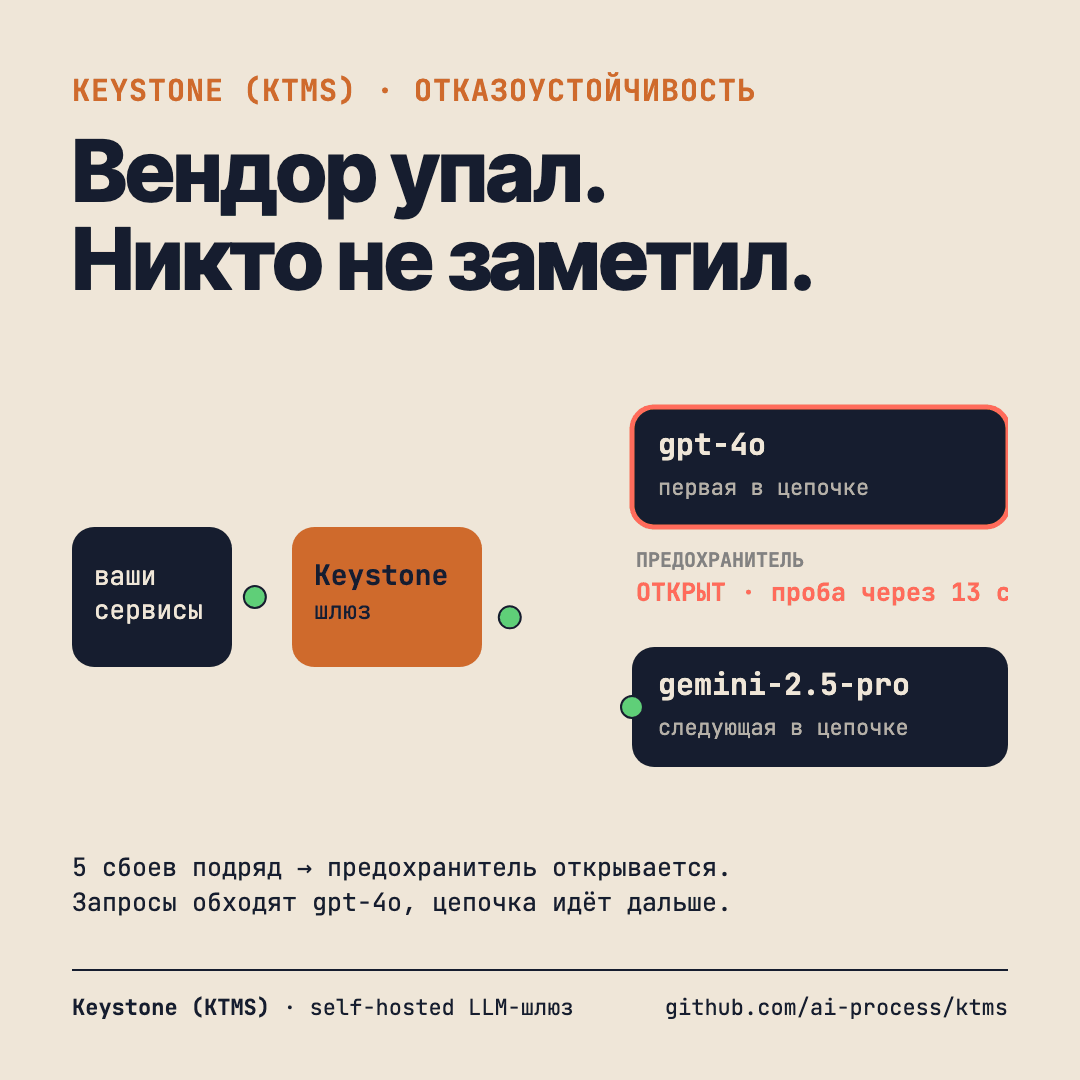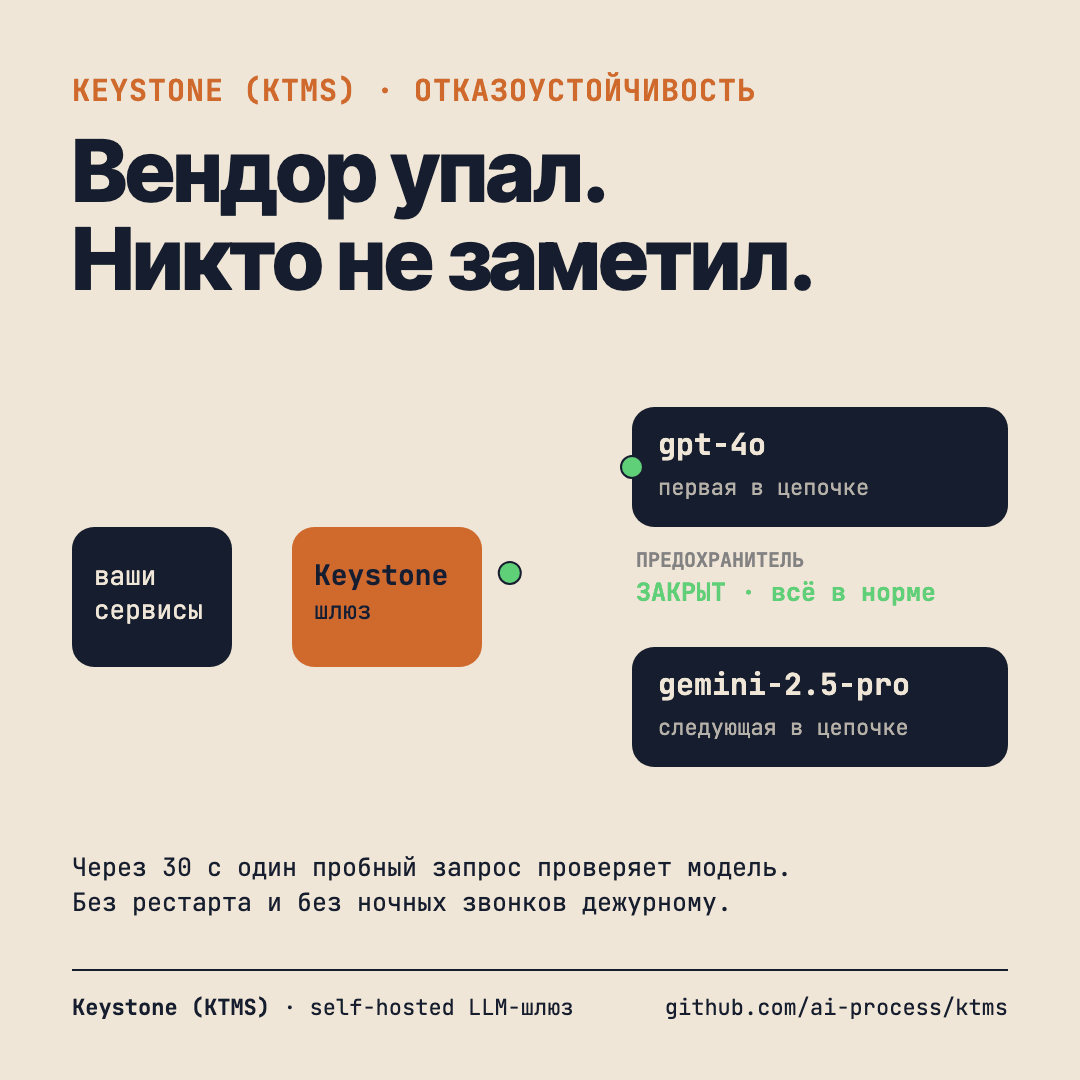
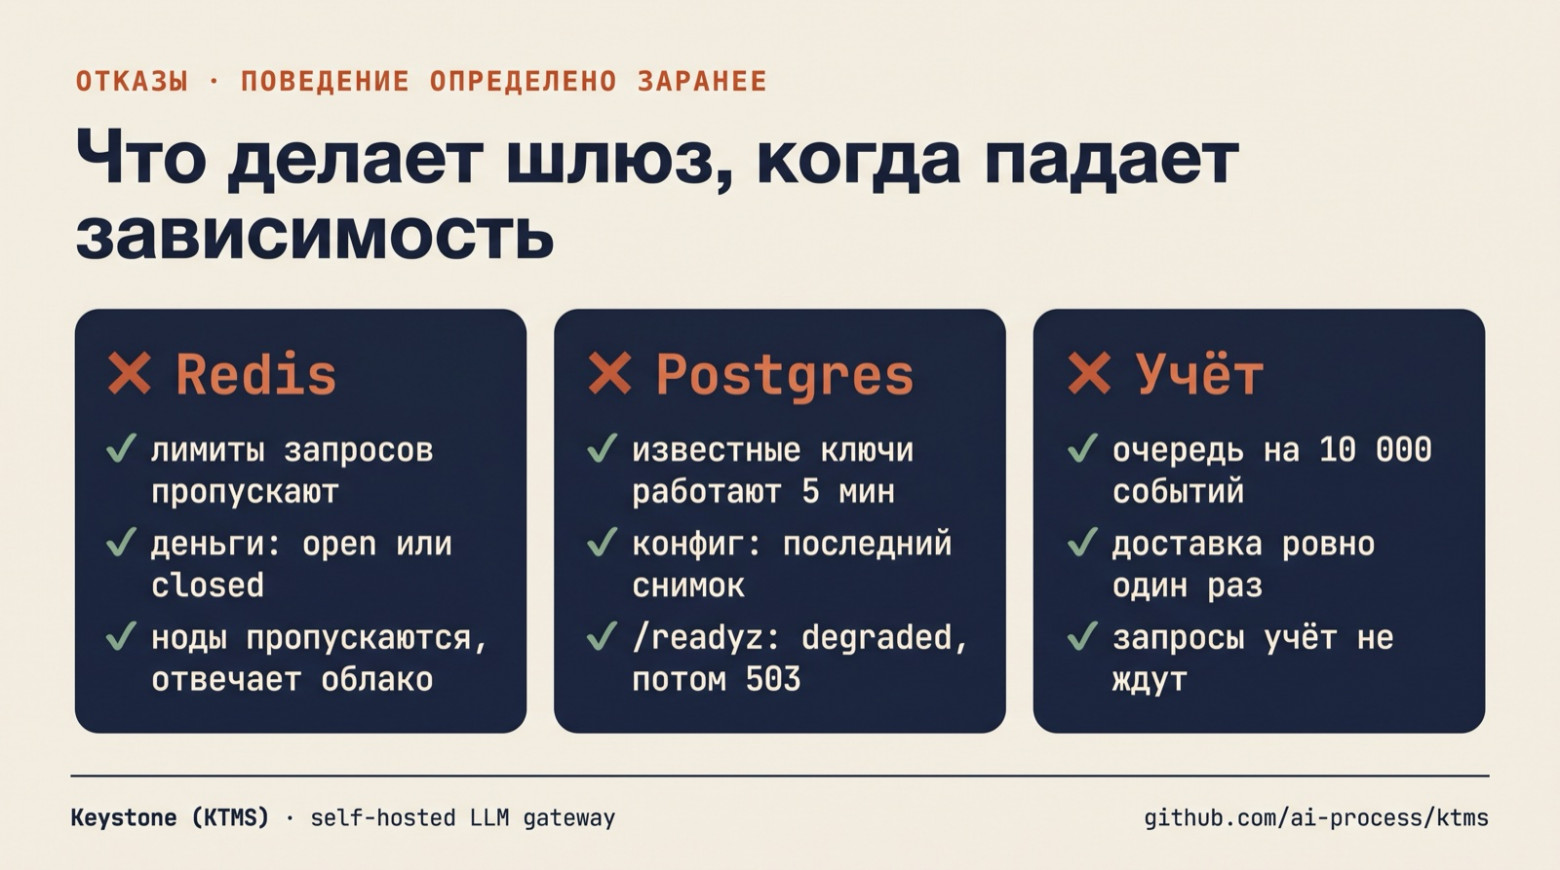
У шлюза три зависимости: Postgres (конфигурация и ключи), Redis (лимиты, кэш, пул нод) и сервис учёта. Для каждой поведение [5] определено заранее:
|
Зависимость |
Что ломается |
Что делает шлюз |
|---|---|---|
|
Redis |
Лимиты запросов и токенов |
Пропускает трафик без учёта: отказ учёта не должен становиться отказом сервиса |
|
Redis |
Лимиты в долларах |
На выбор: |
|
Redis |
Кэш ответов |
Считает промахом, не сохраняет |
|
Redis |
Пул локальных нод |
Состояние нод неизвестно, поэтому они пропускаются и отвечает облако. Ноду не считают свободной, если её состояние нельзя прочитать |
|
Postgres |
Проверка ключей |
Ключи, проверенные за последние 5 минут ( |
|
Postgres |
Конфигурация |
Работает последний удачный снимок, перезагрузка повторяется |
|
Postgres |
Админка, batch |
|
|
Сервис учёта |
События |
Очередь в памяти на 10 000 событий, повтор и доставка ровно один раз. Запросы учёт не ждут |
Ещё два свойства. После трёх подряд сетевых ошибок Redis шлюз 2 секунды не ходит в него вообще, поэтому зависший Redis стоит запросу одного таймаута, а не таймаута на каждую команду. И ничто из этого не требует рестарта: пулы и соединения восстанавливаются сами. Все ошибки зависимостей считаются в ktms_dependency_errors_total{dependency,operation} — на эту метрику стоит поставить алерт.
/readyz при отказе Postgres отвечает 200 со статусом degraded, пока действует окно для известных ключей, и 503 после. Kubernetes не перезапустит поды раньше времени.
Часть 3. Ключи шифрования
Ключи вендоров хранятся в Postgres, зашифрованные AES-256-GCM. Ключ шифрования (keyring) передаётся переменной KTMS_ENCRYPTION_KEYS и в базе не лежит. Keyring версионируемый: 1:<старый>,2:<новый>. Новые записи шифруются старшей версией, читать можно любой из перечисленных.
Ротация в три шага
-
Добавить новую версию и раскатать её на все реплики. Пока раскатка не закончена, не менять ключи вендоров: реплика со старым keyring не прочитает ключ, записанный новой версией. Если это всё же случилось, реплика не падает: она пишет ошибку, считает её в метрике и продолжает использовать ключ, который у неё уже был.
-
Один раз вызвать
RotateEncryptionна любой реплике. В одной транзакции, блокирующей переписываемые строки, она перешифровывает все ключи вендоров и токены зарегистрированных нод. Ключ, который задали в ту же секунду, не потеряется. Повторный вызов ничего не меняет. -
Убрать старую версию, но только когда не осталось бэкапов базы, которые придётся с ней восстанавливать.
Вся последовательность прогоняется на Postgres в CI.
Бэкапы
-
Бэкапьте Postgres: там всё долговечное, включая хэши клиентских ключей и зашифрованные ключи вендоров.
-
Бэкапьте keyring отдельно и храните не рядом с дампами. Дамп плюс keyring — это все ключи вендоров открытым текстом. Потерянный keyring — это потерянные ключи вендоров, их придётся задать заново.
-
После восстановления базы очистите ключи шлюза в Redis: кэш привязан к версии конфигурации, которую восстановление откатило.
Часть 4. Цепочка поставки
Шлюз хранит ключи всех ваших вендоров, поэтому вопрос «то ли я скачал» для него важнее, чем для обычной библиотеки.
-
Начиная с 0.14.0 образы подписываются cosign в режиме keyless: подпись привязана к OIDC-идентичности workflow в GitHub Actions, отдельного ключа, который можно украсть, нет. Подписан каждый платформенный манифест.
-
К образам прикреплены SBOM и SLSA-provenance, к архивам с бинарниками — SPDX SBOM. Файл
checksums.txtрелиза подписан. -
govulncheckдля linux и darwin на каждом pull request и перед релизом: известная уязвимость, достижимая из кода, роняет сборку. -
Релиз проходит гейт:
buf breakingи тест обновления против предыдущего релиза. Пока они не прошли, ничего не публикуется.
Проверка образа и бинарников:
V=v1.0.0
cosign verify coyl/ktms:${V#v}
  --certificate-identity "https://github.com/ai-process/ktms/.github/workflows/docker-publish.yml@refs/tags/$V"
  --certificate-oidc-issuer https://token.actions.githubusercontent.com
docker buildx imagetools inspect coyl/ktms:${V#v} --format '{{ json .SBOM }}'

cosign verify-blob checksums.txt --bundle checksums.txt.sigstore.json
  --certificate-identity "https://github.com/ai-process/ktms/.github/workflows/release.yml@refs/tags/$V"
  --certificate-oidc-issuer https://token.actions.githubusercontent.com
sha256sum --ignore-missing -c checksums.txt
Идентичность закреплена на точный тег: подпись из другой сборки или ветки не пройдёт. Но честно: подпись подтверждает происхождение, а не безопасность. Если кто-то получит права менять наш релизный workflow, он подпишет и вредоносный образ. От этого защищают уже права в репозитории, а не криптография.
Часть 5. Обновления без простоя
С 1.0 действует политика версий: в пределах 1.x публичный API (gRPC ktms.v1, HTTP /v1, переменные окружения, метрики, схема базы для обновлений) не меняется несовместимо.
-
Обновление в один шаг с любого 1.x: миграции применяются при старте под advisory-lock в Postgres.
-
Rolling-деплой работает: миграции только добавляют, поэтому реплики старой версии продолжают обслуживать мигрированную базу, пока стартуют новые.
-
Это проверяется: на каждом pull request тест поднимает базу предыдущего релиза и самого старого релиза мажорной версии, мигрирует её и снова запускает старую версию на новой базе.
-
Откат не поддерживается: у миграций нет шага вниз. Чтобы вернуться, восстановите бэкап, снятый перед обновлением.
-
На SIGTERM запросы в работе получают
SHUTDOWN_TIMEOUT(30 с) на завершение, а агент ноды сначала уходит в режим drain и ждёт, пока на нём закончатся запросы.
Часть 6. Наблюдаемость
-
Prometheus на отдельном порту:
ktms_*метрики фолбэков, пауз вендоров, ошибок зависимостей, потерянных событий учёта. Helm-чарт умеетServiceMonitor. -
OpenTelemetry для распределённой трассировки и Sentry для ошибок, по желанию.
-
Логи — структурированный JSON. Ключи вендоров, клиентские ключи и keyring в логи не пишутся.
-
Учёт расходов — одно событие на вызов в light-tokenmeter: вендор, модель, токены, стоимость, правило, нода, TTFT и TPS, ваши атрибуты. Консоль ktms-admin показывает по ним, кто тратит больше всех и стоит ли оно того.
Чек-лист эксплуатации
-
TLS перед шлюзом: сам он говорит plaintext gRPC.
-
Keyring в менеджере секретов, отдельно от бэкапов базы.
-
После создания настоящих ключей убрать
BOOTSTRAP_ADMIN_KEY. -
Redis, если нужны лимиты. Для денег решить,
openилиclosed. -
Свой ключ на каждый клиент — тогда расходы, модели и отзыв ключа тоже по клиентам.
-
Следить за числом соединений Postgres: до 25 на реплику по умолчанию.
-
Алерт на
ktms_dependency_errors_total. -
Деплой по дайджесту и проверка подписи.
Итог
Свои GPU в общем пуле, определённое поведение при отказе каждой зависимости, ротация ключей без потерь, проверяемые релизы и обновления без простоя — это то, что отличает шлюз для продакшена от прокси для прототипа. В Keystone всё это есть в 1.0 под лицензией Apache 2.0.
-
Репозиторий: github.com/ai-process/ktms [6]
-
Документация: ai-process.dev [7]
-
Как проверить релиз: SECURITY.md [8]
Автор: coylOne
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37774
URLs in this post:
[1] прошлой статье: https://habr.com/ru/articles/1099796/
[2] памяти: http://www.braintools.ru/article/4140
[3] Поведение: http://www.braintools.ru/article/9372
[4] ошибка: http://www.braintools.ru/article/4192
[5] поведение: http://www.braintools.ru/article/5593
[6] github.com/ai-process/ktms: http://github.com/ai-process/ktms
[7] ai-process.dev: http://ai-process.dev
[8] SECURITY.md: https://github.com/ai-process/ktms/blob/main/SECURITY.md#verifying-a-release
[9] Источник: https://habr.com/ru/articles/1100326/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1100326
Нажмите здесь для печати.