Наш ответ Гогену. Часть десятая: что же будет дальше?
Это завершающая статья данного цикла, в ней я попробую дать прогноз развития нашей цивилизации от сегодняшних дней до 2030 года (пытаться заглядывать еще дальше совсем уж авантюрно). Но будущее всегда вырастает из настоящего, соответственно, с него и имеет смысл начать как от отправной точки.
Итак, что мы наблюдаем прямо сейчас? Начнем, пожалуй, с матчасти. В настоящее время на данном рынке активно конкурируют два типа чипов – GPU [1] (Graphics Processing Unit) и TPU [2] (Tensor Processing Unit). Хотя и те, и другие, оптимизированы для задач, в которых активно используются операции перемножения матриц, их архитектуры ощутимо отличаются.
Исторически первыми появились GPU. Изначально они задумывались как средство ускорения вычислений для специфических графических задач, например, расчета в реальном масштабе времени 3D сцен, что было, в частности, остро необходимо для поддержки видеопотока в продвинутых игровых приложениях. Но уже к началу 10-х годов нынешнего века выяснилось, что они идеально подходят и для другой, гораздо более серьезной задачи – ускорения процесса глубокого обучения [3] нейросетей. Уже первые эксперименты продемонстрировали, что время обучения при примерно тех же конечных результатах можно уменьшить в десятки раз.
Ощутимое ускорение процесса обучения, в свою очередь, дало возможность обучать нейросети на огромных базах данных за разумное время. Например, сверточная сеть AlexNet [4], обученная с использованием всего двух графических карт NVIDIA GeForce GTX 580 на базе данных из более, чем миллиона изображений, с огромным отрывом победила в 2012 году на международном конкурсе по распознаванию изображений ILSVRC (ImageNet Large Scale Visual Recognition Challenge) все остальные программы, которые обучались традиционным способом на классических процессорах.
Соответственно, народ быстро просек, что “Бог на стороне больших батальонов”, и все дружно ринулись догонять. Софт для обучения сеток на графических картах становился все более удобным и простым для использования, а сами карты, в свою очередь, быстро совершенствовались под новые тенденции, в частности, уже в 2017 году NVIDA осознав, куда дует ветер, добавила в архитектуру своих чипов специальные ядра (Tensor Cores [5]) для ускорения операций с матрицами, которые активно используются в нейросетях. Другими словами, они выбрали путь добавления в уже существующую к тому времени архитектуру видеокарт дополнительных возможностей, ускоряющих их работу с нейросетями.
По альтернативному пути пошла корпорация Гугл, которая начала продвигать специальные TPU чипы, разработанные конкретно для оптимизации вычислений, необходимых при обучении и работе (режим inference) нейросетей. Никаких других задач такие чипы выполнять не могут, но, зато, на вычисления, востребованные при работе с нейросетями, они тратят в разы меньше энергии, и, соответственно, денег, чем универсальные чипы, выпускаемые NVIDA. При этом, надо понимать, что TPU чипы по сравнению с GPU менее универсальны и требуют больше времени для настройки на конкретную архитектуру сети. Кроме того, они сейчас пока доступны практически исключительно в облаках Гугла, так что, каждая из двух рассмотренных выше технологий имеет свои преимущества и недостатки.
Интересно, что, с одной стороны, сами TPU чипы проектируются и совершенствуются во многом с помощью ИИ системы AlphaChip [6], а NVIDA, со своей стороны, исследует [7] возможности специальной обвязки Claude Opus 5 для улучшения архитектуры собственных GPU. Таким образом, пугающее многих предсказание некоторых гиков о том, что ИИ скоро может войти в режим самосовершенствования, похоже, уже частично сбывается.
Но и это еще не все, на стадии разработки и тестировании прототипов находится еще одна технология – так называемые нейроморфные [8] чипы, которые так же часто ассоциируют [9] с подходом Compute-in-Memory (вычисления прямо в памяти [10]). Суть в том, что это, по сути, аналоговые устройства почти буквально копирующие однонаправленное распространение сигналов между нейронами по синапсам. То есть, это, в каком-то смысле, возвращение к исходной версии персептрона Розенблатта [11], но, конечно, на совсем другом уровне. Если в персептроне функции синапсов выполняли потенциометры [12], то в случае нейроморфных чипов эти функции выполняют мемристоры [13].
Каковы основные достоинства и недостатки нового подхода? Достоинств, по большому счету, два. Первое – для многих задач несмотря на необходимость преобразования цифрового сигнала в аналоговый для подачи его на вход сети, и последующей оцифровки аналогового сигнала, генерируемого на ее выходе, итоговая скорость обработки все равно в итоге возрастает. Второе – для сравнительно небольших по размеру сетей охлаждение вообще не требуется, и, как результат, они потребляют на два порядка меньше энергии, чем классические решения, основанные на цифровых технологиях (то есть, GPU и TPU).
Что касается огромных вычислительных кластеров, содержащих сотни и тысячи нейроморфных чипов, тот тут без охлаждения все же не обойтись, но и в этом случае затраты на него оказываются ощутимо меньше, чем для цифровых микросхем со сравнимой производительностью. В сухом остатке получается, что общая стоимость вычислений при условии налаживания массового производства соответствующих чипов будет ощутимо ниже, ведь сигнал, поданный на вход, далее сам по себе свободно перетекает из слоя в слой по сути почти без затрат энергии.
Рассмотрим теперь минусы новой технологии, ибо их тоже хватает. Во-первых, ее вообще нельзя применять для обучения нейросетей, так как сопротивление мемристора фиксируется уже на этапе его производства. Таким образом, выигрыш можно получить только в инференс режиме после предварительной настройки весов сети с помощью классических методов оюучения. Во-вторых, так как технология основана на аналоговых сигналах, а сопротивление любых реальных материалов, включая те, из которых сделаны мемристоры, хоть немного, но все же меняется с течением временем, срок эксплуатации рассматриваемых устройств, по мнению специалистов, вряд ли будет превышать 10 лет. Наконец, в третьих (и это самое главное), описанную технологию можно применять лишь для сравнительно простых нейросетей без петель обратной связи. Это условие сразу оставляет за боротом много современных архитектур включая рекуррентные сети и LLM.
Одним из наиболее перспективных способов использования в будущем нейроморфных чипов благодаря их низкому уровню потребления электричества считается робототехника. Как альтернативу им в данной области некоторые производители рассматривают усовершенствование традиционной технологии производства чипов в сторону ощутимого увеличения их энергоэффективности. В частности, [14]компания Micron сейчас активно разрабатывает новую архитектуру EIM (Edge Inferenc Memory [14]) с модулями оперативной памяти LPDDR (Low-Power Double Data Rate) специально адаптированными для ускорения нейросетей с одновременным уменьшением их энергопотребления.
По оценкам самой компании, новые чипы смогут поддерживать вычисления, необходимые для автономной работы моделей, содержащих до 2 млрд параметров. Их серийной производство собираются наладить во второй половине 2028 года. Предполагается, что они будут эффективны в робототехнике благодаря возможности запуска нейросетей прямо “на борту” с экономным энергопотреблением. Важным преимуществом архитектуры EIM перед нейроморфными чипами является так же возможность запуска на них нейросетей с любыми современными архитектурами, независимо от наличия у них контуров обратной связи.
Итак, какие из перечисленных технологий будет использоваться в 2030 году? Рискну предположить, что все четыре сохранятся, так как они покрывают ощутимо различные рыночные ниши. Классические GPU будут по прежнему доминировать как самое мощное и универсальное решение как для режима инференс, так и для обучения моделей. В то же время, при обучении и эксплуатации самых больших и мощных моделей еще большую роль, чем сегодня, будут играть гугловские TPU как более экономичные и дешевые в эксплуатации.
Нейроморфные чипы, как мне кажется, тоже займут определенные ниши рынка, особенно, на нижних уровнях систем технического зрения [15] и распознавания других сигналов из внешней среды. Кроме того, их высокая скорость работы и энергоэффективность может обеспечить будущим андроидам некий аналог безусловных рефлексов [16]. Наконец, все большую роль, в частности, в той же роботике, будут играть архитектуры, подобные EIM. Они смогут поддерживать поведение [17] роботов при выполнении ими среднесрочных заданий, используя в качестве входных данных сигналы с первичных датчиков и камер либо непосредственно, либо после предобработки их нейроморфными чипами.
Попробуем теперь оценить тенденции и перспективы прогресса в области софта нейросетей. Одним из основных показателей мощности LLM является количество используемых ею параметров, что очень условно соответствует количеству синаптических связей в головном мозге. Это число в передовых моделях компании OpenAI (а других контор с подобным профилем и размахом вплоть до начала 20-х годов просто не было) исходно росло очень стремительно, прибавив за пять лет примерно четыре (!) порядка.
Однако, после выхода в марте 2023 года во многом прорывной модели GPT-4 чисто количественный прогресс в этой области резко замедлился – за прошедшие с тех пор три с половиной года указанное число выросло лишь в 4 раза. Причины замедления лежат как в существенном удорожании “железа”, необходимого для обучения и последующего использования моделей такого огромного размера, так и в желании самой компании OpenAI переключиться с улучшения путем грубой силы, то бишь, простого наращивания размера моделей, на улучшение за счет усовершенствования самой их внутренней структуры.
Любопытно посмотреть, как число параметров в самых передовых LLM соотносится с числом синоптических связей в мозгу взрослого человека. Например, выпущенная в сентябре этого года GPT-6 Astra [18] содержит, по разным оценкам, примерно от 5 до 10 триллионов параметров. В то же время, количество межнейронных связей в мозгу Хомо Сапиенс оценивается в интервале от 100 до 150 триллионов. Как нетрудно заметить, разница на сегодняшний день примерно в 20 раз.
Если тенденция по скорости роста продолжится в том же темпе, то примерно к 2030 году количество “виртуальных” синапсов в моделях достигнет уровня взрослого шимпанзе (по оценкам от 22 до 28 триллионов), а к 2034 году станет сравнимым по этому параметру с мозгом человека [19]. При этом следует лишний раз напомнить, что, с одной стороны, такое сравнение очень условно и во многих отношениях не корректно, а с другой стороны – в мозге заложена очень большая степень избыточности. Кроме того, достаточно большая доля синапсов у человека отвечает за функции, которые вовсе не нужны классической LLM (обработка информации от органов чувств [20], управление мышцами тела, навигация в пространстве и т.д.).
Пожалуй, одно из самых главных отличий современных LLM от реального биологического мозга – невозможность перестраивать нейронные связи в реальном масштабе времени. Человек может легко запоминать новую информацию, встраивая ее на лету в массив уже хранящейся в мозгу и координировать новые данные с прежними. Но для современных LLM это не так. Что бы обновить информацию, хранящуюся в синапсах, на более актуальную, классические модели сейчас нужно, по сути, каждый раз заново обучать с нуля. Попытки дообучения их на лету, то есть, совмещения этого процесса с одновременным продолжением использования модели (так называемый Online Learning), как правило, приводят к эффекту катастрофического забывания [21] – при встраивании в сеть новых данных из-за обновления весов теряется существенная часть уже сохраненных ранее в сетке важных старых данных.
В настоящее время наиболее эффективным способом решения указанной выше проблемы считается добавление к основной сетке дополнительных сетей меньшего размера, которые обучены для конкретных проблемных областей. Данный подход принято называть Mixture of Experts [22] (MoE). Он позволяет по мере необходимости заливать в уже существующие модели новые данные, не трогая при этом основное ядро с базовыми данными. Кроме возможности дополнительной адаптации к новой информации подход MoE так же ощутимо удешевляет работу LLM, так как при обработке запроса отрабатывают с соответствующей затратой токенов не все экспертные сети, а только те, которые могут содержать необходимую для ответа информацию. Например, в последней модели OpenAI Astra в процессе ответа в среднем активируются связи, соответствующие лишь около 12% параметров.
Еще одной давней проблемой нейросетей является отсутствие возможности расширения набора типовых задач, с которыми они могут работать, если соответствующие им примеры не встречались в обучающей выборке при первичном обучении. Например, предположим, что возникла необходимость научить классическую LLM играть в крестики-нолики и го. Для человека это обычно не представляет проблемы, на протяжении всей жизни мы учимся решать новые задачи, наш мозг умеет это делать практически в реальном масштабе времени. А вот даже для современных нейросетей это серьезный вызов. Одним из возможных путей его преодоления является так называемый подход Model-Agnostic Meta-Learning [23] (MAML) позволяющий, при необходимости, дообучать модели работе с задачами, которые она ранее не видела.
Его суть состоит в том, что бы не переобучать всю сеть с нуля, что занимает много времени и вычислительных ресурсов, а попытаться использовать обученные для уже существующих классов задач значения параметров θ. В этом случае дообучение начинается с текущего, уже оптимизированного под начальный типовой набор задач состояния параметров θ, и от этой точки для новых задач реализуется классический градиентный спуск, оптимизируя на небольшой выборке значения параметров именно под них (так называемый внутренний контур). Обозначим это новое полученное состояние параметров как θ’.
На следующем этапе мы обучаемся уже на полном обновленном множестве задач (все старые задачи плюс несколько новых) и на выборке гораздо большего размера (так называемый внешний контур). Идея состоит в том, что бы стартовав опять из точки θ осторожно двигаться в сторону точки θ’, пытаясь найти где-то примерно на полпути между ними компромиссную область, в которой и старые классы узнаются почти так же хорошо, что и раньше, и эффективность работы для новых классов не сильно хуже, чем в точке θ’.
Другим важным отличием ранних LLM от мозга было отсутствие у них собственной памяти об истории их диалогов с пользователями. Единственное, что помогало модели хоть как-то поддерживать нить разговора, было диалоговое окно броузера, но стоило его закрыть, как и эта зацепка пропадала, и вся память о собеседнике и разговоре с ним полностью исчезала. Модели были в этом смысле похожи на людей, подверженных амнезии, они были абсолютно лишены возможности хоть что-то запомнить из своего предыдущего опыта [24].
Первые попытки улучшить ситуацию были предприняты компанией OpenAI в 2024 году. Новые модели могли автоматически вычленять из диалога с пользователем конкретную новую информацию о нем, сохранять ее в его персональном профиле в сжатой форме, и впоследствии использовать для улучшения качества ответов на его вопросы. В 2025 году ChatGPT получил при “обдумывании” ответа возможность доступа ко всем прошлым диалогам с конкретным пользователем, что позволяло учитывать при ответах ему даже те факты, которые ранее были признаны несущественными и, соответственно, не были сохранены в профиле.
Наконец, летом текущего года OpenAI довело дело до логического конца, внедрив систему Dreaming [25]. Как понятно из названия, это фоновый процесс, в чем-то похожий на анализ полученной за день информации и запоминания [26] наиболее важных эпизодов и фактов из жизни человека в долговременной памяти [27], который, как считается, происходит во сне [28]. При этом, LLM регулярно осуществляет динамическое обновление информации о собеседнике, например, если исходя из предыдущих диалогов с пользователем она считала, что он живет один, но в процессе нового разговора он упомянул о живущей вместе с ним жене или подруге, то модель это учтет и внесет соответствующие поправки в свои сведения о нем. С некоторой небольшой задержкой и другие компании, выпускающие свои LLM (в первую очередь, Anthropic и Google) начали внедрять в них режим долгосрочной памяти, работающий на принципах, аналогичных реализованным в продуктах OpenAI.
Интересно, что резкое подорожание оперативной памяти, наблюдающееся на мировых рынках последние пару лет (как известно, объем производимой оперативки сейчас удваивается примерно каждые 6-7 месяцев) вызвано не столько увеличением размера (количества параметров) современных моделей, сколько необходимостью хранения в процессе диалога с пользователем результатов промежуточных вычислений для предыдущих токенов (так называемый KV-cache [29]). Без этого объем необходимых вычислений возрастал бы в зависимости от длины диалога не линейно, а квадратично, что сделало бы просто невозможными достаточно длинные диалоги, реализацию технологии “цепочки мыслей” (Chain of Thought [30]) и использование агентов, которые без кэширования своих токенов тоже далеко не уедут.
Раз уж мы упомянули про агентов, очень кратко поясним, кто (или все таки что?) такие агенты, которые относительно недавно появились на сцене развития ИИ. После первых восторгов, связанных с выходом на рынок массовых интернет пользователей модели GPT 3.5 достаточно быстро пришло осознание, что, по большому счету, для большинства юзеров это просто прикольная игрушка, с которой можно поболтать на любые темы, но и не более того.
Да, наиболее продвинутые пользователи сети сразу стали с переменным успехом пытаться применять новинку для каких-то практических задач – получения советов по лечению домашних животных, написания обзоров научных статей, использования модели в качестве персонального психотерапевта и т.д., но этого, очевидно, было мало как для дальнейшей коммерциализации будущих продуктов в данной области, так и для вовлечения в финансирование перспективных стартапов консервативных инвесторов. По сути, “голую” LLM можно уподобить чему-то вроде головы профессора Доуэля [31] из известного романа фантаста А. Беляева. С моделью, как и с головой, можно было поговорить на любые темы, но без тела она сама была совершенно беспомощна и для любого активного действия вынуждена была просить помощи со стороны.
Таким образом, сама собой возникла идея создания неких искусственных акторов, называемых агентами, которые бы имели возможность выхода в интернет с правами, приближенными к правам любого зарегистрированного пользователя. Они, кроме беседы с человеком в “песочнице” могли бы с помощью “мозга” в виде конкретных моделей LLM автономно решать поставленные им задачи, совершая активные действия в сети. Принято считать, что основой для реализации указанного подхода явилась статья «ReAct: Synergizing Reasoning and Acting in Language Models» [32], выпущенная группой исследователей Google в октябре 2022 года.
Основная идея в ней была в том, что бы организовать замкнутый цикл, позволяющий моделям переходить от пассивных “мыслей” к активным действиям, то есть, инициировать цепочку “Мысль” => “Действие” => “Наблюдение (за результатом действия)” => “следующая мысль”. Такой цикл в каком-то смысле ассоциируется с аналогичным циклом в процессе жизнедеятельности человека. Действительно, когда мы выполняем некую задачу, то, независимо от уровня ее сложности, наша активность обычно представляет из себя последовательность шагов с циклами обратной связи, когда мы, с одной стороны, осуществляем какие-то операции во внешнем мире, а с другой стороны, одновременно их контролируем и при необходимости корректируем для того, что бы конечный результат соответствовал нашим исходным целям.
Как правило, агенты имеют доступ к определенному набору инструментов, например, они могут вызывать нужные им для работы API, писать и запускать необходимые для достижения назначенных человеком целей скрипты, искать нужную информацию в БД, отправлять и получать электронные письма, пользоваться мессенджерами и т.д. Оснащенные такой оберткой, они уже сейчас по некоторым направлениям могут трудиться над выполнением поставленной человеком цели с эффективностью, сравнимой с той, что характерна для среднестатистического обитателя офиса. Насколько важно взаимодействие ИИ агента с набором приданных ему инструментов ясно из простого сравнения его работы с работой живого сотрудника. Будучи лишен всех доступных ему инструментов, таковой сотрудник, пользуясь исключительно своим мозгом, вряд ли сможет без помощи калькулятора или хотя бы бумаги с ручкой даже просто перемножить в уме два четырехзначных числа, не говоря уже о более сложных действиях.
Каковы могут быть типовые задания, даваемые агентам? Например, один из них может выбрать наиболее подходящий для вкусов пользователя и, в то же время, наиболее приемлемый с точки зрения его финансовых возможностей ресторан, заказать в нем столик на определенное время, при необходимости вызвать такси для соответствующей поездки и т.д. Другой агент, специализирующийся на оптимизации продаж в области розничной торговли может, скажем, отслеживать запасы одежды на складах, при необходимости делать заказы на их пополнение, анализировать тренды моды текущего сезона, и в зависимости от них и от спроса корректировать цены на конкретные товары и т.д. и т.п.
Итак, агенты в связке с LLM и дополнительными инструментами могут уже сейчас выполнять в сети определенный круг задач, которые раньше были возложены, в частности, на офисный планктон или на личного секретаря. Но как обстоят дела с реальным, а не виртуальным миром? В принципе, в перспективе ситуация здесь во многом похожа с тем лишь уточнением, что в качестве условных агентов могут выступать антропоморфные роботы, использующие созданные ранее людьми для себя инструменты и приспособления.
При этом, проблему обучения роботов выполнению практических задач в реальном мире можно условно разделить на две две части – обучение выполнению простых однотипных конкретных действий, таких как, например, закручивание гаек на конвейере при сборке автомобиля, и обучение выполнению более сложных задач, требующих планирования и возможности самостоятельного решения непредвиденных заранее проблем, если что-то пойдет не так. Удобно рассмотреть это более конкретно на примере подхода Google, который в настоящее время активно разрабатывает общую универсальную многоуровневую программную платформу для управления роботами.
Предполагается, что на нижнем уровне этой платформы будут работать модели класса VLA [33] (расшифровывается как Vision-Language-Action, то есть, Зрение-Язык-Действие). Идея заключается в том, что бы создать единую систему управления исполнительными механизмами, так называемыми актуаторами [34] (actuators), которая позволит обучать разные конкретные модели ходить, удерживая равновесие, приседать, выполнять манипуляции руками с объектами реального мира, включая те, что требуют мелкой моторики пальцев и т.д. В настоящее время в роботике используются актуаторы трех типов – электрические, гидравлические и пневматические. В идеале VLA модель должна принимать команды моделей более высокого уровня через API или подданые голосом от человека, связывать их с визуальной картинкой, обеспечиваемой встроенными видеокамерами и, в итоге, исполнять эти команды с помощью актуаторов.
Упомянутой выше моделью более высокого уровня может быть, например, выпущенная в августе этого года Gemini Robotics ER 2 [35]. Она предназначена для среднесрочного планирования и реализации уже спланированных действий роботов. Например, предположим, что человек дал команду – “Возьми рубашку, висящую на спинке стула, и помести ее в корзину для грязного белья”. В этом случае модель должна вначале найти именно тот стул, который имеется в виду, потом (если она находится в еще не знакомой ей квартире) найти корзину, аккуратно взять со спинки стула рубашку, отнести ее к корзине, открыть крышку, и, наконец, бросить рубашку в корзину. Мы выполняем подобные действия автоматически, почти бессознательно, но даже для современных моделей это все еще настоящий квест.
Важным требованием для многих практических применений роботов является их способность работать автономно, то есть, даже тогда, когда нет возможности выхода в интернет. В этом случае достаточно сложную нейросеть нужно размещать прямо внутри робота и остро встает вопрос об оптимизации моделей, которые им управляют, и, в первую очередь, о выборе их разумного размера и энергоэффективности используемой в них памяти. Как уже упоминалось выше, для автономной работы роботами могут быть использованы нейроморфные чипы либо специально разработанные архитектуры, основанные на более традиционных решениях типа EIM. Кроме того, этим летом Гугл объявила о выходе оптимизированной именно конкретно для автономной работы нейросетевой модели класса VLA – Gemini Robotics On-Device 2 [36].
Наконец, уже в процессе работы над данной статьей пришла новость о выходе еще одной модели от Гугл – Google Gemini 4 Argon [37]. Эта новейшая мультимодальная модель имеет очень широкий спектр применения, включая универсальных, и, в значительной степени, автономных роботов. Пока информации о ней мало, но из того, что известно, можно заключить, что она в указанной области может осуществлять планирование и выполнение гораздо более долгосрочных задач, чем упомянутая выше Gemini Robotics ER 2, к которой она при необходимости выполнения рутинных действий может сама непосредственно обращаться.
Кроме того, заявлено, что Google Gemini 4 Argon может учиться выполнению новых задач после просмотра всего 1-2 примеров видео, в которых человек выполняет соответствующую работу. Это разительно отличается от традиционных моделей VLA, которым для этого, как правило, требуются десятки и сотни часов обучающего видеопотока (некоторые компании даже заставляют рабочих, трудящихся на конвейере нацеплять на лоб веб-камеру что бы автоматически записывать все их действия для возможности в дальнейшем обучения на них моделей класса VLA).
По мнению ряда авторов Google Gemini 4 Argon может совершить реальный прорыв в робототехнике. Например, утверждается, что она продемонстрировала рекордный результат в 87% на бенчмарке Embodied Reasoning, который оценивает способность искусственного интеллекта [38] решать реальные задачи, требующие ориентации в трехмерном пространстве и понимания поведения [39] объектов в физическом мире. Кроме того, сообщается, что модель способна работать автономно в течение нескольких часов над одной масштабной задачей, не теряя при этом концентрации, что тоже очень важно для повышения автономности ботов.
Революционные достижения Argon, относящиеся к значительному улучшению процесса самообучения, во многом основаны на подходе Video-to-Sim-to-Rea [40]l. Его суть в том, что после просмотра соответствующих видео, проясняющих, как человек решает определенные задачи, нейросеть создает в специальной виртуальной среде MuJoCo [41] ее симуляцию, учитывающую законы физики, геометрию пространства и другие важные свойства реального мира. Именно это позволяет ей обучаться на очень ограниченном наборе примеров, так как он может быть в огромной степени расширен за счет симуляции внутри модели альтернативных сценариев. Например, в одном из экспериментов модели показали видео, в котором человек пытается забрасывать мешочки в лузу (так называемая игра корнхол [42]). Лишь на основе этого единственного видео Argon сама всего за несколько часов построила модель поведения для гуманоидного робота Apollo от компании Apptronik [43], который после этого с первой же попытки сделал семь точных бросков.
Кроме того, как говорится, не андроидами едиными. В другом эксперименте Argon “поселили” в тело знаменитой собаки-робота Spot [44] от Boston Dynamics. Она достаточно быстро научила ее подходить к мусорному ведру, наступать лапой на педаль, чтобы крышка открылась, а потом аккуратно сбрасывать туда жестяные банки. На видео ниже показан весь процесс как со стороны внешнего наблюдателя, так и глазами самого робота.
Итак, что же будет происходить на планете по имени Земля, вращающейся вокруг звезды по имени Солнце в 2030 году от рождества Христова? Мой обобщающий изложенное выше прогноз таков – разнообразные языковые модели достигнут такого уровня развития, что начнется стремительное вытеснение со своих рабочих мест “белых воротничков”. Могу предположить, что до 30% из них к этому времени уже будет сокращено и данный процесс будет неуклонно продолжаться. Впрочем, возможны и более мягкие варианты, например, сокращение рабочей недели до четырехдневной при сохранении уровня заработной платы, тут многое будет зависеть от административного регулирования со стороны государства.
Андроиды и другие роботы, на мой взгляд, станут обыденностью на многих производствах и даже в квартирах достаточно богатых слоев населения. По крайней мере, если еще несколько лет назад эксперты предсказывали массовую роботизацию лишь примерно к 2035 году, то сейчас некоторые из них пересмотрели свои прогнозы, и ожидают запуска массового производства сложных роботов, способных трудиться в разных сферах их применения с эффективностью, сравнимой с таковой у неквалифицированного работника, уже ближе к концу 2028 года.
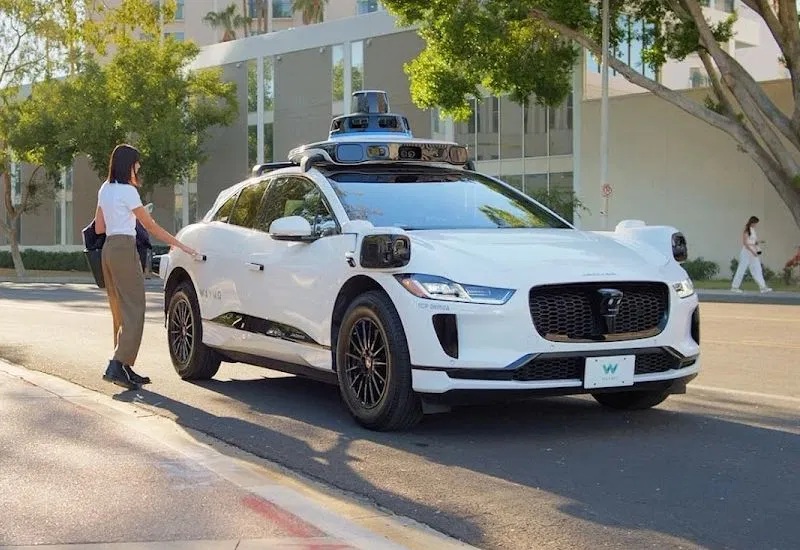
Машины с полными автопилотами (включая такси) в 2030 году станут обыденностью, их доля в общем потоке автомобилей в некоторых крупных городах может превысить 20%.
Быстрое развитие биоинформатики на основе ИИ позволит обеспечить дальнейший рост продолжительность жизни. Средний по всему миру показатель достигнет 75 лет, а в топовой десятке стран он превысит порог в 85 лет.
Но прогнозы – прогнозами, а реальная жизнь, как обычно, будет идти своим путем, порой преподнося неожиданные сюрпризы. Но одно можно сказать наверняка – в ближайшие 5-10 лет мир вокруг нас изменится настолько кардинальным образом, как еще не бывало раньше за всю историю человечества. Мы все живем в уникально интересное время!
Автор: Combinator_30
Источник [45]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37821
URLs in this post:
[1] GPU: https://ru.wikipedia.org/wiki/%D0%93%D1%80%D0%B0%D1%84%D0%B8%D1%87%D0%B5%D1%81%D0%BA%D0%B8%D0%B9_%D0%BF%D1%80%D0%BE%D1%86%D0%B5%D1%81%D1%81%D0%BE%D1%80
[2] TPU: https://ru.wikipedia.org/wiki/%D0%A2%D0%B5%D0%BD%D0%B7%D0%BE%D1%80%D0%BD%D1%8B%D0%B9_%D0%BF%D1%80%D0%BE%D1%86%D0%B5%D1%81%D1%81%D0%BE%D1%80_Google
[3] обучения: http://www.braintools.ru/article/5125
[4] AlexNet: https://en.wikipedia.org/wiki/AlexNet
[5] Tensor Cores: https://buildwithaitoday.com/wiki/tensor-cores#:~:text=Tensor%20cores%20are%20special-purpose%20circuits%20inside%20modern%20NVIDIA,by%204%20or%20larger%20tile%20per%20clock%20tick.
[6] AlphaChip: https://habr.com/ru/news/990164/
[7] исследует: https://habr.com/ru/news/1073344/
[8] нейроморфные: https://ru.wikipedia.org/wiki/%D0%9D%D0%B5%D0%B9%D1%80%D0%BE%D0%BC%D0%BE%D1%80%D1%84%D0%BD%D1%8B%D0%B5_%D0%B2%D1%8B%D1%87%D0%B8%D1%81%D0%BB%D0%B5%D0%BD%D0%B8%D1%8F
[9] ассоциируют: http://www.braintools.ru/article/621
[10] памяти: http://www.braintools.ru/article/4140
[11] персептрона Розенблатта: https://ru.wikipedia.org/wiki/%D0%9F%D0%B5%D1%80%D1%86%D0%B5%D0%BF%D1%82%D1%80%D0%BE%D0%BD
[12] потенциометры: https://ru.wikipedia.org/wiki/%D0%9F%D0%BE%D1%82%D0%B5%D0%BD%D1%86%D0%B8%D0%BE%D0%BC%D0%B5%D1%82%D1%80_(%D1%80%D0%B5%D0%B7%D0%B8%D1%81%D1%82%D0%BE%D1%80)
[13] мемристоры: https://ru.wikipedia.org/wiki/%D0%9C%D0%B5%D0%BC%D1%80%D0%B8%D1%81%D1%82%D0%BE%D1%80
[14] : https://wccftech.com/micron-edge-inference-memory-hbm-power-efficiency-ai-robots/
[15] зрения: http://www.braintools.ru/article/6238
[16] рефлексов: http://www.braintools.ru/article/8998
[17] поведение: http://www.braintools.ru/article/9372
[18] GPT-6 Astra: https://ru.wikipedia.org/wiki/GPT-6
[19] мозгом человека: http://www.braintools.ru/article/7543
[20] органов чувств: http://www.braintools.ru/article/9438
[21] забывания: http://www.braintools.ru/article/3931
[22] Mixture of Experts: https://en.wikipedia.org/wiki/Mixture_of_experts
[23] Model-Agnostic Meta-Learning: https://www.emergentmind.com/topics/model-agnostic-meta-learning-maml
[24] опыта: http://www.braintools.ru/article/6952
[25] Dreaming: https://www.memorylake.ai/en/blogs/chatgpt-dreaming-memory
[26] запоминания: http://www.braintools.ru/article/722
[27] долговременной памяти: http://www.braintools.ru/article/9500
[28] сне: http://www.braintools.ru/article/9809
[29] KV-cache: https://serverflow.ru/blog/stati/chto-takoe-kv-cache-i-kak-on-uskoryaet-rabotu-yazykovykh-modeley-llm/
[30] Chain of Thought: https://arxiv.org/abs/2201.11903
[31] головы профессора Доуэля: https://ru.wikipedia.org/wiki/%D0%93%D0%BE%D0%BB%D0%BE%D0%B2%D0%B0_%D0%BF%D1%80%D0%BE%D1%84%D0%B5%D1%81%D1%81%D0%BE%D1%80%D0%B0_%D0%94%D0%BE%D1%83%D1%8D%D0%BB%D1%8F
[32] «ReAct: Synergizing Reasoning and Acting in Language Models»: https://arxiv.org/abs/2210.03629
[33] VLA: https://en.wikipedia.org/wiki/Vision%E2%80%93language%E2%80%93action_model
[34] актуаторами: https://ru.wikipedia.org/wiki/%D0%98%D1%81%D0%BF%D0%BE%D0%BB%D0%BD%D0%B8%D1%82%D0%B5%D0%BB%D1%8C%D0%BD%D0%BE%D0%B5_%D1%83%D1%81%D1%82%D1%80%D0%BE%D0%B9%D1%81%D1%82%D0%B2%D0%BE
[35] Gemini Robotics ER 2: https://habr.com/ru/companies/bothub/news/1065558/
[36] Gemini Robotics On-Device 2: https://deepmind.google/models/gemini-robotics/on-device/
[37] Google Gemini 4 Argon: https://developers.googleblog.com/gemini-4-argon-for-robotics/
[38] интеллекта: http://www.braintools.ru/article/7605
[39] поведения: http://www.braintools.ru/article/5593
[40] Video-to-Sim-to-Rea: https://video2sim2real.github.io/#:~:text=To%20address%20this%2C%20we%20introduce%20Video2Sim2Real%2C%20a%20full-stack,skill%20acquisition%20from%20a%20single%20human%20manipulation%20video.
[41] MuJoCo: http://en.wikipedia.org/wiki/MuJoCo
[42] корнхол: https://ru.wikipedia.org/wiki/%D0%9A%D0%BE%D1%80%D0%BD%D1%85%D0%BE%D0%BB
[43] Apptronik: https://apptronik.com/
[44] Spot: https://bostondynamics.com/products/spot/
[45] Источник: https://habr.com/ru/articles/1086878/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1086878
Нажмите здесь для печати.