NER для юристов, у которых нет A100: как мы догнали Ministral 14B моделью почти в 10 раз меньше
Юристы не могут отправлять материалы дел во внешние API, а держать A100 ради одного лишь разбора документов дорого. Мы обучили Qwen2.5-1.5B извлекать сущности из судебных документов на уровне Ministral 3 14B: макро-F1 0.70 против 0.71 на 145 реальных документах. На A5000 она работает в 2.2 раза быстрее, чем Ministral на A100. Рассказываем, почему балансировка классов синтетикой не сработала и что сработало вместо неё.
Всем привет! Меня зовут Даниил Шеремет, я AI-инженер в Agentic Lab. В компании делаем Агату [1] — ИИ-ассистента и рабочую среду для юристов.
Арбитражное дело легко набирает несколько тысяч документов: договоры, допсоглашения, акты КС-2, платёжки, претензии, ходатайства, письма. Юристу нужно быстро понять, какие претензии были по договору поставки, когда пришёл последний платёж и сколько неустойки требует другая сторона. Чтобы Агата могла на такое отвечать, не перебирая каждый документ индивидуально, из каждого нужно вытащить сущности: стороны, договоры, платежи, нарушения, требования.
Поначалу с этим неплохо справлялась Ministral 3 14B на нашей арендованной A100, тратя на один документ в среднем около 33 секунд. Для чат-модели мы использовали эту же модель. Получалось удобно в эксплуатации и раскатке: одна карточка, одна модель, много свободного VRAM под кэш. Все счастливы.
Потом мы поменяли модель у чата на Gemma 4 28b, и конечно, она по всем бенчмаркам справлялась с клиентскими задачами лучше. Но вот беда: она отъедает практически всю A100. И если эту же модель гонять для извлечения сущностей (нагрузка бывает нешуточная: клиент посреди дня может закинуть папку на несколько тысяч документов), то чат у других клиентов попросту «встанет».
Раскошеливаться на 2×A100 не хочется, а отправлять документы по API клиентам нельзя. Нужна была модель, которая поместится на карту поменьше, а отработает так же качественно.
Такую модель мы и сделали. Qwen2.5-1.5B с LoRA-адаптером на A5000 в наших тестах разбирает документ в 2.2 раза быстрее, чем Ministral на A100, а по качеству отстаёт на один пункт макро-F1. Но по дороге она сначала научилась молчать о самом важном, а мы долго лечили это не тем способом. Об этом и расскажем.
Девять вопросов к каждому документу
Сущности мы разбили на девять классов:
participant — стороны, подписанты, представители;
document — реквизиты самого документа: тип, номер, дата, суд;
contract — договоры и допсоглашения, на которые документ ссылается;
object — предмет спора: работы, товары, груз, земельный участок;
performance_event — факты исполнения: поставка, приёмка, акты;
payment_event — отдельные платежи;
breach_event — заявленные нарушения: просрочка, неисполнение, брак;
damage — денежные требования: убытки, неустойка, штраф, пеня;
communication — внесудебная переписка: письма, претензии, ответы.
Каждый класс извлекается отдельным вызовом модели: в системном промпте схема класса, в сообщении текст документа, на выходе JSON. Получается девять вопросов к каждому документу. Схема нарушения, например, выглядит так:
class BreachEvent(BaseModel):
    breach_raw: str | None           # формулировка нарушения из текста
    breach_type: Literal["delay", "non_performance",
                         "defective_performance",
                         "cargo_loss", "other"] | None
    breaching_party_raw: str | None  # кто нарушил
    injured_party_raw: str | None    # чьи интересы задеты
    date_of_breach: FlexibleDate
Для фразы «…Ненадлежащее исполнение Контракта на поставку товара со стороны Поставщика в адрес Заказчика…» на выходе получается:
{"items": [{
  "breach_raw": "Ненадлежащее исполнение Контракта на поставку товара",
  "breach_type": "defective_performance",
  "breaching_party_raw": "Поставщик",
  "injured_party_raw": "Заказчик",
  "date_of_breach": "07.02.2024"
}]}
Девять вызовов по 3.6 секунды на A100 и дают те самые 33 секунды на документ. Резонный вопрос: почему бы не отдать всё это большой модели через API?
Почему нельзя просто отправить всё в API
Материалы дела для юриста — это одновременно адвокатская тайна, коммерческая тайна клиента и персональные данные десятков людей. Отправить их во внешний сервис значит передать третьему лицу, и почти наверняка на сервер за границей.
Юристы это хорошо понимают. Вице-президент Федеральной палаты адвокатов Сергей Зубков в интервью РАПСИ [2] назвал главным риском ИИ для адвокатов именно утечку тайны: неизвестно, на каких зарубежных серверах окажутся данные и как их потом используют.
По его словам, работать с материалами доверителя через ИИ можно только с согласия доверителя, а ФПА собрала рабочую группу, чтобы выработать общие правила.
Сверху ложится 152-ФЗ: персональные данные граждан России нужно хранить в России, передача за рубеж — отдельная процедура с уведомлением Роскомнадзора, а за утечки с 2025 года штраф может считаться от оборота компании.
Поэтому первое требование любой юрфирмы или юрдепартамента звучит одинаково: только он-прем. Модель живёт на железе клиента, а хорошее железо дорогое, и каждый гигабайт видеопамяти на счету.
5 500 настоящих документов
С данными нам повезло. У нас было около 5 500 настоящих документов из реальных дел, попавших к нам с согласия клиентов. Такой объём живых юридических документов просто так не достать: в открытом доступе в основном судебные акты, а договоров, актов, платёжек и переписки сторон там нет.
Типичный документ короткий: медиана — 2 380 символов, меньше полутора страниц, а больше трёх тысяч документов умещаются на одной странице. Но у распределения длинный хвост: самые длинные 10% документов содержат 61% всего текста.
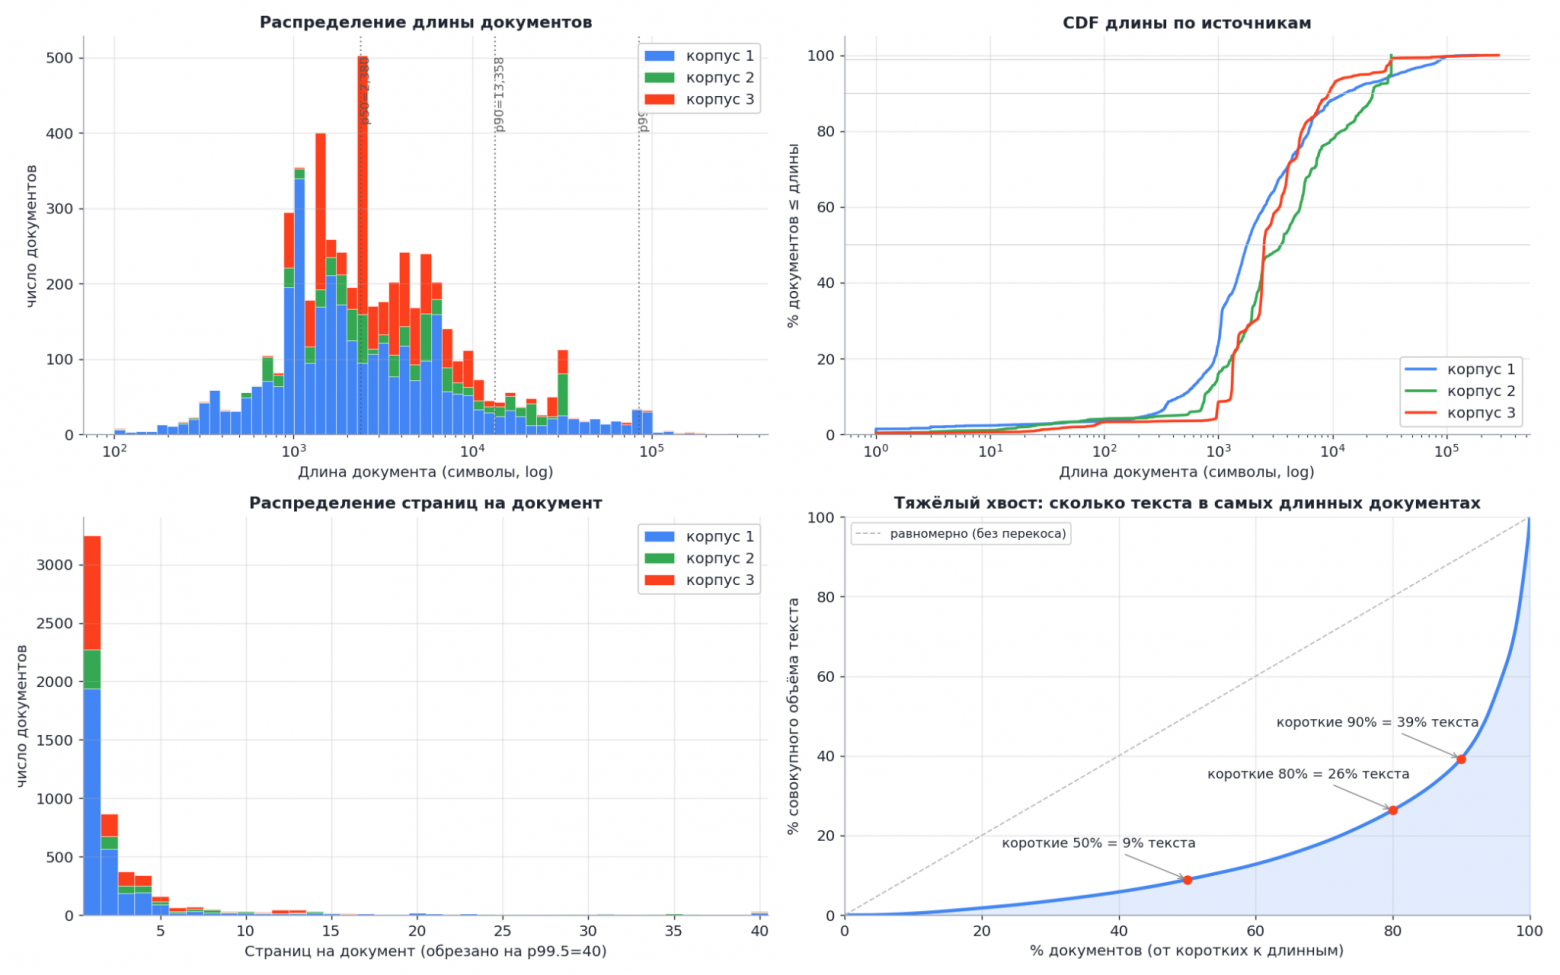
Длины документов по трём корпусам. Правый нижний график: половина самых коротких документов даёт всего 9% текста
Хвост пришлось отрезать. Окно обучения [3] — 16 тысяч токенов, и тренер молча обрезает всё, что длиннее, вместе с правильным ответом в конце. Модель учится на JSON, оборванном на полуслове, и потом так же обрывает свои ответы. Такие документы мы выкинули заранее, а данные разбили на обучение и валидацию по хешу текста, чтобы один документ с разными классами не попал в обе части.
У живых данных есть обратная сторона: распределение в них тоже живое. В реальном деле много договоров и актов, а каких-то видов документов единицы. Для обучения нужен сбалансированный набор, поэтому балансировка с самого начала была отдельной задачей, и решать её мы собирались синтетикой. Вопрос был только в том, что именно балансировать. Об этом ниже.
Сама схема обучения обычная, дистилляция. Модель-учитель разметила корпус, вышло около 45 000 примеров «документ: класс». Студент — Qwen2.5-1.5B-Instruct с LoRA-адаптером: веса базы заморожены, учится только небольшая добавка поверх них, около 80 МБ.
|
параметр |
значение |
|---|---|
|
базовая модель |
unsloth/Qwen2.5-1.5B-Instruct |
|
LoRA r / α |
16 / 32 |
|
целевые модули |
все 7: q, k, v, o, gate, up, down |
|
длина последовательности |
16 384 |
|
эпохи |
3 |
|
эффективный батч |
8 × 4 = 32 |
|
learning rate |
3e-4, cosine, warmup 0.05 |
Проверяли на golden set из 145 реальных документов, которые не участвовали ни в обучении, ни в генерации синтетики. Извлечённое сравнивал с эталоном отдельный судья, а не учитель: модели склонны завышать оценку собственным ответам (self-enhancement bias [4]), и студент, хорошо копирующий учителя, выглядел бы лучше, чем есть.
Точность, полнота и датчик газа на моей кухне
Короткое отступление для тех, кто не занят обучением моделей ежедневно — без него дальше будет непонятно, почему мы так мучились.
У меня на кухне когда-то стоял датчик утечки газа. Срабатывал он не только на газ, но и на спирт, жидкость для снятия лака и вообще на любой резкий запах [5]. И не просто пищал: он перекрывал газ во всей квартире, а подключить его обратно могла только газовая служба. Протёр стол со спиртом — звонишь газовикам и по два часа ждёшь мастера.
Утечку такой датчик не пропустит никогда. В терминах машинного обучения у него идеальная полнота (recall): доля настоящих случаев, которые он поймал. А точность (precision), то есть доля тревог, за которыми действительно стоял газ, у него очень маленькая. Можно представить и обратный датчик: он не реагирует ни на лак, ни на спирт, ни на утечку, если она не очень сильная. Зря не беспокоит, точность безупречная, а полнота плохая — слабую утечку датчик пропускает. Метрика F1 объединяет оба числа, и она высока, только когда хороши оба.
В инженерных системах такой размен встречается сплошь и рядом, и выбирают в нём по цене ошибки [6]. Для юриста пропущенная претензия может стоить проигранного дела, а лишняя находка стоит минуты внимания [7]. Но если лишних находок слишком много, системой перестают пользоваться, как перестаёшь доверять датчику, который каждую неделю отключает газ.
Модель, которая всегда отвечает «нет»
Теперь представьте, что вы языковая модель. Вам дают юридический документ и просят найти в нём деловую переписку сторон: письма, претензии, уведомления. Вы видели десятки тысяч обучающих примеров и выучили статистику: в 93.6% случаев правильный ответ — пустой список. Выигрышная стратегия очевидна: ничего не искать и всегда отвечать, что переписки нет.
По доле правильных ответов такая модель — отличница: она права в 94 случаях из 100. А полнота у неё нулевая, ни одного письма она не нашла. Это излишне спокойный датчик. Вот как выглядел наш обучающий набор:
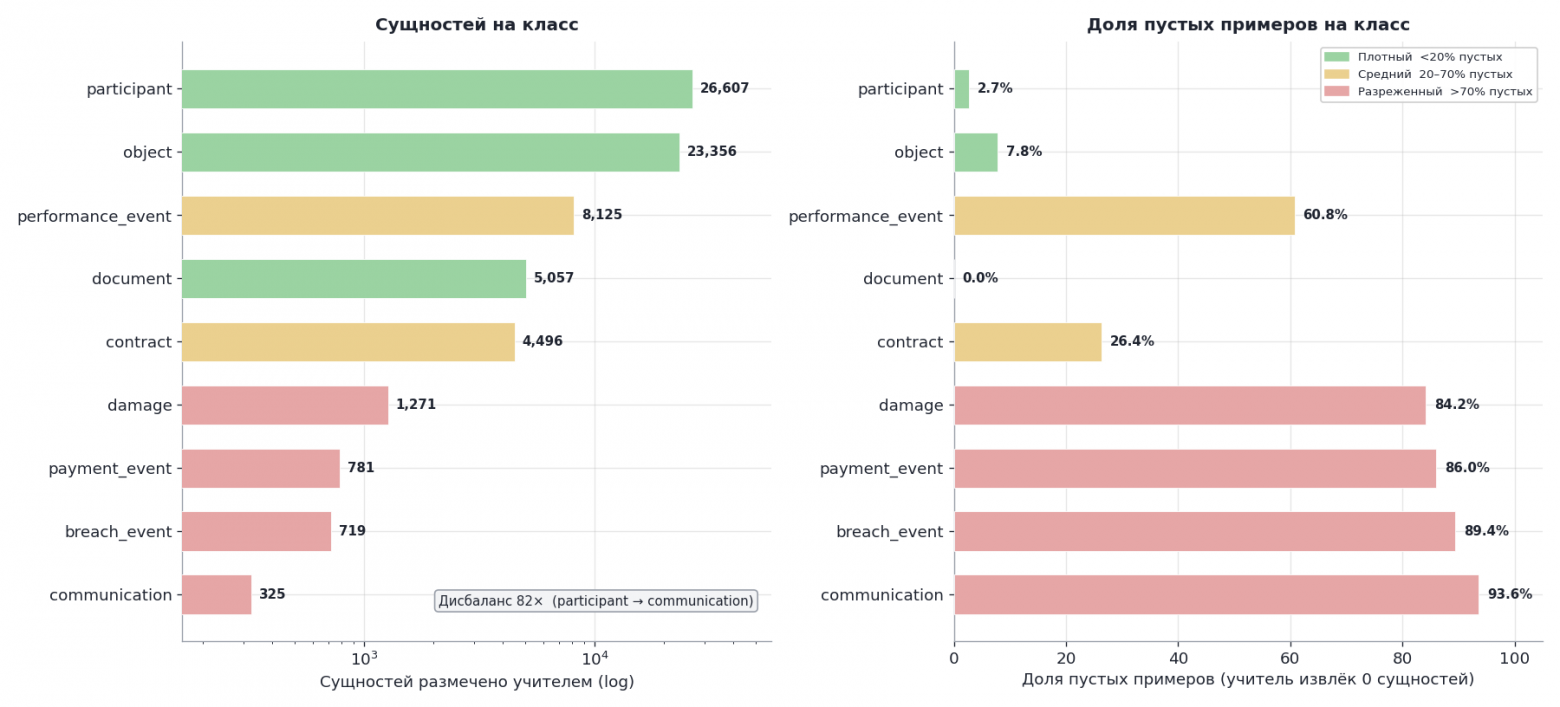
Слева — сколько сущностей каждого класса разметил учитель, справа — доля примеров, где их нет вовсе
Участников в корпусе 26 607, переписки — 325, разница в 82 раза. Четыре класса пусты в 84–94% примеров. Наша первая модель вела себя ровно так, как подсказывает статистика: стороны и реквизиты документов извлекала отлично, а нарушения, платежи, требования и переписку часто пропускала, то есть именно то, ради чего юрист открывает дело.
Синтетика, которая не сдвинула F1
Решение напрашивалось само: показать модели больше примеров, где переписка, платежи и неустойки есть.
Под эту задачу мы построили генератор синтетики и вложили в него много сил. Вставлять в документы случайные сущности бессмысленно: модель быстро научится узнавать подделку. Поэтому генератор вшивал в реальные документы связные истории. Поставщик сорвал срок поставки, заказчик начислил неустойку, отправил претензию, получил ответ и частичную оплату, и всё это с настоящими сторонами и номерами договоров из корпуса. Получались вполне правдоподобные куски текста. Мы собрали несколько датасетов с разной долей непустых примеров и обучили студента на каждом.
На внутренней валидации всё шло как надо: модель стала смелее и начала находить нарушения и платежи. А на golden set общий результат не сдвинулся. Излишне спокойный датчик превратился в излишне тревожный. Писем модель теперь находила больше, но и за письмо принимала что попало. Полнота росла, точность падала, а F1 стоял на месте. Сколько бы мы ни меняли пропорции, мы крутили одну и ту же ручку чувствительности: получали либо меньше пропусков и больше мусора, либо наоборот. Новых знаний модель не получала.
Ходатайств в обучении не было
Мы долго не понимали, почему балансировка не помогает. Причина оказалась в устройстве нашей же проверки. Валидацию мы нарезали из того же корпуса, что и обучение. Если какого-то типа документов в корпусе мало, его мало и в валидации, и там модель выглядит прекрасно. Дыру мог показать только golden set из реальных дел, но на нём мы смотрели сводку по классам. Сводка говорила, что редкие классы плохи, а график выше давал готовое и вполне реальное объяснение: перекос в 82 раза.
Всё встало на места, когда ошибки на golden set разложили по типам документов, а не по классам.
«Я сначала думал, что дело в балансе классов, и подбирал пропорции. Потом построил ту же таблицу ошибок, только по типам документов. Почти все провалы оказались в ходатайствах и претензиях, а в обучении их было по пальцам пересчитать»
— Максим Гордеев, ML-инженер Agentic Lab
Процессуальных документов в корпусе почти не было. А деловая переписка в деле — это в первую очередь претензии и ответы на них. Класс был пуст в 93.6% примеров не потому, что модели не хватало примеров переписки, а потому, что в корпусе почти не было документов, где переписка встречается. Балансировать нужно было не классы, а типы документов.
Генератор пригодился и здесь, только задачу мы ему поменяли. Вместо того чтобы вшивать редкие сущности в знакомые договоры, он стал создавать недостающие типы документов целиком: ходатайства, претензии, ответы на них, сразу с разметкой. Прирост пришёл ровно туда, где была дыра. События исполнения прибавили 23 пункта точности и 22 пункта полноты, переписка — 34 пункта точности, а модель научилась определять процессуальную категорию документа, которую раньше не различала вовсе.
Итоговый счёт: 1.5B против 14B
Обе модели на одних и тех же 145 документах с одним судьёй:
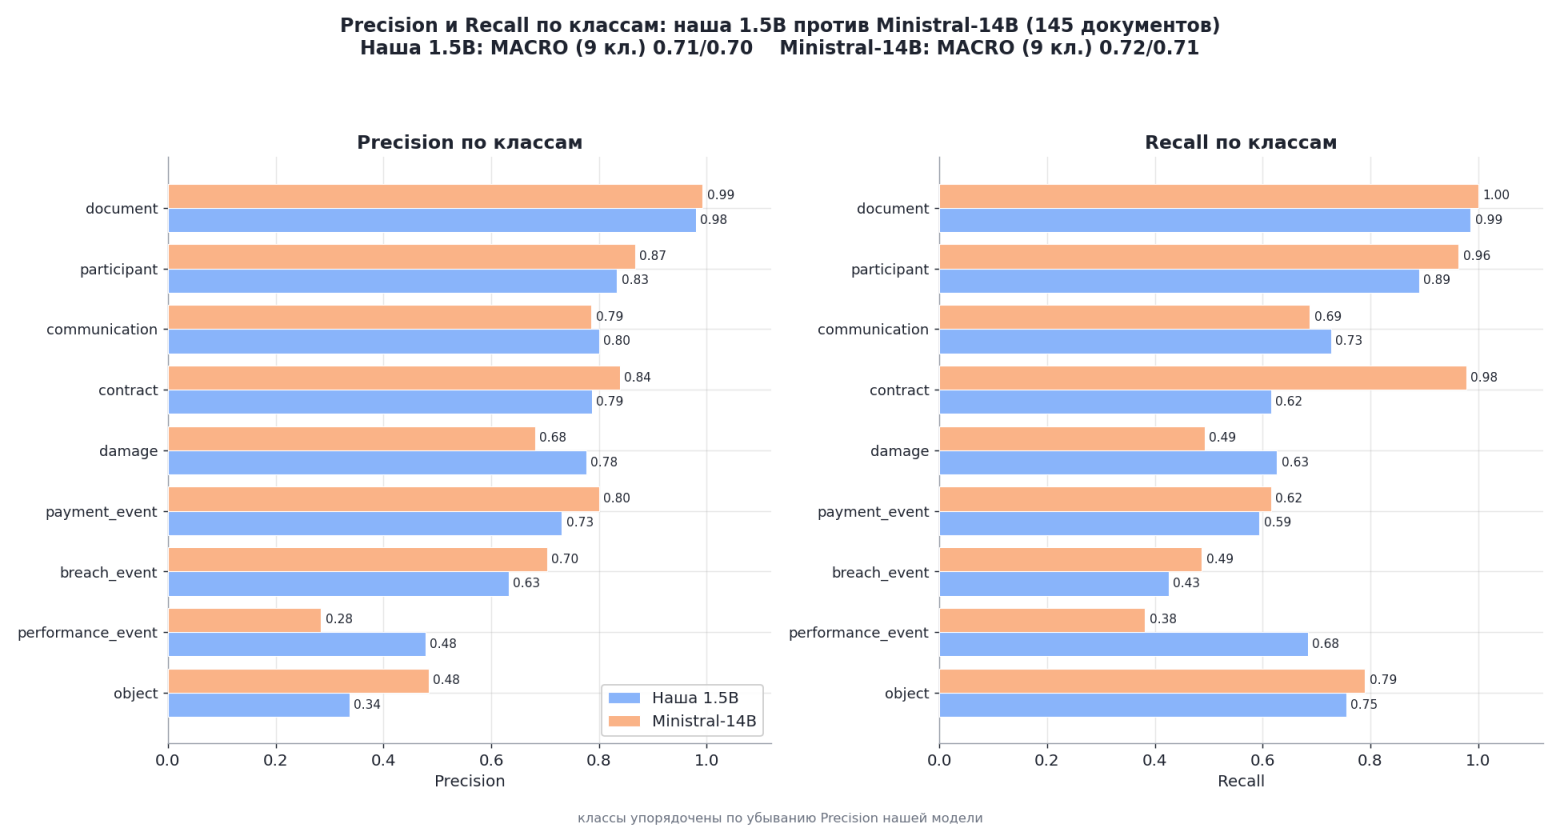
Precision и recall по классам: наша 1.5B против Ministral 3 14B
|
класс |
F1 1.5B |
F1 14B |
|---|---|---|
|
participant |
0.86 |
0.91 |
|
document |
0.98 |
0.99 |
|
contract |
0.69 |
0.90 |
|
object |
0.47 |
0.60 |
|
performance_event |
0.56 |
0.32 |
|
payment_event |
0.65 |
0.70 |
|
breach_event |
0.51 |
0.58 |
|
damage |
0.70 |
0.57 |
|
communication |
0.76 |
0.74 |
|
макро |
0.70 |
0.71 |
Макро-F1 считается от средних precision и recall по девяти классам, поэтому не равна среднему по столбцу.
Студент выигрывает на событиях исполнения (0.56 против 0.32), денежных требованиях и переписке, то есть там, куда пришла синтетика процессуальных документов. Оговорка про события исполнения: у этого класса самые размытые границы. Акт на двадцать позиций — это одно событие или двадцать? Студент выучил, как на такие вопросы отвечает наша разметка, а Ministral работала только по инструкции, и часть разрыва, скорее всего, отсюда.
Проигрывает студент на договорах, объектах и нарушениях, и на договорах сильно. Тут видно, зачем смотреть на два числа, а не на одно. По F1 договоры и объекты выглядят одинаково плохо, но ошибки у них противоположные. На договорах датчик излишне спокойный: точность 0.79 при полноте 0.62, всё найденное почти всегда верно, но треть договоров модель просто не замечает. На объектах излишне тревожный: полнота 0.75 при точности 0.34, в этот класс летит всё подряд. Первое лечится данными, второе — более чёткими границами класса в инструкции.
A5000 вместо A100
Замеренное: Ministral 3 14B на A100 разбирает документ за 32.7 секунды (девять вызовов по 3.63 с), наш студент на A5000, карте заметно слабее, — за 14.8 секунды (девять вызовов по 1.64 с). В 2.2 раза быстрее на более дешёвом железе, и это ещё вызовы по одному, без батчинга.
Посчитанное: веса 1.5B в bf16 занимают около 3 ГБ против 28 ГБ у 14B. KV-кэш у Qwen2.5-1.5B — 28 КБ на токен (28 слоёв × 2 KV-головы × 128 × 2 байта на K и V). Документ на 4 тысячи токенов занимает 112 МБ, и в нашей продовой конфигурации на 15 ГБ одновременно помещается около сотни таких документов. Для он-према это главное: одна недорогая карта обслуживает целый поток дел. Замер пропускной способности обеих моделей на одной A100 у нас ещё впереди.
Что мы вынесли
Реальные данные не бывают сбалансированными, и балансировать их приходится. Но сначала стоит понять, по какой оси. Мы выравнивали классы, а перекос в них оказался следствием перекоса в типах документов.
Валидация, нарезанная из того же корпуса, что и обучение, наследует все его перекосы. Решения стоит принимать только по реальным данным со стороны.
Синтетика хорошо создаёт то, чего в данных нет, и плохо исправляет пропорции того, что есть. Первое дало нам десятки пунктов, второе — качели между точностью и полнотой.
Что дальше: научить модель молчать правильно
Есть у этой истории продолжение. По четырём классам из девяти в 84–94% документов извлекать нечего, а модель каждый раз читает документ целиком и генерирует пустой список. То есть большая часть вычислений уходит на подтверждение того, что сущностей нет.
Проверить это можно дешевле. Чтобы понять, что ответ будет пустым, генерировать его не нужно: достаточно одного прохода по документу и вероятности того, что ответ начнётся с пустого списка. Если она высокая, генерацию можно не запускать, а полный разбор оставить только классам, которые в документе действительно есть.
Мы этого ещё не проверяли. Но забавно: мы долго отучали модель молчать, а следующий шаг — научить её молчать снова. Только теперь осознанно, дёшево и до того, как она начнёт генерировать.
Два вопроса к тем, кто решал похожие задачи. Первый: как вы контролируете, что модель, обученная на синтетике, учится извлекать сущности, а не отличать сгенерированный текст от настоящего? Второй: что бы вы сделали с полнотой по договорам — добавили бы данных, поменяли схему или вынесли договоры в отдельный проход? Будем рады обсудить в комментариях.
Автор: dsheremet
Источник [8]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37956
URLs in this post:
[1] Агату: https://agatha-legal.tech/
[2] в интервью РАПСИ: https://rapsinews.ru/digital_law_news/20251225/311476009.html
[3] обучения: http://www.braintools.ru/article/5125
[4] self-enhancement bias: https://arxiv.org/abs/2306.05685
[5] запах: http://www.braintools.ru/article/9870
[6] ошибки: http://www.braintools.ru/article/4192
[7] внимания: http://www.braintools.ru/article/7595
[8] Источник: https://habr.com/ru/articles/1102342/?utm_campaign=1102342&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.