Хаос как сервис: как мы в Авито проверяем устойчивость в проде и подключаем к этому LLM
Привет! Меня зовут Илья Садыков, я работаю в команде TestOps в PaaS Авито. Мы отвечаем за инструментарий хаос-тестирования — подхода, при котором в систему намеренно внедряются сбои для её проверки.
В этой статье я покажу карту нашего хаос-ландшафта, расскажу, зачем нам собственный оркестратор, и подробно разберу, как во всё это встроена LLM. Рассмотрим кейсы от автоматического разбора прошлых инцидентов (LSR) до генерации AI-conclusion по конкретным экспериментам. Все архитектурные решения, о которых расскажу в статье, — из нашего реального продакшена.
Содержание
Ландшафт: что вообще имеет смысл симулировать [2]
Архитектура: почему нам не хватило готовых open-source-инструментов [3]
От инцидента к проверке: LLM-разбор LSR [4]
AI внутри самого эксперимента: AI-conclusion и связка с разбором инцидентов [5]
Как устроен автораннер и результаты с продакшена [6]
Дальнейшие планы [7]
Заключение [8]
Реактивно vs проактивно
Все мы знаем, что прод может ломаться: база данных слишком долго переходит на резервный сервер, пропадает связь между двумя дата-центрами или у половины подов одновременно случается out of memory. Каждый подобный сбой обходится бизнесу очень дорого.
Мы в Авито предпочитаем выявлять такие риски заранее: собираем «библиотеку известных сбоев», прогоняем её по критичным сервисам и смотрим, что продолжает работать, а что нужно улучшить.
Классический реактивный путь решения проблем с надёжностью знаком любой продуктовой команде:
Инцидент → разбор (post-mortem / LSR) → список Action Items → часть тасок теряется в бэклоге → точно такой же сбой через квартал.
Даже при идеальном процессе разбора инцидентов доля Action Items из LSR, доходящих до продакшена, далека от 100%. Причина банальна: продуктовые фичи почти всегда выигрывают по приоритету у техдолга и инфраструктурных доработок. В итоге за каждый такой «урок» компания расплачивается реальными деньгами и лояльностью пользователей во время повторных падений.
Отсюда возникла идея проактивного подхода: симулировать возможные сбои заранее на продакшене, в безопасных окнах трафика. Цель — увидеть регрессию и деградацию системы до того, как с ними столкнётся пользователь.
Смысл хаос-тестирования не в том, чтобы «намеренно сломать прод». Если сервис спроектирован устойчиво, эксперимент проходит незаметно для пользователей, оставляя в истории отметку: такой-то сервис штатно пережил отказ первичной реплики.
Путь от ручных проверок отдельных сервисов через YAML-конфиги к регулярному автоматическому тестированию занял у нас примерно два года:
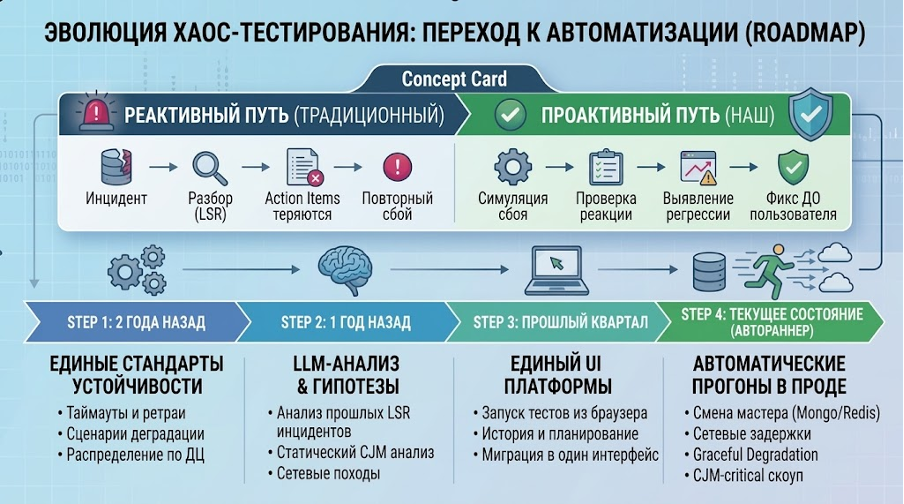
2 года назад: мы утвердили единые стандарты устойчивости. В них описали правила работы с таймаутами и ретраями, сценарии контролируемой деградации, распределение приложений по дата-центрам и клиентские настройки для баз данных.
1 год назад: запустили LLM-анализ прошлых LSR, чтобы строить гипотезы для тестов на основе реальных инцидентов. Параллельно пробовали статический анализ CJM-сценариев, проверяли несовпадения таймаутов на клиенте и сервере, а также рассчитывали число сетевых походов на один входящий запрос.
Прошлый квартал: мигрировали в единый UI для истории и планирования тестов, а запустить эксперимент стало возможно прямо из браузера.
Текущее состояние: запустили автоматические прогоны. Сейчас в планировщике три сценария: смена мастера для MongoDB и Redis, рост сетевых задержек и проверка graceful degradation. Широко раскатан пока один — смена мастера; остальные включены на ограниченном наборе сервисов. Скоуп авторежима мы сужаем сознательно: в него входят сервисы CJM-critical сценариев, а новые типы сценариев добавляются в расписание по одному, после онбординга владельцев.
Автоматические прогоны сами по себе ничего не дадут, пока вы чётко не определите, что именно и на каких слоях будете симулировать. Прежде чем переходить к автоматизации, нам потребовалось составить карту всех возможных сбоев и понять, где проходят физические границы возможностей стандартных хаос-инструментов.
Разберём эту карту подробнее.
Ландшафт: что вообще имеет смысл симулировать
Все возможные сбои инфраструктуры мы делим на шесть групп.
-
Ресурсы: утечки памяти [9], полная загрузка CPU, исчерпание IO, переполнение дисков. Смотрим, как ведёт себя сервис, когда у соседнего контейнера на том же узле течёт память или забился диск.
-
Сеть: рост задержек, потеря пакетов, повреждение трафика, дублирование, разрыв связности. Проверяем сетевые стыки между подами, дата-центрами и внешними сервисами.
-
Состояние и процессы: внезапное удаление подов, принудительное завершение контейнеров, перевыборы мастера у хранилищ. Проверяем, как приложение переживает плановую пересборку и некорректное завершение работы.
-
Прикладной уровень: искажение HTTP-ответов, искусственные таймауты, повреждение заголовков, ошибки [10] DNS. Взаимодействие между сервисами ломается не только при обрыве провода.
-
Вне Kubernetes: падение внешних API, фейловер баз данных вне кластера, отказ физических серверов или отвал целого дата-центра ниже слоя Kubernetes.
-
Бизнес-логика: нарушения идемпотентности, сбои Outbox-паттерна, шторм повторных запросов, дубли в очередях, сбои откатов в сагах. Самая сложная зона: хаос-тест помогает подсветить слабое место, но решать проблему приходится разработчику приложения, а не инженерам платформы.
Чтобы понимать, где мы находимся сейчас и куда двигаемся, мы свели эти группы в матрицу возможностей хаос-платформы:
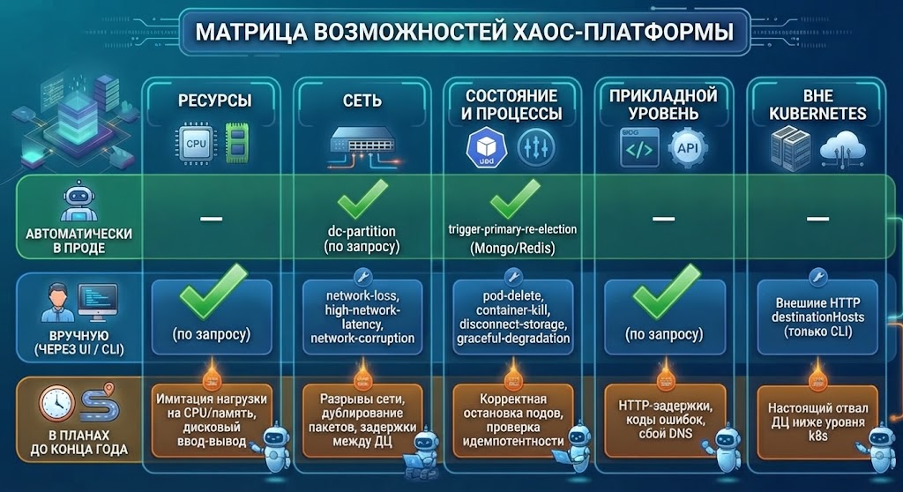
Матрица показывает реальную ситуацию: мы не делаем вид, что у нас закрыто всё, а чётко подсвечиваем пробелы.
Архитектура: почему нам не хватило готовых open-source-инструментов
Внутри хаос-платформы работает связка: готовый движок LitmusChaos + наш собственный оркестратор Kratos.
-
LitmusChaos — популярный Kubernetes-оператор (CNCF Incubating). Вы описываете манифест
ChaosEngine, а оператор применяет аномалии напрямую к подам: гасит контейнеры, режет сетевой трафик, забивает процессор. Инструмент отличный, но работает исключительно на уровне отдельных подов. Он ничего не знает про логику [11] хранилищ: например, он не умеет штатно переключить мастера в репликасете MongoDB или Redis, потому что для него не существует понятия «первичная реплика». -
Kratos (наш оркестратор) — сервис на Go, написанный командой TestOps. Он принимает задачи из UI, консоли или планировщика, формирует нужные конфигурации для Litmus, а главное — умеет выполнять сложные доменные сценарии. Например, безопасно инициировать перевыборы мастера (
trigger-primary-re-election), имитировать разрыв связи с базой или отключать дата-центр. Кроме того, Kratos полностью интегрирован в платформу Авито: он проверяет согласия на работы, сверяется с правилами устойчивости (RDP) и отправляет эскалации.
Зачем нужен свой слой поверх LitmusChaos?
Разницу хорошо видно по реальным данным из наших разборов инцидентов:
-
Litmus «из коробки» (работающий только с подами) способен симулировать около 22% прошлых инцидентов.
-
Litmus + Kratos (с нашими сценариями для баз и сети) закрывает уже 41% инцидентов (это 400 реальных разборов из 977).
Этот прирост покрытия почти в два раза и оправдывает написание собственного доменного слоя поверх готового open-source-движка.
Написать свой оркестратор и расширить библиотеку тестов — это только половина задачи. Вторая и куда более сложная часть — понять, какие именно тесты из этой библиотеки нужно запускать в первую очередь и какие сбои действительно есть в продакшене, а не выдуманы.
От инцидента к проверке: LLM-разбор LSR
Самый надёжный способ понять, какие сбои нужно симулировать в первую очередь, — посмотреть, где система уже давала сбой. В Авито любой разбор инцидента фиксируется в виде LSR (post-mortem) [12]. Чтобы не перебирать сотни отчётов вручную, мы поручили их системный анализ нейросети.
За время работы нашего автоматического пайплайна модель изучила 977 разборов инцидентов.
Как устроен пайплайн анализа
Обработка запускалась ежедневно по расписанию (в 3:00 MSK) и состояла из пяти этапов:
-
Сбор данных: из хранилища выгружаются новые LSR за последние три месяца, которые ещё не анализировались (пачками до 10 000 записей, по 100 за раз).
-
Обогащение: к тексту LSR из Jira добавляется переписка из связанного с инцидентом чата.
-
Шесть вопросов к LLM: вместо одного громоздкого промпта мы задаём модели (Llama 3 70B Instruct во внутреннем контуре) шесть чётких последовательных вопросов:
-
Сделать краткое резюме инцидента на английском (только суть: первопричина и симптом).
-
Оценить
chaosPotential— можно ли воспроизвести этот сбой хаос-тестом? -
Перевести резюме на русский язык.
-
Проверить Action Items из LSR — реально ли дошли до фикса или зависли в бэклоге?
-
Рассчитать
kratosPotential— насколько легко сбой ложится на наши проверки (от 0 до 10)? -
Подобрать конкретные типы аномалий из нашей библиотеки с их оценкой (например,
pod-network-latency, trigger-primary-re-election).
-
-
Векторизация: по резюме генерируется эмбеддинг с помощью модели
nomic-embed-text. -
Сохранение и индекс: результаты пишутся в MongoDB, а в Elasticsearch обновляется KNN-индекс по векторам. Это позволяет находить похожие инциденты и строить карты проблемных мест по каждому сервису.
Текущий статус: процесс временно приостановлен из-за закрытия внутреннего сервиса с моделью. Модели того поколения тоже устарели — разница с текущим поколением принципиальная, поэтому мы переходим на новый LLM-шлюз и современные модели. При этом накопленный датасет и методология продолжают работать. Все цифры этого раздела — на момент остановки пайплайна.
Что показали цифры
Разбор 977 инцидентов дал нам статистику реальных проблем:
-
41% разборов получили от модели
kratosScore = 10— то есть модель считает, что наш существующий или планируемый инструментарий воспроизвёл бы этот сбой один в один. Это оценка воспроизводимости, а не гарантия предотвращения: ниже будет пример, где 10/10 оказалось пустышкой. -
432 автоинсайта сформировано по сервисам (пары «сервис × тип сценария» на 408 сервисах) — это автоматически обновляемый «паспорт устойчивости», где видно, переживает ли сервис отвал мастера БД, сетевые задержки или потерю дата-центра.
Если сгруппировать проанализированные LSR по категориям сбоев, картина выглядит так:
-
Сеть — 448 инцидентов (41%)
-
Ресурсы — 348 инцидентов (31%)
-
Прикладной уровень — 177 инцидентов (16%)
-
Состояние и процессы — 132 инцидента (12%)
В топе сценариев, которые модель предлагает чаще всего: pod-cpu-hog (197), pod-network-latency (175), pod-memory-hog (151), pod-http-latency (122), pod-network-partition (98).
Отсюда виден наш приоритет: в первую очередь автоматизируем сеть, так как один сетевой тест покрывает сразу четыре типа проблем (задержки, потери, обрывы и повреждения пакетов).
Пример 1. От сбоя Redis к главному тесту
Реальный разбор инцидента:
-
Причина: смена мастера в репликасете Redis — часть сервисов не пережила недоступность базы в течение примерно 1 минуты.
-
Симптомы: легли 19 критичных CJM-сценариев, авторизация «упала» на 12 минут, около 50% пользователей не могли обновить токен.
-
Восстановление: часть сервисов поднялась сама, остальные пришлось чинить вручную.
Вывод LLM: модель поставила chaosPotential = yes, предложила сценарий переключения Redis и оценила его на kratosScore = 6/10 (базовый Litmus не умел делать честный фейловер стореджа).
Изучив пачку таких LSR, мы поняли: pod-level хаоса тут не хватит. Litmus умеет «шатать поды», а нам нужно честное переключение primary внутри репликасета — с реальными перевыборами, а не с убийством процесса.
Так появился наш собственный сценарий trigger-primary-re-election, который инициирует честные перевыборы мастера в MongoDB и Redis. Сейчас на него приходится 95,6% всех автопрогонов в проде. Это и есть замкнутый цикл: инцидент → разбор → новый автотест → гарантированная защита от повторения [13].
Пример 2. Ошибка модели: почему 10/10 от LLM — не повод сразу писать тест
Контрпример из практики:
-
Причина: деградация внутренних сервисов для работы с документами из-за ошибки в конфиге Nginx (его правили для закрытия уязвимости).
-
Симптомы: документы в интерфейсе перестали открываться.
-
Восстановление: откат изменений в Nginx.
Вывод LLM: модель выдала kratosScore = 10/10, посчитав, что сбой идеально симулируется через сетевые задержки (pod-http-latency).
Но разбор показал: конфиг сторонней системы мы хаос-тестом не изменим, а pod-http-latency даст лишь похожий симптом, а не первопричину. В инциденте были специфические HTTP-ответы — ошибки SSL handshake, 502, таймауты прокси, — а не сетевая задержка. Такой тест жил бы в расписании, стабильно зелёный, и не проверял бы ровно ничего. Худший вид покрытия — тот, который создаёт ощущение защиты.
Главный вывод: высокий балл от LLM — это лишь подсказка инженеру, куда посмотреть, а не приказ писать тест. Модель отлично отсеивает лишнее, но окончательное решение всегда принимает человек.
AI внутри самого эксперимента: AI-conclusion и связка с разбором инцидентов
Ретроспективный разбор прошлых LSR — не единственное место, где мы используем LLM. Вторая точка интеграции находится прямо внутри отчёта по проведённому хаос-тесту.
Когда эксперимент завершается, оркестратор Kratos собирает метрики, оценивает фазу восстановления и отправляет данные в нейросеть. Модель формирует понятное заключение и записывает его прямо в результаты прогона.
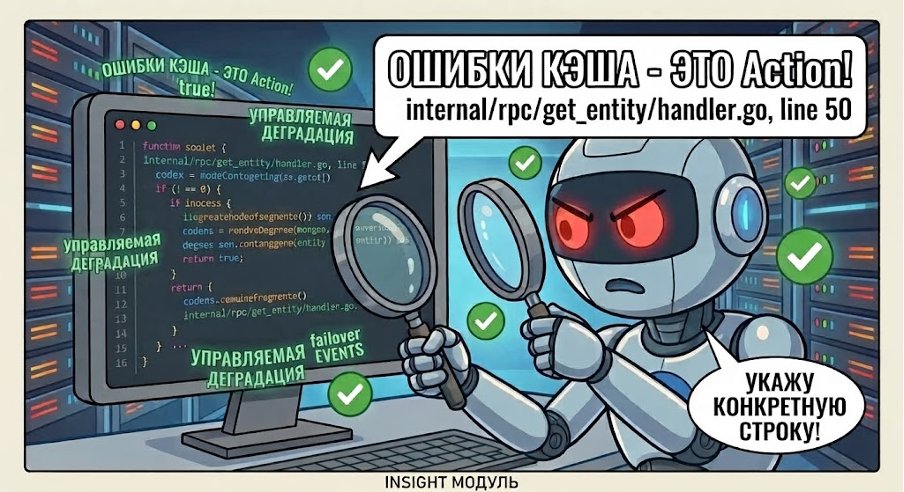
Для инженера: в уведомлении о неудачном тесте приходит не абстрактная оценка resilience level = poor, а человеческое описание — что именно сломалось и в какую сторону смотреть.
Для автоматики: другие сервисы и пайплайны могут сразу отделить действительно важные находки (actionable: true) от обычных отчётов.
Важно, что за этими двумя полями стоит не однократный запрос к модели «объясни метрики». В пайплайн уходит полный слепок прогона — тип сценария, конфигурация, цели, границы фаз, все посчитанные метрики, — а работает над ним агент, у которого есть доступ к коду сервиса. Он идёт от симптома к причине: видит, что после перевыборов мастера доля 5xx не вернулась к базовой линии за окно восстановления, — и ищет в репозитории то, что это объясняет. Например, конфигурацию клиента хранилища, отсутствующую обработку события failover, таймаут, который больше окна перевыборов, ретрай без джиттера, который превращает восстановление в самоDDoS.
Выглядит результат примерно так (пример реального вывода, имена и пути изменены):
Вывод: при любой ошибке обращения к кэшу, кроме «ключ не найден», обработчик возвращает клиенту 5xx вместо того, чтобы сходить в источник данных. Во время перевыборов мастера кэш временно недоступен — отсюда всплеск ошибок, который не спадает до конца фазы восстановления.
Где: internal/rpc/get_entity/handler.go, строки 49–53 и internal/storage/cache.go, строки 83–91 (коммит 60a85a8).
Что сделать: на ошибках кэша, отличных от «ключ не найден», не прерывать обработку, а падать в синхронный поход в источник — метод для этого уже есть.
Вне зоны ответственности команды: переподключение к новому мастеру реализовано в платформенной клиентской библиотеке; её поведение [15] при failover сервис не контролирует.
Ограничения анализа: вывод построен по метрикам прогона и чтению кода; воспроизведение на стенде не выполнялось.
Отдача от этого резко несимметрична по шкале оценок, и это видно в цифрах. За последний месяц агентский разбор отработал на 92% боевых прогонов и в 54% случаев пометил свой вывод как требующий действий. Но если разложить по оценке устойчивости: на прогонах с excellent таких выводов 26%, а на всём, что ниже, — 80%. Агент калибрует сам себя: на зелёном прогоне он чаще всего честно говорит «делать нечего».
Так и должно быть. Прогон с excellent объяснять не нужно. А вот moderate и ниже без объяснения владелец сервиса закрывает как шум — и он по-своему прав, потому что resilience level = poor не говорит, что делать в понедельник утром. Разница между «poor» и «ваш обработчик отдаёт 5xx на любой ошибке кэша, вот это место» — это разница между тикетом, который висит квартал, и тикетом, который чинят за день.
Что происходит с этими выводами дальше, мы тоже считаем. Владелец сервиса может явно согласиться или не согласиться с заключением: на сегодня проставлено 70 вердиктов, из них 61 «согласен» и 9 «не согласен» — 87% согласия при живом механизме возражения. 23 находки взяты в работу, 30 привязаны к заведённым тикетам.
Честно про ограничения: пайплайн работает с суточным лимитом запусков — агентский разбор стоит денег, и мы сознательно не гоняем его на каждый зелёный прогон. Запускается он только на успешно завершённых боевых экспериментах. И точность самих указаний на код мы пока не верифицировали на выборке вручную — знаем долю выводов, которые агент считает требующими действий, и долю, с которой согласились владельцы, но не «сколько раз он попал в нужную строку». Это наш следующий шаг, и обещать здесь «AI сам чинит прод» было бы нечестно.
Как результаты тестов помогают разбирать новые инциденты
Ещё одно применение — наш AI-ассистент для автозаполнения LSR, помощник, который собирает контекст, когда команда пишет разбор свежего инцидента.
Пока инженер только начинает заполнять отчёт, ассистент делает read-only-запрос в хаос-оркестратор и получает все тесты, которые проходили по пострадавшему сервису за последние 30 дней. Каждый прогон раскладывается на чёткие факты:
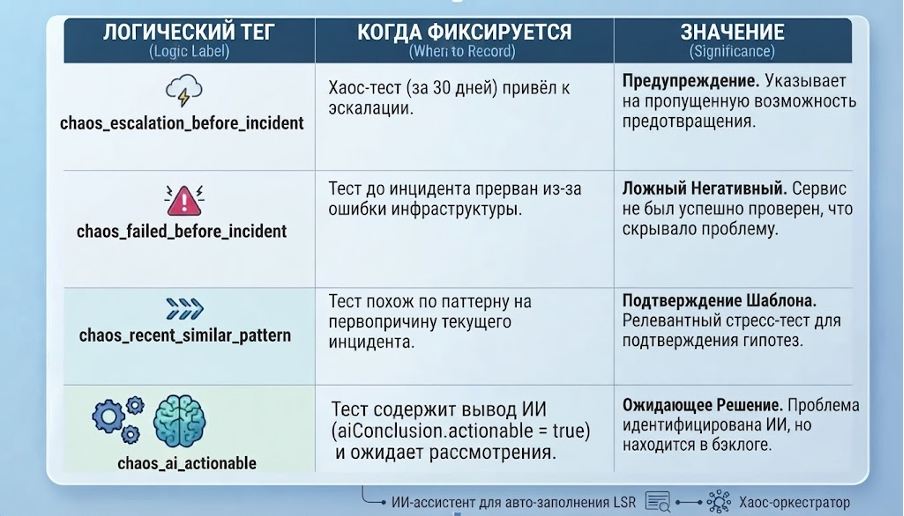
На основе этих фактов автоматически формируется итоговый вердикт — chaos_potential. Он отвечает на вопрос: что делать с хаос-покрытием этого сервиса дальше?
-
already_covered— сервис за последний месяц успешно прошёл аналогичный тест. Повторять этот же сценарий бессмысленно, ищем проблему в соседних узлах. -
regression_needed— тест ранее уже находил эту проблему, а инцидент подтвердил, что её так и не починили. Нужен повторный прогон после фикса. -
chaos_recommended— такой тип аномалий ещё не запускался на сервисе. Стоит добавить его в расписание. -
out_of_scope— сервис находится вне периметра тестов (например, системный компонент платформы).
Архитектурный принцип: нейросеть здесь ничего не решает за инженера. Она лишь формирует структурированный сигнал. LLM работает как фильтр лишней информации, а финальное решение всегда остаётся за человеком.
AI размечает инцидент машиночитаемо
У ассистента разбора инцидентов, о котором шла речь выше, есть второй режим работы, и он интереснее первого. Ассистент не только собирает контекст для человека — он классифицирует инцидент и проставляет на разборе лейблы из закрытого словаря:
-
chaos_coverage_missing— сценарий этого класса на сервисе ни разу не гонялся. -
chaos_regression_needed— гонялся, находил проблему, её не починили, инцидент это подтвердил. -
chaos_scenario_insufficient— сценарий гонялся и проходил, а инцидент всё равно случился: значит, сценарий проверяет не то.
Это не то же самое, что вердикт chaos_potential выше: вердикт — внутренний производный сигнал для формулировки Action Items, а лейблы — то, что реально остаётся на тикете разбора и попадает в витрину.
Ключевое слово — «закрытого». Свободный текст от модели прочитает человек и забудет; лейбл из фиксированного словаря становится строкой в дашборде. Опечатку или потерю уже существующих лейблов блокирует отдельная проверка перед записью в трекер — модели разрешено выбирать из списка, а не сочинять.
Механизм работает меньше месяца, и сразу скажем, как он выглядит в цифрах, чтобы не создавать ложного впечатления [16]: размечено пока десять разборов, все — «сценарий ни разу не гонялся». Ни одной регрессии и ни одного «сценарий проверяет не то» словарь пока не поймал. Для честного счётчика на первом месяце это ожидаемо; интересным он станет через квартал, когда накопится история.
Отдельно стоит рассказать о том, как это сделано организационно. У разбора инцидентов в компании уже есть свой AI-ассистент, который ведёт не наша команда. Мы не стали строить рядом второй — мы добавили в чужой инструмент свой источник данных и свой словарь сигналов. Команде-владельцу это стоило ревью пул-реквеста, а нам дало доступ к чужому потоку разборов, которого у нас иначе не было бы никогда. Если у вас платформенная команда и вы думаете, строить ли свой ассистент дежурного, — сначала посчитайте, сколько в компании уже построено. У нас на момент подсчёта их было три.
Теперь перейдём к технике: как устроен сам автораннер, который ежедневно гоняет эти проверки в проде?
Как устроен автораннер и результаты с продакшена
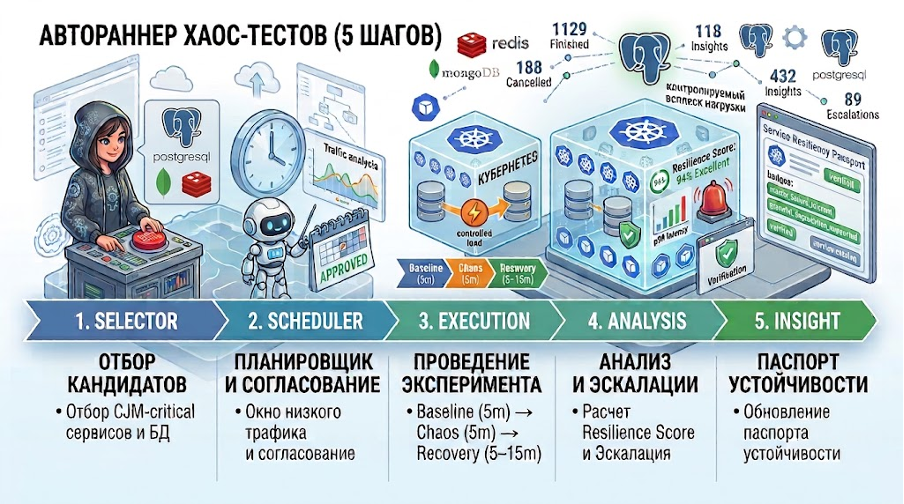
Автораннер работает ежедневно в автоматическом режиме, без прямого участия инженеров. Он состоит из пяти модулей:
-
Selector (отбор кандидатов). Определяет, на каких сервисах прогонять сценарий. Для сценария
trigger-primary-re-electionкритерии простые: сервис входит в CJM-critical список, использует поддерживаемые базы (MongoDB или Redis), у его хранилища нет мёртвых нод, а владелец дал согласие на тесты. -
Scheduler (планировщик и согласование). Анализирует почасовую статистику трафика конкретного приложения и выбирает окно с наименьшим числом запросов в секунду (обычно ночью). Проверяет, что рядом нет других тестов или заморозок выкаток, после чего запрашивает согласие в системе согласования работ. Если владелец попросит перенести тест, планировщик просто вернётся с новым окном позже.
-
Baseline → Chaos → Recovery (проведение). Сначала снятие базлайна по метрикам («до»). Затем подача аномалии (5 минут), отключение аномалии и отслеживание фазы восстановления (5–15 минут). Для безопасности у нас есть режим
dry-run— сгенерировать конфигурации для LitmusChaos, но не применять их к кластеру (очень удобно при отладке). -
Analysis + Escalation (анализ и эскалации). Оркестратор рассчитывает итоговый resilience score по нескольким осям:
-
рост числа ошибок 5xx,
-
рост задержек p99,
-
клиентские задержки RPC p98 у зависимых сервисов,
-
скорость и качество восстановления.
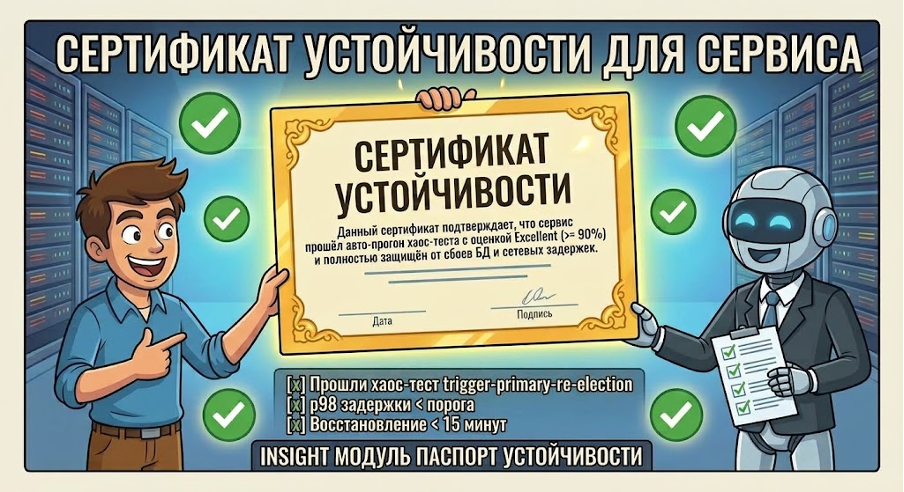
Шкала оценок: excellent (≥ 90%), good (75–89%), moderate (60–74%), poor (40–59%), critical (< 40%). Если оценка poor или ниже — триггерится эскалация. За качеством следит дополнительный верификатор, который перепроверяет восстановление системы — эта двойная проверка нужна, чтобы не спамить ложными тревогами. Наша цель по эскалациям — true-positive rate ≥ 70%, то есть не меньше 70% тикетов должны указывать на реальную проблему.
-
-
Insight (паспорт устойчивости). Результат обновляет статус сервиса в общем каталоге. В карточке приложения автоматически выставляются актуальные галочки напротив правил устойчивости (например,
master_failure_tolerant).
Статистика прогонов на продакшене
Данные на текущий момент. Под «автопрогоном» здесь понимается эксперимент, запущенный планировщиком или из интерфейса в продакшене, не в режиме dry-run. Таких прогонов на сегодня:
-
1129 тестов успешно завершились и прошли через модуль анализа (
finished). -
188 тестов были отменены до запуска (
cancelled) — отмена до подачи аномалии — штатный исход, а не ошибка. Основные причины: владелец попросил перенести окно, в кластере перед запуском нашлась нездоровая нода БД или произошёл короткий сбой в CI.
Абсолютное большинство автопрогонов — 1079 из 1129 (95,6%) — приходится на сценарий trigger-primary-re-election. Остальные: 41 прогон с ростом сетевых задержек, 5 проверок graceful degradation и 4 кастомные конфигурации. Малые числа здесь означают не «не реализовано», а «включено на ограниченном наборе сервисов»: эти сценарии работают в планировщике так же, как смена мастера, просто раскатаны пока узко.
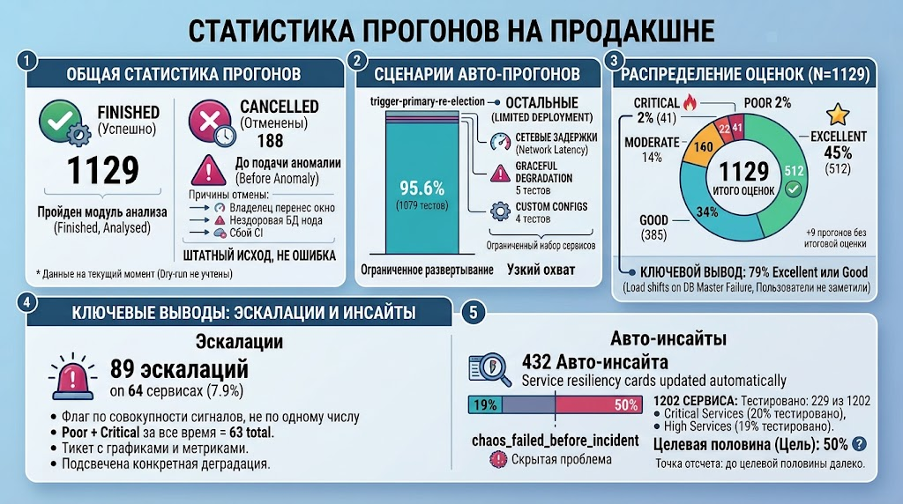
Распределение оценок по этим 1129 прогонам:
-
Excellent (45%) — 512 прогонов
-
Good (34%) — 385 прогонов
-
Moderate (14%) — 160 прогонов
-
Poor (2%) — 22 прогона
-
Critical (4%) — 41 прогон
Ещё 9 прогонов остались без итоговой оценки.
Ключевые выводы из этих цифр:
-
79% прогонов проходят на excellent или good. При отказе мастера БД нагрузка переезжает на реплику, а пользователи ничего не замечают. Обратите внимание [17]: это доля прогонов, а не сервисов, — у одного сервиса за год набирается несколько запусков с разными результатами.
-
89 эскалаций на 64 сервисах — это 7,9% прогонов. Каждая эскалация — тикет с графиками и метриками, где подсвечена конкретная деградация. Здесь важно определение: эскалация у нас не то же самое, что низкая оценка. Низких оценок (poor и critical) за всё время 63, а эскалаций 89 — флаг ставится по совокупности сигналов, а не по одному числу.
-
432 автоинсайта. Столько карточек устойчивости в каталоге сервисов обновляется автоматически, без необходимости проводить ручной аудит. Хотя бы один тест прошёл на 408 сервисах: это 20% critical-сервисов и 19% high, суммарно 229 из 1202. До целевой половины нам далеко, и это честная точка отсчёта.
И главное, чего мы не ожидали. Сейчас платформа делает около 6 тестов в день при плановых 44. Логично предположить, что упираемся мы в безопасность: ограничения по уровню риска, запреты на тесты вне расписания, согласования. Но нет — гейты риска у нас открыты, планировщик простаивает. Самый узкий участок автоматизации оказался не техническим: каждый сервис входит в программу через явное включение флага владельцем, и это ограничивает темп сильнее всего остального вместе взятого. Мы два года строили механику и только сейчас поняли, что следующий квартал уйдёт не на новые сценарии, а на то, чтобы упростить людям кнопку «да».
И цифра, которую обычно спрашивают следом: во сколько это обходится самим сервисам. Расход бюджета ошибок на хаос-тесты — медиана 0,14% месячного бюджета на сервис, максимум по одному сервису 17,3%. То есть в типичном случае хаос-тестирование стоит сервису доли процента его допустимой ненадёжности.
Дальнейшие планы
В развитии платформы мы идём от простого к сложному. До конца года фокусируемся на базовой надёжности: планируем подключить к автосмене мастера все критичные сервисы и довести точность сигналов до 70%.
Дальше будем проверять сервисы и на канареечных релизах с автоматическим откатом при регрессиях, научим платформу самой перезапускать зависшие контейнеры для сокращения времени простоя и сквозным образом свяжем отчёты об авариях с задачами для команд.
Заключение
За два года работы мы сделали три главных вывода.
Во-первых, бессмысленно начинать с выбора инструментов: любые утилиты бесполезны, пока в компании нет единых стандартов устойчивости — базовых правил работы с таймаутами, ретраями и деградацией сервисов.
Во-вторых, нейросети хороши как фильтр лишней информации, но не замена человеку: они отлично структурируют данные по инцидентам и отчётам, но финальное решение всегда принимает инженер.
И в-третьих, автоматические тесты без жёстких ограничений — прямой путь к аварии. Безопасный предпросмотр, прогоны в часы минимальной нагрузки и возможность отложить тест — не роскошь, а базовый минимум для работы в проде.
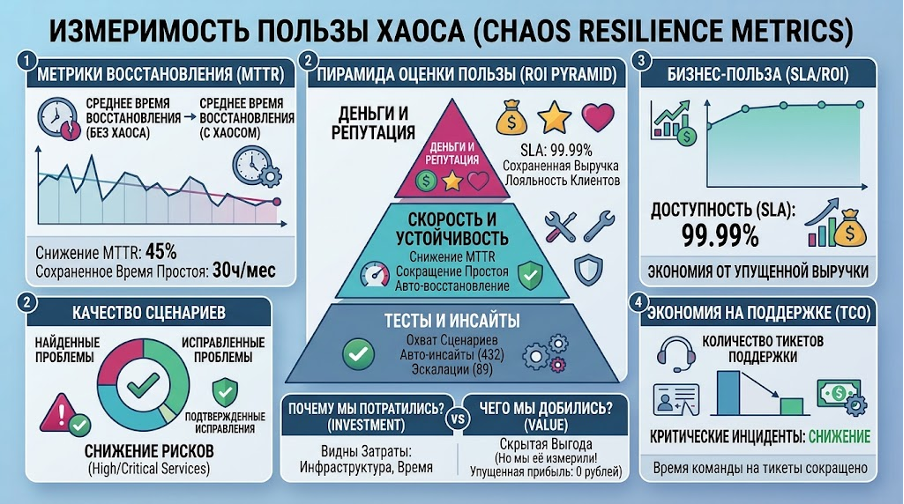
И последнее, чего в подобных статьях обычно не пишут. Мы два года измеряли исключительно левую половину цепочки: сколько тестов провели, сколько проблем нашли. Правая половина — исправлена ли проблема и не случился ли инцидент — не измерялась вообще. Это ровно та асимметрия, из-за которой любому внутреннему инструменту надёжности тяжело защищать свою полезность: затраты видны, выгода — нет.
Кое-что правую половину всё-таки показывает. У нас есть критерий отказоустойчивости «сервис переживает потерю мастера базы» — тот самый, который проверяет наш основной сценарий. Под оценку попало 360 сервисов. Из них 141 когда-либо не проходил критерий. Сегодня не проходят 8. Кривая характерная: год назад не проходящих было 3, к марту стало 69, сейчас — 8. Сначала охват вскрывает дефекты, потом их чинят.
Тут нужна честная оговорка, без которой цифра превращается в рекламу: это корреляция, а не атрибуция. Мы не утверждаем, что все 133 сервиса починились из-за наших тестов — на команды одновременно давили и ревью архитектуры, и требования к запуску. Мы утверждаем другое: нарушение этого критерия перестало быть массовым и стало исключением, и это видно в цифрах.
Чего по-прежнему нет — метрики «проблема, найденная тестом, исправлена и подтверждена повторным прогоном». Не «команда отметила галочку», а «мы воспроизвели ровно тот сбой, и он больше не воспроизводится». Процесс запустился в сентябре, счётчик близок к нулю, и это нормальное состояние честного счётчика в первый месяц. Именно его значение через квартал и будет ответом на вопрос, работает ли всё описанное выше.
И, конечно, интересно узнать, как аналогичные задачи решаются в ваших командах. Как у вас организован выбор безопасных окон для хаос-экспериментов и рискуете ли вы проводить их в рабочей среде? Пробовали подключать LLM к разбору постмортемов и логов инцидентов? И ещё вопрос: вы даёте агенту доступ к коду сервиса при разборе — или держите его на уровне метрик?
А ещё у нас есть подкаст «В SREду на кухне», где вы можете узнать больше про SRE-практики. Выпуск про хаос-тестирование можно послушать по ссылке [18].
Автор: smecsia
Источник [20]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37971
URLs in this post:
[1] Реактивно vs проактивно: #%D0%A0%D0%B5%D0%B0%D0%BA%D1%82%D0%B8%D0%B2%D0%BD%D0%BE%20vs%20%D0%BF%D1%80%D0%BE%D0%B0%D0%BA%D1%82%D0%B8%D0%B2%D0%BD%D0%BE
[2] Ландшафт: что вообще имеет смысл симулировать: https://www.braintools.ru%20%D1%87%D1%82%D0%BE%20%D0%B2%D0%BE%D0%BE%D0%B1%D1%89%D0%B5%20%D0%B8%D0%BC%D0%B5%D0%B5%D1%82%20%D1%81%D0%BC%D1%8B%D1%81%D0%BB%20%D1%81%D0%B8%D0%BC%D1%83%D0%BB%D0%B8%D1%80%D0%BE%D0%B2%D0%B0%D1%82%D1%8C
[3] Архитектура: почему нам не хватило готовых open-source-инструментов: https://www.braintools.ru%20%D0%BF%D0%BE%D1%87%D0%B5%D0%BC%D1%83%20%D0%BD%D0%B0%D0%BC%20%D0%BD%D0%B5%20%D1%85%D0%B2%D0%B0%D1%82%D0%B8%D0%BB%D0%BE%20%D0%B3%D0%BE%D1%82%D0%BE%D0%B2%D1%8B%D1%85%20open-source-%D0%B8%D0%BD%D1%81%D1%82%D1%80%D1%83%D0%BC%D0%B5%D0%BD%D1%82%D0%BE%D0%B2
[4] От инцидента к проверке: LLM-разбор LSR: https://www.braintools.ru%20LLM-%D1%80%D0%B0%D0%B7%D0%B1%D0%BE%D1%80%20LSR
[5] AI внутри самого эксперимента: AI-conclusion и связка с разбором инцидентов: https://www.braintools.ru%20AI-conclusion%20%D0%B8%20%D1%81%D0%B2%D1%8F%D0%B7%D0%BA%D0%B0%20%D1%81%20%D1%80%D0%B0%D0%B7%D0%B1%D0%BE%D1%80%D0%BE%D0%BC%20%D0%B8%D0%BD%D1%86%D0%B8%D0%B4%D0%B5%D0%BD%D1%82%D0%BE%D0%B2
[6] Как устроен автораннер и результаты с продакшена: #%D0%9A%D0%B0%D0%BA%20%D1%83%D1%81%D1%82%D1%80%D0%BE%D0%B5%D0%BD%20%D0%B0%D0%B2%D1%82%D0%BE%D1%80%D0%B0%D0%BD%D0%BD%D0%B5%D1%80%20%D0%B8%20%D1%80%D0%B5%D0%B7%D1%83%D0%BB%D1%8C%D1%82%D0%B0%D1%82%D1%8B%20%D1%81%20%D0%BF%D1%80%D0%BE%D0%B4%D0%B0%D0%BA%D1%88%D0%B5%D0%BD%D0%B0
[7] Дальнейшие планы: #%D0%94%D0%B0%D0%BB%D1%8C%D0%BD%D0%B5%D0%B9%D1%88%D0%B8%D0%B5%20%D0%BF%D0%BB%D0%B0%D0%BD%D1%8B
[8] Заключение: #%D0%97%D0%B0%D0%BA%D0%BB%D1%8E%D1%87%D0%B5%D0%BD%D0%B8%D0%B5
[9] памяти: http://www.braintools.ru/article/4140
[10] ошибки: http://www.braintools.ru/article/4192
[11] логику: http://www.braintools.ru/article/7640
[12] LSR (post-mortem): https://habr.com/ru/companies/avito/articles/529806/
[13] повторения: http://www.braintools.ru/article/4012
[14] Тут ещё больше контента: https://telegram.me/+ShQQPXymxoViNzFi
[15] поведение: http://www.braintools.ru/article/9372
[16] впечатления: http://www.braintools.ru/article/2012
[17] внимание: http://www.braintools.ru/article/7595
[18] по ссылке: https://t.me/sre_avito/25
[19] Жми сюда!: https://clc.to/MDY_jw
[20] Источник: https://habr.com/ru/companies/avito/articles/1095198/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1095198
Нажмите здесь для печати.