Дообучил Qwen3.6 синтаксису 1С и проверил её на случайных вопросах: все результаты не ниже 95 %
Летом я дообучал Qwen3.6 27B на справочном материале по 1С и проверял результат субьективно на глаз: по ответам на последние добавленные объекты и доработанные методы. Позднее решил узнать точно, какие данные не усвоились при дообучении.
В результате сделал нормальный тест: случайные сто вопросов из ~ 20 тысяч записей, ответы дообученной модели, два LLM-судьи и детерминированная проверка критичных полей. Всего 6 прогонов по 100 вопросов.
Все результаты — не ниже 95 % корректных ответов. В эти проценты я зачислил и ответы с некритичными потерями: потерянный пример кода или переформулированное описание при точной сигнатуре — это не та ошибка [1], из-за которой падает код. Как я пришёл к этой методике и почему первые прогоны пришлось выбросить — ниже.
С чего всё началось
Предварительное исследование вопроса «можно ли уместить синтаксис 1С в LoRA адаптер» дало такой результат: при хорошем результате обучения [2] Low Rank Adapter может усвоить только ~ 94 % синтаксических конструкций. Поэтому для точных знаний рекомендуется использовать RAG или LoRA + RAG. Но из этой информации следует практическая задача: примерно 6 % датасета осталось плохо усвоенным, и именно эти пробелы надо найти и запомнить, для понимания, каким точно данным от модели не стоит доверять. Как говориться, если точно знать где упадешь, можно заранее мягкое постелить.
В первой статье я пошёл путём RAG: связал справочный материал через MCP-сервер с Roo Code и пытался проверить, как модель справляется, работая в агентном режиме. Было 4 новых агента с разными настройками: 1. Qwen3.6, 2. Qwen3.6+LoRA1C, Qwen3.6+RAG, Qwen3.6+LoRA1C+RAG. Ответы у всех были правильными — и это стало проблемой. Новым агентам информация давалась слишком легко, они тащили знания из любых доступных источников. Пришлось сначала сильно ограничить агентов в правах, а потом долго отклонять команды на чтение файлов “которые точно помогут в правильном решении задачи” и команды на доступ в интернет. RAG в такой связке работает, но тянет за собой векторную базу, ретрив и MCP-сервер, а вопрос об усвоенных 94 % так и остаётся открытым: правильные ответы агентов ничего не говорят о том, что выучила сама модель.
Чтобы узнать, что реально уместилось в LoRA адаптер, самый простой тест, которому можно верить – это спросить модель по датасету, что она знает по каждой записи датасета использованного для обучения. Планировал сверить все, но сверять все – это очень долго и ускориться за счет запуска на vllm не получилось.
Почему первые прогоны пришлось выбросить
Первый тест был наивный: взять новую jev like модель с ендпоинтом /v1/systemone, взять первые сто записей датасета, прогнать, посчитать. Потом — сто записей, равномерно распределённых по всему справочному материалу. Цифры выходили разные, и разброс между прогонами был большой при том, что модель одна и та же.
Прогоны были сырыми: судья один, потери не классифицированы, калибровки нет. Таким данным нельзя верить — не потому, что они плохие, а потому что непонятно, что именно они измеряют.
Затем откалибровал процентный ответ OpenJev модели и добавил вторую модель судью для понимания насколько правильно работает OpenJev 27B (базовая модель тот же Qwen3.8).
Получивщиеся требования к тесту, которому поверю сам:
1. Случайность [3] и неповторяемость. Вопросы выбираются случайно, с фиксированным зерном, и никогда не повторяются между прогонами.
2. Воспроизводимость. То же зерно и тот же список исключений — тот же набор вопросов. Прогон можно повторить и получить тот же список.
3. Два судьи. Один LLM-судья — это одно мнение. Нужен второй, чтобы понимать, где первый ошибается.
4. Честный учёт мелочей. Ответ без примера кода — не тот же провал, что ответ с неверным типом параметра. Это надо различать явно, а не на глаз.
Всё, что этим требованиям не соответствовало, из статьи убрано. Дальше — только откалиброванные прогоны.
Логика [4] LoRA и модели: веса и адаптер
Прежде чем показывать методику — два слова о том, что я вообще тестировал, потому что здесь легко запутаться.
У любой LLM есть веса — большие матрицы чисел, в которых записано всё, что модель умеет. LoRA-обучение эти веса не трогает: рядом с ними обучается маленькая добавка — веса адаптера, и ответ модели считается сразу по обоим.
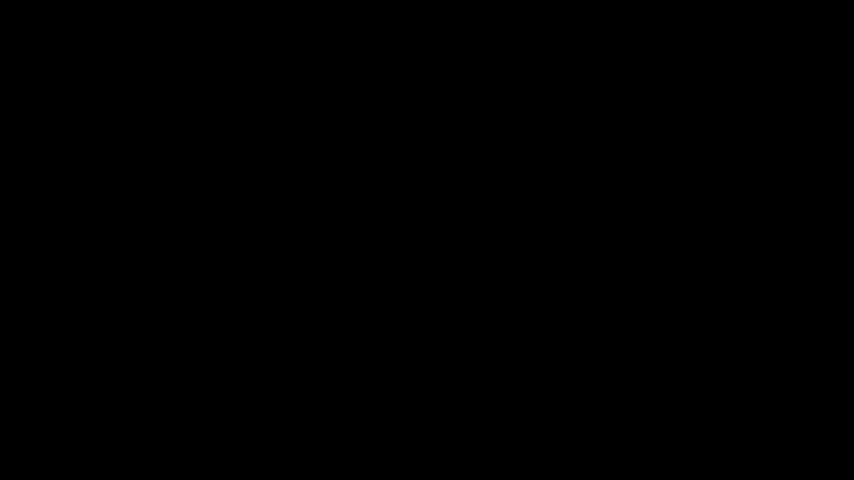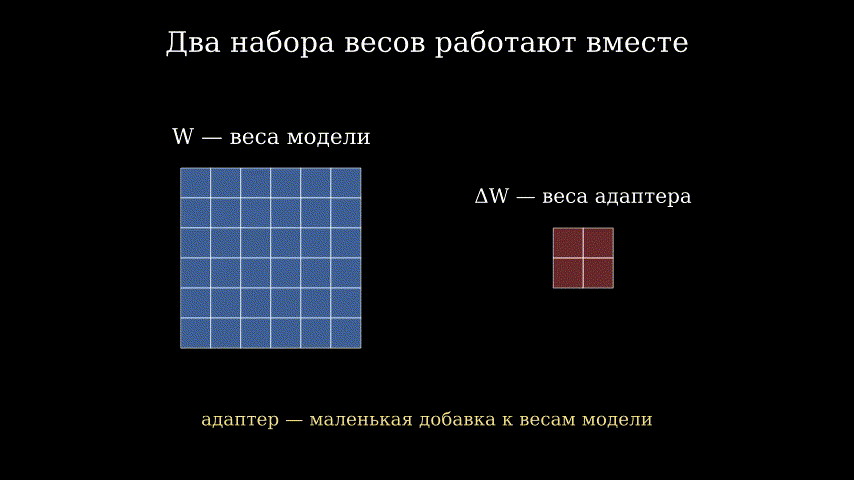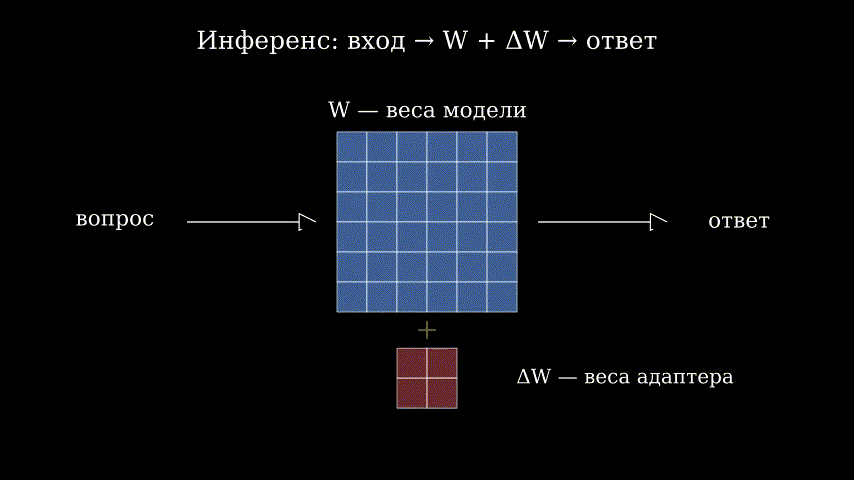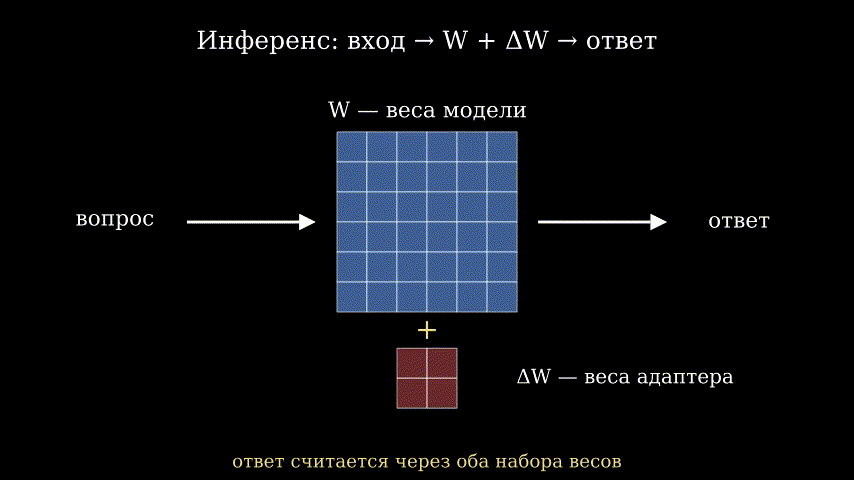
Ответ считается через веса модели и веса адаптера вместе: большая матрица W отвечает за всё, что модель умела раньше, маленькая добавка ΔW — за то, что она выучила про 1С.
Для того чтобы проверить все и ускориться при проверке, установил vllm и скачал NVFP4 Qwen3.8 27B. На 32 gb GPU запустить не получилось OOM, запустил на втором GPU 48 gb, но скорость не увеличилась, надо было распараллеливать тесты для укорения всего процесса, решил не проверять все записи датасета полностью.
Также не стал тратить время на конвертацию LoRA адаптера из safetensors в gguf.
И в итоге тестировал файнтюнинг: адаптер вмержен в веса модели, и на инференсе отдельного адаптера нет. Модель называется Qwen3.6-27B-Q8_LoRA1C, так что «LoRA» в имени — исторический след, а не признак того, что рядом с базой грузится адаптер.
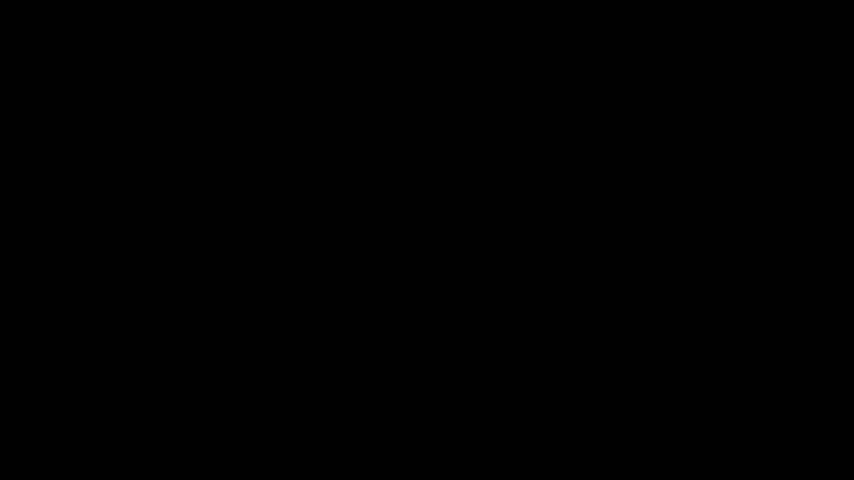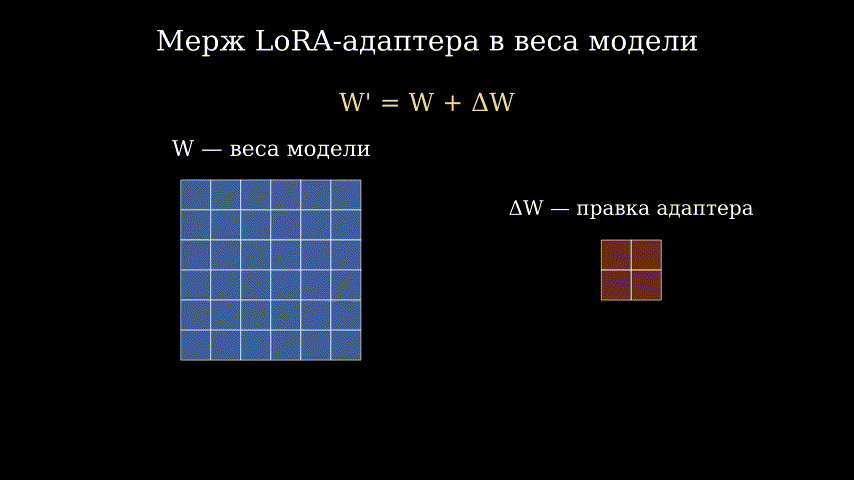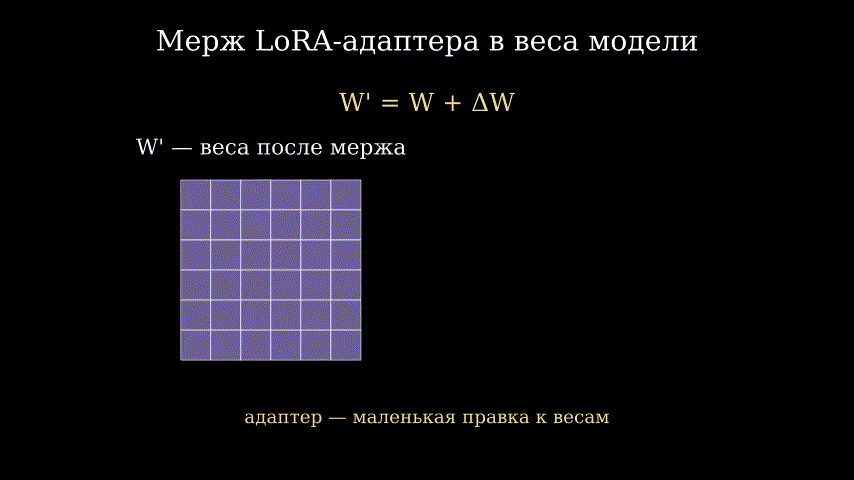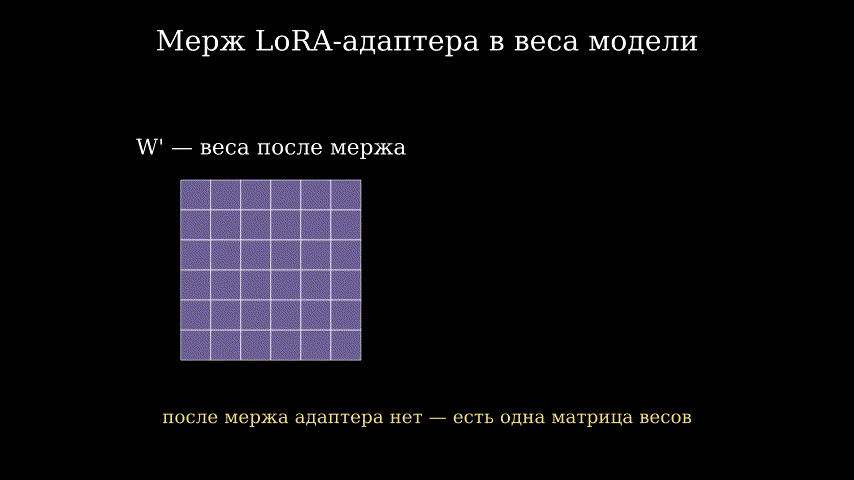
Мерж: ΔW адаптера прибавляется к W, получается единая матрица весов. Один файл вместо двух, и серверу не нужно уметь применять адаптеры.
Методика теста: случайные вопросы и два судьи
Шаг 1. Отбор вопросов
Из ~ 20 тысяч записей случайным образом выбираются 100. Зерно генератора зафиксировано, поэтому набор воспроизводится точно. Главное: из выборки исключаются все вопросы, которые когда-либо использовались в прошлых прогонах, и пересечение проверяется программно — оно обязано быть нулевым. С каждым новым прогоном пул использованных вопросов только растёт.
Каждый вопрос — «предоставь точное описание сущности X из Синтаксис-помощника»: метод, свойство, событие, объект. Никакого RAG и подсказок — модель отвечает только из весов.
Шаг 2. Ответы модели
Вопросы уходят в модель Qwen3.6-27B-Q8_LoRA1C на бэкенде llama.cpp. Параметры инференса фиксированы: температура 0.3, зерно 42, лимит 4096 токенов. Зацикливание ловится стриминговым сторожем с автоповтором; в откалиброванных прогонах ни один вопрос не был пропущен.
Шаг 3. Два судьи
Каждый ответ оценивает JEV-модель OpenJev-Q4_K_M в decision-протоколе: она не пишет текст, а возвращает готовый вердикт — correct, partially_correct или incorrect — с оценкой уверенности. Также попробовал аналогичную JEV like модель Kev-27B-Q6_K.
Одному JEV подобному судье доверять не стоит, поэтому те же ответы оценивает вторая модель — Qwen3.6-27B-Q8 или DS-V4.1-Flash-1017-UD-Q4_K_XLв обычном chat-режиме. Зачем она нужна:
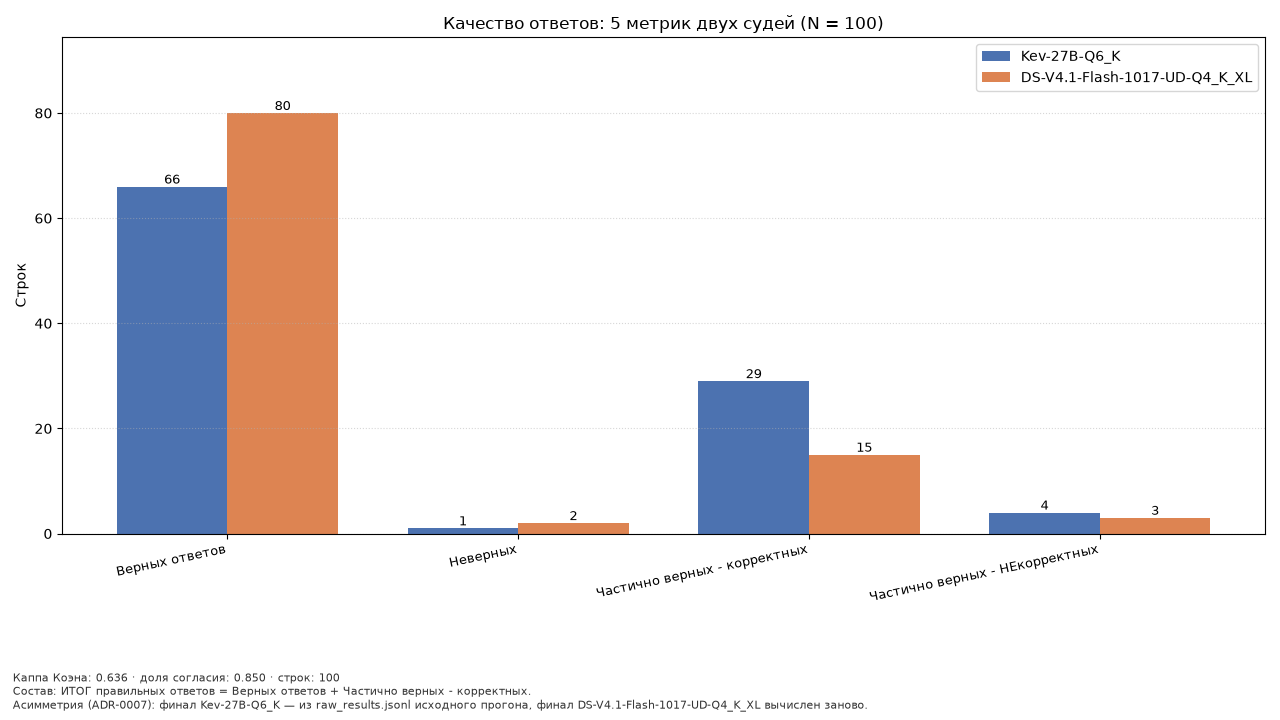
– понять, где JEV ошибается. На шести контрольных сравнениях по 100 ответов судьи согласились на 88–96 % вердиктов (каппа Коэна 0.63–0.90). Расхождения есть, и это ожидаемо: оба судьи сэмплируют с температурой выше нуля;
– сравнить итоги. Итоговая доля правильных ответов по вердиктам двух судей расходилась на один–шесть процентных пунктов, причём в половине прогонов — всего на один–два;
– сравнить подходы к оценке. Chat-судья генерирует вердикт как свободный текст — это полноценная генерация со всеми её затратами. JEV в decision-протоколе генерации не имеет вовсе: она разбирает вход и выбирает один из готовых вариантов. Такой протокол принципиально дешевле по времени на вердикт — ощутимо быстрее, чем chat-генерация ответа. Точную кратность я не замерял и называть конкретные числа не буду.
Согласие судей — это не точность. Размеченного людьми эталона вердиктов у меня нет, и я не делаю вид, что есть. Поэтому все сомнительные вердикты я смотрел руками.
Шаг 4. Частично корректный — не значит неправильный
Самое важное в методике. Судья часто говорит «частично корректно», и раньше такое шло в минус. Но потеря потери рознь:
– некритичное (minor): потеряна версия «доступен, начиная с 8.3.х», потерян или искажён пример кода, описание переформулировано;
– критичное (major): потеряно или искажено имя объекта, имя параметра, тип.
Логика простая. Опытному разработчику обычно достаточно контекстной подсказки в IDE, где показывается минимум инфомации: параметры методов, функций, процедур и событий, обязательность параметров, типы данных параметров, а также тип возвращаемого значения.
Поэтому частично корректные ответы проходят два фильтра. Первый — лексическое покрытие: если ответ покрывает эталон хотя бы на 60 %, потеряно явно немногое. Второй — детерминированная проверка, не имеющая к LLM никакого отношения: скрипт просто ищет в ответе имя объекта, имена параметров, версию и пример. Не нашёл — ставит флаг потери и эскалирует вердикт вверх, но никогда не вниз. Если потеряно только некритичное, ответ засчитывается как корректный, а факт зачёта фиксируется отдельным счётчиком — при желании легко посчитать и строгую метрику без повышений.
Примеры из тестов
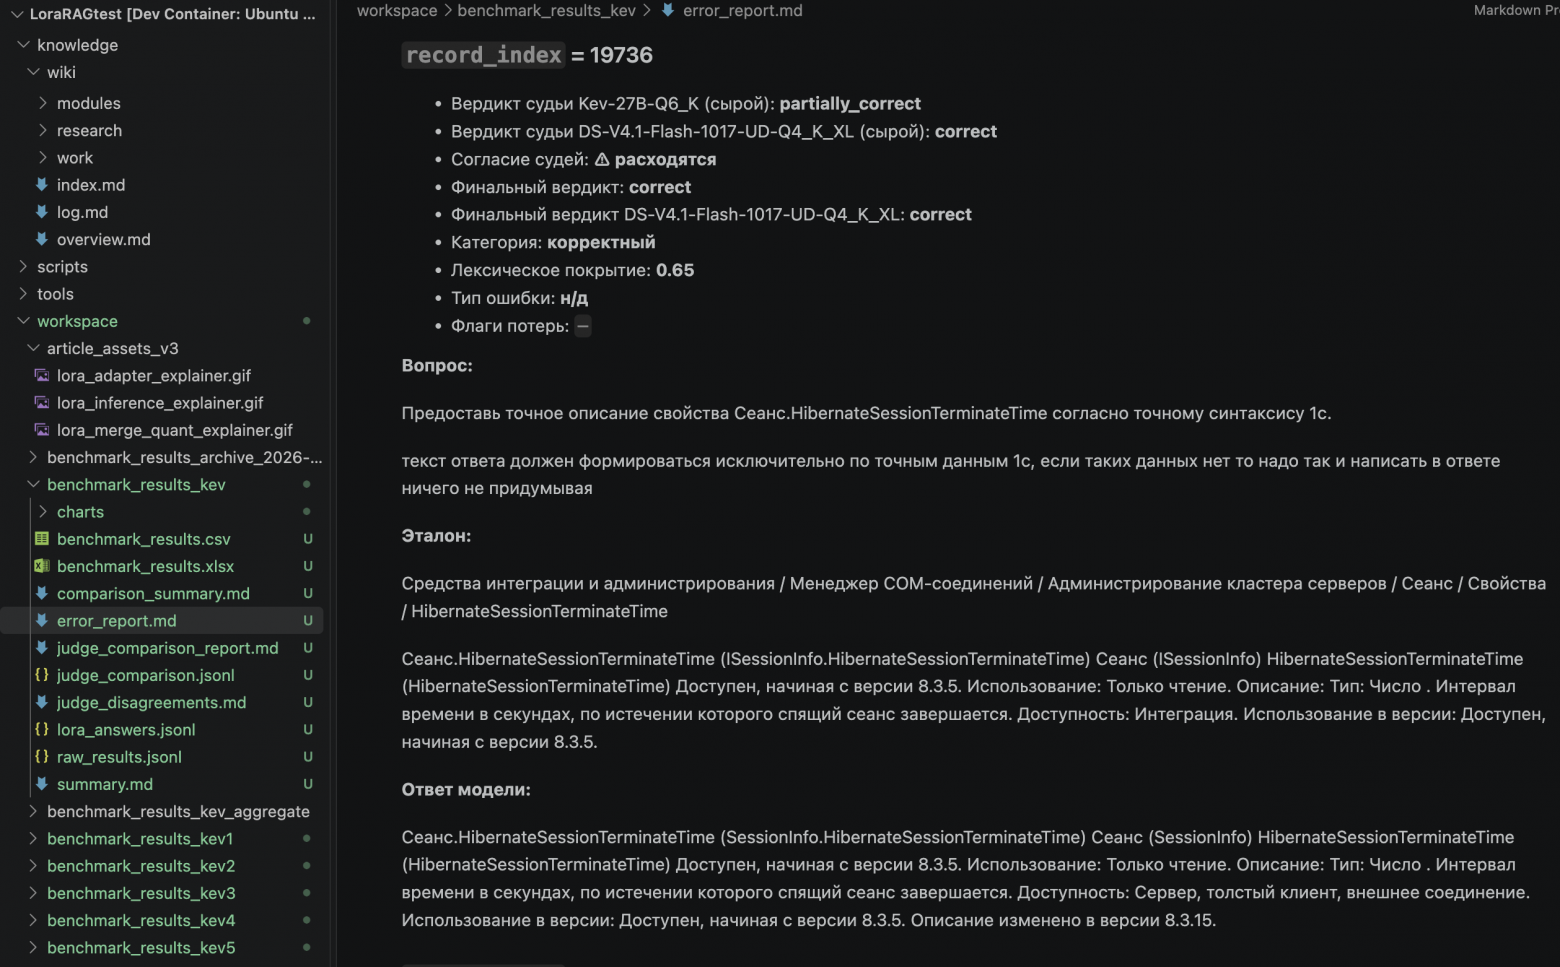
Три реальных ответа, где судья сказал «частично корректно», а мой вердикт — «корректно».
ИзвлечениеТекста.ПолучитьТекст(). Модель выдала точное имя, синтаксис без параметров, тип возврата Строка, версию 8.1 — всё как в эталоне. Потеряла пример использования и написала «получает текст из файла» вместо «извлекает текст из файла». Судья дал частично корректный вердикт из-за покрытия 0.41 — ниже порога. Но детерминированная проверка критичных потерь не нашла: minor, засчитано. Код Текст = ИзвлечениеТекста.ПолучитьТекст() по этому ответу пишется валидный.
ПолеВвода.ПриИзменении(). Имя события, синтаксис ПриИзменении(), версия 8.0 — точные. Описание короче эталонного: «возникает при изменении значения в поле ввода» вместо абзаца с подробностями про переход на другой элемент. Покрытие 0.52. Для обработчика события важны имя и сигнатура — они на месте. Засчитано.
ИнформацияОКопииБазыДанных.СерверБазыДанных. Свойство: имя, английский синоним, версия 8.3.27, «только чтение», тип Строка — всё точно. Описание отличается формулировкой: «имя сервера базы данных копии» вместо «имя сервера, соответствующее копии базы данных». Смысл тот же, покрытие 0.56. Засчитано.
Общее у всех трёх: критичные данные — имя сущности, сигнатура, типы — воспроизведены точно. Теряется полезная информация, по которой код не пишут.
Результаты: все прогоны не ниже 95 %
Откалиброванных прогонов было 6, каждый по 100 случайных непересекающихся вопросов, на одном бэкенде, с одним судьёй и одними порогами. Все дали результат не ниже 95 % корректных ответов.
Разброс между прогонами при этом остаётся: 100 вопросов — небольшая выборка, и доля корректных ответов от прогона к прогону гуляет в пределах нескольких процентных пунктов. Нижняя граница по всем прогонам — 95 %.
В минус идут только потери, из-за которых код может не заработать: потерянные или искажённые имена объектов, имена параметров, типы. Потерянный пример кода или переформулированное описание при точной сигнатуре засчитывается как корректный — по правилам шага 4.
Сводный итог: 6 прогонов по 100 вопросов, все результаты не ниже 95 % корректных ответов.
Выводы по итогу: вода и дубликаты
Результат уже хороший, но его можно улучшить, и улучшать надо не модель, а датасет.
Модель как и человек может забыть любые данные из датасета, но какие то из данных могут быть не критичными.
Получается, если больше каких то не критичных-справочных данных, то шанс, что в 6% потерь попадут критичные даные, меньше.
Также можно попробовать добавить “не простое” дублирование, для всех критично важных данных.
По моему мнению, 94% процента покрытия LoRA адаптера для точных данных вполне достаточно, чтобы уместить все критически важные данные, если правильно умещать.
OpenJev 27B и Kev 27B работают быстро, разница в скорости ~16 раз с обычными моделями, по количеству найденных НЕКОРРЕКТНЫХ ответов схожи с обычными моделями /v1/chat/competition , но иногда существенно ошибаются, особено с ЧАСТИЧНО ВЕРНЫМИ ответами. Планировал сделать tool для проверки выполнения задач по плану с помощью jev подобных моделей, но пока повременю.
Автор: PloAl
Источник [5]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38039
URLs in this post:
[1] ошибка: http://www.braintools.ru/article/4192
[2] обучения: http://www.braintools.ru/article/5125
[3] Случайность: http://www.braintools.ru/article/6560
[4] Логика: http://www.braintools.ru/article/7640
[5] Источник: https://habr.com/ru/articles/1103746/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1103746
Нажмите здесь для печати.