Модель отредактировала веса другой модели без обучения. Часть 2: почему петля рвётся, а навык не добавить
Обложка сгенерирована с помощью ИИ
Статья получилась большой, поэтому я разбил её на две части. Это часть 2 из 2. Первая часть [1] — про сами эксперименты MIT, дифф отредактированной Qwen и математику [2] проекции; здесь — динамика петель, пределы метода, родственные работы, устройство весов разных моделей и риски.
Коротко о первой части
-
В посте MIT CSAIL [1] модель GPT-6 Astra правила веса чужих сетей напрямую, без градиентов. Главный пример — Qwen3.5-0.8B, которая на олимпиадных задачах в 93 % случаев уходила в бесконечный повтор.
-
Я побитово сравнил базовый и опубликованный отредактированный чекпойнт: изменены 131 072 веса в
down_projдвух слоёв (15 и 19), и правка имеет вид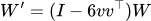 — ранг 1, 99.999 % энергии в одном направлении
 .
-
Это не «вычитание» направления, а его разворот: компонента вдоль
 становится
 от исходной. Среди правок, которые так меняют одну ось, это минимальная по норме Фробениуса.
-
Почему это вообще работает: все слои пишут в общий residual stream, а MLP — это сумма столбцов
down_proj, взвешенных активациями нейронов. Значит, повернув одну ось на выходе MLP, мы меняем то, что все последующие слои «читают» вдоль неё.
Метки те же: [Статья], [Доказано], [Мой замер], [Модель/интерпретация].
Часть 1. Почему разворот одного направления лечит зацикливание
1.1. От направления к решению «выйти из цикла»
[Модель] На каждом шаге модель выбирает между «продолжить петлю» и «сломать её» (закрыть </think>, написать ответ, сменить мысль). Выбор определяется разностью логитов двух токенов. Логиты — линейная функция финального состояния:  , где
 — разность соответствующих строк выходной матрицы. По свойству суммы residual stream (первая часть, 3.1) вклады слоёв 15 и 19 входят в
 слагаемыми, пропорциональными
 . Если
 работает как «продолжай» (
 ), разворот знака у этих нейронов сдвигает
 в сторону выхода на каждом шаге, где они активны. Это допущение:
 мы не измеряли, и следующие слои могут частично компенсировать сдвиг.
Если по-простому: где-то в конце модель «голосует», продолжать ли тот же кусок текста. Слои 15 и 19 раньше подбрасывали голос «за». После правки они голосуют «против», и чаша весов чаще перевешивает в сторону выхода.
1.2. Мой замер: на петле эти нейроны правда пишут в v сильнее
[Мой замер] Я прогнал обе модели на CPU на двух текстах. Первый — нормальное решение уравнения (220 токенов). Второй — искусственная петля «Wait, let me check again…» ×12 (397 токенов). Хуком снимал, сколько выход MLP пишет вдоль  (
code/demo_probe.py):
|
среднее |
норм. текст, L15 |
петля, L15 |
норм. текст, L19 |
петля, L19 |
|---|---|---|---|---|
|
база |
0.273 |
0.385 |
0.280 |
0.520 |
|
правка |
−0.816 |
−1.518 |
−0.014 |
−0.246 |

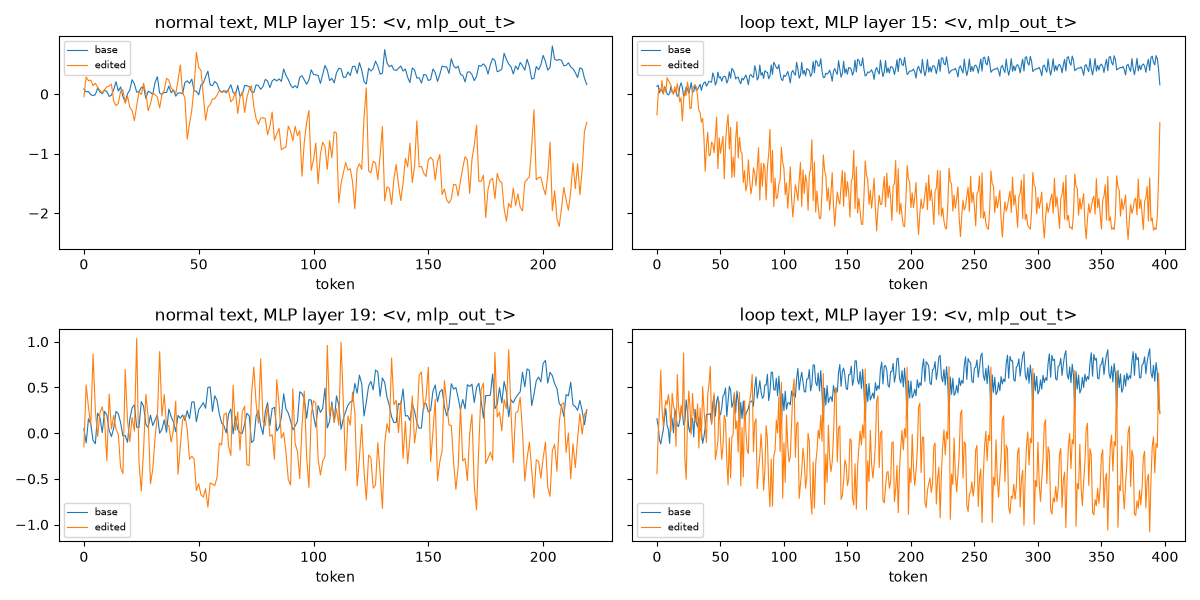
Рис. 1. 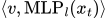 по позициям: база против правки на нормальном и зацикленном тексте.
На петле базовые MLP пишут в  сильнее: в 1.4 раза в слое 15 и в 1.9 раза в слое 19. После правки знак противоположный. Это всего два текста, то есть иллюстрация, а не статистика. Короткая генерация (400 токенов) за отведённое время до ответа не дошла ни у одной модели, поэтому выводов из неё я не делаю.
1.3. Геометрическая модель: (1−p)^T
[Модель] Пусть, попав в петлю, модель на каждом токене выходит из неё с маленькой вероятностью  . Тогда вероятность не выйти за
 токенов — это
 «неудач» подряд:
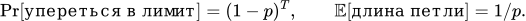
Подставим цифры статьи ( ). 93 % обрывов соответствуют
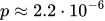 , 33.1 % —
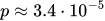 . Шанс выхода на токен вырос примерно в 15 раз. Для маленьких
 логит и логарифм почти совпадают, так что это сдвиг логита выхода всего на
 . Это не измерение, а перевод цифр статьи на язык модели.
Если по-простому: если каждый шаг даёт крошечный шанс вырваться, то при 32 тысячах шагов вероятность так и не вырваться очень чувствительна к этому шансу. Увеличить его в 15 раз — немного в абсолютных числах, но доля «застрявших» ответов падает с 93 % до трети.
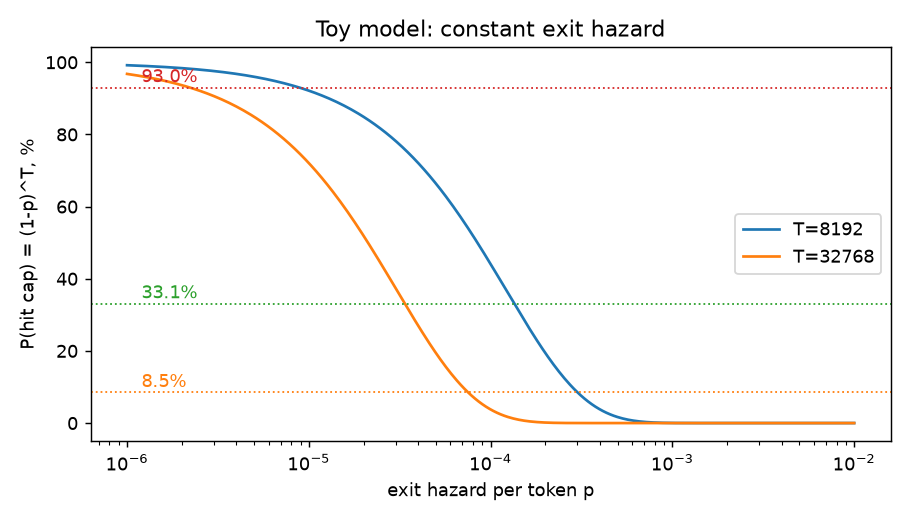
Рис. 2.  для
 и
 ; горизонтали — 93 %, 33.1 % и 8.5 % из статьи. Аналитическая кривая, не данные.
Константное  — грубое упрощение. Xu и др. [2] показали, что повторы самоусиливаются: чем больше раз фраза уже повторилась, тем вероятнее следующий повтор. Петля становится ловушкой, из которой с каждым шагом выбраться труднее; о той же дегенерации при жадном декодировании писали Holtzman и др. [3]. Я собрал игрушечную марковскую модель с таким самоусилением (
code/loop_sim.py). Видно пороговое поведение [3]: небольшой сдвиг логита переводит систему из режима «почти всегда застревает» в режим «почти никогда».
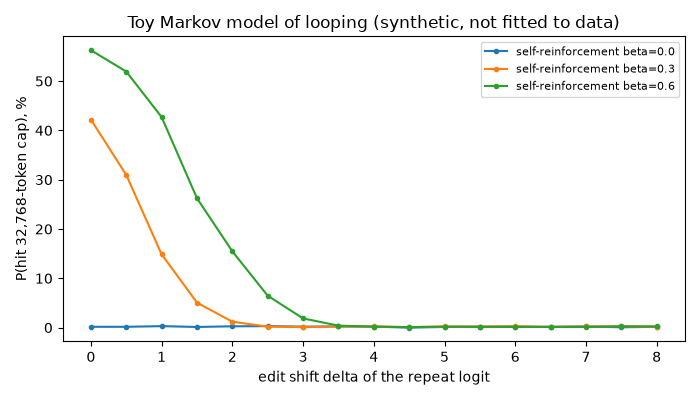
Рис. 3. Монте-Карло игрушечной модели (параметры произвольные, не подогнаны под данные): доля обрывов в зависимости от сдвига логита при разной силе самоусиления β.
[Интерпретация] 93 % против 8.5 %. У Qwen ловушка срабатывает почти всегда, и её ослабление сразу открывает решения, которые модель и так умела довести до конца. Самопроверка Astra это подтверждает: 576 из 579 «спасённых» задач — бывшие обрывы, а точность на ответах, которые и раньше доходили до конца, не изменилась [4]. У Gemma ловушки почти нет, так что сдвигать нечего.
Часть 2. Почему нельзя добавить навык, но можно добавить схему машинке
2.1. Проекция ничего не добавляет
[Доказано] Если правка — проектор  , то новое представление
 вычисляется из старого
 . По неравенству обработки данных информации о правильном ответе
 в нём не больше, чем было:
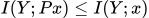 . Размерность тоже не растёт (
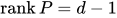 ).
Честная оговорка. Строгого запрета это не даёт. Во-первых, правка с  обратима. Во-вторых, вся информация и так есть в промпте, а модели не хватает вычисления, а не информации. Корректная формализация — «usable information» с вычислительными ограничениями [5], и там обработка может делать информацию доступнее. Поэтому сильное утверждение у меня только на уровне модели [Интерпретация]: одна ось с одним масштабом может переключить режим («продолжать» / «выходить»), но не может вписать новый алгоритм, например корректную многозначную арифметику. У Gemma ошибки [4] распределённые, единого узкого места нет, и это сходится с её провалом.
Если по-простому: выключатель может погасить мешающий шум, но не может научить. Qwen умела решать, просто не могла остановиться, и правка убрала помеху. Gemma ошибается в самих вычислениях, а «где выключатель у неумения считать», не существует.
2.2. Машинка: тут правка именно добавляет схему
[Доказано: явная конструкция] У машинки обратная ситуация: нужно добавить в политику кусок, которого не было. Его можно вписать вручную. Простейший «если — то» строится из двух ReLU: при 
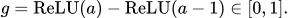
Гейт  равен 0 по одну сторону порога и 1 по другую. Затем к логитам добавляется
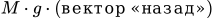 с большим
 . Пока гейт открыт, побеждает новая команда, а когда закрыт, работает исходная сеть без изменений. Пять промежуточных tanh-слоёв сигнал гейта переносят: на малых значениях tanh почти тождество, на больших почти знак, и для сигнала «да/нет» годится и то, и другое. По словам авторов, Astra сделала именно отдельный путь через несколько юнитов в каждом слое.
[Моя оценка] Три юнита на слой — это примерно 680 весов на входном слое на юнит, около 256 на каждый внутренний и 16 на выход. Итого ≈ 5 900 весов, или ~3.4 % от 171 664. Это одного порядка с 3.5 % из поста; точный состав правки я не проверял.
Если по-простому: машинке нужно было одно новое правило — «сначала сдай назад, потом газ». Такое правило умещается в пару «если — то» и несколько тысяч чисел, и его можно вписать руками. Многошаговую арифметику так не впишешь: это не одно правило, а большая программа.
Часть 3. Родственники из литературы — коротко
ROME [6] — тоже правка ранга 1, но с противоположной целью. ROME записывает новый факт: ищет минимальное изменение MLP-матрицы, при котором ключ  («Эйфелева башня находится в…») отображается в новое значение
 , а остальные ключи страдают минимально. Решение задачи наименьших квадратов с одним ограничением даёт формулу
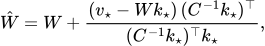
где  — ковариация «обычных» ключей. Числитель — «чего не хватает» для нового факта, знаменатель — нормировка, а
 направляет правку туда, где она меньше всего мешает старым ассоциациям. MEMIT [7] масштабирует то же на тысячи фактов. Обе работы добавляют ассоциации [5], а не алгоритмы, и это ещё одна иллюстрация к части 2.
Если по-простому: абляция говорит слою «никогда не пиши в эту сторону», ROME — «на этот конкретный вопрос отвечай вот так». Это два зеркальных хирургических приёма над одной и той же матрицей.
Направление отказа [8]. Arditi и др. ортогонализуют все матрицы, пишущие в поток, по формуле  . Правка Astra из 50 прогонов локальнее (2 матрицы, 64 столбца,
 ). Правка из 10 прогонов ближе к Arditi: 30 матриц,
 .
Task arithmetic и слияние моделей. Вектор задачи 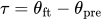 можно прибавлять и вычитать [9]. Это работает, потому что дообученные модели из одной точки старта лежат в одной «долине» лосса (linear mode connectivity [10]). Развитие этой линии — model soups [11], TIES [12], DARE [13], Git Re-Basin [14]. Отличие от Astra: там правка получена обучением [6], здесь — рассуждением.
Суперпозиция. В  -мерном пространстве почти ортогональных направлений помещается гораздо больше, чем
 : у случайных векторов косинус порядка
 (рис. 4). Сети этим пользуются и хранят больше признаков, чем измерений [15, 16]. Отсюда практическое следствие: «чистого» направления цикла может не быть, и разворот
 слегка задевает сотни соседних признаков. Поэтому важен контроль Astra со случайным направлением той же нормы [4].
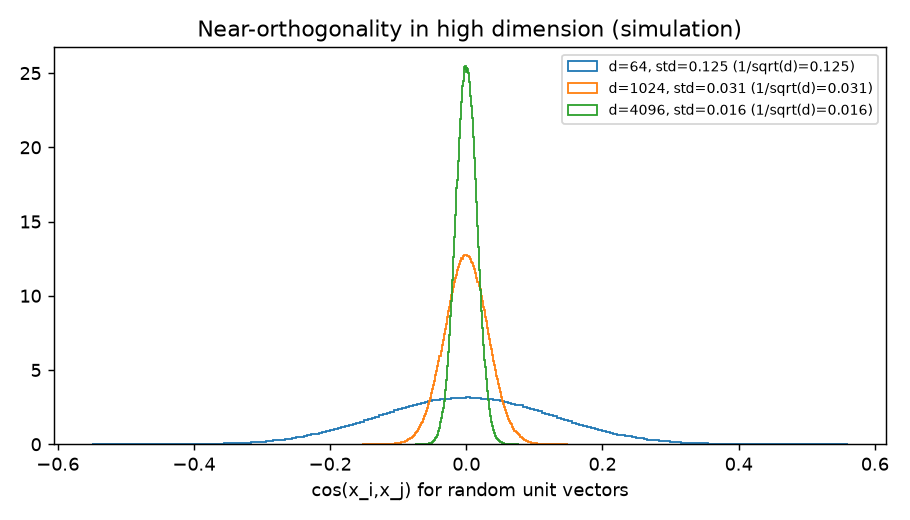
Рис. 4. Симуляция: косинусы между 2 000 случайных единичных векторов при 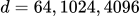 .
Часть 4. Как вообще устроены веса: Qwen, Gemma, Llama, MoE
Это справочная часть, ради которой полезно один раз посмотреть на реальные числа.
4.1. Где лежат параметры
[Мой замер] Я не стал считать по формулам, а прочитал заголовки safetensors всех шардов через HTTP Range-запросы (code/param_census.py). Это точные формы тензоров без скачивания самих весов. Gemma 3 и Llama у официальных репозиториев закрыты авторизацией, поэтому заголовки взяты из публичных зеркал unsloth/gemma-3-270m, unsloth/Llama-3.2-1B, NousResearch/Meta-Llama-3.1-8B. Конфиги в этих зеркалах соответствуют оригиналам, но побитовую идентичность весов я не проверял.
|
Модель |
всего (хранится) |
эмбеддинги/lm_head |
внимание [7] |
MLP |
|---|---|---|---|---|
|
Gemma 3 270M |
0.268B |
62.6 % |
11.0 % |
26.4 % |
|
Qwen2.5-0.5B |
0.494B |
27.6 % |
8.9 % |
63.5 % |
|
Qwen3-0.6B |
0.752B* |
41.4 %* |
23.4 % |
35.2 % |
|
Qwen3.5-0.8B |
0.873B |
29.1 % |
26.8 % (вкл. линейное) |
30.3 % (+13.9 % vision/MTP) |
|
Llama 3.2 1B |
1.236B |
21.3 % |
13.6 % |
65.2 % |
|
Qwen3-8B |
8.191B |
15.2 % |
18.4 % |
66.4 % |
|
Llama 3.1 8B |
8.030B |
13.1 % |
16.7 % |
70.2 % |
|
Mixtral 8x7B |
46.7B |
0.6 % |
2.9 % |
96.6 % (эксперты) |
|
Qwen3-30B-A3B |
30.5B |
2.0 % |
3.0 % |
95.0 % (эксперты) |
|
DeepSeek-V3 |
684.5B** |
0.4 % |
1.7 % (MLA) |
97.2 % routed + 0.4 % shared + 0.2 % dense |
* В чекпойнте Qwen3-0.6B лежат и embed_tokens, и lm_head, хотя в конфиге tie_word_embeddings: true, поэтому эмбеддинги учтены дважды. ** Включая MTP-модуль. Без него получается 671B, как в техотчёте [17].
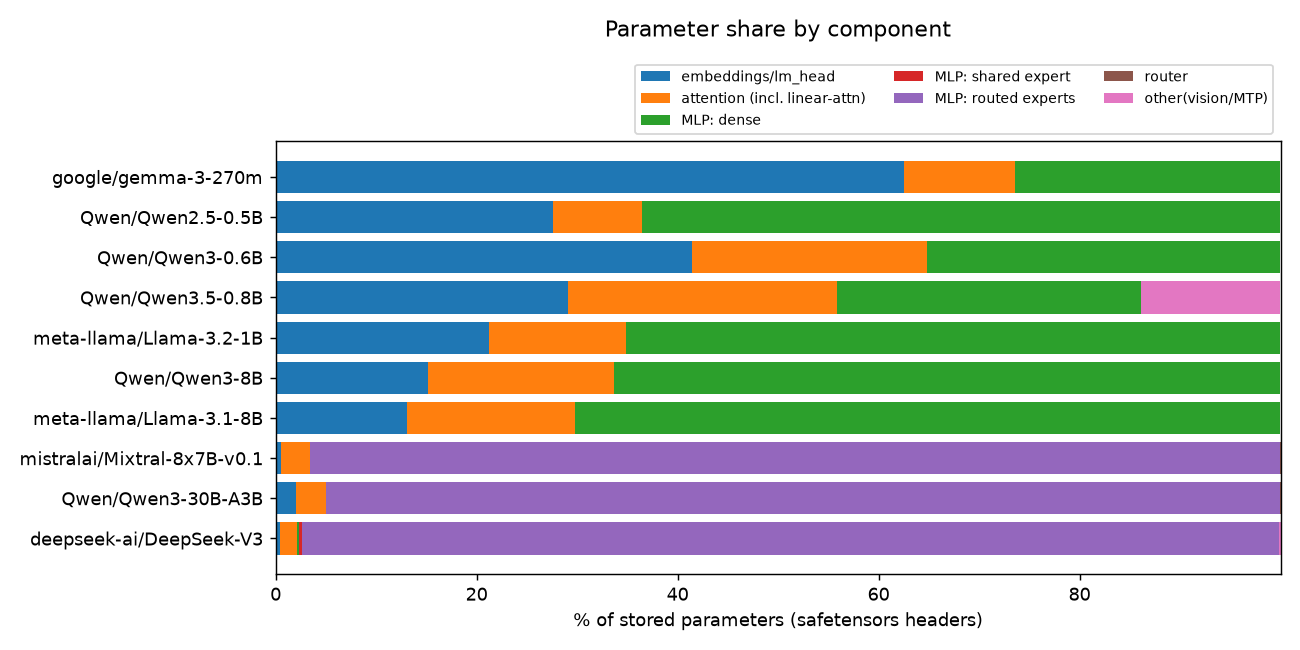
Рис. 5. Доля хранимых параметров по компонентам, по заголовкам safetensors.
Что видно из таблицы:
-
Gemma 3 270M — это наполовину словарь.
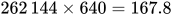 М параметров ушли на эмбеддинг, и на 18 слоёв трансформера остаётся около 100 М. Для правки «изнутри» это меньше «вычислительного мяса», а правки эмбеддингов в эксперименте были запрещены. [Интерпретация] Это ещё один довод в пользу того, что у Gemma просто нечего «разблокировать».
-
Qwen3.5-0.8B — гибрид. По
layer_typesиз конфига каждый четвёртый слой — полное внимание (full_attention_interval: 4), остальные —linear_attention. В конфиге также стоятattn_output_gate: true, GQA 8 голов запроса на 2 KV-головы приhead_dim256, словарь 248 320 и tied-эмбеддинги. Блок MLP при этом классический SwiGLU 1024 → 3584 → 1024, поэтому выкладки первой части к нему применимы буквально. -
Плотные модели среднего размера (Llama 3.1 8B:
 , 32 слоя, 32 Q-головы / 8 KV, FFN 14 336). Проверка: внимание на слой
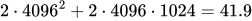 М, ×32 = 1 342 М; MLP
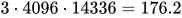 М, ×32 = 5 637 М. Оба числа точно совпадают с заголовками. Около 70 % весов — в MLP, то есть именно в «ключах и значениях» из первой части (3.2).
4.2. Как MoE меняет картину
В MoE вместо одного MLP стоит набор экспертов  и роутер:
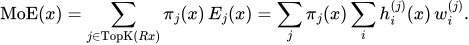
Разложение 3.2 сохраняется, только коэффициенты теперь ещё и гейтятся роутером. По конфигам:
-
Mixtral: 8 экспертов, top-2 [18];
-
Qwen3-30B-A3B: 128 экспертов, 8 активных,
moe_intermediate_size768; -
DeepSeek-V3: 256 routed + 1 shared эксперт, 8 активных, первые 3 слоя плотные, MLA-внимание с
kv_lora_rank512 [17].
[Интерпретация] Для «правок в пространстве весов» MoE двояк. С одной стороны, 97 % весов лежат в экспертах, и каждый эксперт видит только часть токенов, так что правка конкретного эксперта локальна по определению. С другой стороны, одно и то же направление в потоке пишут десятки экспертов. Чтобы убрать его из потока, придётся ортогонализовать всех:  матриц down у DeepSeek-V3. Иначе роутер просто направит токен в нетронутого эксперта.
4.3. Как выглядят сами матрицы
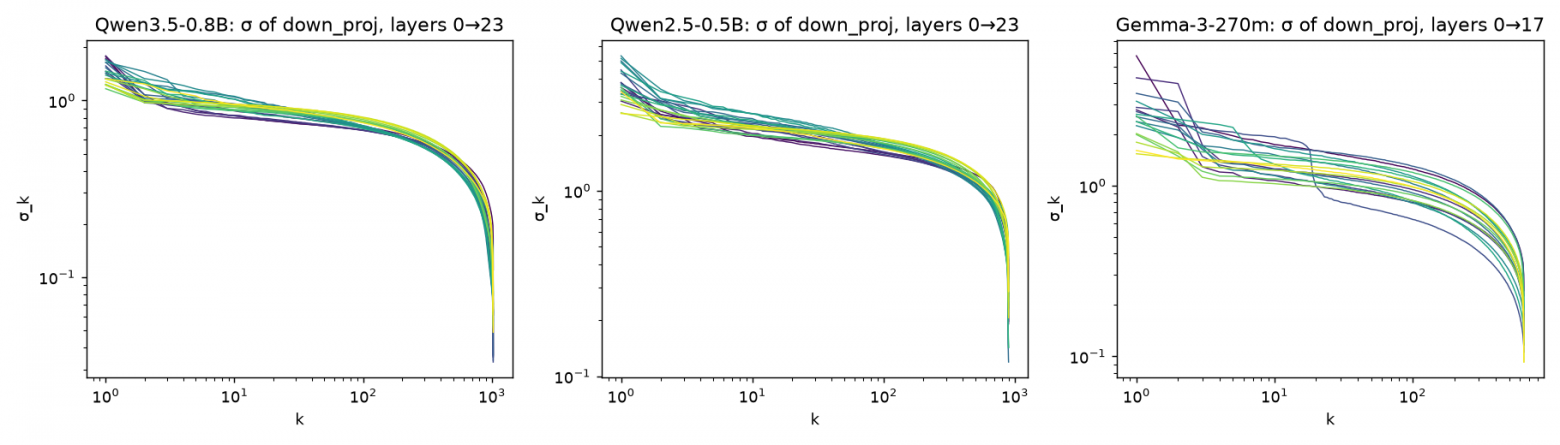
Рис. 6. Сингулярные числа down_proj по всем слоям трёх моделей, от светлого к тёмному по глубине.
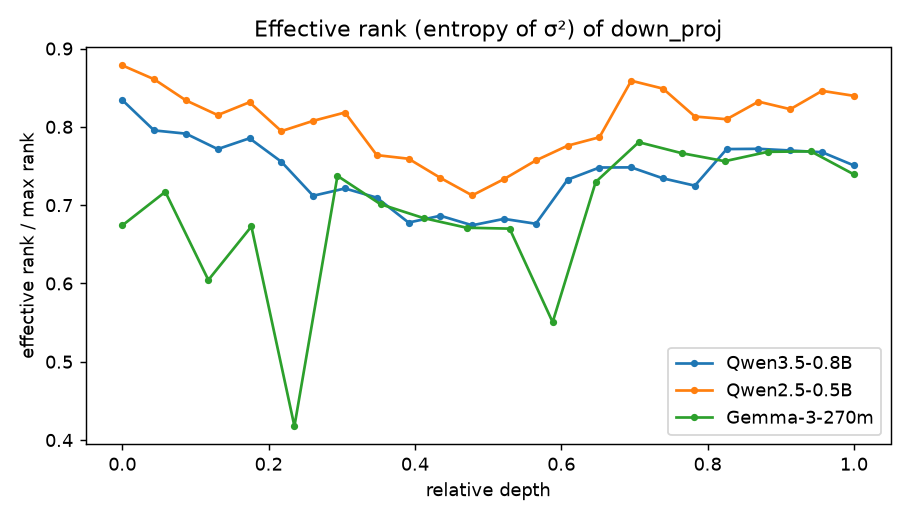
Рис. 7. Эффективный ранг 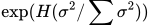 , нормированный на максимальный.
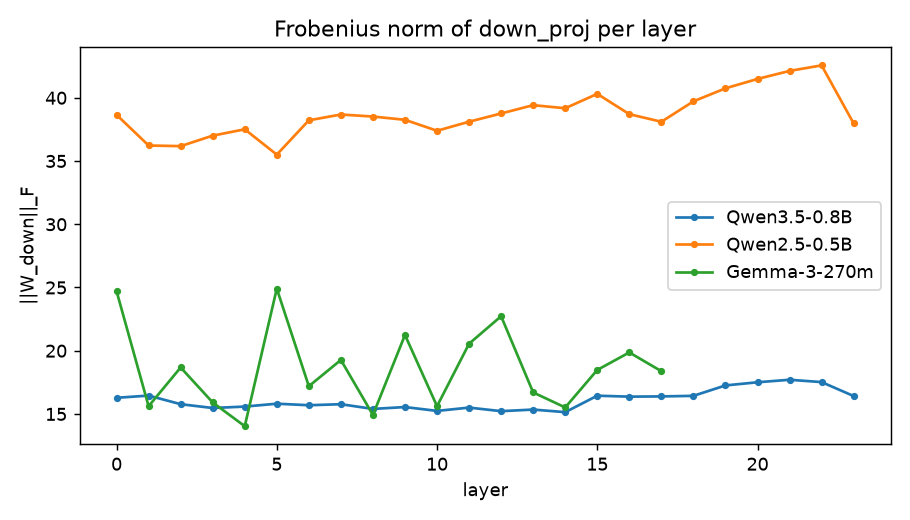
Рис. 8. Фробениусова норма down_proj по слоям.
[Мой замер] У Qwen3.5-0.8B эффективный ранг down_proj (1024×3584) составляет 690–854 из 1024 и имеет U-образный профиль с минимумом посередине (слои 9–13). У Qwen2.5-0.5B — 638–787 из 896, тоже с минимумом в середине. Матрицы далеки от низкорангового вида: модель использует почти всё пространство. Поэтому изменение ранга 1 на 64 столбцах — действительно точечная операция на фоне «плотной» матрицы: относительная фробениусова норма правки составила 10.6 % и 8.1 % от всей матрицы, но вся она сосредоточена в одном направлении из 1024. Нормы у Qwen3.5 почти постоянны по глубине (15–18). У Gemma они «пилообразные» (14–25), и максимумы приходятся на слои 0, 5, 12: 5 и 11 — слои с полным вниманием, а 0 и 12 — нет. Прямую связь я не утверждаю.
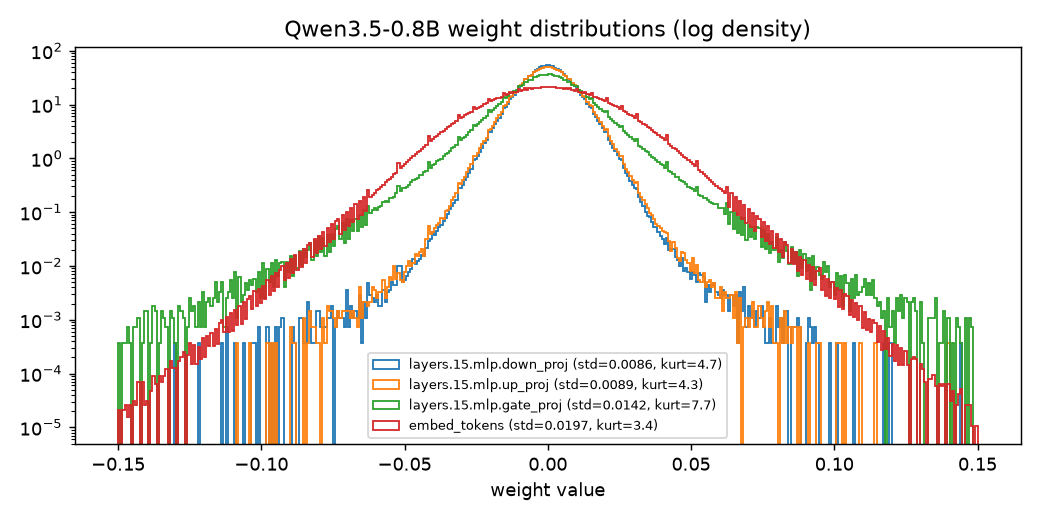
Рис. 9. Распределения весов Qwen3.5-0.8B (слой 15 и эмбеддинг), логарифмическая шкала плотности.
Распределения тяжёлохвостые. Эксцесс равен 4.7 у down_proj, 7.7 у gate_proj и 3.4 у эмбеддинга (у гауссианы 3). Максимум  в
down_proj слоя 15 составляет 0.18 при σ = 0.0086, то есть около 21σ. Для правок это означает, что «посмотреть на большие веса» — плохая эвристика, и Astra её не использовала: отбор шёл по проекции на  , а не по величине (см. первую часть).
Часть 5. Ограничения, риски, открытые вопросы
Ограничения постановки. Это блог-пост, а не рецензированная статья. Модель Astra закрыта, и воспроизвести процесс поиска правки снаружи нельзя. Воспроизводима только сама правка, и её независимо перепроверили [19]. Три бюджета прогонов дали три разные правки с очень разным эффектом (12.3 / 14.1 / 48.1). Вывод: один удачный запуск — это ещё не надёжный метод. Авторы сами пишут, что строят бенчмарк и harness.
Модель, правящая себя. Авторы прямо называют рекурсивное самоулучшение одним из направлений. С формальной точки зрения [8] правка весов — это действие с последствиями для всех будущих входов (см. 4.2: она не зависит от промпта). В отличие от промпта, её нельзя «откатить контекстом». Значит, нужен по крайней мере тот же уровень контроля, что и для обучения: фиксированные eval-сеты, контроль регрессий, ревью диффа.
Аудируемость. Есть и хорошая новость: правка ранга 1 читается лучше любого файнтюна. Диф из двух тензоров, SVD показывает одно направление, а манифест содержит sha256 до и после. Хорошо, что авторы сделали публикацию побитового диффа нормой. [Интерпретация] Плохая новость: правку той же нормы, но «размазанную» на много направлений, найти по весам существенно труднее. Аргумент суперпозиции (7.4) работает и против аудитора.
Цепочка поставок весов. Чекпойнт — это исполняемая логика [9], а не данные. Подмена 0.016 % весов может заметно поменять поведение [10], и метрики на стандартных бенчмарках эту подмену могут не выявить: на практике это сводится к контролю происхождения (хэши, подписи, воспроизводимые сборки). Обратная сторона статьи — тезис авторов, что LLM, читающая веса, могла бы искать такие вмешательства («auditing without evaluation»). В посте это заявлено как перспектива, а не результат: в эксперименте 7 по одним только весам сикофантскую модель отличить не удалось, удалось только с паттернами внимания.
Открытые вопросы (вам, читателям):
-
Почему
 , а не 1? Абляция (
 ) не хватает, потому что остальные слои тоже пишут в
 ? Или нужен активный сигнал «выходи из цикла»? Это проверяется дёшево: сравнить
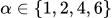 на 100 задачах с лимитом токенов.
-
Можно ли найти то же направление без LLM, классическим diff-in-means между «зацикленными» и «продуктивными» контекстами, как у Arditi и др.? Если да, то что именно добавляет «рассуждение» Astra?
-
Где граница между «снять препятствие» и «добавить навык»? Машинка показывает, что вписать вручную можно то, что описывается коротко. Есть ли для LLM навыки с короткой схемой, которых у модели нет?
-
Как такие правки ведут себя при квантизации? В bf16 уже 884 из 131 072 изменений округлились в ноль. Что останется в int4?
Код и воспроизведение
Все скрипты лежат в code/ и работают на CPU (8 ядер, 15 ГБ RAM):
-
analyze_edit.py— дифф базовой и отредактированной Qwen3.5-0.8B, SVD правки, подгонка ;
-
param_census.py— подсчёт параметров по заголовкам safetensors; -
charts.py— рисунки первой части и рис. 2, 4–9 этой части (спектры, нормы, гистограммы, аналитическая кривая, симуляция косинусов); -
demo_probe.py— зонд (рис. 1) и короткая генерация;
-
loop_sim.py— игрушечная марковская модель (рис. 3).
Ключевая часть зонда:
for L in (15, 19):
    lm.layers[L].mlp.register_forward_hook(
        lambda mod, i, o, L=L: rec.__setitem__(L, (o[0] @ v[L]).detach()))
with torch.no_grad():
    model(tok(text, return_tensors='pt').input_ids)
Источники
-
Takehi R., Teoh J., Zhang A., Khattab O. Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights. MIT CSAIL, 2 Nov 2026. https://rikiyat.github.io/blog/weight-space-programming/ [11]
-
Xu J. et al. Learning to Break the Loop: Analyzing and Mitigating Repetitions for Neural Text Generation. https://arxiv.org/abs/2206.02369 [12]
-
Holtzman A. et al. The Curious Case of Neural Text Degeneration. https://arxiv.org/abs/1904.09751 [13]
-
Логи экспериментов: https://github.com/RikiyaT/lm_understand-logs [14] (каталог
exp8_math/) -
Xu Y. et al. A Theory of Usable Information Under Computational Constraints. https://arxiv.org/abs/2002.10689 [15]
-
Meng K. et al. Locating and Editing Factual Associations in GPT (ROME). https://arxiv.org/abs/2202.05262 [16]
-
Meng K. et al. Mass-Editing Memory in a Transformer (MEMIT). https://arxiv.org/abs/2210.07229 [17]
-
Arditi A. et al. Refusal in Language Models Is Mediated by a Single Direction. https://arxiv.org/abs/2406.11717 [18]
-
Ilharco G. et al. Editing Models with Task Arithmetic. https://arxiv.org/abs/2212.04089 [19]
-
Frankle J. et al. Linear Mode Connectivity and the Lottery Ticket Hypothesis. https://arxiv.org/abs/1912.05671 [20]
-
Wortsman M. et al. Model soups. https://arxiv.org/abs/2203.05482 [21]
-
Yadav P. et al. TIES-Merging: Resolving Interference When Merging Models. https://arxiv.org/abs/2306.01708 [22]
-
Yu L. et al. Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch (DARE). https://arxiv.org/abs/2311.03099 [23]
-
Ainsworth S. et al. Git Re-Basin: Merging Models modulo Permutation Symmetries. https://arxiv.org/abs/2209.04836 [24]
-
Elhage N. et al. Toy Models of Superposition. https://arxiv.org/abs/2209.10652 [25]
-
Cunningham H. et al. Sparse Autoencoders Find Highly Interpretable Features in Language Models. https://arxiv.org/abs/2309.08600 [26]
-
DeepSeek-AI. DeepSeek-V3 Technical Report. https://arxiv.org/abs/2412.19437 [27]
-
Jiang A. Q. et al. Mixtral of Experts. https://arxiv.org/abs/2401.04088 [28]
-
Отредактированный чекпойнт и независимая перепроверка: https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming [29]
Автор: maxim_lomakin
Источник [30]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38048
URLs in this post:
[1] Первая часть: https://habr.com/ru/articles/1103796/
[2] математику: http://www.braintools.ru/article/7620
[3] поведение: http://www.braintools.ru/article/9372
[4] ошибки: http://www.braintools.ru/article/4192
[5] ассоциации: http://www.braintools.ru/article/621
[6] обучением: http://www.braintools.ru/article/5125
[7] внимание: http://www.braintools.ru/article/7595
[8] зрения: http://www.braintools.ru/article/6238
[9] логика: http://www.braintools.ru/article/7640
[10] поведение: http://www.braintools.ru/article/5593
[11] https://rikiyat.github.io/blog/weight-space-programming/: https://rikiyat.github.io/blog/weight-space-programming/
[12] https://arxiv.org/abs/2206.02369: https://arxiv.org/abs/2206.02369
[13] https://arxiv.org/abs/1904.09751: https://arxiv.org/abs/1904.09751
[14] https://github.com/RikiyaT/lm_understand-logs: https://github.com/RikiyaT/lm_understand-logs
[15] https://arxiv.org/abs/2002.10689: https://arxiv.org/abs/2002.10689
[16] https://arxiv.org/abs/2202.05262: https://arxiv.org/abs/2202.05262
[17] https://arxiv.org/abs/2210.07229: https://arxiv.org/abs/2210.07229
[18] https://arxiv.org/abs/2406.11717: https://arxiv.org/abs/2406.11717
[19] https://arxiv.org/abs/2212.04089: https://arxiv.org/abs/2212.04089
[20] https://arxiv.org/abs/1912.05671: https://arxiv.org/abs/1912.05671
[21] https://arxiv.org/abs/2203.05482: https://arxiv.org/abs/2203.05482
[22] https://arxiv.org/abs/2306.01708: https://arxiv.org/abs/2306.01708
[23] https://arxiv.org/abs/2311.03099: https://arxiv.org/abs/2311.03099
[24] https://arxiv.org/abs/2209.04836: https://arxiv.org/abs/2209.04836
[25] https://arxiv.org/abs/2209.10652: https://arxiv.org/abs/2209.10652
[26] https://arxiv.org/abs/2309.08600: https://arxiv.org/abs/2309.08600
[27] https://arxiv.org/abs/2412.19437: https://arxiv.org/abs/2412.19437
[28] https://arxiv.org/abs/2401.04088: https://arxiv.org/abs/2401.04088
[29] https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming: https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming
[30] Источник: https://habr.com/ru/articles/1103804/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1103804
Нажмите здесь для печати.