РобоСобака Unitree Go2: локальная LLM, шумоподавление и ускорение голосовых ответов
Запустить языковую модель на Unitree Go2 оказалось проще, чем организовать нормальный разговор. Собака должна расслышать человека рядом с собственными вентиляторами, определить конец вопроса, сгенерировать ответ и произнести его. Если каждое звено работает «довольно быстро», вместе они всё равно могут дать неприятную паузу.
Мы разместили на Jetson локальную Qwen 4B, сравнили фильтры и распознаватели на записи речи с трёх метров, а затем занялись задержкой ответа. В раннем контрольном прогоне звук начинался через 8,4 секунды после передачи текста. В более позднем — через 2,5 секунды. Между этими числами были изменения вычислительного тракта, контекста и озвучки, а также несколько результатов, которые пришлось пересмотреть.
Я Лев Ларин, инженер Unibot. В первой части [1] мы разбирались с доступом к двум компьютерам Go2, исправляли Wi-Fi и подключали русские команды к штатным API. Здесь — устройство автономного голосового тракта и его измерения. Время от текста до звука не включает микрофон и распознавание: ниже эти этапы разделены.
Два компьютера и три места для вычислений
Прежде чем обсуждать CPU и GPU, нужно разнести их по платам. В нашей Go2 EDU есть основной контроллер Unitree на Rockchip RK3588S и дополнительный Jetson Orin Nano. У каждого собственные Linux, RAM и накопитель; связь между ними — внутренний Ethernet. Для нашего голосового тракта получились три места исполнения: CPU основного контроллера, CPU Jetson и GPU Jetson.
|
Компонент |
Основной контроллер Unitree |
Дополнительный компьютер Jetson |
|---|---|---|
|
Плата / SoC |
Unitree GO2 Board, Rockchip RK3588S |
NVIDIA Jetson Orin Nano 8GB |
|
CPU |
8 ядер: 4 × Cortex-A76 + 4 × Cortex-A55 |
6 × Cortex-A78AE |
|
GPU |
Arm Mali-G610 MP4 |
NVIDIA Ampere, 1024 CUDA-ядра, 32 Tensor Cores |
|
Другие ускорители |
NPU Rockchip с паспортной производительностью до 6 TOPS |
В нашем тракте используется CUDA GPU |
|
Оперативная память [2] |
8 ГБ |
8 ГБ LPDDR5, общие для CPU и GPU |
|
Накопитель нашего экземпляра |
eMMC класса 64 ГБ |
NVMe SSD 512 ГБ |
|
Система в сохранённой диагностике |
Ubuntu 20.04.5 LTS, aarch64 |
Ubuntu 20.04.5 LTS, JetPack 5.1.1 / L4T R35.3.1, CUDA 11.4 |
Это конфигурация нашего экземпляра, а не обещание одинакового железа у каждой Go2. Модель платы и SoC основного контроллера сверили по device tree, состав CPU — по /proc/cpuinfo, память и накопители — по /proc/meminfo и lsblk. Состав ускорителей чипов можно сопоставить с описанием RK3588S у производителя модулей Boardcon [3] и характеристиками Orin Nano у NVIDIA [4]. Это характеристики кремния; 6 TOPS не являются нашим измерением и не означают, что голосовой сервис использует NPU.
Основная плата — точка доступа к роботу. Восемь ARM-ядер RK3588S обслуживают в том числе наш код рядом со штатными аудио- и управляющими сервисами. USB-микрофон и динамик доступны здесь; Wi-Fi тоже находится на основном контроллере. Наш процесс получает микрофонный DDS/Opus-поток и декодирует его на CPU, отправляет PCM на Jetson, а затем принимает WAV или запрос действия. Наш UWB-регулятор подхода и сопровождения тоже работает на CPU этой платы. Мы рассчитываем скорости цели, а исполнение движения отдаём штатным сервисам. Mali GPU и NPU Rockchip наш голосовой сервис не использует.
Jetson — обработка речи и разговор. Его шесть Cortex-A78AE заняты фильтрацией, сегментацией, распознаванием, диспетчеризацией и подготовкой запросов. GPU Ampere выполняет основную нейросетевую часть Qwen и синтез Silero. Установка модели на Jetson не означает, что всё на этой плате считается через CUDA.
В рабочей конфигурации задачи распределили так:
|
Этап |
Где выполняется |
Что именно делает |
|---|---|---|
|
Приём микрофона и декодирование Opus |
CPU RK3588S |
Подписка на штатный DDS-поток, получение PCM, передача на Jetson |
|
Профиль кулеров и усиление ×4 |
CPU Jetson |
Обработка входного PCM до распознавания |
|
Silero VAD и распознавание |
CPU Jetson |
Поиск границ речи; GigaAM v3 — в два потока, Vosk/T-one — быстрый путь |
|
Диалог и разбор намерений |
CPU Jetson |
Выбор обработчика, история, подготовка контекста и вызов модели |
|
Qwen 4B |
GPU Jetson с обслуживающим CPU-кодом |
Генерация текста; в поздней конфигурации attention и KV-кэш тоже на GPU |
|
Silero TTS |
GPU Jetson с подготовкой WAV на CPU |
Синтез частей ответа и отправка аудио основному контроллеру |
|
Действия, UWB-контур и вывод звука |
CPU RK3588S и штатные сервисы |
Запросы API, расчёт скоростей сопровождения, воспроизведение готового WAV |
Например, на «дай лапу» звук сначала декодируется на RK3588S, затем распознаётся на CPU Jetson. Диспетчер выбирает команду, отправляет её обратно, и основной контроллер вызывает штатный API. Генерацию ответа Qwen для выбора этого действия ждать не нужно. В свободном вопросе после ASR добавляется проход через Qwen на GPU Jetson, затем Silero создаёт WAV на той же плате, а звучит он через динамик основного контроллера.
Что должно поместиться на Jetson
Jetson работает с JetPack 5.1.1 и CUDA 11.4 в режиме 15 Вт. Ради этого проекта мы не обновляли всю систему и не повышали режим мощности. Его 8 ГБ LPDDR5 общие для CPU и GPU; Linux в сохранённом снимке показывал около 7,17 ГиБ MemTotal. Память RK3588S — отдельная: выгрузить в неё часть KV-кэша обычным флагом llama.cpp нельзя. SSD на 512 ГБ вмещает файлы моделей и записи, но не превращается в дополнительную быструю память для инференса.
Память нужна сразу нескольким компонентам: языковой модели, её KV-кэшу, распознавателю и синтезу. Кроме того, на Jetson продолжают работать штатные процессы. Выбирать модель только по тому, помещаются ли её веса в память, здесь недостаточно.
Мы попробовали модель на 1,7 млрд параметров, но качество разговора нас не устроило. Основной оставили Qwen3-4B-Instruct-2507 [5] в GGUF-квантовании Q4_K_M. Запуск — через llama-server из llama.cpp, локальный HTTP API на 127.0.0.1:18300/v1. В нашем варианте все 37 слоёв модели размещены на GPU.
Контекст выставили 4096 токенов, batch и microbatch — по 256, число CPU-потоков — четыре. Это выбранная конфигурация нашей системы, а не максимальная длина контекста, заявленная для исходной модели.
Сокращённая команда итогового запуска выглядит так. MODEL — путь к нашему GGUF, а бинарник и библиотеки взяты из отдельной сборки, о которой ниже:
llama-server -m "$MODEL"
  --host 127.0.0.1 --port 18300 --jinja
  -c 4096 -b 256 -ub 256 -t 4 -tb 4
  -ngl 99 -np 1
  --cache-type-k f16 --cache-type-v f16 --flash-attn
Параметр --jinja нужен нашему пути обработки шаблона чата и нативных функций. Сам сервер модели — отдельная systemd-служба: загружать веса заново для каждой реплики не приходится.
Микрофон находится на другом компьютере
USB-микрофон и динамик подключены к основному контроллеру Unitree. На Jetson того же аудиоустройства нет. Поэтому команда arecord, выполненная на Jetson, не решает задачу получения штатного звука.
На основном контроллере микрофоном уже владеет audiohub. Мы подписались на его DDS-тему rt/audiosender, декодировали Opus и передали mono PCM16, 16 кГц, на Jetson по внутреннему Ethernet. Обратно идут команды и WAV для воспроизведения.
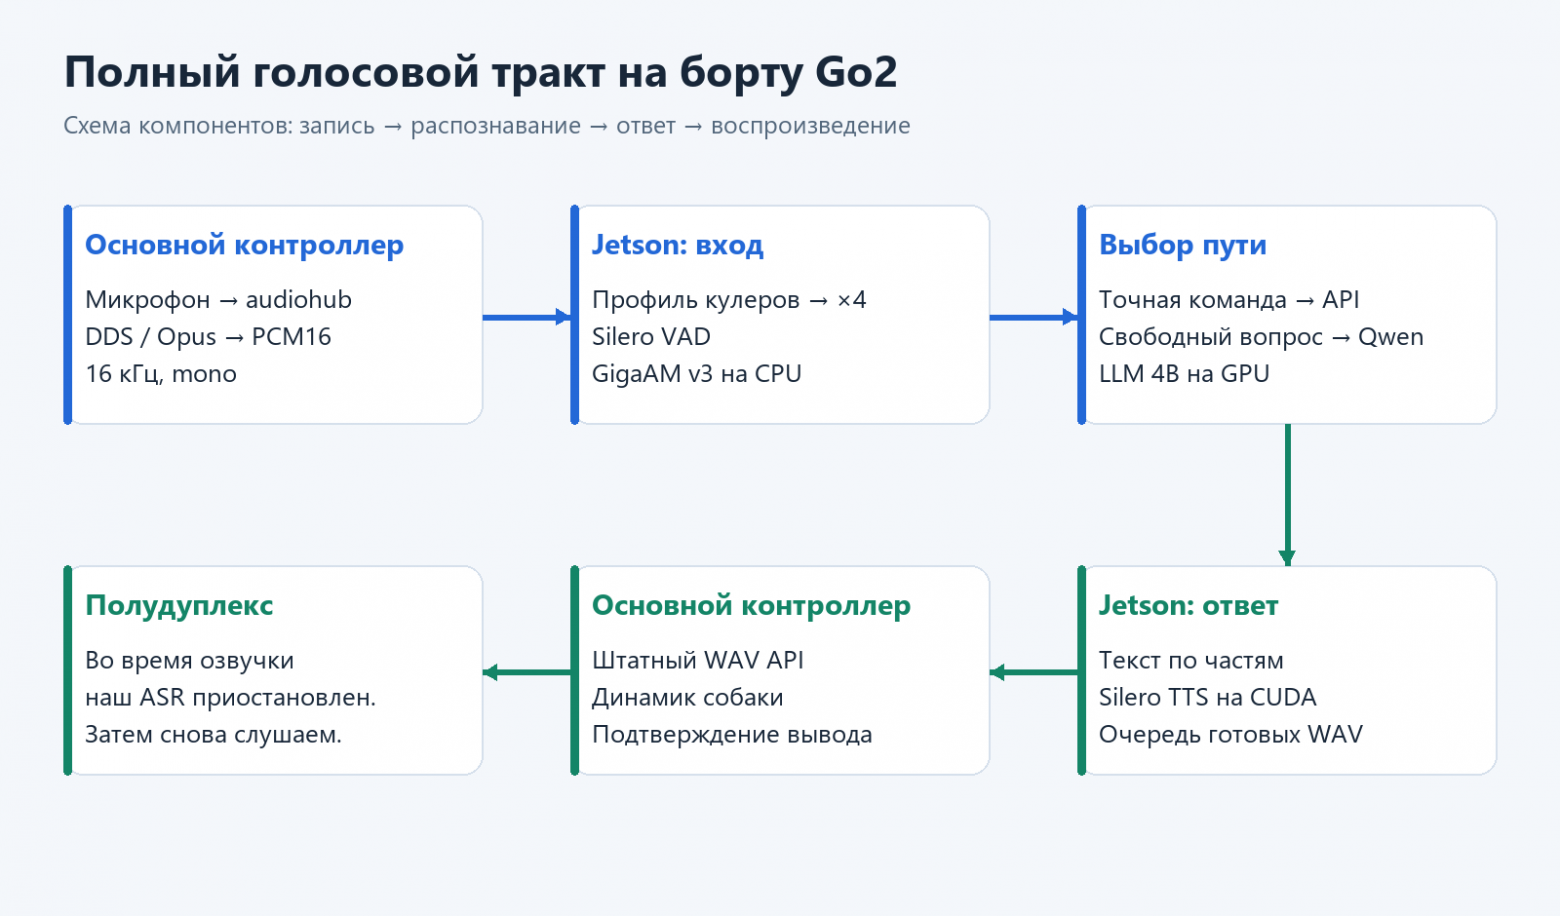
Короткая известная команда после распознавания идёт в диспетчер, минуя генерацию LLM. Свободный вопрос отправляется Qwen. Для времени и некоторых сведений о состоянии есть локальные обработчики: языковая модель не должна угадывать показания часов.
На входе быстро обнаружилась акустическая особенность задачи. Микрофон слышит речь с расстояния в несколько метров, а вентиляторы находятся на самом роботе. Увеличение входного усиления делает громче и голос, и этот фон.
Сначала чистый звук, потом правильные слова
Первые сравнения проводили на синтетических голосах, смешанных с реальным шумом кулеров. Это было удобно для перебора вариантов, но такой результат нельзя переносить на живого человека. Отдельно записали речь владельца с трёх метров и шум без речи.
В течение работы меняли и аппаратный тракт. Усиление микрофона подняли до 35/35, то есть +23 дБ. Сначала оставались включёнными аппаратный AGC и программный AGC Speex. В финальном выбранном варианте аппаратный AGC выключен, дополнительного Speex AGC нет, а после очистки используется фиксированное усиление ×4. На исходной контрольной записи клиппинга не было.
Сравнивали Speex, DTLN [6], RNNoise 0.2, собственный профиль кулеров, разный порядок фильтров и усиление до и после обработки. У RNNoise отдельно сверили нашу обёртку с официальной C-демонстрацией. Для его файлового теста звук повышали с 16 до 48 кГц и возвращали обратно; это не запись с нового микрофона и не восстановление потерянной полосы частот.
У нас уже был сильный профиль кулеров: strength=2.3, floor=-28 dB. На одном из прежних шумовых контрольных отрезков измеренное подавление достигало примерно 25,7 дБ. На слух [7] результат нравился. Но вместе с шумом сильная обработка могла съесть тихие согласные, и распознаватель от этого не обязательно выигрывал.
Ещё одно отличие обнаружилось между красивым офлайн-превью и живым потоком. В исходной сильной версии сглаживание использовало будущие кадры. Её скорость обработки файла ничего не говорит о задержке причинного фильтра, которому будущий звук ещё не поступил.
Для рабочего тракта выбрали мягкий причинный вариант: strength=1.1, нижний предел маски −14 дБ. Он использует текущий и предыдущий пакеты. При частоте 16 кГц пакет содержит 320 отсчётов, окно — 640, добавленная буферизация — 20 мс.
Вычисление маски в нашем фильтре, без оконного преобразования и сглаживания вокруг него:
floor = 10 ** (floor_db / 20)
mask = np.clip(
    1 - strength * noise_power / (smoothed_power + 1e-18),
    floor,
    1,
)
noise_power — профиль мощности, полученный из участка без речи. Предел −14 дБ здесь относится к минимальному коэффициенту спектральной маски. Это не обещание снизить общий уровень любого шума ровно на 14 дБ.
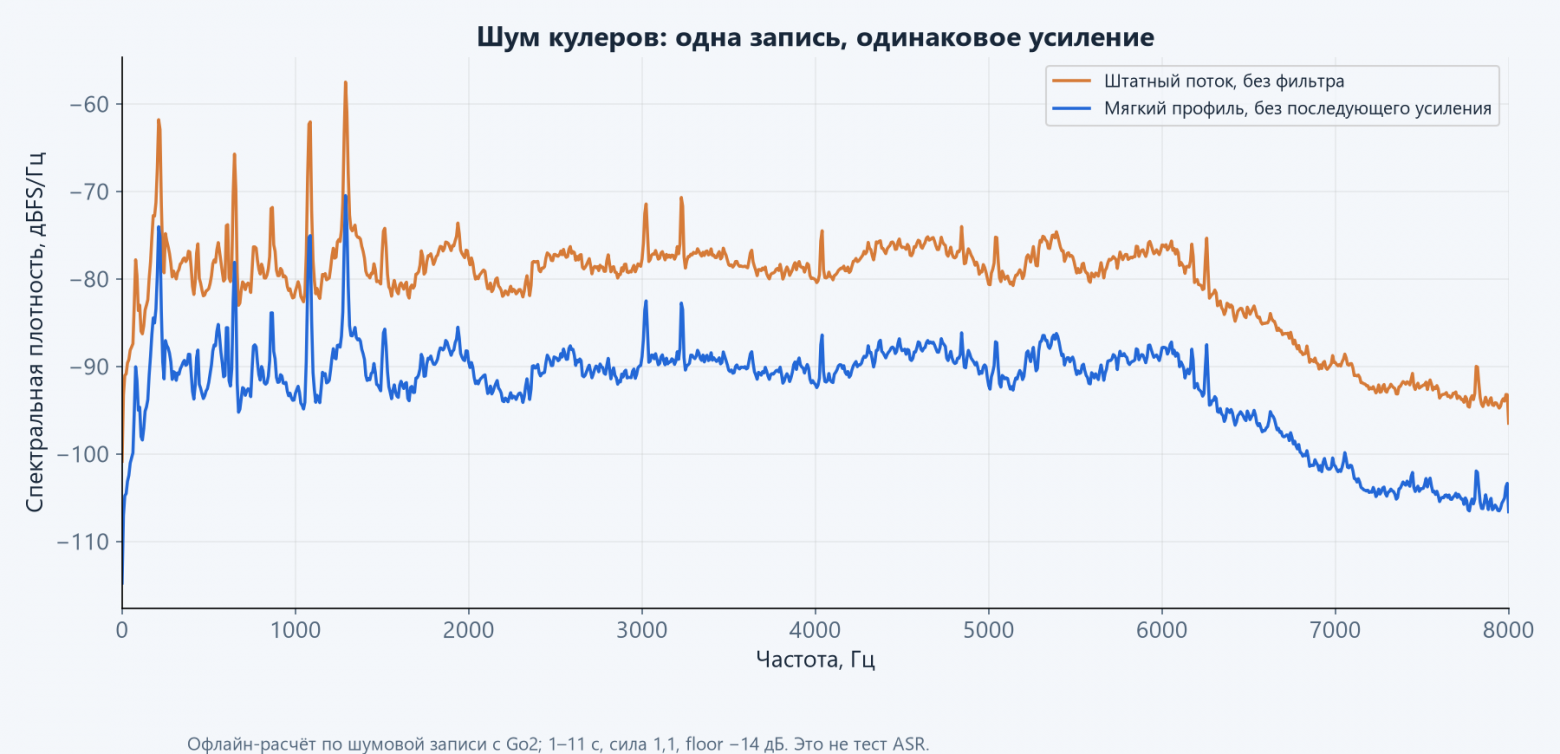
Расчёт по сохранённой записи шума с робота и выбранному профилю. Для сравнения действие последующего усиления ×4 исключено. График показывает изменение шума, а не точность распознавания речи.
Распознаватель оказался важнее сильного фильтра
На одной 90-секундной записи было шесть обращений: вопросы о траве и небе, устройстве велосипеда, арифметике, имени котёнка и завтраке. Для первичного сравнения использовали одинаковые отрезки, затем прогнали исходный поток целиком через настоящий обработчик речи.
Тексты эталонов не передавались распознавателям как grammar, hotwords или список возможных ответов. При оценке дословности игнорировали регистр, пунктуацию и различие «ё/е».
В таблице — файловые прогоны на ПК с одинаковым усилением ×4 после обработки. Показано число дословно распознанных фраз из шести:
|
Входной вариант |
T-one |
Whisper small |
GigaAM v2 |
GigaAM v3 |
|---|---|---|---|---|
|
Без шумоподавления |
0 |
1 |
5 |
6 |
|
Мягкий причинный профиль |
0 |
0 |
4 |
6 |
|
Сильный причинный профиль |
0 |
— |
3 |
5 |
|
DTLN |
0 |
— |
2 |
3 |
|
RNNoise |
0 |
— |
0 |
0 |
Знак «—» означает отсутствие соответствующей комбинации в этой выдержке. Таблица относится к нашим моделям, настройкам и шести фразам; это не рейтинг распознавателей на русском языке вообще.
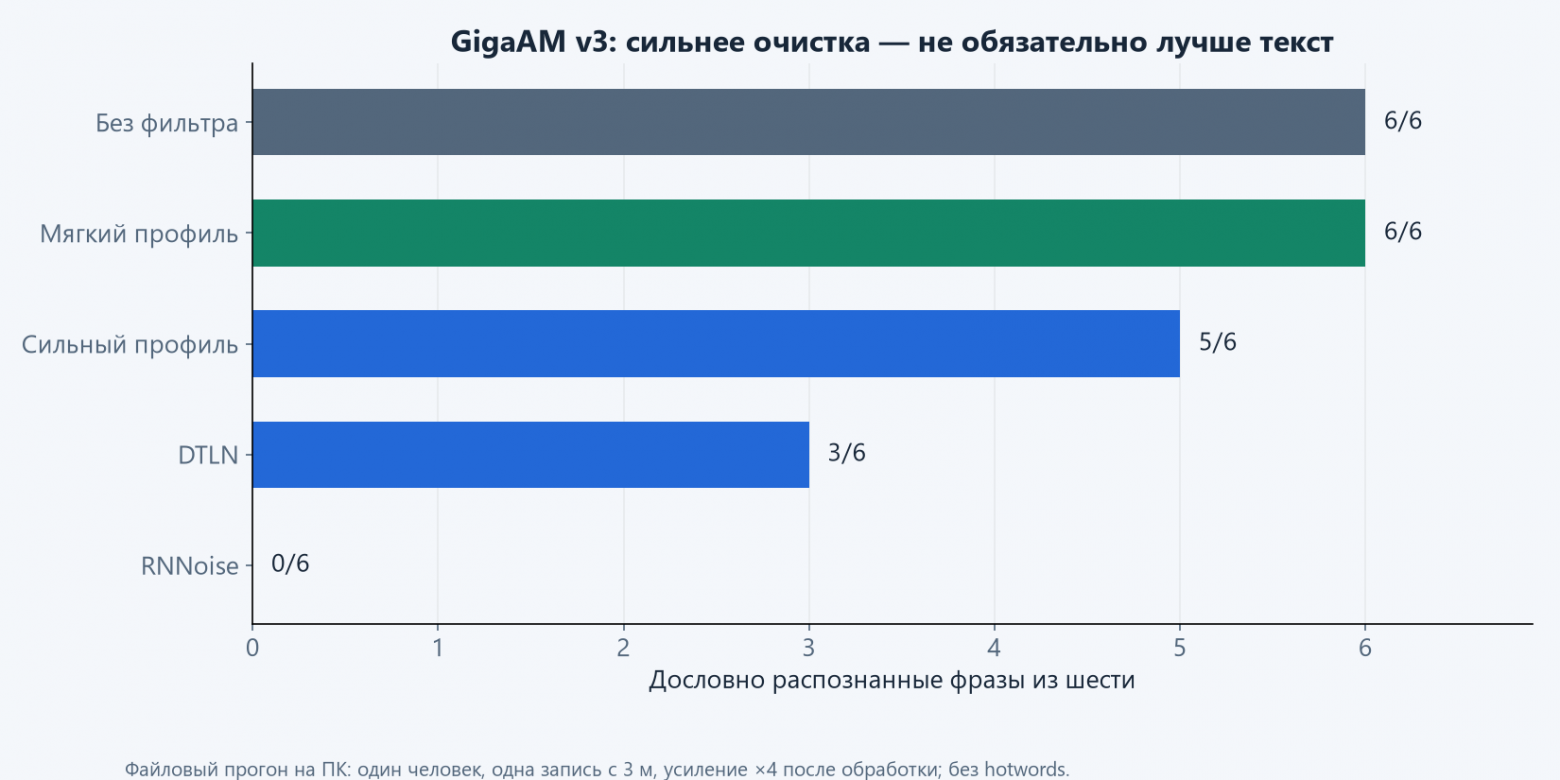
Существенная деталь: GigaAM v3 получил 6/6 и на исходном звуке. Поэтому утверждать, что все шесть фраз мы распознали именно благодаря шумоподавлению, было бы неверно. В этом наборе замена ASR дала больший эффект, чем усиление очистки. Мягкий профиль позволил уменьшить фон и сохранить тот же результат на проверенной записи.
На Jetson развернули GigaAM v3 [8] RNNT в ONNX-варианте через sherpa-onnx. Квантованный encoder — int8, decoder и joiner — отдельные ONNX-файлы. Распознавание работает на CPU в два потока; GPU остаётся для Qwen и синтеза.
recognizer = sherpa_onnx.OfflineRecognizer.from_transducer(
    encoder=str(root / "encoder.int8.onnx"),
    decoder=str(root / "decoder.onnx"),
    joiner=str(root / "joiner.onnx"),
    tokens=str(root / "tokens.txt"),
    model_type="nemo_transducer",
    num_threads=2,
    sample_rate=16000,
    provider="cpu",
)
Здесь OfflineRecognizer означает обработку уже выделенного речевого отрезка. Весь голосовой сервис при этом непрерывно получает звук и сам выделяет обращения.
На Jetson финальная обработка шести фраз занимала примерно 0,46–0,64 секунды на фразу. Модель загружалась один раз; время её загрузки не включено. Qwen и Silero находились в памяти, но одновременная генерация озвучки в этом замере не шла.
Тихое обращение можно потерять до ASR
Одной замены модели было недостаточно. Прежняя сегментация могла склеить соседние фразы или отрезать тихое начало обращения. Если имени уже нет в выделенном звуке, дальнейший распознаватель его не восстановит.
Добавили Silero VAD [9] с сохранением акустического состояния между завершёнными обращениями. Порог — 0,4, минимальная длительность речи — 0,1 с, ожидание тишины для завершения — 0,45 с. К найденному началу возвращаем 0,7 с уже полученного звука, к концу — 0,2 с из уже накопленного буфера.
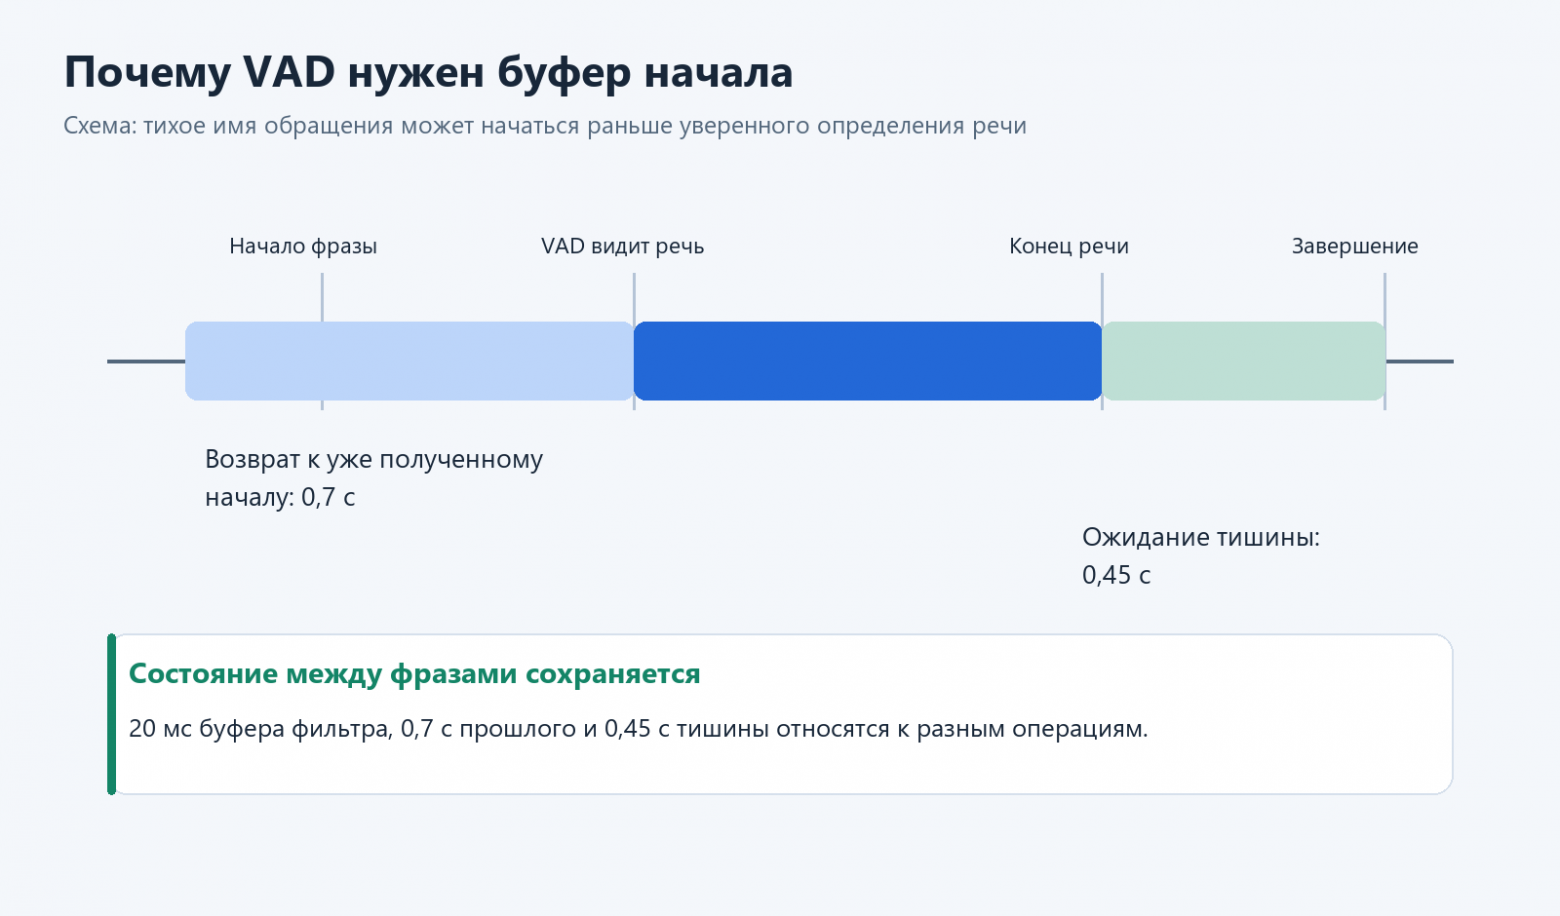
Схема границ, не осциллограмма записи. Возврат к уже полученному началу не равен ожиданию будущих 0,7 с.
При настройке встретили неприятную подробность: попытка задать бесконечный max_speech_duration не отключила ограничение так, как мы ожидали. В используемой реализации произведение длительности на частоту переводится в int32; переполнение приводило к выбору более строгого порога 0,90. Использовали фактический диапазон счётчика вместо Infinity.
После этих изменений полный 90-секундный WAV прошёл через реальный listen_speech на ПК и Jetson: получили ровно шесть правильных обращений, без ручной нарезки и ложных заданий команд. Это проверка сохранённой записи. Новая речь другого человека и другого помещения остаётся отдельным испытанием; позднее в живом разговоре встречалась ошибка [10] «трава/дрова».
GPU занят, ответ всё равно медленный
В исходном варианте Qwen работала с --no-kv-offload: часть attention и KV-кэш оставались на CPU самой Jetson. На основной RK3588S эту часть вычислений не переносили. Последующая оптимизация меняла распределение работы между CPU и GPU внутри Jetson. На накопленной истории измеряли примерно 3,37–3,78 токена в секунду. Для чтения текста это терпимо; для собеседника каждая пауза заметна.
В установленной сборке llama.cpp b6000, commit 4762ad7, Flash Attention была выключена при компиляции. Одним флагом запуска включить отсутствующую реализацию не получилось бы. Собрали отдельную CUDA-библиотеку из той же версии исходников, пересобрав диспетчер и attention-модули. Остальные объекты и параметры компиляции сохранили.
Сначала перенесли attention на GPU и стали проверять форматы KV-кэша. Квантование весов Q4_K_M при этом не менялось: точность весов и точность кэша — две разные настройки.
На коротком запросе вариант с FP16-кэшем выглядел быстрым. На длинном контексте качество разваливалось. Q8-кэш прошёл арифметику, некоторые факты из начала контекста и нативные функции; на длинных запросах получили около 7,5–8,7 токена в секунду. Затем расширили проверку — и обнаружили, что этой приёмки было недостаточно.
При близком к заполненному окне модель могла подражать [11] бессмысленным прежним репликам вместо ответа на вопрос. Запуск с CUDA_LAUNCH_BLOCKING=1 заметно улучшал ответы. Для отдельной сборки добавили синхронизацию до и после вычисления графа backend:
CUDA_CHECK(cudaDeviceSynchronize());
evaluate_and_capture_cuda_graph(
    cuda_ctx, cgraph, graph_evaluated_or_captured,
    use_cuda_graph, cuda_graph_update_required);
CUDA_CHECK(cudaDeviceSynchronize());
Это локальная правка нашей версии CUDA-backend. Она улучшила наблюдаемое поведение [12], но сама по себе не доказывает, где именно была ошибка и что все вычисления теперь эквивалентны CPU. В рабочем варианте осталась эта отдельная сборка, KV-кэш f16, Flash Attention включена, CUDA Graphs выключены. CUDA_LAUNCH_BLOCKING постоянно не включали.
В одном позднем образце получили 9,53 токена в секунду. До двадцати не дошли. Сравнивать этот единичный замер с чужим результатом на другом JetPack, CUDA, режиме мощности и GGUF без оговорки об условиях было бы бессмысленно.
Проверять нужно и текст ответа
Чтобы не списывать любую странную фразу на GPU, сделали парное сравнение с CPU на внешнем Windows-ПК. Здесь CPU reference — отдельный диагностический запуск вне собаки, а не RK3588S и не CPU Jetson; в автономном разговоре этот ПК не участвует. Одни веса, одинаковые исходные контексты, схемы функций и параметры сэмплирования: seed 42, temperature 0,5, top-p 0,8, top-k 20. Это сравнение качества, а не производительности двух устройств.
По минимальным смысловым критериям CPU прошёл 6 из 8 заданий, GPU — 5 из 8. Оба варианта ошиблись в объяснении обычного самоката и выдумали одинаковое время вместо вызова функции часов. Факты из начала контекста и две изолированные тестовые базы с разными ценами прошли с обеих сторон.
Один разный sampled-ответ не доказывает дефект CUDA, а общую ошибку двух вариантов нельзя объявить исключительно проблемой GPU. Даже наша автоматическая проверка однажды оказалась слишком доброй: искала в ответе про траву слово «хлорофилл», хотя окружающее объяснение содержало ошибки.
Дополнительный источник странного стиля нашёлся в памяти. Суммаризация старого разговора превратила поэтические ответы ассистента в контекст о предпочтениях человека. Темы дождя и тишины стали возвращаться в новых ответах. На том же GPU без старой истории поэзия исчезала, хотя физические ошибки модели полностью не исчезли.
Позже разделили полный архив и рабочую сессию, убрали свободную LLM-суммаризацию из этого пути и стали сохранять происхождение сведений. Ответ ассистента не должен незаметно становиться фактом о посетителе. Для выставочного сценария это ещё и вопрос границ разговора: следующему человеку не нужен весь диалог предыдущего.
Начинать говорить, пока модель ещё пишет
После ускорения вычислений оставалась организация вывода. Если ждать весь ответ, затем синтезировать весь WAV и только потом воспроизводить, первое слово запаздывает даже у достаточно быстрой модели.
Поток текста разбираем на смысловые части. Как только готова первая часть, отправляем её в локальный Silero TTS [13]. Silero проверяли и на CPU Jetson, но для живого тракта выбрали CUDA на этой же плате; cuDNN в выбранном пути выключен. После синтеза результат копируется в память CPU Jetson, преобразуется в нужную частоту и PCM/WAV и передаётся основному контроллеру. Пока основной контроллер воспроизводит один WAV, Jetson готовит следующий.
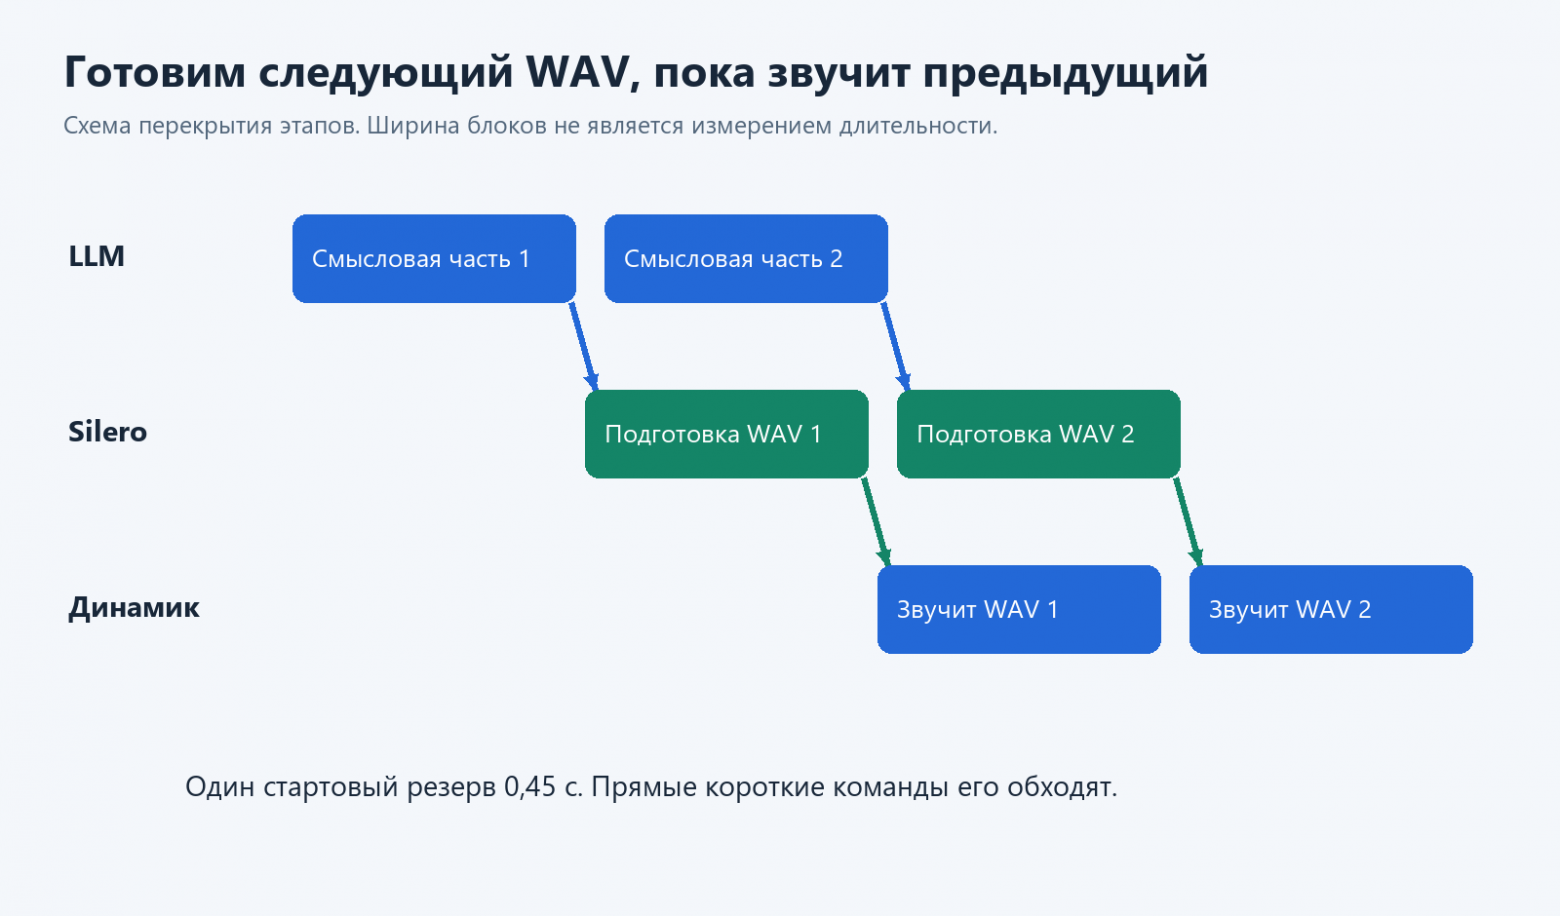
Схема перекрытия этапов. Длина прямоугольников не изображает измеренное время конкретных предложений.
В нашем коде отдельный worker берёт текст из очереди, синтезирует WAV и кладёт готовый результат в очередь воспроизведения. Плеер не обязан ждать окончания всей генерации. Перед первой частью добавлен однократный резерв 0,45 с, чтобы успело накопиться продолжение; для прямых коротких команд этот резерв не используется.
Не стоит путать его с паузой 0,45 с в VAD: один буфер помогает озвучке, другая пауза определяет конец человеческой фразы. Они находятся на разных концах тракта.
В контрольном прогоне ожидание следующего готового аудиофрагмента составило 0,000 с по журналу очереди. Это означает, что плеер не ждал worker; акустическую бесшовность стыков такое число не измеряет.
Вывод через наш DDS/Opus-путь первоначально хрипел. Перешли на штатное воспроизведение WAV, чистоту которого проверили прослушиванием. Качество самого TTS и качество передачи его результата в динамик — две отдельные задачи.
Отдельно пришлось обработать латиницу. В используемом пакете Silero путь SSML обращался к ext_alph.keys(), когда ext_alph был None. Простая замена на пустой словарь убирала исключение, но могла молча терять иностранные слова. Добавили подготовку русского произношения латинских слов, сокращений и чисел. Исходный текст в диалоге сохраняется; это не отдельный английский голос.
От какой точки считать 2,5 секунды
Для замера разговорной части вводили текст напрямую, запускали реальную Qwen и слушали штатный динамик. Такой тест исключает микрофон, VAD и ASR, зато позволяет увидеть изменения последующих этапов.
|
Контрольный прогон |
Время от текста до начала звука |
|---|---|
|
Ранняя версия тракта |
8,408 с |
|
Промежуточная ускоренная версия с коротким ответом |
2,341 с |
|
Поздняя версия с синхронизацией CUDA и обычной длиной |
2,505 с |
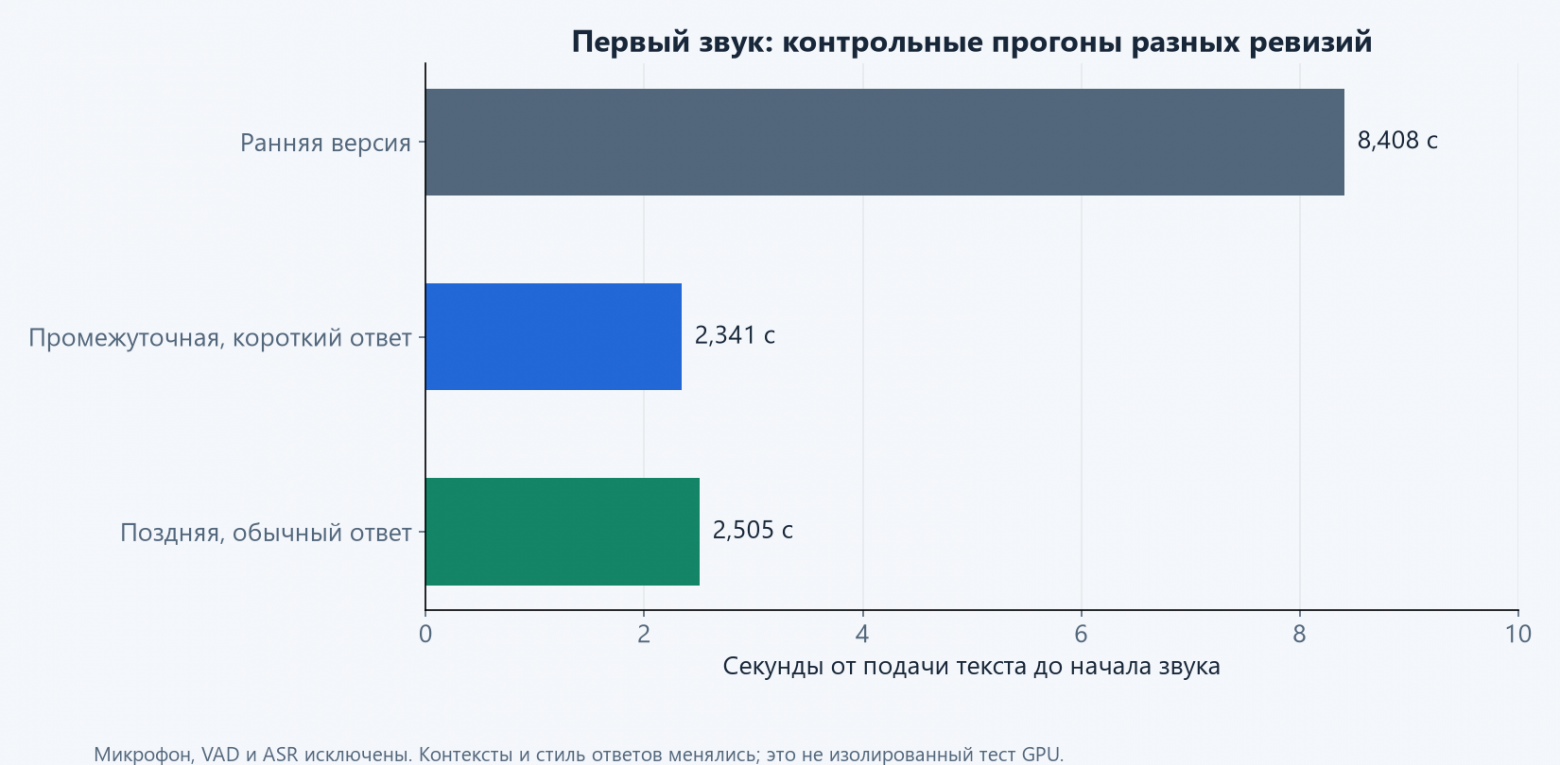
Это замеры разных ревизий разговорного тракта с изменениями контекста и длины ответа. Они показывают наблюдаемый результат работы системы, а не чистое ускорение одного CUDA-ядра.
В позднем прогоне первый текст модели появился через 0,422 с, звук — через 2,505 с. Генерация всего ответа закончилась через 13,801 с, а полное воспроизведение и возврат к слушанию — через 30,775 с. Именно поэтому «быстро начал отвечать» и «быстро закончил ответ» тоже разные показатели.
Общая задержка от голоса человека включает ещё выделение конца речи и финальный ASR. Складывать лучшие числа из разных испытаний и выдавать сумму за измеренный end-to-end результат мы не стали.
Длину ответа вынесли в характер агента: коротко, обычно или подробно. Сначала делали ответы по 10–20 слов для детей, затем добавили обычный режим с ориентиром на 2–4 понятных предложения. Это мягкая инструкция модели, а не обрезание генерации счётчиком. Сокращение реплики уменьшает общее время разговора, но не заменяет оптимизацию вычислений.
Во время собственной озвучки наш ASR приостановлен. После неё открывается разговорное окно. Это полудуплексный режим; полноценное одновременное слушание и перебивание здесь пока не реализованы.
Что осталось на борту
Рабочая цепочка состоит из штатного микрофонного потока, мягкого профиля кулеров, фиксированного усиления ×4, Silero VAD, GigaAM v3 на CPU, локальной Qwen 4B и Silero TTS с выводом через штатный WAV API. Приложение на телефоне и внешний компьютер для обработки обычного разговора не нужны.
Панель настройки отделена от этого тракта. Она передаёт выбранные имя, голос, характер и знания; последний полученный профиль сохраняется на роботе. Снимок настроек фиксируется на всю реплику, чтобы смена агента посреди ответа не смешала голос одного профиля с памятью другого.
На контрольной записи с трёх метров получили шесть правильных обращений через полный обработчик. В разговорной части добились начала звука примерно через 2,5 с от текстового ввода в позднем образце. Ошибки распознавания в новой речи и фактические ошибки Qwen этим не отменяются; итоговая конфигурация также ещё не прошла полный цикл выключения и включения робота.
Практический результат — разговорный тракт, который можно измерять и менять по частям. Если собака не ответила, теперь можно выяснить, потерялось ли начало фразы, ошибся ли ASR, задержалась ли модель или звук застрял в очереди. До установки LLM казалось, что основная работа будет в выборе весов. В итоге пришлось заниматься всем путём от микрофона до динамика.
← Часть 1. Unitree Go2: получаем root, исправляем Wi-Fi и добавляем русские голосовые команды [1]
Автор: Tigramaan
Источник [14]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38052
URLs in this post:
[1] первой части: https://habr.com/ru/articles/1103278/
[2] память: http://www.braintools.ru/article/4140
[3] описанием RK3588S у производителя модулей Boardcon: https://www.boardcon.com/CM3588S_SOM/
[4] характеристиками Orin Nano у NVIDIA: https://developer.nvidia.com/blog/solving-entry-level-edge-ai-challenges-with-nvidia-jetson-orin-nano
[5] Qwen3-4B-Instruct-2507: https://huggingface.co/Qwen/Qwen3-4B-Instruct-2507
[6] DTLN: https://github.com/breizhn/DTLN
[7] слух: http://www.braintools.ru/article/6251
[8] GigaAM v3: https://github.com/salute-developers/GigaAM
[9] Silero VAD: https://github.com/snakers4/silero-vad
[10] ошибка: http://www.braintools.ru/article/4192
[11] подражать: http://www.braintools.ru/article/5584
[12] поведение: http://www.braintools.ru/article/9372
[13] Silero TTS: https://github.com/snakers4/silero-models
[14] Источник: https://habr.com/ru/articles/1103288/?utm_campaign=1103288&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.