Большинство ИИ-агентов внутри одинаковые. Тогда в чём разница?
Представьте: на столе техническое задание и три предложения подрядчиков. Цены — за разные периоды, часть условий вынесена в приложения, у одного предложения не хватает обязательной работы. Нужно всё прочитать, сопоставить, пересчитать на одинаковых условиях и подготовить записку с источниками.
Можно попросить ИИ объяснить, как это сделать. а можно дать ему документы и инструменты и поручить саму работу: пусть читает, сверяет, считает и возвращает результат. Во втором случае модель уже управляет выполнением задачи. Это и есть агент.
Под капотом знакомый цикл: модель выбирает инструмент и параметры вызова, обычный код исполняет инструмент, результат возвращается модели. И так по кругу. Этот принцип — рассуждать, действовать, смотреть на результат — лежит в основе ReAct.
Упрощённый цикл умещается в десять строк:
    messages = [user_message(task)]

    while budget_available():
        response = LLM(messages, tools)
        messages.append(response)uv
        if not response.tool_calls:
            break
        outputs = tool_executor.apply(response.tool_calls)
        messages.extend(outputs)
Почему же вокруг этих десяти строк столько разных продуктов?
Двигатель и четыре колеса есть и у грузовика, и у легковушки, но взаимозаменяемыми они от этого не становятся. С агентами та же история: всё интересное начинается с вопросов, которые в псевдокод не попали.
-
Можно ли вообще выполнять предложенную команду?
-
Что делать, если инструмент вернул гигабайт текста?
-
Как продолжить работу, когда контекстное окно закончилось?
-
Достаточно ли фразы модели «готово», чтобы закрыть задачу?
Всё это собирается в обвязку (harness) — среду исполнения агента: цикл, инструменты, память [1], проверки, лимиты и историю действий. Здесь и находится большая часть инженерной работы.
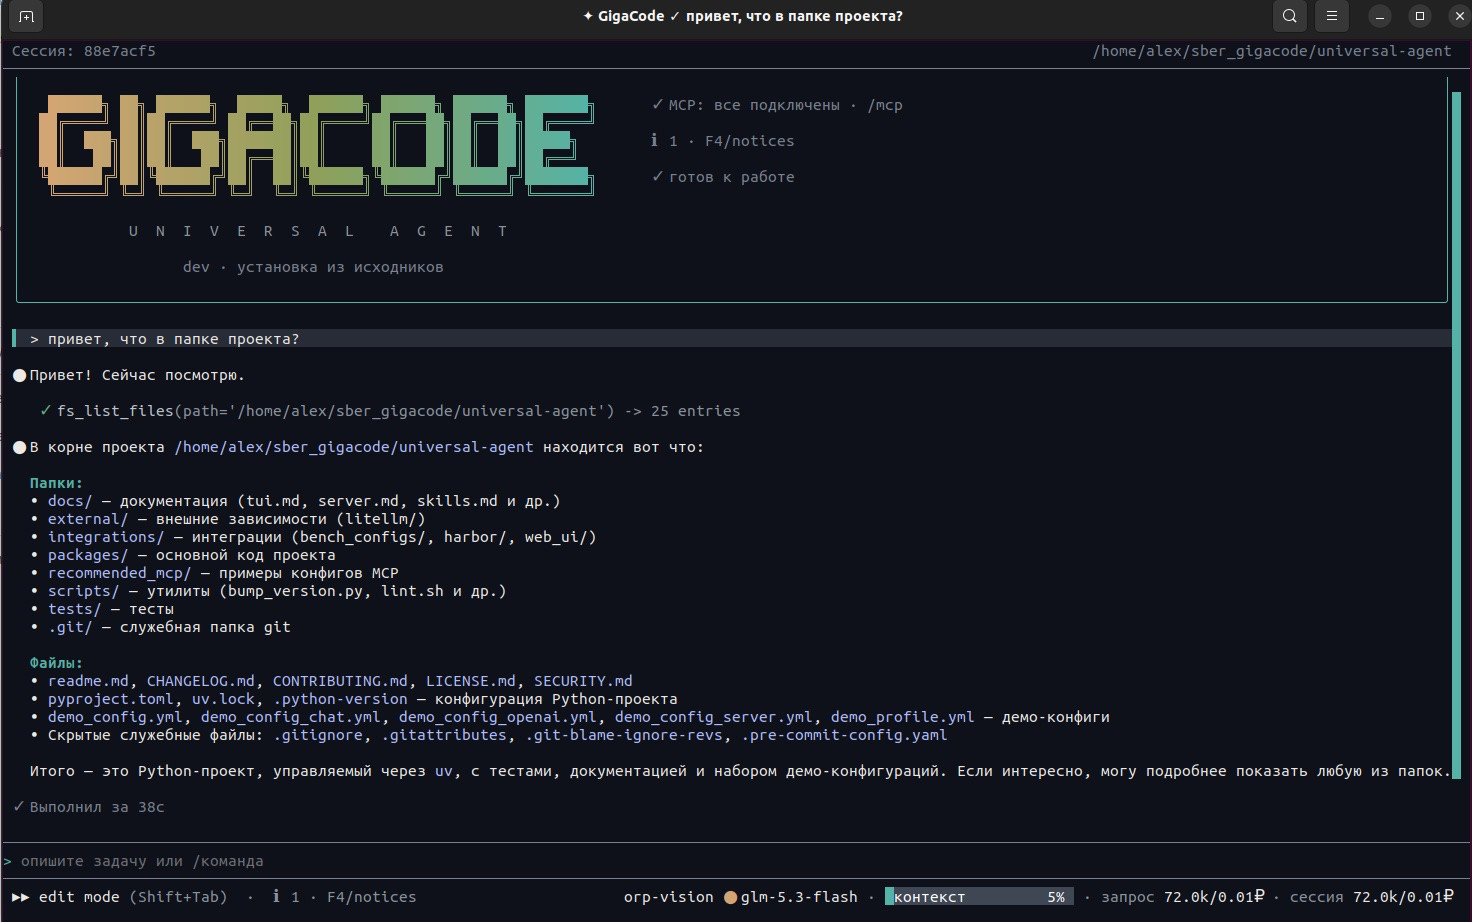
Мы в GigaCode R&D разрабатываем модели для агентных задач. Нам нужен был исполнитель, с которым можно экспериментировать, получать данные для обучения [2] и решать прикладные задачи. Так появился GigaCode Universal Agent [3] — открытый проект на Python с подключением моделей через chat/completions API.
Расскажем, что стоит вокруг агентного цикла и как одно ядро используется для работы с документами, кодом и внешними системами.
Кто прокладывает маршрут?
Есть два основных подхода к автоматизации с LLM.
Первый — заранее описать процесс: прочитай документ, извлеки поля, опроси систему, оформи вывод. Появляются развилки и повторы — получается граф. Пока маршрут известен, это удобно: каждый шаг на своём месте.
Но сравнение подрядчиков быстро выходит за рамки приказа «извлеки три цены». В одном предложении сопровождение включено, в другом оплачивается отдельно, в третьем о нём вообще ничего не сказано. Для каждого случая нужны свои уточнения и расчёты. Чем больше таких сценариев, тем дороже поддерживать отдельный маршрут для каждого.
Второй подход — дать модели выбирать шаги по ситуации. Прочитала предложение, заметила ссылку на приложение, открыла его, нашла недостающие условия, вернулась к сравнению. Среда исполнения предоставляет инструменты и контролирует работу.
Мы создаём агент вокруг второго подхода. Новый сценарий часто подключается инструкцией и инструментами без изменения ядра. А там, где последовательность обязательна, её по-прежнему можно закрепить во внешнем вызывающем агента коде.
Задача, навык и инструменты
Вернёмся к подрядчикам. Пользователь ставит задачу:
В папке лежат техническое задание и три предложения подрядчиков. Сравни состав работ, стоимость и сроки. Подготовь таблицу и короткую записку: отличия, несоответствия требованиям и вопросы для уточнения. Для выводов укажи источники. Ничего подрядчикам не отправляй.
Чтобы агент мог её выполнить, нужны:
-
Задача — конкретная работа: какие документы взять и что получить на выходе.
-
Навык — переиспользуемый регламент. Примерно как инструкция для нового сотрудника:
1. Прочитай ТЗ и составь список критериев сравнения.
2. Изучи предложения и приложения к ним.
3. Приведи стоимость к одному периоду и сопоставимому составу работ.
4. Если условие отсутствует, отметь «не указано» и добавь вопрос.
5. Для фактов укажи источник, для расчётов — исходные данные.
6. Подготовь таблицу и записку. Отделяй факты от оценок.Регламент хранится отдельно: пользователю не нужно каждый раз вставлять его в запрос, агент получает нужные инструкции при работе над задачей. В пакет навыка можно положить и шаблон отчёта, и справочные материалы, и скрипт для расчётов.
-
Инструменты — доступ к данным и действиям: прочитать документ, выполнить расчёт, сохранить файл. Внешние системы можно подключать через MCP (Model Context Protocol). За общим интерфейсом могут находиться корпоративное хранилище, браузер, или база данных. MCP позволяет узнать, какие инструменты доступны, и вызвать их.
В результате правила работы живут в навыке, доступ к системам — в инструментах, а ядро исполняет задачу. Чтобы подключить ещё один сценарий, не приходится переписывать агентный цикл.
Посмотрим, как это работает на нашем примере. Допустим, у первого подрядчика цена годовая, у второго — месячная, у третьего внедрение оплачивается отдельно. Сравнить три числа недостаточно. Агенту нужно проверить состав услуг, учесть разовые платежи и пересчитать стоимость на один период. Если расчёт сложный, то агент может написать и запустить небольшой Python-скрипт.
Часть итоговой таблицы — условной, для наглядности — будет выглядеть так:
|
Критерий |
Предложение А |
Предложение Б |
Предложение В |
|---|---|---|---|
|
Период указанной цены |
Год |
Месяц |
Год |
|
Внедрение |
Включено |
Не указано |
Отдельный платёж |
|
Что уточнить |
— |
Стоимость внедрения |
Состав работ по внедрению |
В записке приведены выводы, расчёты и ссылки на документы. Если данных не хватает, то появляется конкретный вопрос к подрядчику. «Не указано» не превращается само собой в «бесплатно».
Навык задаёт правила анализа, но не перечисляет все возможные расхождения. Какие документы перечитать и что пересчитать, агент решает по ходу работы. Человек получает материал для решения, а не три пересказанных предложения.
Двадцать минут — значит двадцать минут
В чате можно заметить, что агент ходит по кругу, и остановить его. У фоновой задачи такого наблюдателя нет. Поэтому единица исполнения у нас — Run, отдельный запуск. Для него фиксируем задачу, версию навыка, модель, инструменты, рабочую область и лимиты: время, токены, шаги, вызовы инструментов.
Если на сравнение документов выделили двадцать минут, то оно не должно незаметно превратиться в ночное исследование. Если выделенный на задачу лимит токенов закончился, то нужно завершить запуск, сохранить сделанное и сообщить причину остановки.
У каждого запуска остаётся трейс — история работы: обращения к модели, вызовы инструментов, полученные результаты. По ним можно понять, откуда взялся вывод и где агент свернул не туда. А зафиксированные настройки помогают разобраться, почему вчера задача решалась, а сегодня перестала: поменяли модель, инструкцию или источник данных?
Трейс полезен и разработчику, который ищет ошибку [4], и руководителю, которому нужно понять основание рекомендации. Только повторить историю вслепую нельзя: перечитать документ и повторно отправить письмо — разные действия.
Модель сказала «готово». Проверим
Агент сравнил цены подрядчиков и написал аккуратный отчёт. Но обязательную работу из ТЗ пропустил. Внешне всё закончено, по существу — нет. Поэтому в Universal Agent есть отдельный судья: модель со своей инструкцией, которая смотрит трейс и отчёт и сопоставляет результат с задачей. Не хватает проверки, потерялось требование, вывод не подкреплён источником? Агент получает замечания и продолжает работу, пока позволяет бюджет.
Где можно проверить результат программно, лучше так и сделать: файл создан, расчёт сходится, JSON соответствует схеме, тест проходит. Судья помогает с содержательной частью: действительно ли ответили на вопрос, всё ли учли, достаточно ли оснований для вывода. Судья тоже может ошибиться, но фраза исполнителя «я закончил» хотя бы перестаёт быть единственным критерием успеха.
Длинные задачи создают ещё одну проблему: история работы постепенно заполняет контекст модели. Здесь включается автопротоколирование: агент сохраняет компактное описание состояния — что выяснил, что сделал, что осталось — и продолжает с сокращённым контекстом. Это позволяет работать дольше одного окна. Детали при сжатии могут потеряться, поэтому вернуться к исходной задаче и проверить результат в конце особенно полезно.
Доступ на чтение — не доступ на отправку
В постановке было: «Ничего подрядчикам не отправляй». Такое ограничение стоит обеспечить и настройкой инструментов. Для сравнения документов достаточно читать исходники и сохранять отчёт; доступ к отправке писем здесь не нужен.
В Universal Agent есть проверки чтения и записи, модерация команд судьёй и режим с разделением среды: агент работает в одном контейнере, а команды над файлами задачи выполняются в другом.
У этих механизмов разные роли. Судья оценивает действие, изоляция ограничивает возможности исполняемого кода. Права доступа определяют, до каких данных и систем он вообще сможет добраться. Конкретный набор выбирают под задачу.
Одно ядро, разные способы запуска
Менеджер ставит задачу в веб-чате, разработчик вызывает агент из приложения, внешняя система присылает событие, и задача запускается в фоне. Внутри работают те же инструменты, навыки и проверки.
|
Способ |
Для чего подходит |
|---|---|
|
Веб-чат |
Поставить задачу и наблюдать за выполнением в браузере. |
|
TUI — интерфейс в терминале |
Работать интерактивно из командной строки. |
|
Python SDK |
Вызвать агент из своего приложения. |
|
CLI |
Запускать задачи из команд и скриптов. |
|
Сервер |
Принимать задачи от внешних систем. |
Например, вызов из Python выглядит так:
from gc_core.aio import AsyncAgent
from gc_core.config import load_config

config = load_config("~/.gc/config.yml")

async with await AsyncAgent.create(config) as agent:
    answer = await agent.run(
        "Сравни предложения подрядчиков с ТЗ в рабочей папке. "
        "Подготовь таблицу, выводы и вопросы для уточнения.",
        thread_id="t1",
    )
Модель, инструменты и рабочая среда здесь уже настроены, пользователю остаётся только поставить задачу.
Есть и интерфейсы /v1/chat/completions и /v1/responses: к агенту можно обращаться через привычный API языковых моделей. За запросом при этом скрывается целая работа — чтение документов, расчёты, создание файлов. Клиент отправил одно сообщение, агент выполнил десятки шагов и вернул результат.
Что получилось на практике?
Внутри Сбера агент используют и на компьютерах сотрудников, и для фоновой автоматизации. Разрабатываем Pull Request-агентов: задача, изолированная среда, изменения кода, PR на проверку. Анализируем данные, генерируем примеры выполнения задач для обучения моделей. Пробовали научный [5] поиск и кибербезопасность в отдельном периметре.
Для разработки есть готовые бенчмарки, поэтому здесь результат проще выразить числами. На модели Qwen3.6-35B-A3B мы сравнили Universal Agent с двумя открытыми агентами — OpenCode и Qwen Code — на общих наборах задач. Доля решённых:
|
Бенчмарк |
Universal Agent |
OpenCode |
Qwen Code |
|---|---|---|---|
|
SWE-bench Verified |
69,9% |
66,4% |
65,0% |
|
SWE-bench Multilingual |
62,4% |
63,8% |
61,7% |
|
SWE-bench Pro |
46,8% |
46,9% |
45,3% |
|
Terminal Bench 2.1 |
65,5% |
62,1% |
41,4% |
Везде одна и та же модель, меняется только среда исполнения. На Verified и Terminal Bench Universal Agent впереди, на Pro и Multilingual — вровень с конкурентами. На терминале отрыв заметный: до ближайшего соперника три с лишним пункта, а Qwen Code отстал почти на двадцать пять. Характер у агента упрямый: на самых трудных задачах он делает заметно больше шагов, чем соперники, — дольше всех не сдаётся. Иногда это спасает, иногда просто жжёт токены. Но главный вывод не в числах: та же модель в другой обвязке даёт другой результат, потому что среда исполнения имеет значение.
В кибербезопасности проверяли CyberGym lvl1 с DeepSeek-V4-Flash. Без предметного навыка — 70,6%, с навыком — 76,7%, прирост на 6,1 процентного пункта. Ядро осталось прежним, добавили только регламент работы.
В научном поиске использовали модель MiniMax M2.7 и science-mcp. По четырём метрикам — PaSa Recall/F1 и Sage EM/F1 — Universal Agent оказался впереди участников нашего сравнения; максимальный разрыв с Hermes составил около 1,5 раза. При этом абсолютные результаты пока скромные: искать научные источники всем агентам ещё есть куда учиться.
Эти эксперименты показывают, как одно ядро работает в разных областях. Для сравнения подрядчиков или другой бизнес-задачи качество придётся измерять на своих примерах: поймал ли пропуски, правильно ли посчитал, сколько времени сэкономил человеку?
Сколько стоит выполненная задача?
Цена одного вызова модели мало говорит об экономике агента. Дешёвая модель может сделать тридцать шагов и не справиться. Более дорогая — решить задачу за десять. А иногда сильная модель полчаса занимается тем, с чем справилась бы маленькая. Поэтому мы считаем стоимость успешной задачи: Стоимость успешной задачи = затраты на все запуски / число успешно решённых задач. Неудачные попытки остаются в числителе, ручная доработка — тоже: если после агента сотрудник заново сверяет все предложения и переписывает записку, то дешёвые токены мало помогают.
Собственные замеры это подтверждают. На SWE-bench Verified агент обходился примерно на треть дешевле Qwen Code и решал при этом больше. На Multilingual экономия выходила около четверти. Низкая цена за токен и дешёвая выполненная задача — разные вещи, и вторая здесь важнее.
Чтобы не выбирать одну модель на всю работу, мы добавили в наш агент автомаршрутизацию. На очередном шаге среда исполнения выбирает уровень — light, default или max. Простые операции стараемся отдавать быстрым моделям, сложное планирование и исправление трудных ошибок — более сильным. В наших экспериментах 50—60% запросов удавалось переносить на младшие модели, удерживая качество около уровня max. Экономия в отдельных конфигурациях — в разы. Направление ещё экспериментальное, но смысл практический: дорогая модель нужна не на каждом шаге.
Что остаётся человеку?
Начинали мы с данных для обучения агентных моделей. Для их получения понадобились инструменты, состояние, история действий, лимиты и проверка результата. Для прикладных задач понадобилось то же самое.
Из этого выросло общее ядро. Один сценарий работает с документами, другой — с репозиторием, третий — с научными источниками. Меняются навыки и инструменты, а среда исполнения остаётся. Человеку по-прежнему нужно определить, что считать хорошим результатом, дать доступ к нужным данным и описать правила работы. Если инструменты уже подключены, то новый сценарий часто можно собрать без программирования, аесли нет — потребуется интеграция.
В нашем примере всё начинается с папки документов и регламента сравнения. На выходе нужны таблица, расчёты и вопросы, которые иначе пришлось бы собирать вручную. Именно ради этого и существует вся обвязка вокруг десяти строк агентного цикла.
Вы можете взять наш проект как инструмент автоматизации и с его помощью закрыть сразу множество сценариев: автоматизировать свои бизнес-задачи в фоне, использовать для разработки, установить на компьютеры сотрудников, разместить в облаке веб-версию во внутренней сети. Если искать серебряную пулю в ИИ, то ReAct-агенты очень близки к этому. С их помощью можно сделать очень и очень многое.
Код проекта — в репозитории GigaCode Universal Agent [3].
Будем рады обратной связи и совместному развитию проекта!
Автор: MLNavigator
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38141
URLs in this post:
[1] память: http://www.braintools.ru/article/4140
[2] обучения: http://www.braintools.ru/article/5125
[3] GigaCode Universal Agent: https://gitverse.ru/gigacode-ai/universal-agent
[4] ошибку: http://www.braintools.ru/article/4192
[5] научный: http://www.braintools.ru/article/7634
[6] Источник: https://habr.com/ru/companies/sberbank/articles/1104670/?utm_campaign=1104670&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.