Ру-Жев 1.3: какие незнакомые названия категорий модель стала понимать, а какие нет
Я выложил версию 1.3 Ру-Жев. Это открытая модель типизированных решений для русскоязычного текста. Она работает на процессоре и ставится внутрь закрытого контура. В этом релизе я учил модель меньше зависеть от того, какими словами вызывающая сторона называет варианты ответа. Результат получился определённым. На незнакомых названиях, которые являются словами, обычными или заимствованными, новая версия точнее старой. На аббревиатурах и кодах выигрыша нет. Ниже я привожу обе части результата и то, как я их проверял.
Модель и код под лицензией MIT. Веса лежат на Hugging Face в репозитории besktech/ru-jev.
Что это за модель
Ру-Жев получает контекст и набор вариантов. На выходе она даёт вероятность каждого варианта и выбирает один. Текст модель не генерирует. Она поддерживает три формы решения: да или нет, выбор из набора, порядковую шкалу.
По устройству это поточечный кросс-энкодер. К этому же семейству относятся NLI-классификаторы без дообучения и переранжировщики. Каждая пара «контекст плюс вариант» оценивается отдельным проходом через энкодер mmBERT-base. Это 307 миллионов параметров, из них 110 миллионов вне матрицы эмбеддингов. Затем оценки нормируются softmax по вариантам, сверху стоит температурная калибровка.
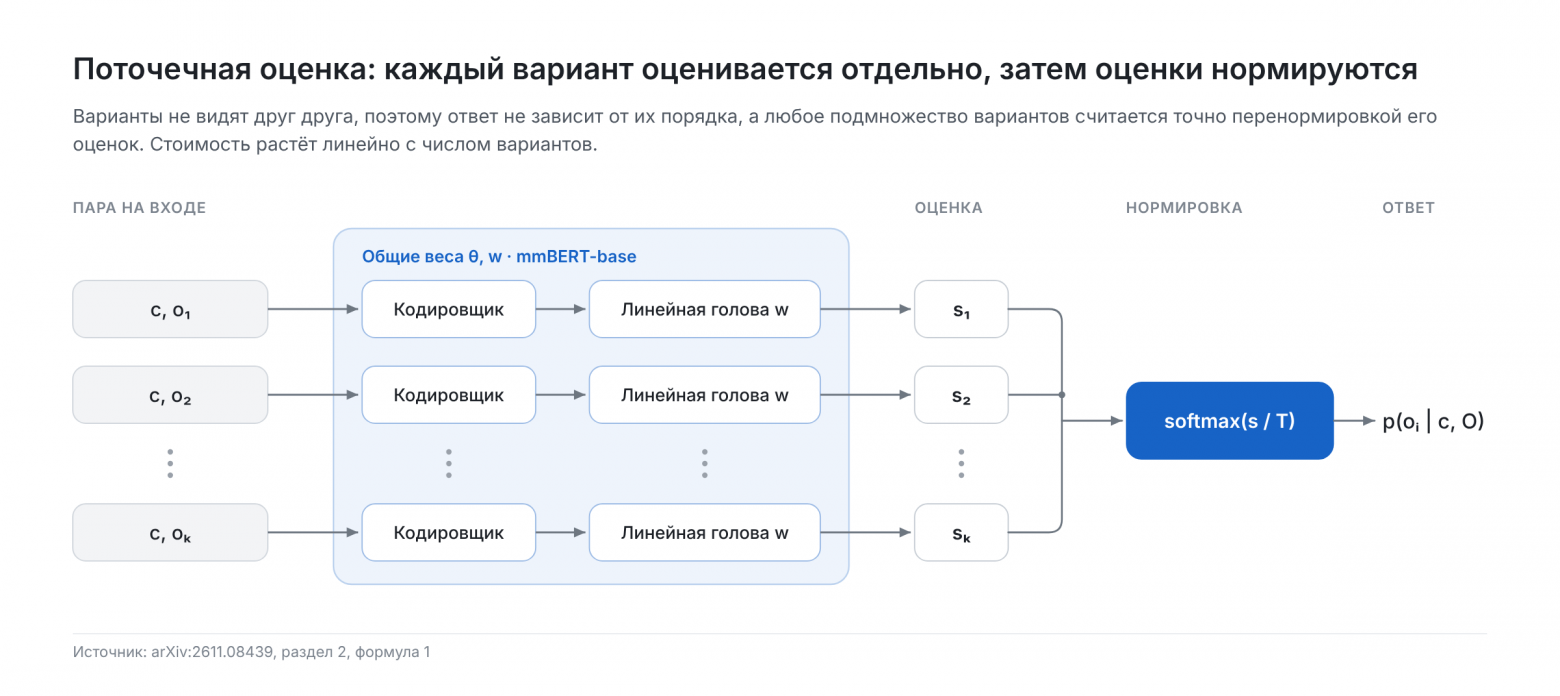
У такого устройства два следствия. Результат не зависит от порядка вариантов, потому что варианты друг друга не видят. Зато время решения растёт с числом вариантов, и с восемнадцатью вариантами модель медленнее, чем модели, читающие все варианты за один проход.
Название отсылает к Jev, коммерческой модели решений компании TypeSafe AI. Ру-Жев с TypeSafe не связан. Модель не обучалась на ответах Jev, и API Jev в этой работе не вызывался.
Зачем это закрытому контуру
Я много лет держу текстовые классификаторы в эксплуатации. В системе обработки обращений граждан, о которой я писал раньше, каждое предсказание проверял оператор. Основное время уходило на эту проверку, а не на работу модели. Следующий шаг в такой системе это порог уверенности. Выше порога модель отвечает сама, остальное уходит человеку. Порог работает, только если вероятность модели откалибрована.
На собственной отложенной валидации Ру-Жев 1.3 даёт такую картину.
|
Доля ответов |
Порог |
Точность на них |
Ошибок на 1000 |
|---|---|---|---|
|
50% |
0.85 |
0.967 |
33 |
|
70% |
0.69 |
0.921 |
79 |
|
90% |
0.54 |
0.859 |
141 |
|
100% |
0.23 |
0.823 |
177 |
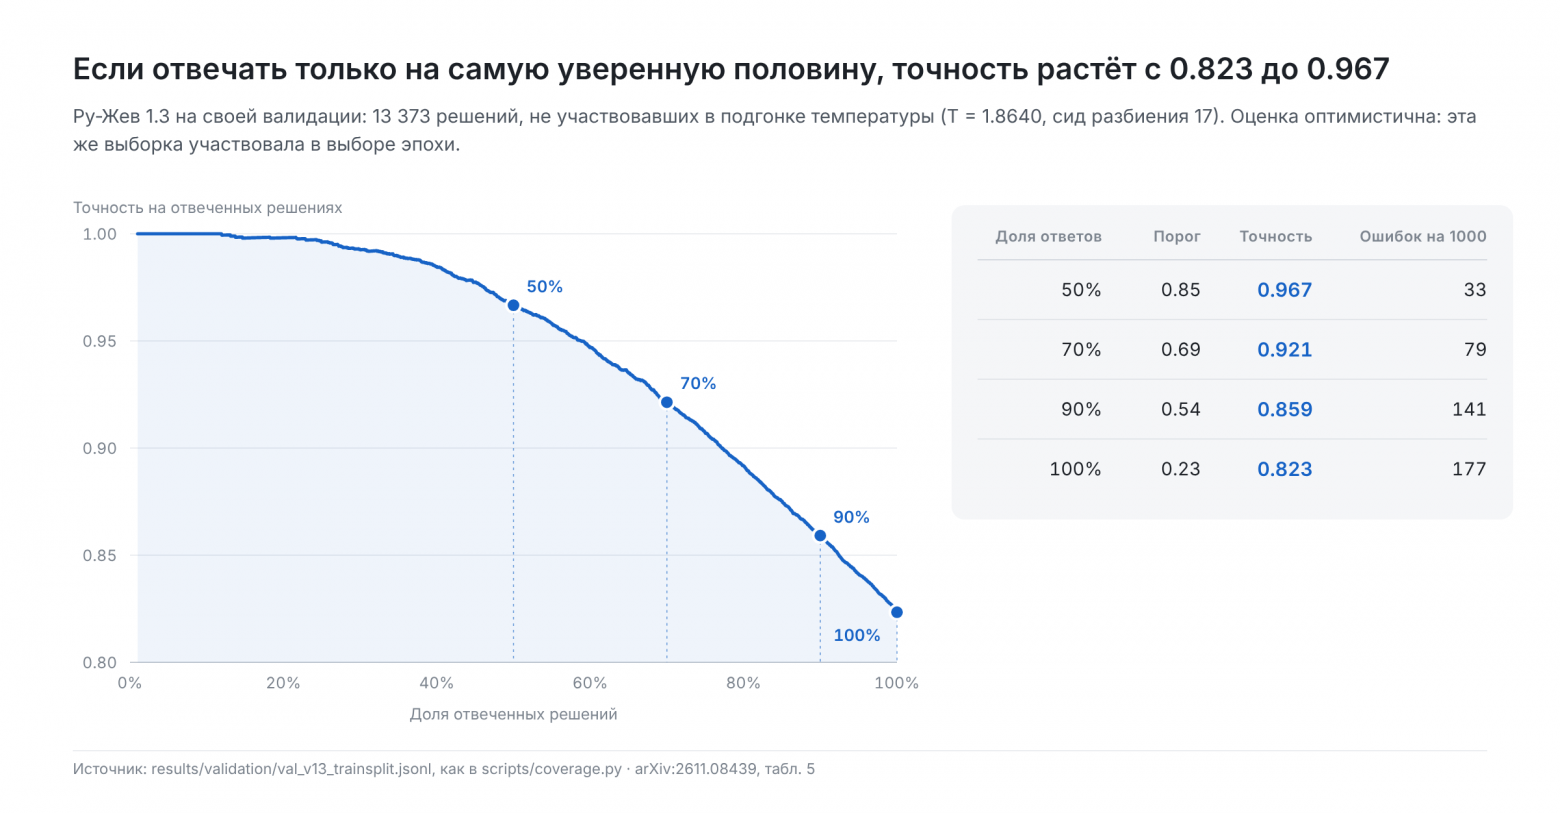
Это 13 373 решения, температура подобрана на другой половине валидации. Цифры оптимистичны, потому что та же валидация использовалась для выбора эпохи. Ниже показано, что на незнакомых метках и новых доменах выложенная температура не переносится. Поэтому на своих данных её нужно подобрать заново. Для этого достаточно нескольких сотен размеченных строк, скрипт fit_temperature.py лежит в репозитории.
Что изменилось в 1.3
Версия 1.1 видела каждый сценарий маршрутизации в двух формах, английским ключом и обычным русским словом. Версия 1.3 хранит для каждой метки несколько форм и на каждый обучающий пример берёт одну случайно. Формы взяты из сборщика данных без пересказа.
-
У интентов MASSIVE (60 меток): английский ключ, русская метка, ключ кириллицей по правилу транслитерации, усечённая форма этого ключа кириллицей.
-
У сценариев MASSIVE (18 меток): английский ключ, русское слово, русская фраза.
-
У токсичности: пять формулировок двух меток вместо одной.
-
У тональности отзывов пять формулировок набора меток, у оценки отзывов четыре, вместо одной.
Кроме аугментации версии различаются ещё тремя вещами. Между ними я исправил нарезку валидации, и часть задач получила другое разделение. Версия 1.1 обучалась три эпохи, версия 1.3 четыре, поэтому расписание шага обучения [1] у них разное. Была и промежуточная версия 1.2 с другими мелкими правками. Поэтому ниже я говорю о разнице между двумя обученными моделями. Аугментация согласуется с ней как причина, но строгой абляцией это не является.
Как я проверял
Все проверки формулировок идут на одних и тех же 1000 вопросах из исходного валидационного сплита сценариев MASSIVE. Ни одна версия на этих строках не училась, но обе использовали их при выборе эпохи и подборе температуры. У каждого вопроса один верный сценарий из восемнадцати. Меняется только то, как названы сценарии.
Каждый словарь я прогнал в двух постановках.
-
Пять вариантов в вопросе. Верная метка и четыре отвлекающие, одни и те же для всех словарей и моделей. Случайное угадывание 0.20.
-
Восемнадцать вариантов в вопросе, то есть все метки. Случайное угадывание 0.056.
Модель оценивает каждый вариант отдельно, поэтому пятивариантный ответ точно получается из восемнадцативариантного прогона перенормировкой нужных пяти оценок. Абсолютные точности и размеры эффекта между постановками я не сравниваю. Две постановки понадобились потому, что размер эффекта зависит от числа вариантов, и для разных словарей по-разному. Замер только в одной постановке вводил меня в заблуждение.
Словари получены тремя разными способами.
-
Основной стенд. Шесть словарей написаны в проекте при разработке модели, до этих замеров. Это английский ключ, русское слово, русская фраза, жаргон из англицизмов («вэзер», «смолток», «фуд-доставка», «логистика»), названия служб («метеослужба») и описания запроса. Словарь жаргона попал в репозиторий за шесть с половиной часов до правил транслита. Под правила его не подгоняли, но при их написании он уже существовал.
-
Словари по правилу. Коды вида
ALARM_SCNи трёхбуквенные аббревиатуры вида «БУД». Их сгенерировал по правилу ИИ-агент, который обучал модель. Прогнаны только в пятивариантной постановке. -
Независимый словарь. Служебный сленг («синоптик», «побудка») и непрозрачные коды («ПГД», «БДК»). Его написала отдельная сессия ИИ-ассистента, которая модель не обучала и оценок по этим словарям не видела. Я передал его дословно.
Каждую метку я сверил со всеми строками вариантов в обучающих смесях обеих версий, по точному совпадению и по префиксу в обе стороны, для верных меток и для отвлекающих. Сверка показала важную вещь. Словари «английский ключ» и «русское слово» это обучающие стили обеих версий, все 18 меток. Поэтому они служат контролем, а не проверкой. «Русская фраза» есть в обучении 1.3 для всех 18 меток, а в обучении 1.1 только для двух, причём одна из них совпадает с русским словом, так что прирост на ней ожидаем по построению. Отложенными для обеих версий остаются жаргон, названия служб и описания запроса. Точных совпадений с обучением у служб и описаний нет, но у всех меток-описаний и у двух названий служб есть префиксная связь с обучающими вариантами, поэтому строгого среза у них нет.
У жаргона два среза. «Чистый» исключает три метки, совпадающие с выводом правила транслитерации (audio, news, weather). «Строгий» исключает все метки с точным или префиксным совпадением с обучением, остаётся 11 меток и 625 вопросов. У независимого словаря строгий срез тоже исключает префиксные связи.
Для каждого сравнения считаются точный парный тест Макнемара и доверительный интервал, в котором пересэмплируются сначала метки, а потом вопросы внутри меток. Обобщается именно метка, а не отдельный вопрос. Меток в срезе от 9 до 18, поэтому эти интервалы широкие и приближённые. Значения p скорректированы методом Холма на 23 сравнения, не считая контролей.
До открытия оценок я записал в репозиторий правило прочтения. В нём сказано, какой результат я буду считать переносом, а какой нет. Время записи видно в истории коммитов.
Результат
Δ это точность 1.3 минус точность 1.1. Звёздочки показывают p после поправки Холма: одна меньше 0.05, две меньше 0.01, три меньше 0.001.
|
Словарь, срез |
5 вариантов: 1.1 → 1.3 |
Δ |
18 вариантов: 1.1 → 1.3 |
Δ |
|---|---|---|---|---|
|
Английский ключ (контроль) |
0.957 → 0.962 |
+0.005 |
0.894 → 0.900 |
+0.006 |
|
Русское слово (контроль) |
0.956 → 0.960 |
+0.004 |
0.883 → 0.892 |
+0.009 |
|
Русская фраза (обучающий стиль 1.3) |
0.881 → 0.957 |
+0.076 |
0.703 → 0.885 |
+0.182 |
|
Жаргон, все 18 меток |
0.633 → 0.855 |
+0.222*** |
0.431 → 0.640 |
+0.209*** |
|
Жаргон, строгий, 11 меток |
0.550 → 0.786 |
+0.235*** |
0.328 → 0.470 |
+0.142*** |
|
Жаргон, чистый, 15 меток |
0.624 → 0.838 |
+0.214*** |
0.427 → 0.595 |
+0.168*** |
|
Названия служб |
0.835 → 0.869 |
+0.034* |
0.632 → 0.733 |
+0.101*** |
|
Описания запроса |
0.939 → 0.958 |
+0.019 |
0.848 → 0.878 |
+0.030* |
|
Сленг, все 18 меток |
0.648 → 0.780 |
+0.132*** |
0.428 → 0.476 |
+0.048 |
|
Сленг, строгий, 14 меток |
0.595 → 0.761 |
+0.166*** |
0.369 → 0.419 |
+0.050 |
|
Коды вида ALARM_SCN |
0.856 → 0.889 |
+0.033* |
не прогонялись |
|
|
Аббревиатуры, все 18 меток |
0.403 → 0.379 |
−0.024 |
не прогонялись |
|
|
Аббревиатуры, чистый |
0.420 → 0.360 |
−0.060* |
не прогонялись |
|
|
Непрозрачные коды, строгий |
0.135 → 0.168 |
+0.033 |
0.018 → 0.061 |
+0.043** |
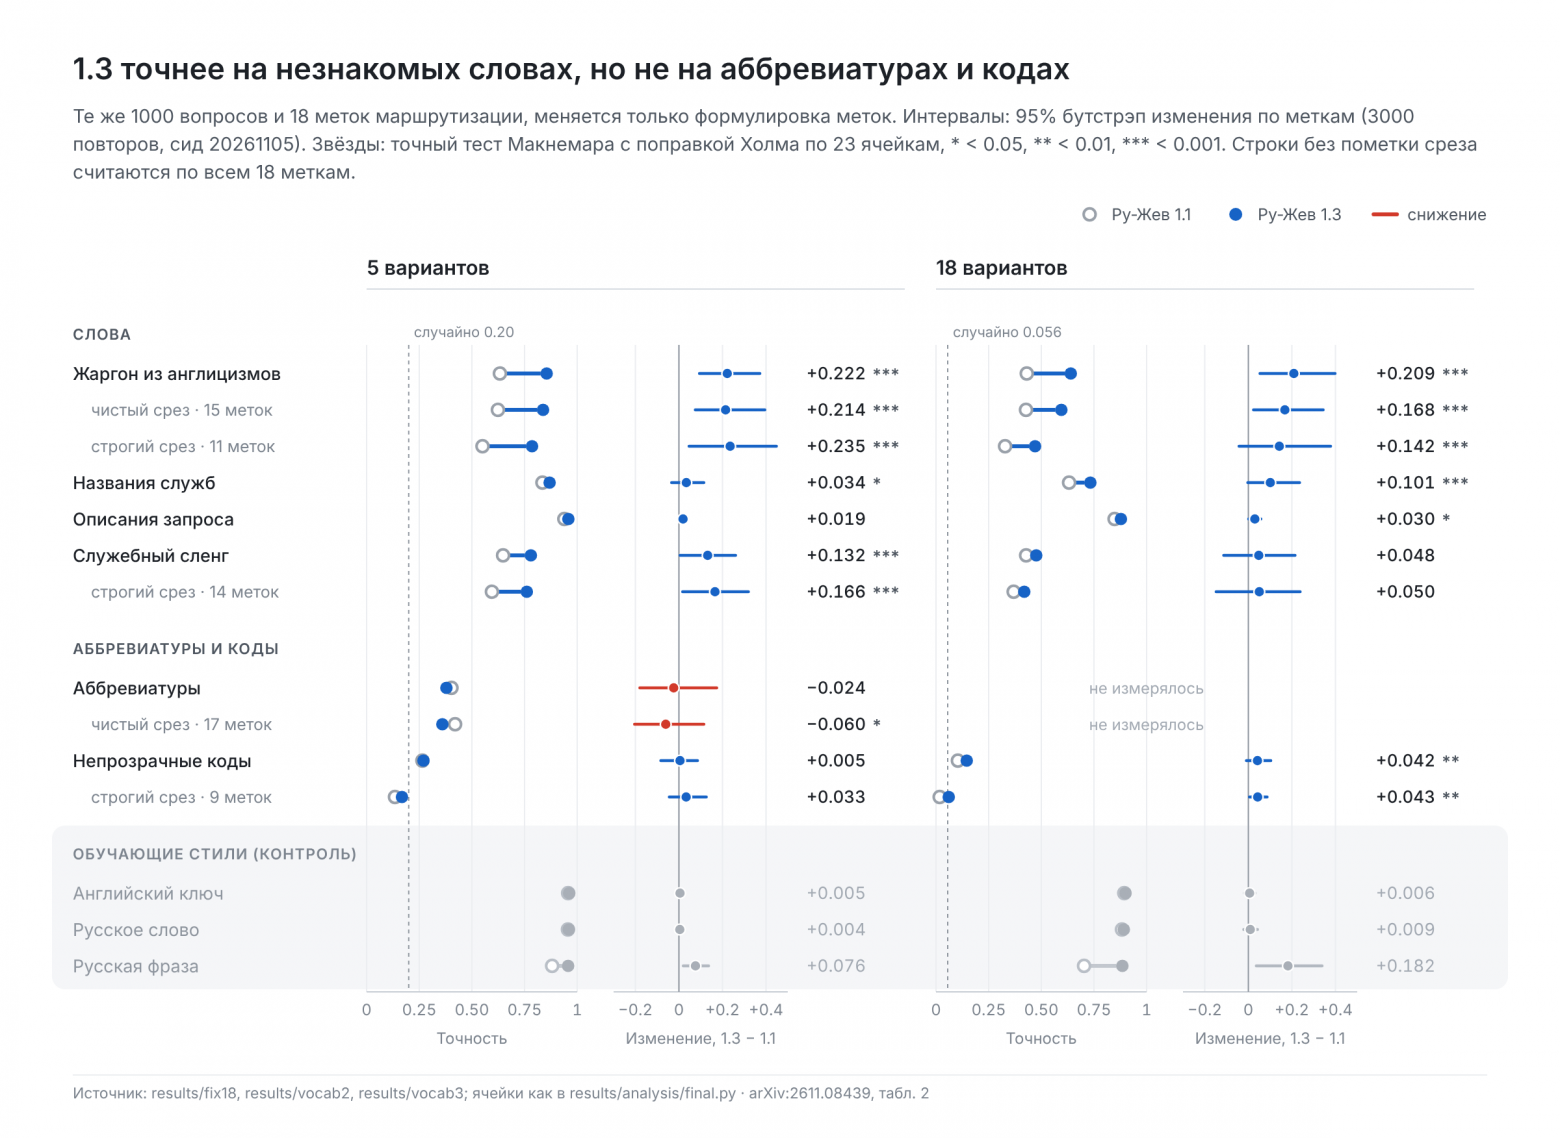
На словах 1.3 точнее. На всех отложенных словарях из слов, обычных или заимствованных, 1.3 точнее 1.1 в обеих постановках. Таких ячеек четырнадцать, вместе со срезами по всем меткам, и знак везде один. Сильнее всего это видно на жаргоне. На строгом срезе, где нет меток с точным или префиксным совпадением с обучением, прирост составляет +0.235 при пяти вариантах и +0.142 при восемнадцати. Интервал по меткам выше нуля при пяти вариантах и проходит через ноль при восемнадцати. По всем меткам жаргона интервал выше нуля в обеих постановках.
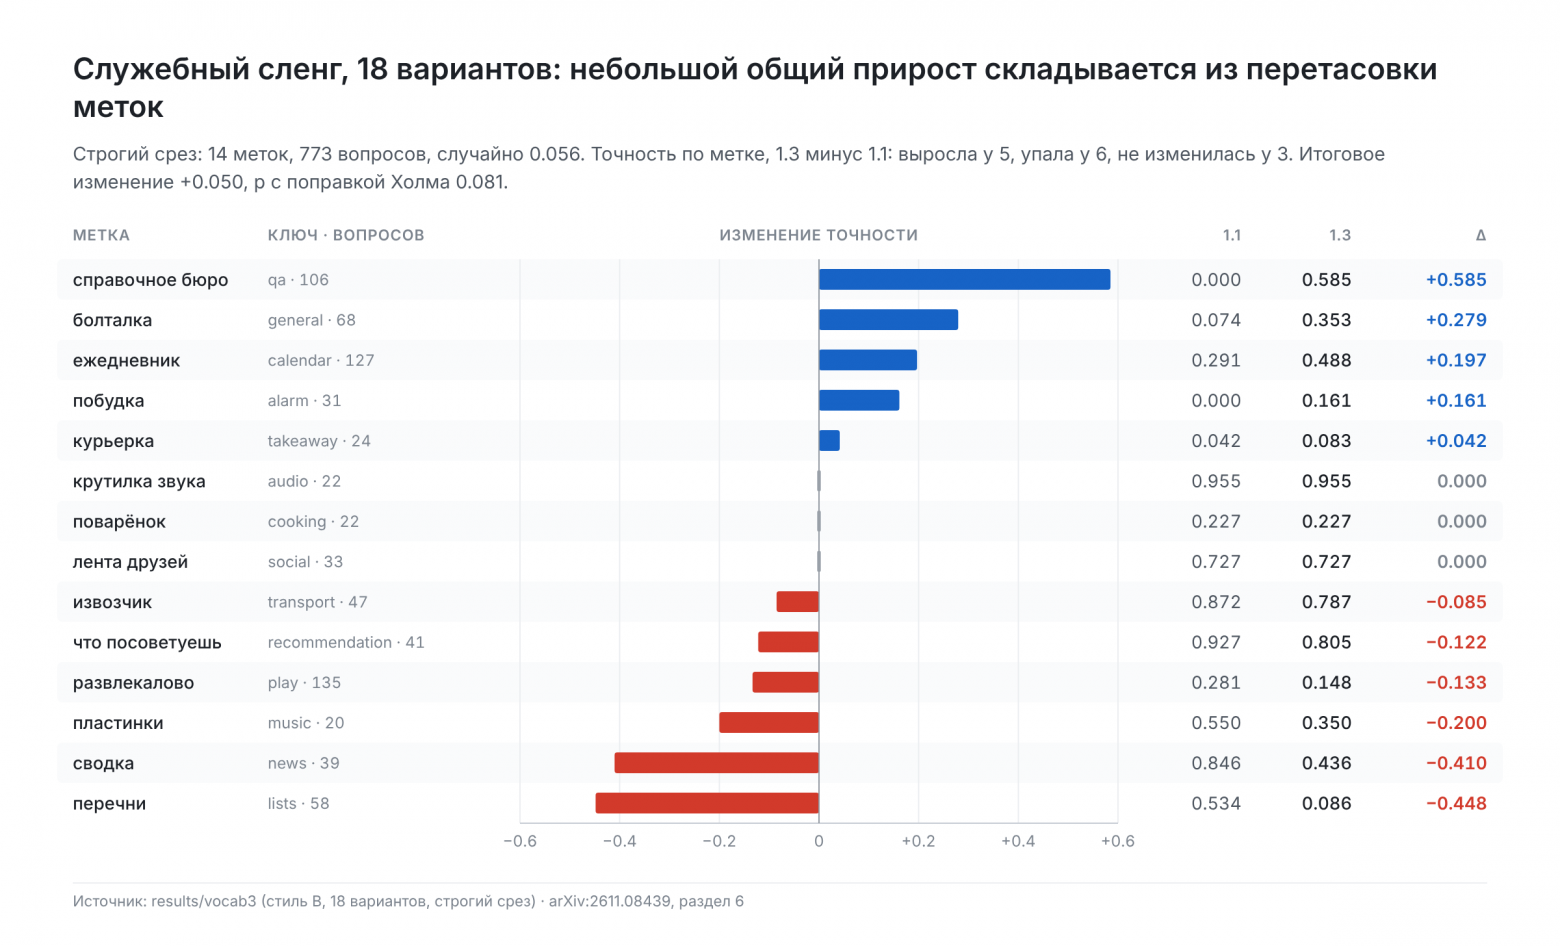
Сленг ведёт себя иначе в двух постановках. При пяти вариантах прирост +0.166, интервал по меткам выше нуля. При восемнадцати прирост +0.050. Правило прочтения, записанное до открытия оценок, засчитывает его как перенос, сырое p = 0.016. Но поправку Холма он не выдерживает, а интервал по меткам проходит через ноль. По меткам это скорее перетасовка. Пять меток улучшились, шесть ухудшились, сдвиги крупные в обе стороны. «Справочное бюро» выросло с 0.000 до 0.585, «перечни» упали с 0.534 до 0.086. Пятивариантный разбор сленга я добавил уже после правила.
На аббревиатурах и кодах полезного прироста нет. На трёхбуквенных аббревиатурах 1.3 не лучше. На всех метках разница −0.024 и не значима, на чистом срезе −0.060. Разрыв между срезами создаёт одна исключённая метка, на которой 1.3 выросла с 0.000 до 0.829. Непрозрачные коды не читает ни одна версия. При восемнадцати вариантах 1.1 ниже случайного уровня, 1.3 на его уровне. Коды вида ALARM_SCN даются обеим версиям легко, потому что содержат обученный ключ целиком, и как проверку устойчивости я их не считаю.
Уверенность. Там, где выросла точность, площадь под кривой «охват и риск» (AURC, меньше лучше) в большинстве случаев уменьшилась. Исключение это сленг по всем меткам при восемнадцати вариантах, где она выросла с 0.354 до 0.395. На строгом жаргоне она упала с 0.235 до 0.078 при пяти вариантах и с 0.452 до 0.418 при восемнадцати. Значит, порог по уверенности в этих случаях работает лучше. Число ошибок с уверенностью выше 0.8 ведёт себя хуже. При пяти вариантах на жаргоне оно упало со 110 до 62 на тысячу. При восемнадцати оно выросло на жаргоне по всем меткам с 79 до 109 (на строгом срезе со 112 до 160) и на строгом сленге с 151 до 191, потому что 1.3 в целом увереннее. На названиях служб оно при этом упало со 123 до 87. На аббревиатурах оно выросло с 77 до 118. Аугментация сама по себе не делает уверенность безопасной на незнакомых метках. Температуру нужно подобрать на ваших метках.
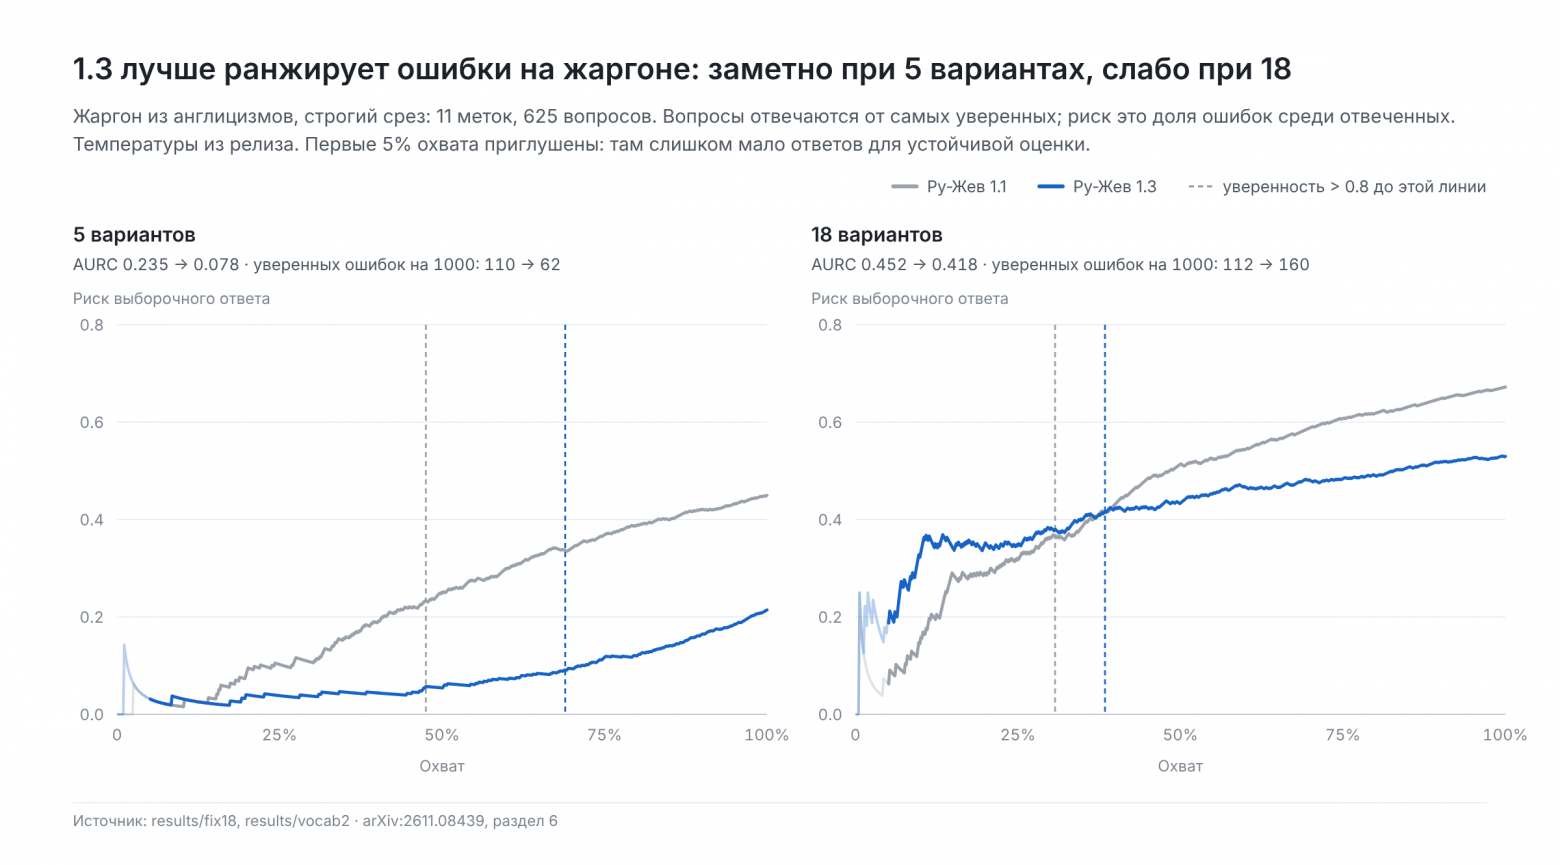
Вывод такой. Версия, обученная на нескольких формах каждой метки, точнее на незнакомых названиях, которые являются словами, в том числе на таких видах слов, которых в обучении не было, например на сленге и названиях служб. На аббревиатурах и кодах полезного прироста нет. Почему так, я отдельно не проверял. Моё объяснение в том, что у кода или аббревиатуры почти нет смысловой опоры. Стили аугментации стоит подбирать по той лексике, которой реально пользуются в вашей организации.
Незнакомые наборы и сравнение с Laya
Laya это открытая модель решений на той же основе mmBERT, 322 миллиона параметров. В отличие от Ру-Жев, она читает все варианты за один проход. Я сравнил три модели на двух наборах, на которых не училась ни одна версия Ру-Жев. В карточке Laya они не названы, но список её обучающих данных там не приводится.
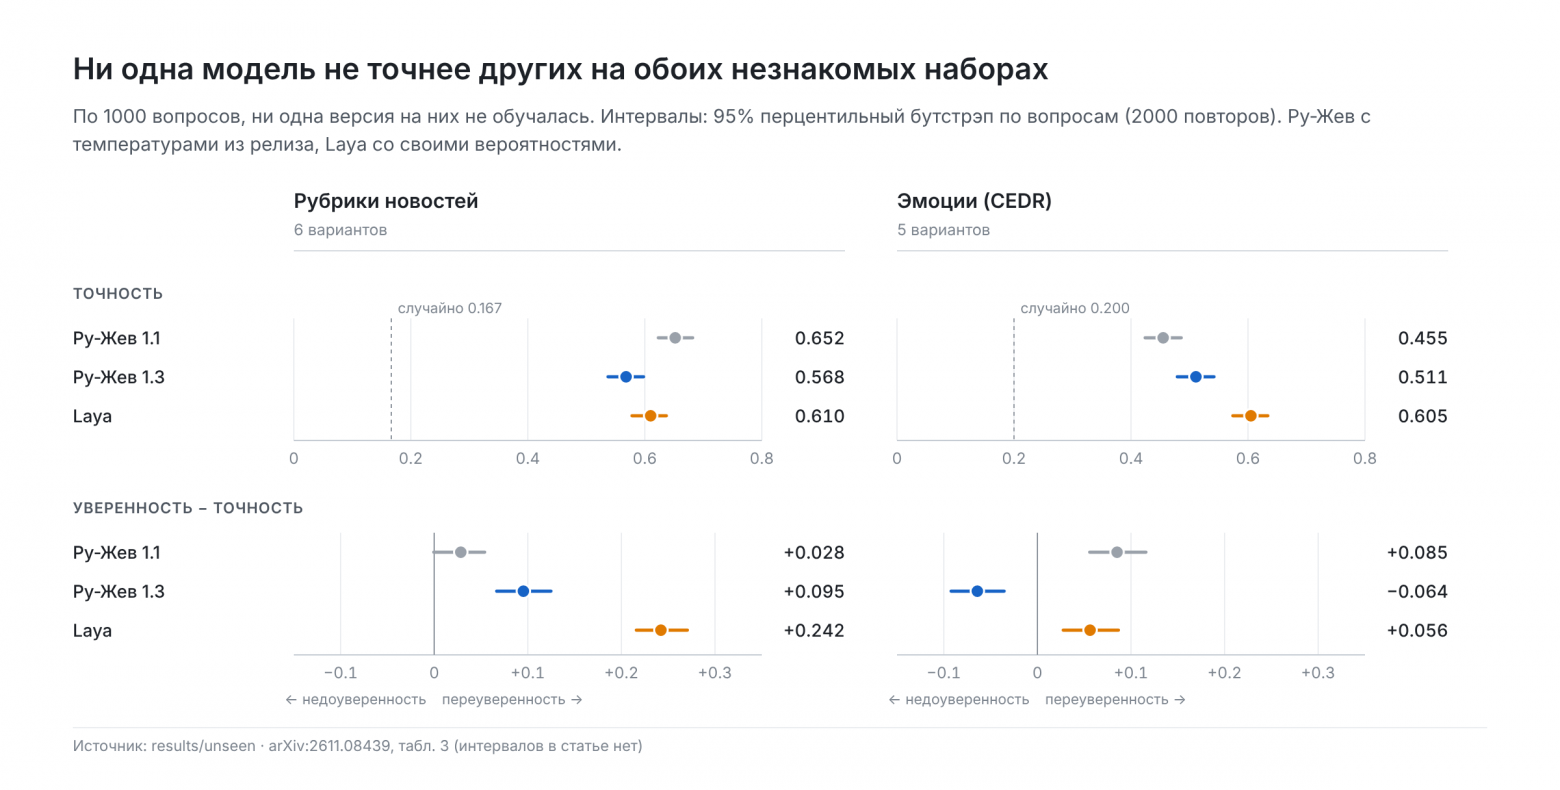
По 1000 вопросов в каждом наборе, шесть и пять вариантов. Рубрики взяты из ruMTEB (в метаданных указана лицензия MIT, файла лицензии нет). Эмоции взяты из CEDR, только строки с одной меткой (Apache 2.0 в метаданных).
Ни одна модель не точнее на обоих наборах. На рубриках 1.3 на 8.4 пункта ниже 1.1, пять меток из шести ухудшились и ни одна не улучшилась. На эмоциях 1.3 на 5.6 пункта выше. Laya заметно переуверена на рубриках и не переуверена на эмоциях. Если каждой модели подобрать свою температуру, остаточная ошибка [4] калибровки у Ру-Жев составляет от 0.056 до 0.067, у Laya 0.055 и 0.081. Для Laya это значения прежнего способа разбиения, без записанного зерна. Превосходства над Laya ни по точности, ни по калибровке я не заявляю.
Laya получала однострочную инструкцию, без неё её интерфейс не работает. Ру-Жев инструкцию не принимает. Ключи вариантов у Laya нейтральные, смысл несёт только текст варианта.
На основном стенде Laya сильно уступает Ру-Жев, при восемнадцати вариантах 0.150 против 0.640 на жаргоне. Но обучающая часть MASSIVE входит в смесь Ру-Жев, а карточка Laya сама говорит о почти случайном качестве без дообучения. Этот разрыв отражает домашнее поле, и сравнением я его не считаю.
Точность на своих задачах и калибровка
На шести задачах Russian SuperGLUE, где строки и наборы вариантов в обеих версиях одинаковые, обе версии дают ровно 8120 верных ответов из 10 157. Расходятся они на 1680 строках, по 840 в каждую сторону. Построчные предсказания и хеши весов обеих версий лежат в репозитории. Задача russe даёт 84 процента этих строк.
|
Задача |
1.1 |
1.3 |
Верно только у 1.1 |
Верно только у 1.3 |
n |
|---|---|---|---|---|---|
|
russe (значение слова) |
0.822 |
0.824 |
650 |
667 |
8505 |
|
danetqa (да или нет) |
0.742 |
0.753 |
58 |
67 |
821 |
|
terra (следование) |
0.775 |
0.733 |
39 |
26 |
307 |
|
parus (выбор причины) |
0.680 |
0.590 |
22 |
13 |
100 |
|
rcb (трёхклассный NLI) |
0.450 |
0.509 |
23 |
36 |
220 |
|
rwsd (кореференция) |
0.564 |
0.480 |
48 |
31 |
204 |
У 1.3 подобранная температура ниже во всех 25 случайных разбиениях этих строк, от 1.50 до 1.60 против 1.94 до 2.10. Сырые оценки 1.3 менее самоуверенные. Остаточная ошибка калибровки после своей температуры у обеих версий одинаковая, 0.0190 и 0.0191. Преимущества в калибровке я не заявляю.
Скорость
Медиана времени одного решения на процессоре Apple M4, все десять ядер, 25 прогонов после пяти прогревочных.
|
Вариантов |
2 |
5 |
18 |
|---|---|---|---|
|
Ру-Жев 1.3, мс |
18.5 |
32.8 |
73.8 |
|
Laya, мс |
15.5 |
17.8 |
30.5 |
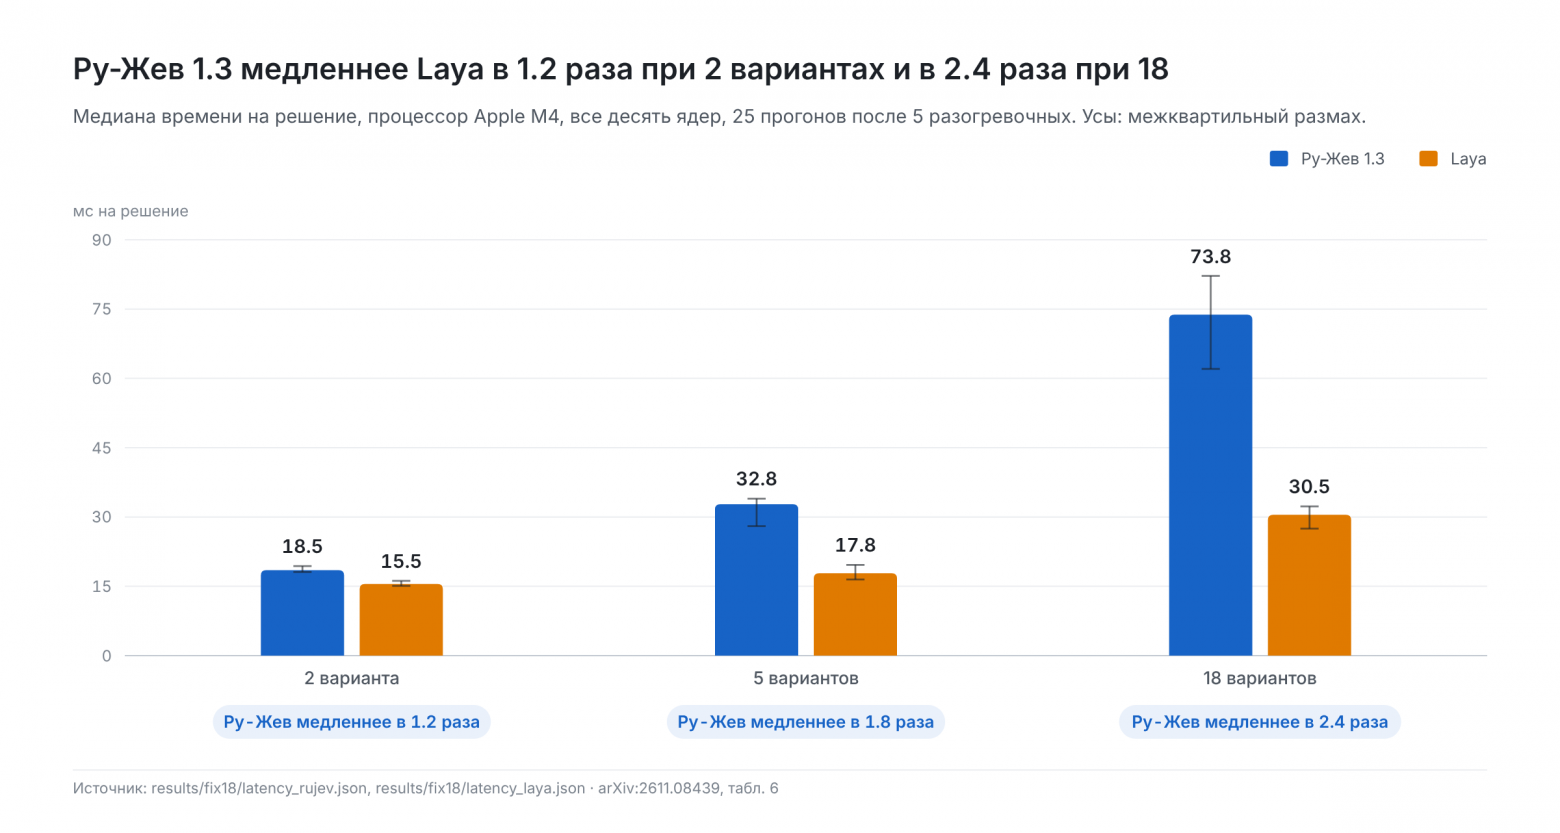
Ру-Жев медленнее Laya в 1.2 раза при двух вариантах и в 2.4 раза при восемнадцати. Это цена независимости от порядка вариантов.
Четыре ошибки в моих замерах
Первое сравнение версий показало чистый прирост точности и два провала. Ни одного из трёх не существовало. Каждую ошибку я нашёл сам, и в карточке указано, какие числа сняты.
Нарезка выборки через общий генератор. Сборщик нарезал валидацию каждой задачи модульным генератором случайных чисел, общим для всего файла. Новые стили меток в одной задаче сдвинули поток, и все задачи ниже по порядку получили другое разделение. В итоге 90.3 процента новой валидации RuCoLA лежали в обучении версии 1.1. Провал с 0.909 до 0.647 был оценкой старой модели на её же обучающих строках. На отложенных строках у неё 0.650. Исправление в том, чтобы засевать нарезку от имени задачи, то есть random.Random(f"split:{task}").
Сверка строк только по тексту. Строка с тем же текстом в 1.3 может нести формулировку варианта, которой 1.1 не видела. Тогда запуск 1.1 на ней измеряет устойчивость, а не точность. При совпадении и текста, и формулировок из девяти сопоставимых задач остались шесть. Рост токсичности с 0.722 до 0.954 был именно этим. 1.3 училась на всех пяти формулировках токсичности, 1.1 на одной.
Смешанные знаменатели. Сводная строка 0.7948 против 0.7920 считалась по половине строк, а таблица рядом считала все. Преимущество в калибровке 0.0172 против 0.0160 было снято с этого одного разбиения. Обе цифры успели попасть в опубликованную карточку и сняты.
Проверка целостности по устаревшему эталону. Чтобы оценить разброс по зерну, я переобучил обе версии. Смесь на удалённой машине совпала с локальной по sha256, по числу строк и по составу задач. Но локальная копия была собрана до коммита со стилями транслита, и прогоны, которые должны были повторить 1.3, учились без них. Поймала это только проверка по содержимому. У интентов было 120 разных строк вариантов в старой копии и 198 после пересборки. Эти прогоны нигде не публиковались и исключены из всех результатов.
Общее правило я вынес такое. Проверять артефакт нужно по тому содержимому, которое изменение обязано поменять, а не по хешу против копии неизвестного возраста. Устойчивость к формулировкам нужно мерить при разном числе вариантов.
Ограничения
Каждая версия обучена один раз. Повтора 1.3 с другим зерном нет. Два корректных повтора рецепта 1.1 дали на жаргоне 0.658 и 0.622 против 0.633 у выложенной версии, на чистом срезе 0.645 и 0.599. Разброс по зерну я мерил только для 1.1, только на жаргоне и только при пяти вариантах. Мелкие разницы в таблице не стоит считать воспроизводимыми. Приросты на жаргоне велики относительно этого разброса.
Версии различаются не только аугментацией, поэтому сдвиги на незнакомых наборах нельзя приписать одной аугментации.
Каждый стиль названий представлен одним словарём из восемнадцати меток. Все словари написаны в моём проекте или ИИ-агентами, работавшими в нём. Ни один не собран из реальных систем. Аббревиатуры и коды вида ALARM_SCN прогнаны только при пяти вариантах.
Проверки формулировок сделаны на одной задаче маршрутизации. Модель отвечает только внутри поданного набора и не умеет сказать, что не подходит ни один вариант, поэтому вариант «ничего из перечисленного» нужно подавать явно. Задачи на рассуждение с обучающей выборкой меньше тысячи строк остаются слабыми.
Как запустить
Код запуска
import json, torch, torch.nn as nn
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file
from transformers import AutoModel, AutoTokenizer

REPO = "besktech/ru-jev"


class Scorer(nn.Module):
    def __init__(self, repo):
        super().__init__()
        self.backbone = AutoModel.from_pretrained(repo)
        self.head = nn.Linear(self.backbone.config.hidden_size, 1)
        self.head.load_state_dict(load_file(hf_hub_download(repo, "head.safetensors")))

    def forward(self, ids, mask):
        cls = self.backbone(input_ids=ids, attention_mask=mask).last_hidden_state[:, 0]
        return self.head(cls).squeeze(-1)


calib = json.load(open(hf_hub_download(REPO, "calibration.json")))
T = calib["temperature"]
tok = AutoTokenizer.from_pretrained(REPO)
model = Scorer(REPO).eval()

context = "Приложение падает при входе после обновления."
options = ["техническая проблема", "оплата, счета и возвраты", "продажи"]

with torch.no_grad():
    enc = tok([context] * len(options), options, truncation=True,
              max_length=calib["max_len"], padding=True, return_tensors="pt")
    probs = torch.softmax(model(enc["input_ids"], enc["attention_mask"]) / T, dim=0)

for option, p in zip(options, probs.tolist()):
    print(f"{p:.3f}  {option}")
На опубликованных весах получается 0.947 на технической проблеме, 0.039 на продажах и 0.013 на оплате.
Делить на температуру до softmax обязательно, иначе логика [5] порога не работает. Прошлые версии лежат на ветках. Если ваш код зависит от поведения [6] 1.1, укажите revision="v1.1".
Демо на Hugging Face показывает примеры, предрасчитанные на выложенных весах. Свои варианты в нём ввести нельзя, для этого нужен код выше.
Данные и лицензии
Лицензия MIT покрывает код и веса. Обучающие данные сохраняют свои лицензии. Тринадцать задач собраны из открытых датасетов: шесть задач Russian SuperGLUE, RuCoLA, одна задача на рассуждение из двух наборов MERA (ruOpenBookQA и ruWorldTree), четыре задачи ruMTEB (тональность отзывов, оценка отзывов, интенты и сценарии MASSIVE) и набор по токсичности. Разбор по каждому источнику лежит в DATASETS.md.
Одна оговорка вынесена отдельно. У отзывов Georeview файл LICENSE это немодифицированная MIT, а README Яндекса просит использовать данные в академических и исследовательских целях. Я опираюсь на файл лицензии. Это не юридическое заключение. Сборщик позволяет собрать смесь без Georeview.
Ссылки
Модель: huggingface.co/besktech/ru-jev [7]
Код, построчные предсказания и скрипты замеров: github.com/beskvladimir-create/ru-jev [8]
Препринт: arXiv:2611.08439 [9]
Замечания принимаю в обсуждениях на Hugging Face. Особенно полезны примеры ваших названий категорий, на которых модель ломается.
Автор: vladimirbesk
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38151
URLs in this post:
[1] обучения: http://www.braintools.ru/article/5125
[2] Эмоции: http://www.braintools.ru/article/9540
[3] Эмоции: http://www.braintools.ru/article/9387
[4] ошибка: http://www.braintools.ru/article/4192
[5] логика: http://www.braintools.ru/article/7640
[6] поведения: http://www.braintools.ru/article/9372
[7] huggingface.co/besktech/ru-jev: http://huggingface.co/besktech/ru-jev
[8] github.com/beskvladimir-create/ru-jev: http://github.com/beskvladimir-create/ru-jev
[9] arXiv:2611.08439: https://arxiv.org/abs/2611.08439
[10] Источник: https://habr.com/ru/articles/1104810/?utm_campaign=1104810&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.