Как измерить силу команды во времени: строим рейтинг Universal Cup
С какой вероятностью наша команда возьмёт медаль на финале ICPC? Вопрос могут задавать себе десятки команд, но кто может дать на него ответ? У меня были результаты 30 контестов Universal Cup, немного свободного времени и желание разобраться.
Всем привет! На связи финалист ICPC [1] и гроссмейстер Codeforces MachineSolution [2]. Сегодняшняя статья посвящена не столько спортивному программированию, сколько математической статистике и рейтинговой системе, я бы даже сказал рейтинговой модели, на примере контестов Universal Cup. Если вам интересны рейтинги, матстат, машинное обучение [3], спортивное программирование или всё вместе — ниже вы найдёте для себя что-то занимательное.
1. Постановка задачи
Я хочу не просто рассказать о рейтинге в вакууме, а показать вам задачу, которая меня заинтересовала, и то, что получилось при её решении. Если вы следите за командой I See Personal Computer, то, возможно, вас тоже интересует вопрос: «а каковы же перспективы этих ребят на финале ICPC?». И нас самих этот вопрос интересует, но ответить на него не так просто. Даже опытные тренеры не могут ответить на вопрос «с какой же вероятностью наша команда завоюет медали?». Когда дело доходит до конкретных чисел, предсказание в духе «небольшие» или «достаточно серьёзные» не годится. Но и мы не будем гадать на кофейной гуще, ведь у нас есть, ни много ни мало, порядка 30 контестов, написанных на Universal Cup, которые пишут многие сильные команды. Может быть, по этим данным получится предсказать итоги финала?
2. Выбор модели
Я не буду мучить вас неудачными попытками решить эту задачу и покажу сразу тот подход, который является достаточно понятным и достоверным, и ключевым фактором здесь является выбор подходящей модели. И нет, я не имею в виду GPT-6, которому можно задать вопрос «оцени вероятность нашей команды на медаль». Здесь речь о том, как мы рассматриваем процесс написания контеста и получения результатов. А именно я предполагаю следующее:
Каждая команда описывается некоторой вещественной случайной величиной Pᵢ, а её результат на конкретном контесте — это реализация данной случайной величины. Результат контеста с N командами определяется следующим образом: у каждой команды i есть перформанс pᵢ, по которому команды сортируются и получается итоговый лидерборд. Все величины Pᵢ независимы в совокупности. Всё достаточно просто и похоже на реальный процесс: команда пишет тур, выдаёт какой-то результат в количестве задач и штрафном времени и по этому результату команды упорядочиваются в финальных результатах. Только в нашей модели результат, состоящий из двух целых чисел, упрощён до одного вещественного.
Внимательный читатель или прожжённый ML-щик заметит, что в нашей модели не учитывается влияние контеста, хотя на самом деле оно есть. Какие-то контесты проще, какие-то сложнее, кому-то больше подходят реализационные задачи, кому-то идейная математика [4], кому-то коктейль из стандартных и не очень алгоритмов. Тут я отвечу следующим образом: сложность контеста здесь не учитывается, так как он одинаков для всех команд и pᵢ можно считать относительным перформансом, а не абсолютным. А то, насколько удачные задачи попались для конкретной команды i, зашито в распределении Pᵢ, если зафиксировать некоторое распределение контестов.
Но, минуточку, — скажет всё тот же прожжённый ML-щик — тогда Pᵢ не независимы! Да, тут вы правы, но я парирую это тем, что модель не обязана быть абсолютно точной, более того, все модели неверны и наша задача найти среди них полезную. И данный подход выглядит разумным компромиссом между реалистичностью и простотой модели. Более того, эта модель позволяет нам получить ответы на интересующие нас вопросы, так как если мы будем знать Pᵢ, то мы сможем оценивать вероятности того или иного события с помощью метода Монте-Карло. Так как поля этой книги слишком узкие для полного объяснения, я предлагаю вам ознакомиться с этим методом по ссылке [5], если вы не понимаете, что это. Впрочем, до главы с оцениванием модели он нам не пригодится.
3. Переход к построению рейтинга
Перед тем, как развивать модель дальше, очень важно посмотреть по сторонам и понять, как уже решаются похожие задачи. Возможно даже ровно те же задачи. А развивать модель явно нужно, так как пока что у нас есть довольно неудобные для оптимизации величины Pᵢ, на которых нет никакой структуры и ограничений. На практике (да и в теории тоже) это означает, что мы просто не сможем их оценить из-за невероятно большой степени свободы.
3.1 Elo на примере шахмат
И первый понятный мне пример рейтинга — это Elo-рейтинг в шахматах. Его модель очень проста для понимания. Представим, что у каждого шахматиста есть скрытая положительная сила pᵢ. Тогда ожидаемый исход партии между игроками 1 и 2 равен  , где победа первого приравнивается к 1, ничья к 1/2 и поражение первого к 0. Простыми словами, первый игрок в среднем за партию будет набирать
 очков. Для равных по силе игроков мы получаем ожидаемый результат 1/2, а если
 , то из 100 партий первый игрок наберёт в среднем 75 очков.
Сам Elo-рейтинг rᵢ игрока i связан со скрытой силой формулой  для удобства шкалы оценивания. Просто человеку намного удобнее ориентироваться в терминах «Рейтинг игрока А на 300 пунктов выше, чем рейтинг игрока B», чем «Рейтинг игрока А в 5,62 раза выше, чем рейтинг игрока B». Для справки: константа b подобрана так, что разница в 400 пунктов рейтинга означает, что скрытая сила фаворита в 10 раз выше, чем у оппонента. Так что если сядете за доску напротив существенно превосходящего вас соперника, то знайте, что из 10 партий у вас очень неплохие шансы сделать хотя бы одну ничью.
Такая система уже показала себя на практике и «обучается» по данным следующим образом: после партии игроков A и B, если ожидаемый результат был e, а фактический f, то игрок A получает (возможно, отрицательную) прибавку рейтинга  , где d — некоторый коэффициент, который отвечает за то, чтобы рейтинг не менялся слишком быстро или слишком медленно. Соответственно, игрок B получает противоположную прибавку рейтинга.
3.2 Elo на примере Codeforces
Ну с шахматами понятно, но у нас же не поединки и не партии, а один и тот же контест, в котором участвуют сотни команд одновременно. Как быть в таком случае? Авторы рейтинговой системы Codeforces [6] предложили практичный и изящный ответ на этот вопрос. Они представили контест из N участников как  партий между всеми парами, в каждой из которых по той же формуле считается ожидаемый результат. И с фактическим результатом пары всё довольно просто: если А оказался выше B, считается, что он победил, если ниже, то проиграл. В редком случае ничьей результат равен 1/2. Несмотря на то, что такая модель не учитывает то, насколько сильно участник А обогнал участника В, ограничиваясь только фактом обгона, она всё равно показывает хороший практический результат и даже является в некотором роде стандартом таких соревнований.
3.3 Почему задача ещё не решена?
И почему же эта статья ещё не закончилась, если мы рассмотрели, как Codeforces решает нашу задачу? Раз уж утверждается, что такая рейтинговая система отлично подходит для формата контестов, давайте возьмём её и вопрос закрыт.
Вот мы и подошли к маленькому нюансу, который всё портит. На Codeforces рейтинги считаются только для официальных участников. Если я пишу контест позже, в виртуальном формате, то мой рейтинг никак не меняется и не влияет на рейтинги других участников. Это отличный формат для рейтинговой системы, но не для решения нашей задачи. И у нас есть сразу две причины не игнорировать виртуальные участия:
-
На платформе Universal Cup примерно 37% участий виртуальные. Это достаточно много для того, чтобы просто пренебречь данными. Попробуйте просто взять и выкинуть треть датасета!
-
Все участия команды I See Personal Computer виртуальные
Вторая причина, пожалуй, не оставляет нам выбора. Даже если мы считаем целесообразным отказаться от виртуальных участников для простоты, это умножает на 0 всю ценность работы, так как мы не узнаем про себя ничего! Однако есть основания полагать, что 30 участий, пускай и виртуальных, могут рассказать про нашу команду многое.
Но нельзя сказать, что обзор предметной области не дал нам совсем ничего. Наоборот, нам бы хотелось расширить подход построения рейтинга на более сложный случай виртуальных участий. Но как это сделать?
4. Проблематика задачи и способы решения
Но почему бы тогда просто не?.. И вот в этот момент появляется вопрос, а что же делать? Нельзя же просто обработать все контесты по порядку и пересчитать рейтинг команд с помощью метода Elo? Появляется проблема хотя бы потому, что непонятно, а в каком порядке обрабатывать контесты. По дате проведения? Но тогда команды, пишущие виртуальные туры, получат обработку контестов совсем не в том порядке. Давайте поясню на личном примере, почему этим нельзя пренебречь:
Со временем можно ожидать (а ещё надеяться и верить), что наша команда прогрессирует, а это значит, что контесты начала 2026 года мы пишем хуже, чем середины того же года. А теперь представьте, что будет думать система, если ей дать контесты в случайном порядке. Да она же просто усреднит результаты! Хотя в финальной точке наша сила явно выше, чем в начальной. А что будет, если обработать контесты в обратном порядке? Думаю, вы понимаете, что ничего хорошего ждать не приходится.
На самом деле эта проблема формулируется довольно понятным образом — если мы учитываем только официальные участия, то сравниваем перформанс команд в один и тот же момент времени t, а с виртуальным участием приходится сравнивать перформанс в разные моменты времени t₁ и t₂. Опять же замечу, что мы не можем, да и не хотим их просто не сравнивать, потому что даже если прошло много времени, то сравнение команды I See Personal Computer в мае 2026 года с командой Block of Cats в феврале 2025 года очень даже информативно и говорит о силе обеих команд в эти моменты времени.
Таким образом мы приходим к естественному расширению нашей модели — распределение перформанса P зависит не только от команды, но и от времени написания. Иными словами, мы имеем дело со случайными величинами Pᵢ(t) и мы будем строить рейтинговую модель исходя из того, что у каждой команды есть некоторое изменение силы во времени. И да, я называю это именно рейтинговой моделью, а не системой, так как в привычном для меня понимании рейтинговая система имеет цель мотивировать и ранжировать команды в зависимости от официальных выступлений, а наш метод, скорее, старается вытащить из имеющихся данных как можно больше информации. В частности, один из эффектов нашей модели будет то, что если команда I See Personal Computer выиграет какой-то прошлый UCup contest (хоть бы хоть бы), то это понизит рейтинг всех участников этого контеста, хотя они могут уже много лет не прикасаться к этой платформе! Согласитесь, довольно неприятное явление для рейтинговой системы, но вполне сносное для рейтинговой модели.
Забегая вперёд, я нашёл способы учесть всю полезную информацию и вот что у меня получилось:
А теперь давайте разберёмся, как именно оно получилось.
5. Формализация модели
Как я уже писал в начале, наша модель пока очень неконкретная и её нужно развивать дальше, тем более с последними двумя главами она стала только сложнее, ведь у нас появилась переменная времени. В этой главе я буду делать много предположений и оправдывать их всеми силами, чтобы получить модель, которую уже можно обучать и оптимизировать. Не обойдётся без интуиции [7], чуечки и веры. Так что присаживайтесь поудобнее.
И начнём мы сразу с очень сильного предположения:
Пускай у каждой команды есть рейтинг rᵢ(t), который описывает её силу в момент времени t. На конкретном контесте команда показывает случайный перформанс Pᵢ(t) = rᵢ(t) + ε, где ε – случайный шум. Это довольно стандартное предположение для рейтинговой модели, например, в шахматах имеет место такая же модель с распределением шума:
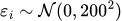
То есть в первоначальной модели Эло перформанс игрока колеблется вокруг его рейтинга с нормальным шумом.
Наша модель имеет свои плюсы в простоте, но, думаю, внимательный читатель снова заметил небольшой нюанс. А именно то, что масштаб ошибки [8] ε не зависит ни от команды, ни от времени! Хотя логично [9] предположить прямо противоположное и давайте я объясню на примере. Допустим, в команде I See Personal Computer есть очень (очень!) сильный математик Таисия (все персонажи вымышленные, а совпадения с реальными людьми случайны), которая может решить очень сложную математическую задачу на контесте и поднять команду в лидерборде. Но сложные задачи на то и сложные, что могут не решиться за время контеста даже сильным (очень сильным) математиком, а математические задачи на то и математические, что могут и вовсе не встретиться на соревновании по программированию. Таким образом, команда I See Personal Computer будет иметь заметно больший шум, чем команда, состоящая из трёх участников без ярко выраженных сильных или слабых сторон, просто потому что наш результат существенно (а дополнительная решённая задача для достаточно сильной команды — это существенно) зависит от решения математической задачи. Но, несмотря на этот неоспоримый пример, моя модель всё же не будет включать в себя разные масштабы шума для разных команд в таком понимании. Отчасти потому, что это усложнение является существенным, отчасти потому, что модель с однородным шумом меня более чем устраивает.
5.1 Байесовский вывод
Обычно в таких задачах вся магия заключается в выборе распределения ошибки. И нет, мы не будем просто утверждать, что 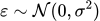 , никаких необоснованных нормальных распределений! (каждый раз, когда вы произносите эту фразу, где-то радуется один Нассим Талеб). Основная причина важности этого выбора в том, что распределение ошибки задаёт форму распределения всего Pᵢ(t), а нам хотелось бы, чтобы модель было удобно обучать. И вот мы плавно подходим к тому, как же мы вообще в принципе собираемся обучать модель.
Думаю, что если вы дочитали до этого момента и не закрыли статью, вам знакома следующая формула:
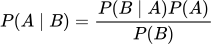
Удивительно, но это не просто соотношение, верное по определению условной вероятности, но и полезная формула, смысл которой сначала нужно почувствовать. Но перед тем как коротко рассказать о том, что же это значит и как она поможет обучать модель, я отмечу, что понимаю, как непросто может быть осознание этого подхода. На факультете МКН целый семестровый курс посвящён Байесовскому выводу и я просто обязан оставить ссылку на курс Сергея Николенко [10] для тех, кто хочет лучше разобраться в предмете. А теперь всё же попробуем почувствовать формулу.
Пускай A — это все параметры нашей модели p(i, t), а B — это результаты контестов, которые мы отнаблюдали. Формула говорит следующее. Вероятность параметров после наблюдения результатов равна вероятности увидеть эти результаты при выбранных параметрах, умноженной на априорную вероятность параметров и поделённой на вероятность самих результатов. Звучит сложно, поэтому давайте разбираться.
 — это условная вероятность модели быть такой (A) при том, что мы увидели конкретные результаты (B). Нам бы очень хотелось посчитать эту вероятность, так как в таком случае мы можем выбрать такую модель A, которая максимизирует эту вероятность. Сразу оставим заметочку на полях, что для такой максимизации нам очень хочется, чтобы и
 и A задавались аналитически в как можно более удобном виде.
 — это вероятность пронаблюдать такие результаты (B) при фиксированной модели (A). Заметим, что этот объект намного более известный нам, так как если модель фиксирована, то мы в точности знаем, какова вероятность пронаблюдать данные B.
 — это вероятность модели в принципе быть такой, также называемая априорной вероятностью (prior). Вместо того, чтобы рассуждать абстрактно, давайте я лучше покажу важность и значимость этой априорной вероятности на примере. Пускай перед вами лежит мешок и вы точно знаете, что в нём только белые и чёрные шарики, неотличимые на ощупь. Теперь вы наугад достаёте 10 шариков, 8 из которых белые, а 2 чёрные. Вам стало интересно, а в каком соотношении присутствуют шарики во всём мешке. Конечно, определить это точно по 10 шарикам нельзя. Казалось бы, вы можете предположить, что белых шариков в 4 раза больше, чем чёрных, раз вы пронаблюдали такое соотношение на случайной выборке извлечённых шаров. Но не всё так просто, представим три варианта:
-
Вам изначально неизвестно ничего. Тогда действительно логично предположить соотношение 4 : 1
-
Вы изначально предполагаете, что шариков должно быть примерно поровну, из-за чего начинаете приписывать часть наблюдаемых данных случайности [11]. В зависимости от степени уверенности ваш прогноз может стать 3:1 или даже 2:1
-
Если вас не убедил второй случай, то представьте, что вы лично знакомы с владельцем этого мешка и он пообещал, что белых шаров ровно столько же, сколько и чёрных. Тогда, сколько бы шаров вы ни вытащили, будучи доверчивым и сообразительным, вы вообще не поменяете прогноза
Ну и осталось  . Оно тоже зависит от наших априорных предположений, но тут есть хорошая новость: считать его не придётся. Результаты контестов у нас уже зафиксированы, а мы ищем максимум по параметрам модели A. Так что
 для нас просто константа, которая на положение максимума никак не влияет. Смело выбрасываем её из формулы и идём дальше.
Казалось бы, такая простая формула, но именно она позволит найти наиболее вероятные параметры модели, имея только лишь голые данные! Ну не магия ли!
5.2 Выбор распределения ошибки
Итак, вооружившись Байесовским выводом, мы хотим подобрать такое распределение ε, чтобы выполнялось два условия:
-
 выражалось простой дифференцируемой формулой, чтобы мы могли оптимизировать эту функцию
-
Для любых двух участников соревнования их ожидаемый результат был согласован с Elo моделью, то есть вероятность победы A над B была равна

Нам повезло: подходящее распределение шума уже известно — это распределение Гумбеля. Оно используется в модели Плакетта — Люса (Plackett–Luce), позволяющей считать вероятность целого порядка участников. Как раз то, что нам нужно! Про эту модель Плакетт написал ещё в 1975 году в статье «The Analysis of Permutations [12]».
Само распределение Гумбеля имеет такую формулу:
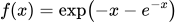
А вот так выглядит её график:
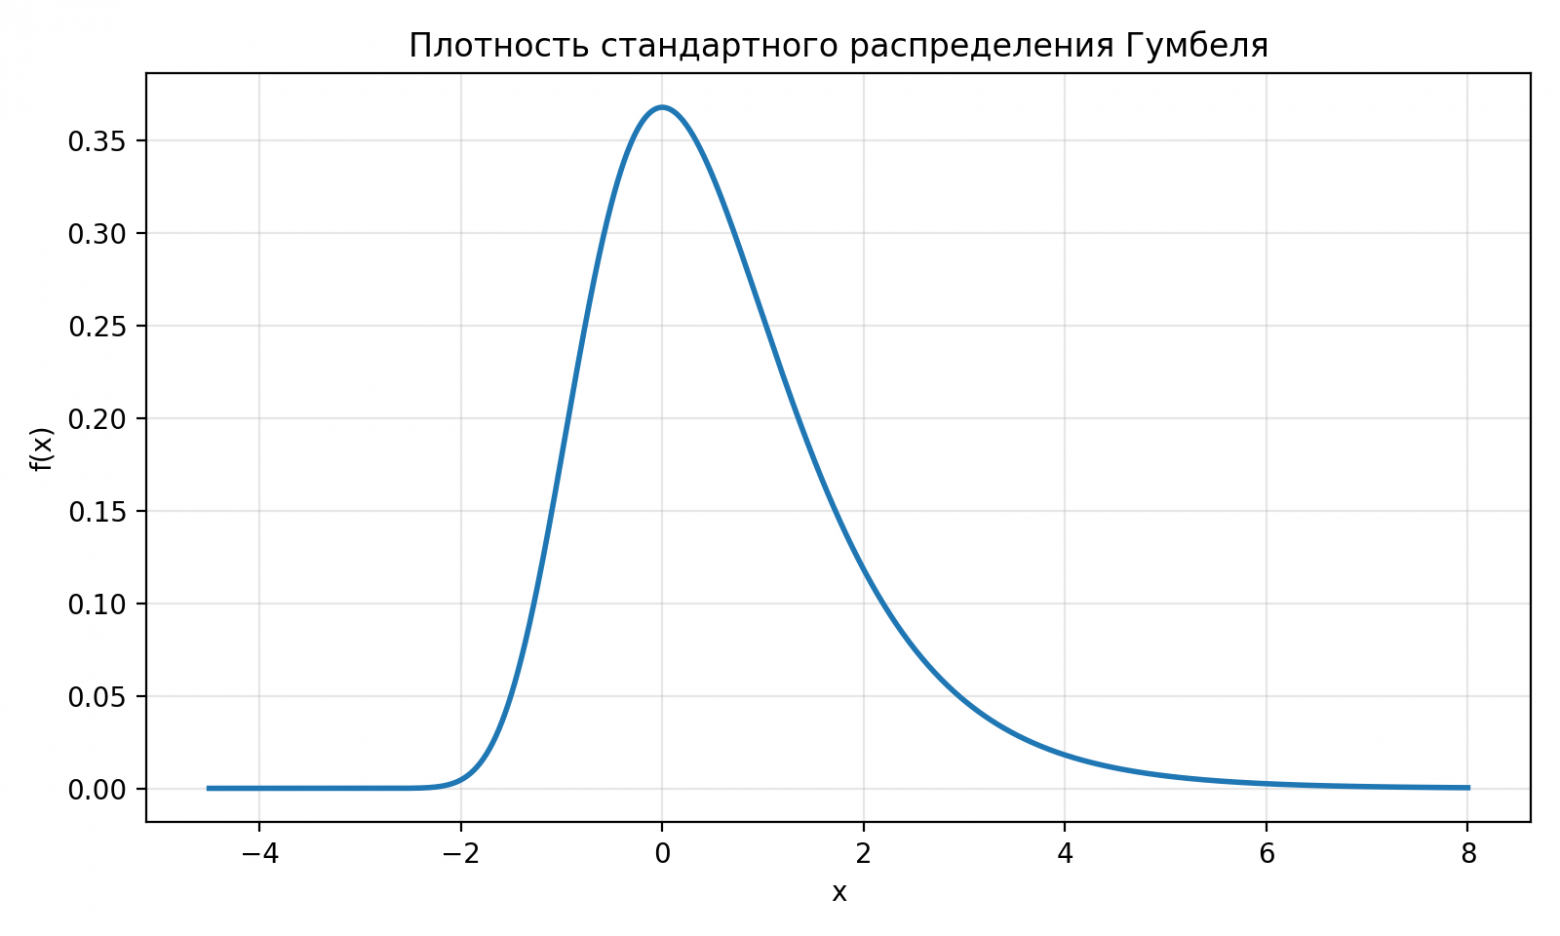
Давайте разберёмся, почему этот шум так удобен в нашей задаче. Вспомним положительную силу команды  из раздела про Elo и представим, что у каждой команды есть свой случайный таймер. Причём таймеры независимы, а время срабатывания
 имеет экспоненциальное распределение с параметром pᵢ. Чем сильнее команда, тем быстрее в среднем срабатывает её таймер.
В этом представлении побеждает команда, чей таймер сработал первым. Поэтому определим перформанс как 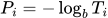 . Чем меньше
 , тем больше Pᵢ.
Но при чём здесь Гумбель? Экспоненциальную величину  можно представить как
 / pᵢ, где
 имеет экспоненциальное распределение с параметром 1. Тогда
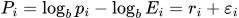 . Причём
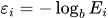 как раз имеет распределение Гумбеля с масштабом
 . Так что наша первоначальная модель «рейтинг плюс случайный шум» получается из этих таймеров автоматически.
А теперь фокус: мы легко и просто можем посчитать вероятность целого лидерборда. Вероятность того, что первым сработает таймер команды i, равна 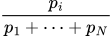 . Для двух команд это ровно формула Elo. А благодаря отсутствию памяти [13] у экспоненциального распределения тот же приём работает и дальше: после первого места выбираем второе среди оставшихся команд, затем третье и так далее. Получаем:
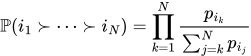
Например, для трёх команд с силами 3, 2 и 1 вероятность увидеть именно такой порядок равна  .
И вот теперь у нас есть удобная формула для вероятности результата целого контеста. А это значит, что мы можем оценивать вероятность увидеть конкретный лидерборд, что в свою очередь означает, что мы идём шаг за шагом к тому, чтобы научиться считать все компоненты формулы Байеса! Но есть один нюанс — в лидербордах бывают ничьи, а наша модель о них ничего не знает и не готова к ним.
5.3 Что делать с ничьими
В прошлой главе мы немного замяли под ковёр наличие ничьих, так как наши распределения Pᵢ(t) непрерывные, а значит вероятность одинаковых значений ровно 0. Но ничьи бывают и даже очень часто. По данным они присутствуют в 91% контестов и 17,5% выступлений заканчиваются ничьей с хотя бы одной командой. К слову, большая часть этих ничьих относится к 1–3 решённым задачам, хотя такой большой процент всё равно удивителен.
И статистика подсказывает, что этот вопрос важный, потому что почти каждая шестая команда делит с кем-то место в лидерборде. Хуже то, что наша модель даёт любой ничье вероятность 0, так как построена на непрерывных случайных величинах (а помните, как в главе «Выбор модели» это безобидное упрощение казалось нам логичным?). Поэтому для обработки групп ничьих мы будем использовать следующее отдельное соотношение:
Обозначим через G группу из k команд, занявших одно место, а через R — все команды, которые ещё не получили место. В обычной формуле Plackett–Luce каждая команда вносит множитель  . Для ничьей возьмём геометрическое среднее таких множителей:
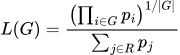
Таким образом мы не назначаем победителя внутри группы: все её участники получают одинаковый вес  . При
 получится обычная формула. После обработки группы убираем из R сразу все команды, которые в неё вошли.
Технически с такой обработкой ничьих мы уже теряем точное соответствие Elo: если считать ничью половиной победы, ожидаемый результат пары команд больше не обязан совпадать с привычной формулой  . Но среди всех пар участников ничьих совсем немного (а если считать именно по парам, мы получим всего 0,02% ничьих), так что ради них я не стал усложнять модель. Причём такой подход уже встречается в научной литературе — например, у Weng и Lin в статье «A Bayesian Approximation Method for Online Ranking [14]» (2011).
5.4 Выбор априорного распределения
С вероятностями результатов контестов мы разобрались. Теперь осталось задать вторую часть формулы Байеса — априорные предположения о рейтингах. Иначе говоря, что мы вообще можем сказать о силе команды, пока ещё не посмотрели на её выступления? Если вы подумали, что «ничего», то ошибаетесь.
У новой команды должен быть какой-то стартовый рейтинг, но мы не знаем, сильна она или нет. Зато предполагаем, что вероятность быть «топовой» командой, как и «слабой» малы, пока мы не увидели достаточно подтверждений. Например, слабая команда напишет свой первый контест и покажет там отличный результат, такое бывает. Но за счёт априорного предположения, мы не окрестим их новыми звёздами, а выдадим немного рейтинга и попросим повторить перформанс. Так, если команда стабильно выступает сильно, модель будет выдавать ей высокую силу, но небольшое количество контестов не введёт её в заблуждение. Для конкретного априорного распределения возьмём нормальное распределение вокруг условного центра рейтинговой шкалы:
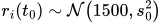
Здесь  отвечает за нашу неуверенность. Чем он больше, тем шире диапазон рейтингов, которые мы готовы допустить до появления результатов. А 1500 — просто выбранный центр шкалы, по сути нормирующее слагаемое.
5.5 Изменение рейтинга во времени
Со стартовым рейтингом разобрались. Теперь пора вспомнить, что наш рейтинг изменяется во времени, но пока что модель об этом ничего не знает, считая значения рейтинга команд во времени просто независимыми величинами. Если команда писала контесты с разницей в 1 день, то её сила, вероятно, не особо изменилась. При этом логично, что за больший промежуток времени рейтинг может меняться сильнее: за год команда может куда больше вырасти, чем за месяц. Поэтому зададим отдельный prior на изменение рейтинга между моментами t1 и t2:
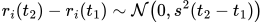
Среднее здесь равно нулю не потому, что команды не прогрессируют, а потому, что мы заранее не знаем, в какую сторону изменилась конкретная команда. А дисперсия растёт пропорционально промежутку времени: если разбить его на два независимых отрезка, изменения рейтинга сложатся, а вместе с ними сложатся и дисперсии. Так получается случайное блуждание: близкие по времени рейтинги сильно связаны, а далёкие могут заметно различаться.
Вот и весь prior: распределение стартового рейтинга плюс распределения его последующих изменений. Да, мы всё-таки взяли нормальное распределение, от которого раньше открещивались. Но теперь оно описывает не случайный перформанс на контесте, а наши предварительные представления о силе команды. Более того, здесь он даже естественно ложится на остальную математику.
5.6 Итоговая модель
Мы уже определили всё для модели, самое время собрать её в кучу. Для каждого выступления команды i мы ищем её рейтинг rᵢ(t). Он превращается в силу  , а по силам всех участников контеста мы считаем правдоподобие его лидерборда
 — с нашей поправкой для ничьих.
Теперь можно и назвать конкретные числа. Для начального рейтинга я выбрал нормальное распределение с центром 1500 и стандартным отклонением  . Для изменения рейтинга во времени —
 пунктов на корень из года. То есть за год стандартное отклонение изменения составляет 200 пунктов, а за четыре года — уже 400. О том, как сравнивать такие варианты, поговорим в разделе про валидацию.
Осталось собрать всё вместе по формуле Байеса. Удобнее максимизировать не произведение множества вероятностей, а его логарифм: произведения превратятся в суммы. Если через R обозначить все неизвестные рейтинги, а через D — результаты всех контестов, то с точностью до не зависящей от R константы получается:
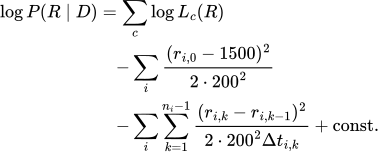
Здесь  — правдоподобие результата контеста c,
 — рейтинг команды i на её k-м выступлении (нумеруем с нуля), а
 — число лет между соседними выступлениями. Первое слагаемое соответствует вероятности пронаблюдать существующие лидерборды, второе является априорным распределением для новеньких команд, а третье задаёт временную структуру нашего рейтинга.
Всё, теперь у нас одна функция, максимум которой и даёт искомые рейтинги команд в разные моменты времени.
6. Обучаем модель
Ну а теперь осталось научить модель. В прошлой главе мы получили функцию, которая тем больше, чем лучше рейтинги объясняют результаты контестов и чем правдоподобнее их изменения во времени. Максимизировать её мы будем методом L-BFGS-B [15]. Если совсем коротко, это более хитрый вариант градиентного спуска: он использует градиент и несколько предыдущих шагов, чтобы эффективнее выбирать, куда двигаться. Градиенты для нашей функции мы способны посчитать аналитически.
Главное отличие от привычного Elo — все рейтинги подбираются одновременно, а контесты не обрабатываются последовательно в каком-то порядке. Поэтому совершенно неважно, когда очередной виртуал попал в базу: его результат может уточнить оценку команды в прошлом, а заодно и оценки соперников.
Чтобы понимать масштаб: в контрольном срезе сентября 2026 года было 134 тура и 18’384 завершённых выступлений с посылками. Я решил исключить из обучения команды без посылок совсем, так как это ещё не означает, что они действительно писали контест: знаю по себе, бывает, откроешь контест, а он был на каких-то сборах и мы знаем задачи, а отменить участие нельзя.
С импортированными участниками оказалось ещё веселее. Они попадали в протоколы UCup из результатов оригинальных соревнований, но постоянного UCup ID у них нет. Получается, для модели это каждый раз новые команды с единственным выступлением: их сила неизвестна, а априорное распределение тянет оценки к условным 1500. Если таких участников много, они начинают тянуть к этому числу и рейтинги знакомых команд. Думаю, вам сразу понятно, как они могут помешать! Представьте только какую-нибудь команду сильных китайцев, которая выиграла соревнование и сидит наверху таблицы UCup. Их рейтинг модель оценит в 1650, не больше! Они же новички. А получается, что вы проиграли куче новичков. Нечестно, не так ли? Так что такие участия я не использовал для обучения в итоговой модели, но в промежуточных итерациях успел увидеть, как сильно они могут испортить рейтинги!
7. Проверяем модель
Мы обучили модель, получили красивые рейтинги. А откуда вообще известно, что они правильные? Никакого валидационного датасета у нас нет и точность предсказаний мы измерить не можем… Или можем?
Сейчас мы встретились лицом к лицу с неприятной задачей: здесь у нас нет никаких проверочных заданий и правильных ответов, нет размеченных датасетов и так далее, но это ещё не значит, что проверить модель мы не можем никак. У нас есть вполне естественный критерий: хорошая рейтинговая модель должна уметь предсказывать результаты соревнований, которых она ещё не видела.
Поэтому в каждом эксперименте поделим контесты на две части: обучающую и валидационную. На обучающей подбираем рейтинги, на валидационной считаем метрики качества. Настройки модели подбираем по той же схеме: обучаем несколько вариантов с разными параметрами и выбираем тот, который лучше показал себя на валидационной части. Здесь важно делить именно по целым турам, а не случайно разбрасывать выступления по двум наборам. Иначе официальный участник попадёт в обучение, а виртуальный участник того же самого тура — в валидацию, и получится не прогноз будущего, а подглядывание в уже известный контест.
Со временем есть ещё один подвох. Виртуальный раунд могут написать через год после официального соревнования, поэтому важна дата окончания конкретного выступления, а не только дата оригинального тура. Для прогноза в момент t нельзя использовать ни один результат, который появился позже t. В честной проверке будущих туров модель каждый раз переобучается только на данных, доступных к моменту прогноза.
Ну вот мы обучили модель, и как теперь измерить качество? Первый подход такой: возьмём две команды из валидационного контеста. По рейтингу предскажем, кто окажется выше, и проверим, совпало ли это с реальностью. Повторим для всех пар: доля правильно упорядоченных пар (Hard accuracy) — наша первая метрика. Ничьи здесь не считаем ни победой, ни поражением. Случайная сортировка дала бы примерно 50%.
Есть и второй вариант, чуть более удачный, но менее интерпретируемый. Давайте заметим вот что: если у команды A рейтинг немного выше, чем у B, и если разница огромная, модель должна давать совершенно разные вероятности победы. Посмотрим для каждой пары, какую вероятность модель дала именно тому порядку, который случился в реальности, и усредним. Это Agreement. В отличие от Hard accuracy, здесь имеет значение не только угаданное направление, но и уверенность в прогнозе: правильный ответ с вероятностью 51% и с вероятностью 99% — совсем не одно и то же. Дальше считаем Brier score — среднее значение  , где p — предсказанная вероятность победы, а y — фактический результат (1, 0 или 0,5 для ничьей). И log loss =
 , усреднённый по парам. Последние две метрики лучше, когда они меньше: log loss особенно сильно наказывает за уверенные, но неправильные предсказания.
Я проверил модель тремя способами. Первый — прогноз будущих туров: я обучаю модель на соревнованиях, результаты которых уже были доступны, и пытаюсь предсказать следующий блок. С виртуальными попытками здесь надо быть особенно аккуратными, чтобы ни одно выступление из будущего не попало в обучение. Второй — 5-fold по турам: я пять раз делю целые контесты на 80% для обучения и 20% для проверки. Он позволяет проверить восстановление исключённых туров, но не является честным прогнозом будущего — часть обучающих соревнований могла пройти позже валидационных. Третий — я обучаю модель вообще на всех данных и оцениваю те же самые контесты. Это уже не проверка предсказаний, а скорее диагностика: насколько хорошо модель вообще способна объяснить наблюдавшиеся результаты.
Получились такие вот числа:
|
Метод проверки |
Agreement |
Hard accuracy |
Brier ↓ |
Log loss ↓ |
|---|---|---|---|---|
|
Будущие туры |
70,31% |
77,12% |
0,15504 |
0,47436 |
|
5-fold по турам |
72,65% |
80,20% |
0,13782 |
0,43105 |
|
Все данные |
75,54% |
84,77% |
0,11076 |
0,35678 |
Что видно из результатов? Самая строгая проверка — прогноз будущих туров — дала 77,12% Hard accuracy и 70,31% Agreement. Восстановление исключённых контестов получилось немного лучше, а полная реконструкция — ещё лучше, что вполне ожидаемо. Но даже на обучающих данных Hard accuracy всего 84,77%, а не 100%. Причём результаты не так уж далеко от проверок на неизвестных турнирах. Это, конечно, не доказательство отсутствия переобучения, но похоже, что модель не просто запоминает каждый лидерборд, а действительно вытаскивает из данных какой-то полезный сигнал.
Кстати, обещал объяснить, откуда взялись эти две «магические» сигмы по 200. Сначала у меня были 225 для стартовой силы и 120 для изменения за год — звучит не хуже, правда? Точнее, я бы сказал «звучит непонятно, чем они отличаются». Поэтому тут нужен чёткий критерий выбора и, чтобы не спорить, какой вариант «правдоподобнее», я устроил параметрам соревнование: разбил туры на пять частей, обучал модель на четырёх и смотрел, как она предсказывает пятую. Пара 200/200 оказалась немного лучше на отложенных соревнованиях. На самом деле разница в метриках на лучших параметрах была лишь в третьем знаке, так что этот метод вряд ли может классно оценить «хорошесть» получившихся рейтингов. Всё же сами мы бы смотрели на логичность, резкость рейтинга и так далее. Но какую-то хорошую стартовую точку дать вполне способен.
Также была идея из расчёта метрик выкидывать пары с одинаковым числом задач, как бы не обязывая нашу модель такое предсказывать, но, чтобы не закидывать вас ворохом чисел и не придумывать как бы получить числа повыше, но не менять модель, я не стану приводить таких сравнений.
7.1 Проверка на дурака
Красивые числа в таблице — это хорошо, но есть ещё одна проверка, которую никакая метрика не заменит. Нужно посмотреть на рейтинги и подумать, а верю ли я им сам?
Я первым делом окинул взглядом топов рейтинга и не увидел USA1 — команду Геннадия Короткевича. Она расположилась заметно ниже, чем я ожидал. Открыв историю рейтинга, я увидел примерно такую картину:
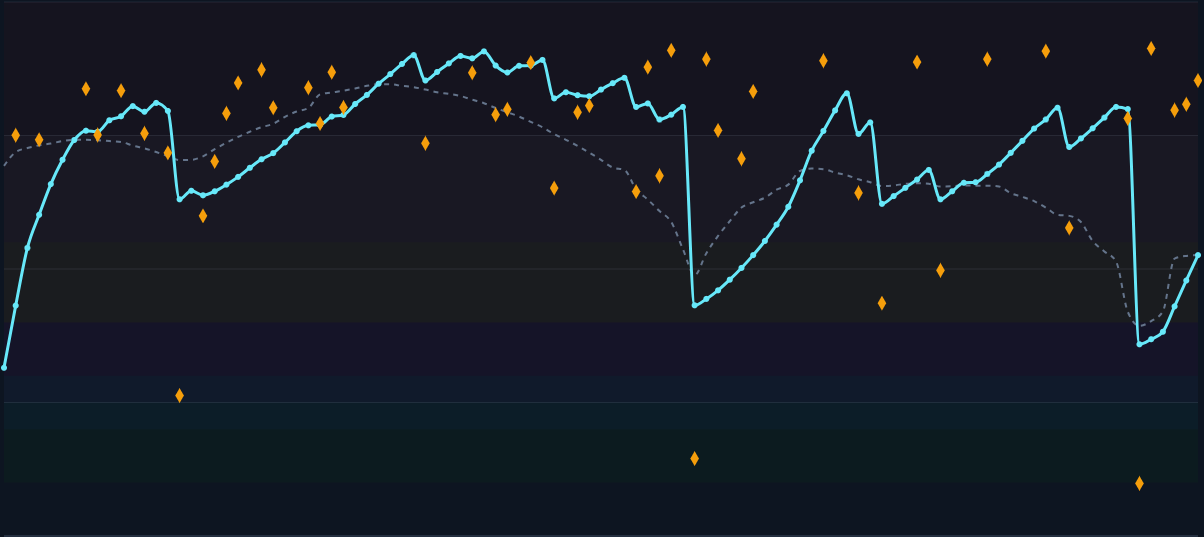
Видно, что отдельные неудачные контесты обрушивали рейтинг на сотни пунктов, а потом он довольно медленно, но верно, отыгрывал падение. Для команды такого уровня это выглядело странно. И так и было! Команда USA1 решила 2 задачи на контесте за 22 минуты и… ушла! Но почему команда так быстро теряет рейтинг и так медленно набирает обратно?
Вспомним распределение Гумбеля. У него тяжёлый правый хвост и очень лёгкий левый. То есть неожиданно высокий перформанс модель охотно объясняет удачей, а настолько же низкий считает крайне маловероятным. Поэтому наша модель очень плохо справляется с выбросами вниз. Но это ещё не значит, что модель плохая! Мы ведь тоже не верим в такое событие!
И не напрасно, мы же видим вполне чёткий симптом: команда начала решать тур и ушла. Мы можем эти выбросы удалить даже автоматически по следующим критериям:
-
У команды есть минимум 5 предыдущих участий
-
Модель собирается уменьшить рейтинг команды минимум на 400 пунктов
-
Затронуто не больше двух задач, даже неудачными посылками
-
Последняя успешная посылка отправлена в первой четверти тура
Так я исключил 45 попыток участия, примерно 0,25%. Более того, наша модель не стала сильно лучше глобально, зато так устранился явный и неприятный дефект. Конечно, кто-то может возразить «а почему это выступления удалили? А команда сама виновата, пусть теперь теряет в рейтинге!». На что я парирую: «Но ведь наша цель — не справедливость, а точность. Если мы видим очевидно сильную команду и очевидные выбросы, ну и давайте их выбросим, зачем модель-то портить?»
Посмотрим, как после такой доработки выглядит история USA1:
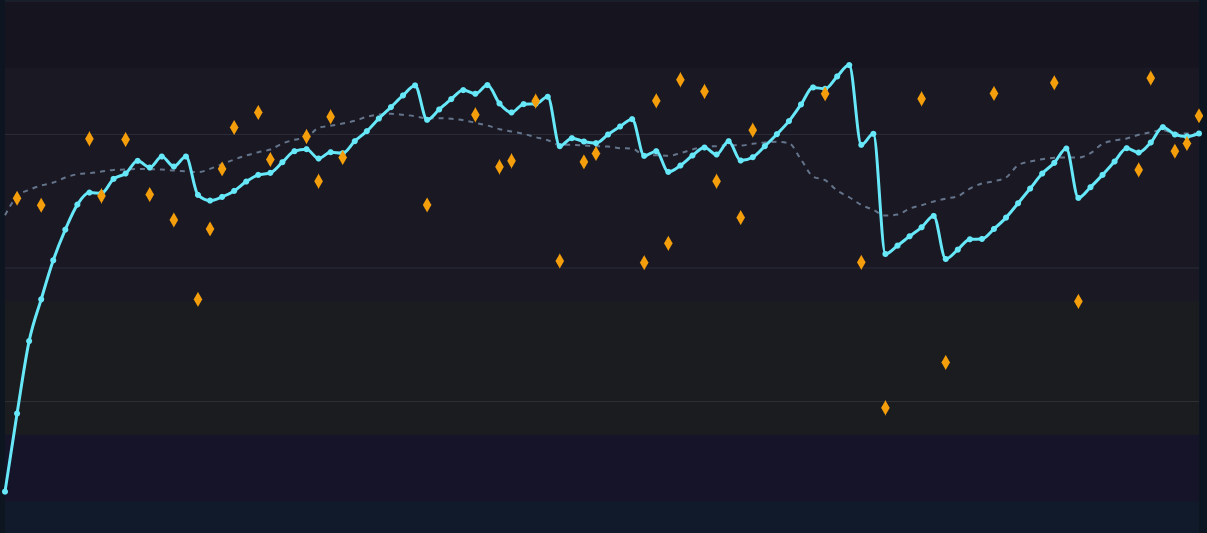
Теперь график больше похож на настоящий. Возможно, вам покажется, что там всё ещё есть выбросы и невероятно плохие результаты, но самая низкая точка перформанса на графике соответствует 27-му месту, которое случайно не займёшь (команда I See Personal Computer никогда не поднималась так высоко). Так что это честный неудачный тур, который мы хотим включать в выборку.
И также давайте посмотрим на новую таблицу с метриками качества, чтобы убедиться, что мы нигде не просели.
|
Метод проверки |
Agreement |
Hard accuracy |
Brier ↓ |
Log loss ↓ |
|---|---|---|---|---|
|
Будущие туры |
70,48% |
77,14% |
0,15455 |
0,47300 |
|
5-fold по турам |
73,10% |
80,42% |
0,13630 |
0,42696 |
|
Все данные |
76,26% |
85,26% |
0,10703 |
0,34456 |
7.2 Необычный чемпион
Но знаете, что меня удивило больше всего? Несколько неожиданный итог подведения результатов. Я привык видеть ник tourist на первых строчках, но самую первую строку заняла команда HoMaMaOvO
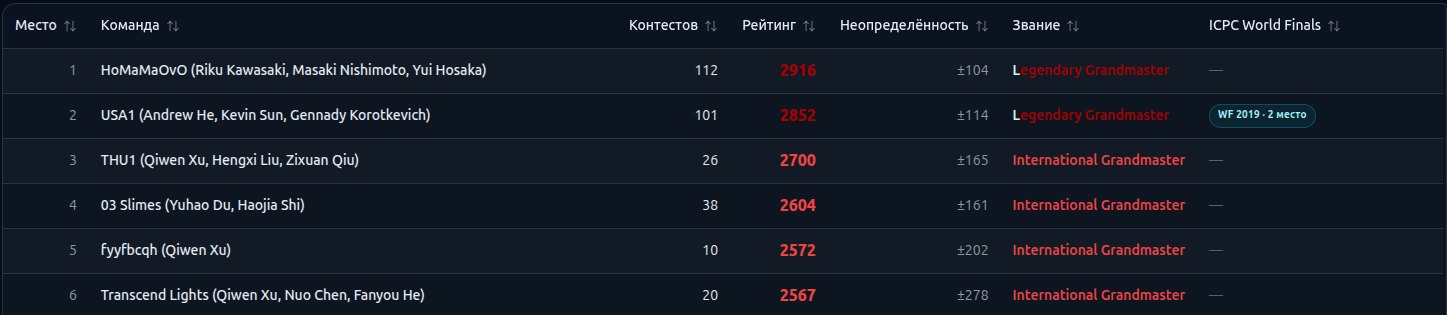
Причём они такие сильные и стабильные, что во всех (абсолютно, не преувеличение) итерациях работы над рейтингом, при любых ошибках методологии и расчётов они оставались первыми! И это очень сильный результат!
8. Сайт с рейтингом
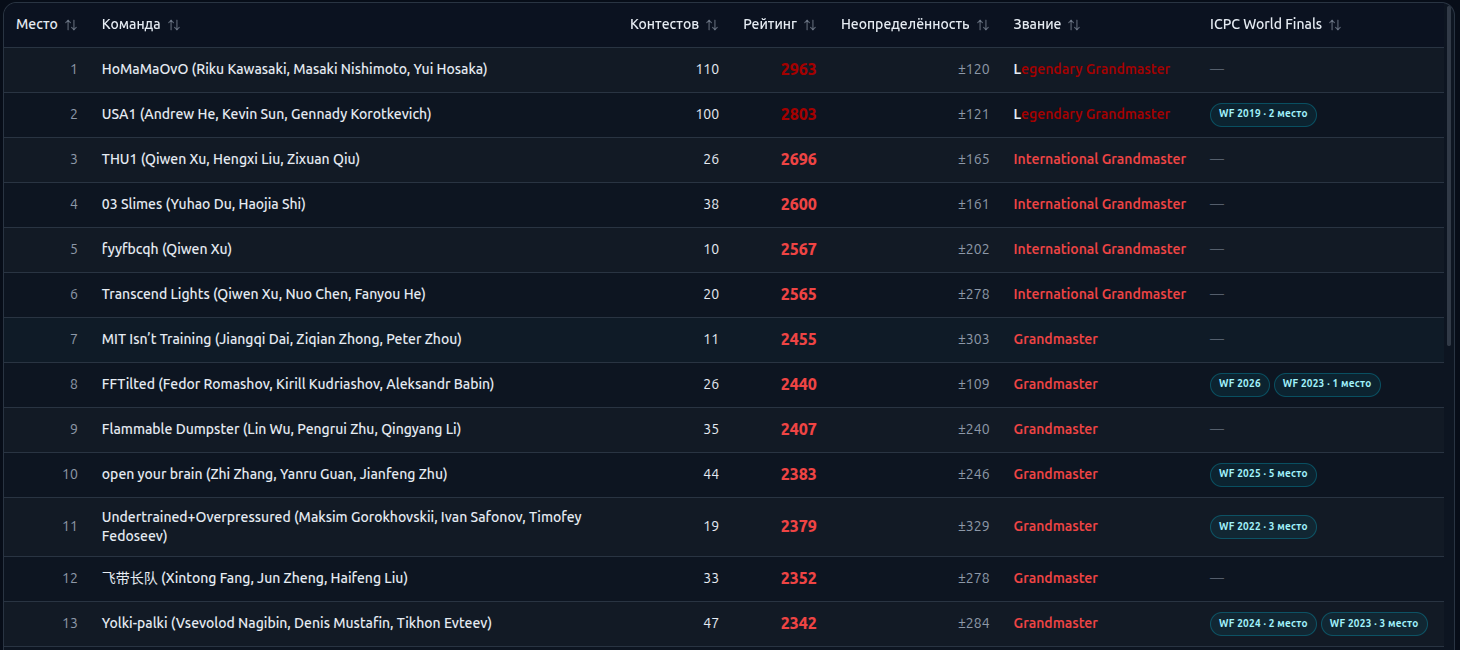
Осталось показать, что получилось в итоге. Я сделал для нашего рейтинга отдельный сайт — UCup Rating [16]. Да-да, статья ещё и с сайтом, мне будет приятно, если он вам понравится! На главной странице есть общий лидерборд команд: место, рейтинг, количество выступлений, неопределённость оценки и звание. Неопределённость выше у команд с небольшим количеством выступлений и у тех, кто давно не писал контестов. На главной также можно искать свою (и не только свою, я разрешаю!) команду по названию, сортировать таблицу и переходить к её истории.
С цветами рейтингов я решил не изобретать велосипед: они примерно как на Codeforces — от серых и зелёных до красных. Границы званий я подбирал примерно под распределение Codeforces, хотя и за счёт того, что тут команд сильно меньше, пришлось немного занизить, иначе получался 1 LGM, 2 IGM и т. д… Разумеется, это условные звания, а не официальные титулы Universal Cup, просто с ними сайт выглядит повеселее.
Ещё я добавил отметки об участии в ICPC World Finals с годом и, где получилось, итоговым местом. Сопоставление команд с участниками финалов делалось автоматически по составам, поэтому ошибки и пропуски вполне возможны: кто-то поменял название, кто-то состав, где-то не совпала транслитерация. Если вы знаете команду, которой не хватает отметки, напишите в комментариях к статье или мне напрямую — я с удовольствием добавлю.
8.1 История рейтинга как бонус
Но у данного подхода есть ещё один бонус. Мы ведь не просто выдали каждой команде один рейтинг, а построили её силу во времени. Значит, можно открыть страницу команды и посмотреть, как она менялась от контеста к контесту. Причём на графике сразу три разных вещи.
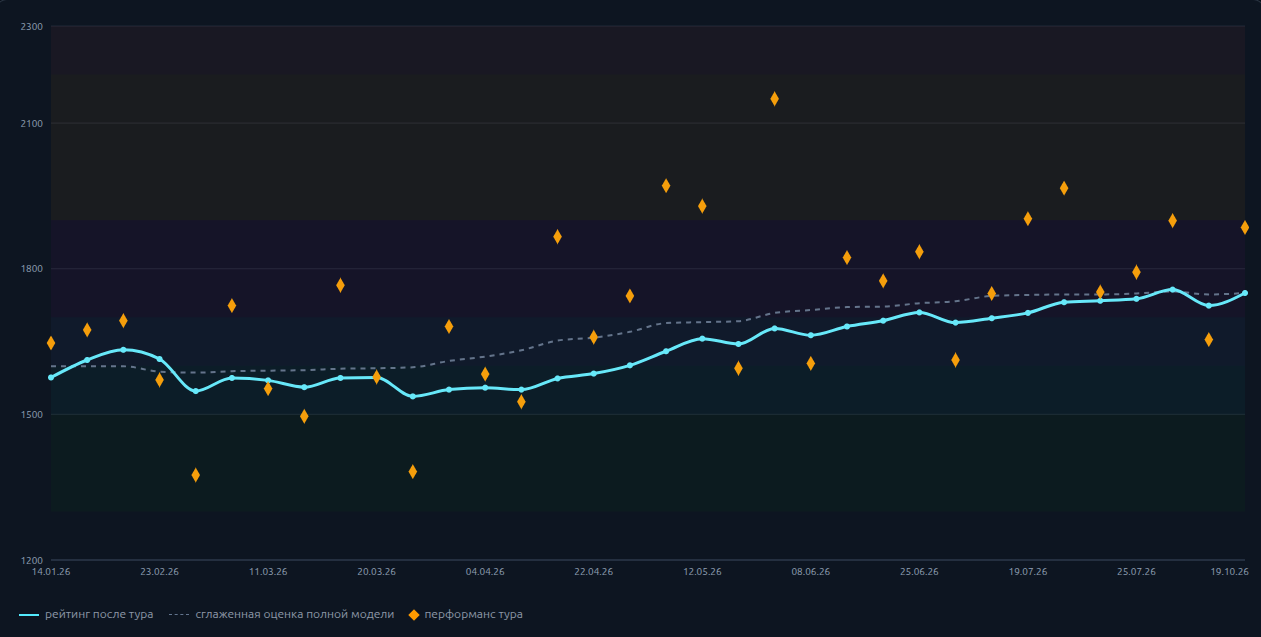
Первая — сглаженная оценка силы. Это результат нашей основной модели, обученной сразу на всей истории. Она может пересматривать прошлое задним числом: если в 2026 году команда вдруг стала решать намного сильнее, модель может немного переоценить и её выступления в 2025-м. На графике это серая пунктирная линия.
Вторая — рейтинг после каждого тура. Чтобы получить его, я отдельно переобучаю модель команды сначала на первом её выступлении, затем на первых двух, трёх и так далее. Получается почти привычная история изменений рейтинга: вот сколько у тебя было до контеста, вот сколько стало после. Это голубая линия. Нюанс: оценки соперников берутся из полной модели, так что это ретроспективная история, а не настоящий прогноз, сделанный в тот день без знания будущего.
Наконец, оранжевыми точками отмечен перформанс каждого отдельного тура. Это такой рейтинг, при котором данный результат сам по себе не потребовал бы изменить оценку силы команды. Он помогает быстро понять, какие выступления оказались выше или ниже привычного уровня. Если команда единолично заняла первое или последнее место, у такого определения вообще может не быть конечного значения — тогда честно показываем  или
 .
В общем, можно не только посмотреть на своё место в таблице, но и повспоминать, с каких контестов начался прогресс, когда случались провалы и насколько по-разному на одну и ту же историю смотрит модель с полными данными и модель, которой мы показываем выступления по очереди.
Заключение
На этом всё! Надеюсь, вам было интересно почитать про рейтинг и мне удалось показать, что это не просто магия чисел, а модель, под которой лежит интересная и логичная математика.
Мне самому понравилось работать над статьёй и даже в процессе написания я делал sanity-checks рейтинга, находил ошибки и исправлял на лету. И честно писал об этом абзацы. Рейтинг мне понравился настолько, что я забыл об изначальной задаче и так и не оценил вероятность команды «I See Personal Computer» взять медали на финале. Отчасти потому, что исследования часто становятся интереснее, чем их цель. Отчасти потому, что UCup пишут далеко не все финалисты. А как получить в таких условиях прогноз, в который сам будешь верить, — уже тема для отдельной статьи :)
А если вам всё-таки интересны шансы «I See Personal Computer» — подписывайтесь на мой телеграм-канал [17]. Там я пишу о личных и командных тренировках. Спасибо за прочтение, читатель! Ещё увидимся!
Автор: machine_solution
Источник [18]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38188
URLs in this post:
[1] ICPC: https://icpc.global/
[2] MachineSolution: https://codeforces.com/profile/machine_solution
[3] обучение: http://www.braintools.ru/article/5125
[4] математика: http://www.braintools.ru/article/7620
[5] ознакомиться с этим методом по ссылке: https://ru.wikipedia.org/wiki/%D0%9C%D0%B5%D1%82%D0%BE%D0%B4_%D0%9C%D0%BE%D0%BD%D1%82%D0%B5-%D0%9A%D0%B0%D1%80%D0%BB%D0%BE
[6] рейтинговой системы Codeforces: https://codeforces.com/blog/entry/20762
[7] интуиции: http://www.braintools.ru/article/6929
[8] ошибки: http://www.braintools.ru/article/4192
[9] логично: http://www.braintools.ru/article/7640
[10] ссылку на курс Сергея Николенко: https://sergeynikolenko.ru/courses
[11] случайности: http://www.braintools.ru/article/6560
[12] The Analysis of Permutations: https://doi.org/10.2307/2346567
[13] памяти: http://www.braintools.ru/article/4140
[14] A Bayesian Approximation Method for Online Ranking: https://jmlr.org/papers/v12/weng11a.html
[15] L-BFGS-B: https://ru.wikipedia.org/wiki/%D0%90%D0%BB%D0%B3%D0%BE%D1%80%D0%B8%D1%82%D0%BC_%D0%91%D1%80%D0%BE%D0%B9%D0%B4%D0%B5%D0%BD%D0%B0_%E2%80%94_%D0%A4%D0%BB%D0%B5%D1%82%D1%87%D0%B5%D1%80%D0%B0_%E2%80%94_%D0%93%D0%BE%D0%BB%D1%8C%D0%B4%D1%84%D0%B0%D1%80%D0%B1%D0%B0_%E2%80%94_%D0%A8%D0%B0%D0%BD%D0%BD%D0%BE
[16] UCup Rating: https://rating.machine-solution.ru
[17] мой телеграм-канал: https://t.me/machine_coding
[18] Источник: https://habr.com/ru/articles/1104260/?utm_campaign=1104260&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.