Почему я не доверил LLM выбор архива: план поиска предков на JSON-справочниках и правилах
Я делаю сервис, который по фамилии, десятилетию рождения и региону отвечает на два вопроса: какие документы той эпохи могли сохраниться и в каком архиве их искать. Очевидное решение 2026 года, один промпт, я отбросил сознательно: модель уверенно называет архивы, которые давно переименованы, и фонды, которых никто не видел. Ниже — как устроено ядро без модели (три слоя JSON-справочников, у каждой записи источник и статус проверки, плюс десяток правил), где модель всё-таки есть и почему там она не может назвать архив, даже если очень захочет.
Постановка: что здесь считается ошибкой
На входе фамилия, десятилетие или год рождения и регион. Вместо региона может прийти свободный текст места из карточки древа: «с. Ягодное, Ставропольский уезд, Самарская губерния». На выходе план: типы документов той эпохи с пояснением (метрические книги, ревизские сказки, записи ЗАГС…), проверенный госархив, вопросы родным, а после входа в аккаунт ещё и готовые ссылки поиска.
Требований три.
-
Детерминизм. Один вход даёт один план, сегодня и через месяц. Иначе жалобу пользователя не воспроизвести, а тест не написать.
-
Проверяемость. Каждый факт в ответе — это запись в репозитории, у которой есть источник и дата проверки. Ревьюер видит факт, а не гадает, что модель «имела в виду».
-
Асимметрия ошибок. Лишняя строка в плане стоит человеку минуты. Неверный архив стоит недель: письмо, нередко платный запрос и ответ «сведения не обнаружены». Хуже всего, если после такого ответа человек решит, что документы не сохранились, и бросит поиск.
Где модель ошибается систематически, а не случайно:
-
Названия архивов. Региональные архивы переименовываются, меняют сайты и организационную форму. В весах лежит смесь всех версий сразу.
-
Уезд ≠ район. Липецкий уезд входил в Тамбовскую губернию. Вторые (консисторские) экземпляры метрических книг собирались в губернском городе, поэтому для Липецкого уезда первым кандидатом оказывается тамбовский архив, а не липецкий. Модель рассуждает по современной карте.
-
Правдоподобные шифры. «Ф. 123, оп. 1, д. 45» выглядит как настоящая ссылка, а новичок проверить её не может.
Проверить это может каждый. Спросите любой чат-бот, где искать метрики конкретного села с указанием уезда. Потом откройте сайт названного архива и сверьте три вещи: существует ли архив под этим названием сейчас, хранит ли он метрические книги этой губернии и есть ли названный фонд в его путеводителе.
Варианты архитектуры
|
Подход |
Один вход → один ответ |
Что видно на ревью |
Что может проверить тест |
Главный риск |
|---|---|---|---|---|
|
Чистый промпт |
нет |
текст промпта |
почти ничего |
выдуманный архив или фонд |
|
RAG по справочнику |
нет |
промпт и выборку |
что нужная запись попала в контекст |
верная запись плюс выдуманная деталь |
|
Structured output (enum кодов) |
нет, но ответ из списка |
схему |
что ответ из списка |
правдоподобный, но неверный выбор |
|
Справочник + правила |
да |
дифф JSON и кода |
точный план на каждый вход |
устаревшая запись, грубое правило |
|
Гибрид: правила в ядре, модель на краях |
ядро — да |
дифф, схему, валидатор |
ядро — точно, края — по записанным ответам |
больше кода |
RAG снижает риск, но не убирает его. Модель получит правильную запись об архиве и всё равно может дописать уверенную деталь, которой в записи нет, например номер фонда. Ловить это придётся сверкой с тем же справочником: источник истины всё равно он, а модель добавляет недетерминизм, задержку и передачу фамилии провайдеру.
Structured output с enum закрывает «выдуманный архив»: модель может вернуть только код из списка. Но «не тот код из списка» он не закрывает. А сам выбор «место и годы → архив» — не языковая задача, а поиск по таблице. Даже при нулевой температуре ответ зависит от версии модели у провайдера, и её обновление в мой релизный цикл не входит.
Я выбрал последнюю строку таблицы. Ядро — это справочники и правила, без модели. Модель работает в трёх узких сценариях по краям, и у каждого есть детерминированный ответ на случай её отказа. Ошибка [1] в правиле воспроизводится, локализуется до строки JSON и чинится одним коммитом. Ошибка в ответе модели воспроизводится не всегда.
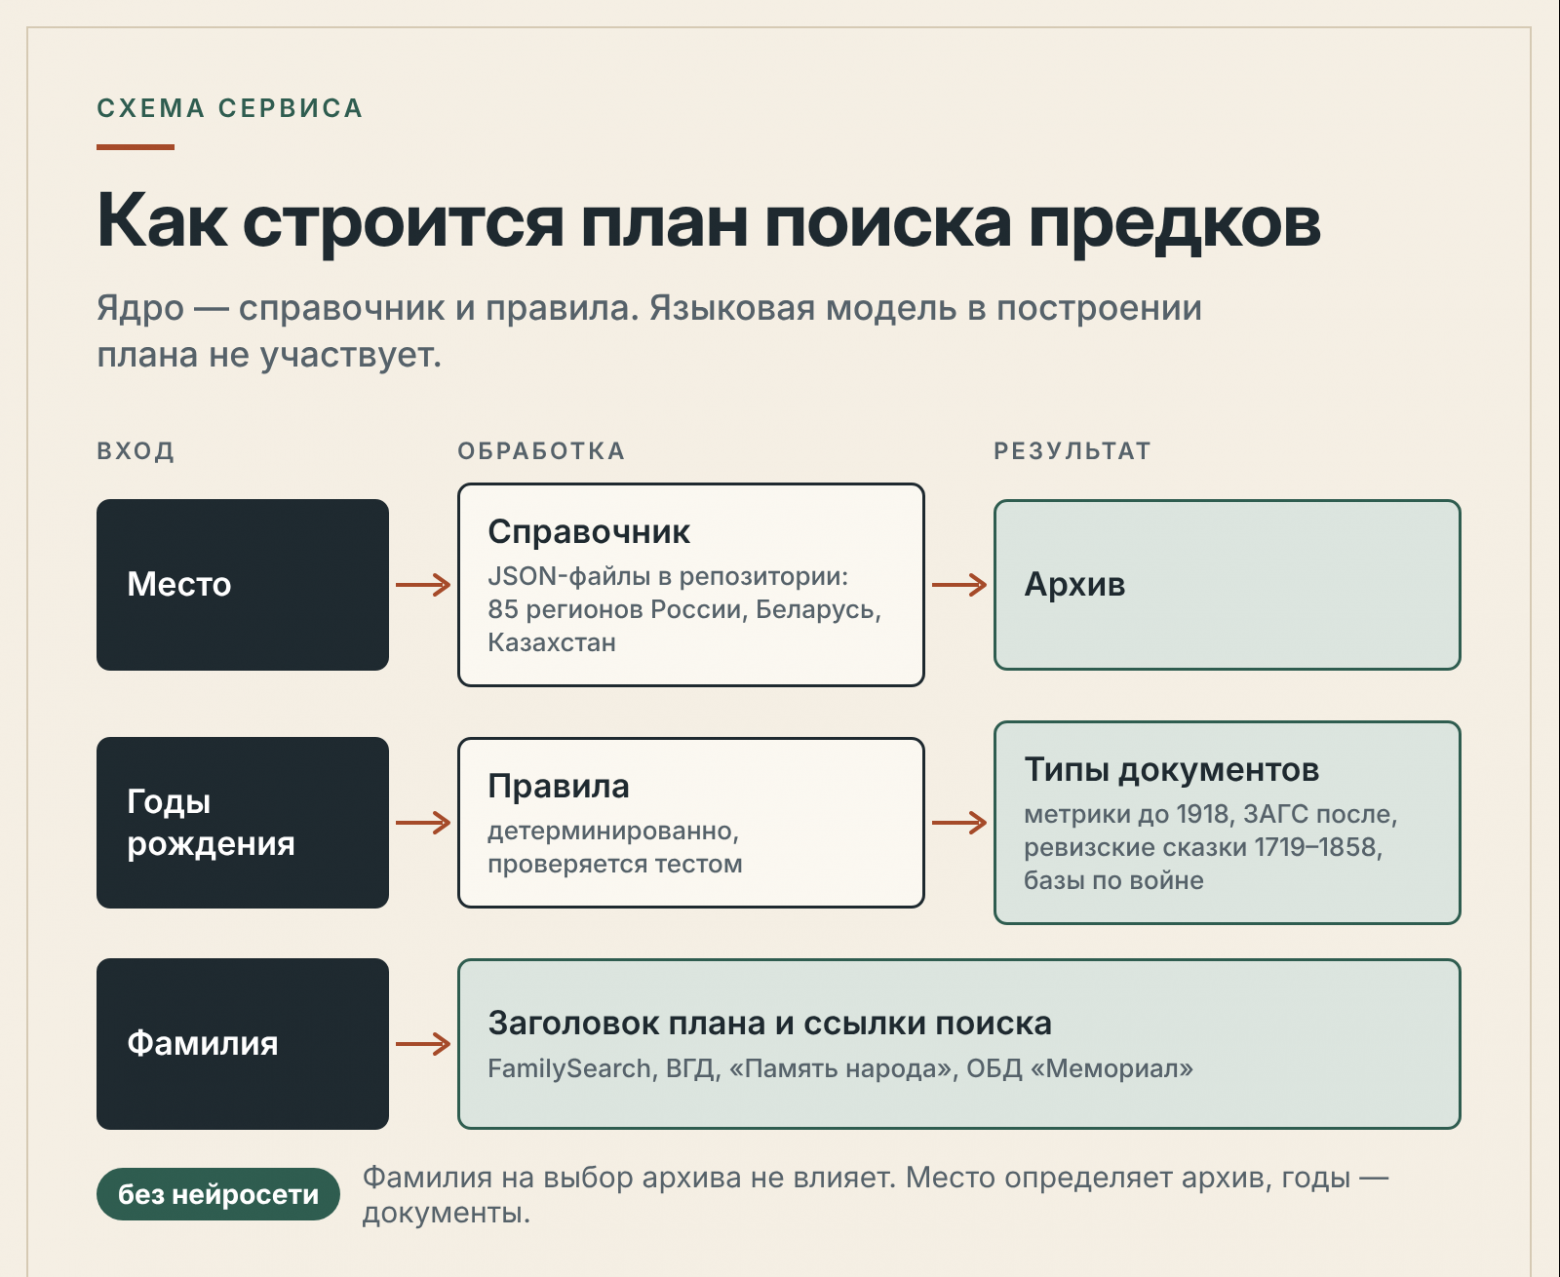
Место → справочник → архив; годы → правила → документы; фамилия → только заголовок и ссылки поиска.
Слой 1: справочник госархивов
Справочник лежит в репозитории рядом с кодом, а не в базе. Так выглядит запись, которую сервис отдаёт:
{
  "code": "RU-TAM",
  "name": "Тамбовская область",
  "aliases": ["тамбов"],
  "archive": {
    "name": "Государственный архив Тамбовской области",
    "url": "https://tambovarchiv.ru/",
    "requestInfoUrl": "https://tambovarchiv.ru/node/35",
    "verifiedFrom": "официальный сайт по поиску + проверка сайта",
    "verifiedAt": "2026-09-27",
    "evidence": "ТОГБУ "Государственный архив Тамбовской области" | Мы бережно храним историю для Вас",
    "status": "verified"
  }
}
А так — запись, которую сервис не отдаёт никогда:
"archive": {
  "name": "Центральный государственный архив Самарской области",
  "verifiedFrom": "не проверено: сайт отвечает HTTP 403 на автоматический запрос; название архива с сайта не подтверждено",
  "verifiedAt": null,
  "status": "unverified"
}
Отправной точкой стал открытый набор данных Росархива о госархивах субъектов. В нём 85 записей, по состоянию на 2019 год. Дальше каждый сайт открывался из российской сети, и запись становилась verified, только если сайт ответил 200 со штатной цепочкой TLS (или по http) и на странице было название архива. В версии справочника от 2 ноября 2026 года таких записей 59. Остальные 26 хранят название, кандидата на адрес и причину, по которой запись не подтверждена. Ни в план, ни в письмо, ни в какой другой текст для человека они не попадают. Вместо названия человек видит честную фразу: «Найдите сайт госархива региона…».
Загрузчик проверяет данные при старте, и с битым справочником сервис просто не поднимется:
// RegionalArchiveDirectory.validate, сокращено
if (archive.name() == null || archive.name().isBlank()
        || archive.url() == null || !archive.url().matches("https?://.+")
        || archive.verifiedFrom() == null || archive.verifiedFrom().isBlank()) {
    throw new IllegalStateException("Incomplete verified archive for " + region.code());
}
LocalDate.parse(archive.verifiedAt()); // иначе IllegalStateException("Bad verifiedAt …")
Самый полезный тест в этом слое краснеет просто от времени, без единой правки кода:
assertThat(ChronoUnit.DAYS.between(LocalDate.parse(archive.verifiedAt()), LocalDate.now()))
        .as("%s was checked more than a year ago - re-open the site", region.code())
        .isLessThanOrEqualTo(365);
Это неудобно, и ровно это мне и нужно. Справочник стареет, даже если его никто не трогал, и сборка напомнит об этом раньше, чем пользователь. Рядом стоит нижняя граница verified >= 59: случайная массовая правка, которая разжалует половину архивов, тоже не пройдёт молча.
Слой 2: губернии и уезды
Первая версия читала место только как современный регион, и «Ставропольский уезд Самарской губернии» уезжал в Ставропольский край. Теперь перед современным справочником стоит исторический слой. В нём 53 записи о губерниях, областях и городах, 438 уездов и уездных городов по 28 губерниям, а ещё 146 записей из разового снимка Wikidata (CC0). Записи из Wikidata нужны только для того, чтобы распознать название, своего архива у них нет. Сам сервис в Wikidata не обращается.
{
  "id": "uezd_tambovskaya_липецк",
  "kind": "uezd",
  "name": "Липецкий уезд Тамбовской губернии",
  "aliases": ["липецк* уезд", "липецк* у."],
  "regionCode": "RU-LIP",
  "archiveRegionCode": "RU-TAM",
  "archiveUntilYear": 1918,
  "archiveWhenYearUnknown": true,
  "status": "reviewed",
  "sources": ["https://ru.wikipedia.org/wiki/Тамбовская_губерния", "отчёт архивиста, п. 3.3"]
}
(Поля userNote, noteStatus и note здесь опущены.) regionCode — это где место лежит сегодня, archiveRegionCode — где искать консисторские метрики до archiveUntilYear. Псевдонимы записаны на маленьком языке. слово* означает любое окончание, =слово — слово целиком, а requires — слово, которое обязано стоять рядом: «Ставропольский уезд» относится к Самарской губернии, только если в тексте есть «самарск», «симбирск» или «оренбургск». При нескольких совпадениях побеждает более точная единица (уезд, потом город, потом губерния), затем запись с requires, затем более длинный псевдоним. Перед сравнением текст приводится к современной орфографии, потому что карточки часто переписаны с дореформенных документов:
static String fold(String text) {
    return text.toLowerCase(Locale.ROOT)
            .replace('ё', 'е').replace('ѣ', 'е').replace('і', 'и').replace('ѳ', 'ф').replace('ѵ', 'и')
            .replaceAll("ъ(?![\p{L}])", "");
}
Ключевое правило слоя: где лежат консисторские экземпляры — это данные, а можно ли назвать этот архив — решает его собственная проверка.
Optional<Region> archiveRegion = historical
        .flatMap(match -> match.archiveRegionCode(birthFrom))
        .flatMap(directory::find)
        // While the region's archive is unverified, the place's own region answers - never an unconfirmed name.
        .filter(found -> directory.verifiedArchive(found).isPresent())
        .or(() -> subjectRegion);
Пример из тестов. Бузулукский уезд Самарской губернии сегодня находится в Оренбургской области. Самарский архив в справочнике не подтверждён, поэтому план называет проверенный оренбургский архив, а не догадку про самарский.
Регион, явно выбранный в форме, исторический слой не переопределяет, и на это есть отдельный тест. В публичной форме на главной регион выбирается из списка, поэтому исторический слой работает на свободном тексте места из карточек древа.
Слой 3: правила «годы → документы»
Ядро правил помещается на экран. Сокращено: в оригинале рядом тексты карточек.
// ResearchPlanService.eras, сокращено
boolean unknown = yearFrom == null;
if (unknown || yearTo >= 1918)    eras.add(zags);            // записи ЗАГС
if (warYears)                     eras.add(war);             // 1941–1945
if (unknown || yearFrom <= 1918)  eras.add(metricBooks);     // до 1918
if (!unknown && yearFrom <= 1917) eras.add(confessionLists); // XVIII век — 1917
if (!unknown && yearFrom <= 1897) eras.add(census1897);
if (!unknown && yearFrom <= 1880) eras.add(revisionTales);   // 1719–1858
Форма на главной принимает 17 десятилетий, с 1800-х по 1960-е. Я прогнал метод краткого плана по всем семнадцати, и вот что выдаёт текущий код:
|
Десятилетие рождения |
Документы в кратком плане |
|---|---|
|
1950-е — 1960-е |
записи ЗАГС |
|
1920-е — 1940-е |
ЗАГС, Великая Отечественная |
|
1910-е |
ЗАГС, Великая Отечественная, метрические книги, исповедные ведомости |
|
1900-е |
Великая Отечественная, метрические книги, исповедные ведомости |
|
1890-е |
то же + перепись 1897 года |
|
1800-е — 1880-е |
то же + перепись 1897 года, ревизские сказки |
В кратком плане регион выбирает только архив, на набор документов он не влияет. В полном плане добавляются ещё эпохи (похозяйственные книги, Первая мировая, переписи 1926 и 1939 годов) и проверенные источники к каждой из них. Связь «эпоха → источник» тоже лежит в JSON, в поле eras, и в коде её нет.
Два независимых времени. Сначала я держал в голове одну границу, 1918 год: кто сделал запись, церковь или ЗАГС. Оказалось, что нужна вторая: кто хранит запись сейчас. Записи актов гражданского состояния сто лет лежат в органах ЗАГС и только потом уходят в госархив (143-ФЗ, ст. 77). План, который отправлял семью человека 1950 года рождения в областной госархив, посылал её туда, где записи ещё быть не может. Вторая ось — отдельная функция:
public static Placement placement(Integer yearFrom, Integer yearTo, Integer deathYear, int currentYear) {
    int horizon = horizonYear(currentYear);            // currentYear - 100
    if (yearFrom != null && yearFrom > horizon) {
        return Placement.ZAGS;                          // все записи ещё в ЗАГС
    }
    if (deathYear != null && deathYear > 0) {
        return deathYear > horizon ? Placement.ARCHIVE_THEN_ZAGS : Placement.ARCHIVE;
    }
    if (yearTo != null && yearTo > horizon - LIFETIME_YEARS) {
        return Placement.ARCHIVE_THEN_ZAGS;             // рождение в архиве, брак или смерть могут быть в ЗАГС
    }
    return Placement.ARCHIVE;
}
Дальше решения, которые видны в таблице, и их цена.
-
1910-е: ЗАГС и метрики вместе. Граница проходит внутри десятилетия, а форма принимает десятилетие, а не год. К тому же сама граница условна: декрет о книгах актов гражданского состояния вышел в декабре 1917 года, кодекс — осенью 1918-го, и часть церковных книг тех лет оказалась в архивах ЗАГС. Показать оба источника дешевле, чем угадать не тот.
-
1870-е и 1880-е: ревизские сказки. Ревизий было десять, с 1719 по 1858 год (последняя шла в 1857–1859 годах). Самого человека в них нет, зато могут быть его родители, и текст карточки говорит именно это. Правило сознательно щедрое: лишняя строка обходится дешевле пропущенного источника.
-
Военный блок. До 4 ноября блок показывался рождённым в окне 1875–1927 годов. Сейчас условие одно: год рождения не позже 1945-го или неизвестен. Текст карточки при этом не утверждает, что человек воевал: «Если ваш родственник мог участвовать в войне или работал в тылу…». Правка уместилась в одну строку:
-        return yearFrom == null || (yearTo >= 1875 && yearFrom <= 1927);
+        return yearFrom == null || yearFrom <= LAST_WAR_BIRTH_YEAR;
У этого решения есть цена: у правила нет нижней границы, и предку 1820-х строка о войне не нужна. Это осознанный размен по той же асимметрии ошибок: лишнюю строку человек пропустит за секунду, а пропущенный блок может стоить семье наградного листа. Точнее отсекать шум можно по году смерти, который в полном плане часто известен: умерший до 1941 года в войне участвовать не мог. Это следующая правка правила.
-
1900-е: в списке эпох нет ЗАГС. Правило эпох смотрит только на год рождения. Брак человека 1900-х скорее всего пришёлся на годы после 1918-го и записан уже в ЗАГС. В плане после входа вторая ось это частично закрывает:
ARCHIVE_THEN_ZAGSдобавляет в чек-лист шаг «Органы ЗАГС: поздние записи о браке и смерти». В кратком плане этого шага нет, и это первый кандидат на правку.
Таблица как спецификация
Тесты на правила есть: границы каждой эпохи из полного плана, маршрутизация уездов от начала до конца, отдельный тест военного блока на годы 1850, 1874, 1928, 1935, 1945 и null. Но одного golden-теста на всю таблицу выше в репозитории пока нет. Вот как я бы его закрепил. Это предложение, а не существующий код:
// Предложение: такого теста в репозитории пока нет.
@ParameterizedTest(name = "{0}-е → {1}")
@CsvSource(delimiter = '|', textBlock = """
    1960 | zags
    1950 | zags
    1940 | zags,war
    1930 | zags,war
    1920 | zags,war
    1910 | zags,war,metric_books,confession_lists
    1900 | war,metric_books,confession_lists
    1890 | war,metric_books,confession_lists,census_1897
    1880 | war,metric_books,confession_lists,census_1897,revision_tales
    1870 | war,metric_books,confession_lists,census_1897,revision_tales
    1860 | war,metric_books,confession_lists,census_1897,revision_tales
    1850 | war,metric_books,confession_lists,census_1897,revision_tales
    1840 | war,metric_books,confession_lists,census_1897,revision_tales
    1830 | war,metric_books,confession_lists,census_1897,revision_tales
    1820 | war,metric_books,confession_lists,census_1897,revision_tales
    1810 | war,metric_books,confession_lists,census_1897,revision_tales
    1800 | war,metric_books,confession_lists,census_1897,revision_tales
    """)
void teaserErasByDecade(int decade, String expected) {
    Teaser teaser = service.teaser("Иванов", decade, "RU-TAM");
    assertThat(teaser.eras()).extracting(Era::code).containsExactly(expected.split(","));
}
Его ценность видна на правке военного блока: в диффе изменились бы девять строк: 1930-е и 1940-е получили войну, и семь десятилетий с 1800-х по 1860-е тоже. Ревьюер увидел бы это решение целиком, до выката, а не по одной строке условия. С ответом модели так не выйдет: тест на «примерно правильный текст» либо флапает, либо ничего не проверяет.
Где модель есть и почему она не может назвать архив
Все сценарии ИИ перечислены в одном реестре: модель, лимит входа в символах, лимит ответа в токенах, таймаут. Плана касаются три:
add(new Scenario("plan_place",    ModelTier.LITE, 3000,  40,  5, false, false, Set.of()));
add(new Scenario("plan_explain",  ModelTier.LITE, 2400, 220,  8, false, false, Set.of()));
add(new Scenario("letter_assist", ModelTier.LITE, 3200, 420, 10, true,  false, Set.of()));
Все три работают на YandexGPT 5 Lite через Yandex AI Studio. Каждый включается своим флагом, и без них план собирается так же: ядро о модели не знает.
plan_place: модель как классификатор в закрытый список. Это единственное место, где модель касается географии, и только потому, что вход — свободный текст: опечатки, старые названия, «с. Покровское Ряжского у.». Сначала идёт цепочка без модели: справочник регионов и стран, словарь исторических названий, регион, который эта семья уже подтверждала для такого написания, общий кэш. Модель вызывается последней, видит только текст места и отвечает по схеме:
{"type": "object", "required": ["code", "confidence"],
 "properties": {
   "code":       {"type": "string", "enum": ["AD", "AL", "BA", "…", "unknown"]},
   "confidence": {"type": "string", "enum": ["high", "low"]}}}
Enum — это коды из справочника. Схеме я тоже не доверяю, поэтому ответ перепроверяется:
String code = shortCode(node.path("code").asText("").trim());
if (!UNKNOWN_CODE.equals(code) && !offeredCodes.contains(code)) {
    return Optional.empty();
}
Ответ модели — только предложение. Человек видит вопрос, и регион применяется к плану после его «Да». Кэшируется только high, а подсказку, которую семьи отклонили три раза (и чаще, чем приняли), больше не предлагают. Архив по-прежнему берётся из справочника по коду.
plan_explain: название вставляет сервер. Модель объясняет простыми словами, почему следующий шаг именно такой. Название архива ей писать запрещено, вместо него она ставит плейсхолдер:
"Название архива или базы не пиши — вместо него один раз поставь {ИСТОЧНИК}, сервер подставит проверенное название, "
        + "но только если ниже сказано, что источник есть."
Это правило появилось после живого прогона: Lite сама написала «национальные архивы Казахстана» и поставила {ИСТОЧНИК} там, где у сервера проверенного источника не было. Такой ответ сервер отклоняет.
letter_assist: два блока в готовое письмо. Письмо в архив собирает детерминированный код. Модель добавляет в него «Что известно о человеке» из фактов древа и формулировку просьбы. Адрес, название архива и номер фонда она не пишет, имён людей, которые могут быть живы, не видит. Если в письме не найдено место для вставки, возвращается исходное письмо: собранное наполовину письмо в архив хуже простого.
Ответ модели — недоверенный ввод. Все сценарии, которые ссылаются на факты, проходят через один валидатор с десятью правилами (V1–V10). Каждая строка ответа обязана сослаться на источник из блока данных. Каждое трёх- или четырёхзначное число в ней должно стоять в процитированном источнике:
// V3: every 3-4 digit number must stand in a cited source.
Matcher numbers = NUMBER.matcher(body);
while (numbers.find()) {
    if (!citedNumbers.contains(numbers.group())) {
        failed.add(Rule.V3_NUMBERS);
        break;
    }
}
То же правило действует для слов с заглавной буквы в середине фразы, то есть для имён и мест. Строка, нарушившая любое правило, выбрасывается. Если выброшено больше половины строк, весь ответ заменяется детерминированным шаблоном.
Регресс промптов. Офлайн-набор прогоняет сценарии на записанных ответах. Ключ записи включает модель, оба промпта и JSON-схему, поэтому любая правка промпта роняет набор с сообщением «промпт изменился, перезапишите». Так каждая правка промпта проходит ревью. Честная оговорка: сейчас эти записи написаны руками, а не сняты с модели. Рядом лежит набор заведомо плохих ответов, на котором проверяется сам валидатор. Живые прогоны идут отдельно, и выводы из них оседают в тексте промптов.
Провайдер вызывается с заголовком x-data-logging-enabled: false и нативным полем jsonSchema. В политике сервиса отдельно записано, что семейные материалы и персональные данные не используются для обучения [2] моделей.
Побочный эффект архитектуры касается приватности. В пути построения плана нет ни модели, ни исходящих HTTP-запросов: ссылки на внешние базы — это просто URL, которые открывает человек. Значит, фамилию незачем отправлять провайдеру. В публичной форме она едет в теле POST, а не в адресе, и не попадает в журнал доступа.
Попутно: SPA, noindex и Disallow
Раньше nginx отдавал оболочку SPA на любой неизвестный адрес. Каждая ссылка-приглашение /invite/<id> и каждая страница заказа /order/result/<id> отвечали 200 с title, description и canonical главной. Для поисковика это бесконечное множество дублей.
Несуществующий адрес теперь получает настоящий 404, но с телом оболочки, чтобы клиентский роутер отрисовал свою страницу:
location / {
    try_files $uri$br_page $uri.html$br_page $uri $uri.html $uri/ =404;
    error_page 404 @not_found_shell;   # без "=": код 404 сохраняется
}
location @not_found_shell {
    add_header X-Robots-Tag "noindex" always;
    try_files /404.html /app-shell.html;
}
Если в error_page поставить =, nginx возьмёт код ответа из именованного location, то есть 200, ведь /404.html существует.
Служебные маршруты отвечают 200 с X-Robots-Tag: noindex, nofollow. Здесь вторая ловушка. Последний аргумент try_files — это внутренний редирект, и после него заголовки исходного location уже не действуют. Поэтому заголовок продублирован в location самой оболочки:
location ~ ^/(?:auth|login|register|forgot-password|reset-password|payments|onboarding|invite|referral|order|branch)(?:/|$) {
    add_header X-Robots-Tag "noindex, nofollow" always;
    try_files $uri $uri.html /app-shell.html;
}
location = /app-shell.html {
    # try_files internally redirects here; headers from the original location no longer apply.
    add_header X-Robots-Tag "noindex, nofollow" always;
    # …
}
Теперь о конфликте [3], который у меня остаётся. Те же маршруты закрыты в robots.txt через Disallow. Google прямо пишет, что noindex работает, только если страница не закрыта в robots.txt: иначе робот не скачает её и заголовка не увидит. URL, найденный по внешней ссылке, может остаться в индексе без сниппета. Для новых адресов меня это устраивает: их просто не будут обходить. Если персональные адреса уже попали в индекс, порядок другой: временно снять Disallow, отдавать noindex, дождаться выпадения и только потом закрыть обратно. Для Яндекса стоит ещё одна строка, без которой каждый клик из рекламы порождает новый адрес в индексе:
Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term&yclid&gclid&_openstat&from&partner&ref&returnToОграничения, о которых я знаю
-
Одна граница года на запись, а не интервалы. Ставрополь-на-Волге был в Оренбургской губернии в 1744–1796 годах, в Симбирской в 1796–1851-м, в Самарской с 1851-го. Метрики до 1851 года нужно искать в архиве Симбирской консистории. Запись в справочнике так и говорит, что слой пока не различает дату события.
-
Уезд привязан к региону, где сегодня его центр. Уезд, который разошёлся по двум областям, для окраинных сёл даёт не тот регион. В карточке метрик есть предупреждение: «Если село раньше относилось к другой губернии, часть документов может храниться в архиве соседней области».
-
«Губернский город = архив консистории» — это эвристика. Границы епархий и губерний в основном совпадали, но не везде. Фонд консистории назван только там, где у него есть источник: для Москвы это ф. 203 ЦГА Москвы, сверенный по каталогу архива.
-
«Проверено» у общероссийских источников слабее, чем у архивов. У 38 из 52 источников стоит
verified, но это HTTP 200 наcurl -I -Lс машины вне России. В самом файле записано, что каждую запись нужно перепроверить из российской сети, и для этого есть скрипт. -
Записанные ответы модели пока написаны руками. Набор регресса ловит изменение промпта, но не дрейф модели.
Что бы я сделал иначе
-
Интервалы с первого дня. Вместо пары
archiveRegionCode/archiveUntilYearхранить список{regionCode, from, to}. Миграция одной записи на интервалы дешевле, чем объяснять пользователю, почему метрики 1840 года ищут не там. -
Сначала golden-таблица, потом правила. Таблица из семнадцати строк — лучший документ о продукте, который у меня есть. Её стоило написать до первой строчки
eras(). -
Автоматическая перепроверка из российской сети. Тест свежести говорит, что запись устарела, но перепроверку пока делает человек.
Стек, чтобы не спрашивали: фронтенд — React 18 и Vite 6, публичные страницы пререндерятся при сборке. Бэкенд — Java 17 и Spring Boot 3.5, PostgreSQL. Всё в Docker Compose в Yandex Cloud: снаружи Caddy, в контейнере фронтенда nginx.
Итог короткий. Модель хорошо пишет текст и плохо держит факты, которые меняются: названия архивов, их сайты, границы уездов. В генеалогии важна именно вторая часть. Поэтому факты лежат в справочнике, который правит человек через PR, а модель работает там, где её ответ либо выбирается из закрытого списка, либо проходит через валидатор, а человек читает результат до того, как им воспользоваться.
Сервис называется Heritage AI, краткий план строится без регистрации: heritageai.ru [4]. Попробуйте сломать его на своём регионе и напишите в комментариях, где справочник ошибся. Особенно нужны места, где документы части бывшего уезда лежат в архиве соседней области: на реальных примерах проще спроектировать интервалы.
Автор: Zakharden
Источник [5]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38206
URLs in this post:
[1] Ошибка: http://www.braintools.ru/article/4192
[2] обучения: http://www.braintools.ru/article/5125
[3] конфликте: http://www.braintools.ru/article/7708
[4] heritageai.ru: https://heritageai.ru/?utm_source=habr&utm_medium=article&utm_campaign=no-llm
[5] Источник: https://habr.com/ru/articles/1105164/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1105164
Нажмите здесь для печати.