Бот уже отвечает. А продукт где? История разработки сервиса с ИИ
Друг принёс мне работающего Telegram-бота. Он сам много публикует короткие видео и заметил интересную вещь: один и тот же ролик может набрать совершенно разное количество просмотров.
Например, снял хороший ролик, выложил в пробный режим Instagram — 300 просмотров. Архивировал, выложил снова — 200. А с третьей попытки тот же ролик набрал 50 тысяч.
Само видео не изменилось. Просто в третий раз оно попало к аудитории, которой оказалось интересно. Пробный режим позволяет показывать ролики новой аудитории, но заранее угадать результат невозможно.
Отсюда и идея: дать хорошему ролику больше попыток найти своего зрителя. Но вручную перезаливать одно и то же видео десять раз неудобно. К тому же Instagram может распознать повторную публикацию и ограничить её распространение.
Для этого и существуют уникализаторы — инструменты, которые немного меняют параметры видео, сохраняя его содержание. Это не генерация роликов нейросетью: исходное видео человек снял сам, а программа лишь готовит его варианты для повторной публикации.
Так появился UNIQ. Присылаешь свой ролик в Telegram, выбираешь одну, пять или десять версий и получаешь готовые файлы для публикации в Reels, Shorts или TikTok. Не нужно открывать редактор и отдельно возиться с каждой копией.
Прототип уже работал. Оставалось, как нам тогда казалось, арендовать сервер, подключить оплату и запустить продажи. Но быстро выяснилось, что готовое видео ещё не означает готовый сервис. Сначала закончилось место на диске, потом появились вопросы с параллельными пользователями, очередью и восстановлением заказов после сбоев.
Сейчас UNIQ [1] работает на шести VPS. Через собственную панель управляем базой, мониторингом и обновлениями.
Далее расскажу, как мы прошли путь от прототипа, написанного с помощью ИИ, до работающего сервиса и какие проблемы пришлось решать по дороге.
Друг принёс вайбкод. Вайбкод даже работал
Прототип друг собрал с помощью ИИ. Он не программист, но смог довести идею до рабочего результата. Уже можно было отправить исходник, получить обработанное видео и понять, что именно мы собираемся продавать. Внутри были Python, FFmpeg и SQLite. Для проверки идеи этого вполне хватало.
Начали готовить приложение к Ubuntu, большим файлам и размещению на VPS. ИИ быстро писал необходимый код, а мы проверяли его через настоящий Telegram. Для больших файлов подняли собственный Local Bot API [2]. Сам бот пока работал на моём Mac. Вскоре он прислал сообщение:
На сервере недостаточно свободного места. Попробуй позже.
При этом «сервер» стоял передо мной на столе.
Оказалось, что для одного заказа одновременно нужны исходник, временные файлы и готовые копии. При загрузке видео до 150 МБ это уже заметный расход диска. Добавили расчёт необходимого места и очистку файлов после обработки. Теперь проверяли не только то, что FFmpeg может создать копию, но и то, что заказ полностью выполняется, а временные файлы потом удаляются.
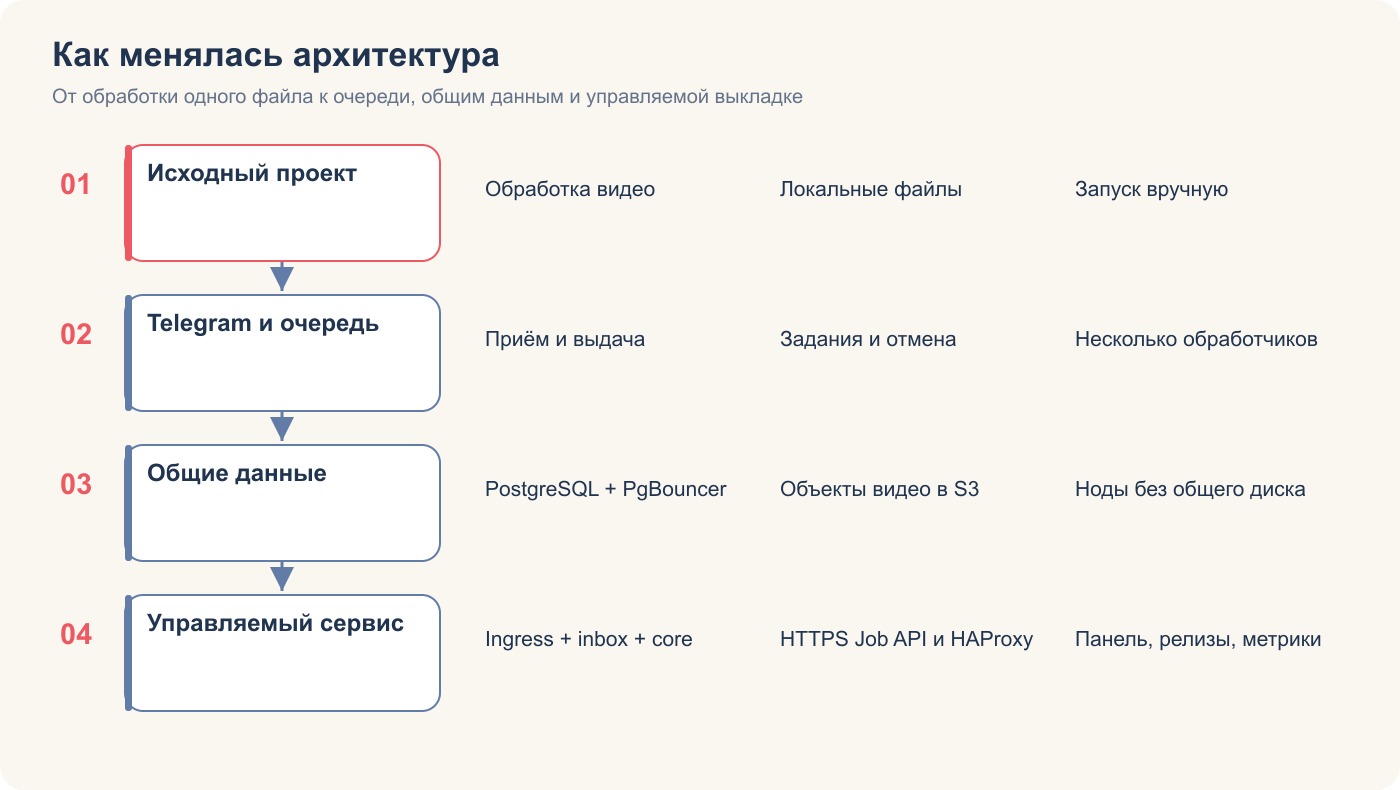
Следующей проблемой стала параллельная работа. Представим двух пользователей. Первый отправил ролик, и FFmpeg начал обработку. Второй в это время открывает меню, меняет настройки и отправляет своё видео. Его действия не должны зависеть от чужого заказа. При этом несколько нажатий одного пользователя не должны выполняться в неправильном порядке.
На этом этапе стало понятно, что одного работающего сценария недостаточно. Пришлось разбираться с блокировками, состоянием пользователей и параллельным выполнением задач. Переписывать всё на Go не стали. Основную тяжёлую работу всё равно выполнял отдельный процесс FFmpeg, а смена языка не решила бы проблему общих блокировок и не добавила процессорных ядер.
Вместо этого разделили сетевые операции, работу с базой и кодирование видео. Так мы пришли к очереди заданий.
У одного ролика оказалось слишком много состояний
В прототипе использовалась SQLite. Несколько процессов могут работать с ней, но запись в один файл выполняется последовательно. Теперь нам нужно было распределять задания между разными VPS и сохранять подтверждение заказа вместе с резервированием монет в одной транзакции. Использовать для этого общий SQLite-файл по сети не хотелось.
Выбрали PostgreSQL: общая база, конкурентные транзакции и блокировки строк. При этом сама замена базы ничего не гарантировала. Нужно было отдельно обеспечить два условия: задание с действующей арендой не должно выдаваться другому обработчику, а повторное нажатие пользователя не должно дважды резервировать монеты.
SQLite полностью не убрали. В панели она осталась для локального инвентаря. Просто для разных задач оказались нужны разные способы работы с данными. Подробнее об этом есть у авторов SQLite [3].
Дальше разобрали сценарий с заказом из пяти копий. Обработчик A (worker) забрал заказ, создал и сохранил первую копию и завис. В базе у задания остались фаза encode и состояние running. Пользователь ждёт результат. Нам нужно понять, можно ли передать оставшуюся работу другому обработчику и что делать, если первый внезапно оживёт. Для проверки в тестах принудительно завершали обработчик.
Для этого ввели lease — ограниченный срок владения заданием. Пока обработчик работает, он продлевает lease. Если срок истёк, заказ может забрать другой обработчик. При выдаче заданий используем FOR UPDATE SKIP LOCKED [4], чтобы не ждать занятые строки. Истечение lease проверяется отдельно.
Допустим, обработчик B уже забрал заказ, а A восстановился и тоже пытается сохранить результат. Поэтому при выдаче задания обработчик получает токен владельца. Каждое изменение состояния проверяет токен и срок lease. Если полномочия A закончились, изменить заказ он уже не сможет.
План эффектов сохраняем заранее. Готовые копии фиксируем через checkpoint — точку, с которой можно продолжить работу. В нашем примере B находит первую готовую копию и обрабатывает оставшиеся четыре, не выбирая эффекты заново.
Есть и другой сценарий: B отправил API сообщение о завершении операции, но ответ потерялся. Обработчик повторяет запрос с тем же идентификатором и получает сохранённый receipt — результат уже выполненной операции. В итоге получились четыре механизма:
-
lease ограничивает срок владения заданием
-
токен не позволяет старому обработчику изменить состояние
-
checkpoint позволяет продолжить обработку
-
receipt защищает от повторного выполнения операции
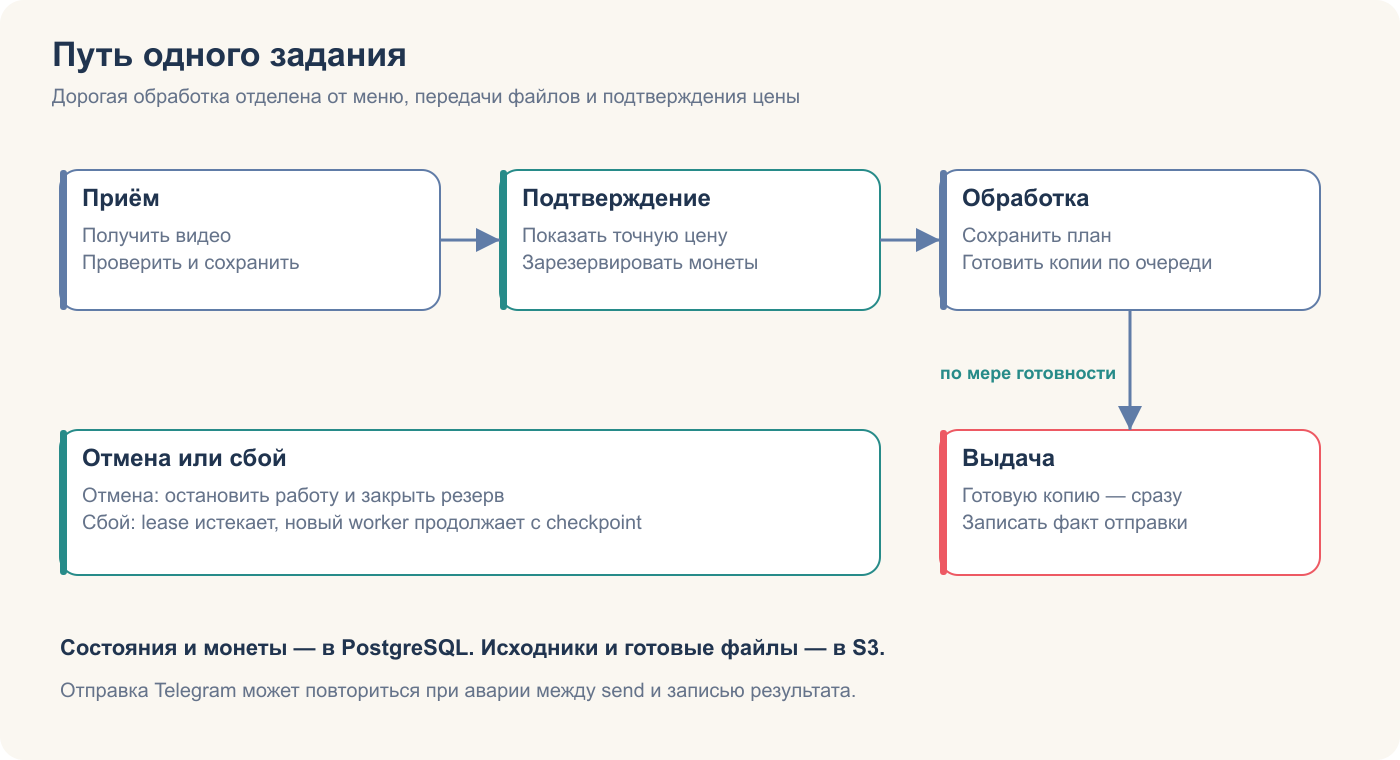
После восстановления занялись отменой заказов. Просто поставить флаг отмены недостаточно. Нужно остановить кодирование, дождаться завершения дочернего процесса и фоновых файловых операций, а уже потом закрывать задание и удалять файлы. Иначе можно получить ситуацию, когда один процесс удаляет папку, а другой ещё пытается записать в неё результат.
С Telegram осталась отдельная проблема. Файл мог успешно отправиться пользователю, но запись об отправке не успевала сохраниться. После восстановления последняя копия в таком случае может прийти повторно. Внутри системы мы можем обеспечить идемпотентность операций, но гарантировать exactly-once для внешнего Telegram API не можем.
Когда эти сценарии стали стабильно проходить тесты, можно было переходить к оплате.
«Просто монетки» оказались маленькой бухгалтерией
Изначально обработка должна была быть бесплатной. Потом появились стартовые монеты, рефералы, ручные начисления и покупки. Каждое начисление решили хранить отдельной партией со своим сроком действия. У купленных монет одни условия, у бонусных — другие. Покупка может продлить срок действующих купленных остатков. Кошелёк должен помнить условия на момент начисления, а не пересчитывать старые монеты по текущему тарифу.
На первый взгляд хватило бы поля balance и нескольких дат. Но проблемы начинаются при отмене заказа. В какую партию возвращать монеты? Какой срок действия у них должен быть? Если при каждой отмене начинать срок заново, монеты можно продлевать бесконечно.
Поэтому появились партии, резервы и история операций. Возьмём условный пример, не действующий прайс. У пользователя 50 монет, одна копия стоит 4. Он заказывает пять копий, и система резервирует 20 монет. Свободными остаются 30.
Две копии отправлены, после чего пользователь отменяет заказ. За готовые копии списываем 8 монет, оставшиеся 12 освобождаем из резерва. В результате доступно 42 монеты, резерв равен нулю. При этом сроки действия монет не меняются.
Если в резерв попали монеты из нескольких партий, неиспользованные возвращаются в исходные партии с прежними сроками. Цена заказа тоже фиксируется при подтверждении. Администратор может изменить тариф, но это не должно влиять на уже принятые заказы.
Отдельно проверяли повторные действия. Два нажатия не должны создавать два резерва. Повторный вход не должен выдавать приветственный бонус ещё раз. Изменение размера подарка не должно менять старые начисления. Реферальные условия и суточные лимиты вынесли в настройки.
Для кнопок подтверждения сохраняем параметры заказа, цену, версию тарифа, срок действия и токен. Если пользователь нажмёт вчерашнюю кнопку, система не должна незаметно оформить заказ по новой цене.
Параллельно пришлось упрощать интерфейс. Пока добавляли настройки, меню становилось всё длиннее. В итоге оставили основной путь: видео, расчёт стоимости, подтверждение. Дополнительные параметры перенесли в «Подробнее». Добавили историю заказов и возможность повторно получить готовый результат без нового списания.
С покупками возникли похожие вопросы. Платёжное уведомление может прийти дважды, потеряться или прийти уже после отключения продаж. Повторное событие не должно повторно начислять монеты. Параметры покупки фиксируются, у внешней транзакции есть уникальный ID, а начисление сохраняется вместе с платежом. Пропущенные события восстанавливаем через сверку.
Добавили Telegram Stars, ЮKassa и GetPlatinum, возвраты и сверку платежей. Интеграция, тестовая операция и реальная оплата учитываются отдельно. Реквизиты профилей зашифрованы, ключ хранится вне базы. Монеты, рубли, Stars и доход продавца считаются раздельно. Для цифровых услуг внутри Telegram действуют правила оплаты в Stars [5].
В процессе работы над оплатой заметили ещё одну проблему. Бот создавал пять копий, но отправлял их только после завершения всего заказа. Первая копия могла быть готова уже давно, а пользователь продолжал ждать. Разделили кодирование и отправку. Теперь worker сохраняет готовую копию и checkpoint, после чего шлюз сразу отправляет файл пользователю.
В реальном Telegram-тесте копии пришли примерно через 40, 70, 105, 136 и 171 секунду. Первый результат пользователь получил на 131 секунду раньше завершения всего заказа. Сама обработка быстрее не стала, но ждать все пять файлов больше не нужно.
Отмена теперь учитывает уже отправленные копии и останавливает оставшуюся работу. Это результат одного ролика на локальном стенде, а не гарантированная скорость на любом VPS. Но для пользователя изменение оказалось заметным.
«Серверы мы обеспечим». А что нужно обеспечить в коде
Когда начали планировать дополнительные серверы, первым делом пришлось убрать зависимость от локальных файлов. Если исходник лежит на одной VPS, обработчик на другой машине не сможет его открыть. Видео перенесли в S3. В PostgreSQL оставили ключи объектов, размеры, SHA-256 и состояния.
Worker скачивает исходник в папку своей попытки обработки, создаёт копии и публикует результаты. Добавили проверку целостности, атомарную публикацию и очистку после сбоев. Готовые видео проверяли через ffprobe и полное декодирование FFmpeg.
Чтобы ограничить число соединений с PostgreSQL при росте числа процессов, поставили PgBouncer. На тестовом стенде до 2000 клиентских подключений используют максимум 10 серверных соединений без дополнительного резерва. Это не означает, что PostgreSQL одновременно выполняет 2000 SQL-запросов.
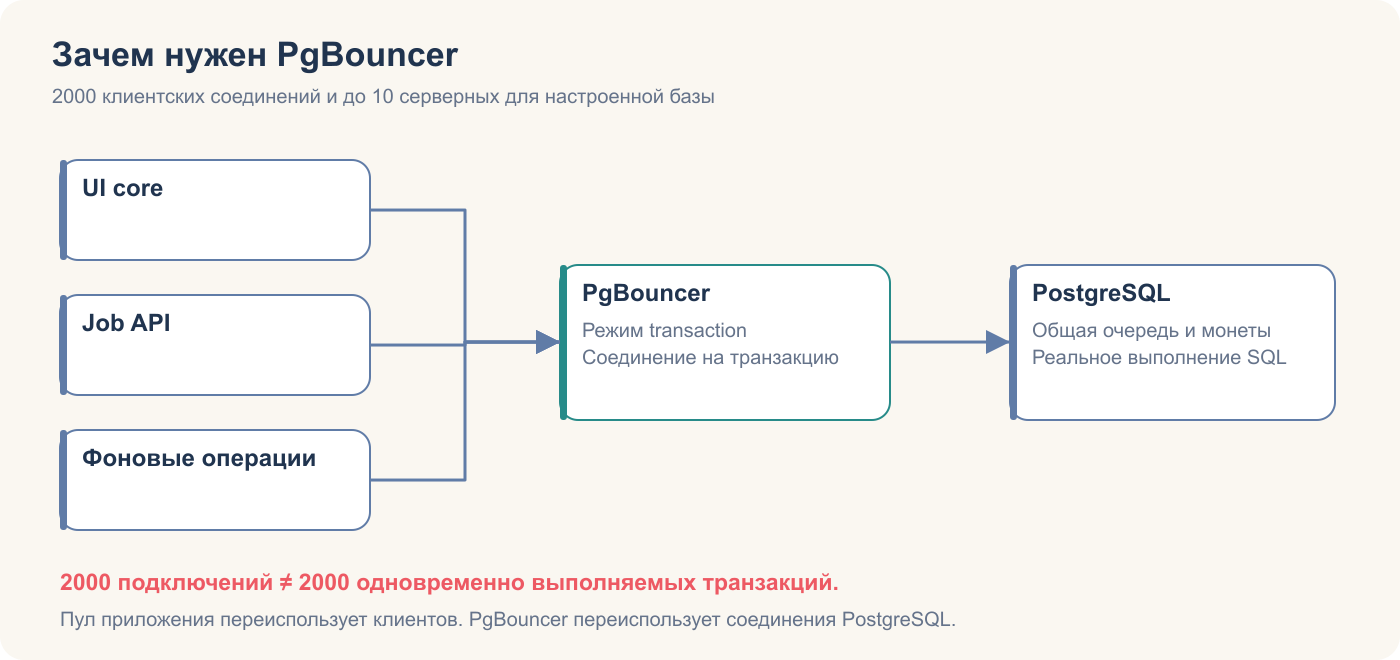
Пул приложения переиспользует клиентские соединения, а PgBouncer выдаёт соединения с PostgreSQL на время транзакции [6]. Сетевые операции вынесли за пределы SQL-транзакций. Соединения с базой не должны простаивать в ожидании Telegram.
Как не занимать базу ожиданием работы
Даже пустая очередь создаёт нагрузку, если все worker постоянно проверяют наличие заданий. В Job API добавили long polling. HTTP-запрос может ждать появления работы, не удерживая SQL-соединение. Обработчики, ожидающие одну фазу, используют общую проверку готовности. Пробуждение означает только то, что стоит попробовать забрать задание. Сам захват всё равно выполняется транзакционно.
Периодические проверки оставили на случай пропущенных уведомлений. Старый API продолжает работать через обычный polling. Для продления lease и сохранения checkpoint выделили отдельный запас HTTP-потоков, чтобы ожидание новых заданий не мешало уже запущенным.
Сначала отправили волну из 1000 подтверждений заказов и измерили общее время выполнения. Получили 5,9 секунды. При этом суммарное ожидание одного вида SQL-блокировки составило около 40 секунд. Причина оказалась в общем исключительном lock, который брали заказы и настройки разных пользователей. То есть приложение выполняло запросы параллельно, но многие из них ждали одну и ту же блокировку.
Разделили операции по пользователям, сохранив общую защиту там, где она действительно нужна. На том же стенде 1000 подтверждений завершились за 3,2 секунды вместо 5,9. Это время обработки всей волны подтверждений, а не кодирования видео.
Полный COUNT очереди при каждой загрузке заменили транзакционным учётом свободных мест. При откате место освобождается, при завершении не освобождается повторно. Убрали повторную запись регистрации при каждом нажатии кнопки. Индексы добавляли под конкретные запросы, проверяя планы выполнения.
Под нагрузкой обнаружилась ещё одна проблема: ответ на нажатие кнопки иногда приходил слишком поздно, и Telegram переставал его принимать. Пользователь видел крутящийся индикатор и не понимал, произошло ли что-нибудь. Поэтому подтверждение получения нажатия для основных кнопок стали отправлять до бизнес-проверок в БД. Это подтверждение означает только «нажатие получили», а не «заказ оплачен». Резервирование и списание денег по-прежнему проходят все проверки, а итоговый результат появляется в карточке.
Пробовали увеличить пул приложения с 8 до 16 соединений, оставив лимит PgBouncer равным 10. Подтверждения быстрее не стали, зато выросло ожидание у пулера. Узкое место просто переместилось. Размеры пулов нужно подбирать по реальной нагрузке, а не увеличивать наугад.
В тесте использовали 20 роликов размером 720×1280, длительностью три секунды, 25 FPS, со звуком. Для каждого создавалась одна копия. Виртуальной машине были доступны 5 CPU. FFmpeg, PostgreSQL и S3 использовались настоящие, а Telegram заменили локальным приёмником.
|
Обработчиков |
Время волны |
Заданий в минуту |
Пик RAM |
|---|---|---|---|
|
2 |
78,14 с |
15,36 |
644 МиБ |
|
4 |
45,22 с |
26,54 |
1166 МиБ |
|
5 |
41,20 с |
29,13 |
1419 МиБ |
|
6 |
42,43 с |
28,28 |
1691 МиБ |
|
8 |
41,26 с |
29,08 |
2168 МиБ |
|
12 |
44,51 с |
26,96 |
3133 МиБ |
После четырёх-пяти обработчиков производительность практически перестала расти. Двенадцать процессов использовали заметно больше памяти [7], но выполняли меньше работы, чем пять. Эти цифры относятся к коротким роликам и машине с пятью CPU. Для длинных видео в 1080p результаты будут другими. По ним также нельзя напрямую рассчитывать количество пользователей.
Отправили 10 000 первых обращений через настоящий код и базу, но с имитацией Telegram. Вся волна завершилась примерно за 30 секунд. p95 времени готовности экрана тоже оказался около 30 секунд. Для повторных обращений волна заняла около 16 секунд. Ошибок не было, но для пользователя полминуты ожидания — плохой результат. Важно, что это не 10 000 настоящих Telegram-сессий и не 10 000 одновременно кодируемых роликов.
Дополнительные FFmpeg-процессы здесь не помогли бы. Поэтому выделили единый приёмник Telegram-событий (ingress) и общую очередь (inbox) в PostgreSQL. Сначала событие сохраняется, после чего его забирает один из core. Получение обновления подтверждаем Telegram после сохранения. Внутри одного пользователя порядок событий сохраняется, а разные пользователи могут обрабатываться параллельно.
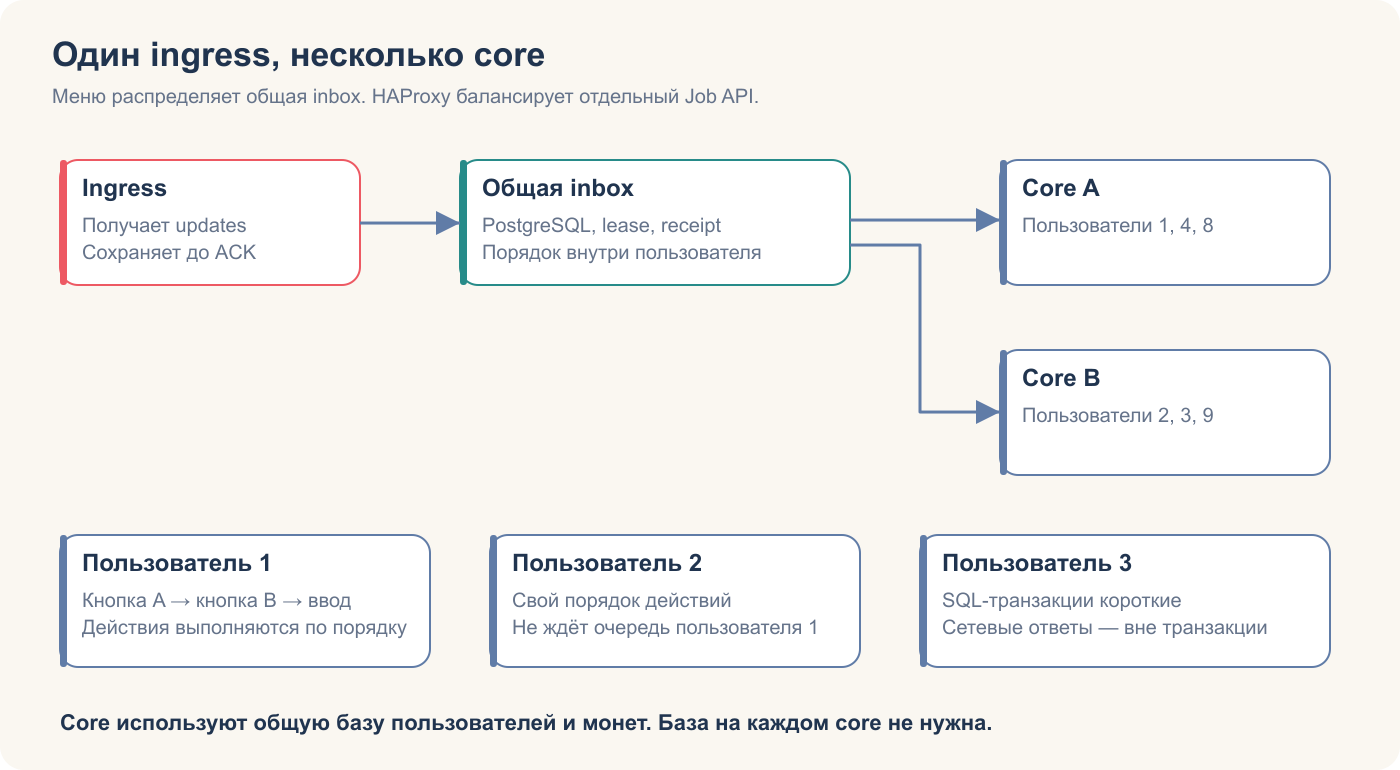
Состояние форм тоже перенесли в общую базу. Теперь ввод на core A не теряется, если подтверждение обрабатывает core B. HAProxy балансирует Job API и исключает неготовые экземпляры. Периодические задачи оставили одному scheduler с проверкой владения, чтобы при добавлении новых core не запускать несколько одинаковых сверок и уведомлений.
Для операций из журнала шагов обработчика сохраняем результаты. Если процесс завершился после изменения заказа, повторное событие использует уже записанный результат и состояние диалога. Идентификатор шага проверяется. Если продолжение несовместимо, выполнение останавливается, а не использует результат другой операции. Внешняя отправка сообщения в этот журнал не входит и после аварии может повториться.
Распределение событий и порядок действий проверили, но сопоставимого нагрузочного теста после перехода на inbox пока нет. Поэтому прежние 30 секунд относятся к ранней версии. Утверждать, что новая схема уже обеспечивает быстрый ответ для 10 000 активных пользователей, было бы неправильно.
После этих изменений добавление нового сервера стало технически понятной задачей. Оставалось решить, где размещать разные части системы.
Где жить сервису и что нужно перевозить за границу
При выборе размещения выяснилось, что основной регион может не иметь прямого доступа к Telegram. Переносить из-за этого всю систему в другой регион не хотелось. Local Bot API и файловый шлюз выделили в отдельные роли, которые можно разместить там, где Telegram доступен. Базу и FFmpeg оставили в основном контуре. Взаимодействие организовали через собственный HTTPS Job API, а большие файлы передаются через S3.
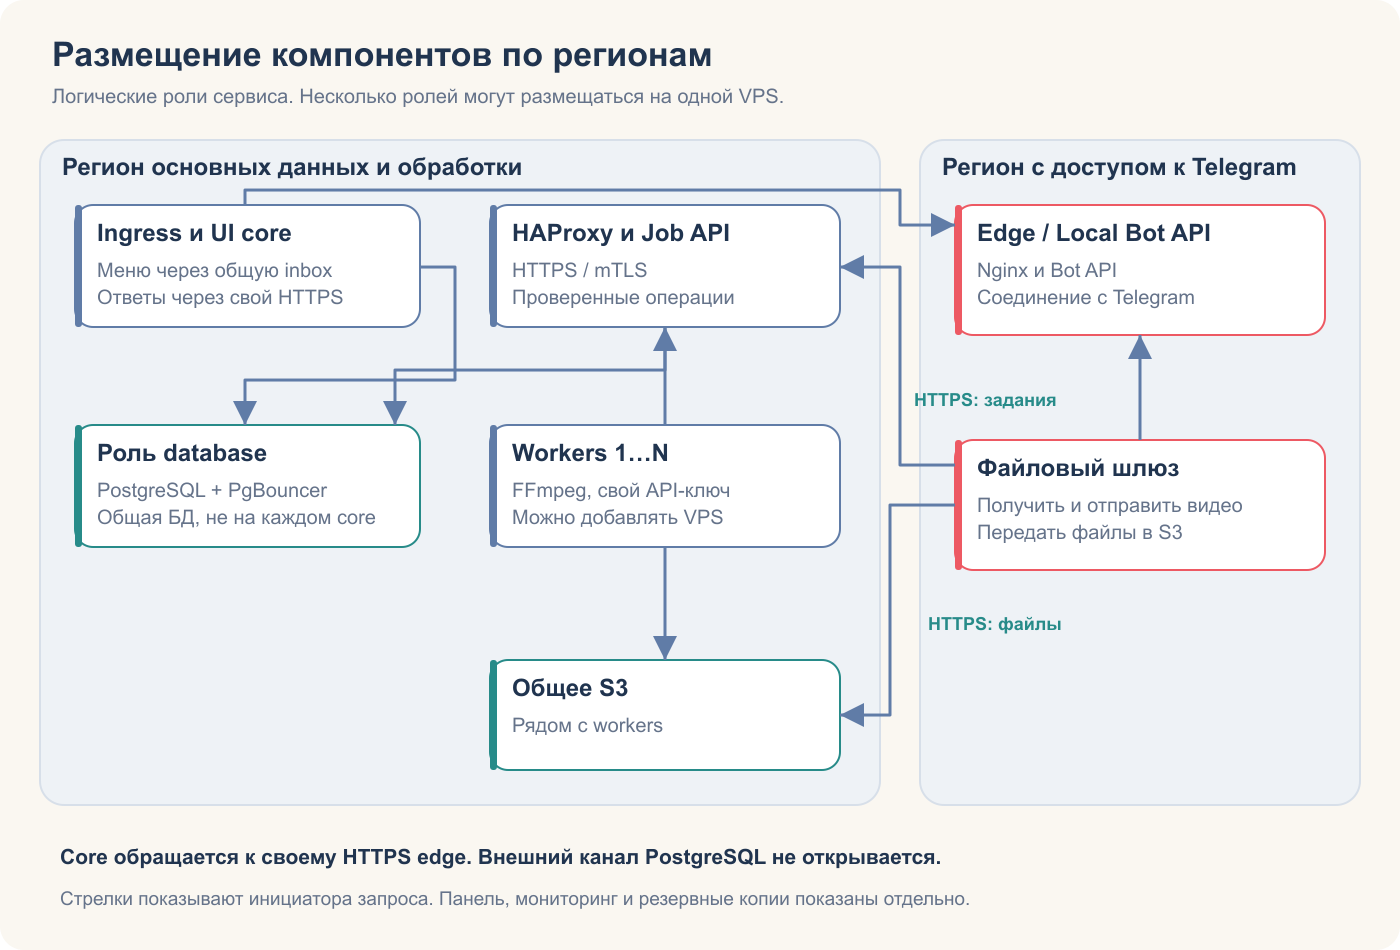
У каждой ноды своя API-идентичность. Backend проверяет роль, фазу и право владения заданием. Worker не получает универсальных методов для выполнения произвольного SQL или изменения баланса. Обработчики и S3 размещаем рядом, чтобы не передавать большие файлы между регионами без необходимости.
Базу тоже выделили в отдельную роль. Замена обработчика видео не должна затрагивать пользовательские кошельки. При этом несколько ролей могут работать на одной VPS, если ресурсов достаточно.
В какой-то момент вариантов архитектуры стало слишком много. Пришлось сформулировать для себя простое правило:
Нам не нужен космолёт, нам нужен стабильный, хороший, понятный продукт.
Часть оптимизаций отложили. Некоторое время сервис продолжал работать на Mac, со всеми ограничениями домашнего компьютера: питание, интернет, FileVault. Позже перенесли его на VPS.
В итоге получилось шесть серверов:
-
control — панель управления и мониторинг
-
core — API и меню
-
edge — работа с Telegram
-
worker — FFmpeg
-
db-01 и db-02 — основной и резервный PostgreSQL
Для больших файлов используется S3.
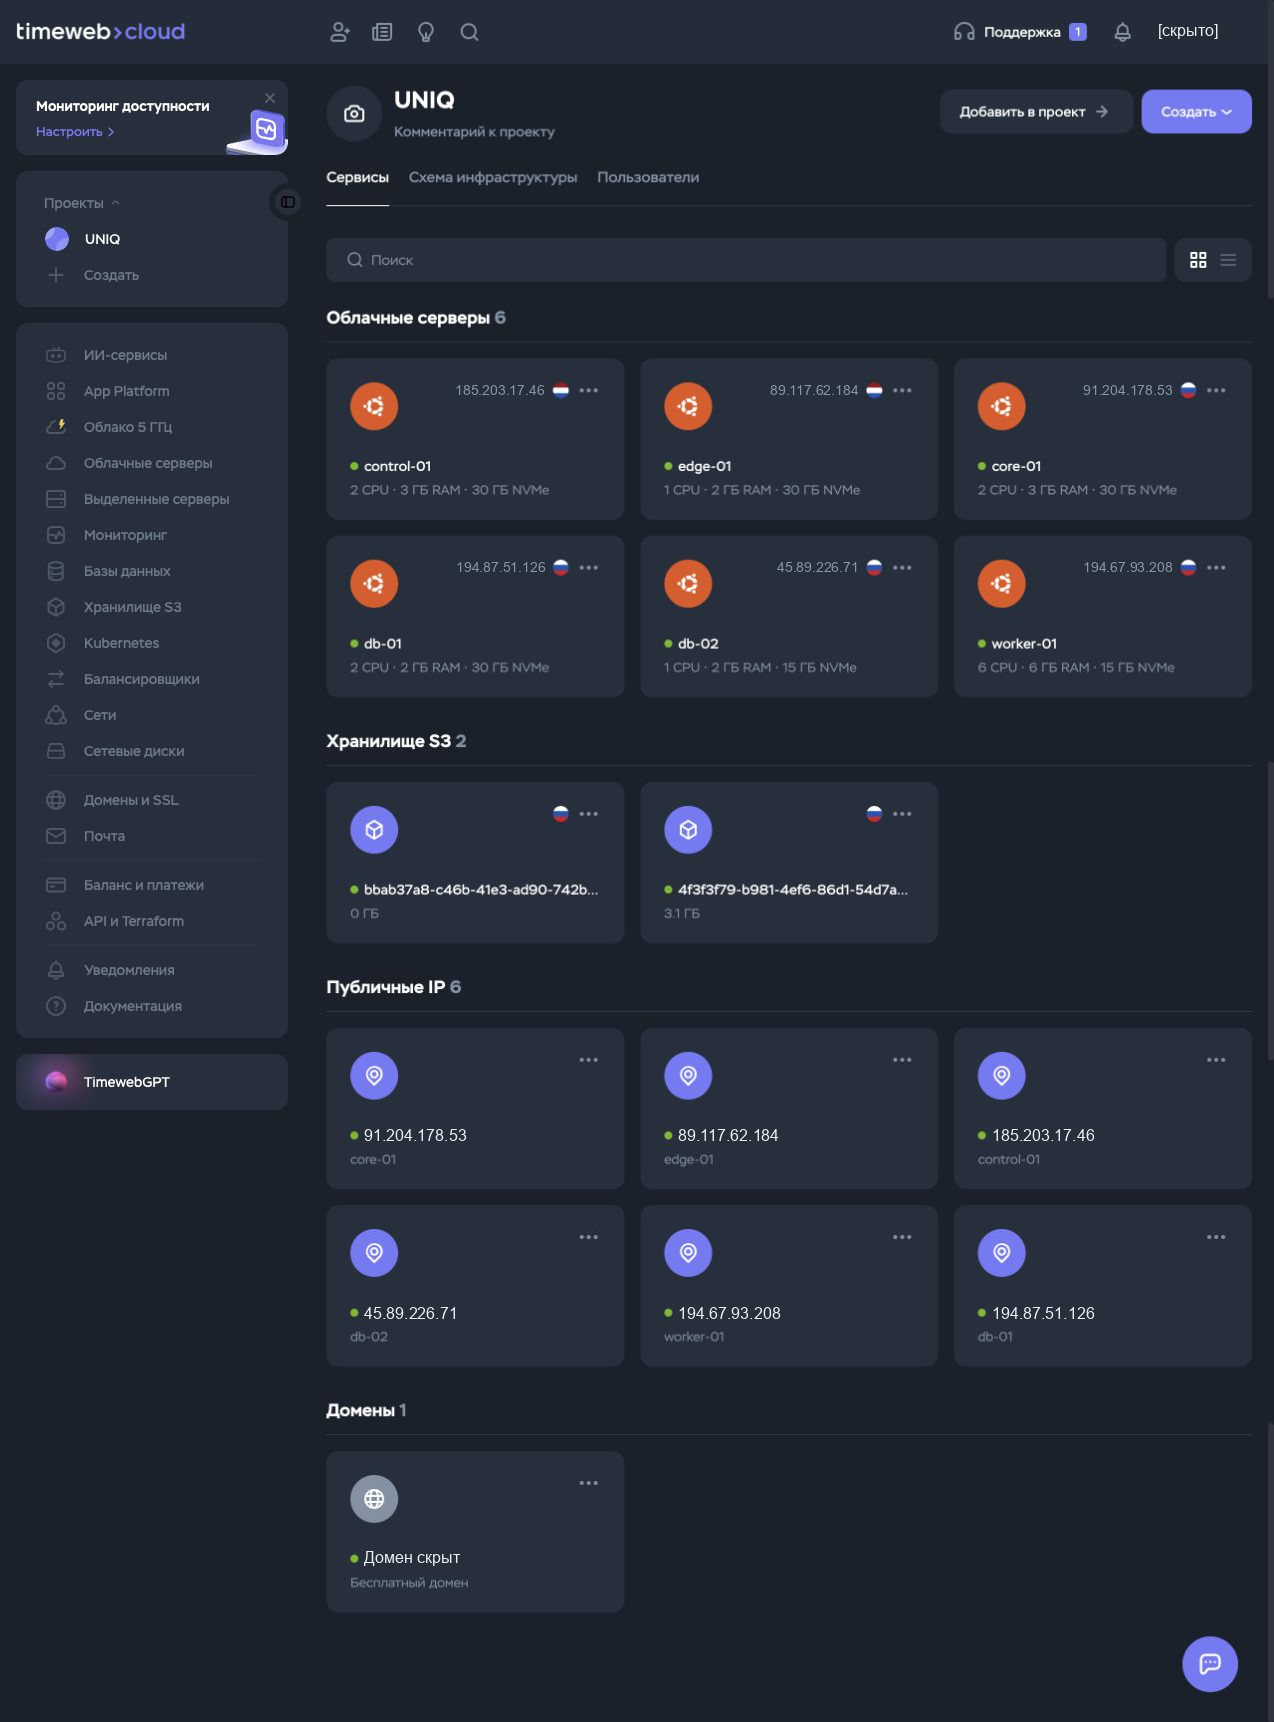
Это не шесть одинаковых копий приложения. Если не хватает производительности кодирования, можно добавить worker, не затрагивая базу и остальные компоненты. Но такая схема ещё не означает полной отказоустойчивости. Один edge и один worker остаются единичными компонентами. Собственные HTTPS-маршруты тоже могут стать недоступны. Поэтому предусмотрели проверки связности и возможность замены edge.
Одна кнопка, чтобы пойти пить чай
На раннем этапе достаточно помнить несколько команд для запуска и обновления. Но когда серверов и компонентов становится больше, ручное управление быстро усложняется. Хотелось, чтобы друг мог самостоятельно подключить сервер, выкатить обновление, заметить проблему и при необходимости восстановить работу. Так появилась собственная панель.
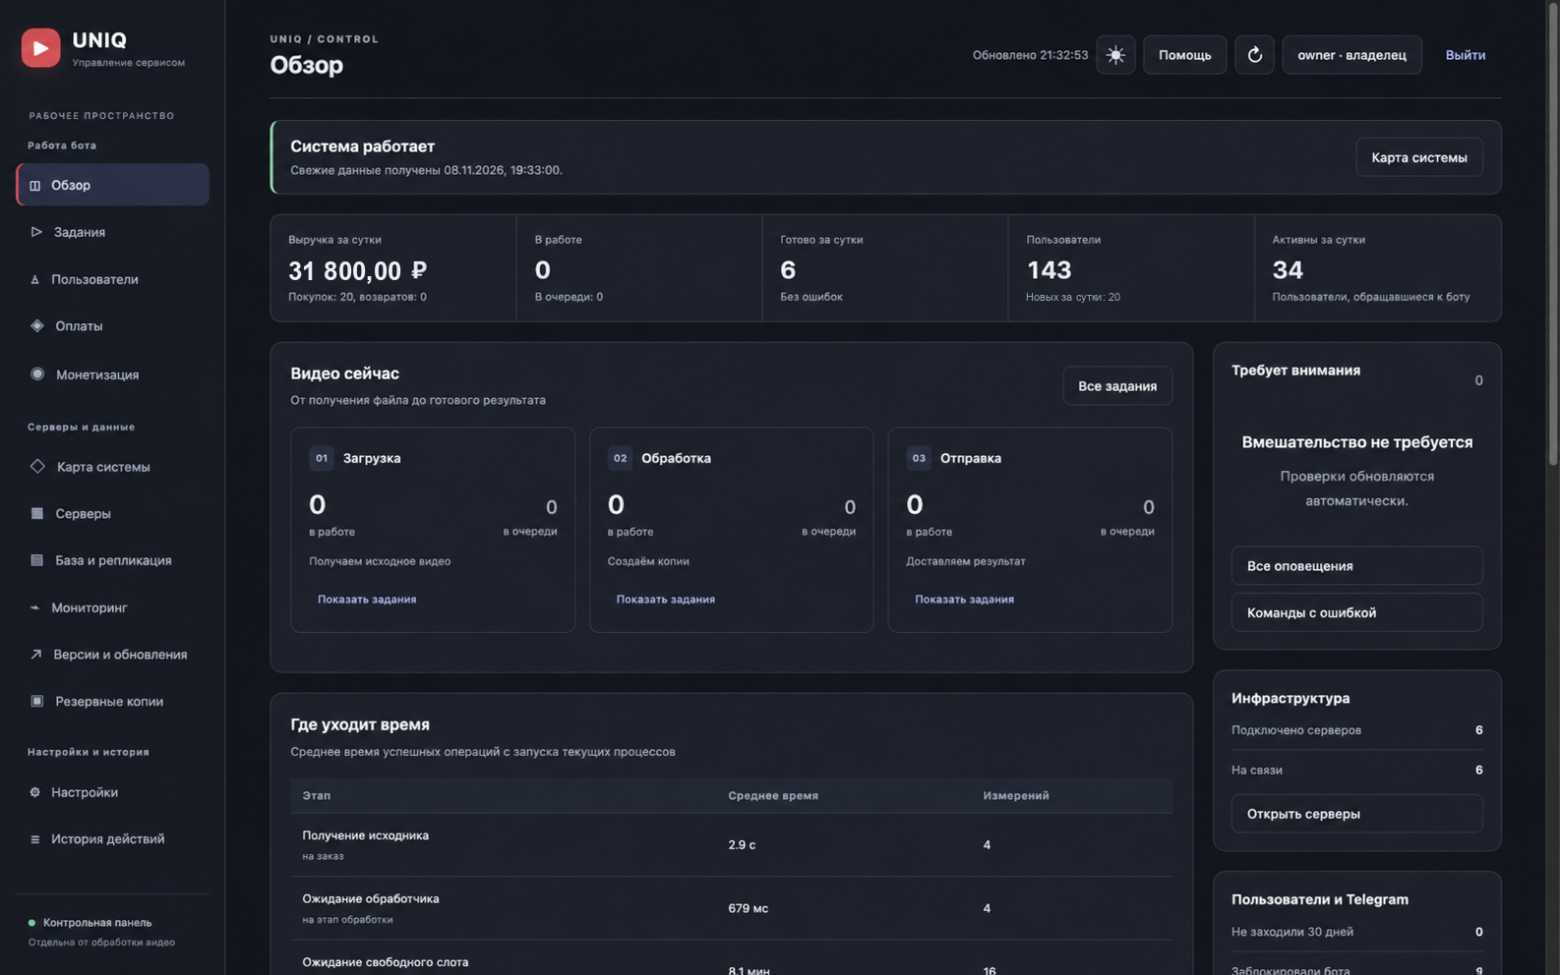
Начали с подключения сервера. Хостер выдаёт адрес и SSH-доступ, а не параметры нашей внутренней сети. Поэтому в панели достаточно указать знакомые данные и выбрать роль сервера. Остальное определяет автоматика.
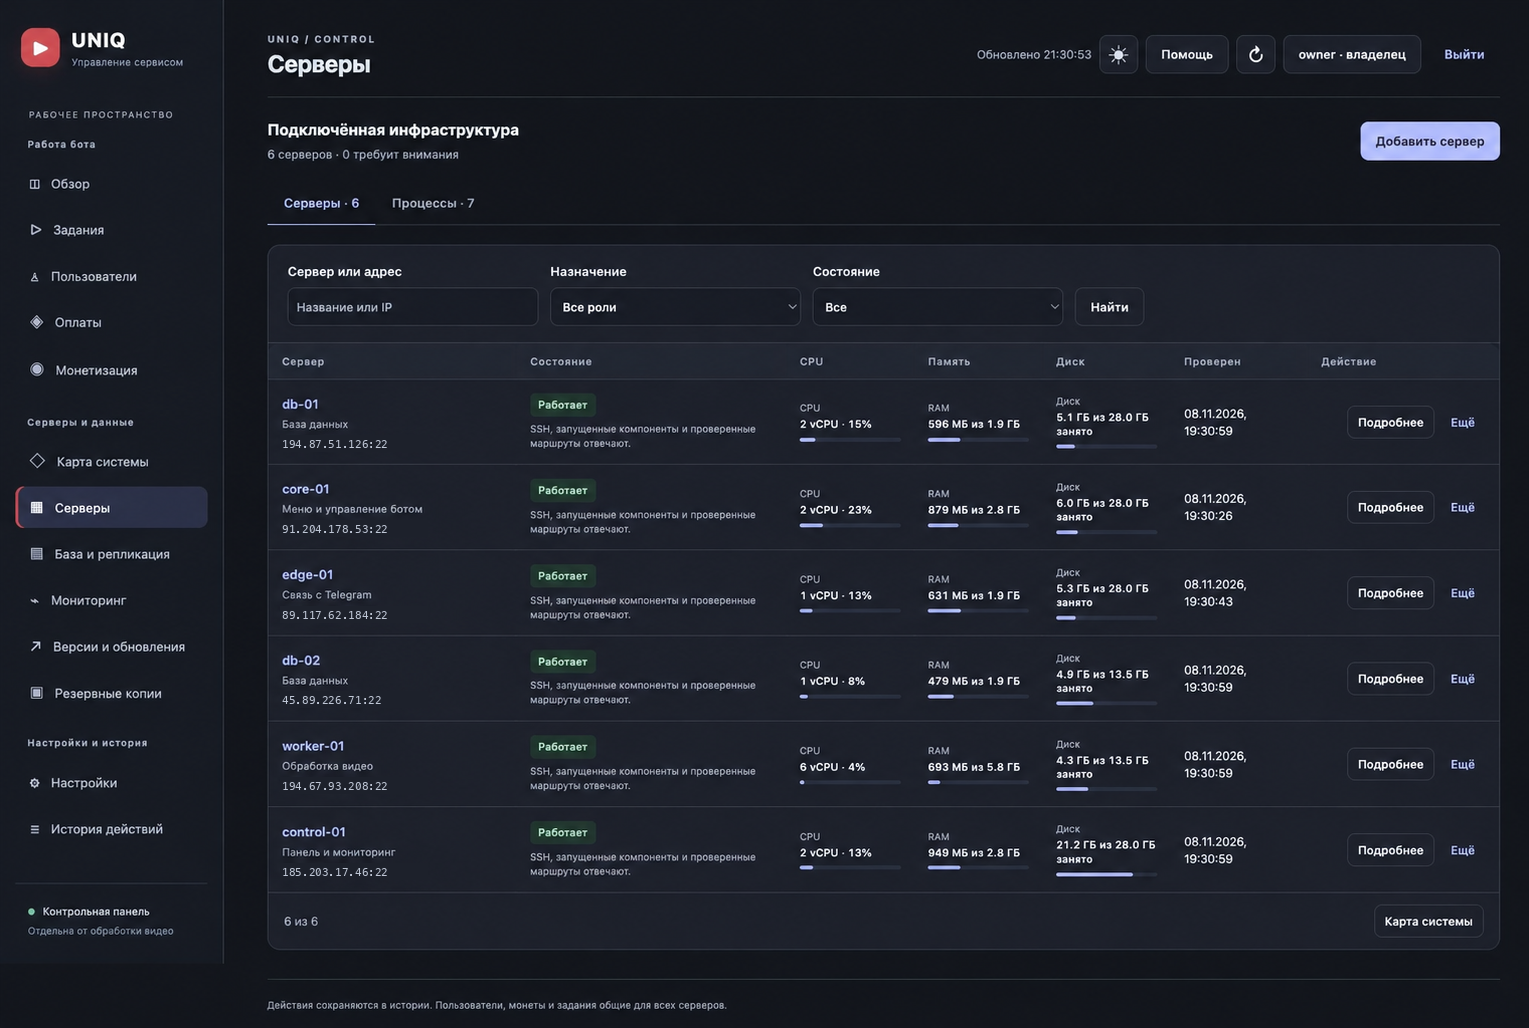
Следующая задача — обновление программы. В панели видны запущенные компоненты, история обновлений, доступные версии и прогресс по каждому серверу.
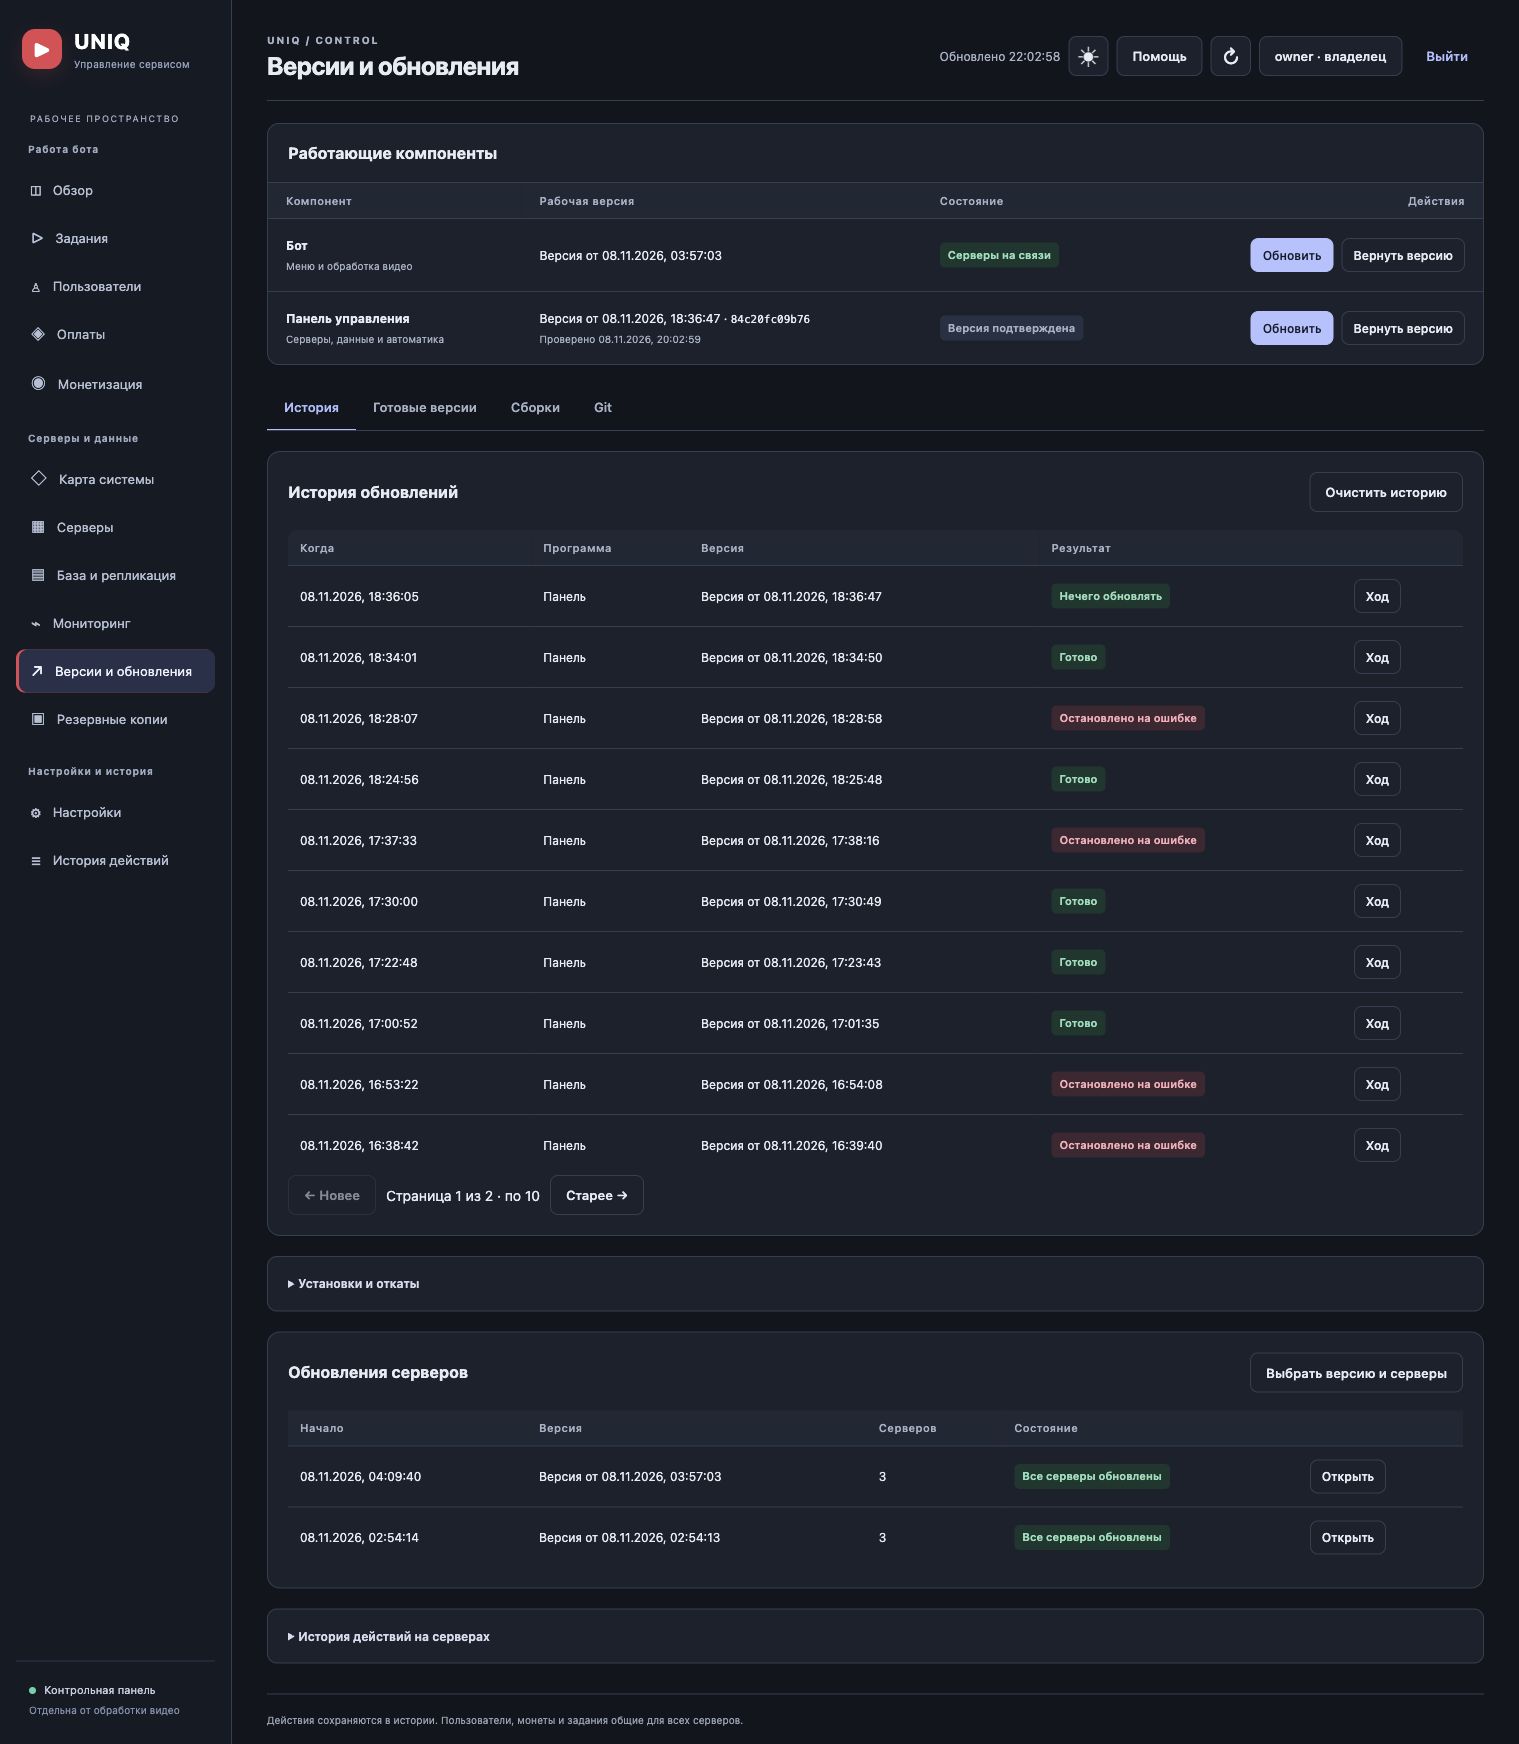
За одной кнопкой скрывается несколько этапов: выбор конкретного Git commit, проверка совместимости, подготовка релиза, сохранение предыдущего артефакта для отката, установка и проверка готовности.
Установщик работает отдельно от панели. Закрытая вкладка или обновление самой панели не должны останавливать выкатку. После повторного открытия можно увидеть журнал и текущий этап. Версию определяем по реально запущенному приложению, а не по сообщению сборщика.
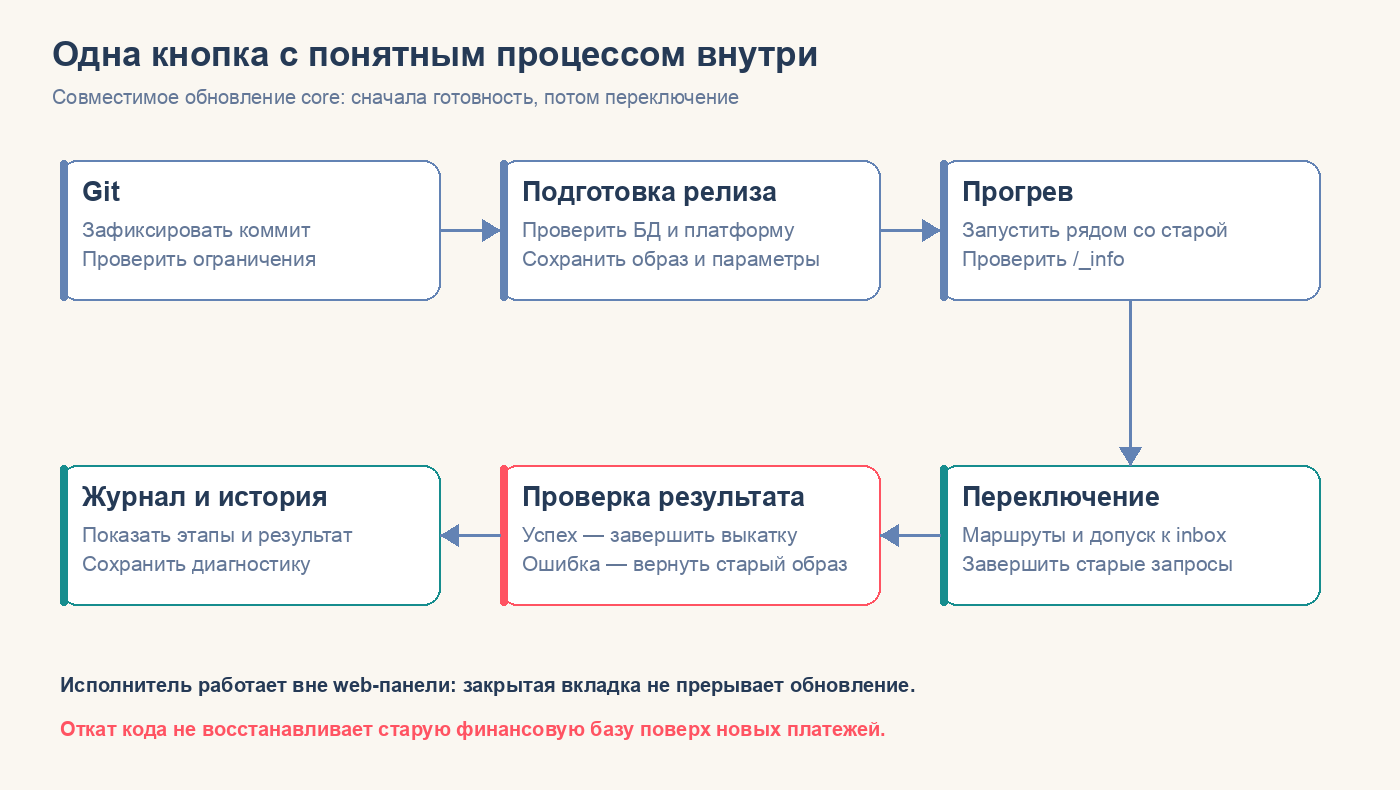
На Mac оставили упрощённый режим обновления для разработки. На VPS панель собирает образ из Git, проверяет его и передаёт узлам. Отдельно проверили совместимость соседних версий: старый worker с новым API и новый worker со старым API. Обработчик должен уметь прочитать сохранённый план, продолжить выдачу результатов и обработать отмену.
Получили 13 проходящих тестов. Затем специально ломали поле ответа API и формат клиентского запроса, чтобы убедиться, что тесты действительно замечают несовместимость. При этом контрактные проверки не заменяют тестирование реальных транзакций и полного процесса обновления. И ещё один момент: откат кода не должен возвращать финансовую базу к состоянию до последних платежей.
Бесшовность начинается не с двух одинаковых контейнеров
Для совместимых обновлений core сделали два слота — blue и green. Пока старая версия обслуживает пользователей, новая запускается рядом и проходит проверку готовности через /_info. Входной прокси и Telegram ingress остаются на месте. До успешной проверки трафик продолжает идти на старую версию.
На небольшой VPS не всегда хватает ресурсов для полного дублирования приложения. Поэтому установщик проверяет доступную RAM и сначала запускает одну новую реплику UI. Если памяти недостаточно, переключение не выполняется, старая версия продолжает работать. После завершения обновления количество реплик восстанавливается.
Nginx проверяет конфигурацию и переключается без обрыва уже начатых запросов. Отдельно в БД меняется допуск обработчиков меню к inbox. Старые процессы должны перестать забирать новые события.
Прежнюю версию удаляем только после проверки активных аренд и завершения старых процессов прокси. Если проверить занятость не удалось, прежнюю версию сохраняем. Этап переключения, образ и конфигурация сохраняются на диск. Это сохраняет данные, нужные для продолжения или отката после обрыва SSH-соединения.
Это относится прежде всего к core. Edge и worker требуют завершения начатой работы и отдельной проверки готовности. Панель может переподключаться. Полного отсутствия пауз при обновлении любого компонента мы не обещаем.
Одна база для старого и нового кода
Blue-green не поможет, если новая схема базы несовместима со старым приложением. Поэтому для миграций предусмотрели окно совместимости. В базе хранится информация о том, какой уровень кода можно запускать. При старте проверяются известные миграции и их контрольные суммы.
Панель проверяет совместимость работающих узлов. Совместимые миграции выполняются на db-узле до переключения приложений, при необходимости после создания резервной копии. PostgreSQL при этом не пересоздаётся. Если используется управляемая репликация, нужен отдельный план. Обычная выкатка с изменением схемы в таком случае блокируется.
Для отката возвращаем прежние образы на совместимой базе, сохраняя новые платежи. Удаление колонок и другие несовместимые изменения требуют отдельной процедуры или нескольких последовательных релизов.
Видеть результат, а не только зелёные контейнеры
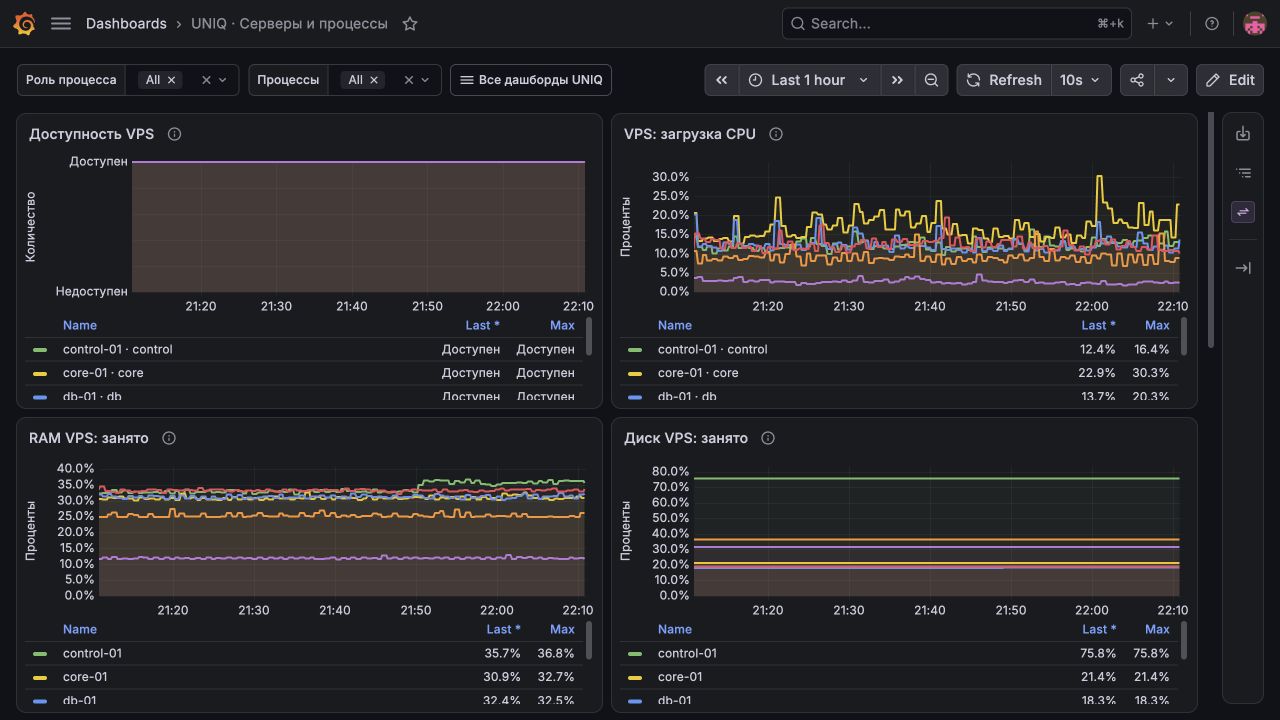
Успешная выкладка ещё не означает, что пользователь получил видео. Контейнеры могут работать, а заказ при этом застрять в очереди или на отправке. Поэтому мониторинг связали с конкретными этапами: очередь, кодирование, передача файлов, меню, база и ошибки [8].
RPS показывает количество запросов в секунду. В него входит и служебный опрос, поэтому использовать его как количество пользователей нельзя.
Если загружен CPU и растёт очередь видео, вероятно, нужно увеличивать мощность обработки. Если растёт ожидание БД, нужно разбираться с запросами и блокировками. Дополнительный FFmpeg здесь не поможет.
Графики ниже показывают отдельный час работы VPS и контейнеров, а не повтор приведённых нагрузочных тестов.
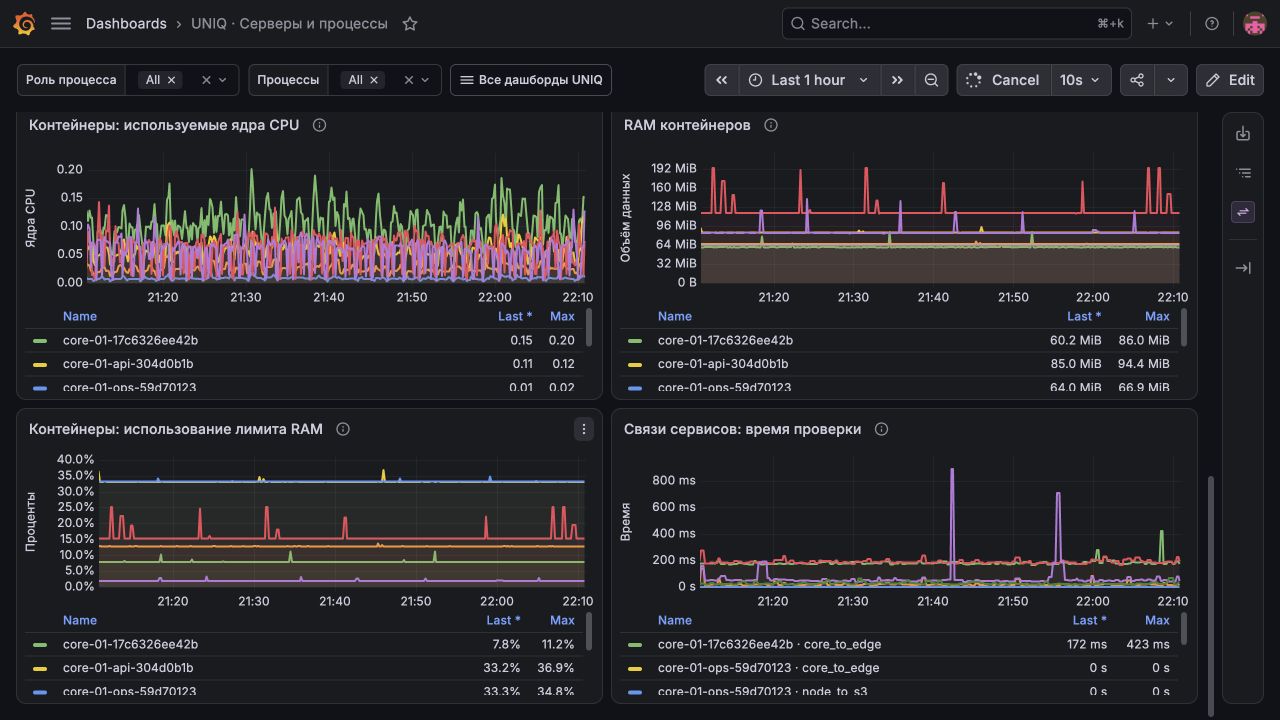
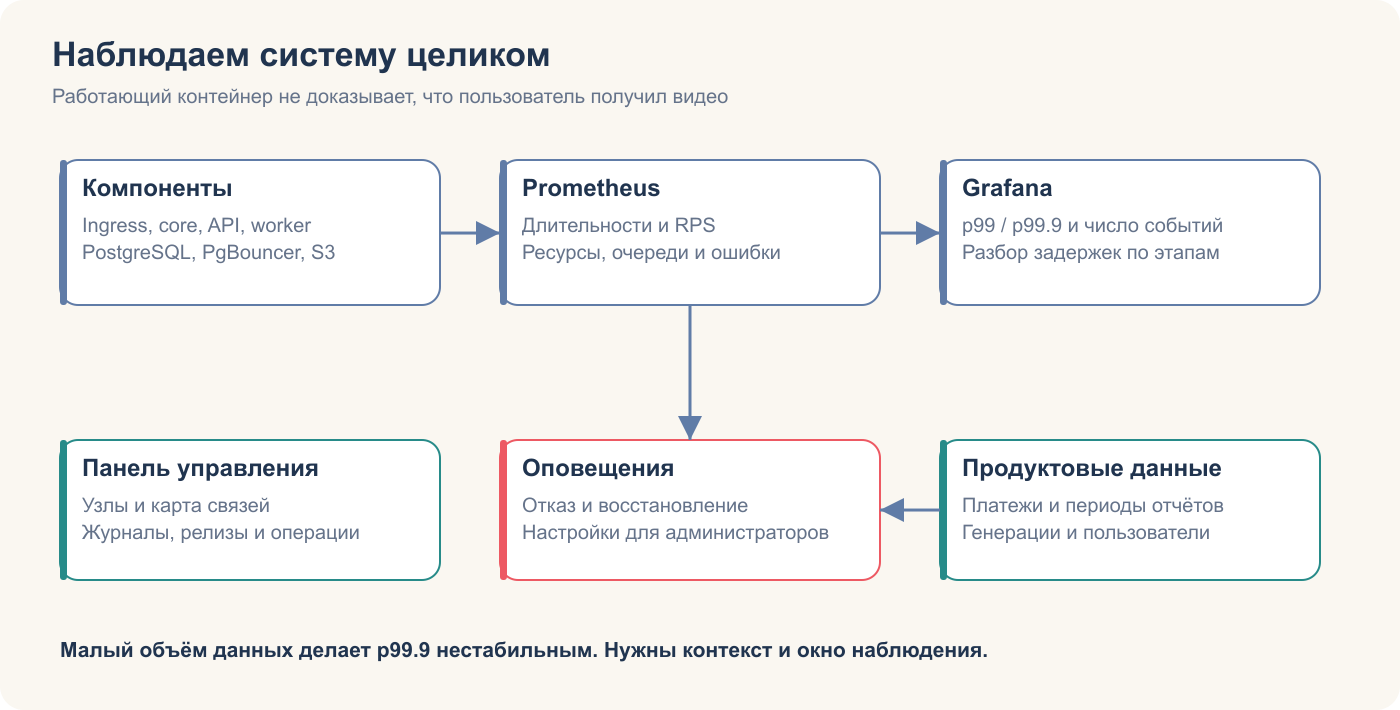
Начисления, тарифы, пакеты и отчёты тоже доступны через панель. Чтобы посмотреть заказ или помочь пользователю с балансом, больше не нужно вручную заходить в базу и менять записи.
Когда откатить код недостаточно
Оставался сценарий потери данных. Нужна была не просто резервная копия, а копия, из которой действительно можно восстановиться. Зашифрованные копии PostgreSQL и настроек появились ещё на Mac. Историю Docker-образов дедуплицировали, а создание копий согласовали с очисткой.
После переезда база и настройки панели остались отдельными объектами. Восстановить инвентарь серверов — не то же самое, что восстановить оплаченные заказы. Резервный комплект должен быть самостоятельным. Ключ шифрования хранится отдельно, а восстановление проверяется вне рабочей финансовой базы.
Копия на том же сервере не защищает от потери всей машины. Реплика тоже не заменяет резервное копирование: она повторяет не только полезные изменения, но и ошибочные. Для сертификатов отдельно проверили выпуск, продление и повторную установку после ошибки.
На резервный PostgreSQL переключаемся управляемо: проверяем отставание реплики и отключаем прежний основной узел. Наличие второго сервера само по себе не гарантирует отсутствие потерь данных.
Иногда главная задача — остановить ИИ
Не весь написанный код попал в проект. Например, мы пробовали сделать общий ограничитель скорости отправки запросов в Telegram. Когда запросов слишком много, Telegram API отвечает 429 и просит подождать. У core уже были локальные паузы, и мы хотели согласовать ограничения между процессами.
Первый вариант сделали через дополнительный Python HTTP proxy. Он обеспечивал примерно 240–300 запросов в секунду против 1000 при прямом обращении. Ограничитель работал, но сам стал узким местом.
Затем проверили вариант без проксирования. На имитаторе он обработал 24 000 запросов без ошибок, но в одном режиме медианный RPS снизился с 1142 до 1090. При этом массовых реальных ответов 429 мы не наблюдали. Получалось, что дополнительные расходы уже измерены, а практическая польза пока не подтверждена. В итоге эксперимент убрали и не стали выкатывать. Это один из случаев, когда важно вовремя отказаться от готового решения, даже если на него уже потрачено время.
С тестовыми окружениями остановились позже, чем следовало. Во время тяжёлых проверок Mac исчерпал ресурсы и перезагрузился. После этого для локальных тестов выделили лёгкую Linux VM с отдельным Docker daemon. Автоматику привязали к её сокету. Теперь она работает со своими контейнерами и томами, не завися от глобального Docker context.
Отдельно защитились от ситуации, когда рабочая база неожиданно пропала. Отсутствие нужных данных не считается первым запуском. Если рабочая база недоступна, автоматика должна остановиться с ошибкой, а не создавать новую пустую базу.
Проверки разделили по окружениям. Контракты и интерфейс проверяем без новых VM. Базу и S3 — на изолированных данных. Сборку и приёмку Ubuntu — на подходящем сервере.
Приёмку автоматизировали через MTProto — программно управляемый Telegram-клиент. Подключили два настоящих аккаунта через QR. Один проверяет административные сценарии, второй — права обычного пользователя, включая невозможность получить доступ к чужим заказам.
Проверяли полный путь: загрузка файла больше 20 МБ, подтверждение, получение первой копии, отмена оставшейся обработки и скачивание результата. Полученное видео полностью декодировали. Баланс монет и резервы сверяли до и после заказа. После тестов настройки возвращали в исходное состояние.
Здесь хорошо видна разница между проверкой вызова метода отправки и проверкой того, что пользователь действительно получил исправный файл, а деньги учтены правильно. ИИ может быстро написать тесты на отдельные методы. Но для продукта нужно проверять всю цепочку.
Ручные проверки на телефоне и Telegram Desktop тоже оставили. Программный клиент может нажать кнопку и проверить ответ. Но он не покажет, насколько удобно читать длинное сообщение на маленьком экране. После всей работы с очередями, транзакциями и серверами мы снова возвращались к основной задаче: пользователь должен отправить видео и без лишних сложностей получить результат.
И у друга появились клиенты
После этой подготовки арендовали серверы и распределили компоненты по ролям. Панель стала управлять реальными машинами вместо локального стенда. Проверили связь компонентов, обновления и основные сценарии. А у друга появились первые клиенты.
Вот работающий бот UNIQ [1]. Для пользователя всё должно оставаться простым: отправил видео, выбрал параметры, получил готовые файлы. Ему не нужно знать, как работают lease, PgBouncer или восстановление зависшего worker.
Если не хватает мощности кодирования, можем добавить обработчик, не перенося базу и кошельки. Если меняем код, обновляем компоненты и проверяем результат. Если происходит сбой, у нас есть состояние задания, журнал операций и метрики, по которым можно разобраться в проблеме.
Первые клиенты ещё не означают, что мы проверили все возможные нагрузки или доказали успешность бизнеса. Но теперь у нас есть работающий продукт, который можно развивать и проверять в реальных условиях.
Вайбкодинг я по-прежнему считаю полезным. Без него друг, возможно, так и не принёс бы работающий прототип, а на первую реализацию ушло бы значительно больше времени. Но между прототипом и сервисом оказалось много работы, которую не видно в первом успешном запуске.
Транзакции, восстановление после сбоев, параллельная обработка, измерение задержек, платежи, резервные копии и обновления — всё это пришлось проектировать и проверять отдельно. ИИ помогал писать код и тесты. Но решения о том, как должна работать система, какие гарантии она даёт и какие оптимизации действительно нужны, оставались за нами. Некоторые готовые решения мы вообще не стали использовать, потому что тесты не подтвердили их пользу.
Excel не делает человека финансовым аналитиком только потому, что умеет считать формулы. Так же и ИИ не делает человека инженером только потому, что умеет писать код. При этом он позволяет быстрее пробовать идеи, учиться и реализовывать решения, до которых раньше могло не хватить времени.
Друг принёс прототип, который умел обрабатывать видео. В итоге получился сервис, поведение [9] которого мы можем объяснить, проверить и постепенно улучшать. Код мы получали быстро, но понимать и проверять работу системы всё равно приходилось самим. Для меня в этом и состоит польза разработки с ИИ: быстрее реализовывать решения, не теряя понимания того, как они работают.
Автор: nvorobev
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38230
URLs in this post:
[1] UNIQ: https://t.me/uniqvideobot
[2] Local Bot API: https://core.telegram.org/bots/api#using-a-local-bot-api-server
[3] авторов SQLite: https://sqlite.org/whentouse.html
[4] FOR UPDATE SKIP LOCKED: https://www.postgresql.org/docs/current/sql-select.html#SQL-FOR-UPDATE-SHARE
[5] правила оплаты в Stars: https://core.telegram.org/bots/payments-stars
[6] на время транзакции: https://www.pgbouncer.org/features.html
[7] памяти: http://www.braintools.ru/article/4140
[8] ошибки: http://www.braintools.ru/article/4192
[9] поведение: http://www.braintools.ru/article/9372
[10] Источник: https://habr.com/ru/articles/1101952/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1101952
Нажмите здесь для печати.