robots.txt не запрещает обучение ИИ: каких роботов закрывать, чтобы сайт остался в ответах нейросетей
Многие владельцы сайтов ставят в robots.txt Disallow для GPTBot и считают, что закрыли свои тексты от ChatGPT. Гари Ильес из Google напомнил [1]: файл решает только, может ли краулер (робот, который обходит сайт) скачать страницу, а что потом делают с контентом, он не решает. Значит, robots.txt для нейросетей работает как просьба к конкретному роботу, а не как запрет на обучение [2]. Строка про GPTBot не убирает сайт из ответов ChatGPT и ничего не говорит о страницах, которые уже скачаны. Поэтому сначала стоит решить, от чего закрываться, от обучения ИИ-моделей или от появления в их ответах, и закрывать это отдельными правилами для отдельных роботов.
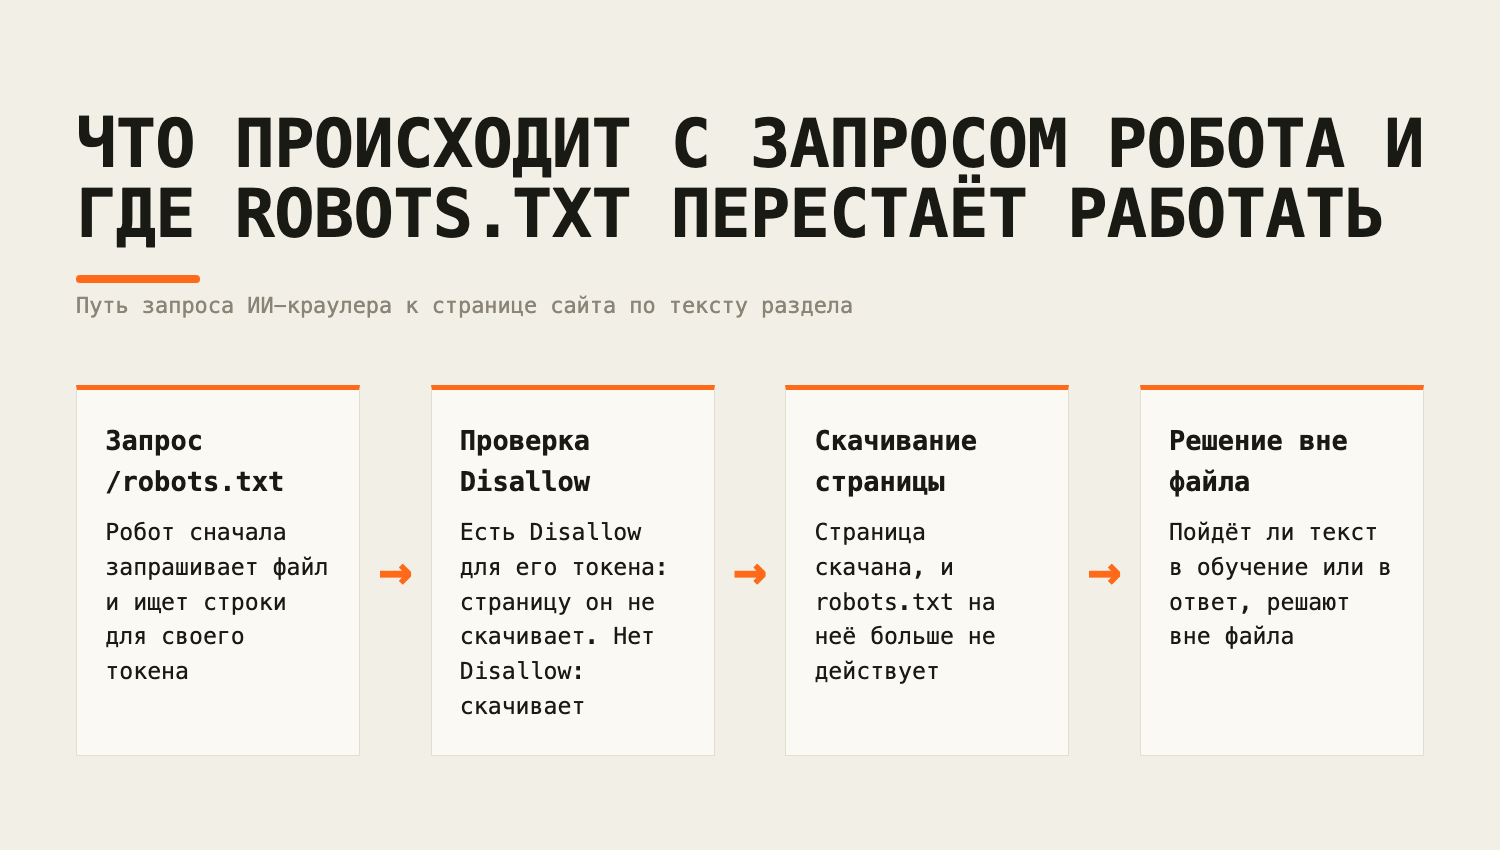
Disallow для GPTBot в robots.txt действует только на следующие обходы сайта
Disallow просит робота не запрашивать страницы, и больше ничего. В видео Search Central 21 октября 2026 года Ильес сослался на стандарт RFC 9309: robots.txt задаёт предпочтения по доступу и не определяет, что система делает с данными после обхода. Файл работает как табличка с просьбой не входить: воспитанный робот за дверь не зайдёт, но что делать с уже увиденным, табличка не говорит.
Поэтому новая строка касается только будущих обходов. Судьбу страниц, скачанных до неё, robots.txt не решает. Стандартного способа запретить обучение, но разрешить обход пока нет: он существует только в черновике.
Строки, которая закрыла бы весь ИИ разом, в стандарте тоже нет. Google поддерживает в файле только User-Agent, Allow, Disallow и Sitemap и пропускает остальное, так что выдуманная директива вроде No-AI-Chicken-Training ничего не даст. Конкретный ИИ-краулер закрывается, только если явно назвать его токен, то есть имя в строке User-agent. Об этом Ильес тоже сказал в видео (расшифровка на Search Engine Roundtable [3]).
У ChatGPT, Claude и Gemini обучение и ответы обслуживают разные роботы
У OpenAI и Anthropic по три робота. Первый собирает тексты для обучения, второй ищет страницы для поиска сервиса, третий заходит на страницу, когда об этом попросил пользователь.
|
Что делает робот |
OpenAI |
Anthropic |
|
Собирает тексты для обучения |
GPTBot |
ClaudeBot |
|
Ищет страницы для поиска сервиса |
OAI-SearchBot |
Claude-SearchBot |
|
Заходит по запросу пользователя |
ChatGPT-User |
Claude-User |
OpenAI пишет [4], что эти настройки независимы. Можно разрешить OAI-SearchBot и остаться в поиске ChatGPT, но запретить GPTBot, чтобы тексты не шли в обучение. ChatGPT-User приходит по действию пользователя, и правила robots.txt к нему, по словам OpenAI, могут не применяться. Из поиска ChatGPT сайт убирают через OAI-SearchBot. Anthropic предупреждает [5]: если отключить Claude-User, Claude не сможет взять вашу страницу в ответ на запрос пользователя, и видимость сайта может снизиться.
Google отделил обучение от Поиска токеном Google-Extended. Своего робота у токена нет. Он решает, пойдут ли страницы, которые обошёл Google, в обучение будущих моделей Gemini и в grounding, то есть в подачу страницы ИИ-модели во время ответа. На включение в Поиск Google-Extended не влияет (документация Google [6]). Похоже устроен Applebot-Extended: страниц он не обходит и только решает, можно ли учить ИИ-модели на данных Applebot. Сайт с его запретом остаётся в поиске (Apple Support [7]). Common Crawl, открытый архив скачанных страниц, обходит сайты ботом CCBot и перестаёт, если закрыть этот токен (FAQ Common Crawl [8]).
В России выбор беднее. Чтобы страницы не попадали в быстрые ответы Алисы AI в поиске, Яндекс Вебмастер [9] советует запретить YandexAdditional или YandexAdditionalBot. Изменение учитывается за 2–14 дней. Отдельного токена только для обучения у Яндекса, по справочнику seodb [10], нет: ИИ-ответы берут страницы из основного индекса, поэтому закрытый YandexBot убирает сайт и из поиска, и из них. Сбер, по наблюдению Флоустата [11] на октябрь 2026 года, не публикует ни имени поискового робота GigaChat, ни правил для robots.txt. Назвать этого робота в файле пока нельзя.
Какие строки robots.txt закрывают обучение ИИ, а какие убирают сайт из ответов
Закрыть сайт от ИИ целиком через robots.txt нельзя. Если пытаться, вы скорее всего потеряете место в ответах нейросетей, а уже скачанный контент так и останется в обучающих данных, то есть в наборе текстов, на которых учат ИИ-модель. Обучение и ответы надо разделять: роботов для обучения можно закрывать, если это важно бизнесу, а поисковые роботы ИИ-сервисов и роботов, которые приходят по запросу пользователя, стоит оставлять открытыми.
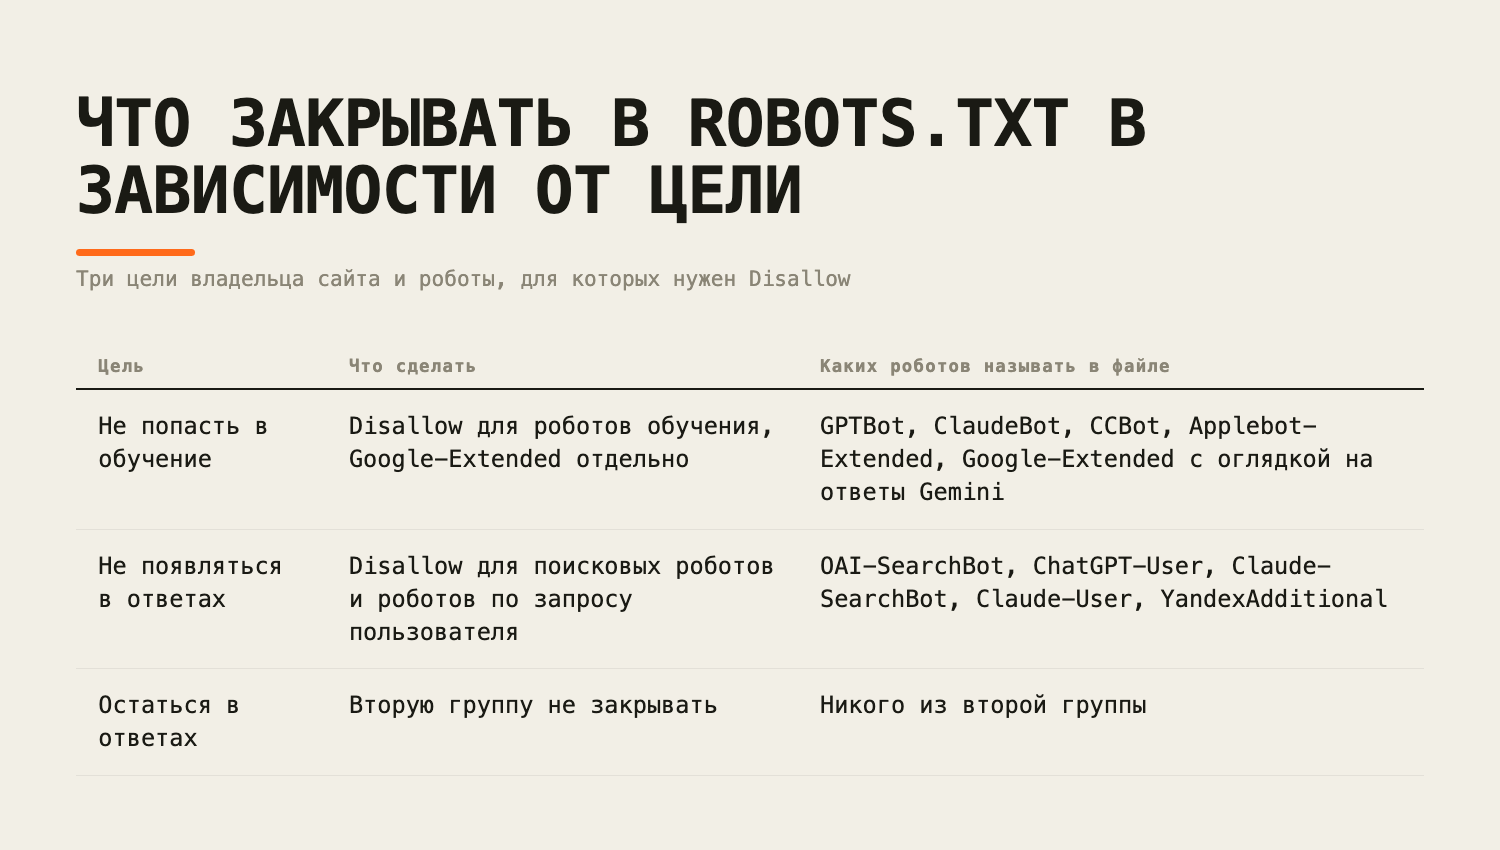
Не попадать в обучение и остаться в ответах:
“` User-agent: GPTBot User-agent: ClaudeBot User-agent: CCBot User-agent: Applebot-Extended Disallow: /
User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: Claude-SearchBot User-agent: Claude-User Allow: / “`
Первая группа просит не скачивать страницы для обучения роботов OpenAI, Anthropic, Common Crawl и Apple. Вторая нужна для наглядности: без запрета эти роботы и так допущены. Поиск Google такой файл не трогает и из поиска ChatGPT и Claude сайт не убирает. Страниц, которые эти роботы забрали раньше, он не касается, и роботов, которые robots.txt не читают, не остановит.
Google-Extended в этот список я не включил. Он закрывает не только обучение Gemini, но и grounding, поэтому запрет может стоить сайту места в ответах Gemini. Ставить его стоит, только если запрет обучения для бизнеса важнее этих ответов.
Не появляться в ответах:
“ User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: Claude-SearchBot User-agent: Claude-User User-agent: YandexAdditional User-agent: YandexAdditionalBot Disallow: / “
Цена такого файла в том, что сайт перестанет появляться в ответах этих сервисов. С ChatGPT-User результат не гарантирован: OpenAI оговаривает, что правила к нему могут не применяться.
Какие ИИ-боты обходят robots.txt и как проверить это по логам сервера
Слушаются файл не все. В августе 2025 года Cloudflare показал [12], что Perplexity при блокировке меняет user agent и ASN (номер сети, из которой идёт трафик) и порой даже не запрашивает robots.txt. Тест шёл на новых доменах с полным запретом в robots.txt и правилами против PerplexityBot и Perplexity-User. Perplexity всё равно получал контент, представляясь браузером Chrome на macOS. По подсчёту Cloudflare, такой скрытый обход шёл на десятках тысяч доменов, миллионы запросов в день. Perplexity исключили из списка проверенных ботов Cloudflare. Забавно, что самым послушным в том же тесте оказался ChatGPT-User: он запросил robots.txt и прекратил обход, хотя OpenAI сама предупреждает, что правила к нему могут не применяться.
Проверить своих роботов можно по access-логу. Отберите строки с токенами и посмотрите, какие страницы они запрашивали после появления Disallow:
“ grep -E "GPTBot|ClaudeBot|CCBot|OAI-SearchBot|ChatGPT-User" access.log “
Каждая строка содержит время запроса, путь, код ответа сервера и user-agent. Успешный ответ на запрос закрытого раздела после появления Disallow значит, что робот скачал страницу, а отказ или ошибка [13] — что содержимого он не получил. Смотрите, запросил ли робот /robots.txt и продолжил ли ходить в закрытые разделы. Подделку по токену не найти, поэтому ищите запросы с user-agent обычного браузера, которые в том же ритме идут на те же страницы. Как выглядят в логах GPTBot, ClaudeBot и остальные, разобрано в статье о том, какие ИИ-боты реально ходят по сайту и что они запрашивают [14].
Что, кроме robots.txt, закрывает контент от нейросетей: блокировка на сервере, метатеги и TDMRep
Против робота, который назвался браузером, не помогают ни robots.txt, ни блок по user-agent. Нужно поручить разработчику проверить защиту от автоматических запросов на сервере или в сервисе доставки сайта (CDN, например Cloudflare): она отличает робота от покупателя с обычным браузером по признакам трафика, таким как сеть, из которой идёт запрос, и ритм обращений. В тесте Cloudflare она сработала: когда закрыли и скрытый краулер, ответы Perplexity стали менее конкретными, без деталей исходной страницы. Блокировка по IP вместо файла с Anthropic может подвести: она мешает роботу прочитать robots.txt, и отказ может не сработать.
• Метатег nosnippet. Apple предлагает его, чтобы конкретный контент не попадал в ответы Siri и поиска Apple на общие вопросы.
• TDMRep. Протокол группы сообщества W3C (стандартом W3C он не является) выражает оговорку прав на TDM, автоматический анализ текстов и данных: отказ задаётся параметром tdm-reservation со значением 1 (описание протокола [15]). Юридический вес у него в ЕС: статья 4 директивы 2019/790 разрешает TDM в коммерческих целях, пока правообладатель не зарезервировал права, в том числе машиночитаемым способом. Вне ЕС это исключение не действует.
• Плата за обход. С июля 2025 года у Cloudflare в закрытой бете есть Pay Per Crawl: сайт может брать плату с ИИ-краулеров за каждый доступ к контенту.
Общий запрет обучения ИИ в robots.txt Anthropic уже учитывает, а Google обещает с 2027 года
С 30 октября 2026 года Anthropic распознаёт машиночитаемый сигнал запрета обучения. Общий запрет выглядит так:
“ User-agent: __usage_ai-training Disallow: / “
Google планирует поддержать тот же сигнал AIPREF в начале 2027 года. По прочтению Lab Leaders [16], Google может считать такой запрет запретом Google-Extended, и тогда общая строка тоже может стоить сайту ответов Gemini. Стандарт готовит IETF: черновик, соавтор которого Ильес, добавит в robots.txt правило Content-Usage и одноимённый HTTP-заголовок, но о словаре там ещё не договорились. Пока стандарт не принят, обучение и ответы приходится закрывать по отдельности и называть каждого робота по имени.
Автор: sburyi
Источник [17]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38266
URLs in this post:
[1] Гари Ильес из Google напомнил: https://www.searchenginejournal.com/google-illyes-robots-txt-crawling-ai-training/593957/
[2] обучение: http://www.braintools.ru/article/5125
[3] расшифровка на Search Engine Roundtable: https://www.seroundtable.com/google-video-robots-txt-rules-42355.html
[4] OpenAI пишет: https://developers.openai.com/api/docs/bots
[5] Anthropic предупреждает: https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
[6] документация Google: https://developers.google.cn/crawling/docs/crawlers-fetchers/google-common-crawlers?hl=en
[7] Apple Support: https://support.apple.com/en-sg/119829
[8] FAQ Common Crawl: https://www.commoncrawl.org/faq
[9] Яндекс Вебмастер: https://yandex.ru/support/webmaster/ru/search-appearance/fast
[10] справочнику seodb: https://seodb.tech/blog/robots-txt-ai-crawlers
[11] по наблюдению Флоустата: https://flowstat.ru/blog/gigachat-seo
[12] показал: https://blog.cloudflare.com/perplexity-is-using-stealth-undeclared-crawlers-to-evade-website-no-crawl-directives/
[13] ошибка: http://www.braintools.ru/article/4192
[14] какие ИИ-боты реально ходят по сайту и что они запрашивают: https://habr.com/ru/articles/1072256/
[15] описание протокола: https://www.w3.org/community/reports/tdmrep/CG-FINAL-tdmrep-20240510/
[16] Lab Leaders: https://lab-leaders.com/guides/zapret-obucheniya-ii-robots-txt
[17] Источник: https://habr.com/ru/articles/1105600/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1105600
Нажмите здесь для печати.