Я Валиев Артур и это моя первая в жизни научная работа. Z3R0
Спустя 34 месяцев я делюсь работой на которую потратил несколько лет. =), свой ИИ, забавно звучит?)
Начнем сразу с дани уважения.
Spore [1], eligibilit [2], e-prop [3], NEST Simulator [4], BindsNET [5], Brian2 [6], Norse [7]. spore [8]
Перед тем как начать, мой низкий поклон за работу, я считаю эти команды гениями [9], и святыми, мало того их стенды СВЯТЫНЯМИ. Пусть у авторов будет всё хорошо, а у исследований перспективы, аминь.
Простите меня что буду слишком пафосно говорить о своих успехах, без тех кто выше не было бы ничего, – вы лучшие.
Отдельно отмечу Spore [8] — уже другой, инженерный проект для управления ИИ-задачами, не связанный с одноимённым нейроморфным модулем.
Перед тем как начать, мой низкий поклон людям, которые создавали эти системы, исследовали пластичность, разрабатывали математический аппарат и публиковали исходные коды.
Я считаю эти команды гениями, а их экспериментальные стенды — почти святынями. Не в религиозном смысле, конечно. Хотя когда в третий раз за ночь проверяешь причинность обновления синаптических весов, начинаешь подозревать, что некоторые математические уравнения действительно заслуживают отдельного храма.
Простите меня, если дальше я буду слишком пафосно говорить о собственных успехах. Без людей, названных выше, значительной части этой работы просто не существовало бы. Наука [10] не начинается в тот момент, когда я открываю редактор и создаю новый файл main.rs.
Она начинается задолго до меня.
С работ Тьюринга, Хебба, Розенблатта, Эшби. С исследований пластичности, нейрофизиологии, обучения [11] с подкреплением [12], стохастических процессов, динамических систем. С десятилетий работы людей, которые пытались понять, как нервная система связывает действие и результат.
Поэтому я не собираюсь объявлять себя изобретателем спайковых сетей или человеком, который разгадал интеллект [13].
Я всего лишь задал собственный вопрос и оказался достаточно упрямым, чтобы проверить несколько ответов экспериментально.
Хабр запомнит.
Что ж, продолжим.
Почему меня вообще не устроили обычные нейросети?
Я разработчик. Мне привычны детерминированные системы: вход, вычисление, выход. Даже если внутри сложнейший механизм, я могу проследить его состояние, зарегистрировать события, проверить инварианты и измерить время исполнения.
Но однажды меня заинтересовало принципиальное различие между вычислением и обучением.
Представим обычную функцию:
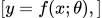
де (x) — входные данные, (theta) — параметры, (y) — результат.
Мы можем усложнять функцию практически бесконечно: добавлять слои, внимание, рекуррентность, внешнюю память [14]. Можем получить чрезвычайно сложное и полезное поведение [15].
Но меня интересует не только сама функция (f).
Меня интересует происхождение и изменение её параметров.
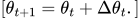
Что должно определять
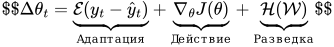
Я чуть пьян, но тут через интерференцию можно другую формулу разбить, честно устал, но ладно,
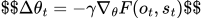
Либо через класический ии с подкреплением
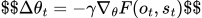
Если система существует в неизвестном мире, действует в нём, изменяет его и наблюдает последствия? Мы тут повторяем [16] то что уже все знаем, харош.
Может ли он использовать опыт [17] так, чтобы следующий неизвестный мир не требовал полного повторного обучения?
Это уже не просто задача аппроксимации функции.
Это вопрос о прижизненной адаптации воплощённой динамической системы.
Я не утверждаю, что привычные методы машинного обучения не способны решать такие задачи. Способны, и весьма успешно. Но я хочу исследовать один конкретный класс решений: обучение спайковой нервной системы при непрерывном взаимодействии с собственным телом и внешней средой.
Поэтому появился Z3R0 — Artificial Neural Organism.
От мембранного потенциала до движения
В одной из основных экспериментальных конфигураций Z3R0 используются 256 искусственных нейронов типа LIF — Leaky Integrate-and-Fire.
Каждый нейрон [18] обладает мембранным потенциалом (V_j), который накапливает входящие воздействия и постепенно затухает.
Дискретная динамика в используемой модели описывается выражением:
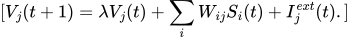
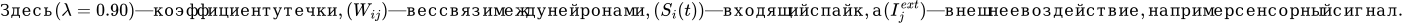
Когда мембранный потенциал достигает установленного порога (V_{th}=1.0), нейрон генерирует спайк:
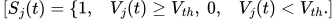
После этого потенциал сбрасывается.
Уже здесь возникают интересные свойства: пороговая нелинейность, временное накопление сигналов, затухание, зависимость активности от предшествующего состояния.
Но я не хотел создавать просто ещё один симулятор нейронов.
Я дал сети тело.
Организм получил две хемосенсорные антенны, двигательные органы и непрерывную двумерную арену с источником пищи.
Для каждой антенны использовалась функция чувствительности:
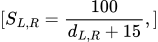
где:

расстояние от соответствующего рецептора [19] до источника.
А движение тела задаётся кинематическими уравнениями:
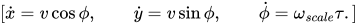
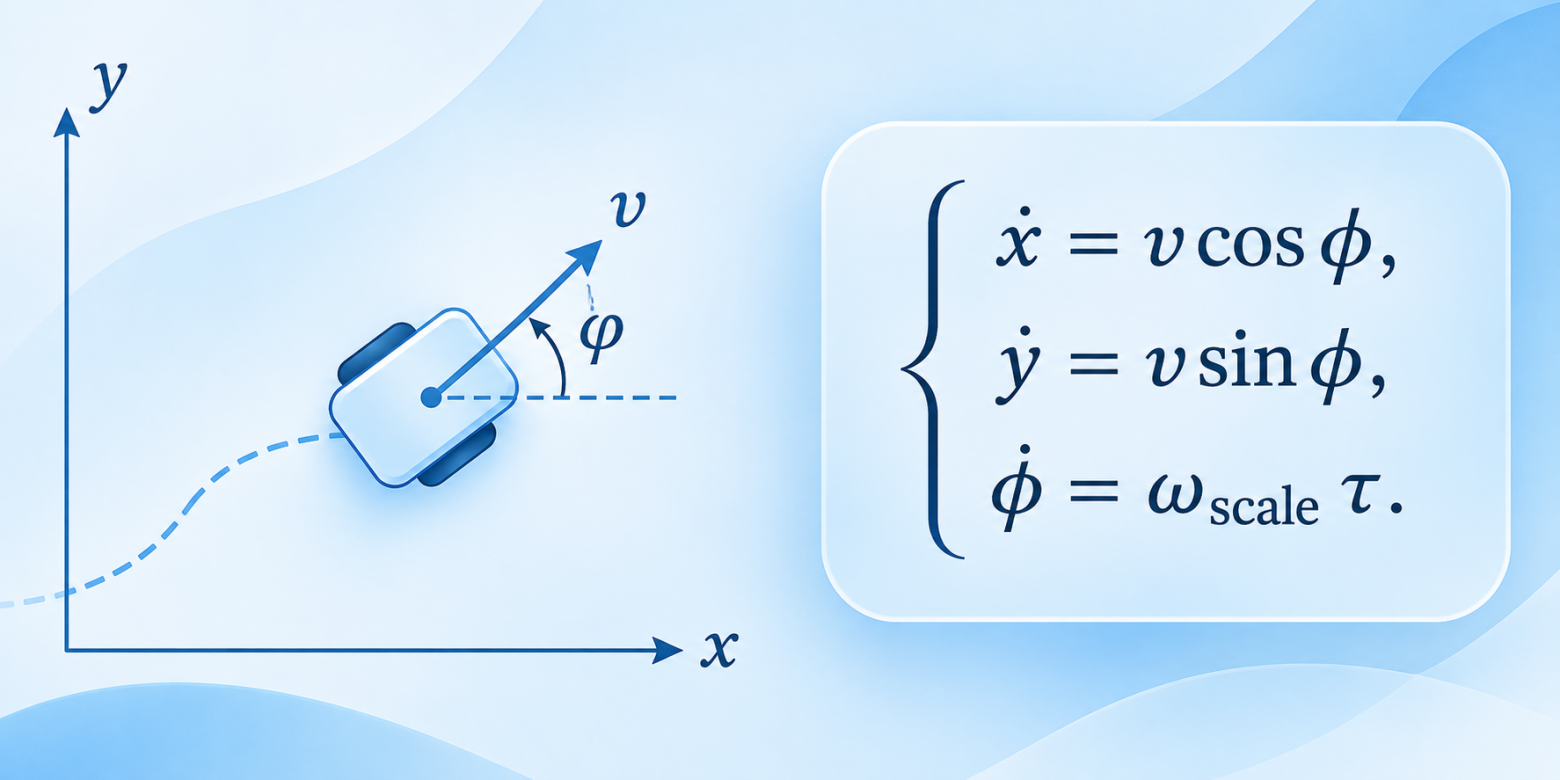
Поворотный момент формируется разностью управляющих воздействий левого и правого моторов:
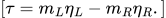
Здесь где

эффективности физических приводов. (чего так тяжело та?)
И вот важнейшее обстоятельство: нейросеть больше ни хрена не решает статическую задачу классификации.
Теперь её выход изменяет положение тела. Изменение положения влияет на показания рецепторов. Новые сигналы снова поступают в сеть.
Образуется замкнутый контур:
Рецепторы → нейронная сеть → моторы → физическое тело → среда → рецепторы.
Состояние организма зависит не только от текущего входного сигнала, но и от всей предшествующей траектории взаимодействия.
Это уже задача управления динамической системой с обратной связью.
И именно здесь я хотел наблюдать обучение.
Почему SPORE оказался для меня настолько важен
Один из первых вопросов, с которым я столкнулся: что вообще означает «синапс учится»?
В простейшем случае можно использовать правило Хебба:
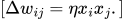
Активность передающего и принимающего нейронов определяет изменение силы связи. Но простое усиление коррелированных активностей ещё не говорит, было ли вызванное ими поведение [20] полезным.
Можно ввести третий фактор — модулирующий сигнал, функционально аналогичный подкреплению, честно и прогнорить но цифры сыпятся.
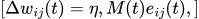
где

локальный след активности,

сигнал, влияющий на обучение.
Теперь появляется возможность связывать локальные нейронные события с внешними последствиями.
Но возникает проблема: если награда приходит через несколько шагов после действия, какой именно синапс должен получить положительное обновление?
И сколько синапсов заслуживают наказания, если организм не достиг цели?
SPORE интересен мне именно тем, что исследует обучение спайковых сетей через подкрепление и стохастическую синаптическую пластичность.
В стохастическом подходе обновление параметров может содержать одновременно направленное воздействие целевой функции, априорное ограничение и случайную диффузию.
В общем виде такую динамику удобно представить как:
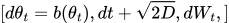
где:

направленный дрейф параметров, (D) — интенсивность диффузии, а (W_t) — винеровский процесс.
Это уже принципиальный втык от представления о нейронной сети как о статичной матрице окончательно выученных весов.
Синапсы могут продолжать изменяться.
Однако сама по себе непрерывная изменчивость ещё не означает обучение.
Случайное блуждание — не интеллект.
Для появления полезной адаптации изменения должны статистически улучшать поведение в интересующей нас среде.
И этот момент оказался решающим для всего моего исследования.
e-prop и проблема ответственности
Другое направление, которое я изучал, — eligibility propagation, e-prop.
В рекуррентной нейронной сети результат действия зависит от множества состояний, разнесённых во времени.
Вопрос состоит в том, как вычислять полезное изменение параметров без полного хранения и обратного распространения всей истории динамики.
Одна из центральных идей e-prop — разложение градиента на локальные следы пригодности и обучающие сигналы:
![sum_t L_j(t)e_{ji}(t), ]](https://www.braintools.ru/images/2026/11/10/ya-valiev-artur-i-eto-moya-pervaya-v-jizni-nauchnaya-rabota-Z3R0-21.svg "Я Валиев Артур и это моя первая в жизни научная работа. Z3R0 - 21")
где

характеризует локальную чувствительность нейронной динамики к параметру, а

обучающий сигнал. При точном обучающем сигнале такое разложение позволяет представить градиент; практические версии e-prop используют приближения, доступные при работе сети.
Меня в этом интересует не столько сама производная, сколько философский вопрос.
Как локальный элемент системы узнаёт о глобальном результате?
Нейрон не видит всю траекторию тела.
Синапс не знает координат источника пищи.
Мотор не знает, насколько полезной окажется команда через десять шагов.
Тем не менее система должна каким-то образом распределить ответственность за результат между огромным количеством локальных событий.
Это не риторический вопрос.
Это конкретная математическая проблема.
И Z3R0 позволил мне исследовать её на физически интерпретируемом примере.
Я сломал своему организму тело
Сначала я моделировал повреждение одного мотора.
Например:

Левый привод стал слабее правого.
Казалось бы, теперь нейросети требуется приобрести новый навык компенсации.
Но контрольные испытания показали неприятную вещь.
На 4000 независимых мирах базовая сеть демонстрировала 40,1% успешности с исправным телом и 39,3% при ослаблении одного мотора.
Разница — всего 0,8 процентного пункта.
Оказалось, что существующий сенсомоторный контур уже частично компенсировал это повреждение посредством обратной связи.
И тогда я осознал фундаментальную ошибку [21] постановки вопроса.
Нельзя доказать приобретение нового навыка, если исходный навык почти не нарушен.
Пришлось изменить сам эксперимент.
Я поменял местами моторные команды.
Вместо обычного момента:
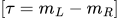
получилось:
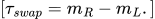
Теперь прежнее управление начало работать наоборот.
У одной базовой сети успешность упала с 40,1% до 10,4%.
Вот это уже был настоящий стресс-тест адаптации.
Но прежде чем требовать обучения, я решил проверить ещё один принципиальный вопрос.
Существует ли вообще полезное решение в доступном пространстве синаптических весов?
Я заморозил внутреннюю нейронную сеть и использовал внешний Evolution Strategies для поиска весов, приходящих к моторным нейронам.
Вес параметризовался через ограниченную координату:

Такая параметризация сохраняет исходный знак ненулевой связи и ограничивает изменение её абсолютной величины приблизительно множителями от 0,301 до 3,320.
На одном организме внешняя оптимизация увеличила успешность после Swap с 10,4% до 33,2%.
В когорте из десяти организмов средняя успешность найденных ES-конфигураций достигла 44,68% против 24,18% у исходных замороженных сетей.
Это не абсолютная теоретическая граница и не доказательство способности к самостоятельному обучению.
Но эксперимент показал важное: внутри проверенного ограниченного пространства параметров существуют конфигурации, обеспечивающие существенно лучшее управление повреждённым телом.
То есть задача не сводилась к отсутствию допустимых полезных весов.
Оставалось самое трудное.
Научить организм находить их самостоятельно.
SMSS: когда красивое уравнение не становится интеллектом
На основе изученных подходов я экспериментировал с Motor Synaptic Sampling — SMSS.
В используемой конфигурации к моторной предактивации добавляется гауссово возмущение:
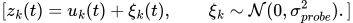
Моторная команда затем проходит через сигмоидальную функцию:
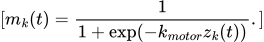
Для гауссовой политики по зашумлённой предактивации score-function даёт:
![frac{xi_k}{sigma_{probe}^2} frac{partial u_k}{partialtheta_i}. ]](https://www.braintools.ru/images/2026/11/10/ya-valiev-artur-i-eto-moya-pervaya-v-jizni-nauchnaya-rabota-Z3R0-30.svg "Я Валиев Артур и это моя первая в жизни научная работа. Z3R0 - 30")
Это позволяет формировать синаптические следы, связывающие параметры моторного считывателя с исследовательскими возмущениями.
Накопленный сигнал используется в обновлении параметров, которое в нашей реализации сочетает градиентный компонент, априорный якорь и шум Ланжевена:
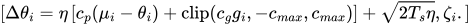
Здесь

Оценка обучающего градиента по накопленным следам,

параметр интенсивности стохастического сэмплирования,

стандартный нормальный шум.
Математически [22] подход интересен.
Но я снова возвращаюсь к своей главной мысли.
Наличие обучающего сигнала в уравнении не доказывает существование полезного обучения.
Поэтому были проведены контрольные испытания: замороженные веса, сэмплирование без градиента, полноценный SMSS и отдельная внешняя оптимизация ES.
На десяти организмах после 200 эпизодов индивидуальной жизни результаты оказались следующими:
|
Метод |
Успешность |
|---|---|
|
Frozen |
24,18% |
|
Zero-Gradient |
23,62% |
|
Full SMSS |
22,02% |
|
Найденные ES-конфигурации |
44,68% |
Разность между SMSS и Zero-Gradient составила −1,60 процентного пункта. Парный статистический тест дал (papprox0.098).
Мы не получили убедительного свидетельства того, что в этой конфигурации обучающий компонент SMSS обеспечивает преимущество над контролем без градиента.
И я не собираюсь называть это победой.
Синаптические веса действительно изменялись.
Но прижизненного восстановления навыка в проверенном режиме мы не продемонстрировали.
Я мог бы показать несколько удачных траекторий, написать о пластичности, добавить красивую визуализацию нейронов и объявить, что искусственный организм научился приспосабливаться к повреждённому телу.
Но тогда я перестал бы исследовать интеллект.
Я начал бы исследовать собственное желание его найти.
Что я понял за эти годы
Я понял, что в нейроморфных исследованиях мало построить нейроны, которые спайкуют. Мало написать правило Хебба. Мало добавить дофамин. Мало создать случайное изменение весов и получить улучшение в нескольких эпизодах.
Необходимо отделять корреляцию от причинности, случайность [23] от направленного поиска, устойчивость готового контроллера от приобретения нового навыка.
А главное — нужно уметь доказывать, что конкретный механизм обучения даёт эффект, которого не возникает без него.
Собственно, ради этого и существуют контрольные группы.
И когда моя гипотеза не выдержала проверки, я получил не красивый ответ о происхождении интеллекта, а гораздо более скромный результат: для выбранного организма, физической задачи и алгоритма простого добавления стохастической синаптической пластичности оказалось недостаточно.
Это не опровергает SPORE. Не опровергает e-prop. Не опровергает локальное обучение и уж тем более не говорит ничего окончательного о природе интеллекта.
Это ограниченный, воспроизводимый в описанном протоколе отрицательный результат моей собственной реализации.
И он важен для меня.
Потому что я больше не хочу подменять отсутствие ответа красивой гипотезой.
Теперь меня интересует следующий вопрос: если организм не может эффективно определить последствия собственных моторных возмущений по одному лишь отложенному подкреплению, может ли он научиться предсказывать эти последствия?
Например:
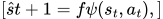
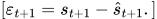
Тута =) :

внутренняя предиктивная модель, а

ошибка между ожидаемым и реальным сенсорным состоянием.
Такая архитектура могла бы дать системе дополнительную информацию о том, как её собственные действия изменяют мир. Однако построение точного предсказателя само по себе не гарантирует улучшения управления. Это новая проверяемая гипотеза, а не уже полученный результат.
Именно с таких различий между возможным, предполагаемым и доказанным я теперь начинаю каждый эксперимент.
Я не знаю, где начинается интеллект.
Не знаю, достаточно ли для него памяти, пластичности, предсказания, внутренней модели тела или чего-то ещё.
Не знаю, способна ли маленькая спайковая сеть стать основой более универсального обучающегося организма.
Но я знаю одно: если я когда-нибудь увижу в Z3R0 поведение, которого не предусмотрел, первым делом я попробую его опровергнуть.
Отключу обучение.
Перемешаю сигналы.
Заморожу веса.
Поменяю начальные состояния.
Проверю независимые среды.
Попытаюсь найти простейшее альтернативное объяснение.
И только если эффект переживёт эти испытания, я позволю себе назвать его приобретённым навыком.
Потому что мне не нужен искусственный интеллект, в существовании которого я убедил самого себя.
Я хочу найти тот, существование которого смогу доказать.
Спасибо всем, кто занимается этой наукой. Спасибо авторам SPORE, e-prop, NEST, BindsNET, Brian2, Norse и множества других работ, до которых мои руки ещё не добрались.
Мождовательской моделью. Но это не делает каждый проведённый эксперимент бессмысленным.
Я продолжаю не потому, что уверен в победе.
Я продолжаю потому, что хочу знать.
Спасибо, что прочитали.
Артур Валиев, EVERTY.
За мечтателей! =)
Автор: vaalimusic
Источник [24]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38288
URLs in this post:
[1] Spore: https://github.com/IGITUGraz/spore-nest-module?utm_source=chatgpt.com
[2] eligibilit: https://github.com/IGITUGraz/eligibility_propagation
[3] e-prop: https://github.com/IGITUGraz/eligibility_propagation?utm_source=chatgpt.com
[4] NEST Simulator: https://nest-simulator.org/?utm_source=chatgpt.com
[5] BindsNET: https://github.com/BindsNET/bindsnet?utm_source=chatgpt.com
[6] Brian2: https://github.com/brian-team/brian2?utm_source=chatgpt.com
[7] Norse: https://github.com/norse/norse?utm_source=chatgpt.com
[8] spore: https://github.com/k0wt00r/Spore
[9] гениями: http://www.braintools.ru/article/4566
[10] Наука: http://www.braintools.ru/article/7634
[11] обучения: http://www.braintools.ru/article/5125
[12] подкреплением: http://www.braintools.ru/article/5528
[13] интеллект: http://www.braintools.ru/article/7605
[14] память: http://www.braintools.ru/article/4140
[15] поведение: http://www.braintools.ru/article/9372
[16] повторяем: http://www.braintools.ru/article/4012
[17] опыт: http://www.braintools.ru/article/6952
[18] нейрон: http://www.braintools.ru/article/9161
[19] рецептора: http://www.braintools.ru/article/9580
[20] поведение: http://www.braintools.ru/article/5593
[21] ошибку: http://www.braintools.ru/article/4192
[22] Математически: http://www.braintools.ru/article/7620
[23] случайность: http://www.braintools.ru/article/6560
[24] Источник: https://habr.com/ru/articles/1105744/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1105744
Нажмите здесь для печати.