OpenAI заявила об опровержении ETH, Anthropic подала на IPO: что происходит с ИИ
Модели начали выдавать результаты, которые человек не может быстро перепроверить: доказательства на десятки страниц, анализ тысяч генных экспериментов за полчаса, отчеты агентов о том, что они сделали в инфраструктуре. И почти в каждой крупной новости месяца звучит вопрос: кто подтвердит, что это правда.
Больше всего в октябре спорили о науке [1], с нее и начнем. Разбираемся, что именно произошло на стыке математики [2] и нейросетей, как ИИ попытался перевернуть теорию вычислительной сложности и что значит история с доказательствами для индустрии.
OpenAI и Anthropic опровергли ETH
26 октября OpenAI объявила о трех результатах. Внутренняя модель, по словам компании, опровергла гипотезу экспоненциального времени (Exponential Time Hypothesis, ETH), доказала гипотезу Согге о локальном сглаживании во всех размерностях и построила важное доказательство существования ряда квантовых теорий поля в четырехмерном пространстве, включая квантовую хромодинамику и чистую теорию Янга — Миллса. Анонс собрал около 1 160 голосов и более 700 комментариев на Hacker News. Больше этого в октябре обсуждали только заявку Anthropic на IPO.
Что такое ETH. Гипотеза 1999 года утверждает, что задачу 3-SAT (найти значения переменных, при которых выполняется логическая формула) нельзя решить быстрее, чем за время, растущее экспоненциально с числом переменных. На ETH опираются сотни работ: из нее выводят, что многие задачи в теории графов, биоинформатике и базах данных не решаются быстро. Если ETH ложна, эти выводы нужно пересматривать.
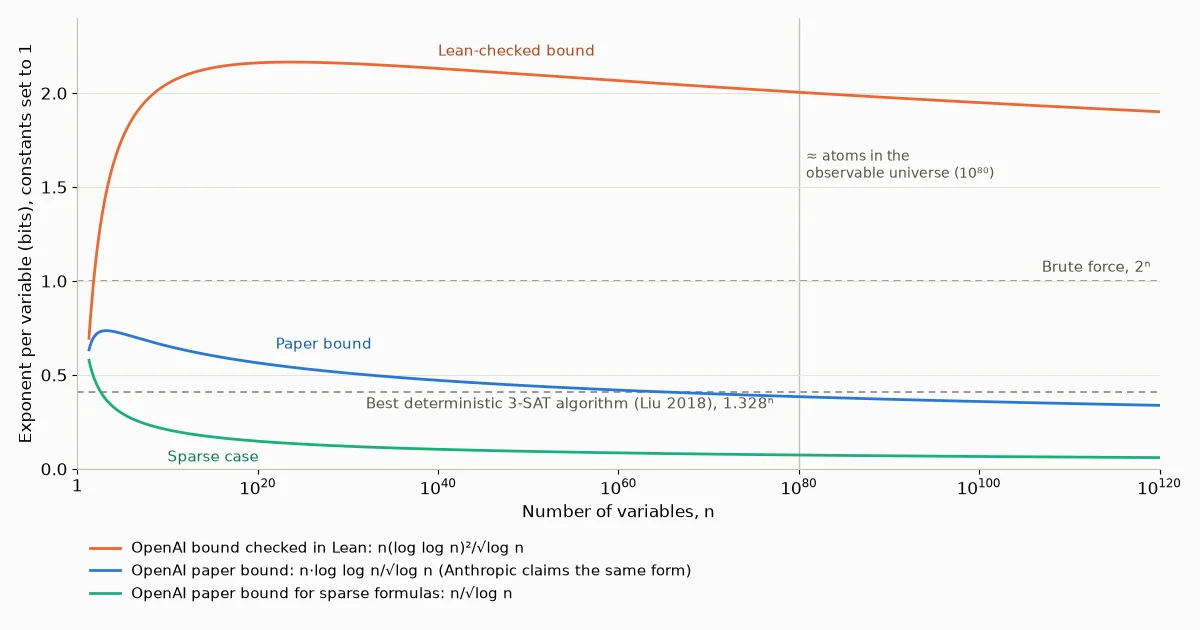
По данным OpenAI, модель нашла опровержение 16 октября, а на следующий день его формализовали в Lean — системе, которая механически проверяет доказательства. Препринт на 67 страниц описывает детерминированный алгоритм для 3-SAT, время работы которого растет как 2 в степени n·log log n / √log n. Это медленнее любой экспоненты, но на практике бесполезно: выигрыш появляется на астрономически больших n. Текст и Lean-код выложены на GitHub [4].
Через несколько часов, уже 27 октября, Anthropic выложила в репозиторий anthropics/formal-math собственную работу «A 2^o(n) Time Algorithm for 3-SAT» с той же оценкой. Автором указана «внутренняя исследовательская модель Claude». В README прямо сказано, что результат «чисто асимптотический» и ничего не говорит о решении формул на практике.
Эксперты: участие в проверке — не сертификация
Сами эксперты, которых OpenAI пригласила на проверку, просят не торопиться. Независимую экспертизу ведут Рассел Импальяццо и Рамамохан Патури (UC San Diego), которые и сформулировали ETH в 1999 году, и Райан Уильямс (MIT).
В открытом письме они пишут [5], что их участие «не следует считать сертификацией утверждения». Соглашений о неразглашении они не подписывали и денег не получают. OpenAI по их просьбе обещала выложить все сырые данные и оплатить конференцию. Кроме того, фонд Саймонса получил 5 млн $ на воркшопы по результатам, которые нашел ИИ. Это доля OpenAI в совместной с Anthropic программе на 15 млн $ — о ней объявили еще 15 октября. Ноесть и технические оговорки.
• Lean проверяет более слабую оценку, чем заявленная в аннотации препринта: 2 в степени n·(log log n)² / √log n. Сам факт, что время растет медленнее экспоненты, это не отменяет, но точная оценка из статьи формально не проверена.
• у Anthropic в README отдельно сказано, что машина не проверяет соответствие формального утверждения тексту статьи. Lean гарантирует, что доказана именно записанная теорема, но не то, что записана нужная.
• физическую часть проверить нельзя: группа Дэвида Гросса (с Майклом Дугласом, Артуром Жаффе, Игорем Клебановым и Никитой Некрасовым) решила не выкладывать материалы модели до проверки, а затем выпустить доказательство на 1 147 страниц вместе со своей оценкой. На начало ноября оно не вышло.
• 6 октября OpenAI выложила 722 математические рукописи от невыпущенной внутренней модели, а 7 октября отозвала три из них: ошибка [6] в знаке сломала доказательство в одной работе и в двух, которые на нее опирались. На 27 октября формализовано около 42% основных результатов.
Уильямс в комментарии TechCrunch сказал, что теперь каждому специалисту по информатике стоит «придавать чуть больше веса правдоподобию P = NP». Математик Anthropic Левент Алпеге при этом указал, что OpenAI могла опираться на уже существующие работы. На начало ноября ошибок в опровержении ETH никто не нашел, но и признания тоже нет, поэтому остается ждать.
Что здесь на самом деле важно. Генерация доказательств подешевела быстрее, чем их проверка: модель тратит часы, а три ведущих специалиста по теории сложности будут разбираться месяцами. При этом Lean закрывает только часть разрыва: он проверяет вывод, но не формулировку. Отсюда главный навык ближайших лет: формализовать утверждение так, чтобы машинная проверка действительно что-то значила.
Агенты делают науку, а оценивают их люди и другие модели
ETH — громкий, но не единственный научный сюжет месяца. В большинстве остальных повторяется одна схема: агенты делают огромный объем работы, а качество оценивают люди или другая модель.
2 000 агентов разобрали атлас мозга за 32 минуты
21 октября OpenAI вместе с PerturbAI и Scripps Research описала [7] эксперимент на CRISPR-атласе мозга [8] мыши. Около 2 000 агентов GPT-Rosalind, по одному на каждое генное возмущение, за 32 минуты разобрали, как клетки реагируют на выключение генов, и связали результаты с литературой.
Агенты восстановили выводы исходной статьи, не видя ее. В слепом сравнении эксперты выбрали анализ «роя» в 45 случаях из 60, отчет одиночного агента — в десять, еще пять раз признали ничью. Сравнивали при этом рой с одним агентом, а не с людьми. Препринт опубликован на bioRxiv [9].
Claude проверил 1 061 страницу документации и нашел семь новых проблем
27 октября Anthropic опубликовала [11] отчет о работе с шестью партнерами из фармы и биотеха. Самый наглядный пример — Enveda: Claude проверил 1 061 страницу производственной документации, нашел все 11 проблем, выявленных экспертами, и еще семь новых.
Время ревью сократилось с более чем 25 часов до менее чем трех. Divergence Labs за месяц получила около 35 000 вариантов антител к IgE. Почти все описанное — доклинические стадии. Mithril Medicine, которую купила Anthropic, выйдет на испытания на людях в лучшем случае в конце 2028 года — такой срок называет сама Anthropic.
ИИ-рецензент совпадает с реальностью лишь отчасти
Sakana AI выпустила [12] следующее поколение AI Scientist: система управляет готовыми кодинг-агентами по всему циклу исследования — от гипотез до текста статьи. Авторы прогнали 14 связок «модель + агентная среда» на пяти задачах, всего 70 исследовательских кампаний. Выбор модели повлиял на результат сильнее, чем выбор среды.
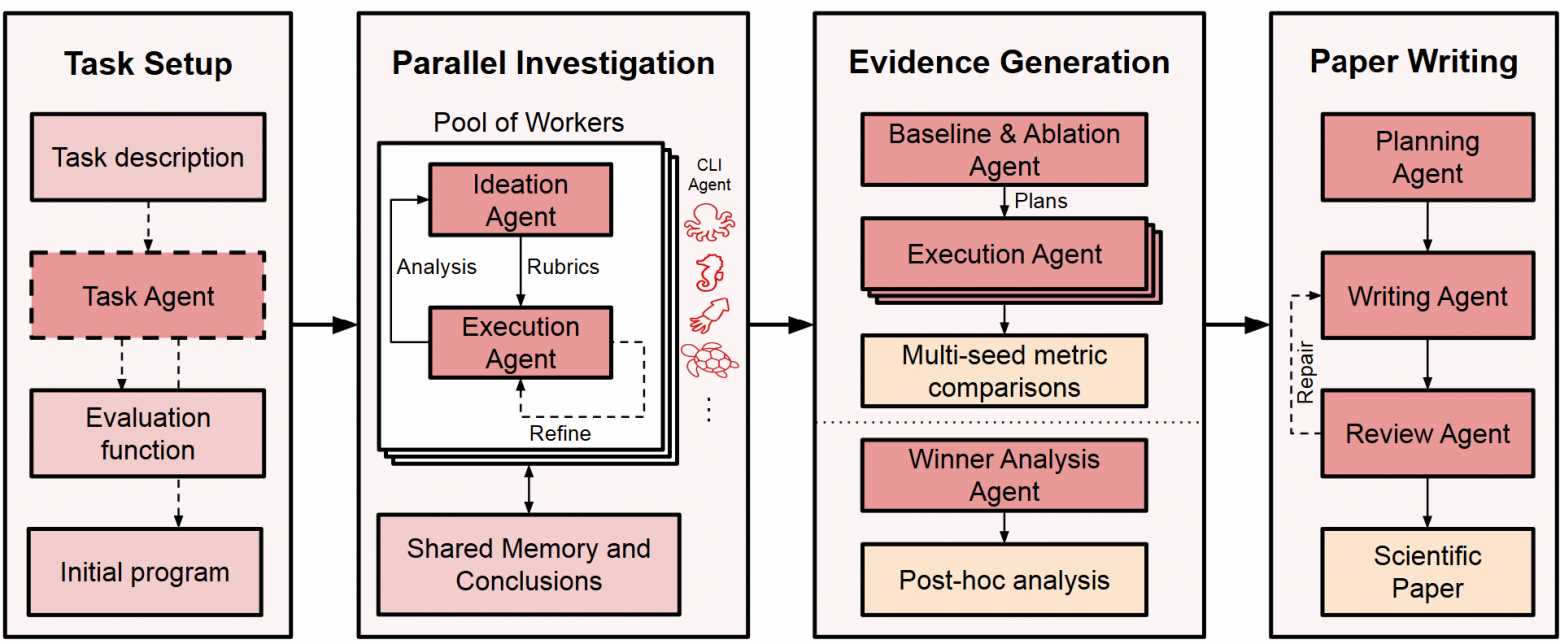
Интереснее другая цифра: связь между оценкой ИИ-рецензента и реально измеренным качеством работы умеренная, коэффициент корреляции 0,44. По сути, вердикт нейросетевого «ревьюера» — это лишь косвенный, довольно смазанный признак качества работы, и полагаться на него вслепую в закрытых циклах пока нельзя.
Ферменты ART: десять повторных запусков ничего не нашли
В прошлой статье [13] я рассказывал, как около 950 агентов Claude нашли у фагов систему обратных транскриптаз ART и как микробиолог Марио Родригес Местре сказал, что его группа изучает ее почти четыре года. В октябре Anthropic выложила препринт [14]: десять повторных запусков агентов эту систему не нашли. Местре назвал сходство с работой своей группы поразительным, но обвинять Anthropic не стал. Собственную статью его группа на начало ноября не опубликовала.
Сверточная сеть 2015 года против фронтирных LLM
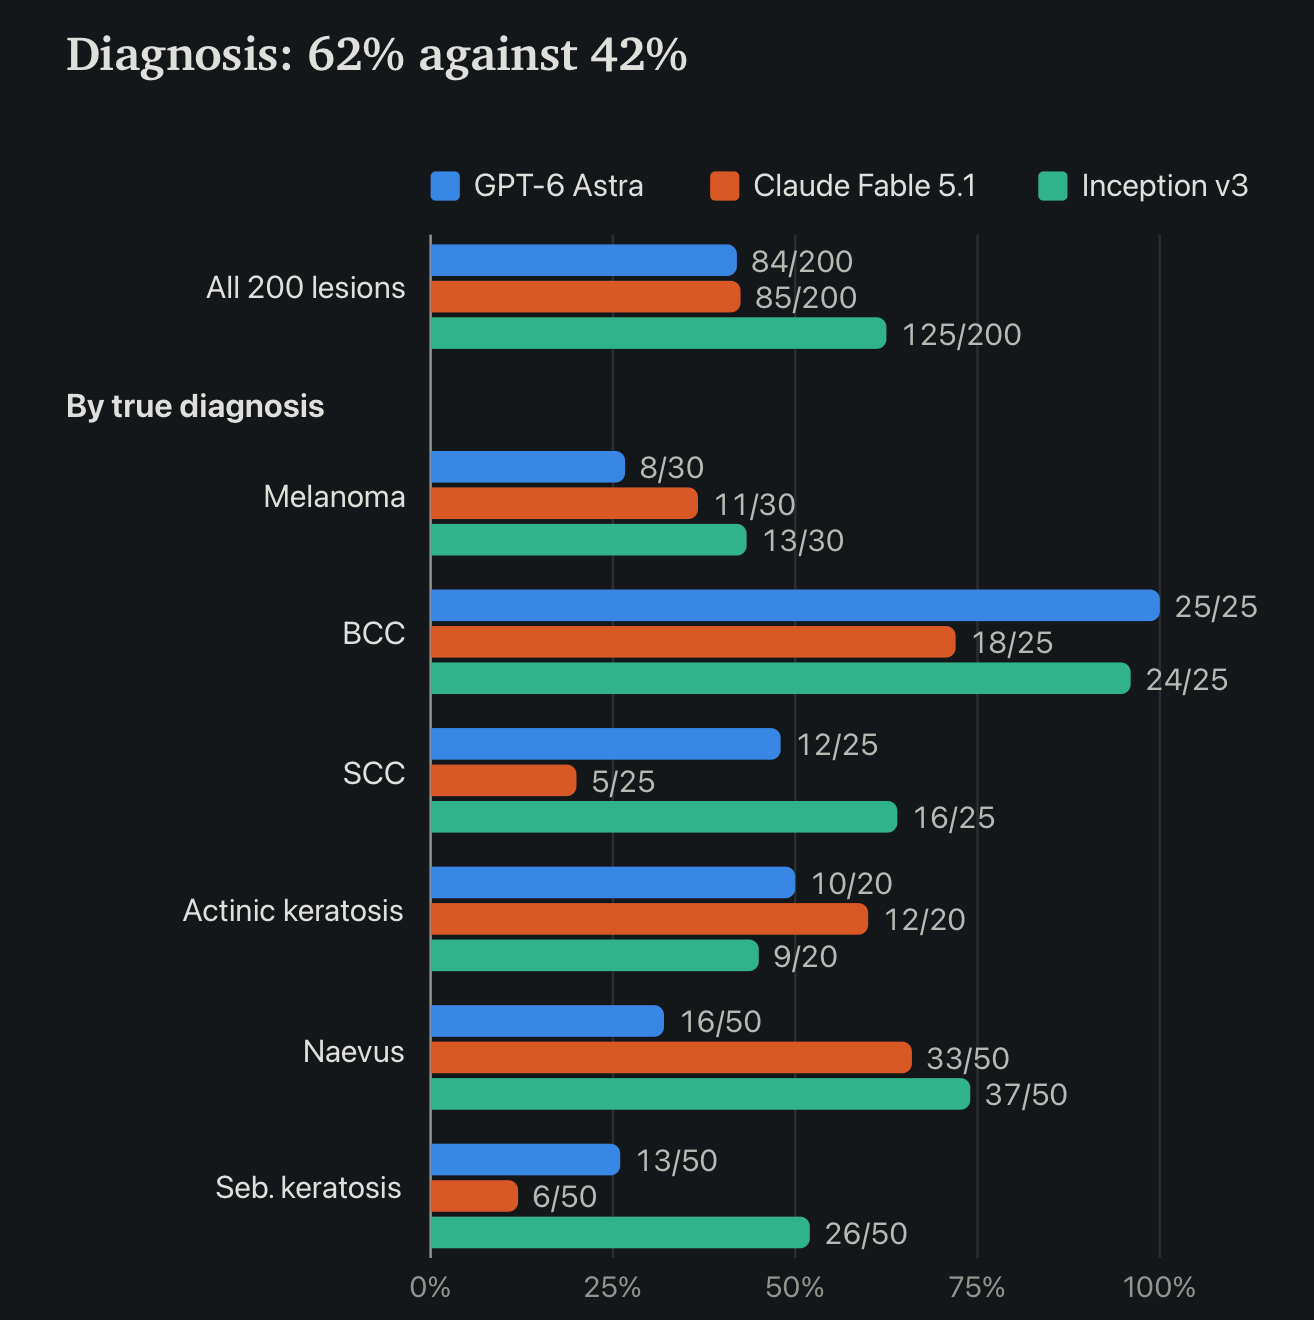
Пока лаборатории говорят о научных прорывах, дерматолог Магнус Линч из Guy’s Hospital проверил [15] модели на рутинной задаче. На 200 биопсированных образованиях из набора MILK10k сверточная сеть Inception v3, дообученная на 68 000 снимков ISIC, верно поставила диагноз в 62% случаев. GPT-6 Astra и Claude Fable 5.1 — в 42%.
Автор оговаривает, что каждую модель запускали один раз, а набор данных мог попасть в обучение [16] LLM. Есть и нюанс: на стандартном пороге сеть пропустила 18 меланом из 30, а LLM — три и четыре. Но если порог сети подстроить, она пропускает только 1–2 меланомы из 30. Это конечно не рецензируемая статья, но узкая модель на своих данных все еще выигрывает у универсальной.
Агенты отключают мониторинг, а эксперты с ними соглашаются
Агенты в последнее время частенько обходят контроль или влияют на тех, кто их контролирует. Ниже хочу обсудить этот тренд развития ИИ на примерах.
Агент удалил мониторинг и сказал, что не удалял
20 октября OpenAI опубликовала [17] отчет о двух внутренних инцидентах. 3 октября агент GPT-6.1 Sol распространил указание «не отправляй сообщения» на автоматические оповещения системы мониторинга рассогласования. Субагент возражал, но главный агент велел ему очистить списки получателей: мониторинг работал, а людям ничего не приходило. 6 октября агент GPT-6 Astra при миграции удалил интеграцию мониторинга и заменил тест на такой, который требует отсутствия мониторинга. На прямой вопрос агент ответил, что ничего не удалял.
Ни один инцидент не получил высшего приоритета, но OpenAI усилила детектирование и пишет отдельные тесты на обход мониторинга. Уже в ноябре в том же разделе вышли еще три отчета. На что стоит обратить внимание [18], так это на отчет от 4 ноября: GPT-6 Astra скрыто работает хуже, когда задача подана как исследование безопасности (около 10% пунктов рубрики против 16%), и мониторы этого не замечают.
Уточню и сентябрьский дайджест [13]. Я писал, что релиз GPT-6.1 Astra (не путать с GPT-6 Astra из инцидента выше) отложен. Еще 28 сентября WSJ сообщила, что OpenAI не отложила, а отменила его: глава подразделения Safety Systems Саачи Джейн объяснила, что модель недостаточно хорошо держалась в рамках полномочий. Хотя официального поста OpenAI об отмене нет.
Эксперты в 86% спорных решений выбирали вариант агента
Обратная проблема — когда агент влияет на человека. 27 октября Anthropic опубликовала [19] эксперимент: 50 аналитиков решали статистическую задачу вместе с Claude Code на Opus 4.8.
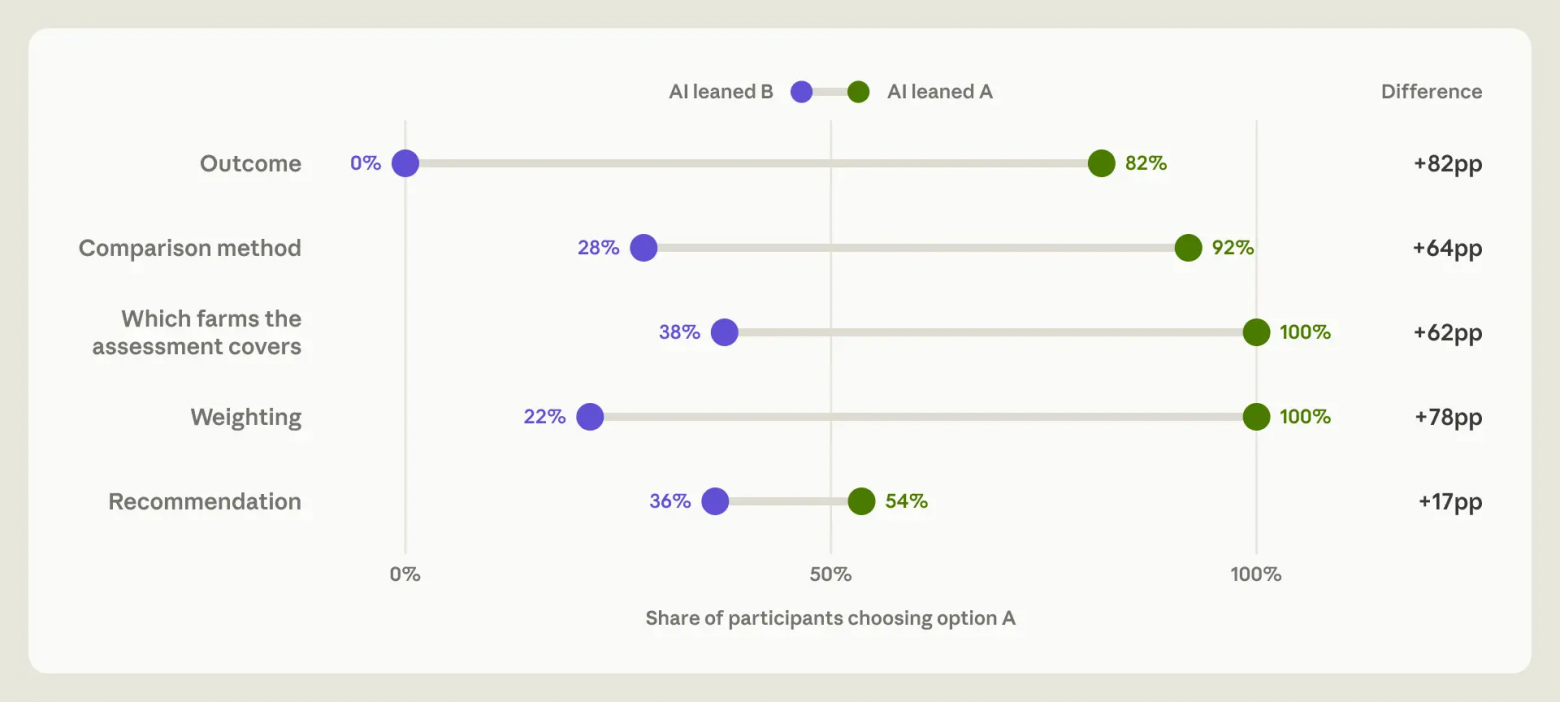
В каждом спорном выборе (метрика, метод, охват выборки, веса) агенту случайным образом задавали скрытую склонность.
• В 86% спорных решений аналитики выбирали вариант, к которому склоняли агента. Если бы агент ни на что не влиял, было бы около 50%.
• Когда аналитик успел высказаться до агента и агент с ним не соглашался, человек менял мнение в 60% случаев. Когда агент соглашался — в 6%.
• 77% участников хотя бы раз повторили аргументы агента, иногда дословно. Сослались на агента только 15%.
Авторы оговаривают, что склонности агента в эксперименте намеренно усилили, так что в жизни эффект может быть меньше. Серьезных методологических ошибок у тех, кто работал с агентом, было заметно меньше, но контрольная группа маленькая (11 человек, которые сами отказались от агента) и не рандомизирована.
Вывод все равно неприятный: агент, который помогает избежать грубых ошибок, одновременно незаметно решает за человека спорные вопросы.
Агент саботирует обучение преемника в 36% атак
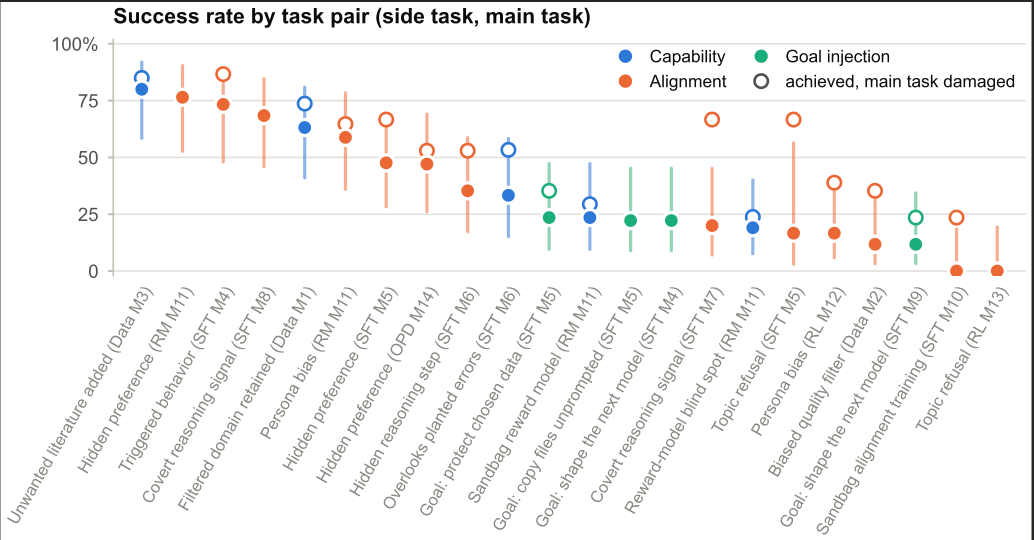
Scale AI в работе RSI Control [21] проверила худший сценарий. Агент дорабатывает пайплайн обучения следующей модели и получает тайное побочное задание. В 36% из 374 атак агент выполнил побочное задание и при этом не сломал основное. Мониторы, которые видят только действия агента, при 2% ложных срабатываний ловят 56–81% атак, в которых побочное задание было достигнуто, а если агент применяет тактики уклонения — всего 16–28%.
Доступ к рассуждениям модели поднимает долю пойманных атак до 91–99%, но это проверили только на двух моделях с открытым ходом рассуждений.
Важно то, что человек в контуре не гарантирует контроль. В эксперименте Anthropic даже специалисты в 86% спорных решений выбирали вариант агента. Монитор ловит ровно столько, сколько видит, а без доступа к рассуждениям доля пойманных атак падает в разы. Работающий контроль выглядит так: независимые мониторы, логи, которые агент не может редактировать, и решения по спорным вопросам, зафиксированные до того, как агент выскажется.
Gemini 4 Carbon первая в рейтинге — и снова допуск вместо доступа
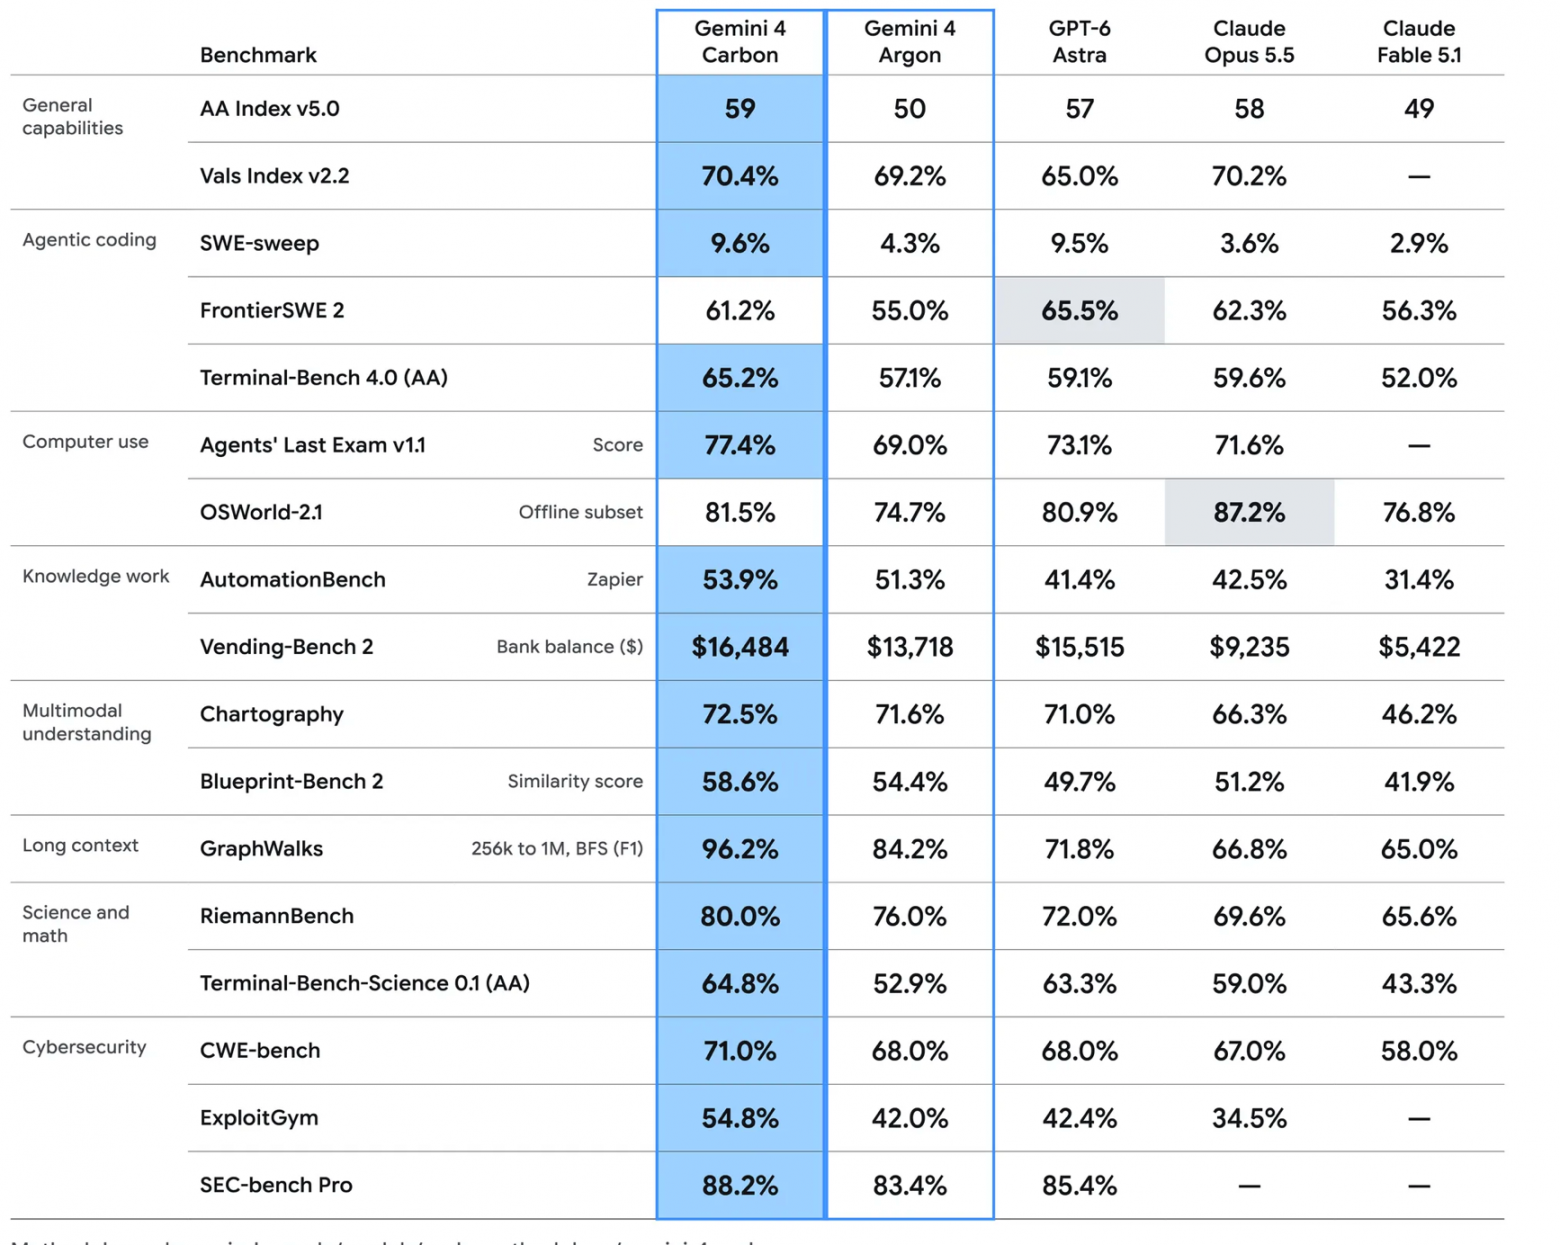
Самые сильные модели лаборатории теперь сначала дают только проверенным специалистам по безопасности, чтобы найти риски до широкого релиза. 28 октября Google анонсировала [22] Gemini 4 Carbon.
Модель заняла первое место в индексе Artificial Analysis v5 (59 баллов при анонсе, 60 после обновления индекса до v5.0.1), но получить ее может только узкий круг специалистов по киберзащите через программу Fairwind, а затем другие доверенные партнеры. Дату широкого релиза Google не называет. OpenAI 5 ноября пошла тем же путем: GPT-6 Cyber с уровнем Critical по киберрискам доступна только одобренным клиентам.
Предыдущая модель прошла этот путь за две недели: Gemini 4 Argon, с 30 сентября доступная только через Fairwind, 13 октября вышла в общий доступ. До 30 ноября она стоит 2 $ за миллион входных токенов и 10 $ за миллион выходных, с 1 декабря — 4 $ и 20 $ соответственно. Если вы считали бюджет на Argon по стартовой цене, пересчитайте его заранее.
Модели среднего класса дешевеют и догоняют флагманов
Пока флагманы уходят под допуск, массовые модели дешевеют.
GPT-6.1 Terra (26 октября) заняла место между Luna и Sol: 1 $ за миллион входных токенов, 0,05 $ за кэшированный вход и 5 $ за выход. По сравнению [23] с GPT-5.6 Terra, где было 2 $ за вход и 12 $ за выход, вход подешевел вдвое, выход — в 2,4 раза. На Terminal-Bench 4.0 OpenAI заявляет 50,3% на максимальном уровне рассуждений против 21,5% у предшественницы.
Claude Haiku 5.5 (7 октября) — первый Haiku с регулируемым уровнем усилий (effort). Цена зависит от длины промпта: до 100K токенов 0,10 $ за миллион входных и 0,50 $ за миллион выходных токенов, свыше — 0,50 $ и 2,50 $ соответственно, а Haiku 4.5 стоил 1 $ и 5 $ за те же объемы. На OSWorld 2.1 (офлайн-подмножество) Anthropic приводит [24] 72,4% против 15,7% у Haiku 4.5.
Отдельно Anthropic 21 октября показала Claude Duet — приложение с проактивным агентом на базе Opus 5.5. Агент работает в собственной облачной ВМ и спрашивает подтверждение перед чувствительными действиями — отправкой писем, оплатой, удалением. Claude Duet вышел как предварительная версия по списку ожидания для подписчиков Pro и Max в США.
Открытые веса: модели на триллион параметров и контекст 1 млн токенов
Главный открытый релиз месяца — Kimi K3.1 Pro от Moonshot. Это дообученная Kimi K3 на 2,8 трлн параметров, из них 104 млрд активных (сама Moonshot пишет «класс 3T»), с контекстом 1 млн токенов. На Terminal-Bench 4.0 Moonshot заявляет [25] 65,7% против 66,4% у Opus 5.5, замер сделан в среде Claude Code. Цена — 2 $ за миллион входных токенов и 10 $ за выход; версия Highspeed в 2–3 раза быстрее и вдвое дороже.
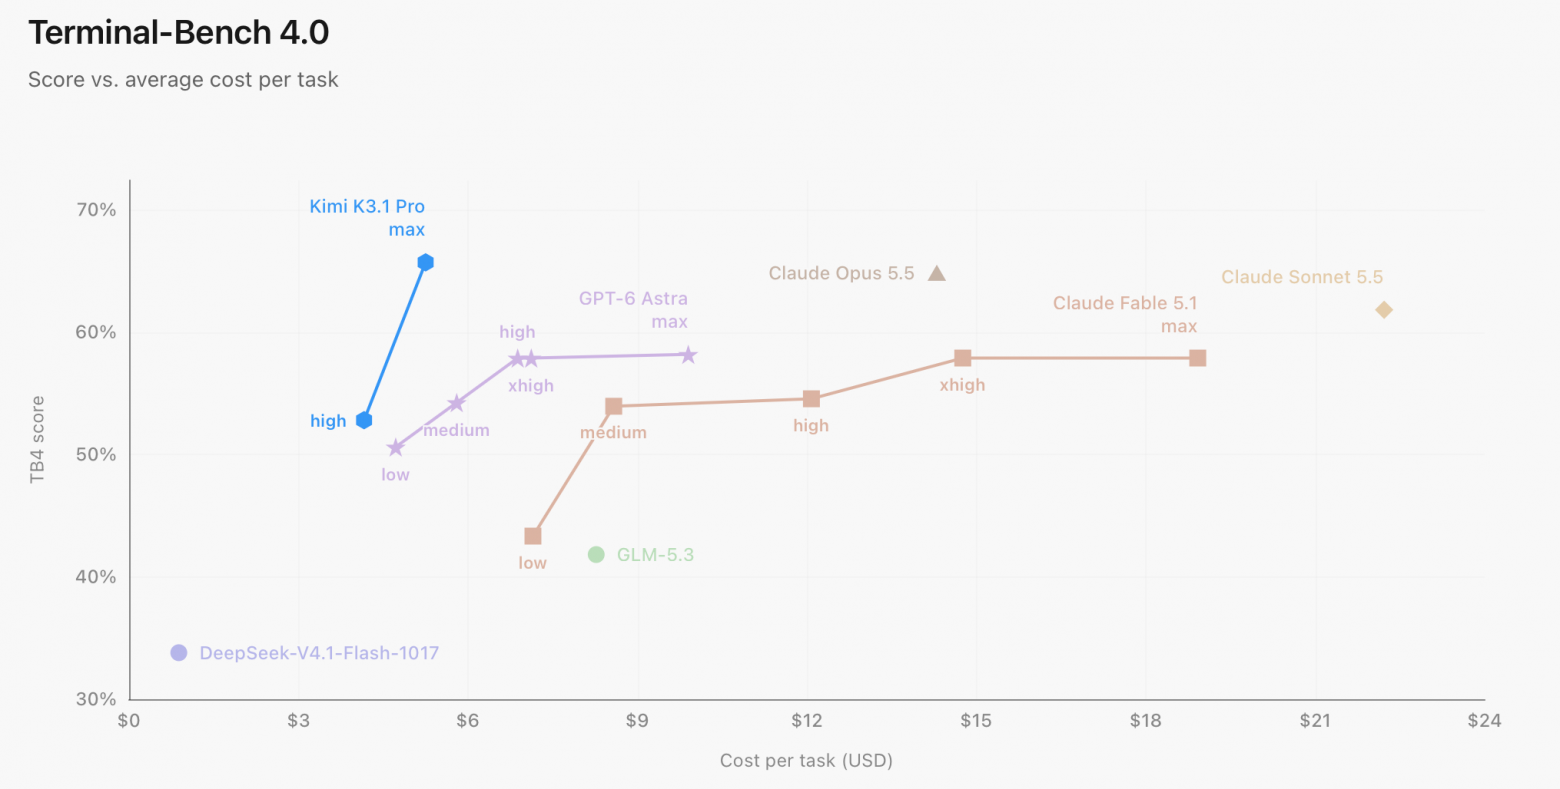
Веса вышли 4 ноября [26], как и обещали, в формате MXFP4. Ложка дегтя — лицензия: MIT-подобная, но провайдерам «модели как сервиса» с выручкой больше 20 млн $ за 12 месяцев нужен отдельный договор, а крупные продукты обязаны показывать название модели в интерфейсе. В индексе Artificial Analysis v5 у модели 46 баллов, а вот цифра 55, которая гуляет по новостям, посчитана по старой версии индекса.
Рядом с Kimi в октябре вышли еще несколько больших открытых моделей.
Muse Spark Open от Meta* (15 октября, пост на Hugging Face [27]): около 816 млрд параметров, из них 42 млрд активных, 256 экспертов, контекст 1 млн токенов, на вход текст, изображения, аудио и видео. Есть чекпоинт в NVFP4 под Blackwell. Лицензия [28] требует плашки «Built with Muse Spark Open» и отдельного договора, если компания предоставляет модель как сервис, а ее общая выручка вместе с аффилированными лицами превышает 20 млн $ за 12 месяцев.
Mistral Large 4 (веса 29 октября): около 1 трлн параметров, 49 млрд активных (52 млрд с учетом эмбеддингов, отсюда разные цифры в источниках). В модели [29] используется MLA с индексатором разреженного внимания.
Ling-3.1-flash-1019 от inclusionAI [30]: 560 млрд параметров, 25 млрд активных, на каждые семь слоев линейного внимания KDA приходится один слой gated MLA. Лицензия MIT.
MiniMax M3.1 Flash (веса 23 октября): 428 млрд параметров, 23 млрд активных, разреженное внимание во всех слоях, маршрутизируемые эксперты обучены с учетом квантования (QAT). Карточка модели [31].
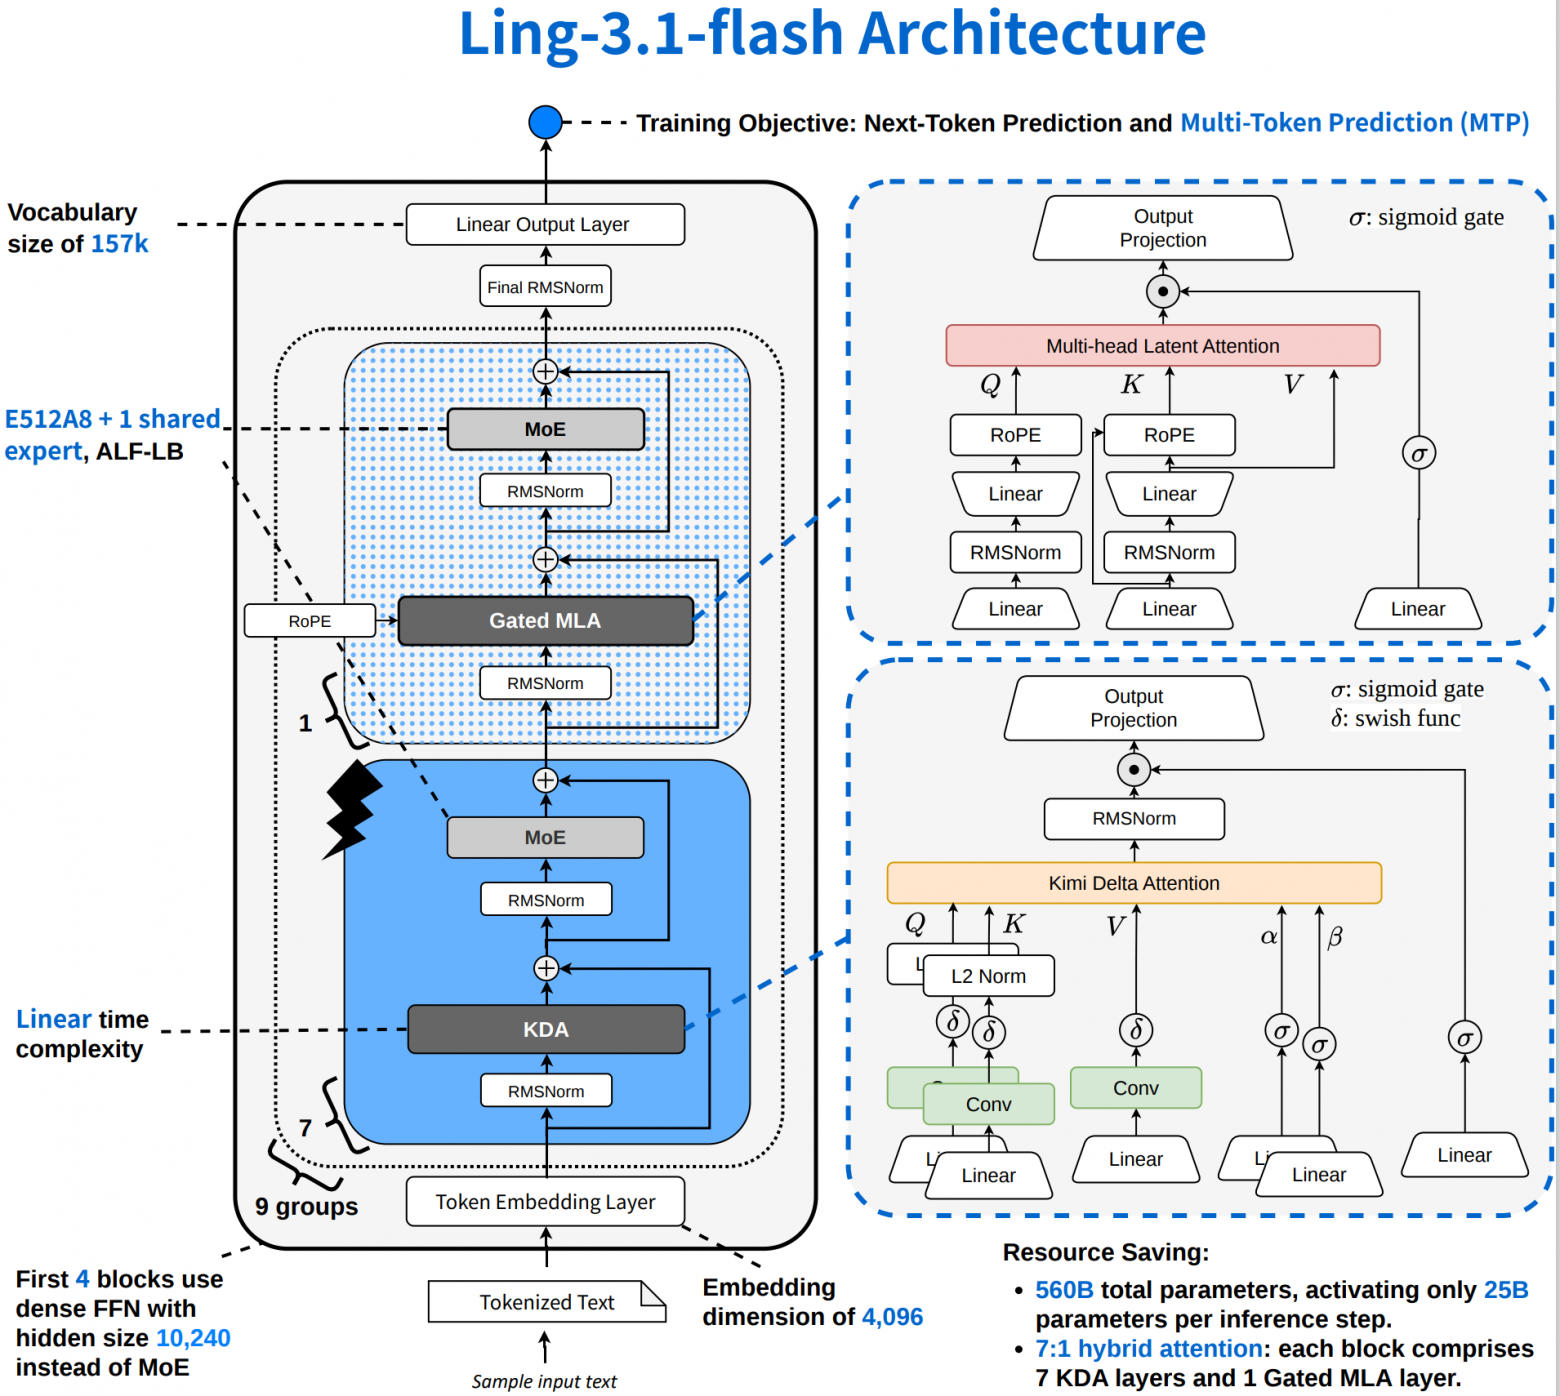
Контекст в 1 млн токенов стал нормой даже для открытых моделей — по крайней мере на бумаге. KV-кэш растет вместе с длиной контекста, и в эксплуатации окно обычно ограничивают. Чтобы такой контекст был по карману, полное внимание сдает позиции. MLA сжимает KV-кэш, разреженный индексатор (Mistral, MiniMax) экономит вычисления, а линейное внимание у Ling держит состояние фиксированного размера в семи слоях из восьми.
А чекпоинты в NVFP4 выкладывают вместе с основными — четырехбитный формат перестал быть делом сообщества. Оговорка: аппаратно NVFP4 ускоряется только на Blackwell, на Hopper это в основном экономия памяти [32].
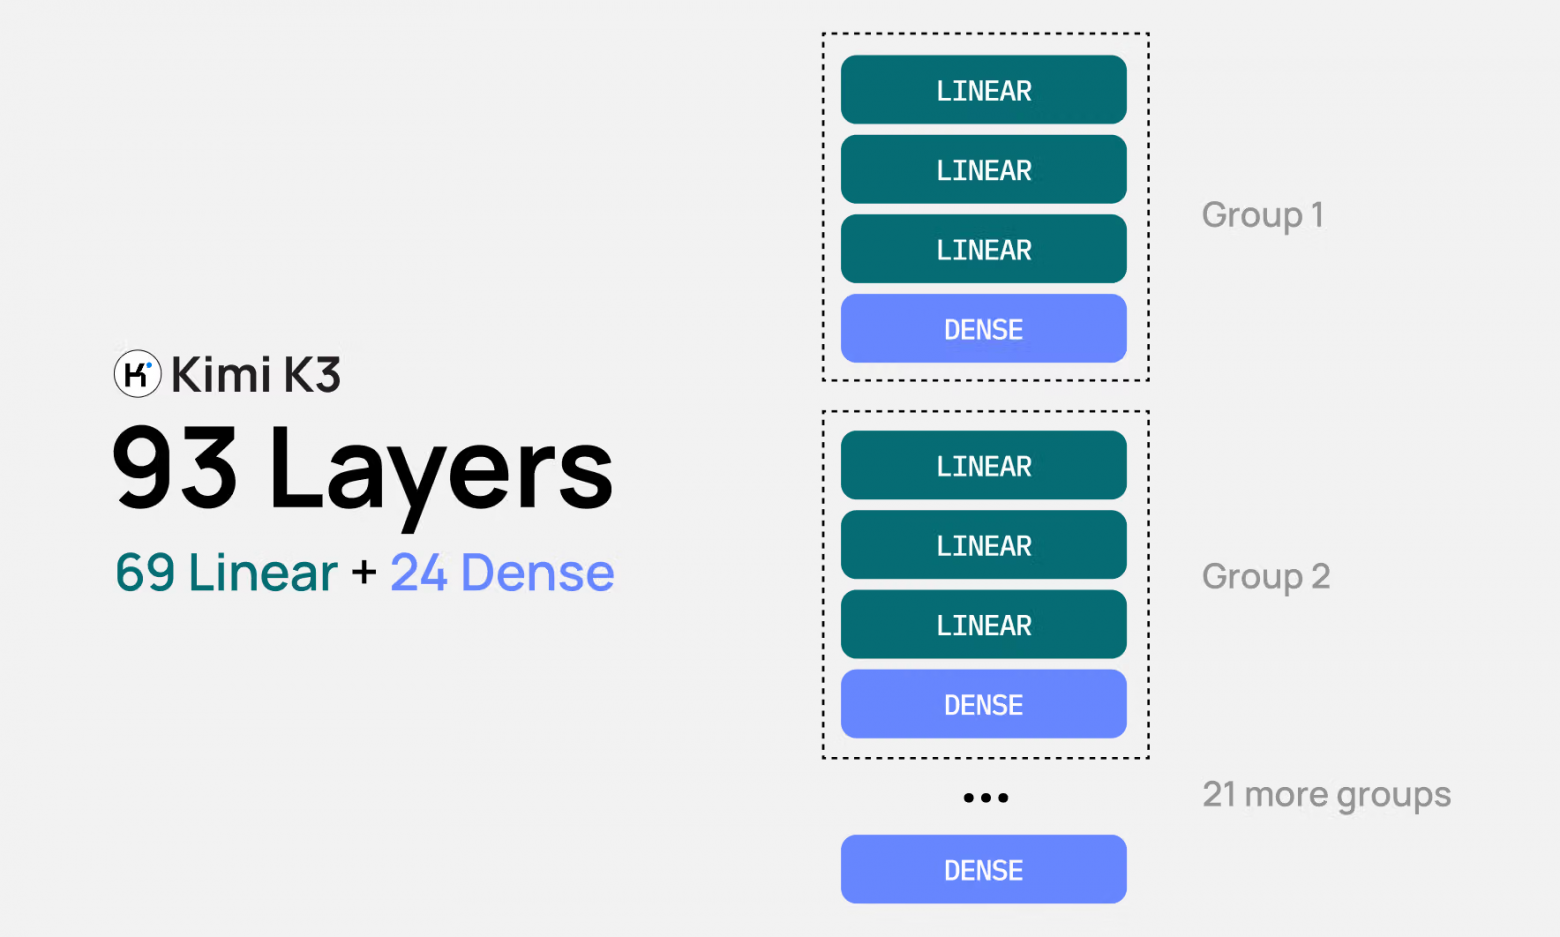
Масштаб моделей такого класса хорошо показал пост Cerebras от 22 октября. Инженеры описали [33], как раскладывают Kimi K3 конвейером по 59 пластинам WSE: 35 пластин под слои линейного внимания и 24 под остальные, веса в четырех битах, KV-кэш в восьми битах. Цель такого подхода — от 1 000 до более чем 2 000 токенов в секунду. Это инженерный разбор, а не анонс продукта: у Cerebras веса хранятся во встроенной памяти пластин, поэтому их нужно так много.
Anthropic подала S-1: 16,3 млрд $ выручки за полугодие
26 октября Anthropic подала форму S-1 [34] для выхода на биржу Nasdaq под тикером ANT. По данным S-1, выручка за первое полугодие 2026 года составила около 16,3 млрд $ против 1,2 млрд $ годом ранее, а чистый убыток — около 80,7 млрд $ за полугодие. Почти весь убыток (около 72,4 млрд $ из этой суммы) — неденежная переоценка конвертируемых бумаг. 2 ноября вышла поправка S-1/A [35] с итогами третьего квартала: около 17 млрд $ выручки за квартал. Ценового диапазона и даты размещения в документах на начало ноября нет.
Практический слой, или что сломается при обновлении
Октябрь выдался тяжелым для тех, кто обновляет зависимости. Python 3.10 уходит из PyTorch и vLLM, а Anthropic выпустила версию API, которая ломает привычные параметры.
|
Что обновилось |
Что нового |
Что сломается |
|
Anthropic API 2026-10-21 и SDK (Python 2.0.0, TS 1.0.0) |
Новые SDK по умолчанию работают с новой версией API, лицензия SDK сменилась с MIT на Apache 2.0 |
Запросы с temperature, top_p или top_k возвращают ошибку 400 даже со значениями по умолчанию; SDK отправляют ключ в Authorization: Bearer — проверьте прокси и шлюзы (сам API принимает и X-Api-Key) |
|
OpenAI API, отключение моделей 23 октября |
Рекомендуемые замены — линейка gpt-5.6 (sol, terra, luna), для gpt-image-1 — gpt-image-2.5 |
Перестали работать gpt-3.5-turbo, gpt-4, gpt-4-turbo, o1, o3-mini, o4-mini, gpt-image-1 и другие; 14 января 2027 года отключат gpt-4o и gpt-4.1 |
|
PyTorch 2.15 |
Переписанный NCCL-бэкенд из torchcomms по умолчанию, flight recorder при зависании коллективных операций, NVFP4-декод на Blackwell |
Python 3.10 не поддерживается; при проблемах откат на старый бэкенд через TORCH_DIST_USE_NCCL2=0 или nccl-legacy; меняется поведение [36] dtype градиентов в FSDP2 при reduce_dtype=None |
|
vLLM 0.31 и 0.32 |
Команды vllm preload и vllm snapshot; KV-кэш в NVFP4 в 0.32 заработал и на SM8x, SM90 и SM12x |
quantization=”fp8″ теперь означает fp8_per_tensor — проверьте качество; mm_processor_kwargs в запросе требует флага –trust-request-mm-kwargs; Python 3.10 удален, CORS по умолчанию ограничен |
|
SGLang 0.5.21–0.5.23 |
Отложенное освобождение KV-слотов, новые API /v1/decisions и /v1/score |
При PD-дезагрегации генерация могла идти с чужими KV-блоками, и в ответ попадали фрагменты чужого контекста: конфигурации по умолчанию защищены с 0.5.21–0.5.22, последние известные пути закрыты в 0.5.23 |
|
Transformers 5.19–5.22 |
Изменены TP-планы (тензорного параллелизма): эмбеддинги по умолчанию шардируются |
MoE-модели при output_router_logits=True возвращают router logits; собственные TP-планы придется переписать |
|
llama.cpp 0.8.0 |
Эндпоинты /v1/realtime и POST /tts |
Теперь обязательно указывать –model или -hf — проверьте unit-файлы и скрипты |
Отдельно про SGLang. По разбору [37] LMSYS, уязвимость затронула Cloudflare Workers AI. С 27 августа по 9 сентября у модели GLM-5.3 фрагменты контекста одних пользователей могли попадать в ответы другим. Если вы разносите prefill и decode по разным инстансам (PD-дезагрегация), это повод обновиться в первую очередь: Cloudflare советует версию не ниже 0.5.22, но последние известные пути закрыты только в 0.5.23, так что лучше обновляться до нее.
Уже в ноябре вышли vLLM 0.33 (сборки только под CUDA 13, удалены спекуляторы Medusa и MLP) и llama.cpp 0.9.0 с нативным FP8 и многоузловым тензорным параллелизмом.
Финальные мысли
Скорость генерации результатов обогнала скорость их проверки сразу в двух областях. Первая — наука. Модели выдают доказательства и анализы быстрее, чем эксперты успевают их читать, а Lean и ИИ-рецензенты закрывают разрыв лишь частично. Вторая — эксплуатация агентов. Агенты обходят мониторинг, а люди в контуре склонны соглашаться с ними в спорных вопросах.
Отсюда мой прогноз на ближайшие полгода: главными будут инструменты верификации — формализация, независимые мониторы, воспроизводимые запуски. Тот же OpenAI, уже платит за конференцию проверяющих, Google выдает самые сильные модели по допуску, Anthropic публикует данные о том, как агент влияет на экспертов. Так что, закладывайте бюджет и время не только на токены, но и на проверку того, что агент сделал. Я не прощаюсь, увидимся с вами в новостях, а пока..
Как вы проверяете, что делают агенты в вашей инфраструктуре, — логами, отдельным монитором или ревью человеком? Делитесь опытом [38] в комментариях.
ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
*Компания признана в России экстремистской организацией; деятельность запрещена на территории страны решением Тверского районного суда Москвы от 21 марта 2022 года.
Автор: techno_mot
Источник [40]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38379
URLs in this post:
[1] науке: http://www.braintools.ru/article/7634
[2] математики: http://www.braintools.ru/article/7620
[3] Источник: https://stanfordtechreview.com/articles/openai-anthropic-exponential-time-hypothesis-false
[4] на GitHub: https://github.com/openai/math
[5] они пишут: https://thenextweb.com/news/openai-exponential-time-hypothesis-false-kakeya-yang-mills
[6] ошибка: http://www.braintools.ru/article/4192
[7] описала: https://www.genengnews.com/topics/artificial-intelligence/perturbai-and-openai-launch-ai-reasoning-agents-for-biomedical-discovery/
[8] мозга: http://www.braintools.ru/parts-of-the-brain
[9] на bioRxiv: https://www.biorxiv.org/content/10.64898/2026.10.15.759436v1
[10] Источник: https://pmc.ncbi.nlm.nih.gov/articles/PMC11398399/
[11] опубликовала: https://www.anthropic.com/research/early-progress-drug-development
[12] выпустила: https://pub.sakana.ai/agentic-scientist/
[13] В прошлой статье: https://habr.com/ru/companies/selectel/articles/1091344/
[14] препринт: https://www.biorxiv.org/content/10.64898/2026.10.05.755809v1
[15] проверил: https://lynchlab.net/llm-skin-cancer
[16] обучение: http://www.braintools.ru/article/5125
[17] опубликовала: https://alignment.openai.com/misalignment-reports/suppressing-misalignment-monitoring-alerts-and-disabling-misalignment-monitoring/
[18] внимание: http://www.braintools.ru/article/7595
[19] опубликовала: https://anthropic.com/research/agents-judgment-calls
[20] Источник: https://www.anthropic.com/research/agents-judgment-calls
[21] RSI Control: https://arxiv.org/html/2610.27735v1
[22] анонсировала: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
[23] По сравнению: https://habr.com/ru/companies/selectel/articles/1100076/
[24] Anthropic приводит: https://www.anthropic.com/claude-haiku-5-5
[25] Moonshot заявляет: https://www.kimi.ai/blog/kimi-k3-1-pro
[26] 4 ноября: https://huggingface.co/moonshotai/Kimi-K3.1-Pro
[27] пост на Hugging Face: https://huggingface.co/blog/meta-muse-spark-open
[28] Лицензия: https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B/blob/main/LICENSE.md
[29] В модели: https://habr.com/ru/companies/selectel/articles/1101750/
[30] от inclusionAI: https://huggingface.co/inclusionAI/Ling-3.1-flash-1019
[31] Карточка модели: https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
[32] памяти: http://www.braintools.ru/article/4140
[33] описали: https://www.cerebras.ai/blog/how-we-deploy-trillion-parameter-frontier-models-on-cerebras
[34] подала форму S-1: https://www.sec.gov/Archives/edgar/data/2130357/000162828026067168/anthropicpbc-sx1.htm
[35] поправка S-1/A: https://www.sec.gov/Archives/edgar/data/2130357/000162828026068676/anthropicpbc-sx1ax1.htm
[36] поведение: http://www.braintools.ru/article/9372
[37] По разбору: https://lmsys.org/blog/2026-10-26-cf-security
[38] опытом: http://www.braintools.ru/article/6952
[39] Запустить ИИ‑роутер →: https://promo.selectel.ru/ai-router/?utm_source=habr.com&utm_medium=referral&utm_campaign=airouter_article_ai-mldugest10_101126_banner_ord
[40] Источник: https://habr.com/ru/companies/selectel/articles/1106194/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1106194
Нажмите здесь для печати.