Агенту мало дать доступ к коду. Как мы перенесли процесс команды в хуки и гейты
Привет! Меня зовут Валерий Почтарёв, я развиваю инструменты антифрода и отвечаю за систему контроля доступов пользователей в Авито [1]. Этот материал будет полезен тем, кто внедряет агентов в разработку и упирается в то, что они забывают [2] процессы. Спойлер: мы заставили агентов работать предсказуемо, когда перенесли контроль на уровень детерминированных runtime-ограничений.
На старте кажется, что достаточно написать подробные инструкции в AGENTS.md, добавить правила про чистый код и обязательные тесты и дать агенту доступ к кодовой базе. Но в сложном контексте агент легко забывает или обходит текстовые правила в AGENTS.md. Чтобы он их не игнорировал, ему нужен командный слой контекста и жёсткие гейты в runtime, которые он физически не может обойти.
Мы в команде Checks (Antifraud) собрали такой сетап — af-checks-context. Сейчас мы раскатываем его с моего личного использования на всю команду, чтобы быстро шарить контекст и автоматизировать процессные договорённости. Расскажу, на чём мы обожглись и почему в какой-то момент его пришлось почистить.
Содержание
-
Почему агент теряет контекст и сдаёт работу без доказательств [3]
-
Сравнение метрик: без агента, с агентом, с агентом и стором [10]
-
Выводы [11]
Почему агент теряет контекст и сдаёт работу без доказательств
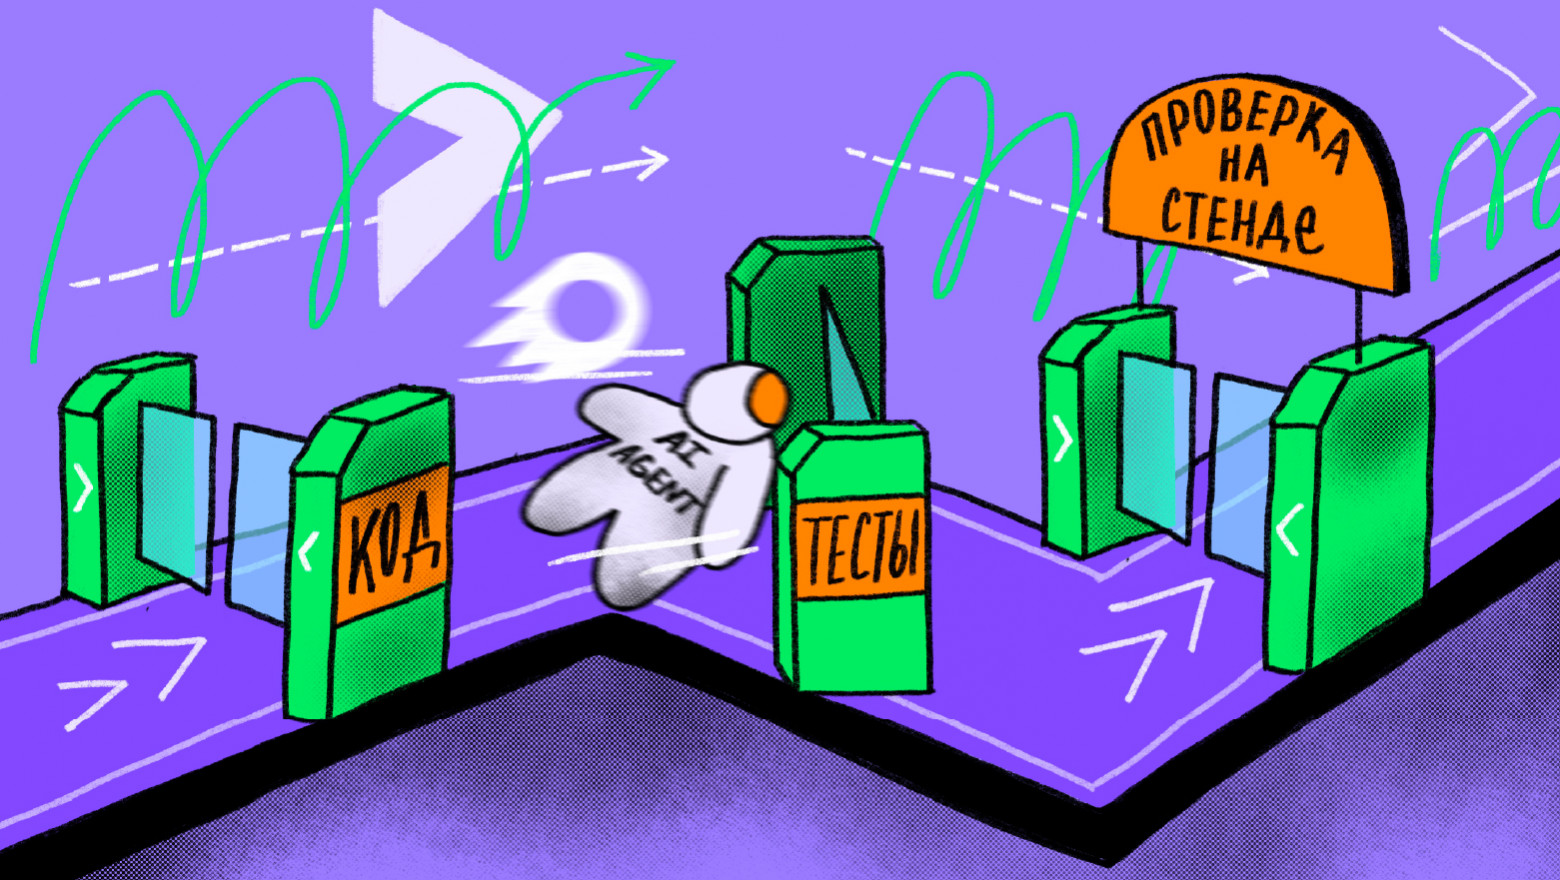
Проблема в том, что знания команды живут в TDR, рабочих тредах и головах разработчиков. Для агента эта информация невидима. Ограниченный рамками одного репозитория, он физически не способен учесть межсервисные контракты и скрытый контекст.
В рамках длинных сессий цель «завершить задачу» подавляет инструкцию «сначала согласуй изменения». Накопленный контекст при разрыве сессии теряется. История чата с уточнениями и поправками человека рано или поздно удаляется, а статусы в трекерах начинают отставать от реальной картины.
Ситуация усугубляется тем, что если один и тот же агент пишет код и проверяет его, проверка превращается в подгонку результата под уже написанное.
Далее мы рассмотрим, как предлагаемый сетап решает эти проблемы.
Стор и пайплайн задачи
Основа сетапа — af-checks-context, отдельный git-репозиторий команды. У нас он называется стором. Там лежит всё, что нужно знать до того, как начнёшь смотреть в код: проекты и фичи (Onepager, TDR, исследования, дизайн), база знаний команды, спецификации сервисов и описание процесса.
Сессия агента стартует в сторе. Репозитории сервисов лежат в соседних каталогах. Поэтому контекст команды агент читает раньше кода, и для межсервисной задачи больше не надо заранее решать, какой репозиторий «главный».
Пайплайн задачи: карточка в Jira → план → реализация → проверка на kbranch со свидетельствами → архив. kbranch — стенд, куда ветка сервиса выкатывается отдельно от остальных.
flowchart LR

    J[Карточка в Jira] --> P[Change и план]

    P --> A1{{Одобрение 1}}

    A1 --> C[Код + e2e]

    C --> K[Прогон на kbranch]

    K --> A2{{Одобрение 2}}

    A2 --> PR[PR на ревью]

    PR --> M[Мерж]

    M --> AR[Ретро и архив]
Внутри пайплайна процесс разбит на три этапа:
-
Агент заводит change: спеку, дизайн, задачи с разбиением по PR и тест-план. Человек одобряет план — это точка 1. До неё код трогать нельзя.
-
Перед PR на ревью человек одобряет итог — это точка 2: дифф плана с точки 1, результат прогона на kbranch, описание PR.
-
Спека задачи вливается в накопленные спецификации сервиса.
Позицию по задаче вычисляет не модель, а детерминированный скрипт движка по артефактам: есть ли change, одобрен ли план, есть ли worktree и коммиты, открыт ли PR, смержен ли он, есть ли отчёт проверки. Текущий шагом является первый шаг с непройденным гейтом. Хук кладёт позицию в контекст агента на каждую реплику с упомянутой задачей. Одобрение человека — это единственный факт, который нельзя вывести из артефактов. Мы материализуем его отдельно (ниже расскажу о том, как мы это делаем).
Изменения проверяются на стенде со свидетельствами. До гейта kbranch проверки на стенде у нас не было вообще. Идею мы взяли из внутреннего скилла для проверки на стенде и дополнили e2e. Тест-план делит кейсы на автоматические (e2e) и ручные. Кейс по умолчанию автоматический. Ручной допускается, только если рядом записана причина, по которой не сделан автотест: например, наблюдение по метрике, особая сборка или одноразовые данные. Если причины нет, значит, план не доделан.
e2e создаются параллельно с кодом. Ветки кода и тестов связываются через ключ задачи, при этом прод для запуска тестов не нужен. Ревью сервисного PR начинается только после прогона на kbranch. Сбои e2e, вызванные окружением, фиксируются со статусом FAIL и указанием причины. Переводить автотесты в ручной режим ради зелёного статуса отчёта нельзя.
Отчёт машина читает по двум полям: вердикт (строго pass) и хэш проверенного коммита. Любой коммит задачи после этого хэша делает отчёт устаревшим.
Мы изолируем каждую задачу в отдельном worktree от свежего master. Ветка не от актуального master уже стоила нам переделанной работы, поэтому new-worktree.sh всегда делает fetch и строит ветку от origin/master.
Старшая модель держит контекст задачи, планирует ход работы и проверяет результат, в то время как младшие решают узкие подзадачи в своих собственных изолированных контекстах. Проверку на стенде делает не тот же агент, который писал код, а отдельная сессия или сабагент без истории реализации.
У каждого разработчика есть локальная память [12] агента: факты из прошлых сессий, которые ищет агент, прежде чем разбираться в незнакомом сервисе. Но эта память личная и коллегам она не видна. Поэтому у нас такое правило: если знание может пригодиться кому-то из команды или его агенту, оно идёт в knowledge/ стора через PR. А в личной памяти мы пишем только свои предпочтения и догадки.
Природа модели вероятностна, поэтому одно и то же правило может быть как учтено, так и проигнорировано. Стор делает работу агента предсказуемой. Позиция считается скриптом, гейты держат переходы между шагами, а решения по плану через одобрение принимаются человеком. Проверки и записи, которые раньше выполняла модель, теперь выполняют команды и хуки. Модели остаётся то, что требует суждения: разговор о решениях, код, разбор находок.
Процессы команды в едином репозитории
Раньше процессы жили в личных заметках, головах и страницах Confluence, которые расходились с практикой. Теперь процесс представлен в виде кода в том же сторе.
Пайплайн построен на декларативном подходе: шаги и гейты конфигурируются через YAML, а сами гейты реализованы как небольшие Python-проверки, которые подключаются по имени. Поддерживаются пять сценариев: задача, облегчённая задача без спеки (применяется для хотфиксов), проект, фича и исследование.
Изменение процесса — это PR. Процесс и контент приземляются разными PR. История решений и по задачам, и по процессу остаётся в git. Контент — это знания и контекст: сюда входят спеки и планы задач, документы проектов и фич, база знаний команды. Агент приземляет его по ходу работы и сам ставит PR на автослияние, чтобы следующий агент или коллега сразу видели актуальное состояние. Процесс — это правила игры: скрипты, хуки, пайплайны, настройки агента. Такой PR сливает только человек.
Проверки детерминированы. Перед пушем посадочный скрипт локально прогоняет линтер стора, валидацию пайплайнов и тесты затронутых частей, а результат дописывает в описание PR. Бот стора сверяет этот итог с головой PR и решает, процессный PR или контентный. Модель в боте ревьюит только контент и может лишь позвать человека.
Схемы не расходятся с процессом. Mermaid-схемы пайплайнов в документах генерируются из YAML, линтер падает, если схема разошлась с декларацией.
Движок отделён от профиля команды. Ядро ничего не знает о нашей команде: Jira, стенд и имена сервисов живут в профиле. Границу держит тест — в ядре нельзя упоминать ни трекер, ни компанию, ни стенд. Другая команда может взять движок и подключить свой профиль.
Процесс исполняет агент на каждой задаче, а следят за ним линтер и хуки. Поэтому регламент не расходится с практикой: если правило перестало работать, его меняют PR-ом, а не устной договорённостью.
Почему спеке не место в репозитории сервиса
Многие из наших фич кросс-сервисные. Логично [13] было бы положить спеку в репозиторий того сервиса, где она родилась. Но контракт, который читают несколько сервисов, не принадлежит ни одному из них.
Сначала мы попробовали гибрид: внутренние спеки положить в репозиторий сервиса, межсервисные — в стор. Аргумент за гибрид был весомым: так как дизайн уточняется по ходу реализации, агенту пришлось бы писать уточнения в чужой репозиторий. Через десять дней мы от гибрида отказались. Пилот не показал никакой пользы от спеки в репозитории сервиса — ценнее всегда оставались документация и описание PR. Теперь вся спецификация живёт в сторе, а capability называется по сервису-владельцу.
Что мы потеряли: спека больше не попадает в дифф кодового PR.
Чем компенсировали:
-
спеку ревьюит человек до кода — это одобрение плана;
-
в описании каждого кодового PR — ссылка на change;
-
линтер стора краснеет, если работа по задаче смержена, а change не заархивирован;
-
у сервиса остаётся свой
docs/, где описано всё, что нужно его пользователям, — без привязки к OpenSpec и подобным формализациям спецификаций. Ссылок на стор там нет: у коллег из других команд к нему нет доступа.
Обход правил агентами
Иллюзия контроля
Первая версия гейтов была честной только на бумаге. «Код не трогать до одобрения плана» было текстом в инструкции, а гейты проверяли наличие, а не содержимое. Гейт одобрения пропускал любое непустое поле — plan_approved: false давал «✓ план одобрен (False)», а записать поле мог сам агент. Гейт проверки на стенде проверял, что путь существует, — проходил даже каталог с именем отчёта.
В одной задаче дизайн переписали и удалили дельта-спеку, но одобрение, поставленное до этих правок, так и осталось зелёным. В другой задаче сессия, писавшая код, после FAIL на стенде переписала тест-план и объявила PASS.
Мы привязали гейты к содержимому, вынесли запреты в runtime, а основание решения оставили человеку. Одобрение хранит хэш плана: спеки, дизайна, кейсов тест-плана и разбиения по PR. Мы нормализуем служебные строки (ссылки на PR, отметки о мерже, галочки). Если смысл плана изменился, одобрение сбрасывается, а гейт называет файлы, которые этот смысл изменили. Отчёт о проверке читается по вердикту и хэшу проверенного коммита.
Хук перед вызовом инструмента запрещает правки кода в worktree задачи, пока план не одобрен, правку полей одобрения (и через редактор, и через Bash) и коммиты в основной чекаут стора. Если движок не загрузился, хук не молчит, а запрещает правки в worktree задачи. Статичные запрещающие правила в настройках агента закрывают неизменные вещи: правку локального файла с логином одобряющего и прямое слияние PR. А правку собственных настроек агент и так не одобряет сам себе.
Сначала мы хотели, чтобы одобрение ставила отдельная команда, которую запускает человек, а агенту это было запрещено. На практике одобрять так оказалось слишком сложно: это отпугнуло бы команду. Теперь человек пишет в чат отдельной репликой одобряю AF-NNNNN, и засчитывается только реплика целиком. «Одобряю, но поправь…» и «не одобряю» не проходят. Хук на реплику человека пишет отметку с ключом задачи, которая живёт 10 минут. Агент запускает команду одобрения: без свежей отметки она отказывает, а с отметкой записывает дату, логин и хэш плана и гасит отметку. Записать отметку агенту запрещает хук. У агента не отняли команду — у него отняли право создать её основание.
Агент уверенно делает выводы из локальной картины мира
Проверяющий агент при ревью задачи сообщил, что спека противоречит коду соседнего сервиса. Выглядело убедительно. Однако спека была верна, так как оказалось, что локальный чекаут сервиса у агента отставал от origin/master на 36 коммитов. Недостающий коммит как раз вводил нужное поведение [14].
Теперь находки сабагентов рассматриваются как гипотезы. Оркестратор сначала проверяет их по origin после git fetch, и только после этого переписывает спеку или несёт человеку. Основной чекаут стора обновляется на старте каждой сессии. Хуки берут код с его master, даже если сессия открыта в отставшем worktree.
Лучше никакого гейта, чем тот, который врёт или молчит
Хук распознавал задачи по шаблону XX-123. Из-за этого на запросы вроде «почини чтение файла в UTF-8, мелкий фикс» он отвечал блокировкой «такт 1, код не трогать». Триггерами могли быть HTTP-500, SHA-256, ключи чужих команд и даже имя временного каталога. Теперь для реплик внедрен белый список префиксов для распознавания задач. Если ключ не входит в список, хук возвращает ответ «в сторе ничего не найдено».
Хук запрещал Bash-команды, в которых поле одобрения просто упоминалось в тексте документации. Теперь он разбирает команду и ищет запись, а не слово.
Хук старта сессии запускал полную проверку стора, которая шла 14,6–18 секунд при таймауте 15. Примерно в каждой второй сессии контекст молча не доходил до агента, и ошибки [15] не было видно. Хук разделили на быстрый и медленный. Сломанный движок теперь сообщает о себе явно: пустая сводка неотличима от «работ нет».
Проверяемое изменение задавало правила своей проверки
Бот стора решал, процессный PR или контентный, по списку процессных путей из конфига. Конфиг он читал из головы самого PR. Мы проверили: PR, который убирает skills/ из процессных путей, классифицировался как контент — бот его одобрял, и он сливался без человека. Теперь правила проверки берутся из целевой ветки, а правка самого конфига всегда считается процессом.
Как стор оброс шумом, и как мы его почистили
Жёсткие гейты закрыли дыры, но вокруг каждого действия появилось много шума: повторные согласования одного и того же, ритуалы вокруг проверок, ручные записи, которые агент делал за движок.
Переход на цикл с PR в стор заметно удлинил задачи — ритуал с PR и мержем приходилось прогонять несколько раз. Один план одобрялся до трёх раз. Ссылка на открытый PR и галочка в списке задач меняли хэш плана и сбрасывали одобрение.
Мы провели аудит с помощью группы агентов: какие проверки и автодействия есть, сколько их, что они дают. Исходили из принципа, что проверки делятся на тесты, которые держат сам фреймворк, и проверки во время работы. Последние экономят время и токены, выполняя работу вместо модели, и добавляют детерминированности. Всё, что не делает ни того ни другого, — шум.
Теперь вместо заморозки кода и повторных согласований у нас две точки одобрения: между точками план уточняется без переодобрения. Версия плана считается по смыслу, служебные строки её не меняют. Позиция по задаче приходит в контекст без повторов внутри сессии. Линтер и тесты гоняет скрипт приземления, а не модель. Ссылку на PR и отметку о закрытии задачи пишут хук и команда, а не модель руками. В итоге агент со стором ведёт задачу по пайплайну за руку в достаточно автономном режиме.
Замер по моим сессиям в сторе до и после ревизии на одну сессию:
|
|
До (30.09–13.10) |
После (15.10–19.10) |
|
Вставок хуков в контекст |
5,8 |
2,3 |
|
Почти-повторов вставок |
54 за окно (~4,4 тыс. токенов) |
0 |
|
Токенов от хука реплики, медиана |
2010 |
340 |
|
Ручных запусков линтера |
2,3 |
0,5 |
|
Ручных запросов позиции |
4,7 |
2,0 |
|
Ручных правок списка задач |
2,8 |
0,6 |
Ритуал PR в стор почти не сократился. Это следующий кандидат на упрощение.
Ретро после каждой задачи
Чтобы стор снова не оброс лишним, мы добавили обязательный шаг ретроспективы при завершении каждой задачи. Агент разбирает сессии задачи и ищет, какие лишние действия он совершал, какие решения оказались неудачными, а какие удачными. Если что-то нашёл, предлагает улучшение процесса — правило в скилл или инструмент вместо повторяющейся механики. Принимать его или нет, решает человек. Если агент ничего не нашёл, шаг проходит молча.
Раскатка на команду
Подготовка к команде сама вскрыла проблемы, которые незаметны, пока инструментом пользуется один человек:
-
у двух людей по одной задаче получался разный следующий шаг: гейт искал worktree только на локальной машине;
-
«моё» и «чужое» определялось по email последнего коммита, а при пустом
user.emailвсё было «моим»; -
хуки и скиллы были зарегистрированы в моих личных настройках — теперь они приезжают вместе с репозиторием;
-
логин одобряющего лежит в локальном файле, и его пришлось защитить от правки агентом.
Один из агентов-критиков сформулировал критерий готовности: на любую задачу позиция у двух людей должна совпадать. Пока это не так, это личный инструмент, а не командный.
После презентации стало понятно, что одной демонстрации мало: раскатка встретила сопротивление, и подход пришлось продавать. Возник вопрос, зачем нужны отдельный репозиторий, пайплайны и гейты, если можно положить в репозиторий пачку скиллов. Ответ мы собрали из того, на чём сами обожглись. Скилл — это текст: агент может его прочитать, а может пропустить, и каждый разработчик зовёт его по-своему. Стор считает позицию по задаче одинаково для всех, переходы между шагами держат гейты, а знание команды лежит в одном репозитории, и его видят все.
Команда начала пользоваться стором. В первую очередь коллеги оценили три вещи: актуальный статус проектов, чужие исследования при разборе проблем в проде и договорённость в один коммит.
Достаточно попросить агента и он покажет, что сделано, что в работе, что заблокировано и выполнены ли критерии приёмки. Статус не отстаёт, как статусы в трекере, потому что считается по артефактам — changes, PR, мержам, отчётам проверки.
Исследования лежат в сторе рядом с проектами, и агент находит их, когда разбирает инцидент. Если коллега уже копал похожую проблему, разбор начинается с его выводов.
Больше не нужно рассылать регламент и напоминать о нём на ревью. Решили что-то на обсуждении? Правка в скилл, пайплайн или гейт занимает один коммит, и со следующей задачи её исполняет агент у каждого в команде.
Сравнение метрик: без агента, с агентом, с агентом и стором
Команда работает со стором первые недели, поэтому сравнивать «до» и «после» пока рано. Базу команды мы сняли за 01.07–25.09 и повторим замер через квартал.
Мои цифры по трём периодам: без агента, с агентом, с агентом и стором.
|
|
01.01–31.03, без агента |
01.04–10.09, агент |
11.09–19.10, агент + стор |
|
Закрыто задач в неделю |
1,6 |
3,4 |
5,2 |
|
Создано PR в неделю |
2,3 |
4,8 |
15,4 |
|
Медиана строк в PR |
95 |
359 |
485 |
|
Доля тестов в строках PR |
28% |
40% |
50% |
|
Медиана от открытия PR до мержа, ч |
52,7 |
48,9 |
42,9 |
|
…PR на 300–1000 строк, ч |
155 |
113 |
45,5 |
|
Тредов ревьюеров на PR |
1,9 |
2,2 |
0,4 |
Объём работы и доля тестов растут, а время до мержа не растёт и у крупных PR заметно падает. Тредов ревьюеров стало меньше: PR стали понятнее и ёмче, с описанием и документацией.
Цифры самого стора на 19.10.2026: 17 задач прошли пайплайн до архива, 16 отчётов о проверке на стенде, больше 160 PR в стор, ~28,7 тыс. строк кода процесса и 55 тестовых файлов.
Выводы
Стоил ли путь затрат?
Первая версия стора заняла несколько вечеров, дальше он дорабатывался по ходу работы над задачами. Был период, когда шума стало больше, чем пользы, и хотелось всё бросить. Сейчас мне по-настоящему удобно разрабатывать: я обсуждаю задачу с агентом и получаю именно тот результат, который хотел. С агентом и стором я закрываю 5,2 задачи в неделю против 3,4 с агентом без стора, а крупные PR мержатся быстрее.
Нейросети берут на себя рутину
Документацию, тесты, проверку на стенде, единые договорённости агент делает как часть работы, если процесс этого требует, а не просит. У разработчиков на это вечно нет времени. Доля тестов в моих PR выросла с 28% до 50%, документации — с нуля до 8%, у каждой задачи есть отчёт со стенда, а ревьюеры оставляют в пять раз меньше тредов на PR.
Процесс команды становится кодом
Самым неожиданным оказалось то, насколько проще стало вводить договорённости. В какой-то момент от меня стали прилетать очень большие PR, которые было сложно ревьюить. После одного обсуждения в процесс добавили небольшую правку: задачу разбивать на PR, а внутри PR — на понятные коммиты. Стало намного лучше, а действий от меня потребовался минимум: правило исполняет агент на каждой задаче, а движок напоминает, когда PR перерастает порог. Нейросети помогают не только писать код, но и строить процессы — причём в привычном разработчикам виде: YAML-конфиги, скрипты и PR.
С чего начать?
Код с помощью агентов пишут уже все, поэтому копать нужно глубже. Начать стоит с двух вещей сразу. Каждую свою задачу пытаться делать с агентом. И с первого дня собирать метрики и повторяющиеся проблемные паттерны: где агент ошибся, что пришлось переделать, какую механику он повторял руками. Дальше — регулярно разбирать метрики и проблемы и улучшать процесс итерациями. Так вырос и наш стор: от нескольких вечеров до ретро после каждой задачи.
Автор: MorionVaive
Источник [18]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38405
URLs in this post:
[1] в Авито: https://clc.to/LV3FBg
[2] забывают: http://www.braintools.ru/article/333
[3] Почему агент теряет контекст и сдаёт работу без доказательств: #%D0%9F%D0%BE%D1%87%D0%B5%D0%BC%D1%83%20%D0%B0%D0%B3%D0%B5%D0%BD%D1%82%20%D1%82%D0%B5%D1%80%D1%8F%D0%B5%D1%82%20%D0%BA%D0%BE%D0%BD%D1%82%D0%B5%D0%BA%D1%81%D1%82%20%D0%B8%20%D1%81%D0%B4%D0%B0%D1%91%D1%82%20%D1%80%D0%B0%D0%B1%D0%BE%D1%82%D1%83%20%D0%B1%D0%B5%D0%B7%20%D0%B4%D0%BE%D0%BA%D0%B0%D0%B7%D0%B0%D1%82%D0%B5%D0%BB%D1%8C%D1%81%D1%82%D0%B2
[4] Стор и пайплайн задачи: #%D0%A1%D1%82%D0%BE%D1%80%20%D0%B8%20%D0%BF%D0%B0%D0%B9%D0%BF%D0%BB%D0%B0%D0%B9%D0%BD%20%D0%B7%D0%B0%D0%B4%D0%B0%D1%87%D0%B8
[5] Процессы команды в едином репозитории: #%D0%9F%D1%80%D0%BE%D1%86%D0%B5%D1%81%D1%81%D1%8B%20%D0%BA%D0%BE%D0%BC%D0%B0%D0%BD%D0%B4%D1%8B%20%D0%B2%20%D0%B5%D0%B4%D0%B8%D0%BD%D0%BE%D0%BC%20%D1%80%D0%B5%D0%BF%D0%BE%D0%B7%D0%B8%D1%82%D0%BE%D1%80%D0%B8%D0%B8
[6] Почему спеке не место в репозитории сервиса: #%D0%9F%D0%BE%D1%87%D0%B5%D0%BC%D1%83%20%D1%81%D0%BF%D0%B5%D0%BA%D0%B5%20%D0%BD%D0%B5%20%D0%BC%D0%B5%D1%81%D1%82%D0%BE%20%D0%B2%20%D1%80%D0%B5%D0%BF%D0%BE%D0%B7%D0%B8%D1%82%D0%BE%D1%80%D0%B8%D0%B8%20%D1%81%D0%B5%D1%80%D0%B2%D0%B8%D1%81%D0%B0
[7] Обход правил агентами: #%D0%9E%D0%B1%D1%85%D0%BE%D0%B4%20%D0%BF%D1%80%D0%B0%D0%B2%D0%B8%D0%BB%20%D0%B0%D0%B3%D0%B5%D0%BD%D1%82%D0%B0%D0%BC%D0%B8
[8] Как стор оброс шумом, и как мы его почистили: #%D0%9A%D0%B0%D0%BA%20%D1%81%D1%82%D0%BE%D1%80%20%D0%BE%D0%B1%D1%80%D0%BE%D1%81%20%D1%88%D1%83%D0%BC%D0%BE%D0%BC,%20%D0%B8%20%D0%BA%D0%B0%D0%BA%20%D0%BC%D1%8B%20%D0%B5%D0%B3%D0%BE%20%D0%BF%D0%BE%D1%87%D0%B8%D1%81%D1%82%D0%B8%D0%BB%D0%B8
[9] Раскатка на команду: #%D0%A0%D0%B0%D1%81%D0%BA%D0%B0%D1%82%D0%BA%D0%B0%20%D0%BD%D0%B0%20%D0%BA%D0%BE%D0%BC%D0%B0%D0%BD%D0%B4%D1%83
[10] Сравнение метрик: без агента, с агентом, с агентом и стором: https://www.braintools.ru%20%D0%B1%D0%B5%D0%B7%20%D0%B0%D0%B3%D0%B5%D0%BD%D1%82%D0%B0,%20%D1%81%20%D0%B0%D0%B3%D0%B5%D0%BD%D1%82%D0%BE%D0%BC,%20%D1%81%20%D0%B0%D0%B3%D0%B5%D0%BD%D1%82%D0%BE%D0%BC%20%D0%B8%20%D1%81%D1%82%D0%BE%D1%80%D0%BE%D0%BC
[11] Выводы: #%D0%92%D1%8B%D0%B2%D0%BE%D0%B4%D1%8B
[12] память: http://www.braintools.ru/article/4140
[13] Логично: http://www.braintools.ru/article/7640
[14] поведение: http://www.braintools.ru/article/9372
[15] ошибки: http://www.braintools.ru/article/4192
[16] Тут ещё больше контента: https://telegram.me/+ShQQPXymxoViNzFi
[17] Жми сюда!: https://clc.to/MDY_jw
[18] Источник: https://habr.com/ru/companies/avito/articles/1101500/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1101500
Нажмите здесь для печати.