ASR для AI-разработки: как я замерял качество распознавания технических терминов
С ноября прошлого года я отстроил себе Dark Software Factory, и большую часть разработки я делал голосом. Сначала это был просто эксперимент, но он стал быстро обрастать фишечками, разными гейтами и постепенно превратился в очень понятный и накатанный флоу сборки продуктов в баре, за рулем или пока стоишь в очереди за кофе.
Глобально такие фабрики софта я бы разделил на два типа: в первом по-прежнему много людей, которым очень помогают роботы и такая фабрика может построить что угодно.
Во втором — свет в помещении выключен и весь конвейер прокатывают роботы. Люди там тоже есть, но их уже сильно-сильно меньше, и они занимаются другим: продуктом, архитектурой и эвалами. Совсем сложные продукты так не собрать, но зато здесь околонулевой интерконнект между теми, кто говорит на разных смысловых языках, полное отсутствие привычной разработки и бешеная скорость поставки.
Первая и важнейшая часть такой фабрики — ASR, автоматическое распознавание речи. Чем точнее голос превращается в текст, тем проще и быстрее задача влетает в конвейер, а значит и быстрее катится дальше. Без хорошего ASR ни одна фабрика на высокие обороты не выйдет.
Но ASR здесь очень коварный!
Стенд и данные
В исходном замере — 1000 голосовых записей, 20,3 часов аудио, 7 говорящих. Большая часть записей мои, но чтобы это не было бенчмарком имени меня, подлил технических аудио из открытых источников (подкастов). Внутри — все, что касается PDLC: интерфейсы, архитектура, логика [1], фреймворки и прочее. Как обычно это выглядит? Дикая смесь разговорного русского и англицизмов, «ну эээээ» и заимствований, и все это приправлено капелькой мата.
Из 18 тысяч присутствующих уникальных словоформ я выделил 454 термина и разметил каждый в аудио. Это была легкая часть — я несколько лет отвечал за разработку большой платформы разметки, поэтому любой пайплайн разметки или подготовки данных теперь не вызывает проблем.
Машина — AMD Ryzen 5 3600, 6 физических ядер, 12 потоков, около 63 ГБ оперативной памяти [2]. Все модели работали на CPU, GPU не использовался. Сравниваются варианты GigaAM, T-one и Whisper.
Сам бенч достаточно классический — один прогон, качество замеряется по голден сету, предварительная чистка и запуск каждой модели с нуля.
Результаты
Эталон, %» — доля терминов, записанных точно в заданной форме; «Распознано всего» учитывает и разновидности: например «backend» и «бэкенд». WER (word error rate) и CER (char error rate) строятся относительно эталонного текста по словам и символам. RTF (real-time factor) — время распознавания, делённое на длительность аудио.
Здесь важно разделять два качества: распознавание самого термина и точность его написания. Некоторые модели ограничены кириллическим алфавитом и не воспроизведут английское название даже при правильном распознавании на слух [3], поэтому считается точное совпадение и более широкий вариант с учётом допустимых вариантов написания.
Для WER и CER меньше — лучше. Для распознавания терминов, наоборот, лучше больше. RTF характеризует скорость, а не качество распознавания.
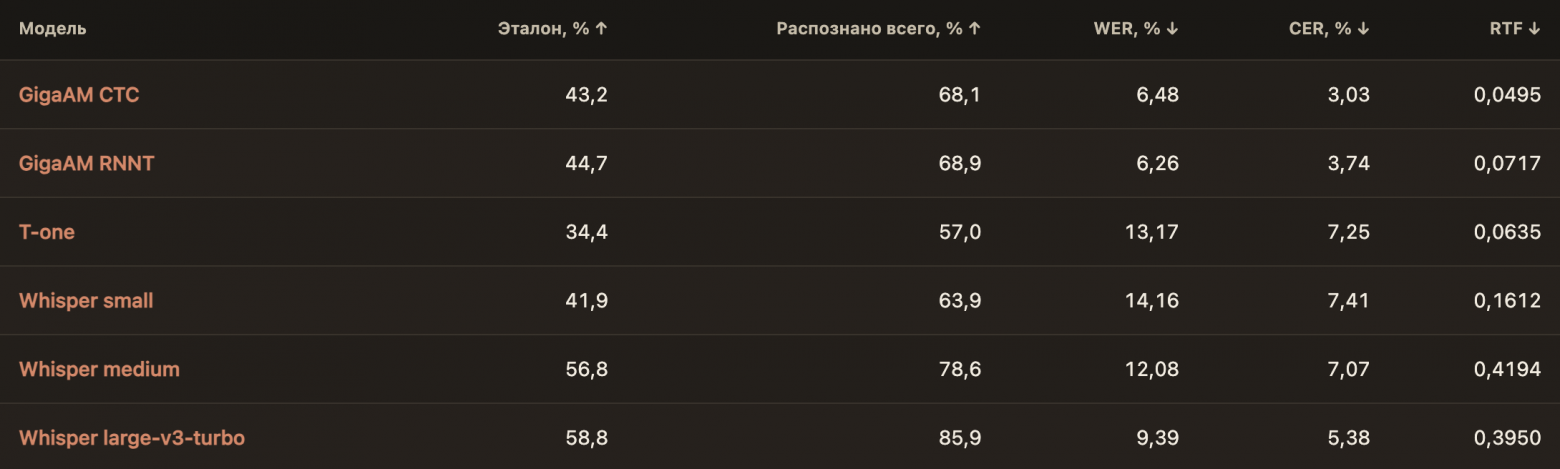
Сначала про RTF: GigaAM и T-One настоящие короли работы на CPU, а вот висперу без ускорителей плохеет. При этом RTF зависит не только от архитектуры и размера модели, но и от движка инференса, квантования и параметров декодирования. Но я здесь решаю конкретную задачу и на софтверной фабрике RTF не обязан быть низким, поэтому здесь поле можно считать просто информационным.
Победитель по голому WER — GigaAM. И это действительно отличная модель для русского и низкий WER здесь оправдан. Но если посмотреть на термины, то проигрыш висперу достаточно серьезный.
Получается довольно понятная развилка: победитель по WER быстро и аккуратно пишет обычный текст, но другая модель лучше доносит технические сущности. Это интересно.
Наверху это общий прогон, а вот как выглядит уровень одной записи в фабричной админке:
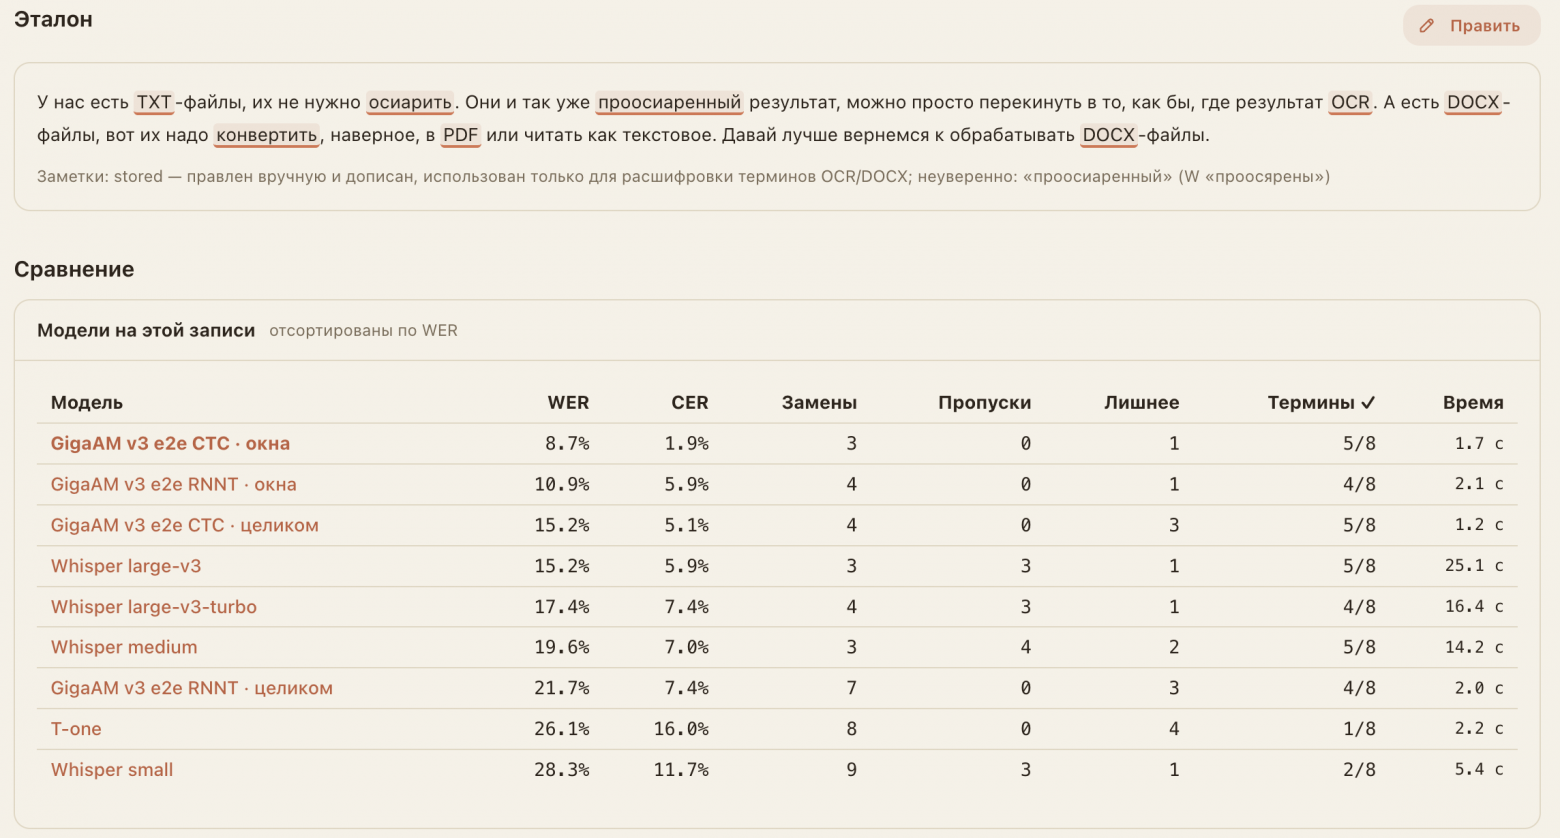
Или вот:
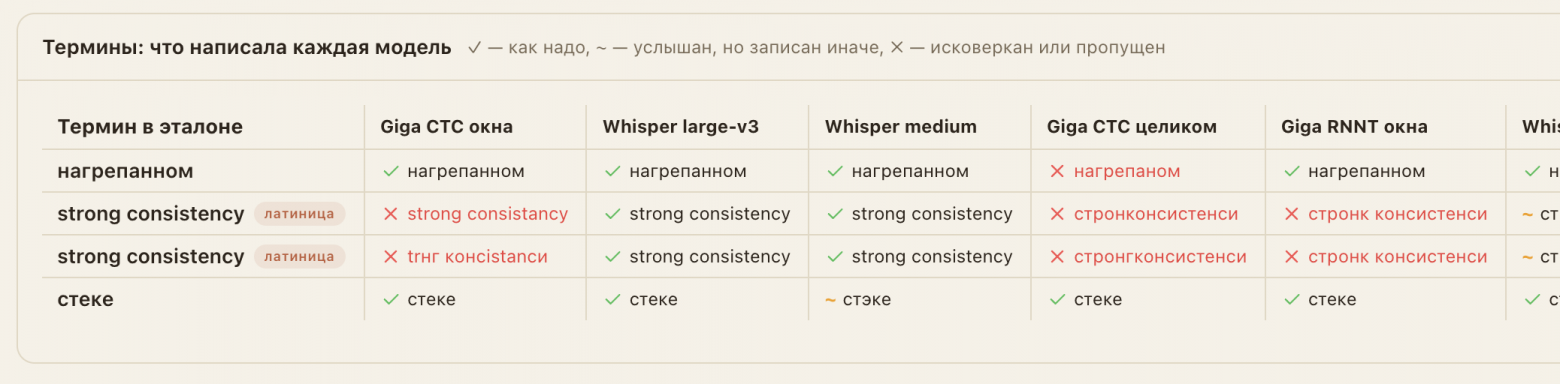
Strong consistency два раза, потому что два раза в оригинале.
Оригинал
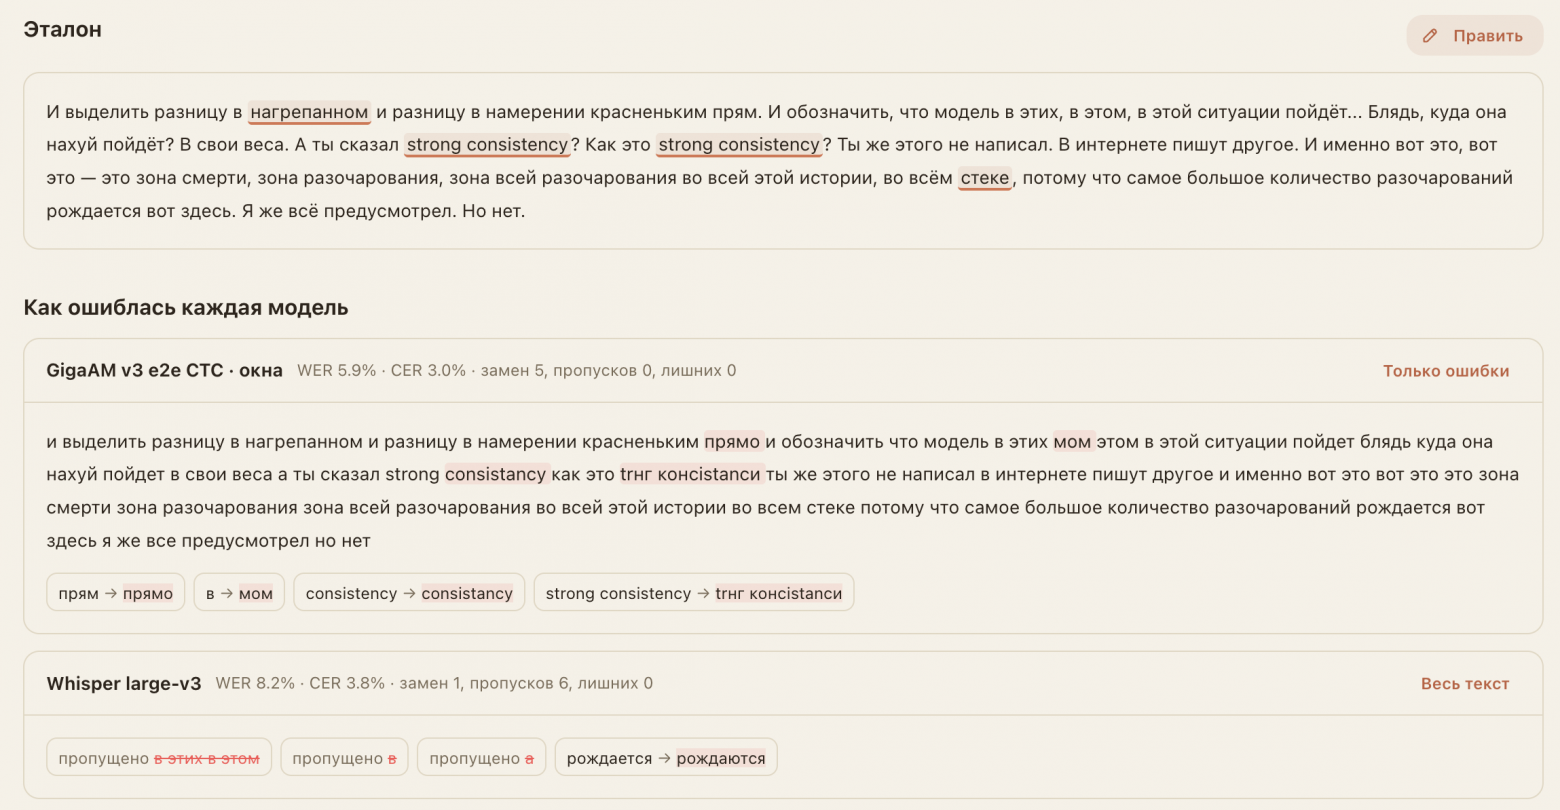
Коварный WER
Берем двух главных претендентов и посмотрим их внимательнее:
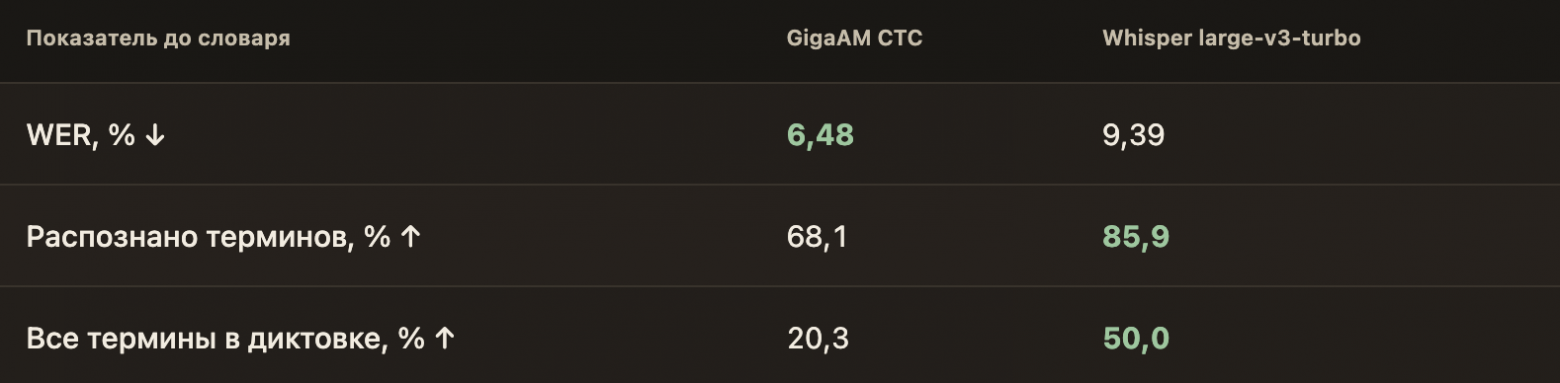
Для начала что вообще такое WER: это достаточно простая (и очень емкая) метрика, которая говорит сколько слов нужно заменить, удалить и вставить, чтобы получить эталон.
WER = (замены + удаления + вставки) / число слов эталона
Каждая операция стоит единицу и это довольно весело, вот намеренно утрированный и чистый по написанию пример:
Открой сессию tmux для текущего проекта, передай туда результат обработки аудио и покажи пользователю команду, но не запускай ее автоматически.
Что такое «низкий WER»? Он может выглядеть вот так:
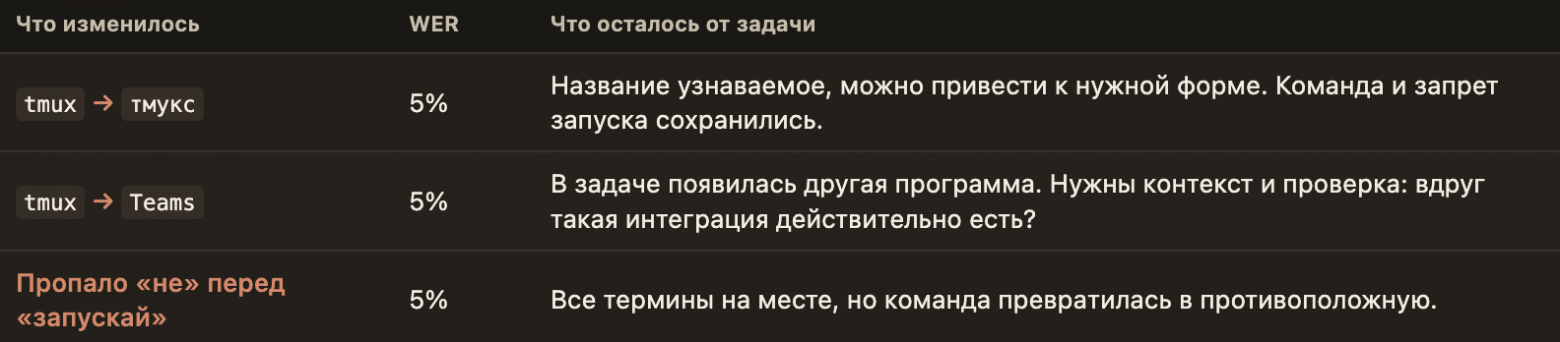
У нас одинаковый процент ошибок — одинаковая циферка, но за ней может как быть как успех, так и испорченная фича и сожженные токены, а может быть даже и че похуже. Можно получить прекрасный WER и очень плохую постановку задачи.
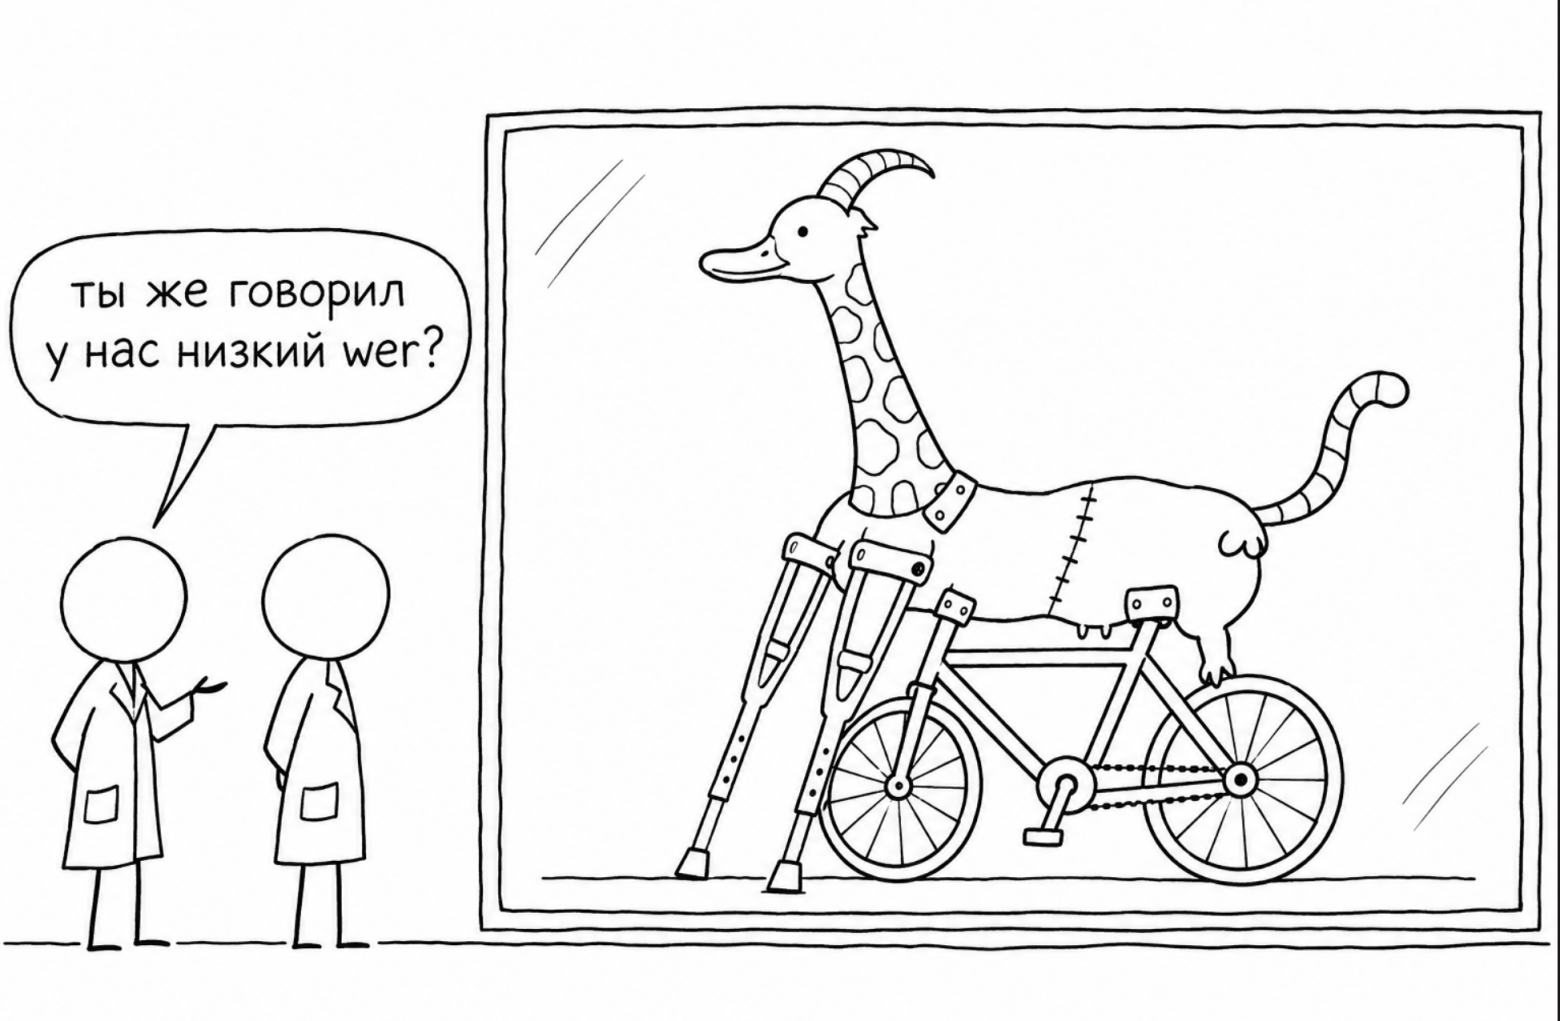
В моем датасете достаточно много длинных аудио, и коротенький критичный термин почти растворяется в общем объеме низкого WER, хотя именно это слово может направить конвейер в нужную сторону. При длинных записях ошибки [4] в редких терминах действительно могут слабо влиять на общий WER, но не потому, что WER как-то специально игнорирует короткие слова, просто у них небольшой вклад в общий числитель и знаменатель.
При этом будет нечестно сказать, что обычная речь совсем не важна. Важна!
Что это означает на практике? Если упростить, то полученный транскриб влетает в харнесс и дальше им раскладывается на две вещи: намерение и задачу на поиск кода. Точность передачи намерения — одна из целевых метрик моей фабрики, но в этом бенчмарке напрямую она не измерялась.
Поиск — это траектория (про инструменты у меня есть отдельный пост), и умный агент может позволить себе ошибки на шагах поиска. Это означает, что у нас есть некоторая терпимость к ошибкам распознавания: если слово распозналось не так, но смысл за ним не теряется («дашборд» и «dashboard» и «дашик», например), это не очень критично влияет на результат.
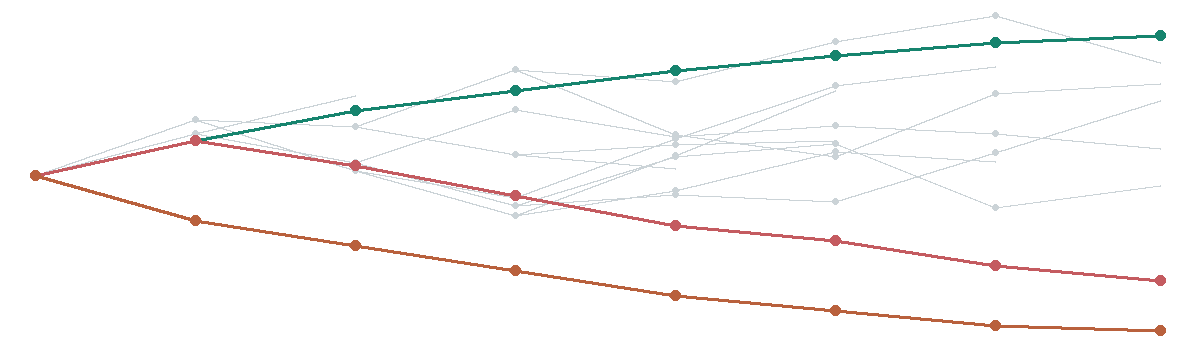
Гораздо хуже если распознается не то. Это напрямую влияет на намерение (агент будет думать, что мы решаем чуть другую задачу) и влияет на поиск — мы можем начать искать то, что искать не нужно и наоборот — не будем искать что нужно в первую очередь. Если мы берем насыщенную терминами речь, то несколько потерянных терминов могут заруинить всю задачу целиком. Если у нас сервис, протокол, либа и что-то на их стыке, то модели сложно додумать правильный контекст употребления из-за его широты.
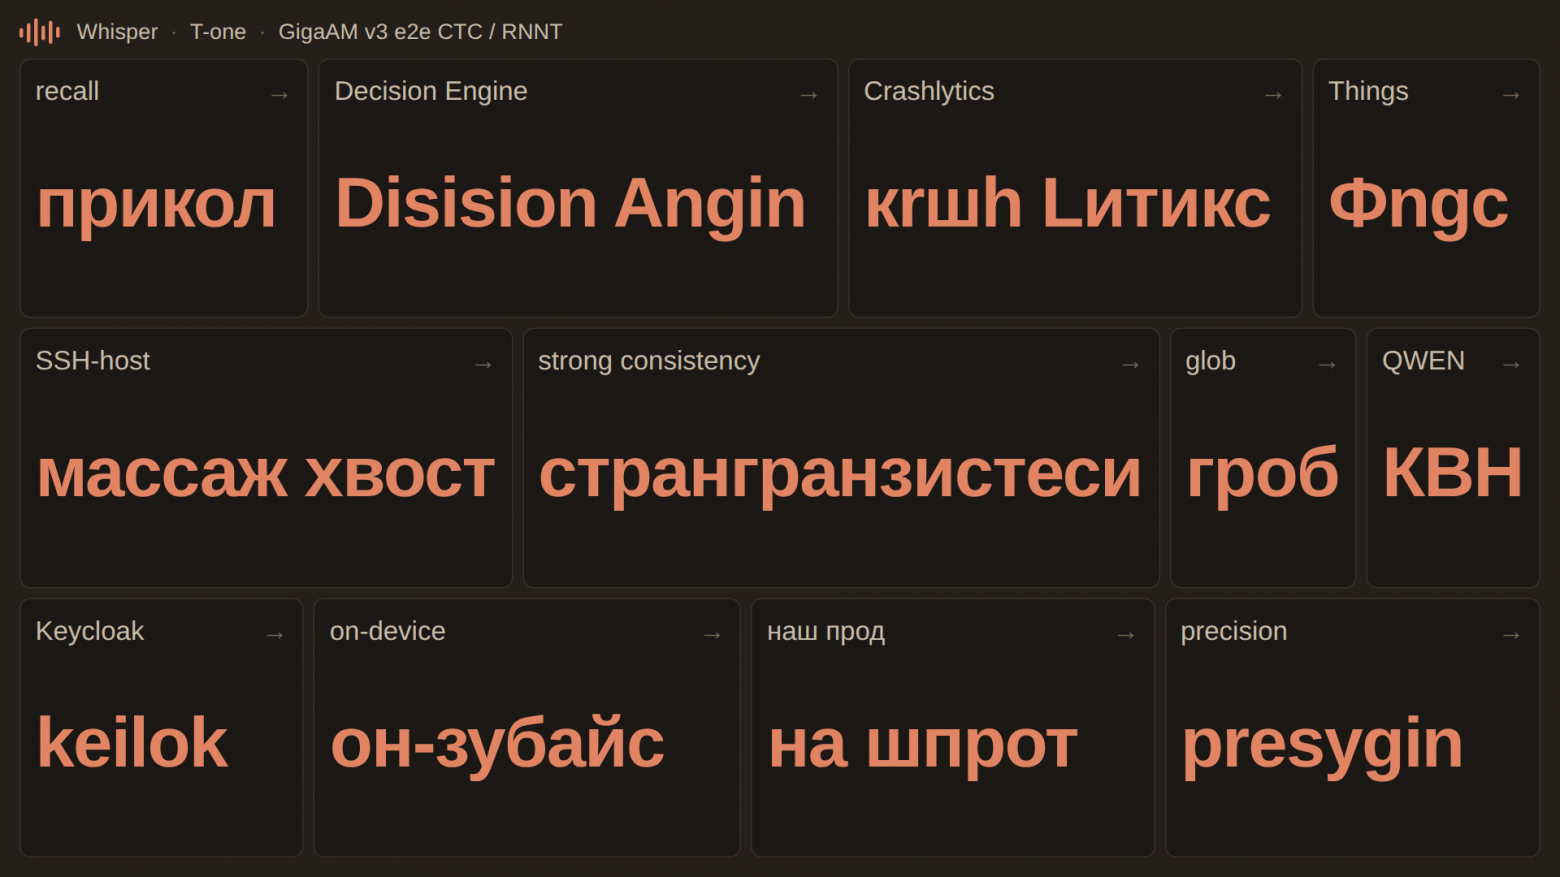
Мой самый любимый случай — «пресиджен» и «recall», который превратился в «прикол». С первым работать все еще можно: по нему допустимо предположить, что это покореженный термин, поэтому намерение восстановимо. Но «прикол» — обычное русское слово, оно не вызывает подозрений, при этом у него не совсем одно явное значение.
В таких случаях харнессу необходимо превращаться в текстовую диффузию: расшумлять весь шум, который насыпала ASR. Иногда это срабатывает отлично, а иногда уводит модель в черные дыры и глубокие воды.
Но иногда ASR просто грубо ошибается там, где человек бы этого не сделал. Например, «наш прод» превратить в «на шпрот». Угадайте куда поехал весь коммит после этого.
Почему ASR не может
Рассмотрим шпрот.
В реальном фрагменте человек спрашивает: «можно ли ее тащить в прод на своем железе?», и распознавалка выдает: «можно ли ее тащить в прот на своем железе?».
Пока все довольно безобидно. «Прот» похож на «прод», контекст понятный, расшумить можно, но мы все же в одном шаге от консерв. «Наш прод» гораздо легче превращается в «на шпрот», а расшумить его сложнее.
Модель получает звуковую волну. Дальше ее режут на короткие окна, считают спектр, объединяют частоты в полосы по шкале mel (шкале того, как наше ухо воспринимает высоту звука) и логарифмируют энергию. Получается log-mel-спектрограмма — карта того, как звук менялся во времени. Логарифм сжимает разброс значений, чтобы тихие и громкие участки удобнее помещались в одном представлении.
Никаких готовых букв на этой карте нет. Пробелов тоже.
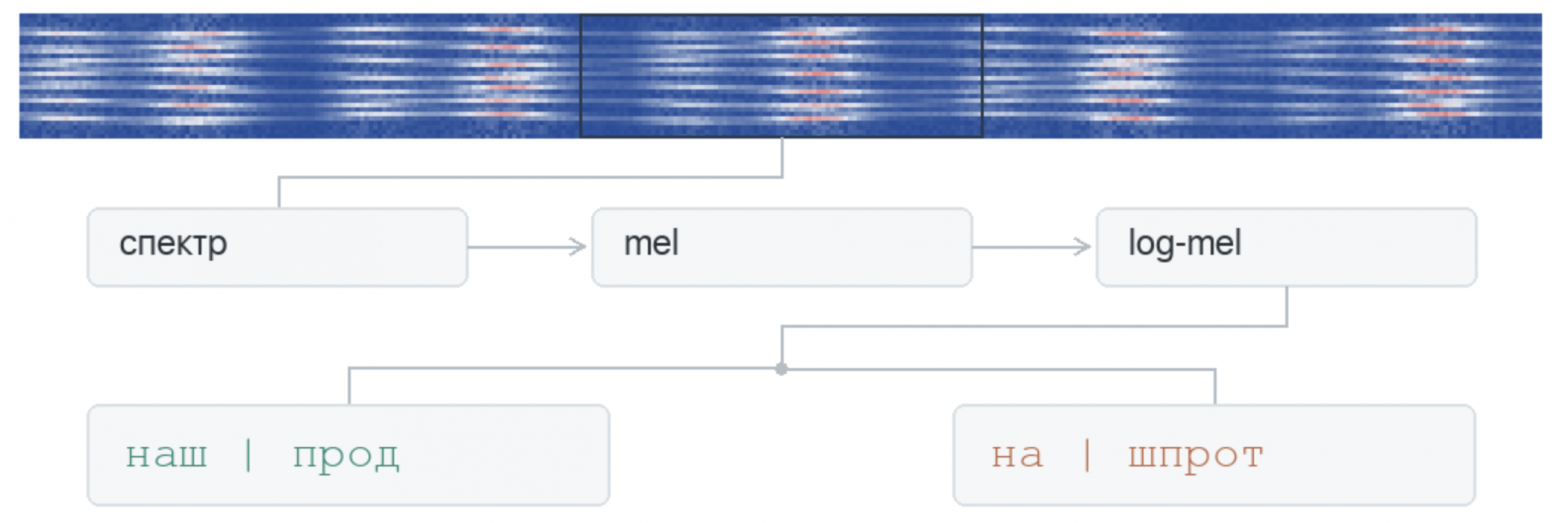
Конечное «д» в слове «прод» может оглушаться до «т», а границу между «наш» и «прод» мы отдельным звуком не обозначаем. Нужно самим догадаться, где заканчивается одно слово и начинается следующее. Ударение и гласные могут помочь различить варианты, но в быстрой речи цепочки сближаются.
Для человека с продакшеном и пачкой незакрытых задач выбор обычно очевидный. У модели такого знания может не быть. Особенно если мы говорим быстро, рядом шумит кофемашина, орет городской сумасшедший в метро, а название сервиса мы вообще придумали вчера.
При этом ошибка может получиться очень гладкой. Все слова знакомые, предложение читается, орфография хорошая. Вот только токены могут начать жечься не туда.
Как из звука собирается текст
У моделей в этом замере три разных способа добраться до готовой строки. Сначала энкодер превращает аудио в числовое представление, а дальше начинается выбор текстовых меток — символов или частей слов.
GigaAM CTC и T-one используют CTC. Если сильно упростить, модель на каждом акустическом шаге оценивает метки без зависимости от ранее выданных меток. Среди них есть специальная blank — «на этом шаге ничего не вывести».
Причём одной транскрипции могут соответствовать разные последовательности меток и blank. При поиске итогового текста модель может учитывать суммарную вероятность этих путей, а не только самый вероятный символ на каждом шаге.
В выбранной последовательности сначала схлопывают соседние одинаковые метки, потом убирают blank. Получается текст.
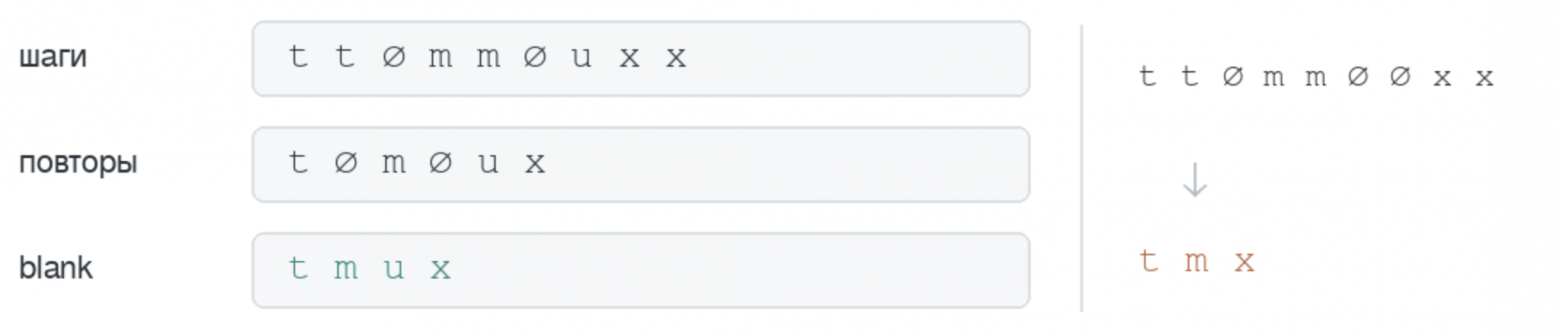
Здесь есть важная особенность: сама свертка ничего не допридумывает. Если в выбранном пути для tmux уже не оказалось буквы u, операция удаления повторов ее обратно не принесет. Нужно было выбрать другой путь или потом чинить результат.
У GigaAM RNNT выбор следующей метки зависит и от аудио, и от уже выданных меток. Blank там тоже есть, но работает иначе: позволяет перейти к следующему акустическому шагу, правила свертки повторов CTC здесь нет.
Whisper собирает текст токен за токеном, глядя на аудио и уже написанное начало.
У каждой модели есть свой словарь выходных меток. У одних это отдельные символы, у других — части слов, как в LLM. Whisper использует BPE-токенизацию, поэтому один технический термин может занимать один токен, а другой — несколько. Вот пример токенизатора виспера: backend с пробелом впереди — один токен, бэкенд — четыре. Убираем пробел перед английским вариантом — получаем back и end.
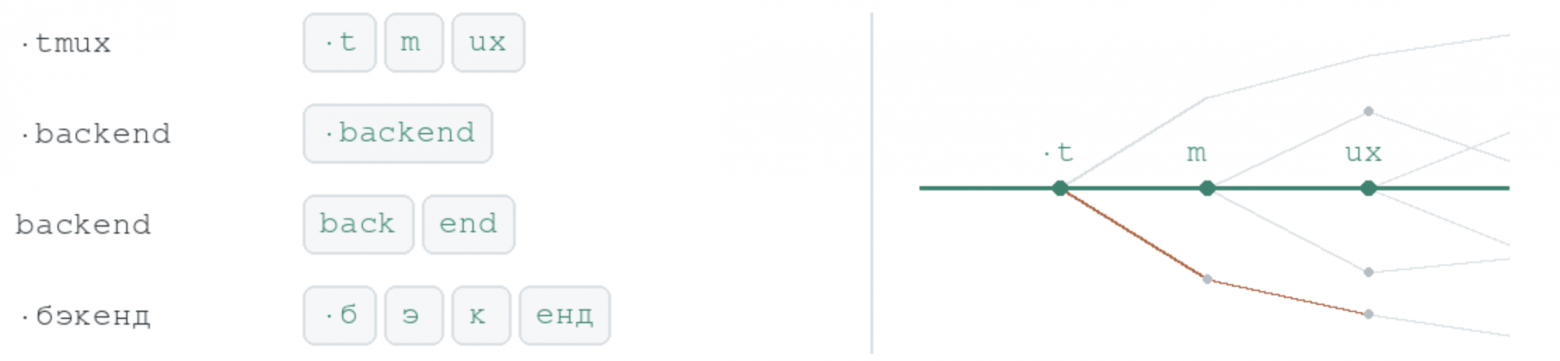
Из этого легко сделать красивый, но неправильный вывод: больше токенов — больше ошибок. Только recall здесь занимает один токен, а прикол — два.
Дело сложнее. Возможность собрать нужное слово у модели есть, но дальше нужная последовательность должна выиграть у остальных.
Здесь помогает beam search, или лучевой поиск. Вместо того чтобы на каждом шаге выбирать один наиболее вероятный токен, декодер сохраняет несколько перспективных последовательностей и продолжает каждую из них. Это снижает риск слишком рано отбросить правильный вариант, но beam search не делает модель умнее: он лишь тщательнее ищет среди последовательностей, которым она сама назначает вероятности. Если неправильная транскрипция для модели вероятнее правильной, увеличение beam size вполне может оставить ошибку без изменений, а иногда даже ухудшить WER: наиболее вероятная по оценке модели строка не обязательно совпадает с человеческим эталоном.
А наружу все равно уезжает одна строка. И фабрика дальше будет работать именно с ней — без пояснений какие варианты были откинуты, насколько близко к финалу пробрался нужный термин и почему в итоге победил другой.
Итоги
Что же с этим делать? На самом деле, вариантов несколько и все достаточно хороши. Попробовал сделать постпроцессинг без залезания в модели — зарекомендовал себя хорошо, но дальше — обязательно попробую подфайнтюнить именно на техничку.
Бенч-то есть, че нет-то.
Спасибо!
Мой канал про агентов, LLM, продукты и людей: Agentic World [5] и другие статьи:
Автор: antipov_dmitry
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38488
URLs in this post:
[1] логика: http://www.braintools.ru/article/7640
[2] памяти: http://www.braintools.ru/article/4140
[3] слух: http://www.braintools.ru/article/6251
[4] ошибки: http://www.braintools.ru/article/4192
[5] Agentic World: https://t.me/anti_notes
[6] Когда лопнет пузырь AI?: https://habr.com/ru/articles/993078/
[7] Jev: большой инженерный разбор нашумевшей System One модели: https://habr.com/ru/articles/1085450/
[8] Как работает текстовый водяной знак в Claude: https://habr.com/ru/articles/1076018/
[9] Источник: https://habr.com/ru/articles/1107308/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1107308
Нажмите здесь для печати.