Как я оживил картину XIX века: Photoshop, локальная LLM, MiniMax H3 и After Effects
В этой статье мы рассмотрим можно ли взять историческую картину XIX века и превратить её в полноценную анимированную сцену – так, чтобы композиция, стиль и положение персонажей остались на своих местах. Основные инструменты про которые будет идти речь: Adobe Photoshop для разбора картины, локальная мультимодальная модель Qwen 3.8 27B Q5_K_XL через LM Studio для подготовки промтов, видеогенерация MiniMax H3 в ComfyUI и финальный композитинг в After Effects.
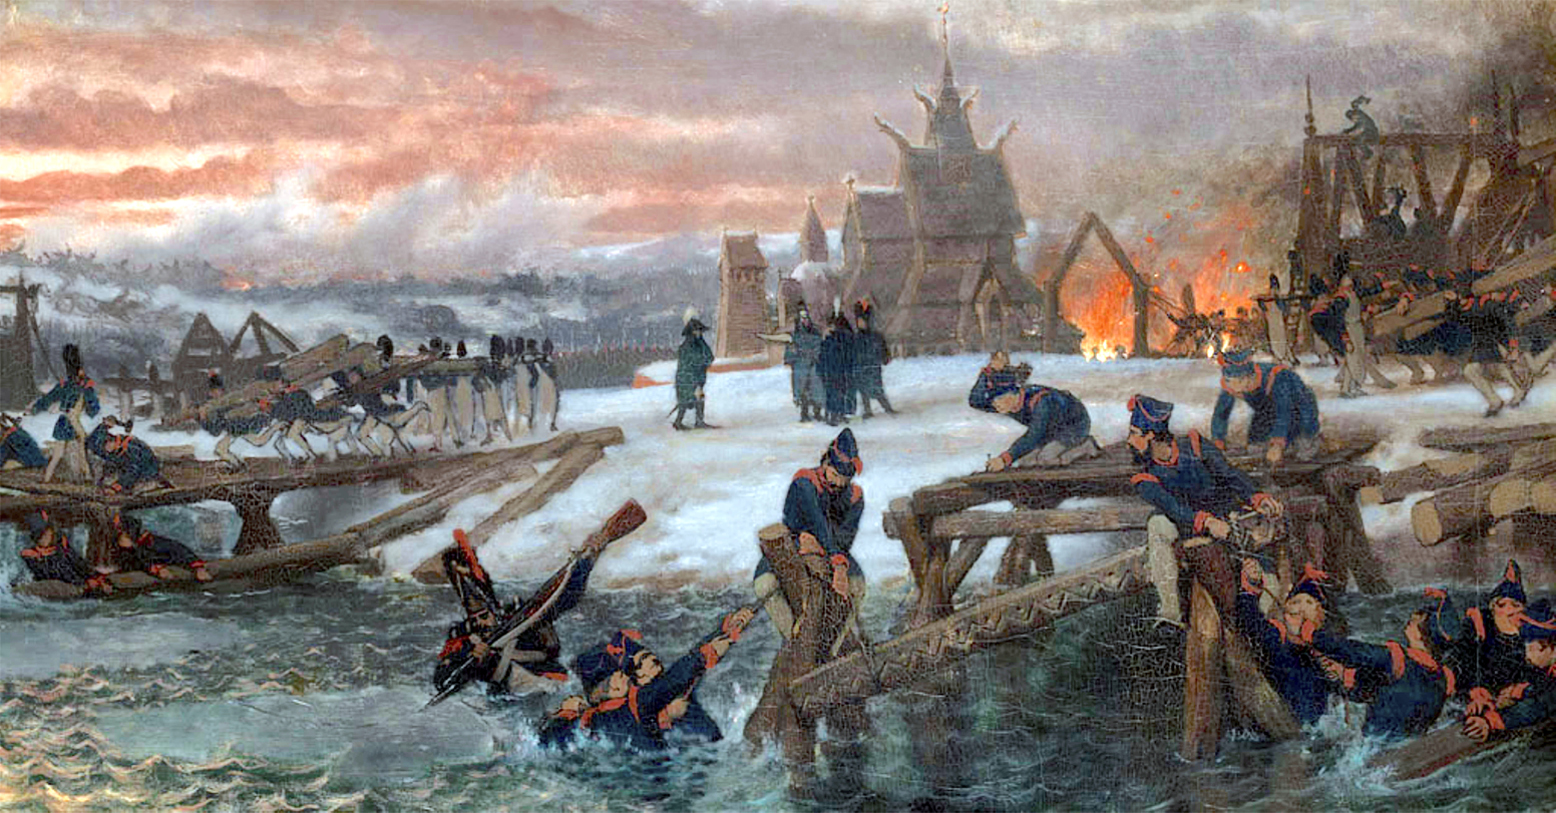
Исходник – произведение Лоуренса Альма-Тадемы “Anno 1812. Kapitein Benthien aan de Beresina” (также известно как The Crossing of the River Berezina – 1812). Ссылка на оригинал [1]

Небольшая оговорка в начале: задача была не в том, чтобы закинуть картину в видеогенератор и получить какое-нибудь движение. Я хотел разобрать изображение на независимые элементы, подготовить каждого персонажа по отдельности, восстановить то, что было скрыто за ними, а потом анимировать фрагменты и собрать всё обратно в одну композицию.
Видео с полным процессом и финальным результатом: https://youtu.be/kedgNXEFHJs?si=XcYYtQ0vVzd9CNhY [2] (YOUTUBE-ВИДЕО на моём канале Dmitrii DAK, продолжительность 10:41)
Источник и лицензия
Картина Альма-Тадемы посвящена ноябрю 1812 года – переправе через Березину во время отступления армии Наполеона. На ней голландские понтонёры под командованием капитана Бентьена строят переправу: люди, деревянные конструкции, вода, лёд, мосты и куча мелких деталей, из которых складывается вся историческая сцена.
Оригинал хранится в Amsterdam Museum (инвентарный номер SA 4857). Цифровая репродукция лежит на Wikimedia Commons под лицензией Public Domain Mark 1.0 – так что работать с ней можно свободно.
С чего начал: картина и почему её нельзя просто “прогнать” через видеомодель
С такими изображениями сразу натыкаешься на три проблемы.
Первая: персонажей много, и почти все они взаимодействуют друг с другом и с окружением – кто-то держит бревно, кто-то стоит в воде по пояс, кто-то перекрывает другого.
Вторая: если вырезать человека из кадра, за ним остаётся дыра. А за ним должна быть деревянная конструкция, другой солдат или часть моста – то, что на оригинале было скрыто его телом.
Третья и главная: если прогнать всю картину одним запросом через видеомодель, контроля почти нет. Модель поменяет лица, одежду, архитектуру, направление движения – всё, что захочет. На сложной сцене это гарантированно даст кашу.
Поэтому я пошёл поэлементным путём: разобрал картину на фрагменты и анимировал каждый отдельно.
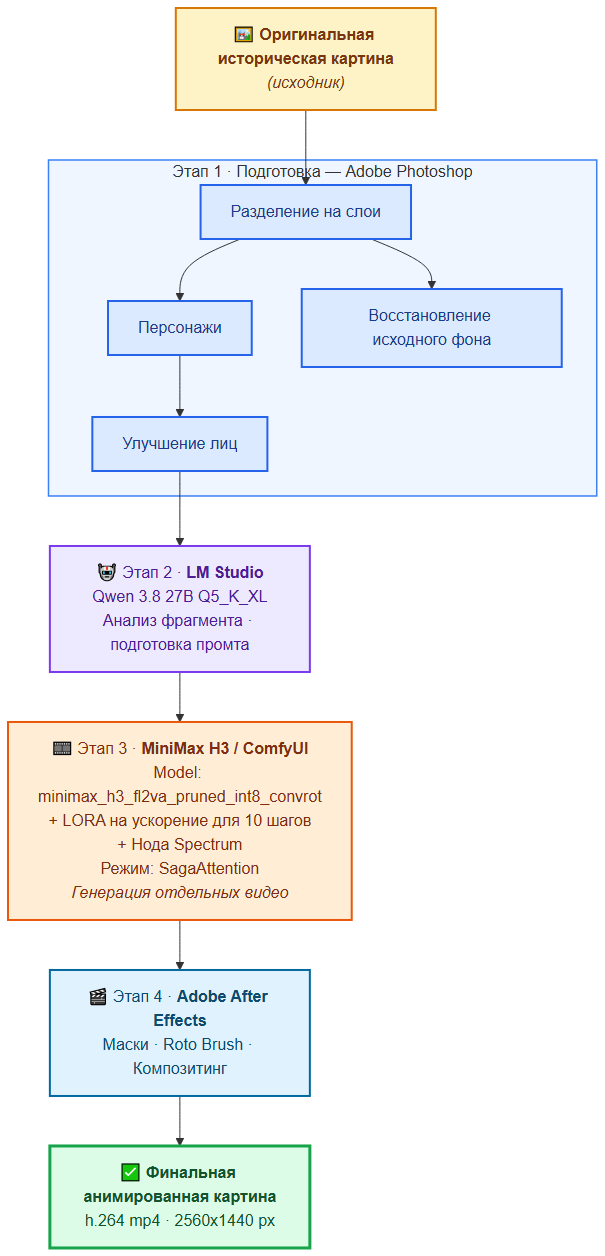
В итоге вместо одной большой генерации получается набор независимых элементов, каждым из которых можно управлять по отдельности.
Разбор картины на слои в Photoshop
Первый этап – разделение картины на отдельные элементы. Я открыл оригинал в Photoshop и начал выделять тех персонажей и те объекты, которые планировал оживить.
Здесь есть одно правило, без которого дальше всё развалится: каждый фрагмент я сохраняю в исходной системе координат. То есть не обрезаю вырезанного человека до минимального прямоугольника, а оставляю его на том же месте относительно размера всего холста. Зачем? Чтобы потом в After Effects можно было просто импортировать слои и они легли бы друг на друга без пересчёта масштаба и координат. Я не хочу вручную подгонять каждый кусок – это скучно и ошибочно.
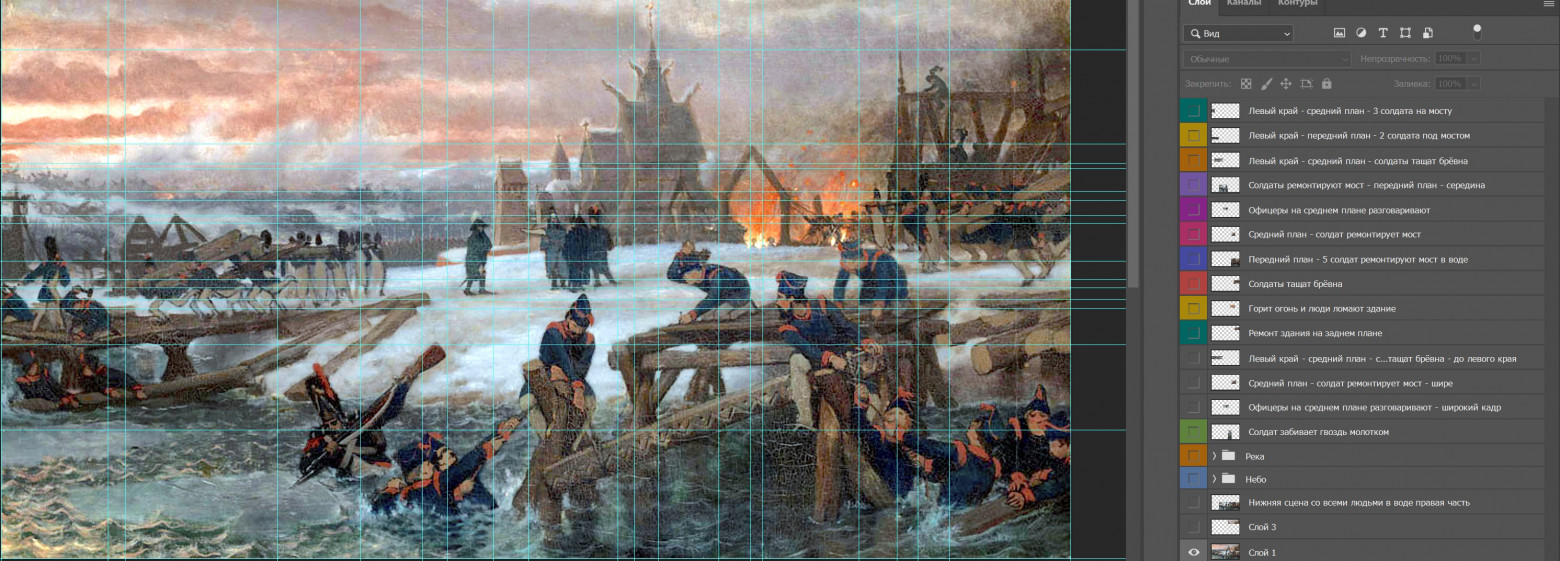
Сам разбор сводится к рутине, но без неё не обойтись: выделяю персонажа или объект, переношу на отдельный слой, проверяю границы выделения (особенно по краям одежды и волос), сохраняю координаты и группирую слои по смыслу – вода отдельно, люди отдельно, конструкции отдельно.
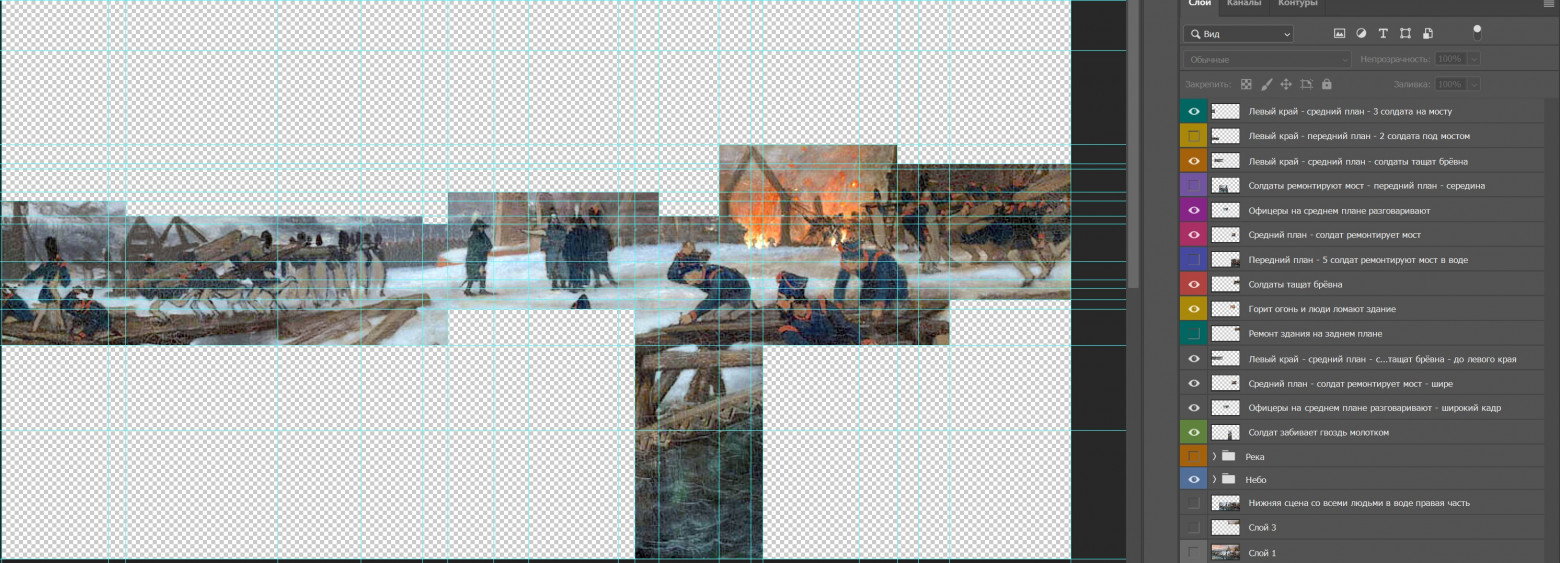
После этого каждый объект можно трогать независимо от остальных.
Inpainting: что делать с дырой, где стоял персонаж
Как только я вытаскиваю персонажа на свой слой, в оригинале остаётся пустое место – то самое, которое раньше занимало его тело. Просто удалить его нельзя: получится провал.
Например, солдат стоит перед деревянной конструкцией и другим человеком. Убрал его – а за ним должны быть доски, плечи того человека, снег. Всё это надо дорисовать так, будто солдата там никогда не было.
Для этого я использую Inpainting. Но просто «замазать» пятно нельзя: восстановленный участок должен вписаться в живопись по цвету, свету, фактуре мазка и перспективе. Иначе на статичном кадре это ещё пройдёт, а после анимации глаз сразу цепляется за несовпадение – фон начинает «плыть» относительно движущейся фигуры.
Поэтому я возвращаю персонажа обратно на место и смотрю на стыки: нет ли перепада оттенка, не бьётся ли направление мазков. Границы проверяю особенно тщательно – именно там чаще всего виден шов.
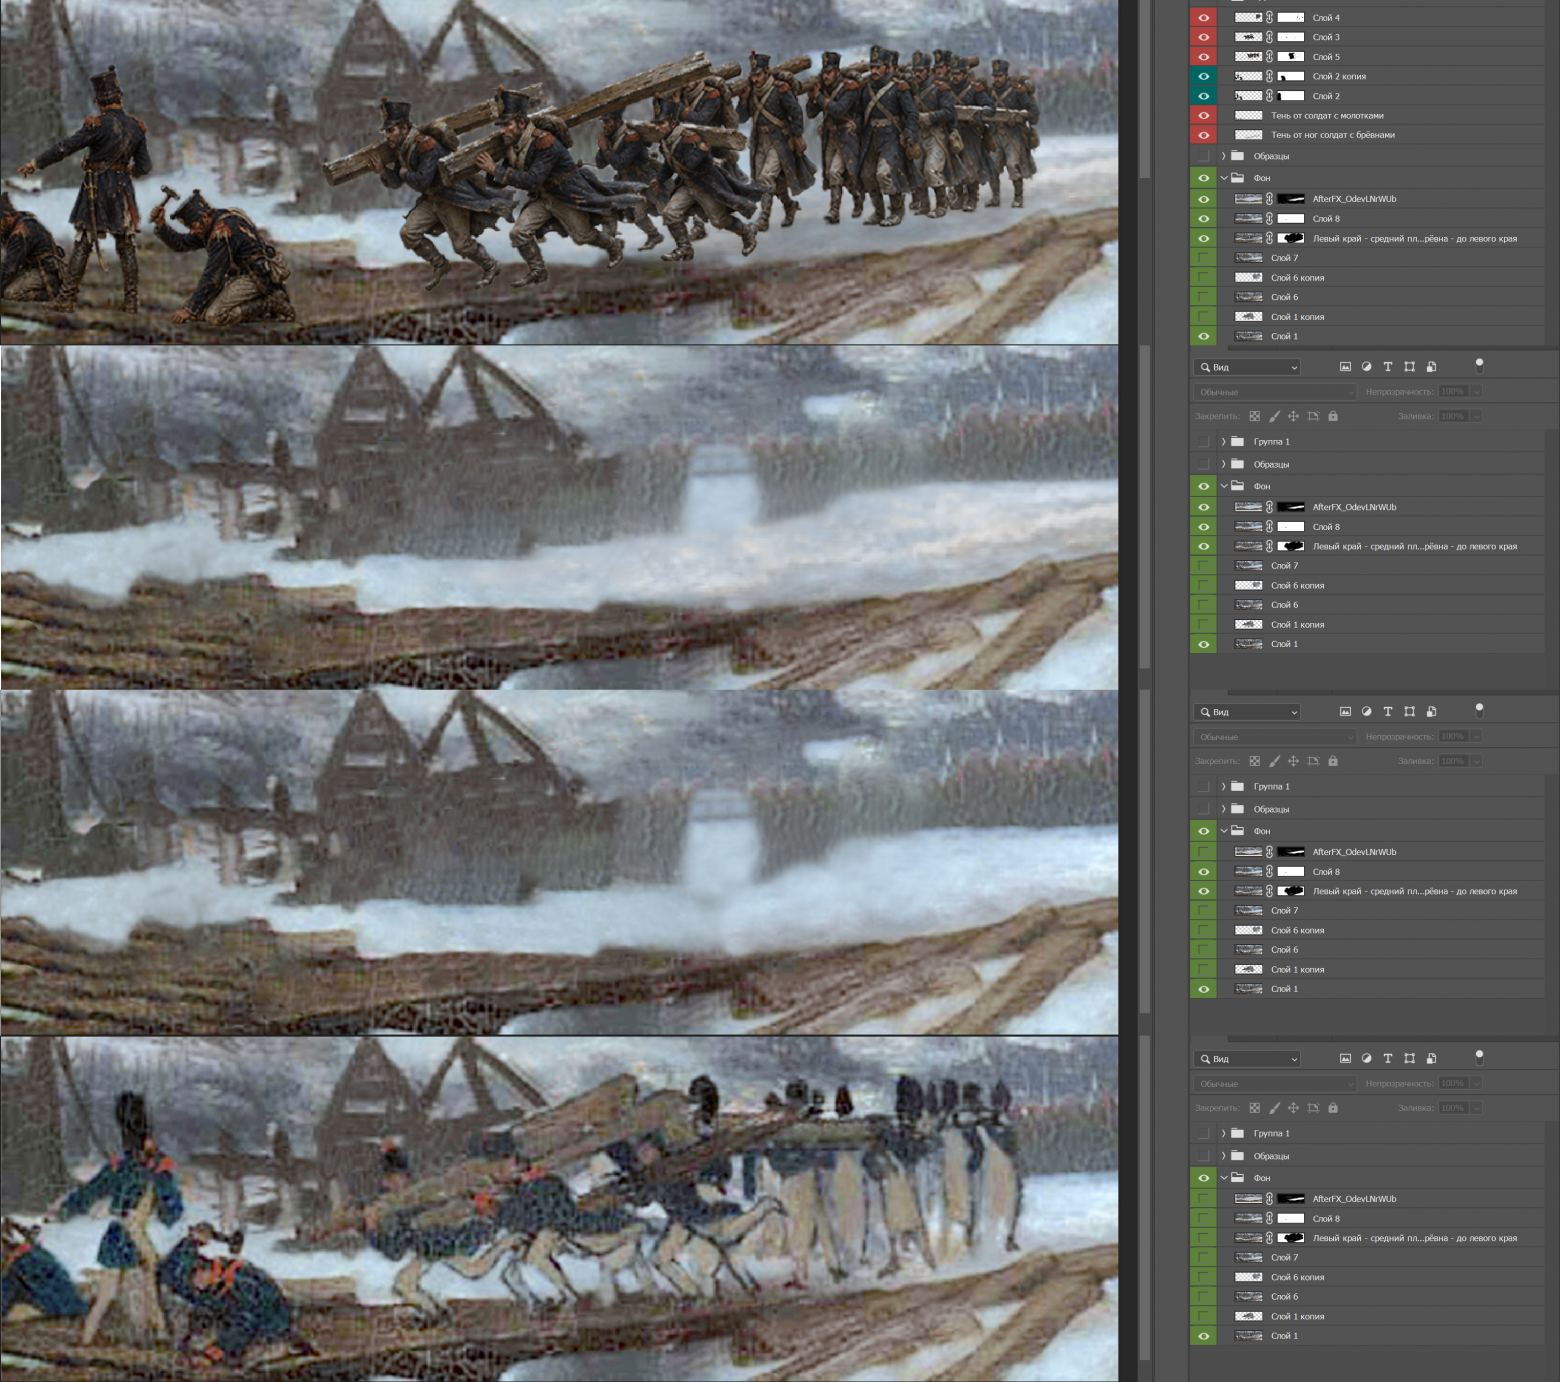
Такую “операцию” нужно провести для каждого фрагмента картины.
В итоге на выходе два независимых элемента: чистый фон и отдельный объект, который можно анимировать.
Лица: детализация без переделки позы
Следующая проблема – детализация. На картине многие фигуры маленькие, и если приблизить лицо, видно, что его просто недостаточно для убедительной анимации: при движении такие «мыльные» лица сразу выдают подмену.
Поэтому я дополнительно прогоняю вырезанных персонажей через улучшение (генерацию), делая упор на лица. Но задача тут не в обычном апскейле. Нужно поднять детализацию и при этом ничего не сдвинуть: положение головы, пропорции, исходная поза и общий художественный характер – всё должно остаться как было.
Дополнительно на этом же этапе я убираю задний фон за персонажем которого я буду в дальнейшем анимировать. Логика [3] в том, что сзади буду находится другие персонажи которые также будут анимироваться. Поэтому гораздо лучше вставить сзади зелёный фон и потом на композе после анимации убрать его пипеткой.
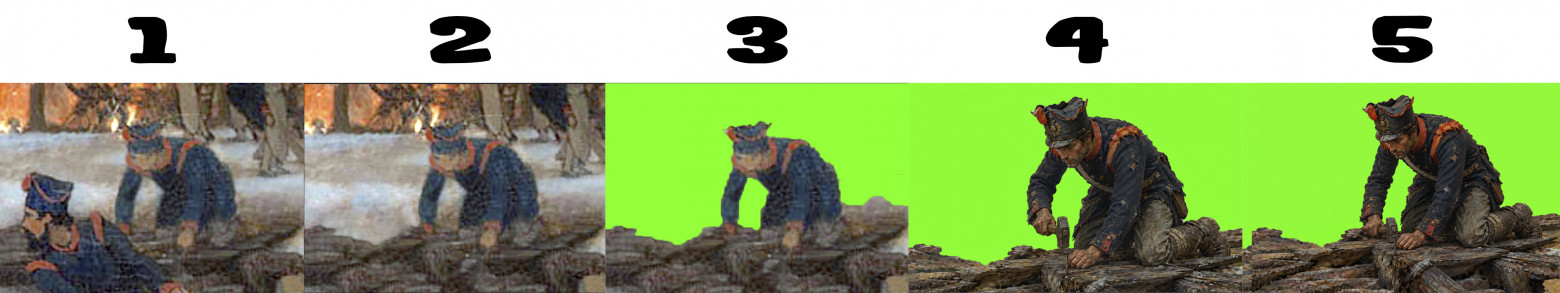
На этом подготовка исходника заканчивается. Можно переходить к анимации.
Промты через локальную LLM (LM Studio)
Я запускаю в LM Studio локальную мультимодальную модель (в проекте это Qwen 3.8 27B, квант Q5_K_XL) и использую её как промежуточное звено между мной и видеомоделью.
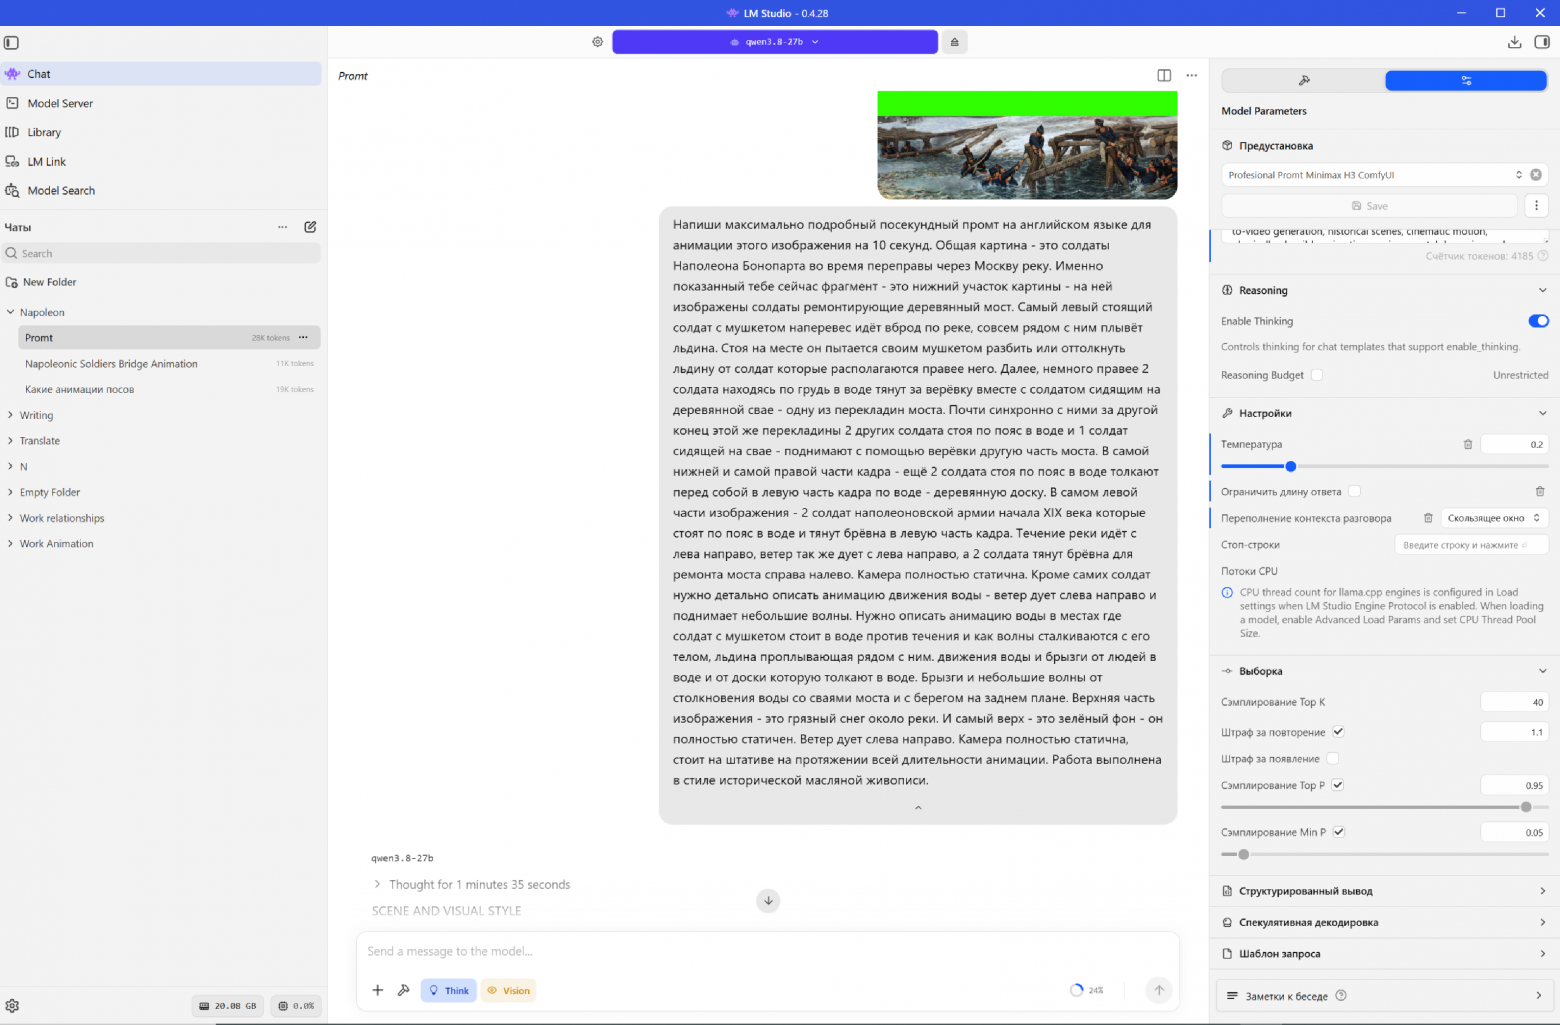
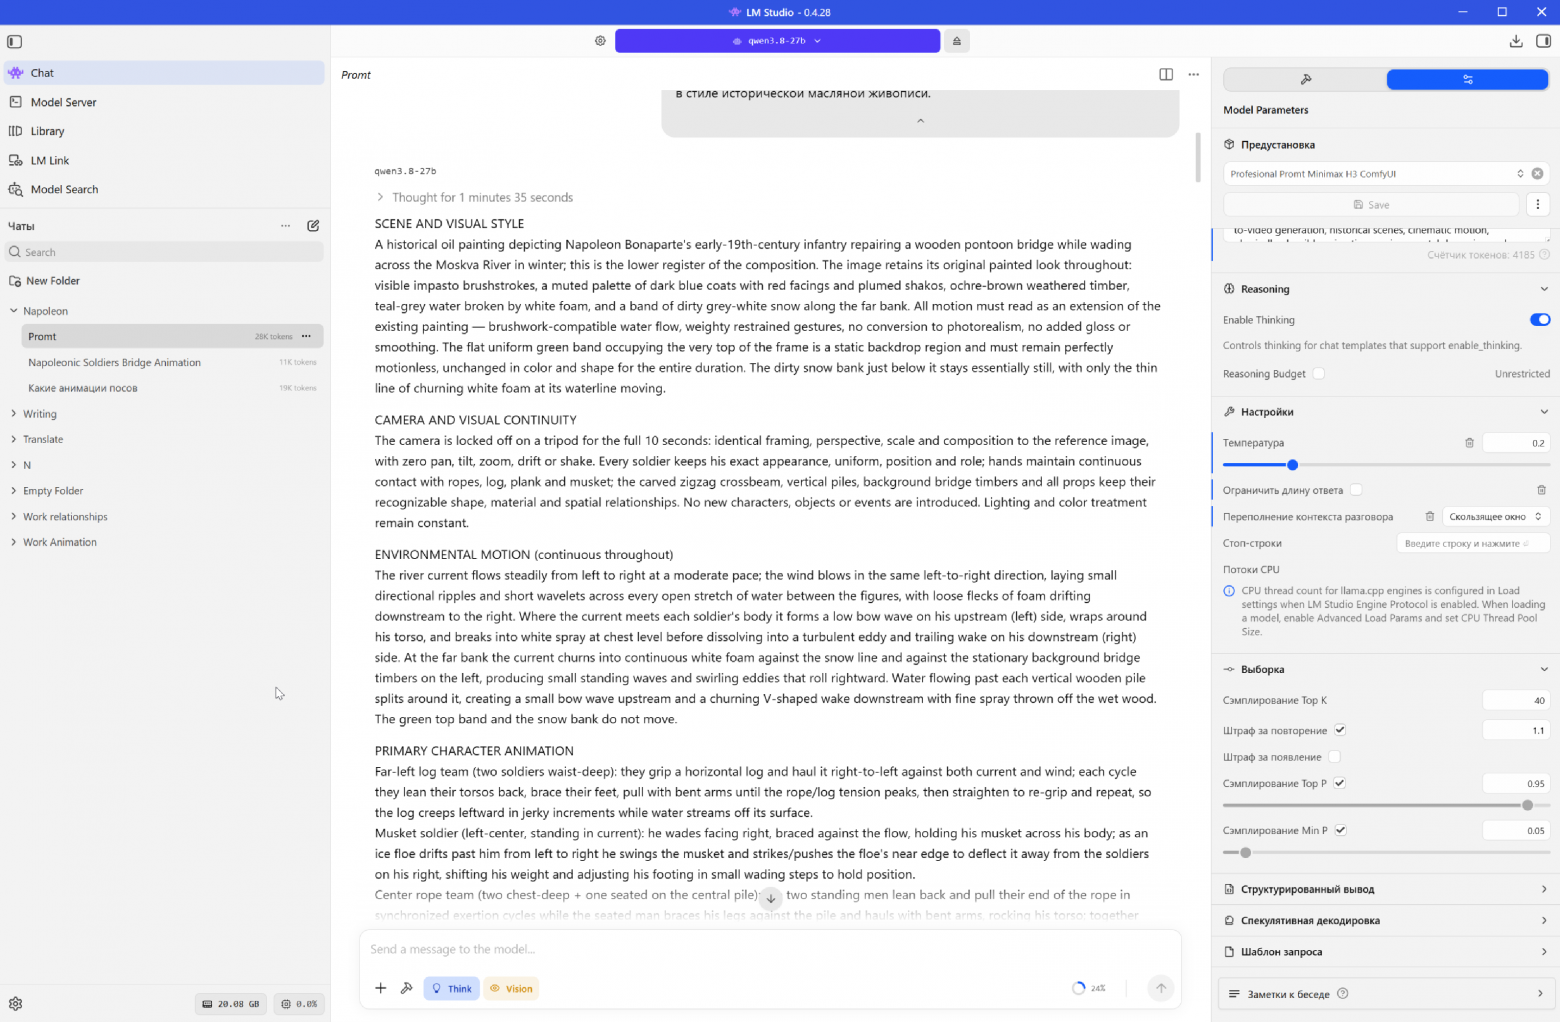
Суть такая: вместо того чтобы каждый раз вручную писать длинный подробный промт, я подаю модели три вещи – мой базовый запрос с описанием желаемого поведения [4] сцены, подготовленный фрагмент картины и набор ограничений для сохранения композиции. Модель смотрит на картинку и собирает из этого специализированный промт под MiniMax H3.
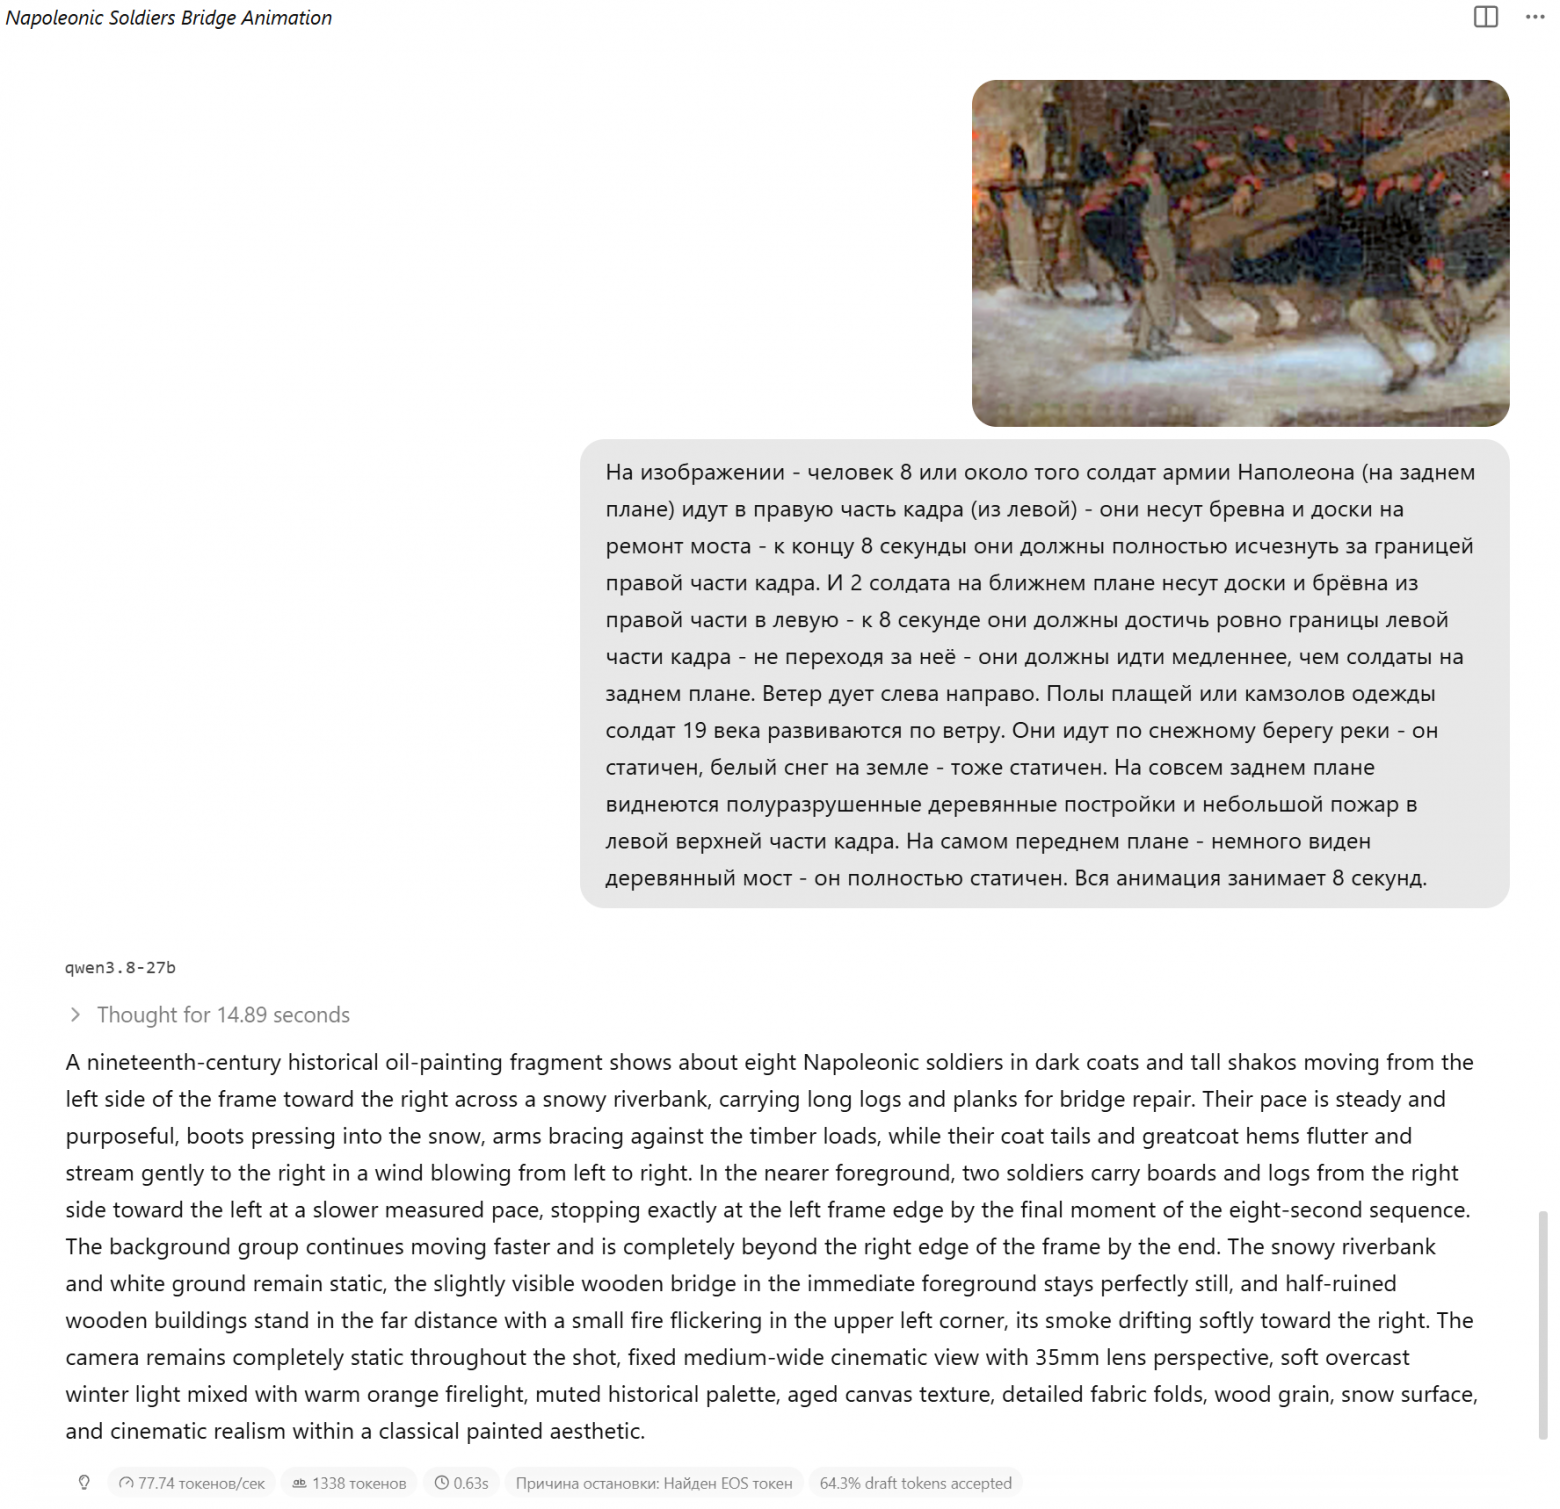
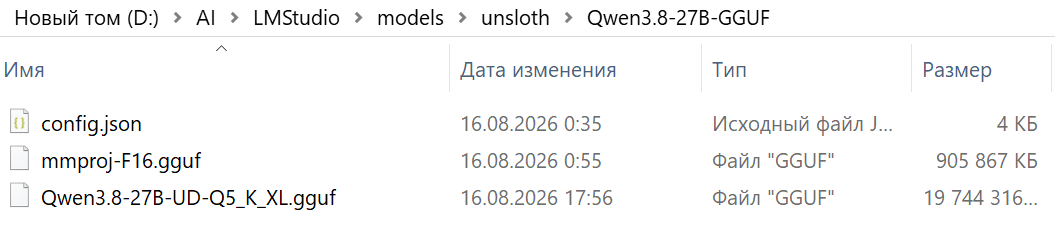
При подготовке запроса я держу в голове несколько вещей: какой именно объект должен двигаться; каким должно быть движение (оно обязанно соответствовать позе и историческому контексту, а не «просто махать руками»); как персонаж взаимодействует с окружением – стоит ли он в воде, держит ли бревно, толкает ли другого человека; и какие ограничения нельзя нарушать – одежда, внешность, композиция и положение соседей должны остаться. По камере я обычно фиксирую исходную точку съёмки, если отдельно динамика камеры не нужна.
На выходе получается довольно плотный промт. В моём случае модель сгенерировала его на английском и очень детально: восемь солдат в тёмных мундирах и шапках идут слева направо по снежному берегу, несут длинные брёвна и доски для ремонта моста, шаг ровный и целеустремлённый, камера полностью статичная, средний план на 35мм, приглушённая историческая палитра, фактура холста. Именно такой уровень описания нужен видеомодели, чтобы не улететь в сторону.
Генерация фрагментов в MiniMax H3 / ComfyUI
Видеогенерацию я кручу через ComfyUI на модели MiniMax H3 (в воркфлоу это minimax_h3_fi2va_pruned_int8_convrot [5], CLIP от qwen3vl_32b [6], VAE fp16 [7]; для ускорения вешаю LORA под 10 шагов [8] и включаю режим SagaAttention в ComfyUI и добавляю дополнительное ускорение через ноду Spectrum).
Идея прежняя: каждый подготовленный фрагмент анимируется отдельно. Так видеомодель не пытается одновременно обработать всю картину с десятками персонажей, а работает с одной областью – одним человеком, движением воды, деревянной конструкцией или группой людей.
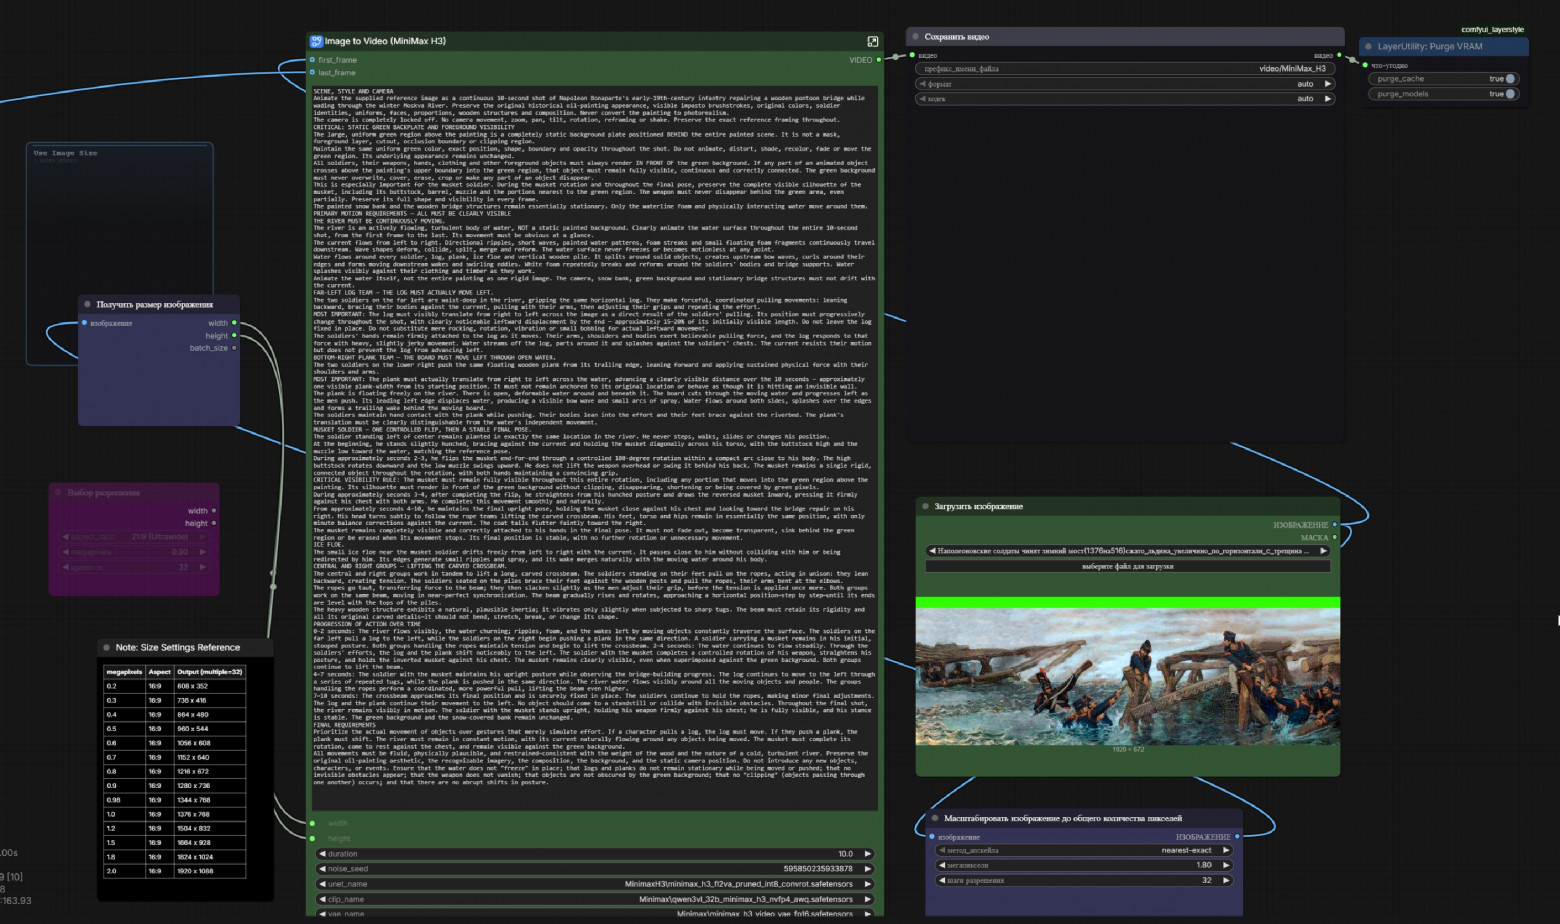
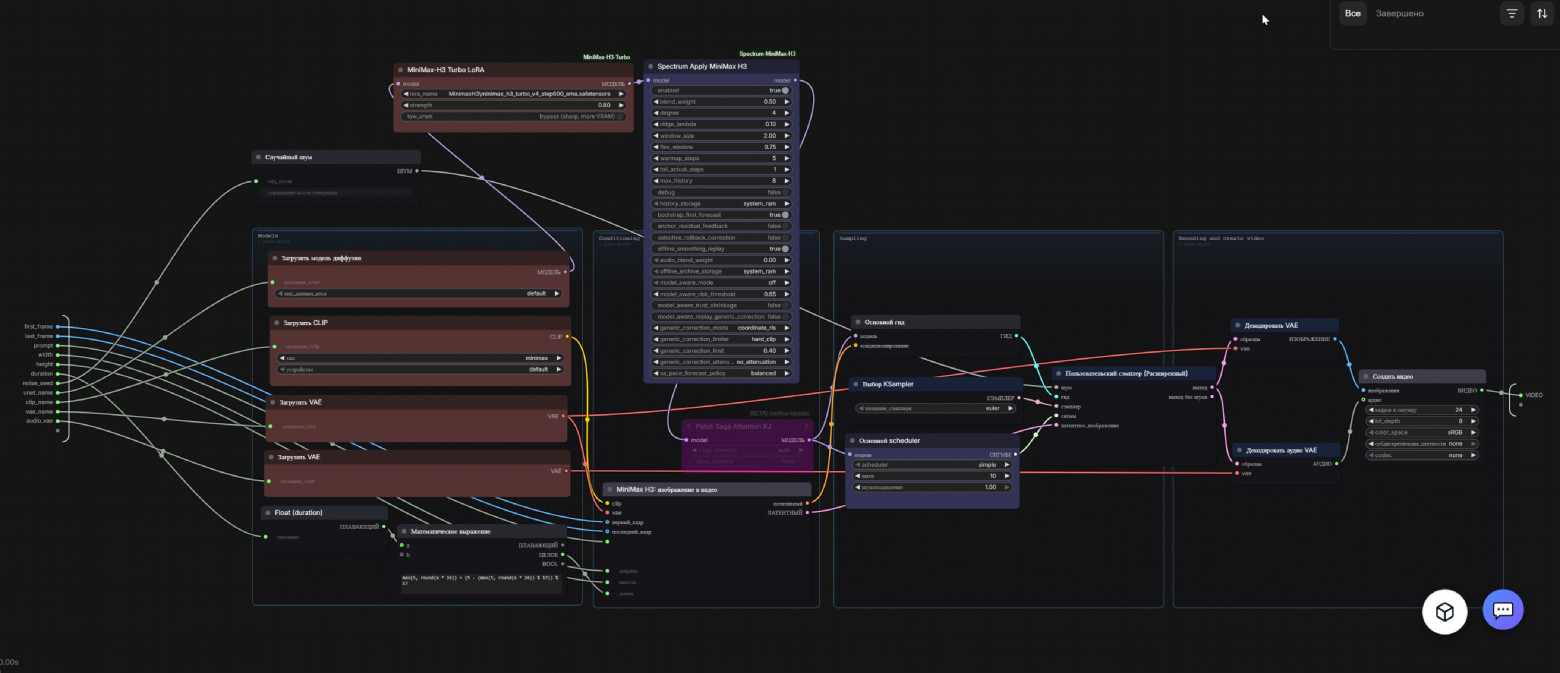
После запуска я смотрю на результат не только “красиво/не красиво”, а пригоден ли он для композитинга: сохранилась ли исходная поза; не изменилось ли количество объектов и конечностей; не проходит ли рука или нога одного персонажа через тело или голову другого; соответствует ли движение физике среды; не появились ли детали, которых в картине не было. Не подошло – правлю промт и гоняю снова.
Тут важный момент, который обычно не показывают в демо-роликах: далеко не каждая генерация доживает до монтажа. По моему опыту [9] на одну по-настоящему удачную попытку приходится четыре-пять неудачных или “почти” вариантов. Это не универсальная статистика для всех моделей, а наблюдение именно за этим производственным процессом. Чем больше объектов и чем сложнее их взаимодействие, тем выше шанс артефактов. Для офицеров с брёвнами и досками в левой части кадров ушло больше 15 попыток та как в некоторых моментах один из офицеров проходил через тело солдата кто ремонтирует мост.
Физика – отдельная проблема: плывущая вода, люди в ледяной воде по пояс, которые одновременно толкают брёвна и держатся друг за друга. Анимировать человека на берегу куда проще, чем того же человека в воде посреди переправы.
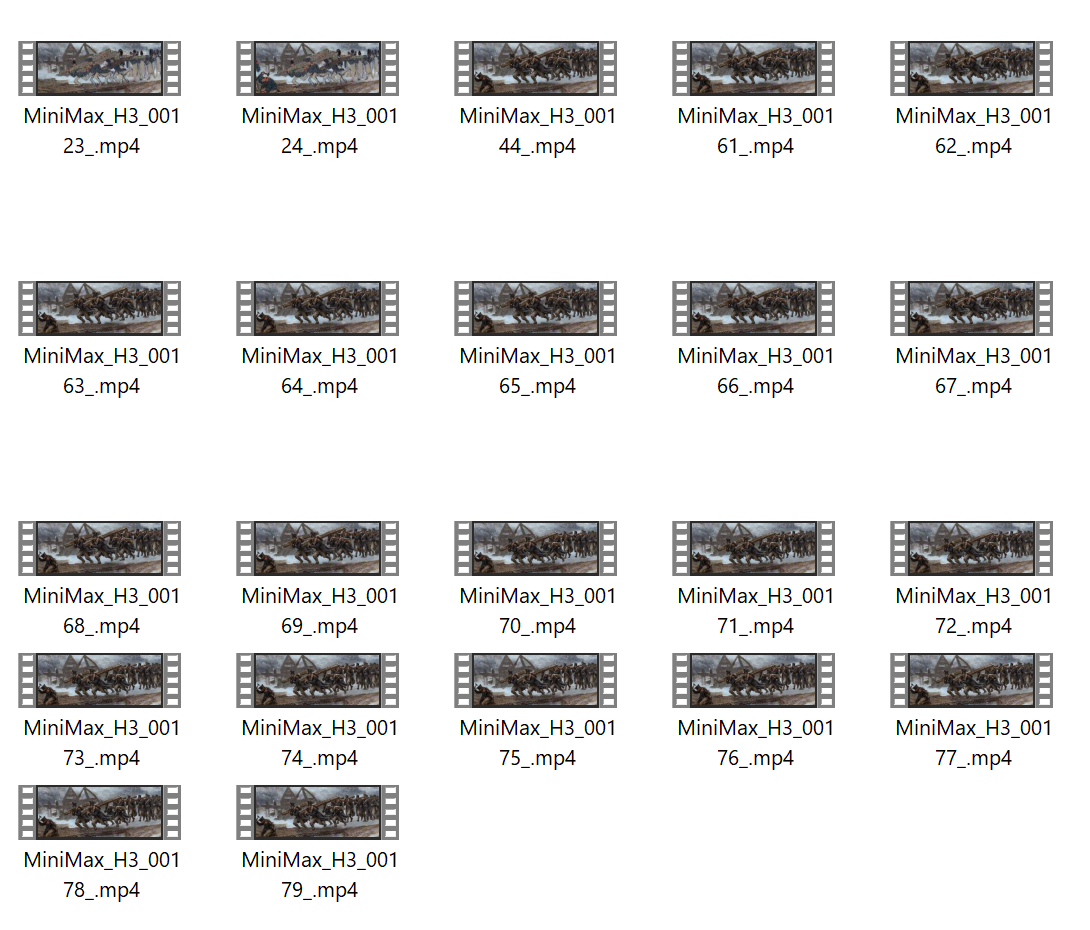
Потому я бы не оценивал сложность такой работы по длине итогового ролика. Несколько секунд чистой анимации могут стоить кучи подготовки, генераций и ручной доработки. (Или как вариант много токенов (или кредитов) для облачных моделей).
Ближний план генерировался на 1.8МП (1824 на 1024). Все остальные планы – на 0.3МП (736 на 416).
Сборка и маски в After Effects
Когда подходящие фрагменты есть, перехожу к их интеграции в After Effects. Я собираю композицию из подготовленных слоёв и сгенерированного видео, расставляя всё по исходным координатам картины – отсюда и правило про систему координат из второго пункта. Так структура оригинала сохраняется, и AI-фрагменты не выглядят как отдельные ролики, просто положенные рядом.
Дальше задача – аккуратно совместить движущиеся объекты с остальной сценой. Где-то для этого нужны дополнительные маски и отделение персонажа от фона. Тут в дело идёт Roto Brush: он выделяет объект по последовательности кадров, я проверяю стабильность маски, подправляю границы и чищу проблемные участки.
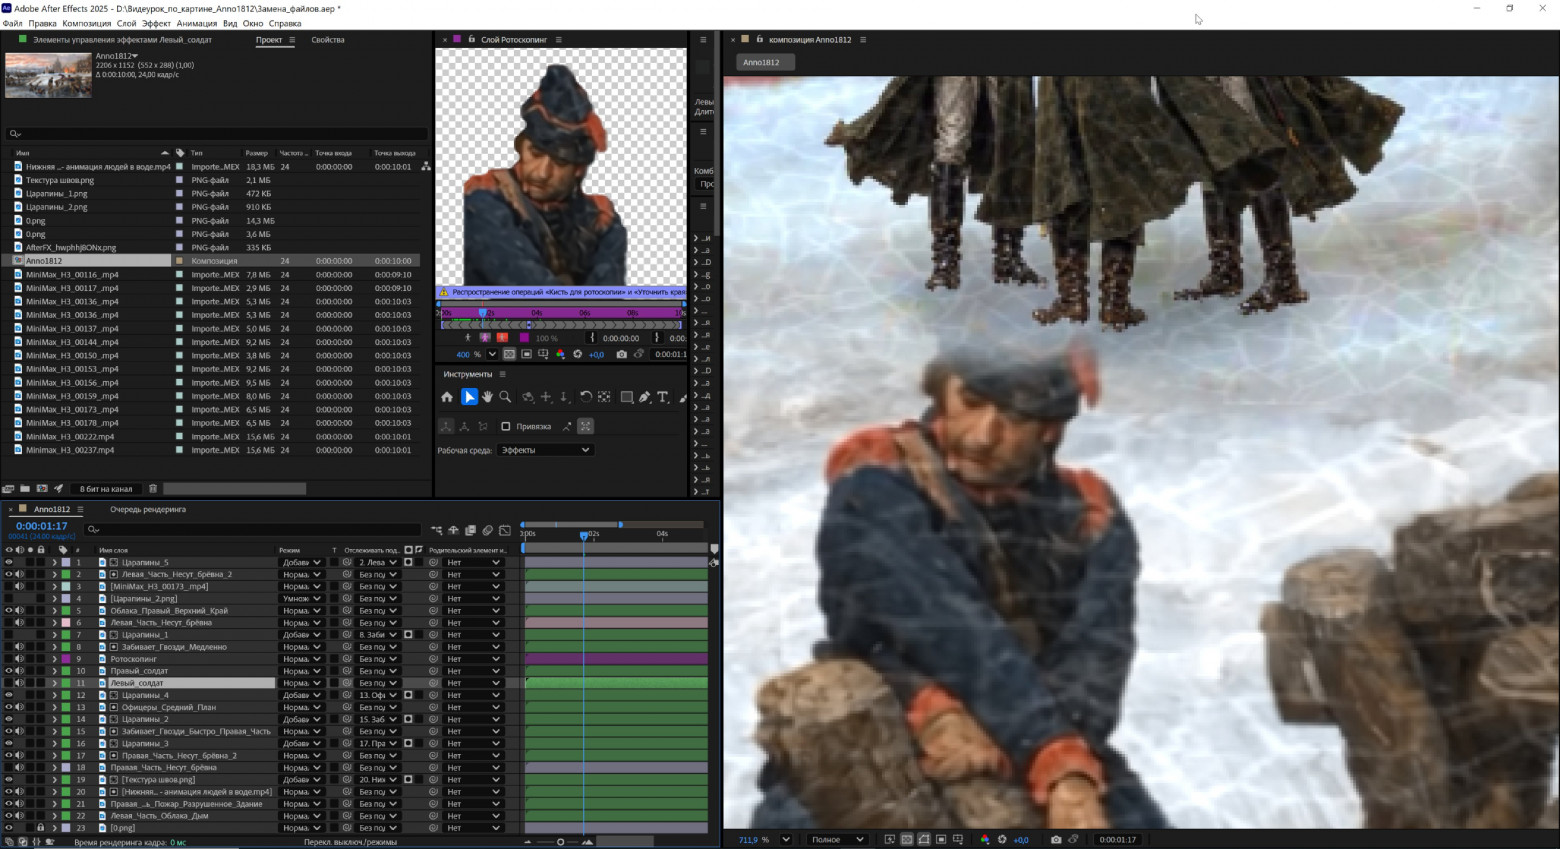
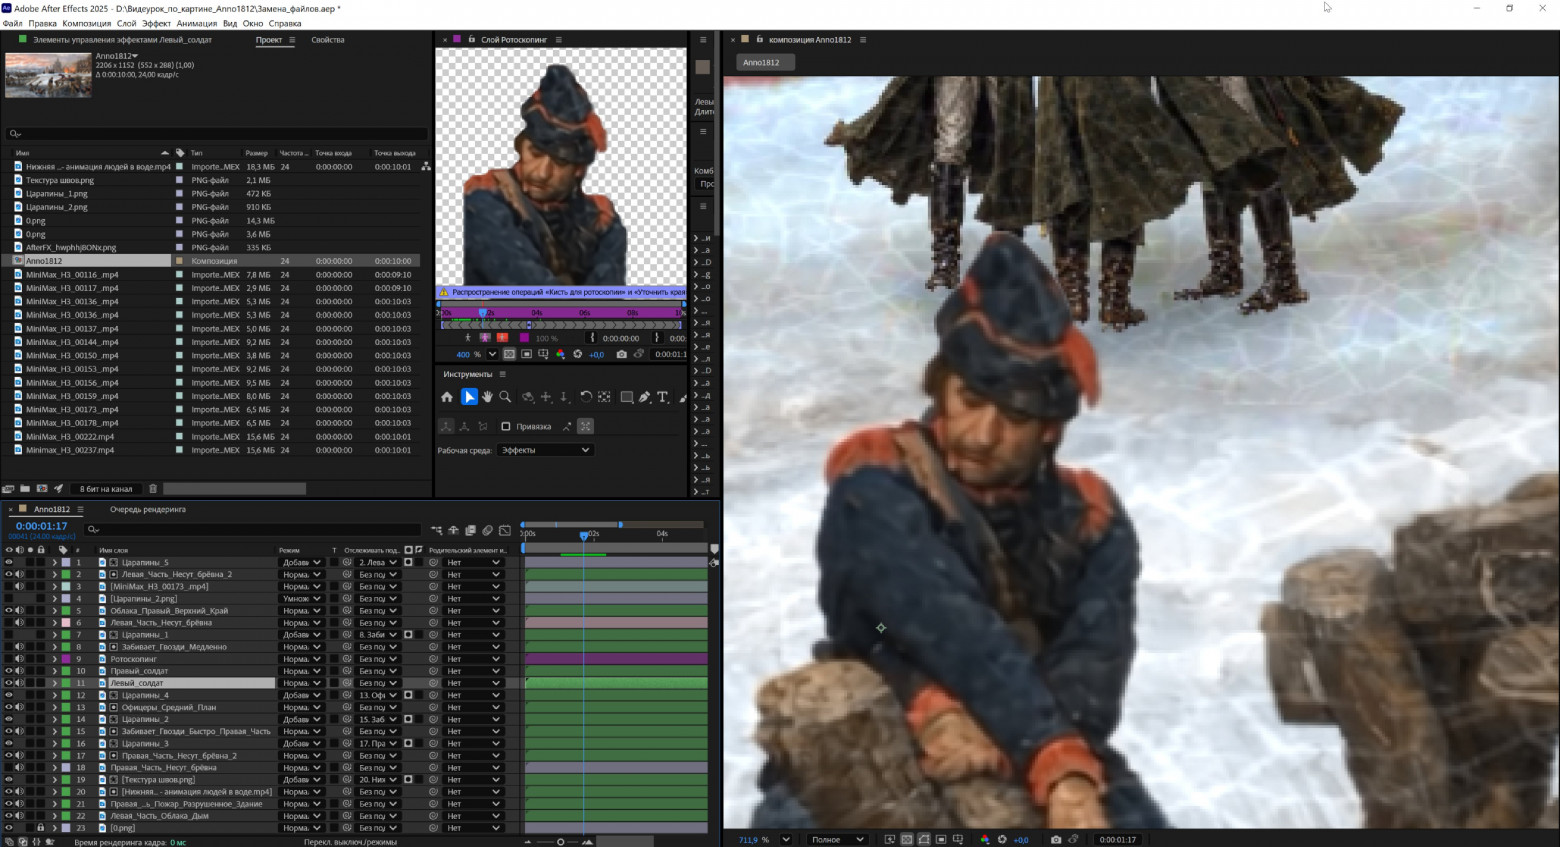
Смотрю особенно внимательно на одежду, руки и ноги – мелкие элементы, где ошибки [10] выделения видны сильнее всего. После этого финальная сборка: совмещаю анимированные элементы с восстановленным фоном, проверяю маски и перекрытия, подгоняю положение и длительность фрагментов, убираю заметные швы и выравниваю общую стилистику, чтобы куски не выбивались по цвету и свету.
В результате отдельные генерации складываются в одну сцену:
Железо, на котором всё это крутится
Основная обработка шла на моей рабочей станции:
|
Компонент |
Конфигурация |
|
CPU |
Intel Core i9-14900K |
|
GPU |
NVIDIA GeForce RTX 5090 |
|
Видеопамять |
32 GB VRAM |
|
Среда видеогенерации |
ComfyUI |
|
Среда локальных LLM |
LM Studio |
|
Видеоредактор |
Adobe After Effects |
|
Растровый редактор |
Adobe Photoshop |
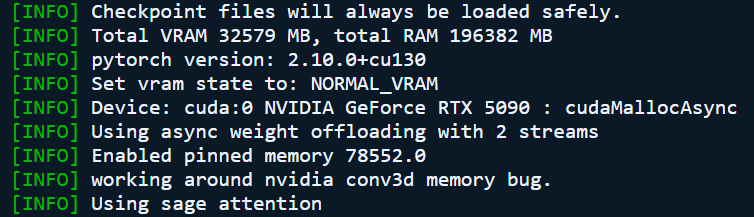
32 ГБ видеопамяти позволяют запускать требовательные модели и собирать сложные локальные воркфлоу прямо на своём компьютере, без облака. Я держу обработку локально. При этом RTX 5090 не является обязательным условием самой методики: отдельные этапы можно делать на более слабом железе, брать облегчённые версии моделей или выносить видеогенерацию в облако. Просто доступные разрешения, скорость и набор запускаемых моделей будут зависеть от конфигурации.
Итоги
В итоге получилась анимированная интерпретация исторической картины: отдельные персонажи и элементы среды двигаются независимо, а исходная художественная композиция при этом сохраняется. В этом проекте традиционная живопись встречается с современными инструментами CGI и AI – и ни одно из них не отменяет другое.
Подход, думаю, пригодится не только для отдельных роликов, но и для музейных экспозиций, мультимедийных инсталляций, исторических выставок и образовательных проектов. Локальный AI позволяет собирать собственные производственные процессы, где несколько моделей работают вместе с привычными VFX-инструментами.
Получившееся видео можно посмотреть в конце YouTube ролика в начале статьи или в группе ТГ по ссылке [12] (ссылка ведёт на конкретный пост-ролик).
Использованные материалы и атрибуция
Оригинальное произведение: Lawrence Alma-Tadema (1836-1912). Anno 1812. Kapitein Benthien aan de Beresina (c. 1859-1869). Amsterdam Museum, collection object SA 4857.
Цифровая репродукция: Wikimedia Commons, Public Domain Mark 1.0 – https://commons.wikimedia.org/wiki/File:Lawrence_Alma-Tadema_12.jpeg [13]

Благодарю Amsterdam Museum за подтверждение возможности публикации образовательного видеоматериала и за рекомендации по атрибуции оригинального произведения.
Опрос: какой эксперимент сделать следующим?
Планирую примерно раз в 10-14 дней выкладывать на Habr материалы про локальные нейросети, AI/CGI, автоматизацию творческих процессов и интеграцию AI в софт. Есть несколько направлений, которые хочется разобрать на практике – выбирайте тему следующей статьи:
Какое направление интереснее? Свою тему тоже можно предложить в комментариях – читаю всё.
Автор: Dmitrii_DAK
Источник [14]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38534
URLs in this post:
[1] Ссылка на оригинал: https://ru.wikipedia.org/wiki/%D0%A4%D0%B0%D0%B9%D0%BB:Lawrence_Alma-Tadema_12.jpeg
[2] https://youtu.be/kedgNXEFHJs?si=XcYYtQ0vVzd9CNhY: https://youtu.be/kedgNXEFHJs?si=XcYYtQ0vVzd9CNhY
[3] Логика: http://www.braintools.ru/article/7640
[4] поведения: http://www.braintools.ru/article/9372
[5] minimax_h3_fi2va_pruned_int8_convrot: https://huggingface.co/DeepBeepMeep/MiniMax-H3/blob/main/MiniMax-H3-FL2VA-pruned_int8_convrot.safetensors
[6] CLIP от qwen3vl_32b: https://huggingface.co/DeepBeepMeep/MiniMax-H3/blob/main/Qwen3-VL-32B-Instruct/qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
[7] VAE fp16: https://huggingface.co/DeepBeepMeep/MiniMax-H3/blob/main/MiniMax-H3-video_vae_fp16.safetensors
[8] LORA под 10 шагов: https://huggingface.co/DeepBeepMeep/MiniMax-H3/blob/main/loras/minimax_h3_light2xv_fl2v_turbo_8step_alpha8_v1.0_bf16.safetensors
[9] опыту: http://www.braintools.ru/article/6952
[10] ошибки: http://www.braintools.ru/article/4192
[11] внимания: http://www.braintools.ru/article/7595
[12] по ссылке: https://t.me/photoudzen/2063
[13] https://commons.wikimedia.org/wiki/File:Lawrence_Alma-Tadema_12.jpeg: https://commons.wikimedia.org/wiki/File:Lawrence_Alma-Tadema_12.jpeg
[14] Источник: https://habr.com/ru/articles/1107574/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1107574
Нажмите здесь для печати.