От чата до тёмной фабрики: шесть уровней ИИ в разработке и почему мы остановились на L4
Больше года я внедряю ИИ в разработку зрелой SaaS-компании, вместе со сложившейся инженерной командой, которая поначалу относилась к ИИ скептически. Мы прошли большой путь: от копирования кода из ИИ-чата до того, что отдаём агентам разработку фич целиком. Мы не занимаемся вайб-кодингом и не делаем продукт за вечер одним промптом. То, чем мы занимаемся, я называю AI-инженерией: мы строим систему, которая стабильно выдаёт результат по нашим стандартам качества. Сейчас мы экспериментируем с полуавтономной агентной фабрикой в облаке.
Этот путь я разложил на шесть уровней, от привычной ручной разработки до «тёмной фабрики». Ниже — как меняется жизненный цикл разработки на каждом уровне, какова роль человека, как понять, где сейчас ваша команда, и что нужно, чтобы двигаться дальше.
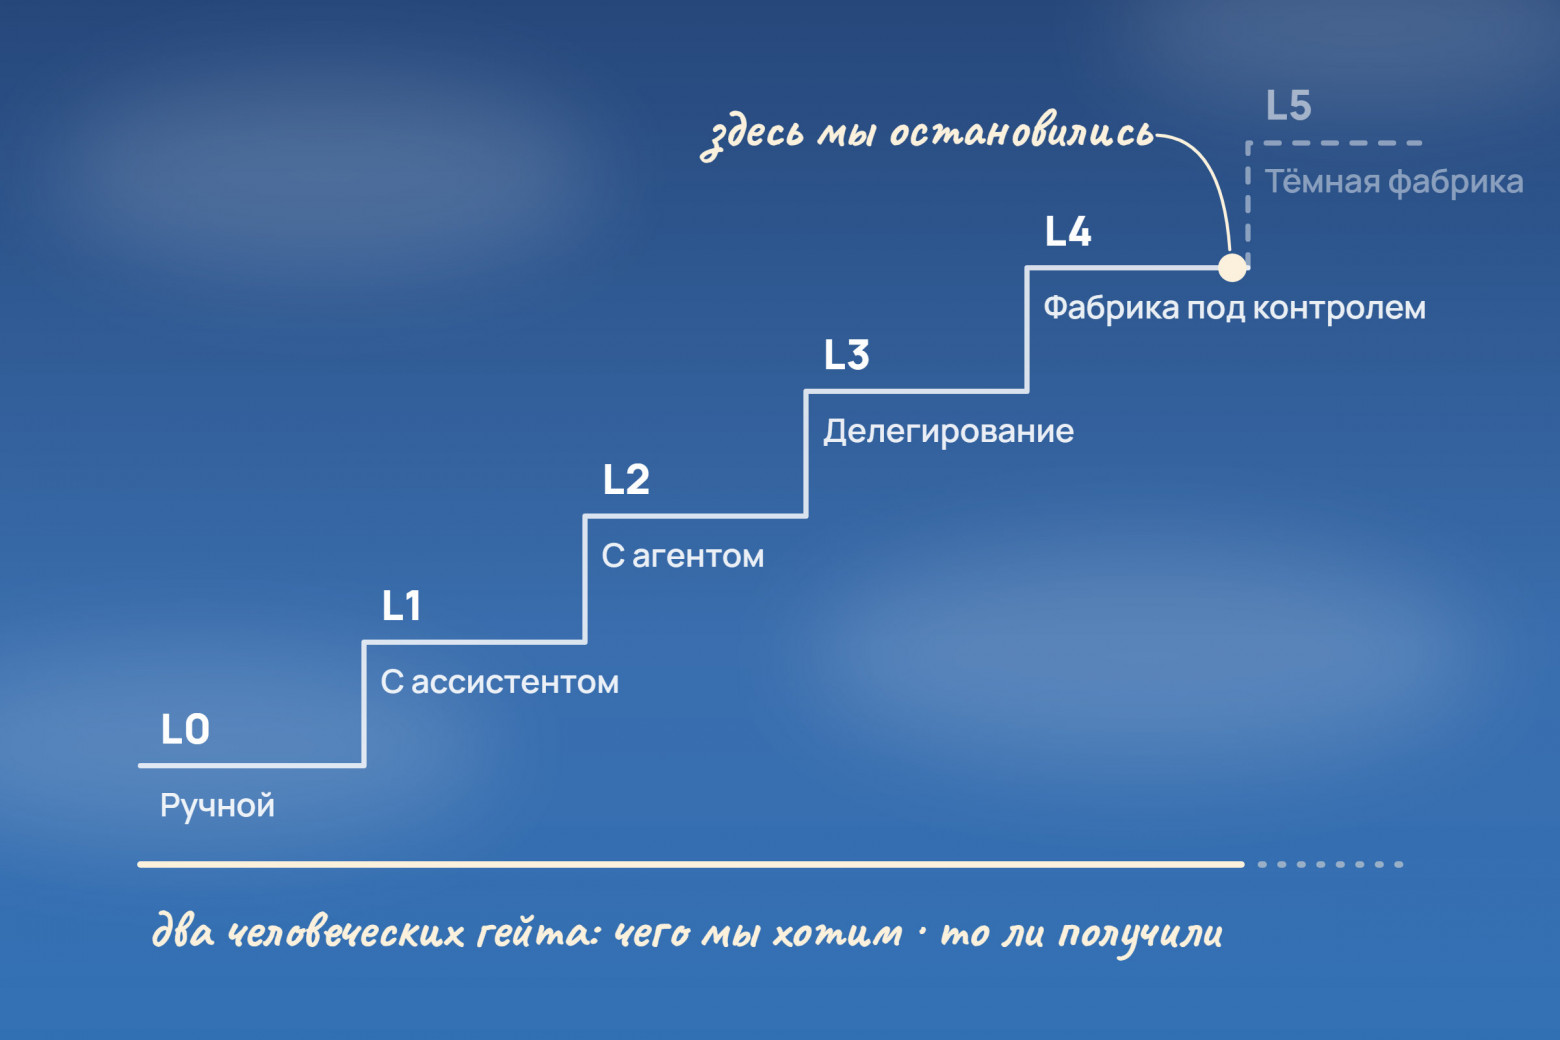
Много текста? На сайте есть интерактивная схема [1] со всеми уровнями и практиками. Встроить интерактив в статью на Хабре нельзя, поэтому как дополнение.
L0 Ручной: точка отсчёта, где каждый этап делаем сами
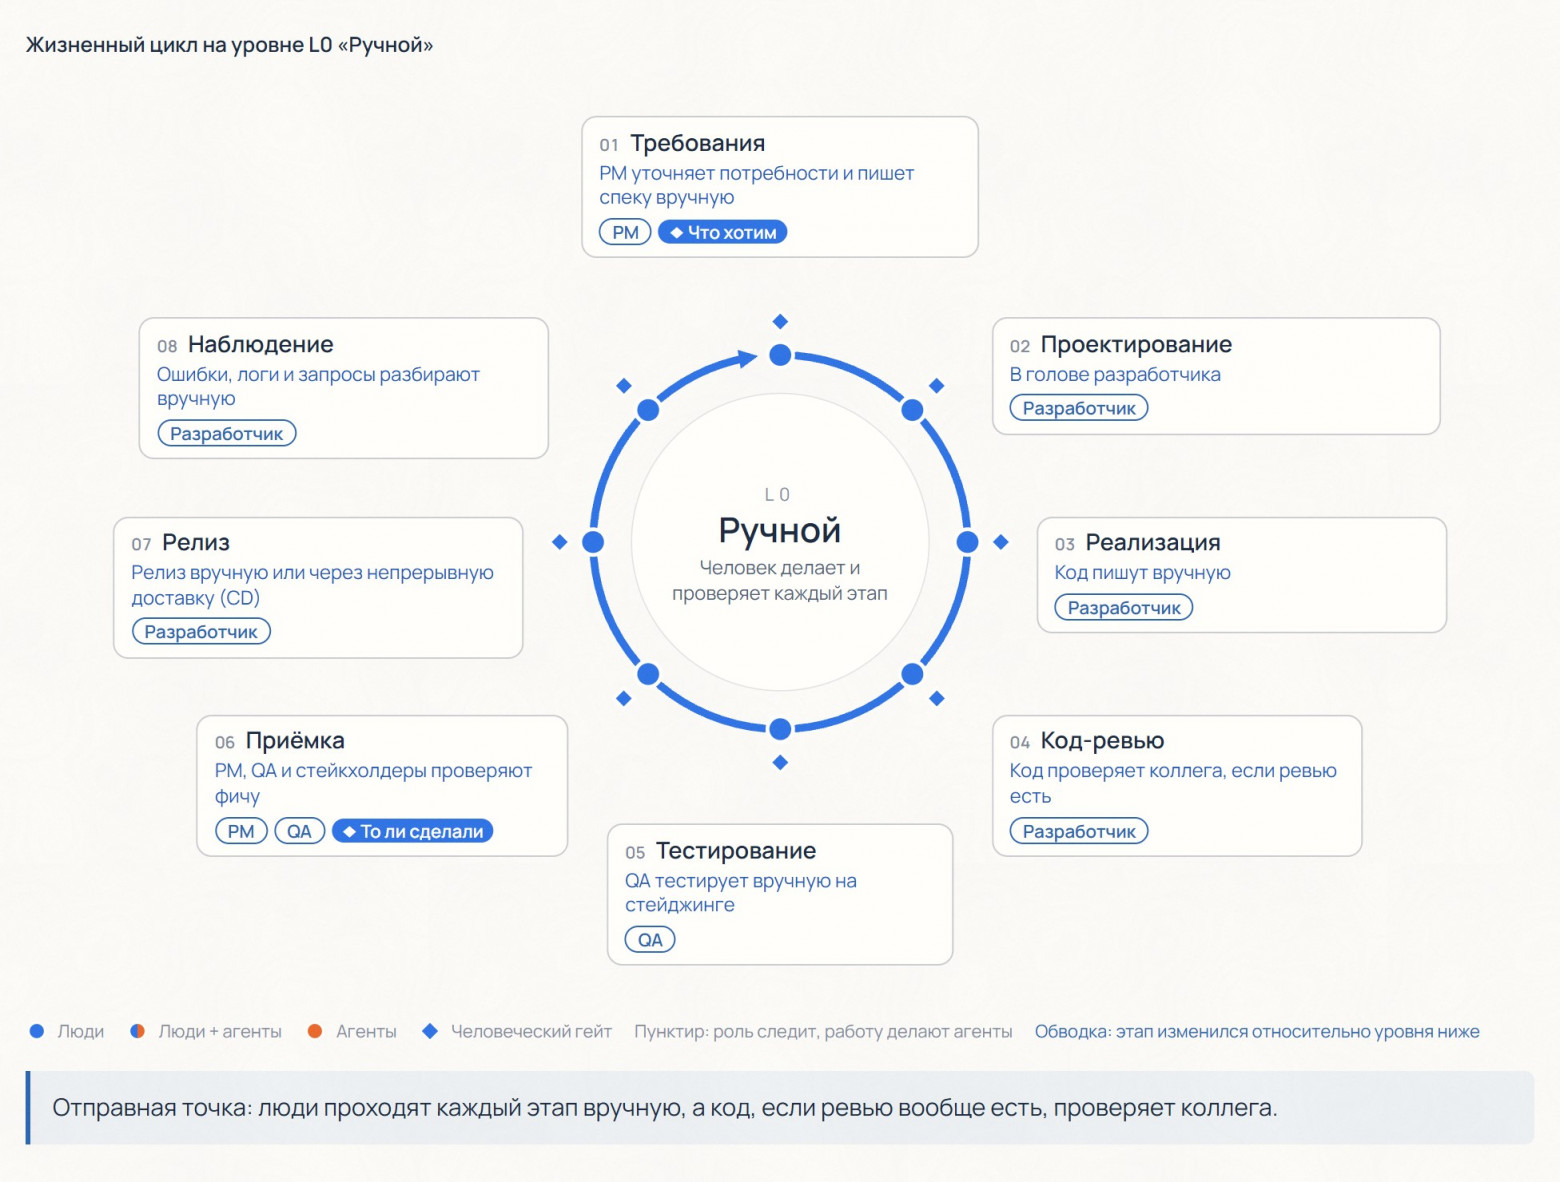
На L0 люди делают каждый этап жизненного цикла вручную, как раньше: от сбора требований и написания кода до релиза и мониторинга.
Два года назад запросы на новые фичи и обращения в поддержку наша команда разбирала вручную, спека была страницей в Notion, а план реализации существовал только в голове разработчика. Часть сервисов жила по trunk-based development [2]: комиты прямо в мастер, без пул-реквестов и без ревью. Где ревью было, его делал коллега-разработчик по своему усмотрению. QA тестировали вручную на общем staging-сервере по исходной спеке PM, которая после реализации могла устареть. Были и Playwright-тесты. В некоторых проектах было хорошее покрытие тестами и настроен статический анализ. Это хороший задел, потому что для агентной разработки CI критически важен.
Практики L0
🔴 критична — без неё уровень ломается; 🟠 обязательна — уровень её требует; 🟢 усиливает — помогает на этом уровне.
Организация
-
🔴 Инженерная база: контроль версий, таск-трекер, база знаний, пайплайн релизов — хранить каждое изменение, задачу и ответ в одном месте, автоматизированный релиз.
-
🟢 Шаблоны проектов и репозиториев — начинать каждый проект с одной и той же структурой, гейтами качества, правилами.
-
🟢 Quality Gates: тесты, статический анализ, автоматический CI — ловить регрессии до релиза.
-
🟢 Работа через пул-реквесты: каждое изменение идёт через PR, а не напрямую в основную ветку — одно место для взаимодействия, ревью и истории.
PM
-
🟠 Отвечает за требование: переводит потребности [3] клиентов и видение стейкхолдеров в требования
-
🟠 Пишет спеку вручную
-
🟠 Принимает фичу вместе с QA: человеческий гейт
Разработчик
-
🟠 Планирует в голове
-
🟠 Пишет код вручную
-
🟠 Релизит вручную или через CD
-
🟠 Разбирает ошибки [4], логи и запросы вручную
-
🟢 Коллега читает каждую строку
QA
-
🟠 Составляет тест-кейсы вручную
-
🟠 Тестирует на тестовом окружении по спеке
-
🟠 Принимает фичу вместе с PM
L1 С ассистентом: вы советуетесь с начитанным собеседником
Практики L1
🟠 обязательна — уровень её требует; 🟢 усиливает — помогает на этом уровне.
Практики, которые уже были на L0, здесь не повторяю, если их статус не вырос: они в спойлерах уровней ниже.
Организация
-
🟠 Позиция по ИИ-инструментам и доступ к одобренным — сказать, какими ИИ-инструментами можно пользоваться и как.
PM
-
🟠 Набрасывает спеку в ИИ-чате по заметкам с требованиями
Разработчик
-
🟠 Спрашивает чат, как спроектировать, объяснить или исправить код
-
🟠 Копирует код из чата или принимает автодополнение фрагмент за фрагментом
-
🟠 Вставляет ошибки в чат
QA
-
🟢 Набрасывает тест-кейсы и тестовые данные в чате
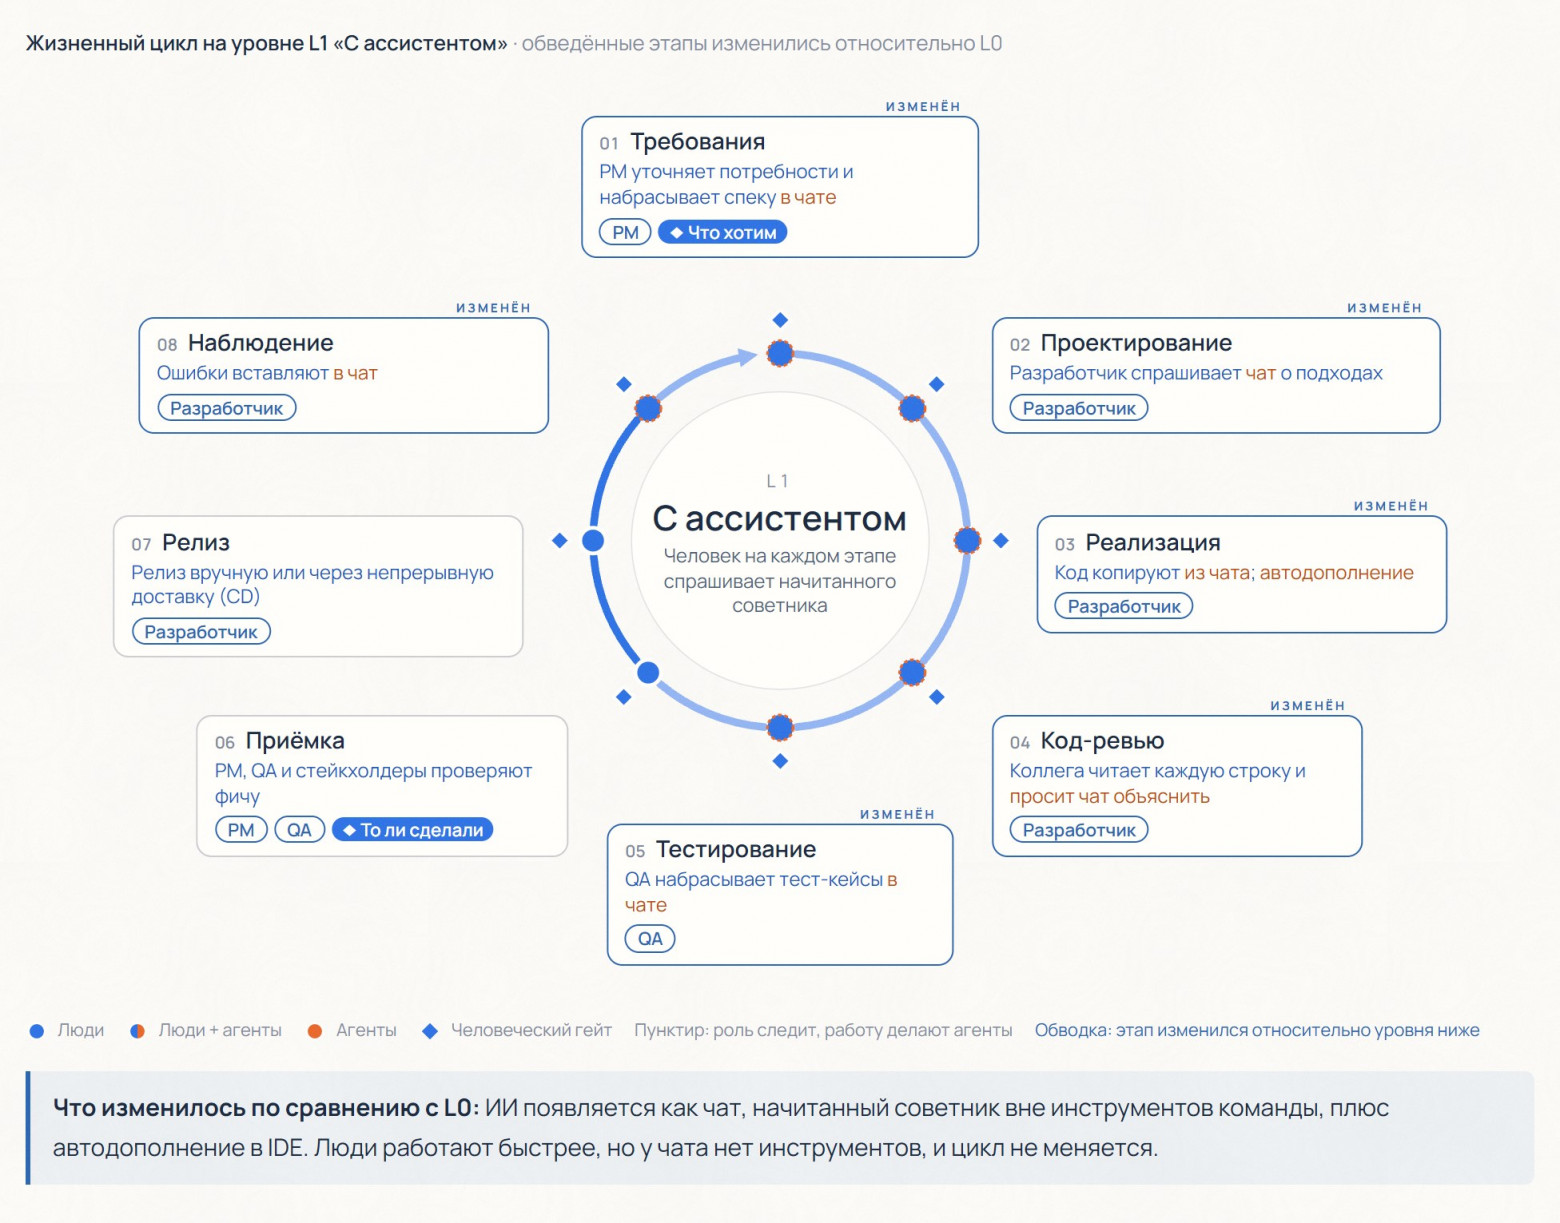
На L1 у вас появляется подписка на ChatGPT, и вы начинаете задавать вопросы собеседнику, который как будто прочитал разом все IT книги, — мудрому и всегда доступному коллеге за соседним столом. Вы спрашиваете, как спроектировать фичу, просите набросать спеку, объяснить кусок кода, написать эффективный алгоритм или найти в нём ошибку. Он даже может написать простой скрипт, и вы копируете его обратно в IDE.
Потом в IDE появляется autocomplete или AI Assistant, и вы начинаете бесконечно жать Tab и Accept. Вы работаете на уровне мелких правок и принимаете подсказки сниппет за сниппетом.
Люди решают задачи быстрее, но по сути ничего не меняется: у чата нет доступа к артефактам команды и нет инструментов, чтобы действовать за пределами разговора. Дэн Шапиро [5], известный автор в AI-сообществе, сравнивает этот уровень с удержанием полосы и круиз-контролем: вы отдаёте конкретные, отдельные задачи «ИИ-стажёру».
Организации здесь нужно немного: дать доступ к ИИ-инструментам и чётко сказать, какие из них разрешены и как ими пользоваться.
L2 Работаем с агентом: вы учите агента-джуна правилам команды
Практики L2 «С агентом»
🟠 обязательна — уровень её требует; 🟢 усиливает — помогает на этом уровне.
Практики, которые уже были на L1, здесь не повторяю, если их статус не вырос: они в спойлерах уровней ниже.
Организация
-
🟠 Quality Gates: тесты, статический анализ, автоматический CI — ловить регрессии до релиза.
-
🟠 Работа через пул-реквесты: каждое изменение идёт через PR, а не напрямую в основную ветку — дать каждому изменению агента одно место для гейтов, ревью и истории.
-
🟠 Файлы контекста (AGENTS.md) в каждом репозитории, разбитые на части, которые агент подгружает по необходимости — дать агенту специфичные домену знания и правила команды, научить работать с проектом как надо не переполняя его контекст.
-
🟠 Доступ агента к инструментам и внутренним данным: скрипты проверок, MCP-серверы, трекер, документация, логи, браузер — дать агенту проверять свою работу и читать то же, что читают люди.
-
🟠 Правило на каждый повторяющийся “косяк” агента, его пишет человек — не дать агенту повторять [6] ошибку.
-
🟠 Личные скиллы: описанный процесс, который агент может выполнить; подходящие команде скиллы становятся общими — научить агента повторяющемуся процессу.
-
🟢 Регламенты как скиллы: стандартные процедуры записаны в скиллы, которые проверяют, что работа им следует — соблюдать договорённости команды (формат PR, ссылки на тикеты, QA-тикеты), не полагаясь на память [7].
-
🟢 Метки ИИ: каждое изменение, сделанное с ИИ, помечено, и указаны его скиллы — видеть, сколько работы делают агенты и как сделана каждая фича.
-
🟢 Записанные архитектурные принципы, ADR и журнал решений — дать агентам и людям одни и те же рамки.
-
🟢 Правило двух для агентов: в продакшене по умолчанию только чтение — не давать одной сессии сразу недоверенный ввод, приватные данные и право действовать.
-
🟢 Гейты безопасности: статический анализ, сканирование зависимостей и секретов — блокировать небезопасный код без построчного ревью.
PM
-
🟠 Пишет спеку с агентом, у которого есть доступ к документации, коду и трекеру: агент расспрашивает PM, PM решает на продуктовых развилках
-
🟢 Получает черновики спек из входящих запросов
-
🟢 Шаблон спеки, оптимизированный для ИИ
-
🟢 Скилл для написания спек: сначала личный, потом командный
-
🟢 Хранит спеки, планы, тест-кейсы и отчёты в репозитории рядом с кодом; знает основы Git: ветки и версии
Разработчик
-
🟠 Планирует с локальным агентом и направляет его
-
🟠 Локальный агент пишет код; разработчик направляет каждый шаг
-
🟠 Ведёт файлы контекста: правила команды в AGENTS.md, разбитые на части, которые агент подгружает по необходимости
-
🟠 Агент прогоняет обязательные проверки CI на своей работе
-
🟠 Добавляет правило на каждый повторяющийся “косяк” агента
-
🟠 Пишет личные скиллы для повторяющейся работы
-
🟠 Читает каждый дифф по ходу работы
-
🟢 Локальный агент читает логи и ошибки по запросу
QA
-
🟠 Агент генерирует тест-кейсы по спеки и реализации
-
🟠 Прогоняет тест-кейсы, которые сгенерировал агент
-
🟠 Тестирует творчески: сомневается в требованиях, исследует, находит неудобные случаи
-
🟢 Агент прогоняет детерминированные сценарии в браузере
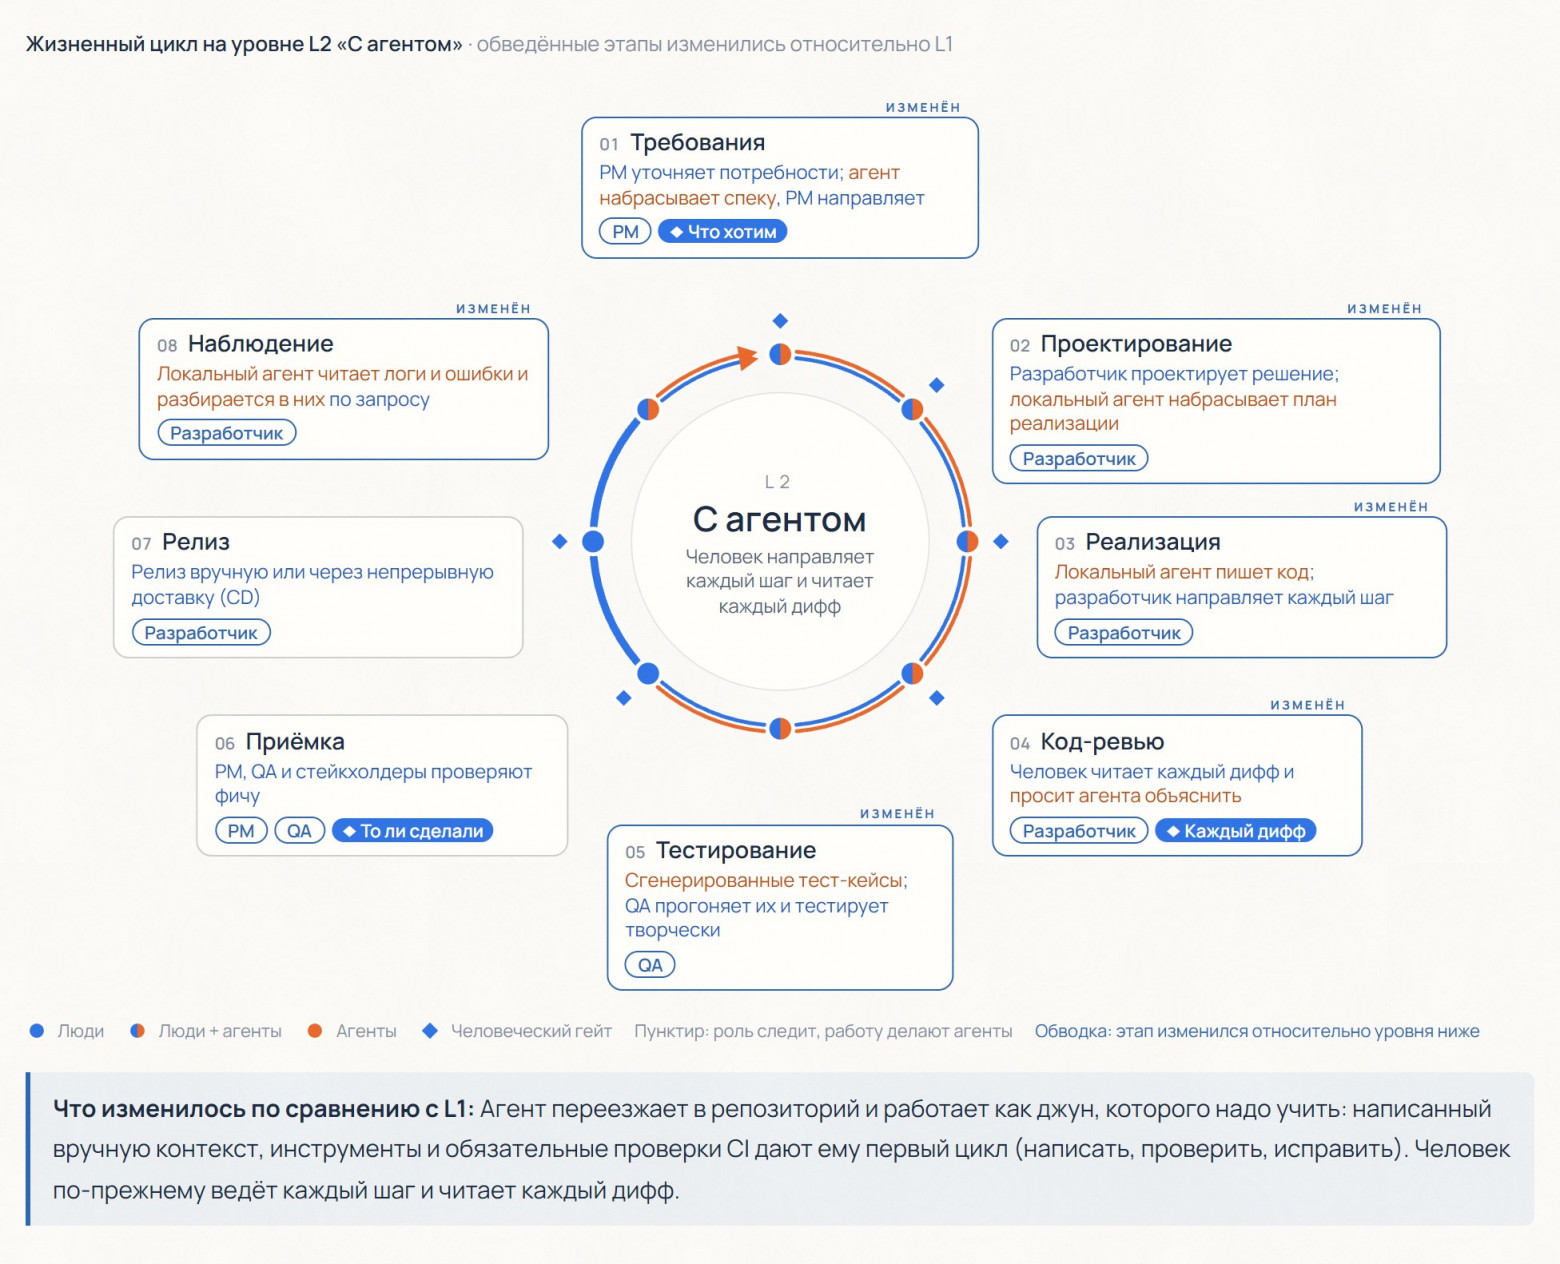
На L2 у вас появляется агент — Claude Code или Codex. Он умеет не только вести с вами заумные диалоги в чате, но и менять проект: пишет тексты, спеки и код прямо в репозитории. Но скоро выясняется, что мудрый начитанный собеседник кодит как посредственный джун. Он пишет спеки и код так, как пишет интернет, а не так, как принято в вашей команде. Результата хватает, чтобы впечатлить бизнес, но всё начинает разваливаться, как только до продукта доходят настоящие пользователи. Поэтому вы начинаете учить джуна правилам: строите «мир, основанный на правилах», и задаёте контекст.
«Смотри, я за вечер собрал 80% продукта одним промптом»
…через год: всё ещё отлаживаю оставшиеся 20%.
В каждый репозиторий вы кладёте короткий, написанный руками AGENTS.md с правилами и инструкциями команды. Агент загружает его в каждую сессию и использует как долговременную память [8] проекта. AGENTS.md уже стал стандартом [9]: его выпустила OpenAI в 2025 году, а теперь им управляет Linux Foundation [10]. В нём вы собираете то, что рассказали бы новому разработчику и чего он не понял бы из кода сам: как устроен проект, архитектурные границы, паттерны, naming conventions, язык предметной области и доменные знания.
И всё равно агент не всегда делает по-вашему. Каждый раз, когда он ошибается, вы добавляете инструкции, которые объясняют, как «правильно». Ваша работа смещается от кодинга фич к созданию системы, которая кодит фичи: запустить агента, посмотреть результат, поправить инструкции. Ещё вы даёте джуну инструменты: команды и скрипты, которые запускают тесты и статический анализ; коннекторы к MCP-серверам базы знаний компании, логов прода и Sentry; браузер, чтобы прокликивать интерфейс. Когда AGENTS.md разрастается, вы дробите его на файлы, которые агент загружает лениво, только по необходимости, а повторяющиеся задачи превращаются в скиллы.
Гейты качества (quality gates) важны так же, как контекст. Гейт — это проверка, которую изменение должно пройти до слияния в основную ветку: сборка, тесты, статический анализ. Без гейтов джун-агент слепой: он не получает обратной связи и не ловит собственные регрессии. В нашей команде агент сверяет свою работу с обязательными проверками CI: тестами, статическим анализом кода, сборкой и проверкой архитектурных границ. Это первый цикл, который осваивает любой джун: написать код, запустить проверки, увидеть ошибки, исправить их. Этому циклу нужны пул-реквесты: trunk-based development без ревью работал в некоторых наших сервисах, пока код писали люди, но изменениям агента нужны CI и ревью.
QA тоже меняется. Когда агент умеет прокликивать приложение в браузере, он берёт на себя детерминированную часть тестирования, где сценарии чётко определены. Творческая часть остаётся за людьми: ставить продуктовые требования под сомнение, придираться к дизайну и UX, опираться на свой вкус [11] и опыт [12].
Результат L2 — база знаний о вашем проекте: его архитектура, стандарты и процессы. Вы наполняете её (Базу знаний не только наполняют, но и чистят от лишних деталей: модели становятся сильнее, и часть подсказок им больше не нужна.), пока агент не начнёт стабильно выдавать результат, который отвечает ожиданиям команды. Эту часть процесса нельзя пропустить по пути на L3: даже если вы начинаете с шаблона или берёте готовую базу знаний, контекст всё равно придётся адаптировать к новому проекту.
L3 Делегируем агенту: личные практики становятся общим процессом с владельцами
Практики L3 «Делегирование»
🔴 критична — без неё уровень ломается; 🟠 обязательна — уровень её требует; 🟢 усиливает — помогает на этом уровне.
Практики, которые уже были на L2, здесь не повторяю, если их статус не вырос: они в спойлерах уровней ниже.
Организация
-
🟠 Общие скиллы и процессы: один реестр, у каждого владелец — сделать работу всей команды с агентами единообразной.
-
🟠 Регламенты как скиллы: стандартные процедуры используются в скиллах, которые проверяют, что работа им следует — соблюдать договорённости команды (формат PR, ссылки на тикеты, QA-тикеты), не полагаясь на память.
-
🟠 Метки ИИ-работы: каждое изменение, сделанное с ИИ, помечено, и указаны его скиллы — видеть, сколько работы делают агенты и как сделана каждая фича.
-
🟠 Разработка по SDD (spec-driven development): спека, план и реализация в одном общем процессе и среде — проводить каждую фичу одним путём.
-
🟠 Цикл ИИ-ревью: второй агент ревьюит каждый пул-реквест, скилл исправляет обоснованные замечания — ловить проблемы до того, как код прочитает человек.
-
🟠 Записанные архитектурные принципы, ADR и журнал решений — дать агентам и ревьюерам одни и те же границы.
-
🟢 Цикл самоулучшения: когда исправление повторяется, агент предлагает проверку, правку скилла или контекста, а человек её утверждает — чинить систему, а не очередной пул-реквест.
-
🟢 Дизайн-система в коде — дать агентам собирать UI из проверенных частей, а PM прототипировать на реальных компонентах, а не в Figma.
-
🟢 Метрики поставки: lead time, дефекты, переделки, доля принятых изменений — доказать, что фабрика даёт результат, и лучше, чем прежний способ работы.
-
🟢 Фича-флаги и быстрый откат — сделать ошибку дешёвой в откате.
-
🟢 Трейсинг агентов — видеть, что агент сделал и почему.
-
🟢 Политика решений и эскалации с журналом решений — определить, кто что решает сам и где должен спросить, и проверять принятые решения.
-
🟢 Evals: автотесты для агентов — знать, хорошо ли агент всё ещё делает работу.
-
🟢 ИИ-шлюз: один путь к моделям, стоимость каждого запуска агента, затем бюджеты и лимиты — знать, сколько стоит каждая фича, и останавливать неконтролируемые траты.
-
🟢 Обвязка агента (harness), независимая от вендора и модели — менять модели и вендоров, не перестраивая процесс, даже если вендор отключит доступ.
-
🟢 Песочницы: временные изолированные среды — ограничить вред, который может нанести агент.
PM
-
🟠 Шаблон спеки, готовый для ИИ
-
🟠 Скилл для черновика спеки: сначала личный, потом командный
-
🟠 Хранит спеки, планы, тест-кейсы и отчёты в репозитории рядом с кодом; знает основы Git: ветки и версии
-
🟢 Спрашивает агента, как работает продукт
-
🟢 Прототипирует в реальном приложении на компонентах дизайн-системы, в среде для прототипов, которую легко поднять
Разработчик
-
🟠 Принимает архитектурные решения: агент набрасывает план, разработчик его утверждает
-
🟠 Передаёт спеку и план общему скиллу фичи и получает пул-реквест после ревью
-
🟠 Читает готовую фичу построчно
-
🟢 Выбирает ошибку для общего скилла триажа и утверждает его план
QA
-
🟠 Агент прогоняет детерминированные сценарии в браузере
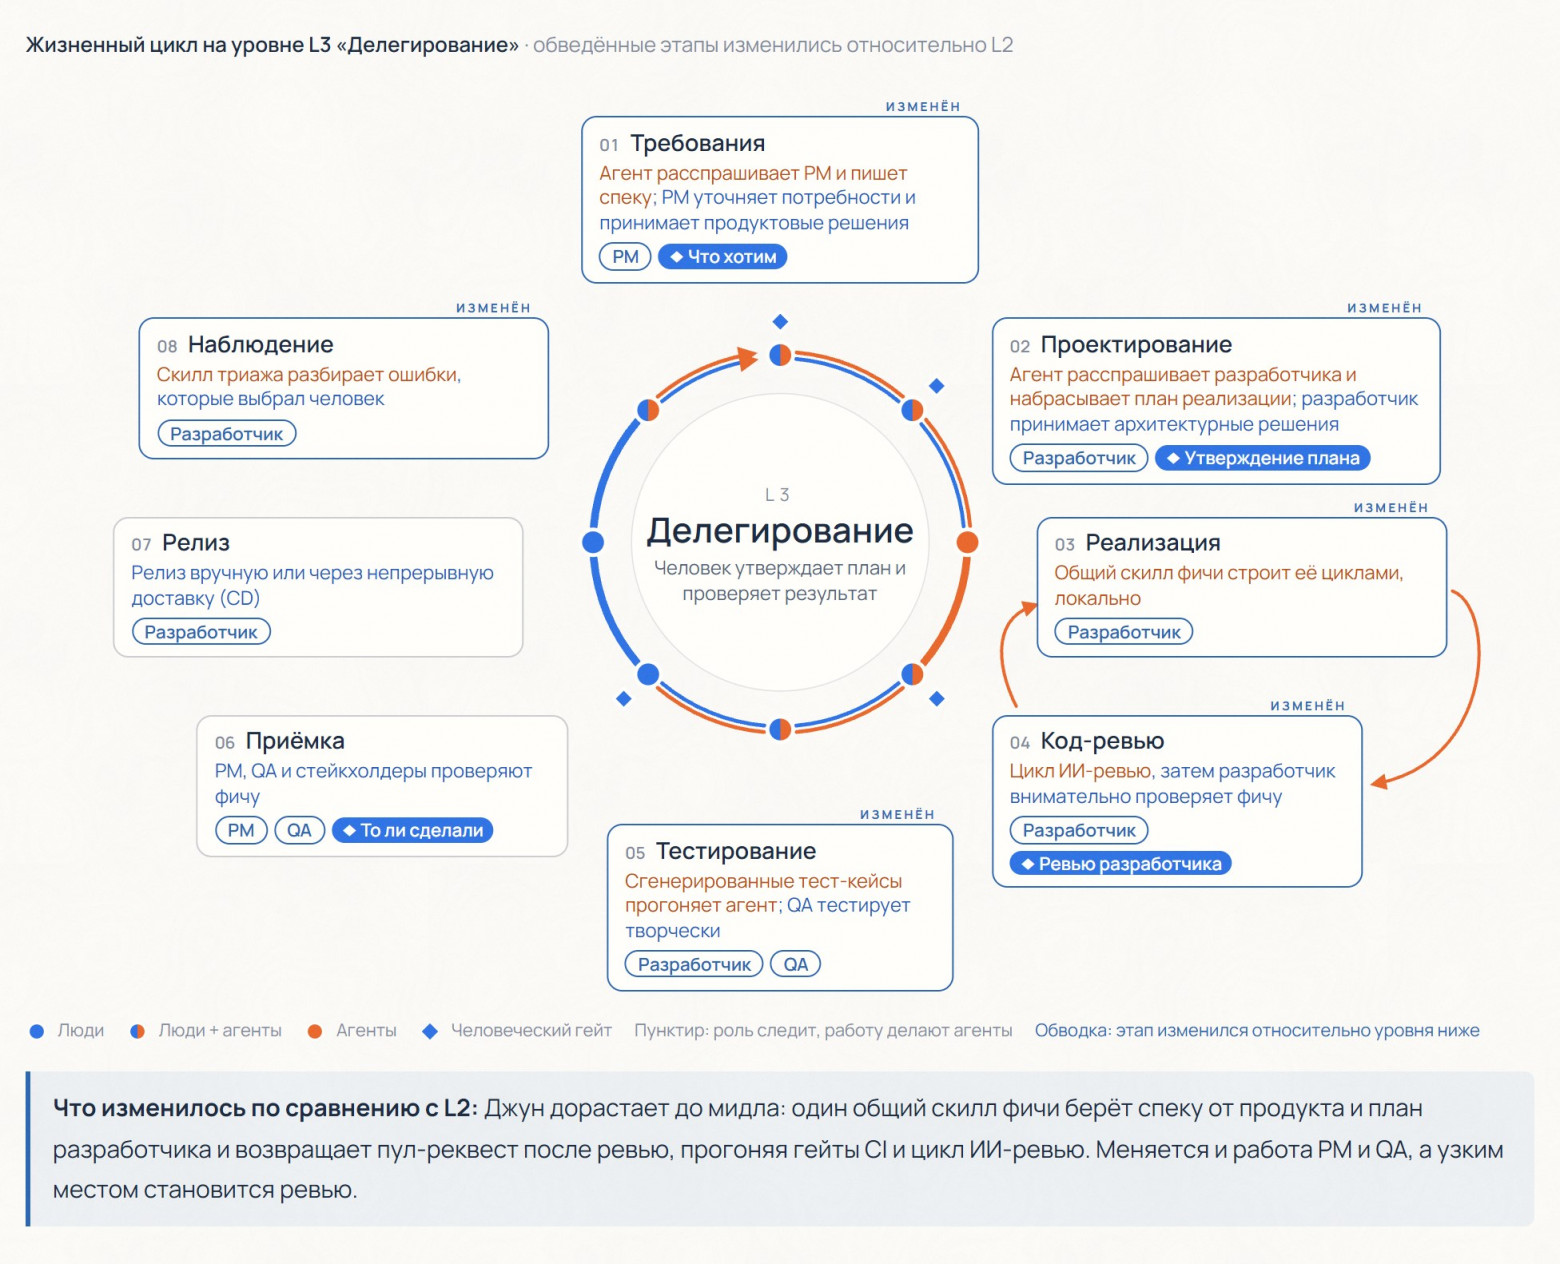
На L3 джун дорастает до мидла: разработчик, как тимлид, отдаёт агенту фичу целиком. Чтобы это работало, агенту, как и человеку, нужна инструкция: вы записываете процедуры и учите его навыкам — скиллам [13].
Мы начали с небольших скиллов: открыть пул-реквест по стандартному шаблону, спланировать реализацию фичи, запустить локальные проверки, сгенерировать тест-кейсы для QA. Потом объединили их в один процесс — скилл /implement-feature. Мы даём ему спеку, за которую отвечает продукт, и план реализации с уже принятыми архитектурными решениями; он возвращает пул-реквест, уже прошедший ревью.
Скилл прогоняет гейты CI из L2 и цикл ревью: второй агент ревьюит PR, а отдельный скилл проверяет каждый комментарий, исправляет код по обоснованным замечаниям и запрашивает новое ревью. Ревью делает модель другого вендора, а не та, что писала код, и это второе мнение заметно улучшает результат. Роль разработчика — принять архитектурные решения, передать задачу агенту и проверить результат.
Скилл — записанная процедура с версиями: инструкции, проверки, инструменты и контекст. Наш скилл для фич живёт в общем плагине, так что обновления доходят до каждого разработчика. По нашим соглашениям шаблон репозитория держит часть контекста в одних и тех же файлах, и скилл находит нужное в любом репозитории. У каждой части процесса есть владелец, который следит, чтобы она не устарела.
Это и есть сдвиг мышления [14] на L3:
Команда поддерживает общий процесс, а не каждый разработчик пилит свои собственные решения и скиллы.
Работа продакт-менеджера тоже меняется. PM больше не нужно идти к разработчику за разъяснениями: его агент понимает кодовую базу и нетехническим языком отвечает, как работает продукт. Агент может провести интервью PM по исходным требованиям и с опорой на код найти детали и развилки решений для спеки. PM теперь может прототипировать фичу прямо в рабочем репозитории, на реальных компонентах дизайн-системы. Даже навайбкоженный прототип, который выглядит правильно, но толком не работает, даёт разработчику полезную отправную точку. Поэтому дизайн-систему важно перенести из Figma в код. Спека тоже переезжает из Notion в репозиторий, рядом с кодом, вместе с планом, тест-кейсами и отчётом о тестировании. PM осваивает основы Git: ветки и версии.
Наша команда QA построила собственную тестовую обвязку. Она генерирует тест-кейсы из спеки и реализации, включая расхождения между ними. Агент прогоняет детерминированные сценарии через браузер или Playwright, снимает скриншоты и видео и пишет отчёты о проблемах. QA сосредотачиваются на творческом тестировании: ставят требования спеки под сомнение, исследуют продукт, ищут неудобные места в UX и сценарии, о которых никто не подумал.
L3 переносит узкое место в ревью. В телеметрии Faros AI за 2025 год [15] по 10 000 разработчиков команды с высоким уровнем внедрения ИИ сливали на 98% больше пул-реквестов, а время ревью PR выросло на 91%. Это корреляция для команд с высоким внедрением ИИ, а не измерение именно L3, но она совпадает с тем, что происходит, когда агенты пишут целые фичи. Теперь объём выпуска упирается во время, которое разработчики тратят на ревью.
На L3 общая система знает продукт, помогает прорабатывать требования и умеет собрать и протестировать фичу. Но каждый процесс по-прежнему запускают люди, а агенты обычно работают на локальных машинах.
L4 Фабрика под контролем: перестаёте делать фичи и строите систему, которая их делает
Практики L4 «Фабрика под контролем»:
🔴 критична — без неё уровень ломается; 🟠 обязательна — уровень её требует; 🟢 усиливает — помогает на этом уровне.
Практики, которые уже были на L3, здесь не повторяю, если их статус не вырос: они в спойлерах уровней ниже.
Организация
-
🔴 Evals: автотесты для агентов — знать, хорошо ли агент всё ещё делает работу.
-
🔴 Платформа для агентов: общая среда запуска вне ноутбуков с доской, роутером и оркестратором — запускать агентов на платформе, которой пользуются люди, без чьего-то ноутбука.
-
🟠 Цикл самоулучшения: когда исправление повторяется, агент предлагает проверку, правку скилла или контекста, а человек её утверждает — чинить систему, а не очередной пул-реквест.
-
🟠 Метрики поставки: lead time, дефекты, переделки, доля принятых изменений — доказать, что фабрика даёт результат, и лучше, чем прежний способ работы.
-
🟠 Фича-флаги и быстрый откат — сделать ошибку дешёвой в откате.
-
🟠 Трейсинг агентов — видеть, что агент сделал и почему.
-
🟠 Политика решений и эскалации с журналом решений — определить, кто что решает сам и где должен спросить, и проверять принятые решения.
-
🟠 Правило двух для агентов: в продакшене по умолчанию только чтение — не давать одной сессии сразу недоверенный ввод, приватные данные и право действовать.
-
🟠 ИИ-шлюз: один путь к моделям, стоимость каждого запуска агента, затем бюджеты и лимиты — знать, сколько стоит каждая фича, и останавливать неконтролируемые траты.
-
🟠 Обвязка агента (harness), независимая от вендора и модели — менять модели и вендоров, не перестраивая процесс, даже если вендор отключит доступ.
-
🟠 Песочницы: временные изолированные среды — ограничить вред, который может нанести агент.
-
🟠 Гейты безопасности: статический анализ, сканирование зависимостей и секретов — блокировать небезопасный код без построчного ревью.
-
🟠 Потолок уровня для каждого вида работы по цене ошибки — держать аутентификацию, биллинг и миграции на уровне, где человек читает каждую строку.
-
🟠 Инженер ИИ-платформы — отвечать за платформу и обвязку агента (harness).
-
🟢 Slack-агент и бот поддержки — отвечать коллегам вне разработки.
PM
-
🟠 Кладёт спеку на общую доску, дальше её берёт агент; на L5 в спеки есть цели и критерии качества
Разработчик
-
🟠 Следит за фабрикой: агент берёт тикет и строит фичу в облачной песочнице, разработчик отвечает на развилках
-
🟠 Ревьюит архитектуру изменений, а не каждую строку
-
🟠 Превращает находки ревью в гейты, гайдлайны или контекст; утверждает правки, которые агент предлагает для повторяющихся исправлений
-
🟠 Пайплайн релизит после гейтов
-
🟠 Поддерживает фабрику: обвязку агента (harness), скиллы, гейты; улучшает её, когда она ломается по-новому
-
🟢 Агент следит за ошибками и запросами, эскалирует или открывает фикс
QA
-
🟠 Сгенерированный набор тестов запускается сам; QA проверяет отчёт и доделывает случаи, где нужен человек
-
🟠 Строит систему, которая тестирует, а не каждый тест
Ваш агент-мидл выдаёт приличный результат, но узким местом становитесь вы: вы проектируете фичи, запускаете процессы и проверяете каждое изменение. Harness всё ещё работает на вашем ноутбуке: это обвязка вокруг модели, которая дает ей контекст, инструменты и инструкции.
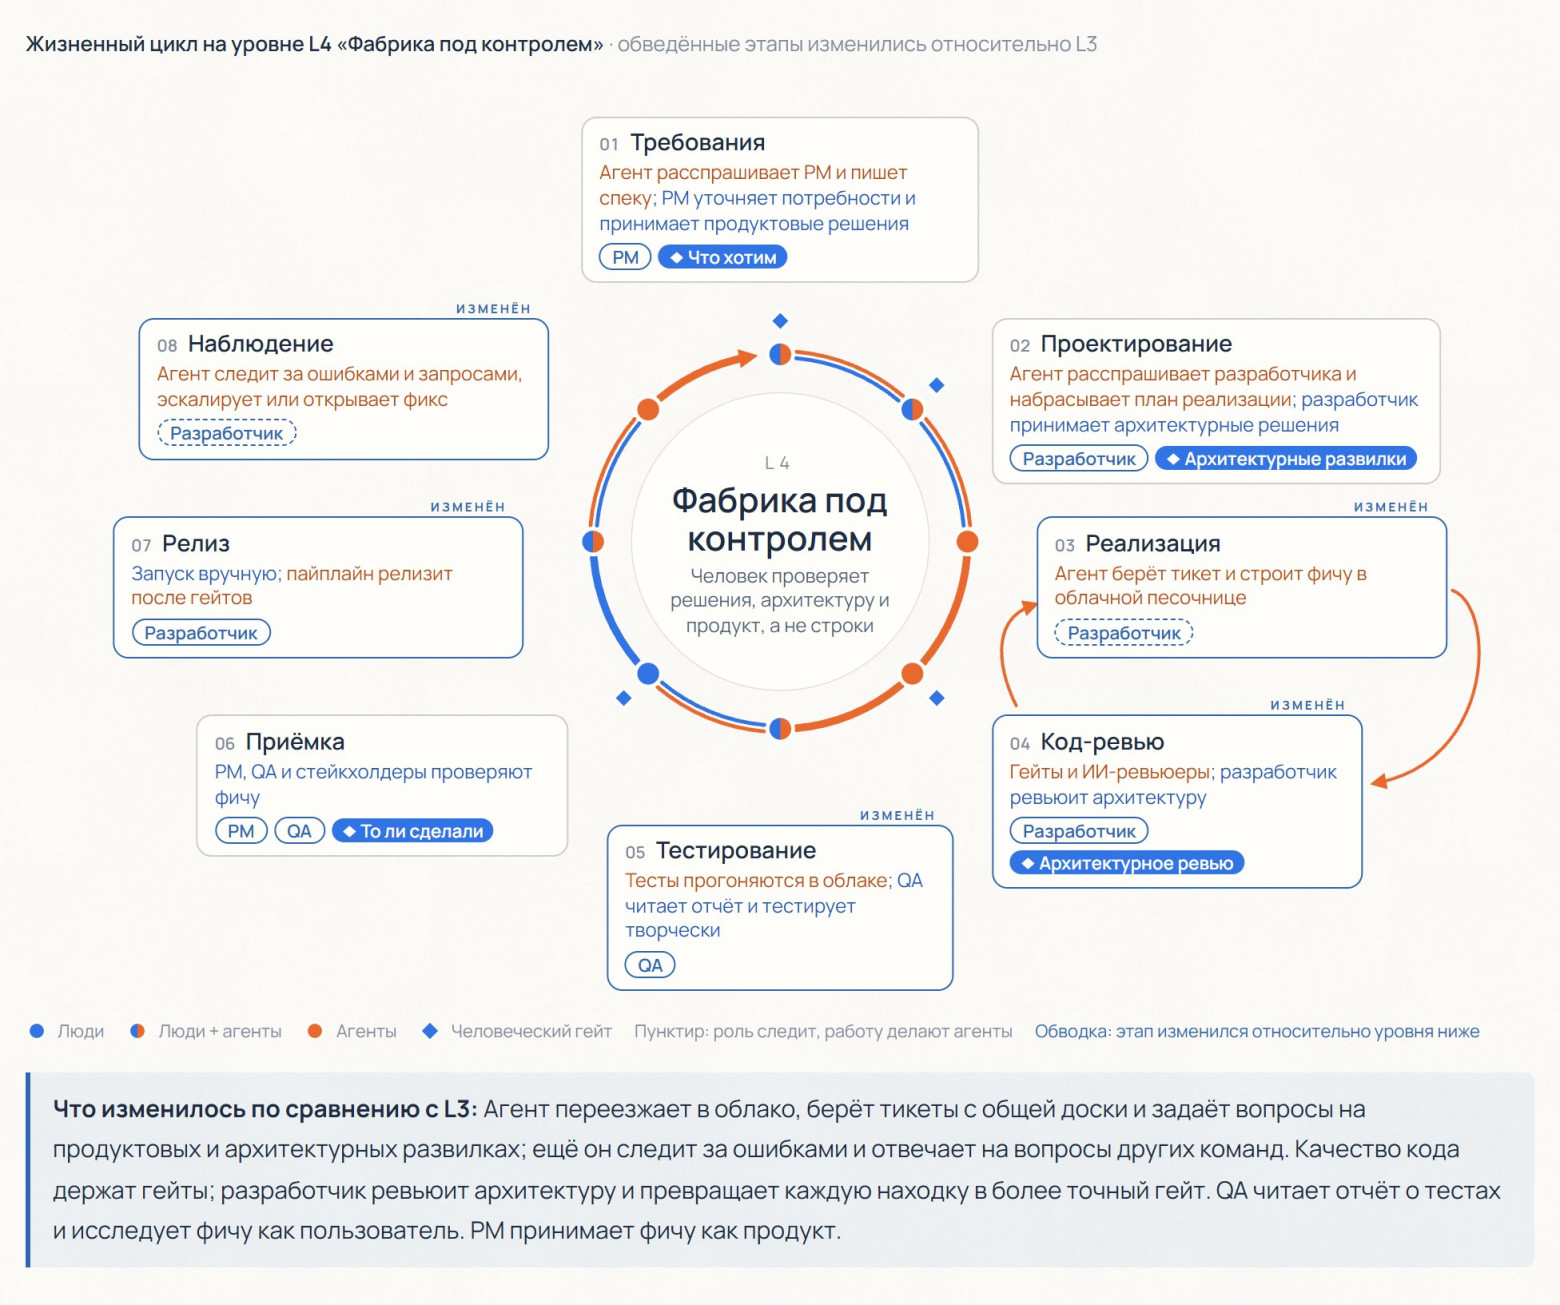
На L4 агент переезжает в облако и берёт задачи с общей доски трекера. Продакт-менеджер пишет спеку; агент предлагает план и задаёт архитектурные вопросы на развилках. Когда разработчик и агент договорились о подходе, агент работает самостоятельно. Дальнейшие решения он может эскалировать человеку или принимать сам по согласованной политике и записывать их для ревью. Агент возвращает пул-реквест, готовый к ревью человеком и творческому тестированию на staging-окружении.
За доской трекера задач стоит роутер: он решает, какому агенту отдать каждый входящий сигнал. Оркестратор управляет очередью и свободными машинами, запускает для каждой фичи агента в песочнице и сообщает, когда работа готова.
На L4 агенту не обязательно ждать задачи из трекера. Он проактивно следит за ошибками и логами, разбирается с проблемами по мере появления и либо эскалирует их, либо предлагает исправление.
Наш скилл для Sentry уже умеет вести такие расследования. Он изучает ошибки и логи прода, читает код и запускает read-only скрипты на проде, чтобы проверить гипотезы. Он может воспроизвести дефект падающим тестом и подготовить план исправления; для подходящих проблем оператор может разрешить ему дойти до пул-реквеста. Сегодня процесс всё ещё запускает человек. На L4 расследование запускалось бы само, по входящей ошибке.
Через Slack или другой мессенджер агент доступен и людям без навыков программирования. Поддержка может спросить, как работает фича; продакт-менеджеры могут задавать вопросы, не читая код. Агент смотрит в код и базу знаний, отвечает по тому, что знает, и может превращать запросы в черновики спек для PM.
Теперь вы выпускаете больше фич, но спеки, пул-реквесты и архитектурные решения начинают копиться. Работа выматывает: сплошное проектирование и ревью, переключение задач, а отдых в виде сфокусированного написания кода у нас отняли агенты. Вы снова становитесь узким местом в процессе. Постепенно вы доверяете системе все больше, ослабляете контроль на ревью, перестаете проверять каждую строку и поднимаетесь на уровень абстракции выше.
На L3 разработчик делает ревью реализации и исправляет найденное в пул-реквесте. На L4 каждое изменение проверяют автоматические гейты. Разработчики делают ревью на соблюдение архитектурных принципов и правил компании, а по находкам улучшают гейты. Им не обязательно ревьюить каждое изменение, но без архитектурного ревью они не узнают, работают ли гейты, и перестанут знать код достаточно хорошо, чтобы поддерживать фабрику.
На L4 фабрика учится на своих ошибках и собирает все исправления: упавшие тесты, замечания на ревью, ошибки в проде, слова человека «у нас так не делают». Когда исправление повторяется, агент предлагает изменить систему [16], а не чинить ещё один пул-реквест. Джуну больше не нужно напоминать одно и то же дважды. Самое сильное исправление делает ошибку невозможной на уровне архитектуры; дальше идут типы, правила линтера и проверки CI, потом тест, и только в последнюю очередь — строчка в AGENTS.md или в скилле: это самое слабое средство, потому что агент может его пропустить. Каждое предложение одобряет человек, прежде чем оно попадёт в систему, чтобы контекст не раздувался, а цикл не ошибался без присмотра.
Сначала постройте процесс, которому доверяете, и только потом отдавайте агенту крупные куски работы под меньшим контролем. У этого процесса должен быть владелец: AI Platform Engineer поддерживает платформу и обвязку агента.
Это еще один сдвиг в мышлении: вы перестаёте делать работу сами и начинаете строить систему, которая её делает, и следить за ней.
Перестаньте делать работу сами. Стройте систему, которая её делает.
Без построчного ревью безопасность должна быть частью гейтов. Отчёт Veracode за 2026 год [17] показал, что код, сгенерированный ИИ, проходит проверки безопасности в 56% случаев на эталонных задачах, если в промпте нет требований к безопасности. По «правилу двух для агентов [18]» от Meta агент, который в одной сессии сочетает недоверенный ввод, доступ к закрытым данным и возможность менять состояние или общаться вовне, не должен работать автономно — у него может быть не больше двух из трёх.
В QA тест-кейсы берутся из спеки, набор тестов запускается автоматически, а QA читает отчёт. Творческая часть остаётся: человек по-прежнему исследует фичу, пытается её сломать и замечает неудобные взаимодействия.
Остерегайтесь ложного L4: одних облачных агентов мало. Если архитектурное ревью продолжает находить дефекты на уровне строк, гейты не готовы и роль всё ещё на L3. Прежде чем люди перестанут читать каждую строку, кто-то должен убедиться, что гейты работают. Понять, улучшается ли процесс в целом, помогают метрики вроде доли принятых изменений и объёма переделок.
L5 Тёмная фабрика: почему стоит остановиться на фабрике под контролем
Практики уровня L5 «Тёмная фабрика»
🔴 критична — без неё уровень ломается; 🟠 обязательна — уровень её требует; 🟢 усиливает — помогает на этом уровне.
Практики, которые уже были на L4, здесь не повторяю, если их статус не вырос: они в спойлерах уровней ниже.
Организация
-
🔴 Спеки настолько точные, что диффы можно не читать — выпускать, не читая код.
PM
-
🟢 Проверяет результат
Разработчик
-
🟠 Задаёт границы и пороги качества
QA
Нового по сравнению с L4 нет.
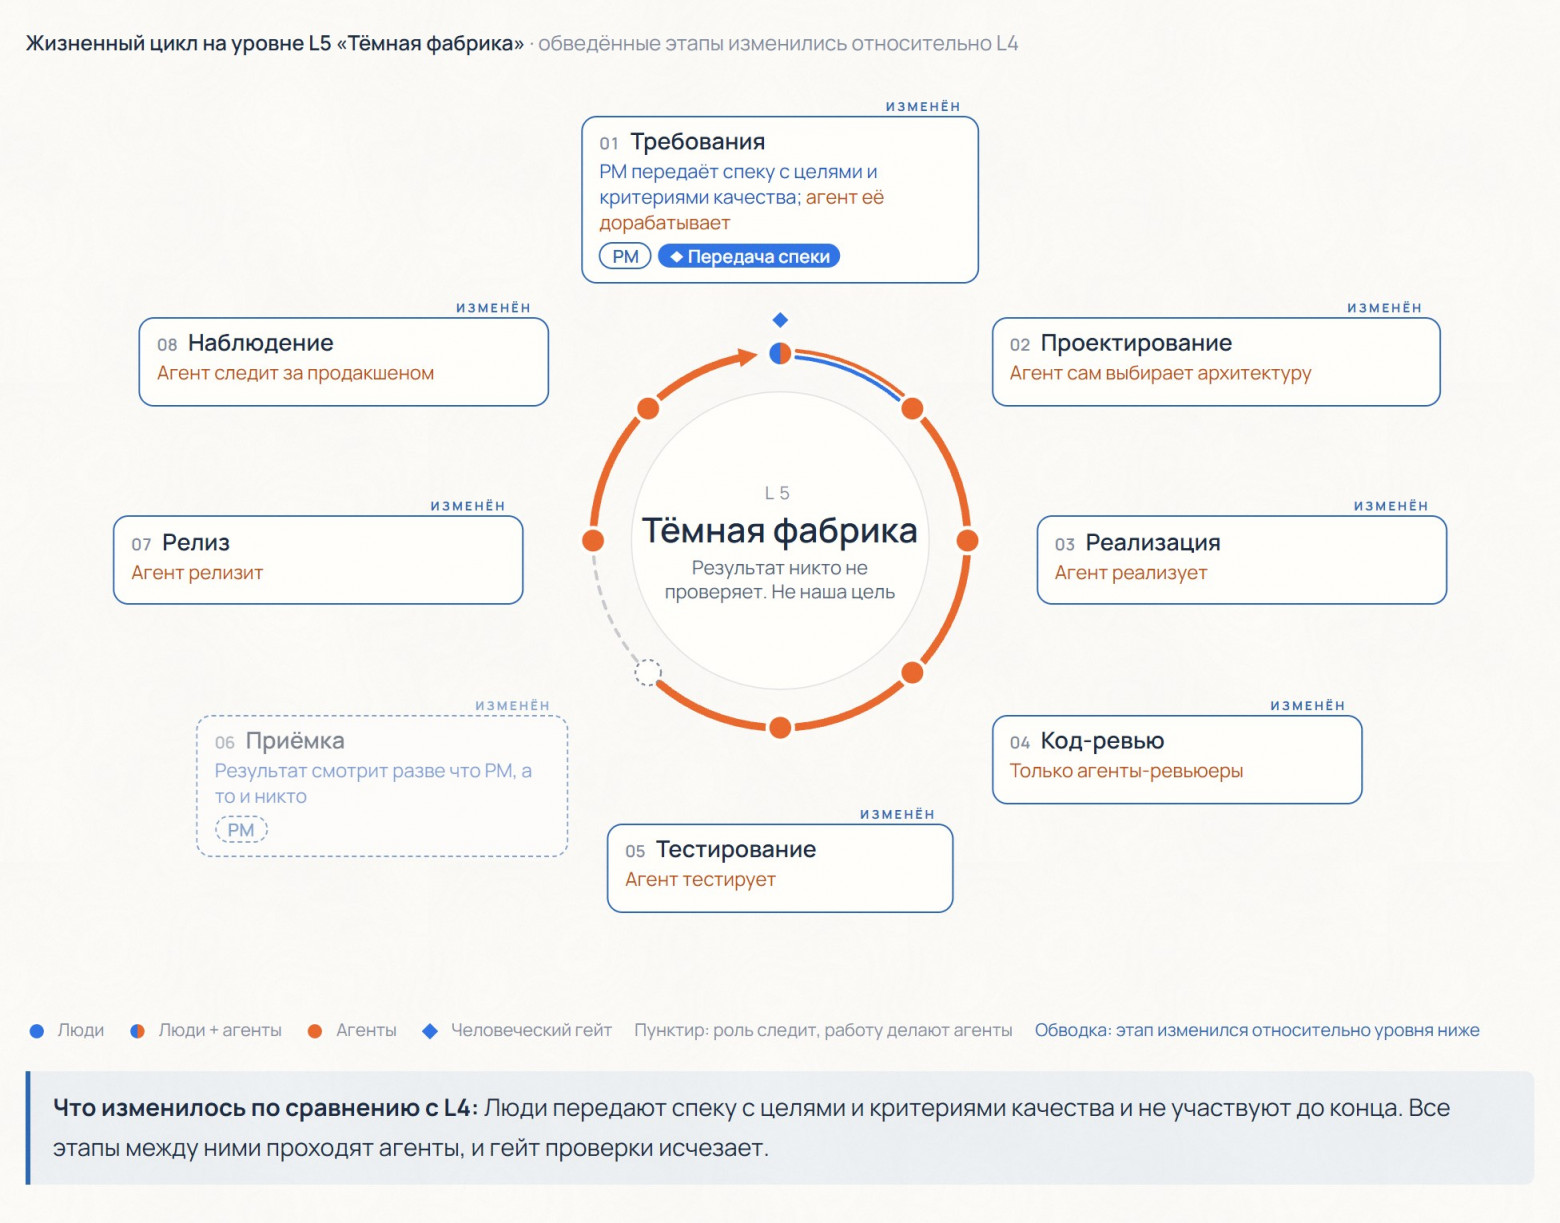
На L5 никто не сверяет результат с тем, что хотел получить, и поэтому мы останавливаемся на L4. Дэн Шапиро называет тёмную фабрику «чёрным ящиком, который превращает спеки в софт [5]» (пер. автора). Её сторонники не отказываются от проверки: она переезжает из диффов в точные спеки, сценарные тесты и пороги качества, которые люди задают заранее. Dash0 [19] добавляет, что для этого нужны спеки настолько точные, что в диффы уже никто не смотрит, и что черновые спеки на полной скорости дают черновой результат.
Мы не стремимся на L5, потому что он убирает второй гейт — проверку, что вы получили то, что просили, а ради этого софт и делают. Это как разрешить мидлу отгружать работу клиентам, когда никто не сверяет результат с запросом. Автоматические проверки могут подтвердить, что результат отвечает критериям, написанным до того, как он появился. Но они не скажут, описывали ли эти критерии то, что вы хотели, и не заметят, что фича неудобна тому, кто будет ею пользоваться. Для этого нужен человек, который просил, и QA-инженер, который пробует фичу глазами пользователя. Более сильные модели этого не изменят. Это вопрос смысла, и каждый отвечает на него сам. Мы делаем софт для людей. Если никто не проверяет, получили ли мы то, что просили, работа теряет смысл и превращается в ИИ-мусор. Поэтому и смысл, и его проверку мы оставляем людям. Там, где результат предназначен не людям, ответ может быть другим.
Потолок для каждого вида работ задаёт цена ошибки
Насколько близко к L4 подпускать каждый вид работ, компания решает сама — по цене ошибки. Фреймворк Сбера AI-Disrupt PDLC [20] ведёт отдельную шкалу прав агентов с учётом риска, где самые критичные пути остаются на уровне предложений, которые принимает человек.
|
Цена ошибки |
Примеры |
Высший уровень |
Глубина архитектурного ревью |
|---|---|---|---|
|
Низкая, легко откатить |
внутренняя админка, интерфейс за фича-флагом, одноразовый прототип |
L4 |
на части изменений можно не делать |
|
Высокая, но обратимая |
продуктовые фичи для клиентов |
L4 |
человек остаётся в контуре решений |
|
Необратимая или высокий риск |
аутентификация, биллинг, данные клиентов, миграции схемы |
L3: человек ревьюит каждую строку |
– |
Потолок — это самый высокий уровень, на котором ваши гейты надёжно ловят ошибки, которые нельзя откатить. Аутентификация и биллинг остаются на L3 не потому, что человек читает код лучше гейта, а потому, что пропущенный там дефект не откатить, а гейты пока не исключают такой класс ошибок; когда научатся, потолок можно поднять. Dash0 говорит то же самое: сервис переходит на уровень выше только по доказательствам, по одному сервису за раз, а зоны высокого риска могут не пройти никогда.
Два гейта для человека: какова роль людей в новом процессе?
Нужен ли в этом процессе человек? Останетесь ли вы без работы?
Я считаю, что люди останутся незаменимыми, но планка растёт: агент берёт на себя всё больше работы разработчика, поэтому вам придётся стать лидом, который ответственен за результат “вкруг”, разговаривает с бизнесом, принимает решения на каждом этапе, управляет командой агентов и верифицирует результат . Какие-то профессии исчезнут, большинство изменится, но это тема для отдельной статьи. Здесь я останавливаюсь только на том, что не меняется от уровня к уровню.
Два гейта остаются за людьми на каждом уровне ниже L5: решить, чего же мы хотим достичь, и проверить, получили ли мы это. Агент может найти пробелы в запросе и помочь превратить его в спеку, но проблему, результат и компромиссы выбирают люди. Результат проверяет тот, кто просил; на L4 эта проверка поднимается с каждой строки на архитектуру и продукт, а QA исследует продукт так, как это делал бы пользователь.
За людьми остаются два гейта: решить, чего мы хотим, и проверить, получили ли мы это.
Между гейтами вы делегируете работу агенту так же, как разработчику: ставите задачу, договариваетесь о контрольных точках и гейтах, о правилах, когда нужно остановиться и позвать человека принять важное решение на развилке.
Что проверяет человек на каждом уровне:
|
Уровень |
Что проверяет человек |
|---|---|
|
L0, Ручной |
Всё |
|
L1, С ассистентом |
Всё + ответы чата |
|
L2, С агентом |
Каждое изменение агента |
|
L3, Делегирование |
Все еще каждое изменение агента, но фокус смещается на общее направление решения и план, ключевые архитектурные решения, соблюдение конвенций |
|
L4, Фабрика под контролем |
Продукт, только общее направление решения, ключевые архитектурные решения. |
|
L5, Тёмная фабрика |
Входящую спеку |
В заключение
Эта статья — попытка осмыслить наш путь внедрения ИИ и набросать карту [1]. Сейчас мы где-то на L3 и экспериментируем с L4. Команда почти никогда не находится целиком на одном уровне, и темп задаёт самая медленная роль: настроили процесс в разработке — узкое место переезжает в QA. Поэтому оценивайте зрелость по самому слабому измерению, а не по самому сильному.
На L4 ролей может остаться не три (PM, Dev, QA). В ИИ бизнес видит волшебную пилюлю, которая должна все делать одним промптом, а экономика заставляет сокращать издержки. Если вы больше не пишете код, то какова ваша роль в компании? Я вижу две роли, в которые всё сливается в 2026 году. AI Builder отвечает за продукт и контролирует фичи, проходящие через фабрику, а AI Platform Engineer поддерживает платформу и обвязку агента. Компании побогаче сохранят узких специалистов, а бизнес помельче будет выжимать из сотрудников все соки: больше ролей в одном человеке за те же деньги.
Участвовать в этих изменениях очень интересно, хотя иногда и страшно: вместе с технологическим рывком радикально меняются или исчезают целые профессии и отрасли. Об этом поговорим в следующей статье. Но в будущее я смотрю с оптимизмом: не можешь победить — возглавь, будь early adopter.
Автор: bravik
Источник [21]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38548
URLs in this post:
[1] интерактивная схема: https://naumenko.me/ru/articles/ai-sdlc-six-levels-of-adoption?utm_source=habr&utm_medium=social&utm_campaign=ai-sdlc-six-levels-of-adoption&utm_content=scheme
[2] trunk-based development: https://habr.com/ru/companies/avito/articles/680522/
[3] потребности: http://www.braintools.ru/article/9534
[4] ошибки: http://www.braintools.ru/article/4192
[5] Дэн Шапиро: https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
[6] повторять: http://www.braintools.ru/article/4012
[7] память: http://www.braintools.ru/article/4140
[8] долговременную память: http://www.braintools.ru/article/9500
[9] стал стандартом: https://agents.md/
[10] Linux Foundation: https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
[11] вкус: http://www.braintools.ru/article/6291
[12] опыт: http://www.braintools.ru/article/6952
[13] скиллам: https://agentskills.io/
[14] мышления: http://www.braintools.ru/thinking
[15] телеметрии Faros AI за 2025 год: https://www.faros.ai/blog/ai-software-engineering
[16] агент предлагает изменить систему: https://www.youtube.com/watch?v=SM0F74IzAUA
[17] Отчёт Veracode за 2026 год: https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
[18] правилу двух для агентов: https://simonwillison.net/2025/Nov/2/new-prompt-injection-papers/
[19] Dash0: https://www.dash0.com/knowledge/the-six-levels-of-agentic-software-engineering
[20] AI-Disrupt PDLC: https://aipdlc.ru/documents/ru/whitepaper_full_ru.pdf
[21] Источник: https://habr.com/ru/articles/1106718/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1106718
Нажмите здесь для печати.