Какие слои что знают: сравниваем RWKV-7 и трансформеры послойными пробами
Где языковая модель хранит порядок слов, грамматику и смысл — и зависит ли это от архитектуры? Я обучил 12 небольших моделей, которые отличаются только архитектурой, и проверил линейными пробами каждый слой каждого чекпоинта. Короткий вывод: на этом масштабе заметнее всего различается то, как хранится позиция токена, а для синтаксиса и смысла модели при равном loss выглядят похоже.
-
Сравнивал RWKV-7, трансформер с RoPE и трансформер без позиционного кодирования (NoPE). Размеров два (56.6M и 115M параметров), языков два (русский, английский), на модель 1–2 млрд токенов, по 21 чекпоинту на прогон, у 9 из 12 прогонов есть второй сид инициализации.
-
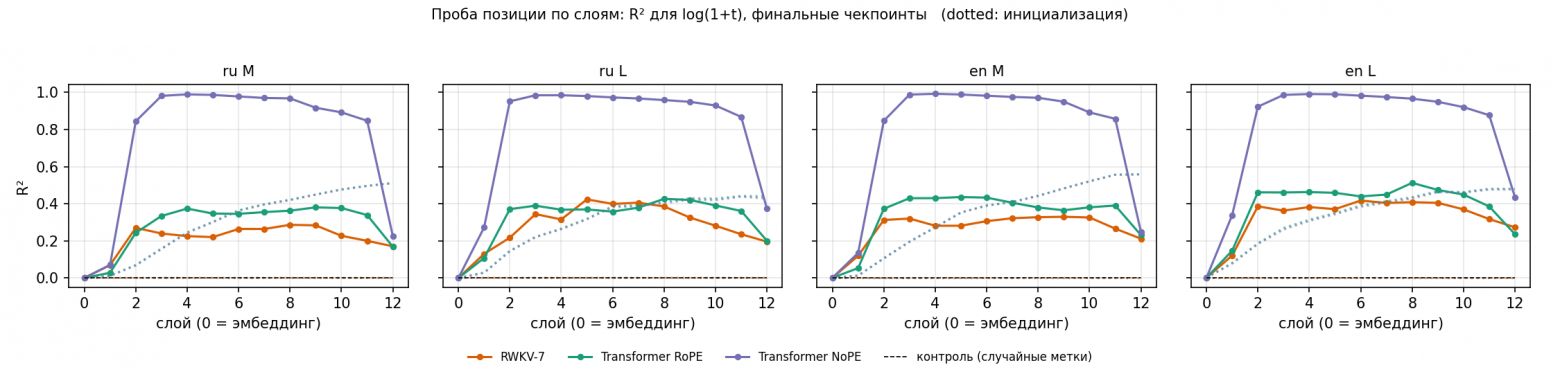
Позицию токена линейная проба считывает из NoPE почти идеально, из RoPE заметно хуже, из RWKV ещё хуже (R² от log(1+t) на лучшем слое: 0.99 / 0.38–0.51 / 0.29–0.42). Это воспроизводится на обоих языках, обоих размерах и обоих сидах.
-
Глубина слова в дереве зависимостей даёт тот же порядок, но с гораздо меньшим разрывом (0.02–0.06).
-
Всё остальное — не больше 0.02–0.03 или в пределах разброса между сидами.
-
У RWKV пик «синтаксических» проб приходится на слои на 1–4 ниже, чем у трансформеров, но это наводка, а не результат (подробности ниже).
-
Модели маленькие, корпуса скромные. «Различий нет» здесь значит «не видно на этом масштабе», а подтвердившиеся различия — не закон архитектур.
Код, результаты и чекпоинты открыты: репозиторий [1], чекпоинты сида 0 [2].
Зачем это нужно
Языковой модели нужно знать, где в тексте стоит токен, какую роль он играет в предложении и что он значит. Три способа получить порядок слов:
-
RoPE — трансформер получает позицию, поворачивая запросы и ключи в внимании.
-
NoPE — у трансформера нет позиционного кодирования вообще, единственный источник порядка — причинная маска. Haviv и др. показали, что такие модели всё равно выучивают позиционную информацию (arXiv:2203.16634 [3]).
-
RWKV-7 — рекуррентное состояние без внимания [4]; порядок встроен в то, как это состояние обновляется.
Я обучил согласованные модели каждого вида и спросил: в каком слое то или иное свойство читается линейно, и чем это отличается между архитектурами?
Модели обучались и проверялись на сервере, предоставленном Bo Peng, автором RWKV. Это третья статья серии: раньше были про квантизацию RWKV-7 [5] и про state tuning против системного промпта [6].
Сначала прочитайте это. Модели маленькие (56.6M и 115M параметров), обучены на 1–2 млрд токенов скромного корпуса, сида два, и они меняют только инициализацию (порядок данных одинаковый). Разброс по двум сидам — ориентир, а не доверительный интервал.
Что именно я сделал
Модели
|
|
56.6M («M») |
115M («L») |
|---|---|---|
|
ширина × слои |
512 × 12 |
768 × 12 |
|
токенов / шагов |
~1.0 млрд / 3 800 |
~2.0 млрд / 7 600 |
|
learning rate |
1e-3 |
6e-4 |
Остальное одинаково: контекст 1024, 256 последовательностей на шаг, AdamW, warm-up 100 шагов, косинусный спад до lr/10, обрезка градиента 1.0, bf16, BPE-токенизатор на 16k на язык. Порядок данных одинаков во всех прогонах, сид меняет только инициализацию. Корпус — около 2.1 млрд токенов на язык, 76 % из них Википедия; остальное литература, наука [7], новости и разговорные тексты (подробно [8]).
Финальный val-loss (сид 0 | сид 1):
|
|
RWKV-7 |
Трансформер RoPE |
Трансформер NoPE |
|---|---|---|---|
|
ru M |
2.554 | 2.554 |
2.683 | 2.667 |
2.786 | 2.802 |
|
ru L |
2.318 | 2.320 |
2.422 | 2.423 |
2.505 | 2.506 |
|
en M |
2.764 | 2.765 |
2.893 | 2.892 |
2.993 | 3.011 |
|
en L |
2.534 | — |
2.640 | — |
2.725 | — |
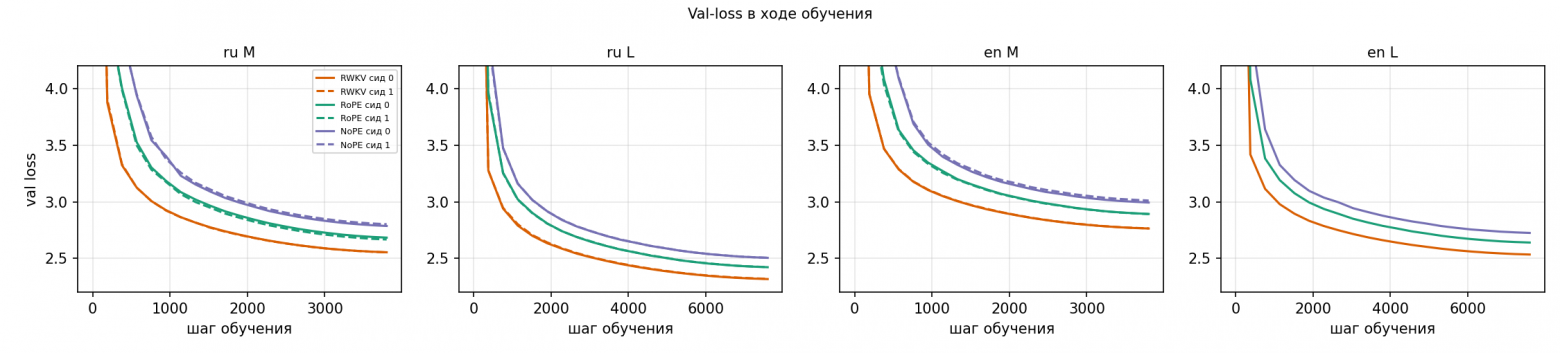
Здесь сразу видна проблема сравнения: RWKV-7 заканчивает на 0.10–0.13 ниже RoPE, то есть финальные чекпоинты просто не сопоставимы. Модель с меньшим loss может выглядеть «умнее» по любой пробе уже по этой причине. Поэтому я сравниваю архитектуры при равном val-loss.
Пробы
Проба — это простая модель (линейная ridge-регрессия или классификатор) на замороженном скрытом состоянии токена, обученная отдельно для каждого из 13 слоёв (эмбеддинги и 12 блоков). Она измеряет то, что читается линейно, а не то, что модель использует. Я проверял:
-
позицию токена (R² для log(1+t));
-
синтаксис русского (SynTagRus): роль в предложении, глубину в дереве зависимостей, селективность UPOS;
-
морфологию: падеж, род, время, вид;
-
смысл: омонимы, парафразы против сложных пар (наборы я написал сам);
-
тональность (русский и английский).
Для задач со словами использовалось состояние последнего субтокена слова. Контрольные задачи со случайными метками дают селективность (реальная точность минус контроль, по Hewitt и Liang [10]), а случайно инициализированная сеть (шаг 0) — нижний ориентир.
Как сравниваю при равном loss
Для каждой пары архитектур я интерполирую каждую пробу по val-loss на 21 чекпоинте и сравниваю на 4 уровнях loss: худший финальный loss из трёх архитектур, затем +0.1, +0.3, +0.6. Δ — первая архитектура минус вторая.
Различие я называю устойчивым, если выполнены три условия: оба сида, один знак на всех 4 уровнях и |Δ| больше разброса между сидами (средний |сид 0 − сид 1| у одной архитектуры). Два сида — не доверительный интервал, поэтому слово «значимо» я не использую.
Результаты
1. Позиция: NoPE ≫ RoPE > RWKV
Проба предсказывает log(1+t), где t — номер токена в окне. На финальном чекпоинте R² лучшего слоя равен 0.99 у NoPE во всех четырёх конфигурациях, 0.38–0.51 у RoPE и 0.29–0.42 у RWKV. NoPE к 3-му слою достигает R² ≈ 0.98 (0.84–0.95 уже на 2-м слое), до 11-го слоя держится не ниже 0.85 и падает до 0.22–0.44 на последнем.
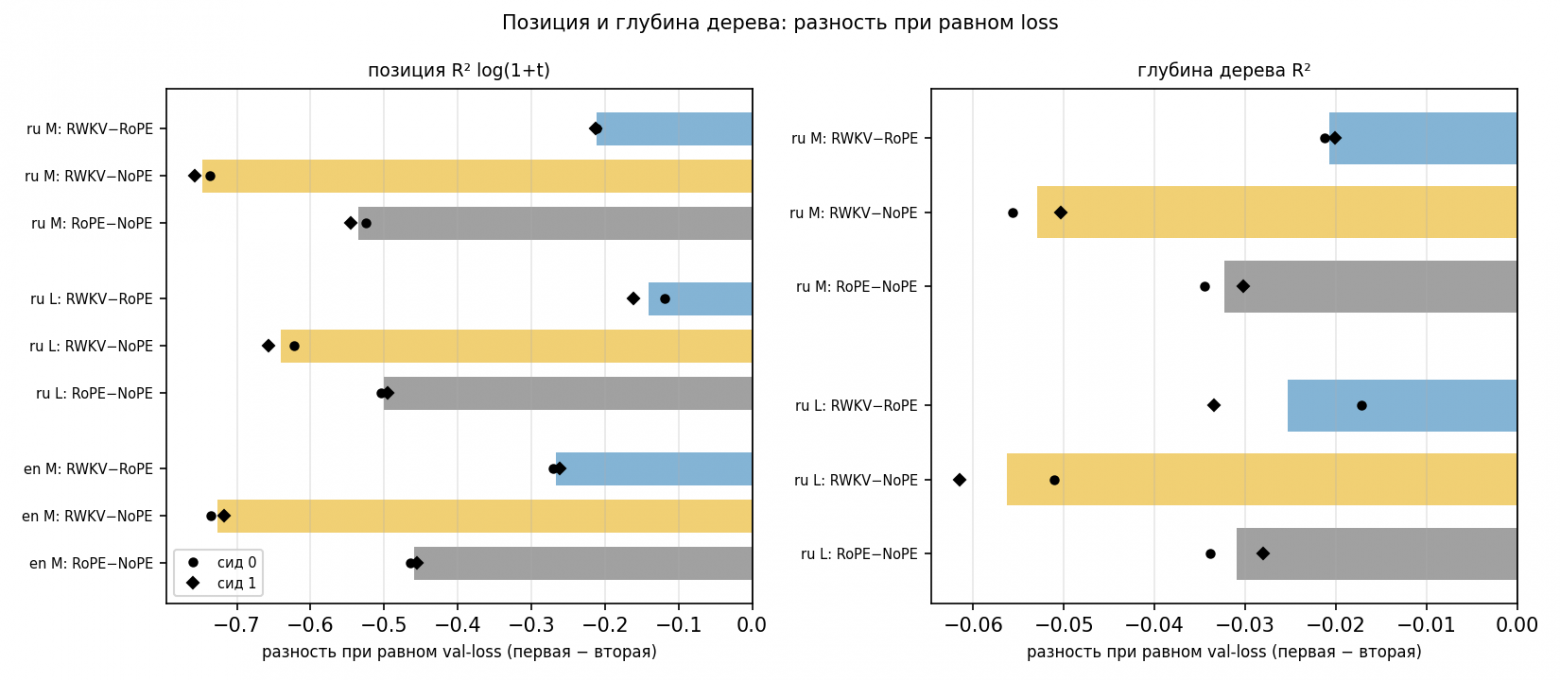
При равном val-loss разность RWKV − NoPE по R² равна −0.64…−0.75, RoPE − NoPE: −0.46…−0.54, RWKV − RoPE: −0.14…−0.27. Это верно для моделей 56.6M и 115M, для русского и английского, в обоих сидах (у английской 115M один сид).
Две вещи, которые нужны для правильного чтения:
-
Случайно инициализированный трансформер уже имеет R² от 0.44 до 0.56, потому что одна причинная маска даёт позиционный сигнал. Поэтому правильный ориентир для трансформера — шаг 0, а не ноль.
-
RoPE в ходе обучения эту информацию теряет (русский 56.6M: 0.51 → 0.38; английский: 0.56 → 0.44). Это согласуется с идеей, что позиция вводится прямо в внимание и ей больше не нужно храниться в остаточном потоке, но это объяснение я не проверял.
Позиция — не главный признак того, как устроена архитектура, а лишь тот, что различается сильнее всего. Подробнее: позиция [11], позиция против loss [12].
2. Глубина в дереве: тот же порядок, меньший разрыв
Для глубины слова в дереве зависимостей (русский, SynTagRus) порядок NoPE > RoPE > RWKV сохраняется на обоих размерах: RWKV − RoPE −0.021 и −0.025, RWKV − NoPE −0.053 и −0.056, RoPE − NoPE −0.032 и −0.031. Разброс между сидами 0.003–0.013.
Поскольку глубина слова коррелирует с его номером в предложении, я считаю это тем же эффектом, увиденным с другой стороны, а не отдельной находкой.
3. Малые различия
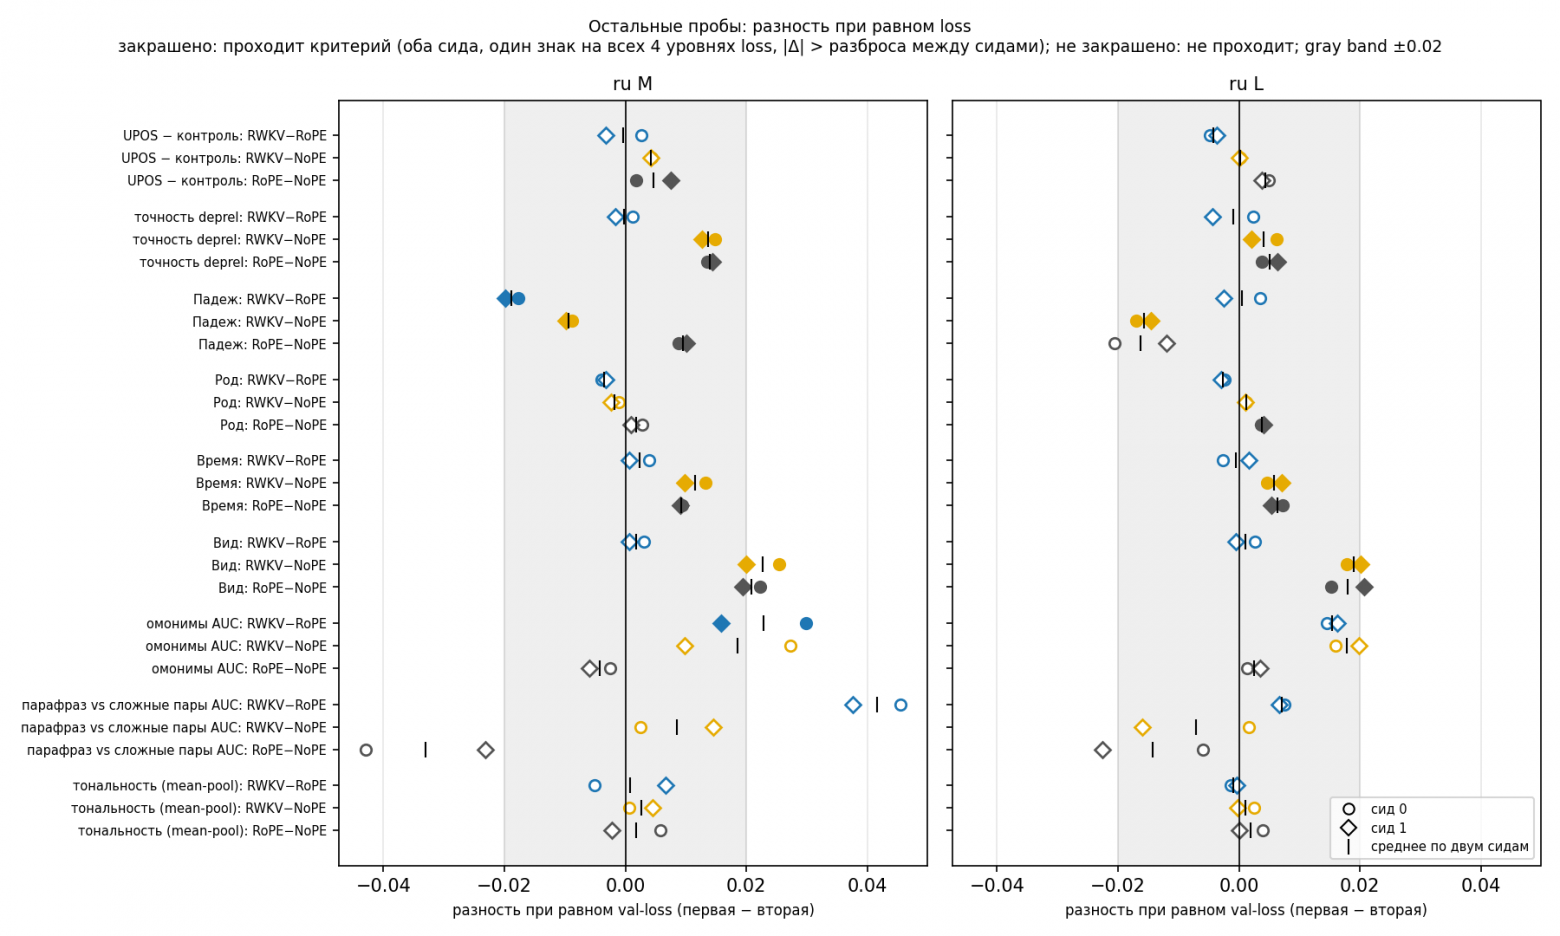
При равном loss все остальные пробы различаются на 0.003–0.03. На рисунке каждое сравнение (два сида и их среднее); закрашенные маркеры проходят критерий устойчивости.
Что выполняется в русском в обоих сидах:
-
Роль в предложении, время, вид: NoPE ниже RWKV и RoPE на 0.004–0.023, наибольший разрыв у вида (0.019–0.023). Между RWKV и RoPE различий нет.
-
Падеж: RWKV − RoPE −0.019 (только 56.6M; на 115M +0.001), RWKV − NoPE −0.009 и −0.016. Так что «RWKV и RoPE лучше NoPE» верно для роли в предложении, времени и вида, но не для падежа и не для глубины дерева.
-
Омонимы, RWKV − RoPE: +0.023 на 56.6M, +0.015 на 115M — это ниже разброса между сидами (0.015–0.019).
В английском (один размер, 56.6M) RWKV выше NoPE на омонимах (+0.020), парафразах против сложных пар (+0.033) и тональности (+0.017). В русских моделях это не повторяется, английский набор на смысл маленький (16 слов), а разрыв 0.017 на 1 066 примерах тональности — около одной биномиальной стандартной ошибки [13] (≈ 0.013). Поэтому я считаю эти различия слабыми.
Различий между архитектурами не видно у селективности UPOS (не больше 0.005, один размер), рода, тональности в русском и теста на парафразы. Тональность в основном лексическая: слой 0 уже даёт 0.83–0.85 (русский) и 0.70–0.72 (английский). Усреднённые по токенам парафразы отделяются от случайных пар уже на слое 0 (AUC 0.95–0.99), так что этот контроль мало говорит о слоях.
И отдельно о «преимуществах RWKV» на финальных чекпоинтах (омонимы в русском 0.876 против 0.819, тональность в английском 0.758 против 0.720): они в основном объясняются меньшим loss у RWKV и при равном loss уменьшаются или исчезают. Это хороший пример того, зачем нужно сравнение при равном loss.
Подробнее: все сравнения [14], морфология [15], смысл и тональность [16].
4. Какой слой: у RWKV пик раньше
Пробы синтаксиса и морфологии у RWKV достигают пика раньше. Для роли в предложении лучший слой у RWKV 7–8, у RoPE и NoPE 9–10; для глубины в дереве 7–8 против 9–10 у RoPE и 8–9 у NoPE; для падежа, рода и времени 4–9 против 7–11. Для вида RWKV и RoPE совпадают (5–6 против 6–7), NoPE позже (8–10). Омонимы везде пикуют поздно (слои 9–12). Для этих проб два сида согласуются в пределах 2 слоёв.
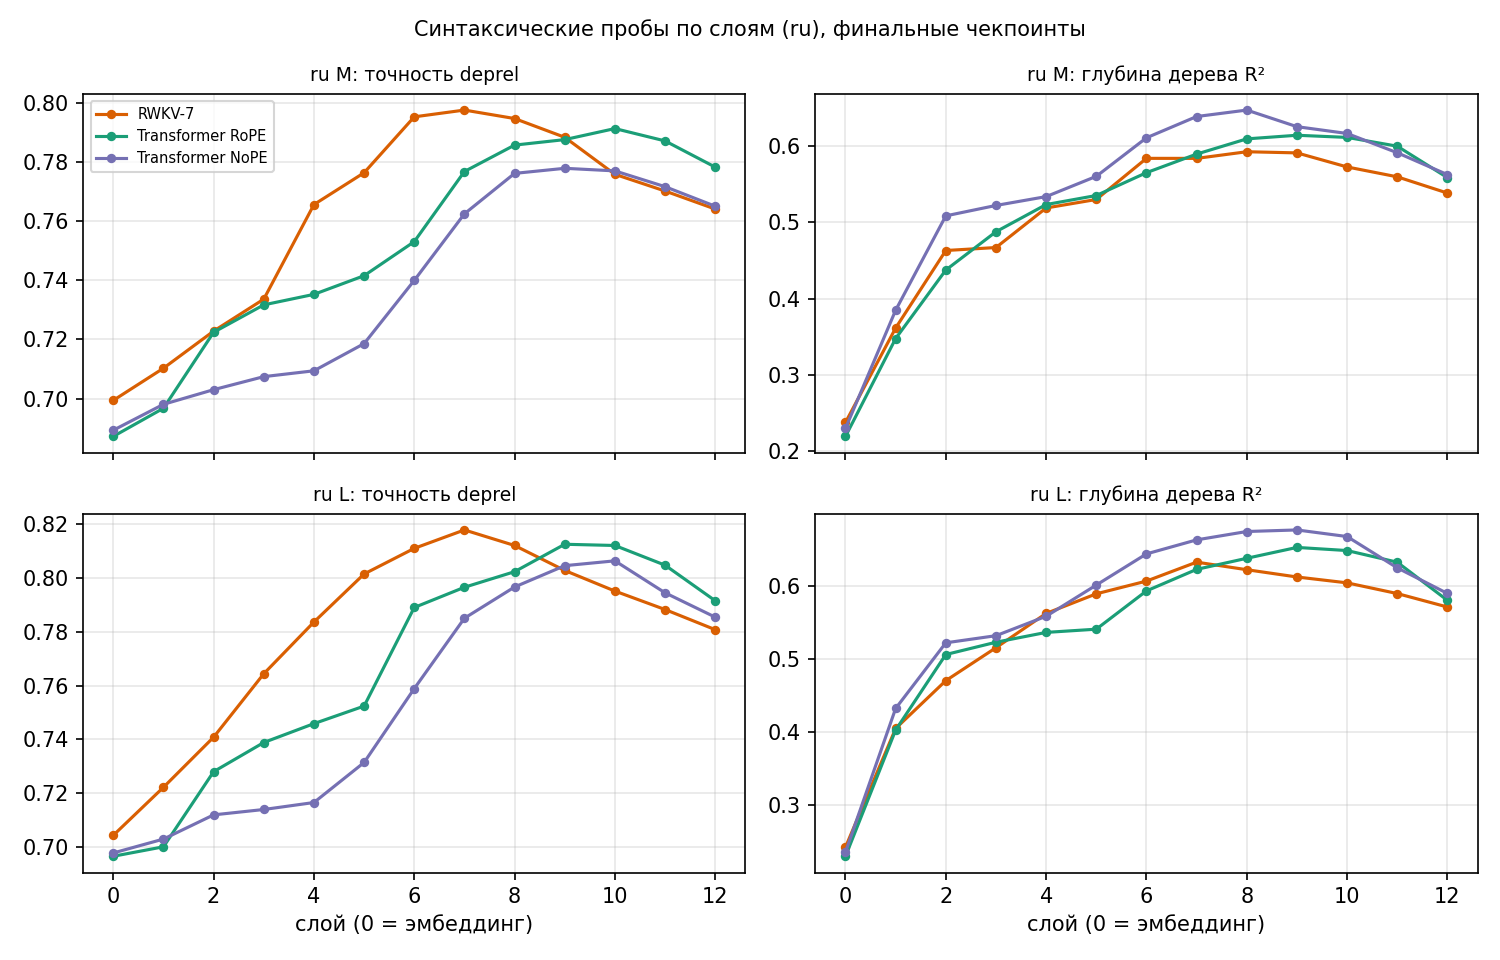
Два предупреждения. Пики считаны по финальным чекпоинтам, где у RWKV к тому же меньший loss, а кривые около максимума плоские (для роли в предложении и глубины лучший слой в среднем на 0.003, не более чем на 0.010, выше второго по качеству). И я не оценивал разброс самого слоя между сидами при равном loss. Относитесь к сдвигу как к наводке для более крупного исследования. Таблица лучших слоёв: docs/results.ru.md [17].
Что это показывает и чего не показывает
-
На этом масштабе самое явное различие между RWKV-7 и трансформерами — как хранится позиция; для синтаксиса и смысла модели при равном loss выглядят для линейной пробы похоже.
-
Это не показывает, что RWKV «понимает» меньше или больше. Линейная проба — один взгляд, а мои семантические тесты малы (20 русских и 16 английских слов).
-
Это не показывает, что происходит выше 115M параметров или за пределами 2 млрд токенов.
-
Порядок NoPE > RoPE > RWKV относится к тому, что читается линейно. Он ничего не говорит о том, какая модель лучше использует позицию.
Чему верить, а чему нет
-
Один автор, один набор рецептов, один прогон обучения на (архитектуру, язык, размер, сид); два сида меняют только инициализацию. У английской 115M второго сида нет.
-
Порядок данных не варьировался.
-
Семантический тестовый набор написан мной, носитель языка его не вычитывал. Подсказка смысла стоит до слова (модели причинные); вариант с подсказкой после слова не измерялся.
-
Утечка в обучающий поток проверена только для русского синтаксического набора (SynTagRus): убрано 1 487 предложений и 10 документов. Предложения короче 12 токенов не проверялись. Для английского синтаксиса, тональности и семантических наборов утечка не проверялась.
-
Английский набор тональности приведён к нижнему регистру и с пробелами вокруг знаков, то есть сдвинут относительно обучающего текста.
-
Сравнение при равном loss — линейная интерполяция между чекпоинтами, взятыми каждые 5 % обучения, поэтому в начале обучения оно грубее.
-
Позиция и глубина в дереве не независимы. Для слоёв (раздел 4) оценки разброса при равном loss нет.
-
Лицензии корпусов и пробных наборов нужно прочитать перед повторным использованием: таблица лицензий [18]. Полный список ограничений: docs/results.ru.md [19].
Что открыто
-
Код и результаты (код проб, все результаты в JSON, кривые val-loss, таблицы равного loss и лучших слоёв, скрипт рисунков): github.com/RafaelUI/rwkv-layer-probing_ARTICLE [1].
-
Чекпоинты сида 0: все 21 чекпоинт каждого из 12 прогонов (86.5 ГБ,
.pth) на Hugging Face: RafaelUI/rwkv-layer-probing-checkpoints [2]. Чекпоинты сида 1 пока только на сервере обучения. Код обучения, конфиги и токенизаторы в репозиторий ещё не входят (что воспроизводится [20]). -
Лицензия: Apache License 2.0. Обучающие корпуса и пробные наборы в репозиторий не входят и сохраняют свои лицензии.
Литература
-
Haviv, A. et al. Transformer Language Models without Positional Encodings Still Learn Positional Information. Findings of EMNLP 2022. arXiv:2203.16634 [3].
-
Hewitt, J., Liang, P. Designing and Interpreting Probes with Control Tasks. EMNLP 2019. arXiv:1909.03368 [10].
-
Kazemnejad, A. et al. The Impact of Positional Encoding on Length Generalization in Transformers. 2023. arXiv:2305.19466 [21].
-
Su, J. et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. 2021. arXiv:2104.09864 [22].
-
Alain, G., Bengio, Y. Understanding intermediate layers using linear classifier probes. 2016. arXiv:1610.01644 [23].
-
Tenney, I., Das, D., Pavlick, E. BERT Rediscovers the Classical NLP Pipeline. ACL 2019. arXiv:1905.05950 [24].
-
Peng, B. et al. RWKV-7 “Goose” with Expressive Dynamic State Evolution. 2025. arXiv:2503.14456 [25].
-
Nivre, J. et al. Universal Dependencies v2: An Evergrowing Multilingual Treebank Collection. LREC 2020. arXiv:2004.10643 [26].
Автор: RafaelUI
Источник [27]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38592
URLs in this post:
[1] репозиторий: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE
[2] чекпоинты сида 0: https://huggingface.co/RafaelUI/rwkv-layer-probing-checkpoints
[3] arXiv:2203.16634: https://arxiv.org/abs/2203.16634
[4] внимания: http://www.braintools.ru/article/7595
[5] про квантизацию RWKV-7: https://github.com/RafaelUI/rwkv-quant_ARTICLE
[6] про state tuning против системного промпта: https://github.com/RafaelUI/state_tuning-vs-prompt
[7] наука: http://www.braintools.ru/article/7634
[8] подробно: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D0%B4%D0%B0%D0%BD%D0%BD%D1%8B%D0%B5
[9] обучения: http://www.braintools.ru/article/5125
[10] Hewitt и Liang: https://arxiv.org/abs/1909.03368
[11] позиция: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D0%BF%D0%BE%D0%B7%D0%B8%D1%86%D0%B8%D1%8F
[12] позиция против loss: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D0%BF%D0%BE%D0%B7%D0%B8%D1%86%D0%B8%D1%8F-%D0%BF%D1%80%D0%BE%D1%82%D0%B8%D0%B2-loss
[13] ошибки: http://www.braintools.ru/article/4192
[14] все сравнения: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D1%81%D1%80%D0%B0%D0%B2%D0%BD%D0%B5%D0%BD%D0%B8%D0%B5-%D0%BF%D1%80%D0%B8-%D1%80%D0%B0%D0%B2%D0%BD%D0%BE%D0%BC-loss
[15] морфология: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D0%BC%D0%BE%D1%80%D1%84%D0%BE%D0%BB%D0%BE%D0%B3%D0%B8%D1%8F
[16] смысл и тональность: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D1%81%D0%BC%D1%8B%D1%81%D0%BB-%D0%B8-%D1%82%D0%BE%D0%BD%D0%B0%D0%BB%D1%8C%D0%BD%D0%BE%D1%81%D1%82%D1%8C
[17] docs/results.ru.md: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D1%81%D0%BB%D0%BE%D0%B8
[18] таблица лицензий: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D0%BB%D0%B8%D1%86%D0%B5%D0%BD%D0%B7%D0%B8%D0%B8
[19] docs/results.ru.md: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/docs/results.ru.md#%D0%BE%D0%B3%D1%80%D0%B0%D0%BD%D0%B8%D1%87%D0%B5%D0%BD%D0%B8%D1%8F
[20] что воспроизводится: https://github.com/RafaelUI/rwkv-layer-probing_ARTICLE/blob/main/REPRODUCE.ru.md
[21] arXiv:2305.19466: https://arxiv.org/abs/2305.19466
[22] arXiv:2104.09864: https://arxiv.org/abs/2104.09864
[23] arXiv:1610.01644: https://arxiv.org/abs/1610.01644
[24] arXiv:1905.05950: https://arxiv.org/abs/1905.05950
[25] arXiv:2503.14456: https://arxiv.org/abs/2503.14456
[26] arXiv:2004.10643: https://arxiv.org/abs/2004.10643
[27] Источник: https://habr.com/ru/articles/1108076/?utm_campaign=1108076&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.