Дообучать LLM или дать ей документы: сначала выясните, что сломалось
«Давайте дообучим модель на наших данных» — эту фразу я слышу почти в каждом разговоре о внедрении LLM. Обычно к этому моменту лечение уже выбрано, а диагноза ещё нет.
Допустим, агент ошибся в условиях возврата товара. Ему вообще передали актуальный регламент? Поиск нашёл нужный пункт? В базе одна версия правил или три, и все помечены как действующие? Пока это не выяснено, говорить об обучении [1] рано: у плохого ответа часто вполне административная причина.
Моя позиция такая. Начинать стоит с документов, инструкций и проверки на реальных задачах. Дообучение понадобится, когда найдётся конкретная проблема, которую оно умеет решать. А вот данные для будущей модели нужно собирать с первого дня — потом их не восстановить.
Контекст и дообучение решают разные задачи
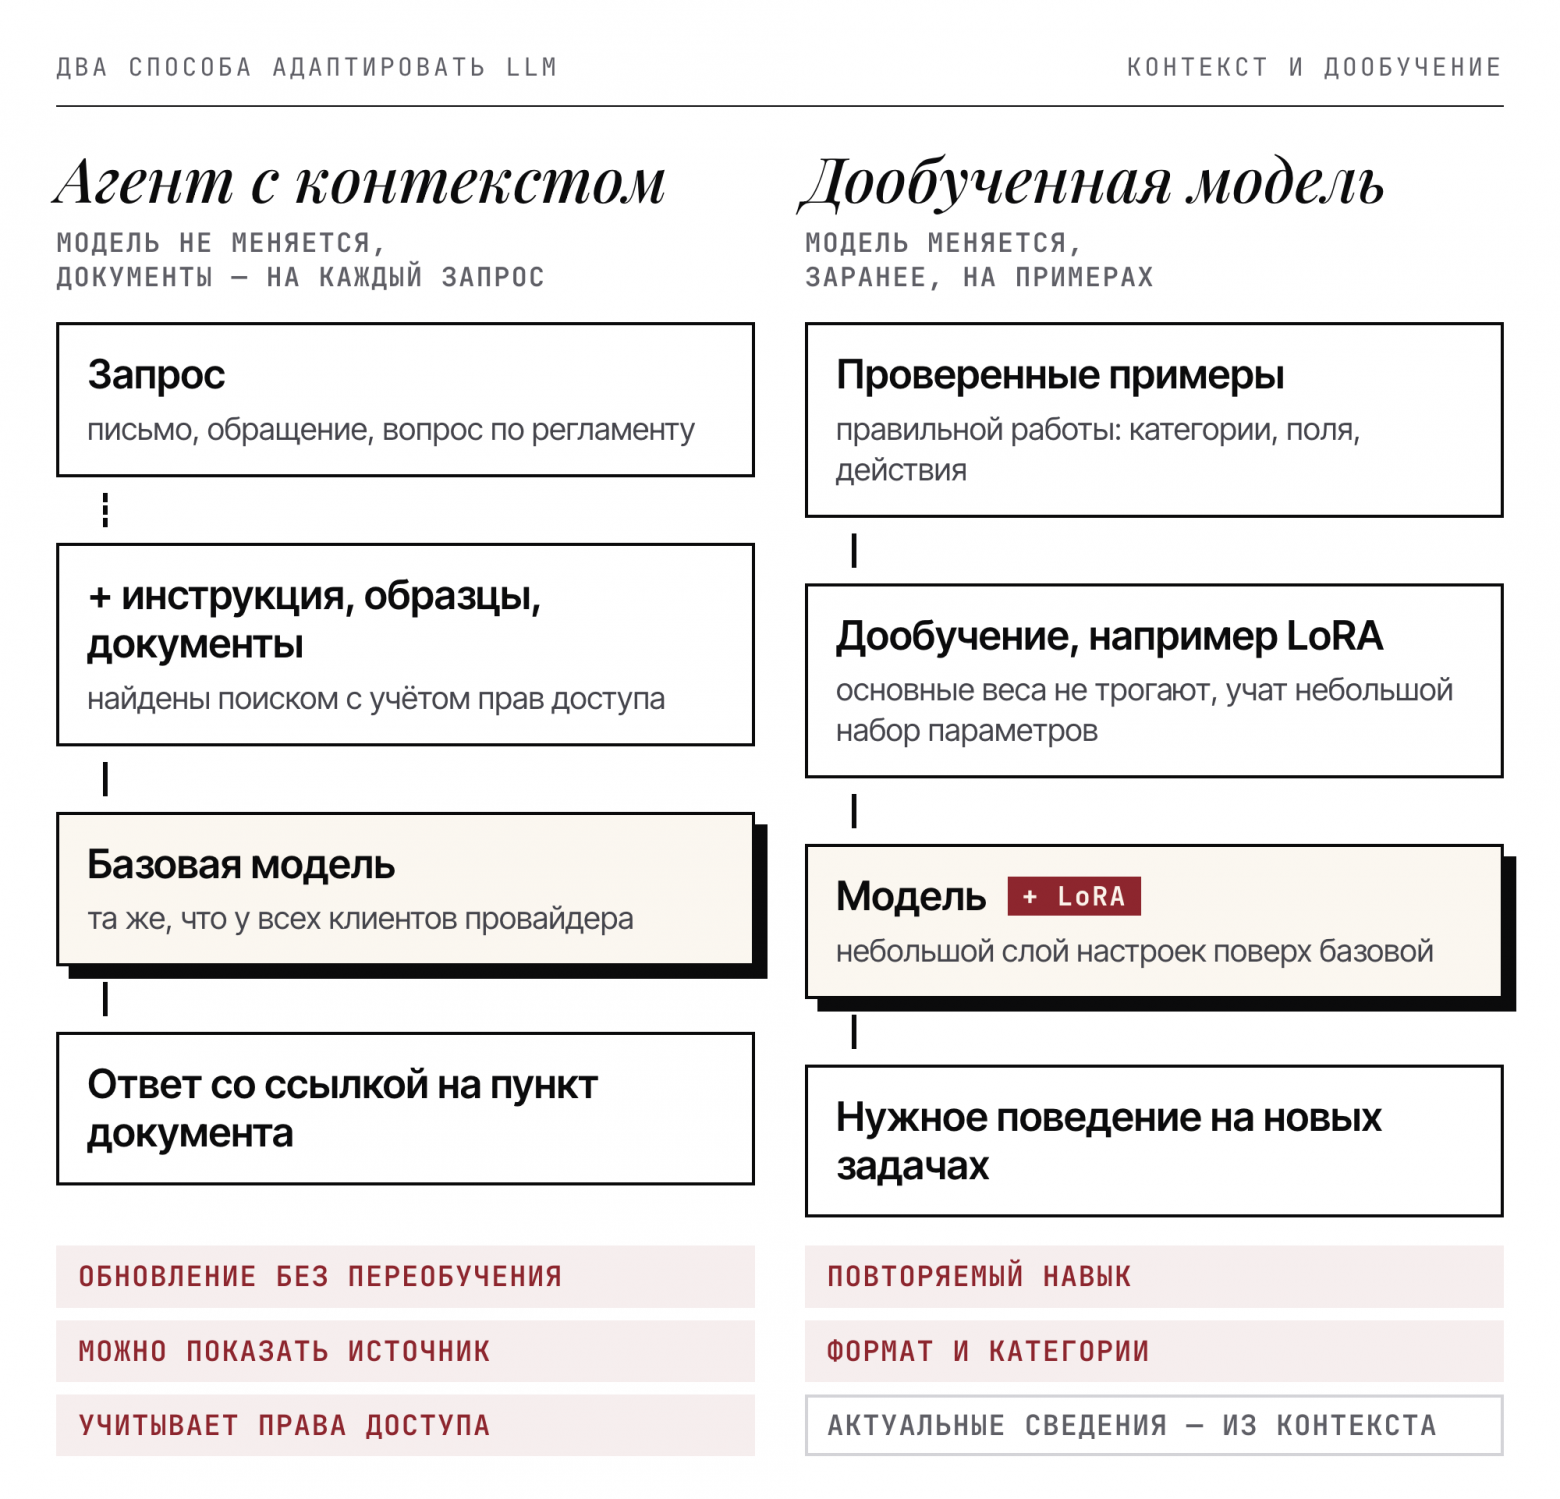
Контекст — всё, что модель получает в конкретном запросе: вопрос, инструкцию, примеры, найденные фрагменты документов. Это и есть RAG: система находит нужный пункт регламента и передаёт его модели вместе с вопросом. Веса модели не меняются.
Дообучение меняет саму модель. Ей показывают примеры правильной работы: как разносить обращения по категориям, извлекать поля из договоров, выбирать действие. Модель учится воспроизводить это поведение [2] на новых входных данных, а проверяют результат на примерах, которых в обучении не было.
Экономный вариант — LoRA: основные веса заморожены, обучается небольшой набор дополнительных параметров. Ресурсов нужно меньше, но качество примеров по-прежнему обеспечивают люди (Unsloth [3]).
Подходы не исключают друг друга. Дообученная модель тоже может получать документы и вызывать инструменты: актуальные сведения приходят в контексте, а дообучение помогает ими пользоваться.
Не храните прайс-лист в весах
Модель может усваивать факты при дообучении. Но делать из весов хранилище актуальных цен, договоров и регламентов — сомнительное инженерное решение.
В работе исследователей Microsoft RAG стабильно отвечал на фактические вопросы лучше, чем дообучение без учителя на тех же текстах, — и по уже знакомым модели фактам, и по новым (Ovadia и др., 2023 [5]). В другом эксперименте модель усваивала новые факты медленнее уже знакомых, а по мере их усвоения чаще выдумывала ответы (Gekhman и др., 2024 [6]). Это результаты конкретных экспериментов, а не запрет учить модель новому. Практический вывод из них простой: сначала проверьте поиск.
У знаний в контексте есть три свойства, которых нет у знаний в весах:
-
Обновление. Новый прайс подключают к индексу, убеждаются, что старая версия исключена, и прогоняют тесты. Переобучать модель ради каждой цены не нужно.
-
Проверяемость. Найденный фрагмент можно показать как источник. Правда, саму ссылку тоже надо проверять: она не гарантирует, что ответ ей соответствует.
-
Разграничение доступа. Документы фильтруются по правам пользователя до того, как попадут к модели. Запомненное в весах так не отфильтруешь.
Сначала разберите трассу ошибки
Прежде чем обсуждать дообучение, я бы взял несколько неверных ответов и прошёл путь каждого: что спросили, что вернул поиск, что попало в промпт и что модель сделала.
|
Симптом |
Что проверить первым |
|---|---|
|
Агент не знает условие договора или актуальную цену |
Есть ли сведения в источниках и попали ли они в контекст |
|
Документ найден, но ответ неверный |
Однозначны ли правила, хватает ли контекста, помогает ли более сильная модель |
|
Агент обещает оформить возврат, но ничего не происходит |
Подключён ли нужный инструмент, есть ли доступ и проверка результата |
|
Агент систематически путает похожие категории |
Есть ли чёткие критерии, хорошие примеры и воспроизводимая ошибка [7] на тестах |
|
Ответы верные, но обработка слишком дорогая или медленная |
Можно ли сократить контекст, упростить пайплайн или взять модель поменьше |
Самый полезный эксперимент здесь — подставить модели «идеальный» контекст: ровно тот фрагмент, который нужен для ответа, вместо того, что нашёл поиск. Если качество заметно выросло, проблема в поиске и сборке контекста. Если нет — смотрите на инструкцию, сложность задачи и возможности модели.
Делать это нужно на наборе примеров, а не на одном вопросе. Схематично:
# Сравниваем один и тот же набор задач в двух режимах:
# контекст от поиска и контекст, размеченный человеком.
def accuracy(cases, get_context):
    correct = 0
    for case in cases:
        context = get_context(case)
        answer = llm(prompt(case.question, context))
        correct += is_correct(answer, case.expected)
    return correct / len(cases)

retrieved = accuracy(cases, lambda c: retriever.search(c.question))
gold = accuracy(cases, lambda c: c.gold_context)
# Большой разрыв gold − retrieved: чините поиск, а не модель.
# Плохо в обоих режимах: смотрите инструкцию, задачу, модель.
Обсуждать дообучение имеет смысл, когда вы можете показать воспроизводимую ошибку или измеримое ограничение по цене и скорости. Формулировка «агент иногда тупит» для этого не годится.
Когда дообучение оправдано
Первый типичный случай: поддержка распределяет обращения между отделами, категории похожи, исключений много. Инструкция и примеры в промпте уже отлажены, но модель продолжает путать одни и те же случаи. При этом есть история обращений с проверенными решениями сотрудников. Это разумный кандидат для эксперимента.
Второй — стоимость. Большая модель справляется с узкой задачей, но на вашем объёме обходится дорого. Можно проверить, достигнет ли небольшая дообученная модель нужного качества дешевле. Экономию считают вместе с подготовкой данных, оценкой и сопровождением.
Я бы начинал эксперимент только при четырёх условиях:
-
Задача определена. Понятно, что считать правильным ответом и какие ошибки недопустимы.
-
Есть проверенные примеры — и обычные случаи, и исключения. Универсального порога вроде «нужна тысяча записей» нет: всё зависит от задачи, модели и разнообразия данных.
-
Есть бейзлайн. Вариант с инструкцией и контекстом работает, его качество, задержка и стоимость измерены.
-
Есть независимый тест. Тестовые примеры и их близкие копии не попали в обучающую выборку. Победа на знакомых примерах ничего не говорит о работе завтра.
Если текущий агент справляется, объём небольшой, а процесс ещё меняется, дообучение вполне может не окупиться. Свою модель приятно упомянуть на совещании, но сопровождать её придётся и после совещания.
Сколько это стоит: GPU — не главная статья
В небольшом эксперименте вычисления часто оказываются скромной частью бюджета.
|
Статья затрат |
Что в неё входит |
|---|---|
|
Данные |
Сбор примеров, согласование правильных ответов, очистка, удаление чувствительных сведений |
|
Обучение |
Ресурсы провайдера или аренда GPU, пробные запуски, подбор гиперпараметров |
|
Оценка |
Отдельный тестовый набор, сравнение вариантов, разбор ошибок специалистом |
|
Эксплуатация |
Инференс, мониторинг качества, обновления и повторная проверка |
Для примера: 1000 уже собранных ответов по три минуты проверки на каждый — это 50 часов специалиста. И это ещё без исправления ошибок, споров о пограничных случаях и подготовки теста. Человек, который знает процесс, — тоже вычислительный ресурс, просто счёт за него приходит из другого отдела.
Теперь о железе. По данным Unsloth [8], для модели на 8 млрд параметров нужно около 6 ГБ видеопамяти с QLoRA (4 бита) и около 22 ГБ с LoRA в 16 битах. Для 70B — от 41 ГБ и 164 ГБ соответственно. Это нижняя граница: длинные примеры требуют больше.
Для первого эксперимента разумно арендовать GPU. У Selectel облачный сервер с L4 на 24 ГБ стоит от 70 ₽ в час, с RTX PRO 6000 на 96 ГБ — от 290 ₽ в час (Selectel [9]). Даже десяток пробных запусков по несколько часов обычно дешевле тех 50 часов специалиста.
Если не хочется заниматься инфраструктурой, есть сервисы дообучения. Например, River AI [10] дообучает открытые модели через API с LoRA и позволяет скачать обученные веса. С отечественными провайдерами стоит уточнять заранее: в Yandex AI Studio дообучение теперь помечено как устаревшее и неподдерживаемое, новое дообучение недоступно (документация [11], проверено 14 ноября 2026 года).
И ещё одна статья расходов, о которой вспоминают поздно: смена базовой модели. Новая версия сама по себе не заставляет бросать старую. Но при переходе адаптацию обычно приходится повторять [12] и проверять заново, а отключение версии у провайдера может сделать переход обязательным.
Кнопка запуска обучения — освоенная технология. Сложнее договориться, какие ответы считать правильными. Если два опытных сотрудника размечают один случай по-разному, сначала нужен разговор между ними, а не GPU.
Почему тогда в дообучение вкладывают миллиард
В августе 2026 года River AI привлекла 1,1 млрд долларов. Компанию основал Игорь Бабушкин, ранее работавший в DeepMind, OpenAI и xAI. В интервью на сайте фонда General Catalyst ставку связывают с тем, чтобы компании сами адаптировали открытые модели и контролировали их (General Catalyst [13]).
River предлагает не только обучение на примерах, но и последующее обучение с подкреплением [14]: клиент задаёт задачу, инструменты и функцию награды (River AI [10]). Это отдельная и непростая работа — формально описать, какое действие агента считать успешным. Доступ к API её не делает.
Мне здесь интересно, что цикл «обучить → проверить → запустить → собрать обратную связь» становится доступнее. Но раунд не доказывает, что дообучение окупится в конкретной компании: у венчурного фонда и вашего отдела поддержки разные метрики успеха.
Мой прогноз: небольших моделей под повторяющиеся процессы станет больше. Где-то они выиграют по скорости, цене или контролю над системой, где-то общая модель с хорошим контекстом останется удобнее. Проверять придётся на своих задачах.
Датасет начинают собирать до обучения
Что стоит делать уже сейчас — сохранять проверенные примеры того, как ваша команда решает задачи. Они пригодятся для отладки промптов, для регрессионных тестов и для будущего дообучения.
Полезная запись содержит запрос, контекст, который был доступен в тот момент, ответ или действие агента, исправление сотрудника, причину исправления и, если возможно, итог. Для примера, запись по обращению в поддержку может выглядеть так:
{
  "id": "ticket-2026-11-0412",
  "task": "route_ticket",
  "input": "Пришёл не тот размер, хочу обменять, чек потерял",
  "context": [
    {"doc": "returns-policy", "version": "2026-09", "section": "4.2"}
  ],
  "agent_output": {"category": "return_refund"},
  "correction": {"category": "exchange", "by": "support_lead"},
  "reason": "Обмен без чека оформляется по п. 4.2, это не возврат денег",
  "outcome": "resolved",
  "split": "test"
}
Поле split стоит заполнять сразу: часть случаев нужно с самого начала откладывать в тест, чтобы потом не выяснять, видела модель их или нет.
Архив переписки сам по себе не обучающая выборка. В нём есть ошибки, устаревшие правила и решения, принятые по обстоятельствам, которых в тексте нет. Правка сотрудника тоже не становится эталоном автоматически: утверждать ответ должен тот, кто отвечает за процесс.
Порядок, с которого я бы начал:
-
Выбрать один повторяющийся процесс и договориться, какой результат считать приемлемым.
-
Собрать небольшой набор реальных задач с проверенными ответами. Для первого разбора ошибок хватит 30–50 случаев; для уверенной оценки, особенно редких сбоев, набор придётся расширять.
-
Прогнать агента с инструкцией, примерами, документами и инструментами. Зафиксировать бейзлайн.
-
Наладить сбор исправлений: кто проверяет, что сохраняется, какие сведения исключаются. Часть случаев сразу отложить в независимый тест.
-
Возвращаться к дообучению, когда накопятся данные и появится измеримая задача. Сравнивать варианты в одинаковых условиях, включая стоимость инференса.
Модель у провайдера может заказать и ваш конкурент. А историю проверенных решений вашей команды ему придётся собирать самому. Видеокарту можно арендовать завтра — историю правильных решений за прошлый год уже нет.
Автор: aleko855
Источник [15]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38602
URLs in this post:
[1] обучении: http://www.braintools.ru/article/5125
[2] поведение: http://www.braintools.ru/article/9372
[3] Unsloth: https://github.com/unslothai/unsloth
[4] поведение: http://www.braintools.ru/article/5593
[5] Ovadia и др., 2023: https://arxiv.org/abs/2312.05934
[6] Gekhman и др., 2024: https://arxiv.org/abs/2405.05904
[7] ошибка: http://www.braintools.ru/article/4192
[8] Unsloth: https://unsloth.ai/docs/get-started/fine-tuning-for-beginners/unsloth-requirements
[9] Selectel: https://selectel.ru/services/gpu/
[10] River AI: https://river.ai/
[11] документация: https://aistudio.yandex.ru/ru/docs/ai-studio/concepts/tuning/
[12] повторять: http://www.braintools.ru/article/4012
[13] General Catalyst: https://www.generalcatalyst.com/stories/own-your-ai-experience
[14] подкреплением: http://www.braintools.ru/article/5528
[15] Источник: https://habr.com/ru/articles/1107846/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1107846
Нажмите здесь для печати.