Нейросеть на железе со свалки, или Как Bonsai 2 27B проиграла Qwen3 8B
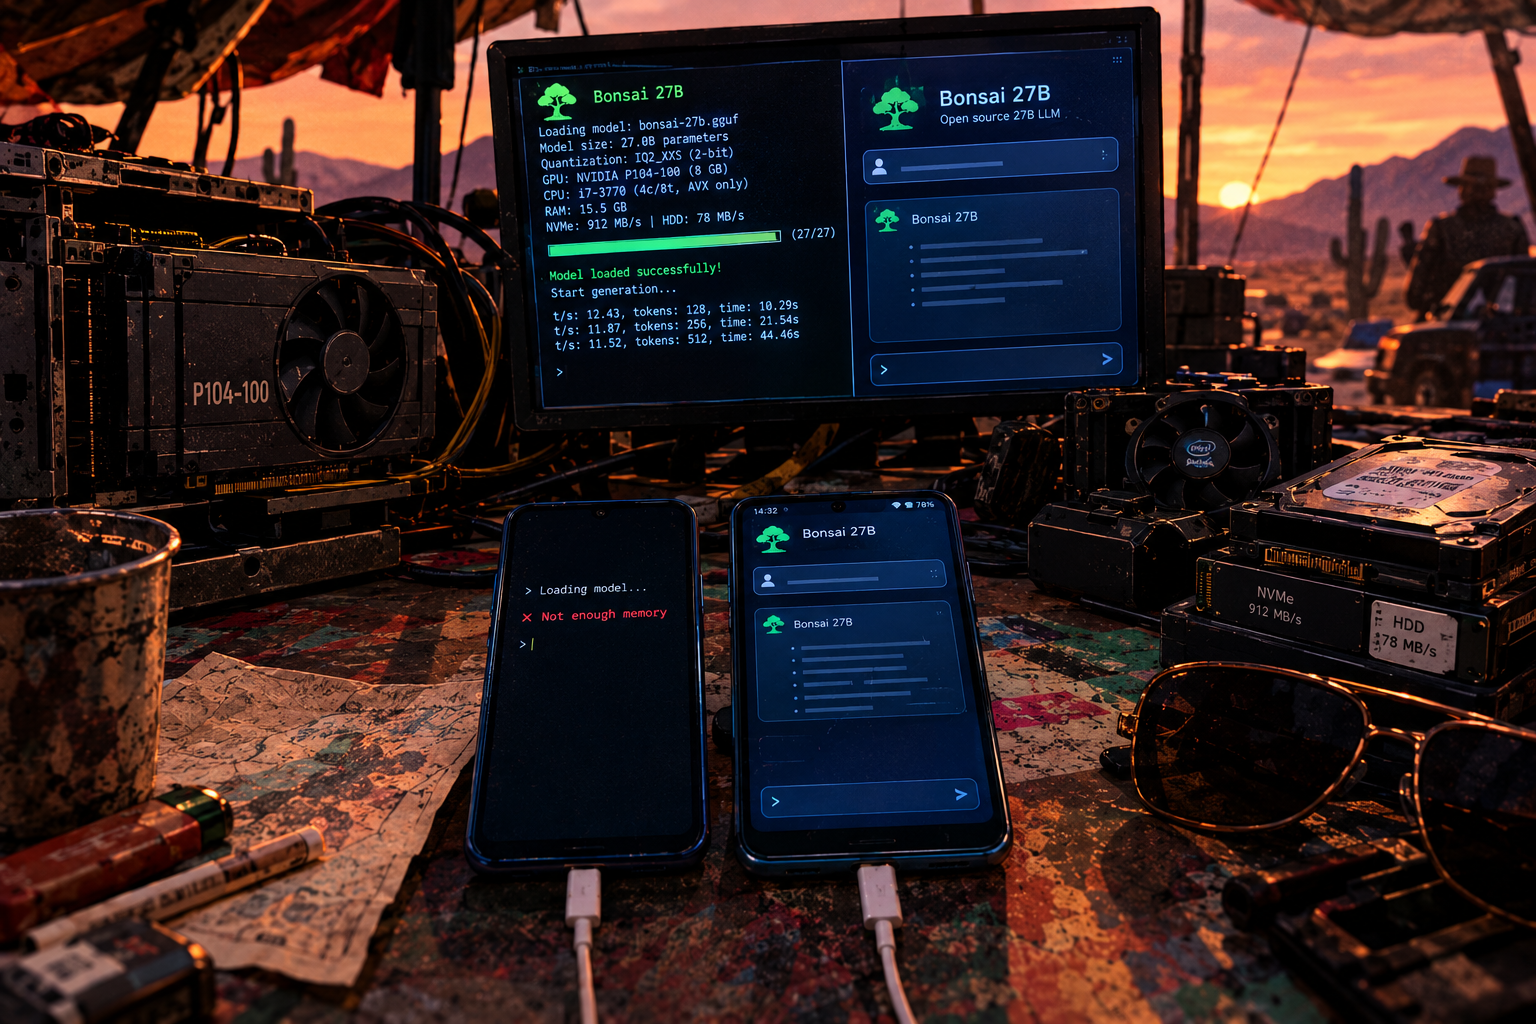
У меня было 8 гигабайт видеопамяти на старой майнинговой NVIDIA P104-100 семнадцатого года, древний i7-3770 родом из двенадцатого, знающий только AVX, ровно 15,5 гигабайта оперативной памяти [1], NVMe-накопитель и HDD — его взяли специально, чтобы замерить этот чертовски долгий старт. Не то чтобы все это было категорически необходимо для запуска нейросетей, но если уж начал собирать домашний стенд, к делу надо подходить серьезно. Единственное, что вызывало у меня опасение, — это телефоны.
Мы находились где-то на краю пустыни технологического прогресса, когда железо начало плавиться… На деле все было гораздо скучнее.
Для своего проекта я искал локальную модель, без облака, на железе, которое уже стоит под столом, и наткнулся на Bonsai 2 27B. Она обещала уместить модель класса 27B в 8 ГБ старой карты. Модель запустилась, но на реальных задачах обычная Qwen3 8B, которая помещается в те же 8 ГБ без форков и патчей, держалась на уровне, а местами оказывалась быстрее и стабильнее. Дальше разбираюсь, нужна ли Bonsai, если рядом есть 8B.
С чем имеем дело?
Bonsai 27B PrismML выпустила [2] в середине июля и сразу заявила, что это первая модель такого размера, которая влезает в iPhone. Через два месяца, 17 сентября, появилась Bonsai 2 27B [3], уже троичная. О ней быстро заговорили в профильных каналах.
Звучало сказочно. 27 млрд параметров ужали в девять раз: было 54 ГБ, стало 5,9. Качество при этом почти не пострадало, если верить разработчикам: осталось 98,2% от исходной модели. А июльскую версию на Hugging Face [4] скачали уже около 5 млн раз.
Под капотом у Bonsai 2 27B — Qwen3.8-27B, лицензия Apache 2.0. Контекст по паспорту 262K токенов. Внимание [5] гибридное, примерно три четверти слоев в нем линейные. Такие слои на длинном тексте обходятся дешевле: их затраты растут вместе с длиной контекста, а у полного внимания — с ее квадратом.
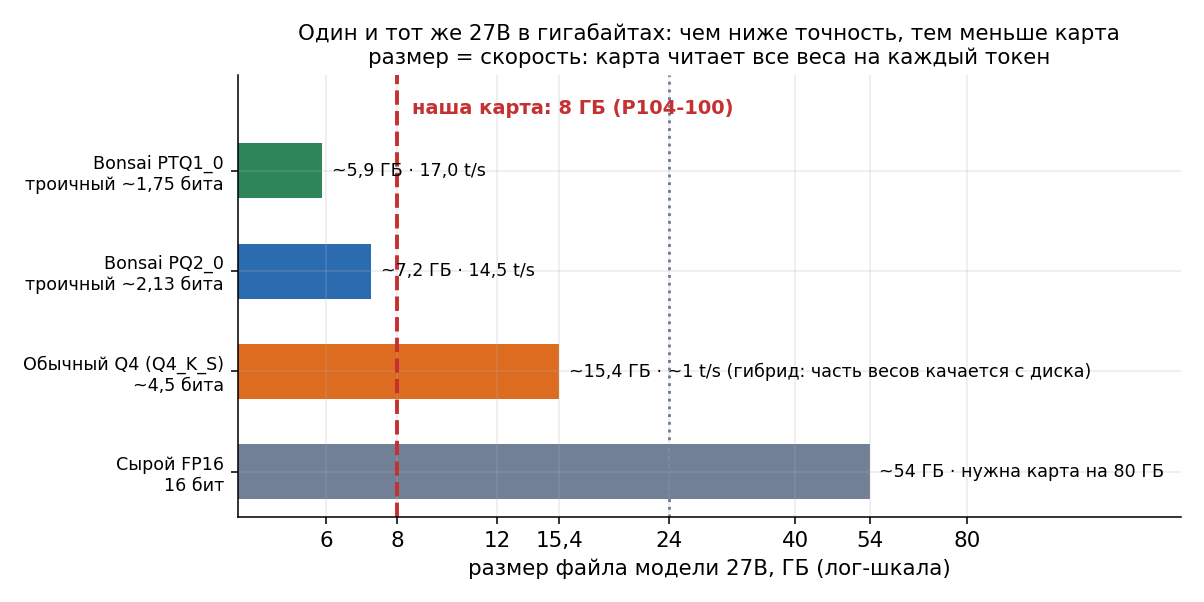
Но главное тут, конечно, размер файла. Добились его троичными весами. В обычной модели каждый вес хранится как 16-битное число, а здесь у него всего три возможных значения: −1, 0 и +1. Разработчики обещают и выигрыш в вычислениях: умножать на такие числа не нужно, хватает сложения и смены знака. Нагрузка на процессор от этого резко падает.
В гигабайтах картина такая:
|
Формат |
Бит на вес |
Размер 27B |
Под какую карту |
|
FP16 |
16 |
~54 ГБ |
80 ГБ |
|
Q4 |
~4,5 |
~15,4 ГБ |
24 ГБ |
|
PQ2_0 (троичный) |
~2,13 |
~7,2 ГБ |
8 ГБ |
|
PTQ1_0 (троичный) |
~1,75 |
~5,9 ГБ |
8 ГБ |
На старых картах размер важен еще и для скорости. Чтобы выдать токен, карта читает все веса, поэтому скорость генерации чаще упирается в пропускную способность памяти, чем в вычисления.
Зачем два формата? По данным PrismML, PTQ1_0 быстрее на игровых картах уровня RTX 4090, а PQ2_0 — на серверных H100, A100 и Blackwell.
Старое железо и обязательный форк PrismML
Обещания я решил проверить на том, что было под рукой: на майнинговой карте 2017 года и паре недорогих смартфонов.
|
Компонент |
Что было |
|
GPU |
NVIDIA P104-100 — Pascal 2017 года, 8 ГБ VRAM, бывшая майнинг-карта |
|
CPU |
i7-3770 (4 ядра, 2012 год, не поддерживает AVX2) |
|
RAM |
15,5 ГБ |
|
Диски |
NVMe (912 МБ/с) и HDD (78 МБ/с) — HDD специально для замера старта |
|
Телефоны |
TECNO Pouvoir 4 — Helio A22, 2,9 ГБ, Android 10, 32-бит; TECNO Pova 5 — Helio G99, 8 ГБ, Android 14, 64-бит |
Скорость я мерил утилитой llama-bench из llama.cpp [6]. Параллельно каждые полсекунды через nvidia-smi снимал с карты температуру, мощность и загрузку памяти. Телефоны подключал по adb, через него же ими и управлял.
Первая проблема вылезла еще на ПК: стандартные llama.cpp и Ollama троичный GGUF не понимают. Веса модели лежат в тензорах типов PQ2_0 и PTQ1_0, а их знает только форк PrismML [7]. Стандартная Ollama версии 0.40.6 при попытке прочитать такой файл выдает ошибку [8]. Ollama с тех пор обновлялась, часть форматов Bonsai приняли в официальный llama.cpp [9], но быстрые троичные тензоры PQ2_0 по-прежнему работают только в форке [10].
Для замеров я запускал модель напрямую через готовую сборку от PrismML с поддержкой CUDA 12.4, так проще и быстрее. Но при желании троичную Bonsai можно подружить и со стандартной Ollama. Для этого ее придется доработать вручную: пропатчить Go-парсер GGUF (без этого Ollama не сможет рассчитать размер тензоров) и заменить стандартный бинарник llama-server на сборку из форка PrismML. Тогда ollama create и ollama run заработают и с 27B, причем скорость не упадет: генерация идет так же, как в чистом форке. Только практической пользы в этом мало: такой «костыль» продержится ровно до первого обновления Ollama, которое затрет все изменения.
Ollama хотя бы честно падает, когда не может разобрать файл. Со стандартным llama.cpp хуже: он молчит. Старый формат Q2_0 из той же серии он загружает без единого предупреждения, а модель потом выдает полную бессмыслицу.
Все из-за того, как устроено сжатие. Перед квантованием веса «поворачивают»: умножают на матрицу Адамара, чтобы сгладить редкие выбросы, которые хуже всего переживают сжатие. Значит, и во время работы входные данные, то есть активации, нужно поворачивать так же, иначе они с весами окажутся в разных системах координат. Стандартный llama.cpp этого не умеет. Разработчики прямо предупреждают об этом на странице модели на Hugging Face [11].
Как быстро Bonsai работает на видеокарте
Пять кандидатов, все не больше 8 ГБ, кроме эталона:
|
Модель |
Формат |
Бит на вес |
Размер |
Роль |
|
Bonsai 2 27B PTQ1_0 |
троичный |
1,75 |
5,95 ГБ |
главный герой |
|
Bonsai 2 27B PQ2_0 |
троичный |
2,13 |
7,21 ГБ |
то же, чуть тяжелее |
|
Qwen3 8B Q4_K_M |
обычный 4-битный |
~4,5 |
4,7 ГБ |
8B, тот же класс «влезает в 8 ГБ» |
|
Qwen3.8 27B UD-IQ2_XXS |
обычный 2-битный |
~2 |
7,27 ГБ |
соперник того же размера |
|
Qwen3.8 27B UD-Q4_K_S |
обычный 4-битный |
~4,5 |
15,4 ГБ |
почти несжатый эталон (через mmap) |
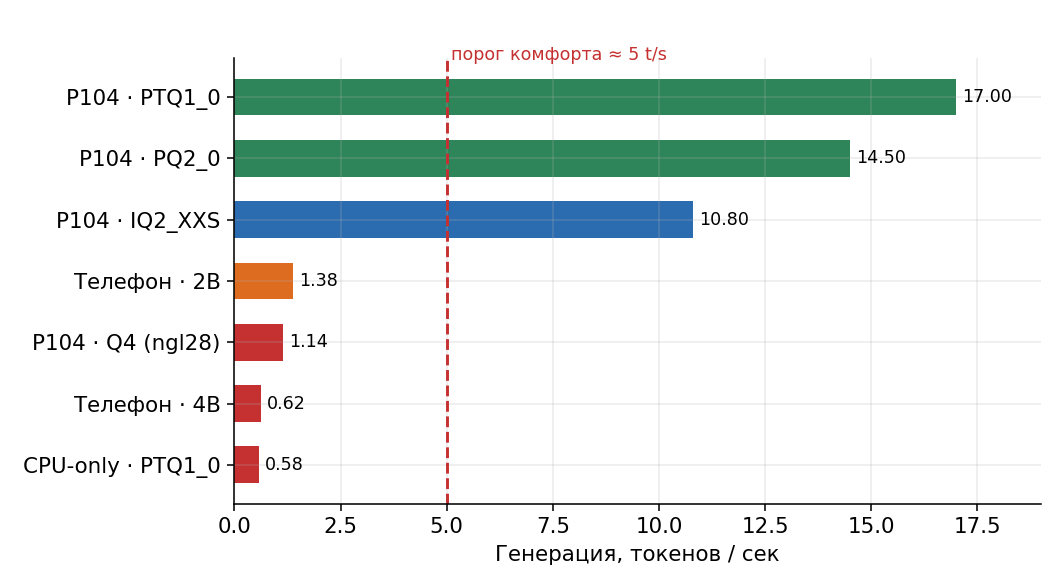
Эталону Q4_K_S на этом стенде тесно: 15,4 ГБ не влезают ни в видеопамять, ни в свободную оперативку. Через mmap, когда веса подтягиваются с диска по мере надобности, он выдает около 1 t/s. Я пробовал и по-другому: отдал видеокарте 28 слоев, остальное оставил процессору. Вышло 1,14 t/s, почти то же самое.
В таблице ниже две скорости. Чтение промпта показывает, как быстро модель переваривает уже заданный вопрос, а генерация — как быстро печатает ответ. Считаются обе в токенах в секунду (t/s).
|
Модель |
Размер |
Чтение промпта, t/s |
Генерация, t/s |
Пик видеопамяти |
|
Bonsai PTQ1_0 |
5,95 ГБ |
93,8 |
17 |
6,98 ГБ |
|
Bonsai PQ2_0 |
7,21 ГБ |
97,7 |
14,5 |
7,81 ГБ |
|
Qwen UD-IQ2_XXS (обычный 2-бит) |
7,27 ГБ |
15,7 |
10,8 |
7,89 ГБ |
В последней строке кроется неожиданный результат. Обычный 2-битный IQ2_XXS на Pascal в шесть раз медленнее читает промпт и в 1,6 раза медленнее генерирует, хотя размер файла у соперников сопоставим. Скорость определяют вычислительные ядра, написанные под конкретный формат, а число бит на вес отходит на второй план. IQ2_XXS тоже сжат очень сильно, так что в таблице сравниваются два способа ужать одну и ту же Qwen 27B. Несжатую версию для сравнения на этой карте запустить негде.
Для сравнения: на RTX 4090, по данным PrismML, модель выдает 81–91 t/s. Майнинговая карта 2017 года дает примерно пятую часть этой скорости.
По контексту карта упирается в 16K токенов. На 16 384 видеопамять забита на 97%, это 7967 МБ из 8191. А на 32 768 модель даже не стартует. Так что паспортные 262K для 8 ГБ остаются теорией. На картах с 12–16 ГБ после 5,9 ГБ весов под кэш контекста остается заметно больше места, и длинные окна там, скорее всего, достижимы. Но на моем стенде это не проверить.
Без видеокарты я тоже попробовал, хотя чудес не ждал. Старый i7-3770 без AVX2 выдал 0,6 t/s, почти в тридцать раз медленнее карты.
Пока модель целиком сидит в видеопамяти, диск важен только на старте. С NVMe она поднялась за 25 секунд, с HDD пришлось ждать 87. Дальше разницы почти нет: 16,5 и 17,0 t/s. Выходит, SSD спасает только от лишней минуты перед запуском. Но если перезапускать модель часто, эта минута быстро надоедает.
Сколько ждать токена на телефоне
Июльскую Bonsai 27B PrismML подавала [12] как «первую модель класса 27B для запуска на телефоне». Только телефоном там был iPhone с 12 ГБ памяти, где модели отдают около шести, а моделью — однобитная версия на 4 ГБ. У меня все было иначе: троичная Bonsai 2 на 5,9 ГБ и два обычных Android-смартфона. На первом она даже не стартовала, а второй ее все-таки запустил и выдавал по токену раз в 20 секунд.
TECNO Pouvoir 4: только младшие модели
Первый смартфон оказался строго 32-битным. Здесь 27B невозможна сразу по двум причинам. Во-первых, форк публикует Android-сборку только для arm64, и запуск заканчивается так:
/system/bin/sh: ./llama-bench: not executable: 64-bit ELF file
Вторая причина глубже. Даже если собрать рантайм под armv7, 32-битный процесс не сможет работать с файлом на 5,9 ГБ из-за жесткого лимита адресного пространства в 4 ГБ.
Младшие модели серии в память Pouvoir 4 помещаются, но рантайм для armv7 под них пришлось собирать вручную из исходников форка. Мешали три вещи:
-
Хост-инструмент llama-ui-embed. Он жестко привязан к MSVC и чем-то другим компилироваться наотрез отказывался.
-
Библиотека libc++fs.a. В Android NDK r21e ее не оказалось, пришлось лезть в исходники самой libc++, выковыривать нужное и собирать с нуля.
-
Флаги оптимизации. По умолчанию релизная сборка шла с -Oz, то есть оптимизировалась под размер кода, и использовала компактные Thumb-инструкции. Когда я вручную переключил ее на -O3 и обычный набор ARM-инструкций, скорость выросла на 13–17%.
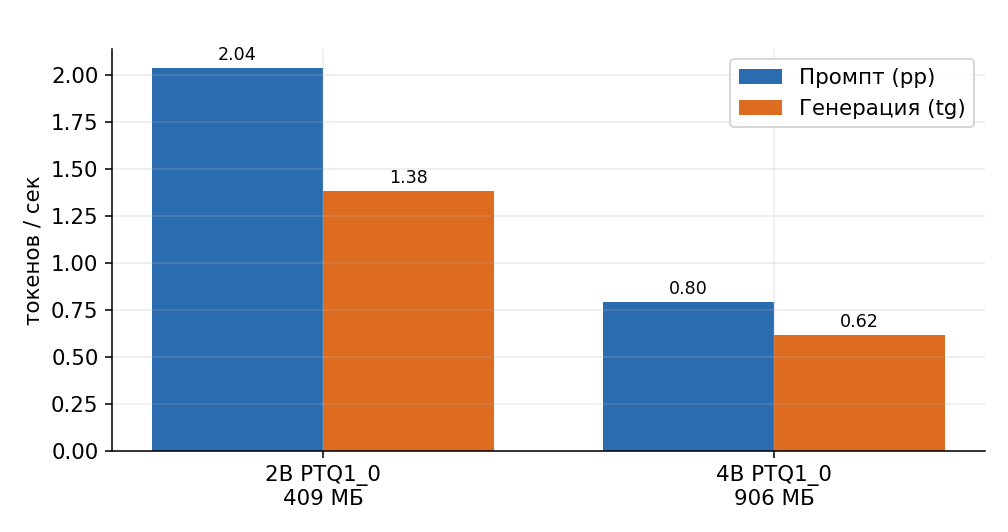
Готовые бинарники llama-cli и llama-bench я закинул на смартфон обычным adb push, рядом положил libomp.so [13] и загрузил две младшие модели серии, 2B на 409 МБ и 4B на 906 МБ. Отвечают обе осмысленно, и русский понимают хорошо. Правда, у версии 4B стандартный размер контекста целиком занимает доступные процессу 2,9 ГБ оперативной памяти, поэтому запустить ее удалось только с урезанным контекстом, с флагом -c 512.
|
Модель |
Файл |
Промпт, t/s |
Генерация, t/s |
|---|---|---|---|
|
Bonsai 2 2B PTQ1_0 |
409 МБ |
2,04 (pp128) |
1,38 (tg64) |
|
Bonsai 2 2B (-Oz/Thumb) |
409 МБ |
1,80 |
1,19 |
|
Bonsai 2 4B PTQ1_0 |
906 МБ |
0,79 (pp64) |
0,62 (tg32) |
|
27B PTQ1_0 |
5,95 ГБ |
невозможно |
невозможно (32-бит + ОЗУ) |
TECNO Pova 5: 27B запускается, но очень медленно
С 64-битным TECNO Pova 5 на 8 ГБ все прошло проще. Чистый рантайм под aarch64 я собрал по инструкции из репозитория форка [14], залил на смартфон те же файлы 27B, что гонял на ПК, и модель запустилась. Из шести контрольных вопросов (умножение, ловушка про овец, короткий код, вопрос с ложной посылкой, проверка фактов, творческое задание) она верно ответила на пять.
Сорвалось творческое задание, причем только на PTQ1_0: PQ2_0 с ним справилась. Еще один ответ сначала обрывался, но модель тут ни при чем: ему не хватало лимита длины. С -n 64 ответ вышел полным и верным.
Скорость при этом такая:
|
Модель |
Размер |
Промпт, t/s |
Генерация, t/s |
|---|---|---|---|
|
Bonsai 2 27B PTQ1_0 |
5,95 ГБ |
0,59 |
0,05 |
|
Bonsai 2 27B PQ2_0 |
7,21 ГБ |
0,67 |
0,04 |
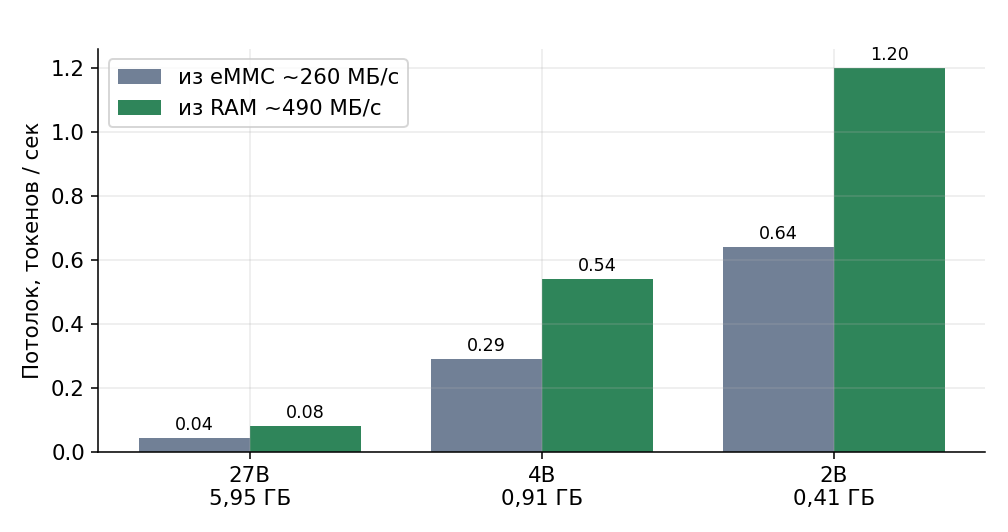
Android сам занимает изрядную часть памяти, и из 8 ГБ приложению остается около 3–4. Файл на 5,95 ГБ туда не влезает, поэтому на каждый токен телефон заново читает веса с флеш-памяти, примерно на 260 МБ/с.
Проверить легко: при такой скорости файл читается секунд 23, а замер дал 20 секунд на токен. Почти все это время телефон ждет флеш-память. Pouvoir 4 подвела разрядность, а Pova 5 — объем оперативки. От видеокарты он отстает примерно в 340 раз. Точнее не скажу: 0,05 t/s — уже округленное значение.
Pova 5 относится к середнякам. На флагмане с 12–16 ГБ ОЗУ, где веса целиком лежат в памяти, скорость, скорее всего, будет совсем другой, но проверить это на момент тестов было нечем.
По моему опыту [15], для 27B на телефоне нужны 64-битная система и минимум 8 ГБ оперативной памяти. Тогда модель запустится и будет отвечать осмысленно, но при 0,05 t/s переписываться с ней не получится. На бюджетных 32-битных смартфонах вроде Pouvoir 4 такая модель не запустится вообще, там остаются версии 2B и 4B со скоростью от 0,6 до 2 t/s.
На коротких заданиях 27B и 8B разделяет один балл
Шести вопросов для сравнения мало, поэтому я собрал набор из 40 коротких заданий: восемь категорий по пять. В него вошли логические ловушки, многошаговая арифметика, код, который должен пройти юнит-тесты, JSON по заданной схеме и задания на точное следование инструкции, например вывести ровно N пунктов или не использовать определенную букву. Остальные три категории — поиск информации в контексте длиной от 1 до 8K токенов, фактические знания и качество текста на русском. Поиск в контексте — это тест «иголка в стоге сена» (needle in a haystack): в длинный текст прячут один факт и просят его найти.
Условия у всех моделей были одинаковые: температура 0, сид 42, контекст 8192 токена, рассуждение выключено, на каждое задание один прогон. Проверял я по-разному. Код гонял через тесты, JSON прогонял парсером, а в математике [16] сверял числа. Знания и русский текст оценивал вслепую по шкале, которую составил заранее, и только потом смотрел, чей это был ответ.
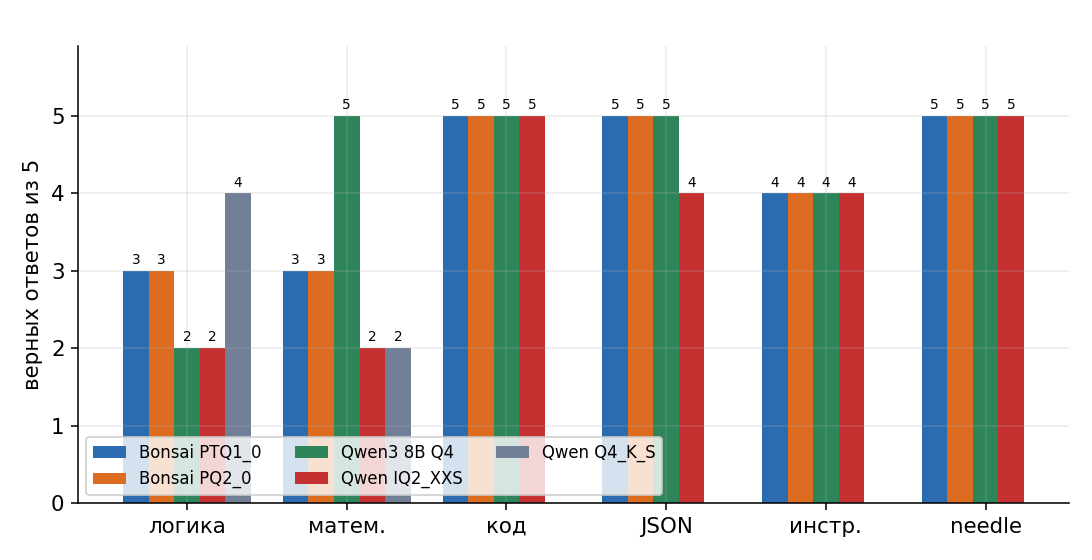
Эталон Q4_K_S при скорости около 1 t/s прогнал только на логике [17] и математике.
|
Категория |
Bonsai PTQ1_0 |
Bonsai PQ2_0 |
Qwen3 8B |
Qwen IQ2_XXS |
Эталон Q4_K_S |
|
Логика |
3/5 |
3/5 |
2/5 |
2/5 |
4/5 |
|
Математика |
3/5 |
3/5 |
5/5 |
2/5 |
2/5 |
|
Код |
5/5 |
5/5 |
5/5 |
5/5 |
— |
|
JSON |
5/5 |
5/5 |
5/5 |
4/5 |
— |
|
Поиск в контексте |
5/5 |
5/5 |
5/5 |
5/5 |
— |
|
Знания |
5/5 |
5/5 |
5/5 |
5/5 |
— |
|
Русский текст |
5/5 |
5/5 |
5/5 |
5/5 |
— |
Итог по короткому набору почти ничейный: у Bonsai 35 баллов из 40, у 8B — 36. Интереснее смотреть по категориям. С кодом и поиском факта в тексте справились все, слепые тесты на знания и русский текст тоже прошли без ошибок. Споткнулась только IQ2_XXS, и то на JSON: в одном задании она вернула пустой ответ.
Расходятся модели на логике и математике. В логике впереди эталон с 4 из 5, у обеих Bonsai по 3, у 8B и IQ2_XXS по 2. В математике 8B взяла 5 из 5, обе Bonsai — по 3, IQ2_XXS и эталон — по 2. В сумме по этим десяти заданиям у эталона и обеих Bonsai по 6 баллов, у 8B — 7, у IQ2_XXS — 4.
PrismML обещала, что Bonsai сохранит 98,2% качества исходной модели. На логике и математике троичная Bonsai набрала столько же, сколько почти несжатый эталон, так что с этим обещанием мой маленький тест не спорит.
Ответы PTQ1_0 и PQ2_0 побайтово совпали в 35 заданиях из 40. В остальных пяти ответ давался в свободной форме, и там расходились только формулировки. PQ2_0 весит на гигабайт больше, но на этом наборе ничего за это не дала.
Рассуждение меняет математику
С отключенным рассуждением троичные модели выдают ответ одним числом и ошибаются там, где нужны промежуточные вычисления. Тогда я прогнал те же пять задач еще раз, уже с рассуждением. PTQ1_0 решила все пять вместо трех, эталон Q4_K_S — все пять вместо двух. При этом PTQ1_0 потратила на рассуждение 63 токена, а эталон — 400. Пять задач — слишком мало для доказательства, но похоже, что математику портит ответ без промежуточных шагов, причем не только у троичной модели. Правда, эталону на задание нужно около 145 секунд, а PTQ1_0 — 21: скорость генерации у них 1,2 и 15 t/s.
Математику 8B выиграла не совсем честно. Рассуждение я у всех отключил, а в промпте стояло жесткое условие выводить только итоговое число. Остальные модели условие выполнили и в математике ошиблись, а 8B его проигнорировала и стала считать вслух, раскладывая вычисление на шаги:
Сколько будет 144 / 12 + 17 * 3? Ответь только числом.
144 / 12 = 12
17 * 3 = 51
12 + 51 = 63
Ответ: 63
Получается, 8B сама включила себе рассуждение, которое я у всех отключил, — отсюда и ее 5 из 5 в математике.
Три срыва общие для всех участников: задача про яблоки (12 яблок, половину отдали, из трети оставшихся сварили компот), выражение 144/12+17*3 при прямом ответе и запрет буквы «о» в предложении о зиме.
Разницу между способами сжатия хорошо видно на старой загадке про фермера и овец. У фермера 17 овец, все, кроме девяти, убежали. Сколько осталось? Ловушка в том, что рука тянется вычесть 9 из 17, хотя ответ уже есть в условии.
IQ2_XXS во всех 15 прогонах (пять при температуре 0 и десять при 0,7) отвечала «8», то есть считала убежавших овец. Обе версии Bonsai и эталон Q4_K_S каждый раз отвечали «9». В основе у всех четырех моделей одна и та же Qwen 27B, так что ошибку IQ2_XXS остается списать на способ сжатия. Но и Q4 не обходится без потерь. В первой серии из шести вопросов эталонная модель один раз ошиблась в тесте. Ей дали промпт — «придумай одно короткое предложение про кота и дождь», но она упустила дождь и написала фразу только про кота. На сложных заданиях 27B тоже не обогнала 8B.
Короткие вопросы плохо показывают, в чем большая модель сильнее маленькой, поэтому я собрал второй набор из 20 заданий посложнее. Отбирал такие, где 27B должна обыграть 8B, иначе возиться с ней дома нет смысла. В набор вошли редкие знания, многошаговые логические задачи, сказки и поиск скрытых фактов в русских текстах длиной 8K и 16K токенов. Его прошли три модели:
|
Модель |
Знания |
Контекст 8K |
Авто-итог |
t/s |
Контекст 16K |
|---|---|---|---|---|---|
|
Qwen3 8B |
5/5 |
5/5 |
8/10 |
31,9 |
ок |
|
Bonsai PTQ1_0 |
5/5 |
5/5 |
7/10 |
16,8 |
ок |
|
Qwen IQ2_XXS |
4/5 |
4/5 |
6/10 |
10,7 |
таймаут |
Как ни грустно признавать, явного преимущества у массивной 27B перед более шустрой «малышкой» 8B обнаружить так и не удалось.
По направлениям картина такая:
-
Эрудиция и память. На редких фактах и поиске «иголки в стоге сена» в пределах 8K контекста разницы между 8B и 27B нет.
-
Сложная логика. С включенным режимом рассуждения модели справляются почти одинаково.
-
Длинный контекст (16K). Только здесь одна из 27B споткнулась. IQ2_XXS весит больше PTQ1_0 и вместе с кэшем на 16K в 8 ГБ не поместилась. Полчаса она гоняла веса с диска, а потом упала по таймауту. 8B и PTQ1_0 с таким объемом справились и ответили.
-
Креативность. Модели писали сказки в заданном стиле, например «Репку», «Колобка» и «Теремок». Оценивал я их вслепую и вручную. Обе 27B набрали по 19 баллов из 25, 8B отстала на шаг с 18 баллами. Максимума не получил никто: все модели теряли героев и рвали сюжет. 27B к тому же пишут длиннее, и сюжеты у них, на мой вкус [18], интереснее. Но пять сказок на модель — слишком мало для выводов.
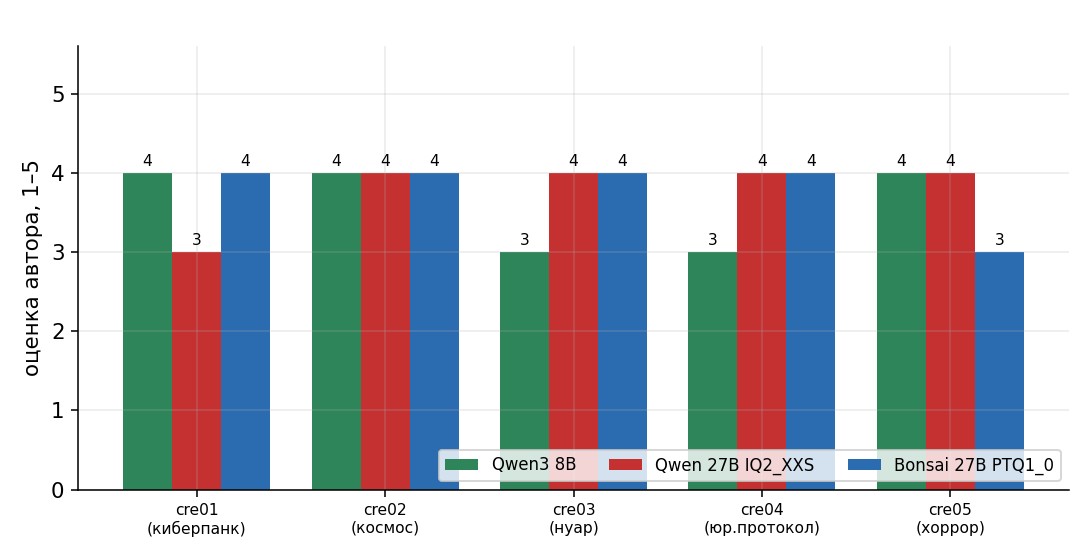
На испытания 8B потратила 7,2 минуты, PTQ1_0 — 11,1 минуты, IQ2_XXS — 54,8 минуты.
Картинки обе модели читают одинаково
Еще Bonsai 2 умеет смотреть на картинки. Для этого к ней прилагается отдельный визуальный модуль на 0,6 ГБ, и его я тоже погонял.
Картинок было 11, и простых среди них почти не было: русская поговорка, строчка на шести языках, английский текст на зашумленном фоне, надписи под углом, мелкий шрифт, вывеска с категорией и рукописный текст на доске. Прогонял все через llama-mtmd-cli, это утилита llama.cpp для мультимодальных моделей.
Распознала модель все. На картинку уходило около 35 секунд, хотя само изображение она разбирала секунды за две, а остальное время рассуждала. В память тоже уперлись: картинка 4:3 при контексте 8192 токена в 8 ГБ не влезла, и вылетела CUDA OOM. Пришлось урезать контекст до 4096.
Для сравнения я взял мультимодальную Qwen3-VL 8B в Q4_K_M. Она тоже прочитала все 11 картинок, а на обработку каждой тратила от 2,2 до 3,3 секунды.
Разница проявилась в работе с памятью. Визуальный модуль (файл mmproj) у Qwen3-VL весит 1,16 ГБ, и на 8-гигабайтной карте балансировал на грани фола. В нескольких прогонах он забивал видеопамять целиком, обработка уходила на процессор, и кодирование одной картинки растягивалось до 3–5 минут. Модуль Bonsai на 0,6 ГБ проходил этот этап стабильно, без таких задержек.
Размер все-таки не главное
Главное обещание PrismML выполнено. Модель класса 27B работает на майнинговой карте с 8 ГБ и выдает 17 t/s, втрое больше порога в 5 t/s, после которого с ней уже можно спокойно переписываться. На телефоне она тоже запускается, но ответа длиной в пару абзацев там придется ждать больше часа.
А вот обыграть обычную 8B большая 27B не смогла. На коротких заданиях 8B опередила ее на балл из сорока, в сложном наборе — на один ответ, 8 из 10 против 7. С картинками ничья: Qwen3-VL 8B тоже прочитала все 11. Зато 8B почти вдвое быстрее, 31,9 t/s против 16,8, и ставится в обычную Ollama без всяких патчей. Для чата на русском, простой арифметики, кода и JSON ее вполне хватает.
Но кое в чем Bonsai все-таки лучше. Ее визуальный модуль вдвое легче и на 8 ГБ ни разу не уходил на процессор, а Qwen3-VL так застревала на 3–5 минут. В задачах с подвохом Bonsai ошибалась реже, чем 8B, и ни разу не попалась на загадку про овец. Правда, задач с подвохом было всего пять, а на таком числе одна случайная ошибка меняет всю картину.
Сама идея троичного сжатия работает. 27B и впрямь влезла в 8 ГБ, а промпт Bonsai читает вшестеро быстрее, чем IQ2_XXS с файлом того же размера. Вот пользоваться этим пока неудобно. Новые троичные файлы стандартный llama.cpp даже не открывает. Старый Q2_0 открыть-то открывает, а модель потом несет чепуху, и никаких ошибок при этом не видно. Без форка PrismML тут не обойтись. Ollama пропатчить можно, только патч проживет до первого обновления. Поэтому на карте с 8 ГБ я бы пока остался на обычной 8B.
Непроверенными остались карты на 12–16 ГБ и флагманские смартфоны, где веса и кэш контекста помещаются в память целиком. Возможно, там 27B покажет себя лучше, но такого железа на моем стенде не было.
Автор: SkaldByte
Источник [19]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38612
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] выпустила: https://prismml.com/news/bonsai-27b
[3] Bonsai 2 27B: https://prismml.com/news/bonsai-2-27b
[4] на Hugging Face: https://huggingface.co/collections/prism-ml/bonsai-27b
[5] Внимание: http://www.braintools.ru/article/7595
[6] llama.cpp: https://github.com/ggml-org/llama.cpp
[7] форк PrismML: https://github.com/PrismML-Eng/llama.cpp
[8] ошибку: http://www.braintools.ru/article/4192
[9] приняли в официальный llama.cpp: https://docs.prismml.com/run/llamacpp
[10] по-прежнему работают только в форке: https://docs.prismml.com/download/formats
[11] странице модели на Hugging Face: https://huggingface.co/prism-ml/Ternary-Bonsai-2-27B-gguf
[12] подавала: https://prismml.com/news/prismml-releases-bonsai-27b
[13] libomp.so: http://libomp.so
[14] инструкции из репозитория форка: https://github.com/PrismML-Eng/llama.cpp/blob/prism/docs/android.md
[15] опыту: http://www.braintools.ru/article/6952
[16] математике: http://www.braintools.ru/article/7620
[17] логике: http://www.braintools.ru/article/7640
[18] вкус: http://www.braintools.ru/article/6291
[19] Источник: https://habr.com/ru/companies/ru_mts/articles/1107236/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1107236
Нажмите здесь для печати.