Корпоративная база знаний на базе ИИ
Корпоративная база знаний на базе ИИ отвечает сотрудникам на вопросы по внутренним документам компании и показывает, откуда взят ответ. Строится она по схеме RAG — поиск нужных фрагментов плюс языковая модель. Это руководство для архитектора: из чего состоит стенд и где его разместить, сколько ресурсов нужно каждой модели, как выбрать хранилище и посчитать среду, что проверить до запуска и где обычно совершаются ошибки [1].
Зачем компании база знаний с ИИ
Сотрудник задаёт вопрос обычными словами и за несколько секунд получает ответ со ссылкой на документ, из которого он взят. Ему не нужно искать нужную папку, открывать десяток файлов и вспоминать [2], как назывался регламент.
Типовые вопросы, которые закрывает такая база:
· Персонал и внутренние правила: «как оформить отпуск за свой счёт», «кто согласует командировку».
· Продажи и пресейл: условия услуг, SLA, ограничения продукта, ответы на типовые вопросы заказчика.
· Поддержка и эксплуатация: инструкции, известные ошибки и обходные пути, история похожих обращений.
· Юристы и закупки: что говорит договор о сроках, штрафах и порядке расторжения.
· Инженеры: проектная и техническая документация, стандарты, требования.
Чем это отличается от обычного поиска. Поиск по словам выдаёт список файлов, где встретились слова запроса. Если в документе написано «отпуск без сохранения заработной платы», а спросили «отпуск за свой счёт», он промахнётся. База знаний на ИИ ищет по смыслу, собирает ответ из нескольких документов и показывает источники.
Чем это отличается от «просто чат-бота». Языковая модель не знает ваших документов. Дообучать её на них дорого, а после каждого изменения регламента пришлось бы дообучать снова. Поэтому модель не учат, а на каждый вопрос показывают ей нужные фрагменты документов — этот подход и называется RAG (Retrieval-Augmented Generation, «ответ с опорой на найденное»). Обновили документ — обновился ответ.
Как это работает
Работа делится на две части. Загрузка идёт заранее: документы превращают в текст, режут на фрагменты и для каждого считают вектор. Ответ собирается на каждый вопрос: система находит фрагменты, ближайшие к вопросу, отбирает лучшие и отдаёт их языковой модели.
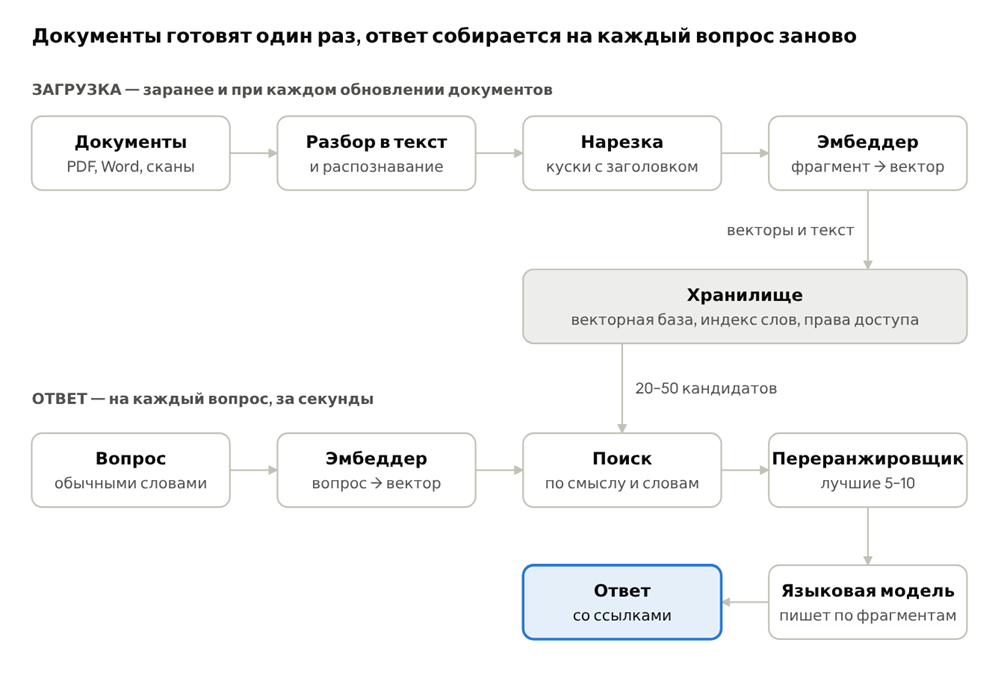
Вектор — это «отпечаток смысла» текста: фразы «отпуск за свой счёт» и «отпуск без сохранения зарплаты» получат близкие векторы, хотя общих слов у них почти нет. Поэтому поиск по векторам находит нужное, даже когда сотрудник спрашивает не теми словами, что в документе. А точные номера и коды лучше ловит поиск по словам, поэтому в хорошей системе работают оба.
Из чего собирается
База знаний — это цепочка из семи звеньев. Качество ответа определяет самое слабое из них, и чаще всего это не языковая модель, а поиск.
|
Звено |
Что делает |
Типичные решения |
Где ошибаются |
|
Разбор документов |
Превращает PDF, Word, таблицы и сканы в чистый текст со структурой |
Docling, Apache Tika, Unstructured; для сканов — распознавание текста (OCR) |
Таблицы рассыпаются в кашу; русские сканы читаются латиницей; колонтитулы попадают в каждый фрагмент |
|
Нарезка на фрагменты |
Делит текст на куски, которые будут находиться и показываться модели |
По заголовкам и абзацам, с небольшим перекрытием; к фрагменту дописывают название документа и раздела |
Кусок без названия документа: «таблица компенсаций» из двух разных SLA выглядит одинаково |
|
Эмбеддер (модель векторов) |
Превращает фрагмент и вопрос в вектор — набор из сотен или тысяч чисел; близкие по смыслу тексты получают близкие векторы |
Qwen3-Embedding, BGE-M3, multilingual-e5, GigaEmbeddings, Gemini Embedding |
Выбирают по мировому рейтингу, не проверив на своих русских документах; не учитывают, что размер вектора множит объём хранилища |
|
Векторная база |
Хранит векторы и за миллисекунды находит ближайшие к вектору вопроса |
pgvector (PostgreSQL), Qdrant, Milvus, Weaviate, OpenSearch |
Нет фильтра по правам доступа; не посчитана память [3] под индекс |
|
Поиск по словам |
Находит точные совпадения: номера договоров, артикулы, коды ошибок |
BM25 в OpenSearch и Elasticsearch, полнотекстовый поиск PostgreSQL, встроенный смешанный поиск в Weaviate и Qdrant |
Оценки по словам и по смыслу складывают без приведения к одной шкале, и один вид поиска забивает другой |
|
Переранжировщик |
Берёт 20–50 найденных фрагментов и точнее расставляет их по полезности для вопроса |
Qwen3-Reranker, bge-reranker, Voyage rerank, Cohere Rerank |
Вызывают без нужного шаблона запроса — и порядок становится почти случайным |
|
Языковая модель ответа |
Пишет ответ только по найденным фрагментам и ставит ссылки на источники |
Qwen, GigaChat, YandexGPT, зарубежные модели |
Модели не запрещают отвечать «из головы», когда нужного фрагмента нет |
Сверху цепочки нужны ещё две вещи: права доступа (сотрудник видит в ответах только то, что может открыть сам) и набор контрольных вопросов с известными ответами, на котором проверяют каждое изменение.
Как выглядит стенд
Из всех частей стенда GPU нужна только четырём: разбору сканов, эмбеддеру, переранжировщику и языковой модели. Всё остальное — векторная база, индекс слов, хранилище текстов и прав, портал и защита — работает на обычных серверах. Это и открывает выбор, что держать у себя, а что брать сервисом.
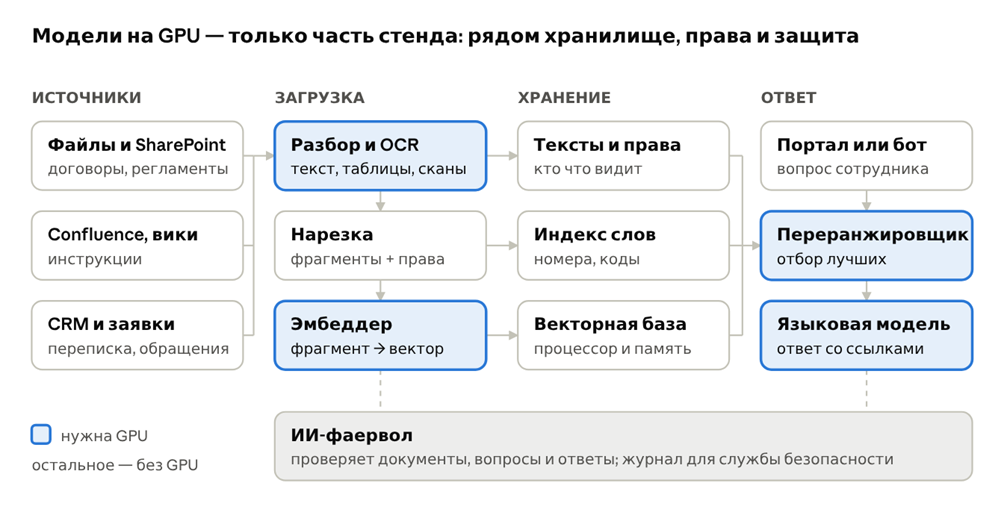
Стенд не обязан стоять целиком в одном месте. Чаще всего встречаются три схемы, и они совместимы: пилот можно запустить на моделях по API, а промышленную базу перенести на свои GPU.
|
Что |
Модели по API |
Всё в облаке ITGLOBAL.COM [4] |
Всё у вас: выделенные GPU |
|
Эмбеддер, переранжировщик, языковая модель, OCR |
AIaaS [5]: |
AIaaS или Private AI Cloud — выделенные GPU-серверы в нашем ЦОД |
Выделенные GPU [6]: сервер с картами на вашей площадке, поставка и обслуживание — ITGLOBAL.COM |
|
Векторная база, индекс, тексты |
У вас или в нашем облаке |
Облако ITGLOBAL.COM [7]: виртуальные машины или Managed Kubernetes |
У вас |
|
Портал, бот, загрузка документов |
У вас |
Облако ITGLOBAL.COM [4] |
У вас |
|
Что уходит за периметр |
Фрагменты и вопросы — в модели по защищённому каналу |
Данные целиком в облаке в РФ |
Ничего |
|
Кому подходит |
Быстрый старт и пилот, своих GPU нет, нагрузка неравномерная |
Не хотите держать свою инфраструктуру, данные должны оставаться в РФ |
Данные не покидают контур, есть требования регулятора или большая постоянная нагрузка |
|
Как платите |
За фактическое потребление (ИИ-кредиты) |
Потребление моделей + ресурсы облака |
Серверы и обслуживание по договору, независимо от числа вопросов |
Первичная загрузка большого архива — отдельный случай: даже если база будет работать на ваших GPU, саму загрузку выгодно прогнать через AIaaS или временно взятые в облаке карты, а не покупать железо под разовый пик.
Сколько ресурсов нужно каждому компоненту
Размер весов — по карточкам моделей на Hugging Face. Столбец «Как у нас» — как эти модели работают в AIaaS сейчас. Память карты нужна не только под веса: языковой модели ещё нужна память под диалоги, и чем их больше одновременно, тем больше памяти.
|
Компонент |
Модель |
Веса |
Как у нас |
Без GPU? |
|
Эмбеддер |
Qwen3-Embedding-4B, 4 млрд параметров |
8 ГБ |
На сервере с двумя NVIDIA L40S по 46 ГБ вместе с переранжировщиком, OCR, разбором документов и речевыми сервисами; 20–22 тыс. токенов в секунду |
Только для малых объёмов: на процессоре многократно медленнее |
|
Переранжировщик |
Qwen3-Reranker-4B |
8 ГБ |
Там же; 20 фрагментов за 0,68 с |
Нет: задержка ответа вырастет до секунд |
|
Разбор документов и OCR |
Docling, OCR |
сотни МБ |
Там же |
Docling — да, медленнее; сканы лучше на GPU |
|
Языковая модель |
Qwen 3.8, 27 млрд параметров, сжатие FP8 |
около 27 ГБ |
Одна NVIDIA RTX PRO 6000 Blackwell 96 ГБ: остальная память — под диалоги, около 13 одновременных диалогов с полным окном 128 тыс. токенов |
Нет |
|
Языковая модель |
Gemma 4, 26 млрд параметров (активны 4), FP8 |
около 26 ГБ |
Около 38 ГБ на NVIDIA A800 80 ГБ вместе с памятью под диалоги |
Нет |
|
Векторная база |
pgvector, Qdrant и др. |
— |
— |
Да: процессор и оперативная память по расчёту ниже |
|
Портал, загрузка, ИИ-фаервол |
— |
— |
— |
Да: обычные виртуальные машины |
Стенд у себя: с чего начать. Это ориентир по нашему опыту [8], а не готовая спецификация: точная конфигурация считается по числу одновременных пользователей и объёму базы.
· Пилот — один GPU-сервер с картой на 80–96 ГБ: на ней помещаются языковая модель уровня Qwen 3.8, эмбеддер и переранжировщик (около 43 ГБ весов), но запас под одновременные диалоги будет меньше. Плюс обычная виртуальная машина под векторную базу и портал.
· Промышленная база — как у нас: языковая модель на отдельной карте или картах, сервисы векторов и разбора — на карте с памятью от 40 ГБ. Второй такой же сервер — в резерв, чтобы поломка одной карты не останавливала базу знаний. Векторная база — на серверах без GPU с памятью по расчёту из раздела ниже.
· Большая языковая модель уровня GLM-5 целиком требует уже восьми карт уровня H200. Для базы знаний это редко оправдано: ответ по найденным фрагментам хорошо пишут и модели на 20–30 млрд параметров, а большую модель дешевле брать по API.
Какую векторную базу выбрать
Выбор решают три вещи: число фрагментов, как устроены права доступа и что уже есть в инфраструктуре клиента. Все пять баз ниже работают на серверах клиента или в нашем облаке, без зарубежных сервисов.
|
База |
Когда выбирать |
Сильные стороны |
Ограничения |
Лицензия |
|
pgvector [9] (PostgreSQL) |
У клиента уже есть PostgreSQL, фрагментов до десятков миллионов |
Права доступа и метаданные — обычным SQL рядом с данными; знакомая эксплуатация и резервное копирование |
Индекс строится по векторам до 2000 чисел (в половинной точности — до 4000); фильтр по правам срабатывает после поиска; смешанный поиск собирают вручную; растёт в основном вверх, для больших объёмов — расширение pgvectorscale |
PostgreSQL License |
|
Qdrant [10] |
Отдельная база под RAG на миллионы — сотни миллионов фрагментов со сложными правами |
Фильтр по правам прямо во время поиска; сжатие векторов в 4–32 раза; полные векторы на диске, сжатые в памяти; смешанный поиск встроен; кластер в открытой версии |
В самостоятельной установке нет перераспределения данных по узлам — число частей коллекции закладывают сразу; индексы по полям прав создают до загрузки |
Apache 2.0 |
|
Milvus [11] |
Сотни миллионов — миллиарды фрагментов, есть команда эксплуатации |
Индексы на диске (DiskANN) и на GPU; поиск по словам с русской морфологией встроен; разделение на миллионы арендаторов |
Тяжёлая эксплуатация: Kubernetes, etcd, объектное хранилище, журнал записи; для малых объёмов избыточен |
Apache 2.0 |
|
Weaviate [12] |
Нужен смешанный поиск «из коробки» и богатая схема данных |
Слова и векторы в одном запросе с весом; встроенное разделение по арендаторам |
Сжатие по умолчанию выключено; русская морфология в поиске по словам не заявлена; часть функций — по коммерческой лицензии |
BSD-3 + коммерческие модули |
|
OpenSearch [13] |
У клиента уже есть полнотекстовый поиск на OpenSearch или Elasticsearch |
Сильный поиск по словам, смешанный поиск встроен, права на уровне документа, дисковый режим со сжатием в 32 раза |
Для одного векторного поиска тяжеловат; у Elasticsearch часть функций платная |
OpenSearch — Apache 2.0 |
Ориентир по числу фрагментов (наша рекомендация, а не жёсткая граница):
· до 10 млн — все пять справятся на одном сервере; если есть PostgreSQL, проще всего pgvector;
· 10–200 млн — Qdrant или OpenSearch со сжатием векторов, несколько узлов;
· сотни миллионов и больше — Milvus или кластер Qdrant с индексами на диске.
Две ловушки, которые всплывают в каждом проекте.
1. Размер вектора не проходит в индекс. У сильных современных эмбеддеров вектор длинный: у Qwen3-Embedding-4B — 2560 чисел. pgvector такой вектор хранит, но индекс по нему не построит. Выходов два: хранить в половинной точности (на замерах полнота поиска почти не меняется, индекс вдвое меньше) или попросить модель отдать укороченный вектор, например 1024. Остальные четыре базы вектор из 2560 чисел индексируют напрямую.
2. Права доступа ломают быстрый поиск. Если сотруднику доступна малая доля базы, а фильтр срабатывает после поиска, в ответ приходит пустота. Поэтому схему прав и способ фильтрации проектируют вместе с выбором базы, а не после.
Ещё один приём для больших объёмов: тексты фрагментов хранить отдельно, а в векторной базе держать только вектор, номер и короткие поля для фильтрации по правам.
Как посчитать среду под свой объём
Размер среды определяет не объём файлов, а число фрагментов текста. Из него следуют память под векторы, диск, время первичной загрузки и выбор векторной базы. Ниже — расчёт по шагам; коэффициенты в нём условные и уточняются на аудите на выборке документов клиента.
Шаг 1. Сколько в файлах настоящего текста
Большая часть объёма корпоративных файлов — картинки, шрифты, разметка, архивы, видео и копии одних и тех же документов. В базу знаний попадает только извлечённый текст без повторов.
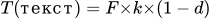
· F — объём файлов, которые решили подключить;
· k — доля текста в файлах. У каждой компании своя: договоры в Word дают много текста, презентации и чертежи — мало. В примере ниже взято 5%;
· d — доля повторов, старых версий и мусора. В примере — 30%.
Как узнать настоящие k и d: прогнать через разбор случайную выборку в 1–2% файлов из каждого источника и измерить. Расчёт «на глаз» здесь ошибается в разы.
Шаг 2. Из текста — в токены и фрагменты
Русский текст в кодировке UTF-8 занимает около 1,9 байта на знак. По нашему замеру на деловых документах на один токен эмбеддера Qwen3 приходится 2,8 знака. Отсюда на токен — примерно 5,4 байта текста.
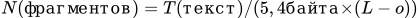
L — длина фрагмента в токенах, o — перекрытие соседних фрагментов. В примере L = 500 и перекрытие 15% (o = 75) — такое перекрытие лучше всего показало себя в замере NVIDIA; на каждый фрагмент приходится 425 новых токенов. Microsoft для старта предлагает 512 токенов с перекрытием 25%.
Шаг 3. Память под векторы
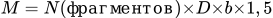
· D — размерность вектора. У Qwen3-Embedding-4B — до 2560 чисел; модель умеет отдавать и укороченный вектор, например 1024;
· b — байт на число: 4 в обычном виде, 1 при сжатии до целых (квантование int8), 1/8 при двоичном сжатии;
· 1,5 — запас на поисковый индекс и служебные данные (грубая оценка Qdrant; точные формулы у каждой базы свои и приведены в их документации).
На диск ещё ложатся сами тексты фрагментов и полные векторы для пересчёта — примерно ещё один объём текста плюс несжатые векторы.
Шаг 4. Время первичной загрузки
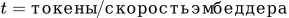
Наш замер 9 октября 2026 года: Qwen3-Embedding-4B на общей боевой карте AIaaS обрабатывает 20–22 тыс. токенов в секунду: это около 60 тыс. русских знаков в секунду, или около 72 млн токенов в час. Выделенные карты работают параллельно, и время делится примерно на их число.
Расчёт по объёмам
Условия примера: текста 5% от объёма файлов, повторов 30%, фрагмент 500 токенов с перекрытием 15%, одна карта со скоростью из замера.
|
Файлов |
Текста без повторов |
Токенов |
Фрагментов |
Память: 2560 чисел × 4 байта |
Память: 1024 числа × 1 байт |
Загрузка на одной карте |
|
100 ГБ |
3,5 ГБ |
0,65 млрд |
1,5 млн |
23 ГБ |
2,3 ГБ |
9 ч |
|
1 ТБ |
35 ГБ |
6,5 млрд |
15 млн |
230 ГБ |
23 ГБ |
4 дня |
|
10 ТБ |
350 ГБ |
65 млрд |
150 млн |
2,3 ТБ |
230 ГБ |
38 дней |
|
30 ТБ |
1 ТБ |
195 млрд |
460 млн |
7 ТБ |
700 ГБ |
112 дней |
Из таблицы следуют три вывода:
1. До единиц терабайт файлов база помещается на одном сервере, а загрузка занимает часы или дни даже на общей карте.
2. От десятков терабайт без сжатия и укорочения векторов не обойтись: сжатие даёт выигрыш в 10 раз по памяти. Первичная загрузка требует нескольких выделенных карт и кластерной векторной базы.
3. Главный рычаг — не железо, а отбор. Вдвое меньше подключённых файлов — вдвое меньше всего в таблице. Архивы и документы, по которым никто не задаст вопрос, стоит не загружать вовсе или оставить только поиск по словам.
Сколько нужно на ответы
Первичная загрузка — разовая работа, а ответы идут каждый день. На один вопрос уходит (наш замер, одиночный запрос):
|
Шаг |
Время |
Предел на одной общей карте |
|
Вектор вопроса |
0,19 с |
не ограничивает |
|
Поиск в векторной базе |
десятки миллисекунд |
зависит от сервера базы |
|
Переранжирование 20 фрагментов |
0,68 с |
около 2 вопросов в секунду, то есть ~7 тыс. в час |
|
Ответ языковой модели |
основная часть ожидания |
зависит от модели и длины ответа |
Поиск и переранжирование занимают меньше секунды. Среду под ответы считают от числа одновременных пользователей и выбранной языковой модели, а не от размера базы.
Аудит до запуска
Самая дорогая ошибка — начать с выбора модели, а не с данных. По опросу Gartner, 63% организаций не имеют нужных для ИИ практик работы с данными или не уверены в них. Прогноз там же: до конца 2026 года будет брошено 60% ИИ-проектов, для которых данные не подготовлены. Ниже — что проверить до первой строки кода.
|
Что проверить |
Почему это важно |
Что получить на выходе |
|
Источники и владельцы |
Без владельца никто не решает, какая версия главная и что удалять. Отсюда устаревшие и противоречивые ответы |
Список источников с ответственным и решением по каждому: загружать, загружать с маскированием, не загружать |
|
Повторы и версии |
В типичной корпоративной базе, по оценке практиков, около 30% устаревших версий и около 20% повторов. Они раздувают среду и сбивают ответы |
Доля повторов d для расчёта; правило «отменённая версия в поиск не попадает» |
|
Форматы и качество |
Сканы, таблицы, презентации и чертежи разбираются по-разному; скан ниже 300 точек на дюйм читается с ошибками |
Доля текста k по выборке 1–2% файлов; список форматов, требующих особого разбора |
|
Права доступа |
База знаний не должна показывать сотруднику то, что он не может открыть в источнике. Права меняются, и индекс отстаёт до следующей синхронизации |
Откуда берутся права (каталог пользователей, права SharePoint и файловых ресурсов), как часто синхронизировать, как метка прав доходит до каждого фрагмента |
|
Персональные данные и тайна |
152-ФЗ, коммерческая тайна, договоры с клиентами. От этого зависит, какие модели можно использовать и где должна стоять среда |
Классификация источников; решение, можно ли отправлять текст во внешние модели |
|
Поток изменений |
Первичная загрузка и ежедневные правки — разные задачи с разной нагрузкой |
Объём новых и изменённых документов в день; допустимая задержка между правкой и появлением в ответах |
|
Инфраструктура и размещение |
Где разрешено обрабатывать данные, есть ли GPU, хватит ли памяти и канала до файловых хранилищ |
Расчёт среды по методике выше и выбор размещения: облако, выделенные серверы или свой контур |
|
Критерии успеха |
Без набора контрольных вопросов невозможно понять, стало ли лучше после любой правки |
Минимум 30, лучше 100–200 настоящих вопросов сотрудников с эталонными ответами, включая вопросы, на которые в базе ответа нет |
Итог аудита — не отчёт, а четыре решения: что загружаем, где размещаем, сколько ресурсов нужно и по каким вопросам проверяем качество. На практике после аудита объём для загрузки часто сокращается в разы: в одном из описанных на Хабре проектов из 12 тыс. документов годными остались около 3,8 тыс.
Путь от аудита до работающей базы
Базу знаний не запускают сразу на весь объём. Сначала — узкий пилот с измеримой целью, и только после него — расширение.
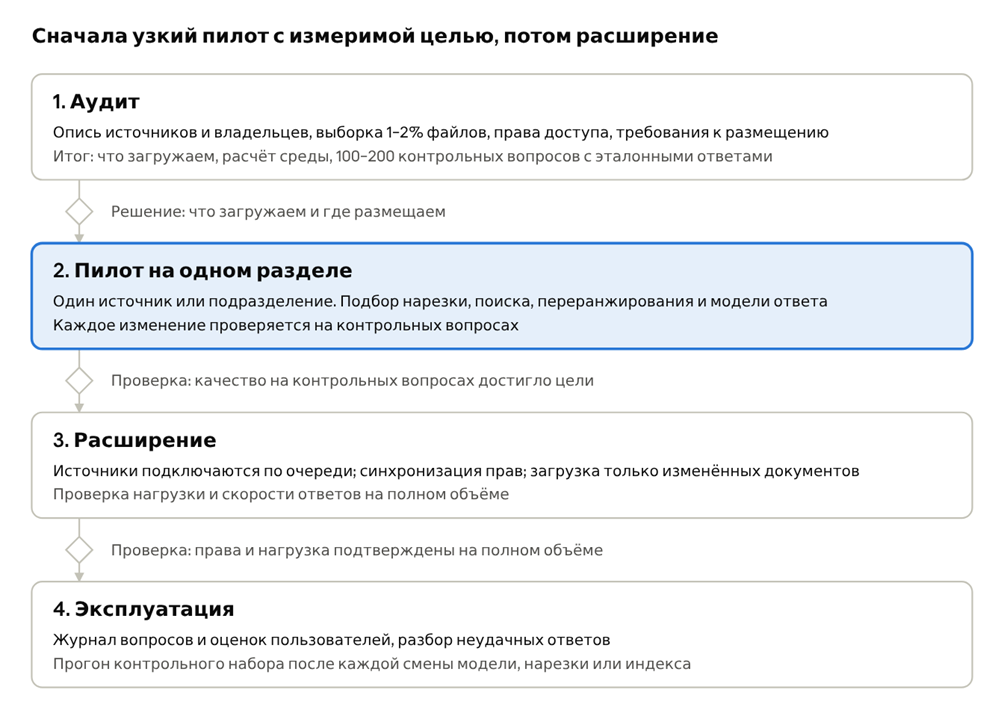
Ошибка в нарезке или выборе модели, найденная на пилоте, стоит часов пересчёта. Та же ошибка на десятках терабайт обойдётся неделями повторной загрузки (см. расчёт выше). Смена эмбеддера или способа нарезки всегда означает полный пересчёт всех векторов, поэтому эти решения принимают на пилоте и дальше не меняют без нужды. При обновлениях новую версию индекса собирают целиком рядом со старой, проверяют на контрольных вопросах и только потом переключают — иначе оборвавшаяся переиндексация оставит смесь старых и новых фрагментов.
Качество ответов и выдумки
RAG снижает число выдуманных ответов (галлюцинаций), но не убирает их. Исследование Стэнфорда показало: коммерческие юридические системы на RAG ошибаются в 17–33% случаев — реже, чем модель без поиска, но далеко не ноль. Поэтому качество нужно закладывать в проект и мерить, а не надеяться на сильную модель.
Почему база знаний ошибается
|
Что происходит |
Как выглядит для сотрудника |
Что помогает |
|
Ответа в базе нет, а модель всё равно отвечает |
Уверенный ответ «из головы» |
Разрешить и потребовать ответ «в документах этого нет»; запретить отвечать по собственным знаниям модели |
|
Нужный документ есть, но поиск его не нашёл |
Ответ по соседнему, похожему документу |
Смешанный поиск по словам и смыслу, переранжировщик, название документа и раздела в каждом фрагменте |
|
Фрагмент найден, но модель его не использовала |
Неполный или слишком общий ответ |
Отдавать модели 5–10 лучших фрагментов, а не 50: модели хуже всего читают середину длинного контекста (эффект «lost in the middle») |
|
В базе старая и новая версии документа |
Ответ по отменённому регламенту или смесь двух |
Дата, версия и статус в метаданных; отменённые версии исключать из поиска |
|
Модель добавила подробности, которых нет в источнике |
Правдоподобные, но неверные цифры и сроки |
Ссылка на источник к каждому утверждению; утверждение без ссылки — убирать |
Наибольший выигрыш даёт поиск, а не смена языковой модели. Замер Anthropic: если дописывать к каждому фрагменту краткий контекст документа и сочетать поиск по словам, по смыслу и переранжирование, доля промахов поиска падает на 67% (с 5,7% до 1,9%). И ещё один вывод оттуда же: если база меньше примерно 500 страниц, RAG не нужен — её можно целиком положить в запрос к модели.
Как мерить качество
1. Собрать набор контрольных вопросов. Databricks советует не меньше 30, а лучше 100–200. Вопросы — настоящие, из переписки и обращений сотрудников; к каждому — эталонный ответ и документ. Обязательно добавить вопросы, на которые в базе ответа нет: правильная реакция [14] на них — отказ.
2. Мерить поиск отдельно от ответа. Поиск: есть ли нужный фрагмент среди первых найденных. Ответ: опирается ли он только на найденное и отвечает ли на вопрос. Так сразу видно, какое звено чинить. Готовые инструменты — Ragas, TruLens, DeepEval.
3. Проверять моделью-судьёй и выборочно людьми. Сильная модель в роли судьи согласна с людьми более чем в 80% случаев, но любит длинные ответы. Эксперт заказчика регулярно пересматривает набор и спорные оценки.
4. Прогонять набор после каждого изменения: новой модели, другой нарезки, переиндексации. Следить не только за средним, но и за вопросами, которые раньше работали.
Наш опыт
ITGLOBAL.COM [4] эксплуатирует несколько внутренних баз знаний на RAG и мерит их на настоящих вопросах сотрудников. Три вывода, которые мы сделали для себя:
· Ошибка в сборке поиска стоит дороже выбора модели. В одной из баз оценки поиска по словам и по смыслу складывались без приведения к одной шкале, а переранжировщик вызывался без нужного шаблона. Первый найденный фрагмент отвечал на вопрос примерно в 5% случаев. После исправления — примерно в 40%, а среди первых трёх ответ находится более чем в половине случаев. Смена эмбеддера на том же наборе меняла итог на единицы процентов.
· Смешанный поиск выигрывает у поиска по словам. В другой базе поиск только по словам находил ответ среди первых трёх фрагментов в 52–55% случаев, а поиск по смыслу и словам с переранжированием — в 90–93%. При этом точные коды и артикулы надёжнее ловит именно поиск по словам, поэтому он остаётся в схеме.
· Эмбеддер нужно проверять на своих документах. На наших русских документах по услугам Qwen3-Embedding-4B находил нужное наравне с лучшими проверенными моделями, но ставил первым документ про чужую услугу в 2% случаев — против 11–13% у других. Для базы, где документы о разных продуктах похожи друг на друга, это главное свойство.
Безопасность
База знаний собирает в одном месте то, что раньше было разбросано по папкам с разными правами, и отвечает на вопросы любого сотрудника. Поэтому её защищают строже, чем исходные хранилища. В списке главных рисков для приложений на языковых моделях OWASP Top 10 за 2025 год под RAG выделен отдельный пункт — LLM08, слабые места векторных хранилищ.
|
Риск |
Как это происходит |
Что делать |
|
Утечка через права доступа |
Права в индексе отстают от источника; метка прав есть у документа, но не у его фрагментов; удалённый документ всё ещё находится |
Фильтр по правам при поиске и ещё раз перед ответом; метка на каждом фрагменте; регламент синхронизации прав и удаления |
|
Вредные указания внутри документов |
В файле спрятан текст для модели — например, белым по белому в резюме. Модель воспринимает его как указание. OWASP прямо пишет: RAG от этого не защищает |
Проверка документов на входе в базу; найденный текст помечать для модели как недоверенный; минимум прав у самого приложения |
|
Отравление базы |
В базу подкладывают тексты с нужным злоумышленнику «ответом». В исследовании PoisonedRAG пяти подброшенных текстов на один вопрос хватило для успеха атаки в 90% случаев |
Контроль, кто и какие источники может подключать; журнал всех изменений базы; владелец у каждого раздела |
|
Восстановление текста из векторов |
Вектор — не шифр: в исследовании 2023 года из векторов дословно восстановили 92% коротких текстов, включая имена из медицинских записей |
Хранить и защищать векторную базу так же, как сами документы: те же требования к размещению и доступу |
|
Персональные данные уходят наружу |
Если языковая модель внешняя, каждый найденный фрагмент вместе с вопросом уходит поставщику модели |
Локальные модели в РФ для чувствительных разделов; маскирование персональных данных до загрузки или не загружать такие разделы вовсе |
Российские команды, уже прошедшие внедрение, советуют одно и то же: подключать службу безопасности с первого дня, а не перед запуском.
Что даёт ITGLOBAL.COM
ITGLOBAL.COM [4] закрывает все звенья базы знаний: модели для разбора документов, поиска и ответа, инфраструктуру под векторную базу, защиту и внедрение. Можно взять всё вместе или только недостающие части.
|
Звено |
Что даём |
Наши цифры |
|
Разбор документов |
Сервисы AIaaS [5] на нашем железе: Docling — Word и PDF в текст с таблицами; распознавание русских сканов |
Договор Word на 118 КБ — за 2,2 с; страница скана — за 10,6 с |
|
Эмбеддер |
Qwen3-Embedding-4B на наших GPU через API AIaaS; на наших русских документах реже других путает темы. Есть и эмбеддеры Сбера и зарубежные |
Вектор вопроса — 0,19 с; загрузка — 20–22 тыс. токенов в секунду на общей карте; 2,5 ₽ за 1 млн токенов по странице цен на 06.10.2026 |
|
Переранжировщик |
Qwen3-Reranker-4B на наших GPU, пример вызова с нужным шаблоном — в нашей документации; также Qwen3-Reranker-8B и Voyage rerank |
20 фрагментов на вопрос — 0,68 с |
|
Языковая модель ответа |
Локальные Qwen 3.8 и Gemma 4 на наших GPU — для данных, которые нельзя отдавать наружу; российские GigaChat и YandexGPT; ведущие зарубежные модели — всё через один API и один договор |
Каталог и цены — на странице «Модели и поставщики» |
|
Инфраструктура под базу |
Облако ITGLOBAL.COM [15] под PostgreSQL с pgvector, Qdrant, OpenSearch или Milvus; Managed Kubernetes; развёртывание и сопровождение баз нашими инженерами |
Расчёт памяти и диска — по методике выше |
|
Выделенное железо |
Выделенные GPU — сервер с картами на вашей площадке с поставкой и обслуживанием; Private AI Cloud — выделенные GPU-серверы (в том числе NVIDIA RTX PRO 6000 96 ГБ и H200 141 ГБ) с платформой AInergy в нашем ЦОД — когда данные должны быть физически изолированы или нужна гарантированная скорость первичной загрузки |
Несколько выделенных карт делят время загрузки на их число |
|
Защита |
ИИ-фаервол ITGLOBAL.COM [16]: проверка документов на входе в базу (персональные данные, вредоносное содержимое, скрытые указания для модели), права доступа на выдаче, журнал для службы безопасности |
На испытательном наборе из 300 атак и 250 обычных запросов — 92% атак поймано, ни один обычный запрос не остановлен |
|
Внедрение |
Аудит данных, расчёт среды, пилот на контрольных вопросах, настройка поиска и прав, сопровождение |
Опыт собственных баз знаний — в разделе о качестве |
Вместо заключения
Если свести статью к пяти решениям, которые стоит принять до запуска:
-
Начинайте с данных, а не с модели. Аудит источников, версий и прав часто сокращает объём для загрузки в разы, а вместе с ним и всю среду.
-
Считайте среду по фрагментам, а не по терабайтам. От их числа зависят память под векторы, время загрузки и выбор векторной базы. Главный рычаг — не железо, а отбор документов.
-
Вкладывайтесь в поиск. Гибридный поиск с реранкером в наших базах находит ответ среди первых трёх фрагментов в 90–93% случаев против 52–55% у поиска только по словам. Смена языковой модели такого эффекта не даёт.
-
Фиксируйте эмбеддер и нарезку на пилоте. Их смена означает полный пересчёт всех векторов, а на десятках терабайт это недели работы.
-
Проектируйте права доступа и защиту с первого дня. База знаний собирает в одном месте то, что раньше было разнесено по папкам с разными правами.
Для ориентира по деньгам: первичная загрузка 1 ТБ файлов из примера выше — это около 6,5 млрд токенов. Через наш эмбеддер по цене 2,5 ₽ за 1 млн токенов она стоит около 16 тыс. ₽. Дорога не загрузка, а память под векторы и ответы языковой модели на каждый вопрос.
Все замеры в статье мы делали на своей инфраструктуре: эмбеддер, реранкер, разбор документов, Qwen и Gemma работают на собственных GPU в ЦОД [17]ITGLOBAL.COM в Москве. Доступ к моделям AIaaS [5] есть через площадки в России и Казахстане. Для данных, которые должны оставаться в РФ, всю цепочку от разбора документов до векторной базы можно собрать без зарубежных сервисов.
А на чём споткнулись вы, когда строили свою базу знаний: на разборе документов, правах доступа или качестве поиска? Расскажите в комментариях.
Автор: itglobalcom
Источник [18]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38646
URLs in this post:
[1] ошибки: http://www.braintools.ru/article/4192
[2] вспоминать: http://www.braintools.ru/article/3999
[3] память: http://www.braintools.ru/article/4140
[4] ITGLOBAL.COM: https://itglobal.com/ru-ru/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[5] AIaaS: https://itglobal.com/ru-ru/aiaas/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[6] Выделенные GPU: https://itglobal.com/ru-ru/services/virtual-infrastructure/arenda-vydelennyh-serverov-s-gpu/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[7] ITGLOBAL.COM: https://itglobal.com/ru-ru/services/virtual-infrastructure/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[8] опыту: http://www.braintools.ru/article/6952
[9] pgvector: https://github.com/pgvector/pgvector
[10] Qdrant: https://qdrant.tech/documentation/
[11] Milvus: https://milvus.io/docs
[12] Weaviate: https://docs.weaviate.io/
[13] OpenSearch: https://docs.opensearch.org/latest/vector-search/
[14] реакция: http://www.braintools.ru/article/1549
[15] ITGLOBAL.COM: https://itglobal.com/ru-ru/services/virtual-infrastructure/chastnoe-oblako-vmware/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[16] ITGLOBAL.COM: https://itglobal.com/ru-ru/services/platform-services/aiaas/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[17] ЦОД : https://itglobal.com/ru-ru/services/virtual-infrastructure/arenda-infrastruktury-s-gpu/?utm_source=habr&utm_medium=article&utm_campaign=rag_knowledge_base
[18] Источник: https://habr.com/ru/companies/itglobalcom/articles/1108414/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1108414
Нажмите здесь для печати.