Скидки, сделки и секреты: как я дообучал NER-модели для маскирования
Я дообучил GLiNER2.5 выделять коммерческие условия в свободном тексте: согласованные цены, скидки, графики оплаты и внутренние ограничения по сделкам. Это задача распознавания именованных сущностей, или NER: модель должна найти нужный фрагмент и определить его тип. Для эксперимента взял синтетические заметки и переписку из условной CRM, чтобы проверить, насколько обучение [1] под предметную область меняет поведение [2] готового распознавателя и как это сказывается на скорости и расходе памяти [3].
Начал с шести типов сущностей и сравнения полного дообучения с LoRA, DoRA, rsLoRA и QLoRA. Затем сохранил те же обучающие тексты, но заменил исходную разметку метками DeepSeek и обучил отдельную GLiNER. Чтобы посмотреть на другую архитектуру, добавил Qwen и Gemma с NER-головами, а после короткого теста проверил все распознаватели на длинных документах.
На коротком синтетическом тесте после полного дообучения доля целиком скрытых секретов выросла с 39,53% до 91,84%, а число ошибочно задетых публичных упоминаний снизилось с 368 до 8 из 575. Одновременно Exact F1, который учитывает совпадение типов и границ сущностей, вырос с 22,51% до 94,13%. Данные, конфигурации и пример запуска сохранены в репозитории материалов.
Пример предметной области
Задача здесь определяется контекстом коммерческого условия. Фразы “Скидка 12% действует для всех покупателей” и “Согласовали с клиентом скидку 12%, условия непубличные” содержат одно значение, но маскировать его нужно только во втором случае. Поэтому в корпус вошли заметки по сделкам, письма, итоги разговоров и условия закупок и продаж, где модель должна определить статус упоминания и вернуть его точные координаты в исходном тексте. Для этого примера выбрал шесть типов сущностей:
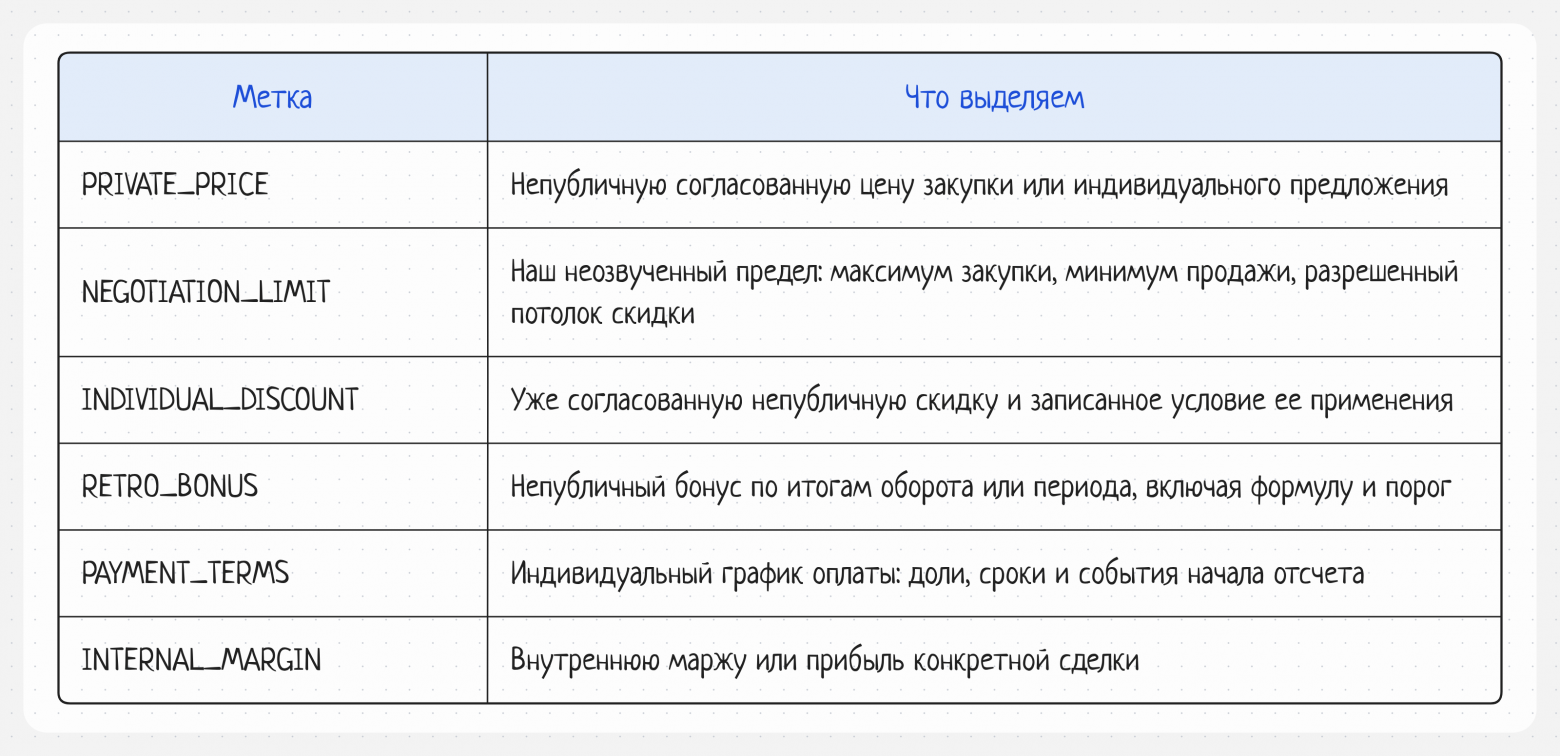
Типы и границы заданы инструкцией разметки. Здесь показана политика выбранного примера.
Помимо типа нужно заранее определить границы того, что считаем секретом. Если закрыта вся договоренность о бонусе, маскировать следует 3% от годового оборота при закупке от 500 единиц, а не только 3%; в графике оплаты должны попасть под маску обе доли и сроки. Эти правила я задал до генерации корпуса, чтобы одинаковые по смыслу условия получали согласованную разметку.
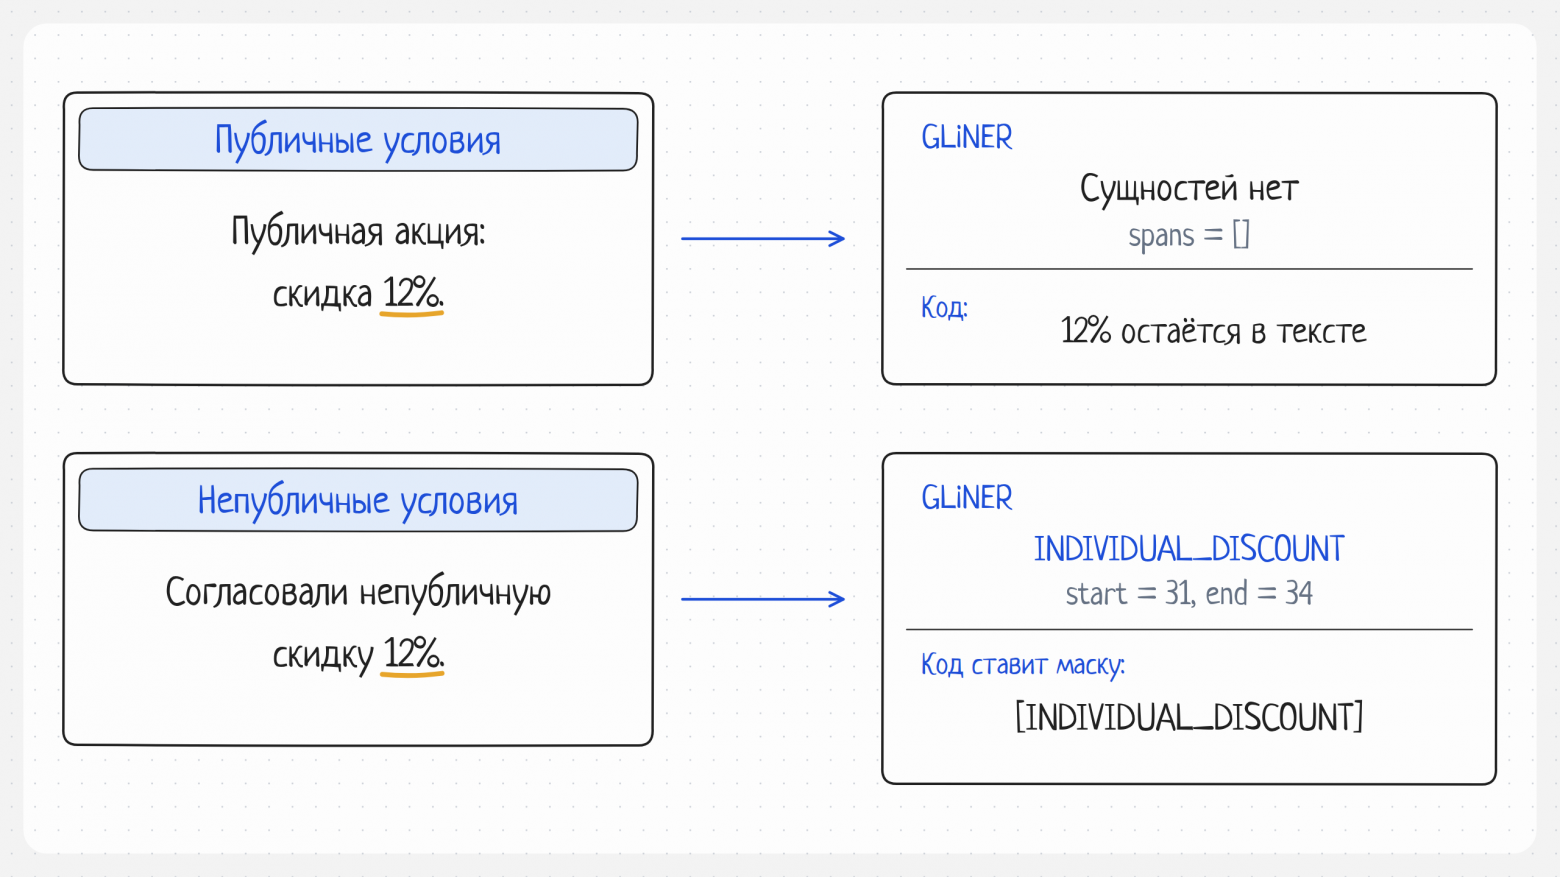
Упрощенная синтетическая пара для объяснения задачи. Модель находит тип и границы, а код заменяет выбранный фрагмент маской. Публичное значение должно сохраниться.
Для части такой задачи уже достаточно обычного кода: известные имена клиентов, названия компаний и значения полей можно находить словарным поиском, а устойчивые форматы вроде телефона – правилами и регулярными выражениями. В этом эксперименте меня интересовали условия, записанные свободным текстом, где нужно учитывать, к какой договоренности относится значение и какую часть фразы следует закрыть. Именно это поведение [4] я проверял до и после обучения.
Почему GLiNER
Для эксперимента выбрал fastino/gliner2.5-multi-v1 [5], модель примерно на 287 млн параметров с энкодером mDeBERTa и механизмом определения границ сущностей. Вместе с текстом ей передаются названия и описания искомых типов, поэтому одну и ту же схему из шести типов можно было использовать и при проверке исходной модели, и после дообучения. Чтобы сохранить исходную версию весов, закрепил ревизию cf5593a5d45e3bbf204b9df621b13b1c0cf25ee3.
Результат работы GLiNER – найденные фрагменты с типами и оценками уверенности, из которых код собирает общий формат ответа. Ниже условный пример этого формата, а не сохраненное предсказание модели:
text = "Согласовали непубличную скидку 12%."

{
    "start": 31,
    "end": 34,
    "label": "INDIVIDUAL_DISCOUNT",
    "text": "12%",
    "score": 0.97,
}
Координата start включается в фрагмент, а end указывает на первый символ после него. Это позволяет проверить найденную сущность через text[start:end] и убедиться, что координаты относятся к исходной подстроке. Когда границы проверены и пересечения разрешены, остается заменить фрагменты масками:
def mask(text, spans):
    # spans уже проверены и не пересекаются
    for span in sorted(spans, key=lambda s: s["start"], reverse=True):
        text = (
            text[:span["start"]]
            + f'[{span["label"]}]'
            + text[span["end"]:]
        )
    return text
Замены выполняются справа налево, поэтому длина уже подставленной маски не сдвигает координаты фрагментов, которые еще предстоит обработать. Таким образом, модель отвечает за поиск типа и границ, а JSON и итоговый текст с квадратными скобками формирует код.
Сначала политика разметки, потом 5 000 текстов
После выбора типов и границ подготовил 5 000 текстов для обучения, 500 для валидации и 1 000 для итоговой проверки. Обучающая часть, train, используется для обновления весов; на валидационной части, dev, выбираются сохраненная версия весов (checkpoint) и порог уверенности. В test попадают уже выбранные конфигурации, чтобы настройки и итоговая оценка опирались на разные части корпуса.
Все тексты вымышленные: исходные формулировки подготовлены агентом, а варианты собраны композиционным генератором из 336 компонентов. Поэтому корпус из 6 500 записей состоит из связанных семейств, а не из независимо написанных писем. В нем есть заметки, короткие диалоги и полуструктурированные записи, в которых меняются валюты, запись чисел и порядок коммерческих и технических фрагментов. Значения иногда повторяются, чтобы модель училась находить нужное упоминание, а не закрывать одинаковую строку во всем документе.
Четверть документов не содержит секретных сущностей; дополнительно в корпус включены контрастные пары, где одно и то же целевое значение бывает непубличным или опубликованным. Такие примеры нужны для проверки контекста: само наличие числа рядом со словом “цена” еще не определяет разметку. Семейства вариантов и исходные компоненты распределены между train/dev/test до сборки, после чего проверены точные и близкие межчастевые дубликаты, символьные границы и арифметика платежных формул. Это технические проверки генератора; независимой экспертной разметки в эксперименте не было.
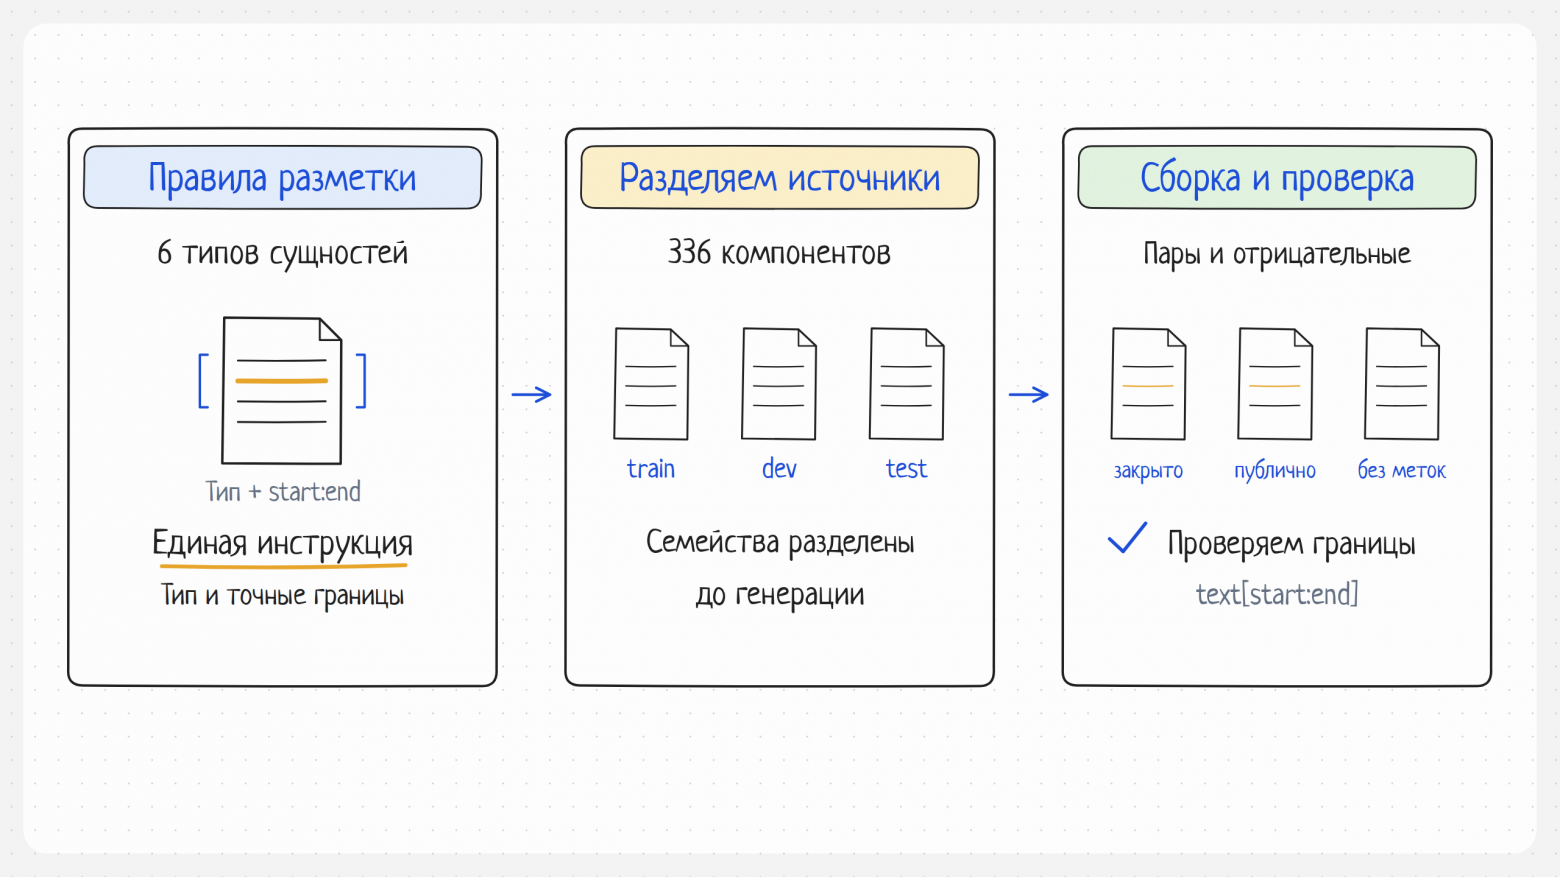
В нашем примере исходные компоненты и семейства разделены между частями до сборки вариантов. Контрастные пары и тексты без секретов дополняют положительные примеры; аудит проверяет соответствие границ исходному тексту.
Корпус, инструкция и читаемая выборка [6] сохранены вместе с генератором. Каждая запись содержит исходный текст и список spans; перед обучением она преобразуется в формат GLiNER с полями input, output.entities и entity_descriptions. Координаты start/end задаются для каждого вхождения, в том числе при повторении [7] одной подстроки. В следующем примере из синтетического train текст и координаты сохранены как в данных; опущены только служебные поля семейства и происхождения:
{
  "id": "train-family-0026-p1-private",
  "text": "Заметка CRM по позиции ST-6379-59.nВ непубличном протоколе расчетов по ST-6379-59 установлен график 40% авансом, оставшиеся 60% через 45 дней после приемки.nПроверьте комплектацию и наличие партии 175 единиц.",
  "spans": [
    {
      "start": 100,
      "end": 155,
      "text": "40% авансом, оставшиеся 60% через 45 дней после приемки",
      "label": "PAYMENT_TERMS"
    }
  ]
}
В этой записи размечен только график оплаты: код товара и количество находятся за его границами. Обучающий ответ задает эталонные тип и координаты, а поле score появляется уже в предсказании модели. При этом схема типов во всех вариантах GLiNER одинакова: шесть англоязычных названий и описаний для русских текстов. Она сохраняется и у отрицательных примеров, где списки сущностей пусты; при оценке модели передаются текст и схема, без эталонной разметки, номера семейства и признака private/public.
Как обучали GLiNER
Перед основным дообучением на RTX 3090 24 ГБ проверил, что модель проходит прямой и обратный проходы, помещается в память и корректно сохраняется и загружается. Этот короткий ресурсный пилот нужен был для проверки запуска; основное обучение начиналось с исходных весов GLiNER, без весов пилота.
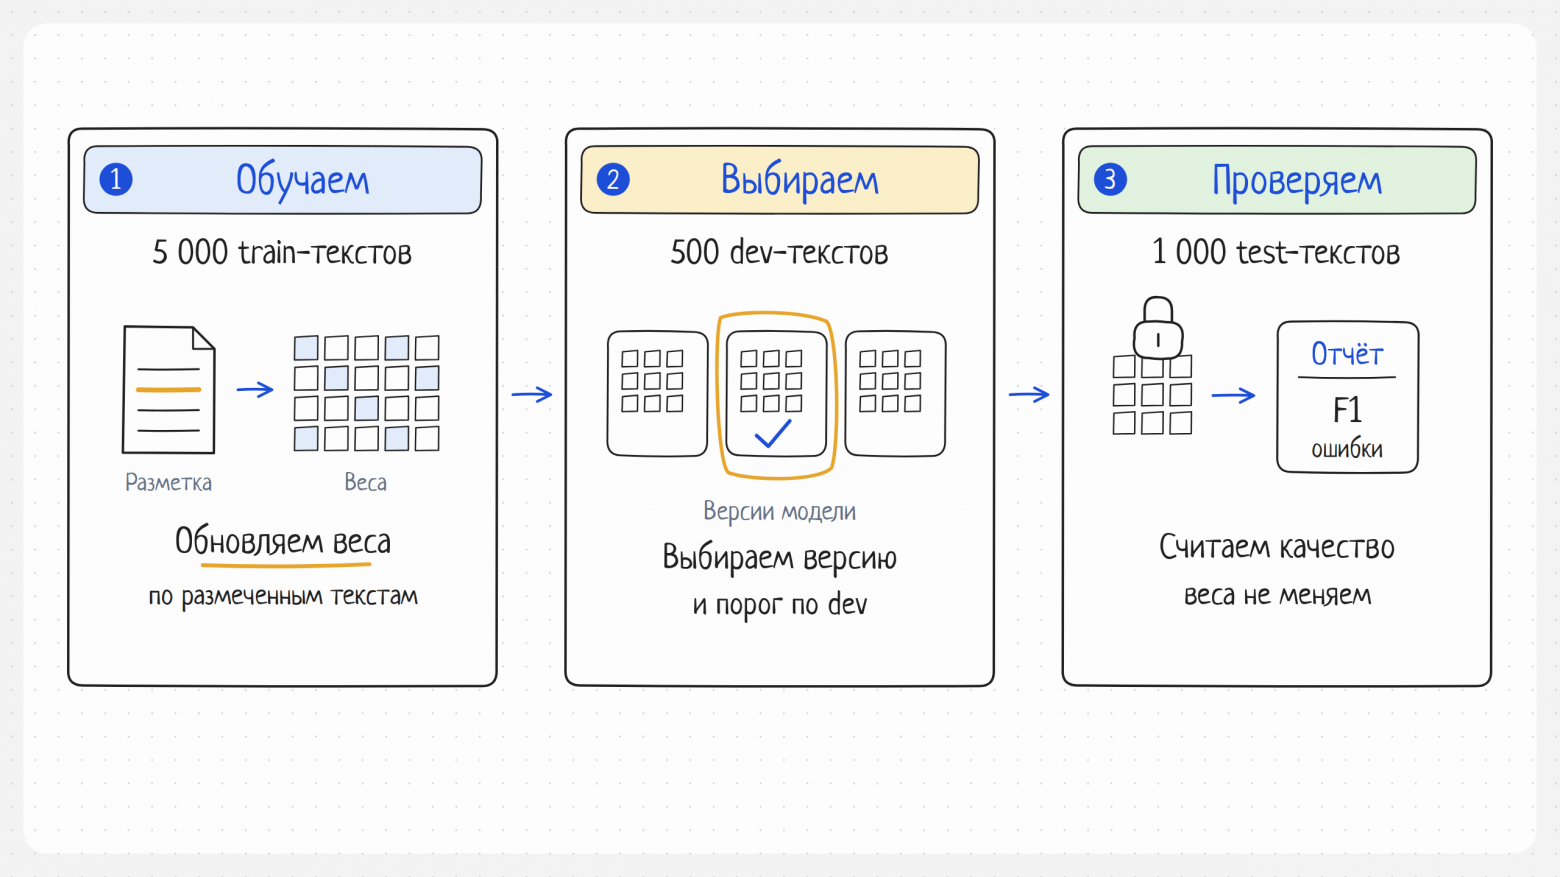
На train обновляем веса. По dev выбираем сохраненную версию и порог, затем закрепляем их и оцениваем на test. Тестовая часть не участвует в выборе настроек.
В обоих способах обучения модель получает небольшую порцию текстов – батч – вместе со схемой типов. По размеченным сущностям обучающий код вычисляет функцию потерь, то есть численную ошибку [8] предсказания, а затем при обратном проходе рассчитывает градиенты для обновления весов. Различается набор параметров, которые оптимизатору разрешено менять: при полном дообучении обновляется вся модель, а в LoRA исходные веса заморожены и обучаются добавленные матрицы.
В LoRA обновление записывается как ΔW = (α/r) · B · A, где r задает низкий ранг, а α – масштаб. Я установил адаптеры только в encoder.query и encoder.value, поэтому обучались 589 824 параметра A/B, около 0,21% базы. Остальная модель, включая слои извлечения сущностей над энкодером, оставалась замороженной.
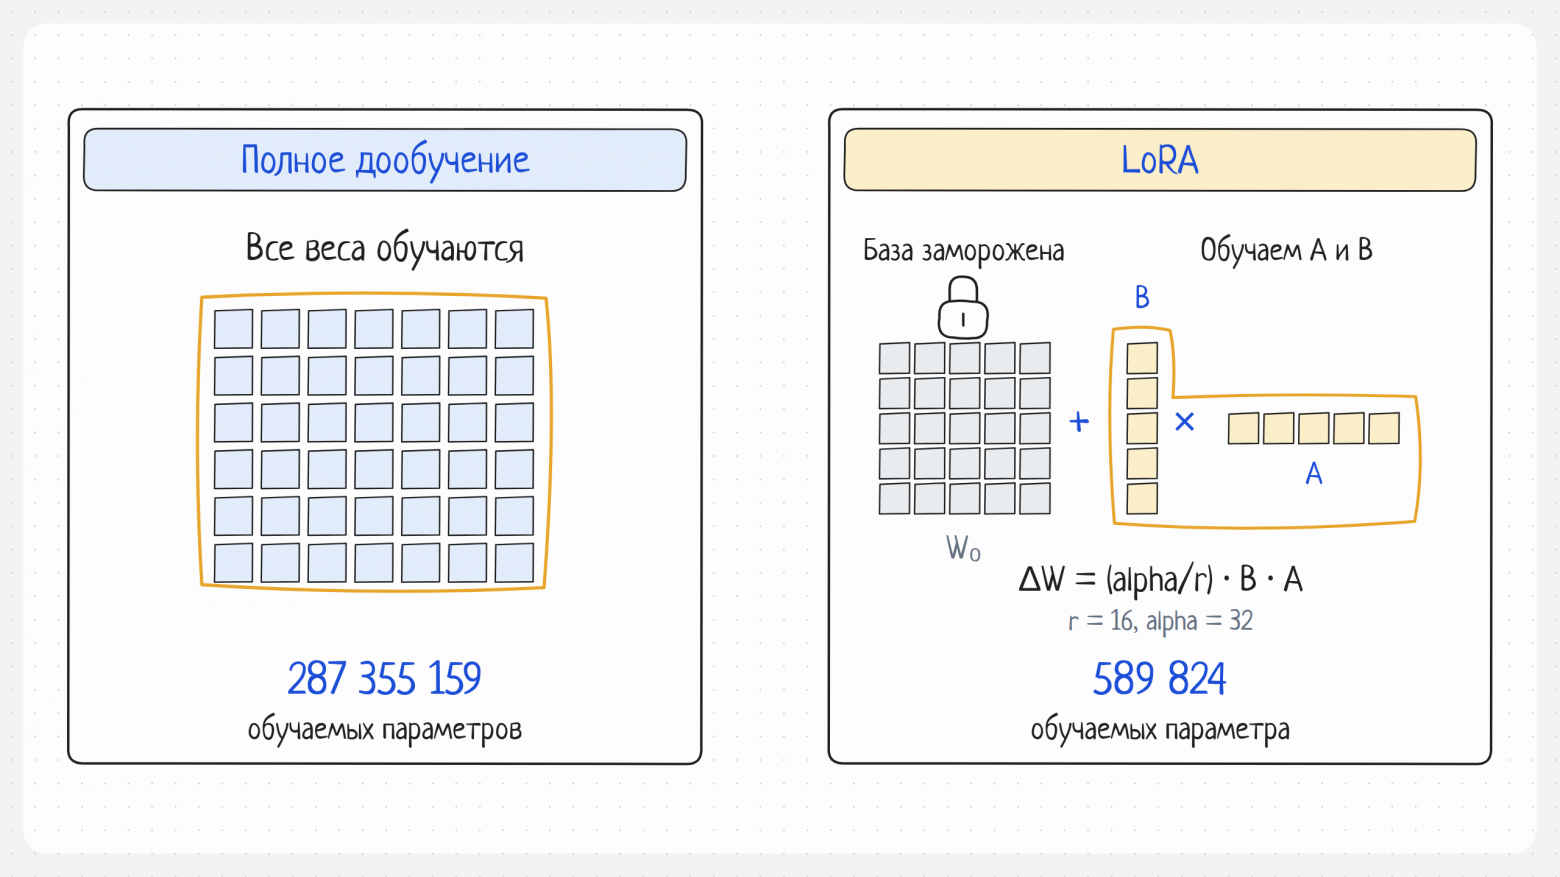
Полное дообучение меняет все веса. В выбранном LoRA-рецепте обучаются только A/B в query/value энкодера. Маленький файл адаптера используется вместе с исходной моделью. Формы матриц на схеме условны; число обучаемых параметров относится ко всей конфигурации.
Для двух способов обучения использовал разные настройки, приведенные в таблице. Learning rate в ней означает размер шага обновления весов; при полном дообучении для энкодера, обрабатывающего текст, и слоев извлечения сущностей задавались разные значения.
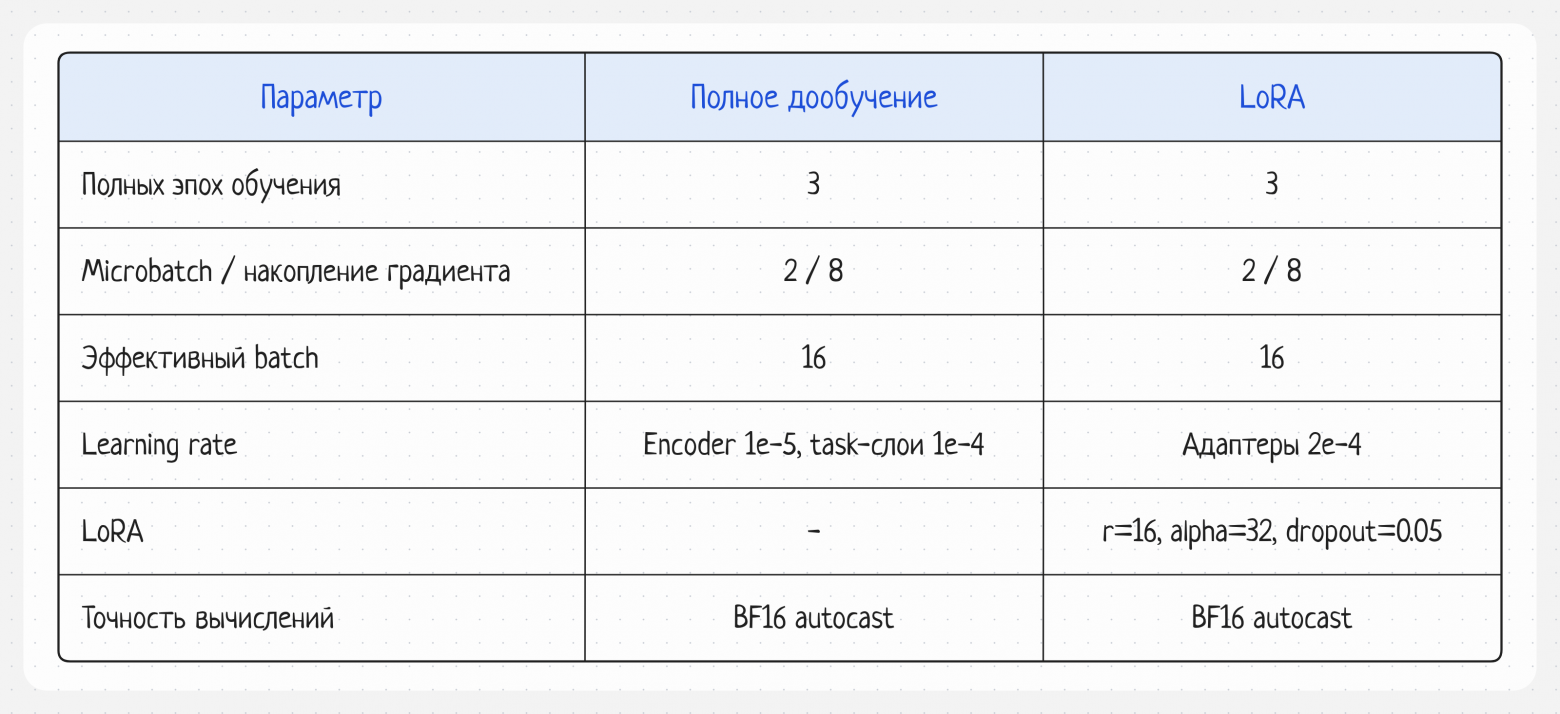
Одна конфигурация на рецепт; сохраненную версию и порог выбираем по dev.
Общие настройки оставил одинаковыми: оптимизатор AdamW, постепенный разогрев в первые 10% шагов с последующим линейным снижением скорости обучения, weight decay 0,01 и ограничение нормы градиента 1,0. Weight decay сдерживает рост весов, а разогрев, или warmup, постепенно выводит скорость обучения на заданное значение. Начальные случайные состояния и порядок перемешивания фиксировал seed 20261114.
Чтобы увеличить эффективный батч, использовал накопление градиента: обновление весов происходит после нескольких маленьких батчей. При microbatch 2 и accumulation 8 эффективный размер равен 16; за три эпохи модель проходит каждый из 5 000 документов три раза.
Обучение выполнялось через ExtractorTrainer из gliner2==2.1.0 с оберткой, которая фиксировала обучаемые параметры и сохраняла веса каждой эпохи. Для входа установлен предел в 1 024 токена вместе со схемой типов, тогда как самый длинный исходный train-вход занимал 788 токенов. При превышении лимита или нехватке памяти запуск останавливался с ошибкой, без обрезки и пропуска текстов; отдельно проверялось участие каждого примера в каждой эпохе и изменение только добавленных матриц в LoRA. Конфигурации и описание экспериментального протокола [9] и пример запуска на своем JSONL [10] находятся в репозитории материалов.
Как выбирали версию модели и порог
После каждой полной эпохи проверял сохраненную модель на dev и перебирал общую сетку порогов 0.05, 0.10, ..., 0.95. Порог определяет, какие предсказания попадут в ответ: при его повышении обычно остается меньше сущностей. Для выбора версии использовал строгий micro-F1, при котором сущности всех типов считаются вместе, а правильный ответ должен точно совпасть с эталоном по типу, началу и концу.
Эта оценка объединяет два свойства распознавателя: precision показывает долю правильных сущностей среди найденных, а recall – долю найденных эталонных сущностей. F1 связывает их одной формулой:
F1 = 2 · precision · recall / (precision + recall)
При равном F1 сначала выбирал вариант с меньшим числом ложных масок на публичных значениях, затем более раннюю эпоху и больший порог. Для всех шести типов использовался один порог: по результатам dev у полного дообучения выбрана вторая эпоха с 0,95, у LoRA – третья с 0,90, у rsLoRA – первая с 0,90. До итоговой проверки на test сохранены checkpoint, пороги, схема и хеши данных и кода.
Качество маскирования я оценивал дополнительно: рядом с precision, recall и F1 показываю полное покрытие секретов и ошибки на публичных значениях. Если маска захватила весь секрет вместе с лишним словом, покрытие будет полным, хотя границы для строгого F1 окажутся неверными. Если же она оставила видимым хвост платежного условия, секрет закрыт лишь частично. Полное покрытие засчитывается, когда маски скрыли все символы сущности, а публичное упоминание считается задетым при любом пересечении с маской. Поэтому строгий recall и полное покрытие могут заметно различаться.
Что дали полное дообучение и варианты LoRA
К сравнению полного дообучения и обычной LoRA добавил еще три варианта из PEFT [11]. Они по-разному меняют обучение адаптеров или хранение исходных весов:
-
DoRA представляет исходные веса через величину и направление: LoRA обучает направление, отдельный magnitude-вектор – величину. В нашем запуске обучались 608 256 параметров, включая magnitude-векторы.
-
rsLoRA меняет масштабирование с
alpha/rнаalpha/sqrt(r). Приr=16,alpha=32коэффициент меняется с 2 на 8. -
QLoRA в нашем исполнении использует NF4 и двойное квантование для 72 линейных слоев энкодера, затем обучает LoRA. В 4-битном виде хранится около 29,6% весов исходной модели; embeddings, нормы и task-слои остаются FP32. Paged optimizer не использовался.
Для каждого метода использовал один набор гиперпараметров без дополнительного поиска. В этом сравнении полное дообучение дало F1 94,13% против 22,51% у исходной модели и обошло LoRA на 3,44 процентного пункта. Изменение поведения видно на сохраненном примере test-family-0029-p1-private: ниже приведена коммерческая строка с графиком оплаты, а техническое окружение документа опущено.
Исходный фрагмент:
Закрытая запись по взаиморасчетам устанавливает 50% в дату приемки и 50% спустя 60 календарных дней. Это обязанность по оплате данной поставки.

GLiNER Base:
Закрытая запись по взаиморасчетам устанавливает [PRIVATE_PRICE] в дату приемки и [PRIVATE_PRICE] спустя 60 календарных дней. Это обязанность по оплате данной поставки.

GLiNER после полного дообучения:
Закрытая запись по взаиморасчетам устанавливает [PAYMENT_TERMS]. Это обязанность по оплате данной поставки.
Исходная Base распознала два процента как цены, тогда как после полного дообучения модель выделила график оплаты целиком и присвоила ему правильный тип. У этого документа есть публичный двойник со строкой “Публичная запись в справочнике устанавливает…”: на нем Base снова скрыла оба процента, а дообученная модель оставила текст без масок. Оба ответа сохранены в результатах теста и показывают, как обучение изменило не только границы, но и обработку публичного условия.
Что дала разметка большой моделью
До этого я менял способ обновления весов, сохраняя обучающую разметку. В следующем опыте [12] оставил те же тексты, но поручил разметить их большой модели: через OpenCode Go [13] DeepSeek V4.1 Flash получал train-текст и инструкцию по шести типам, а возвращал тип сущности, буквальную цитату и номер ее вхождения. По этим цитатам локальный код восстанавливал символьные координаты в исходном тексте.
Учитель работал без авторских ответов и получал только train: dev и test ему не отправлялись. После подготовки меток я снова взял исходную GLiNER и выполнил полное дообучение на тех же 5 000 текстов. Ученик сохранил прежние размер и архитектуру, а от учителя получил готовую разметку – жесткие метки, без logits и скрытых состояний большой модели.
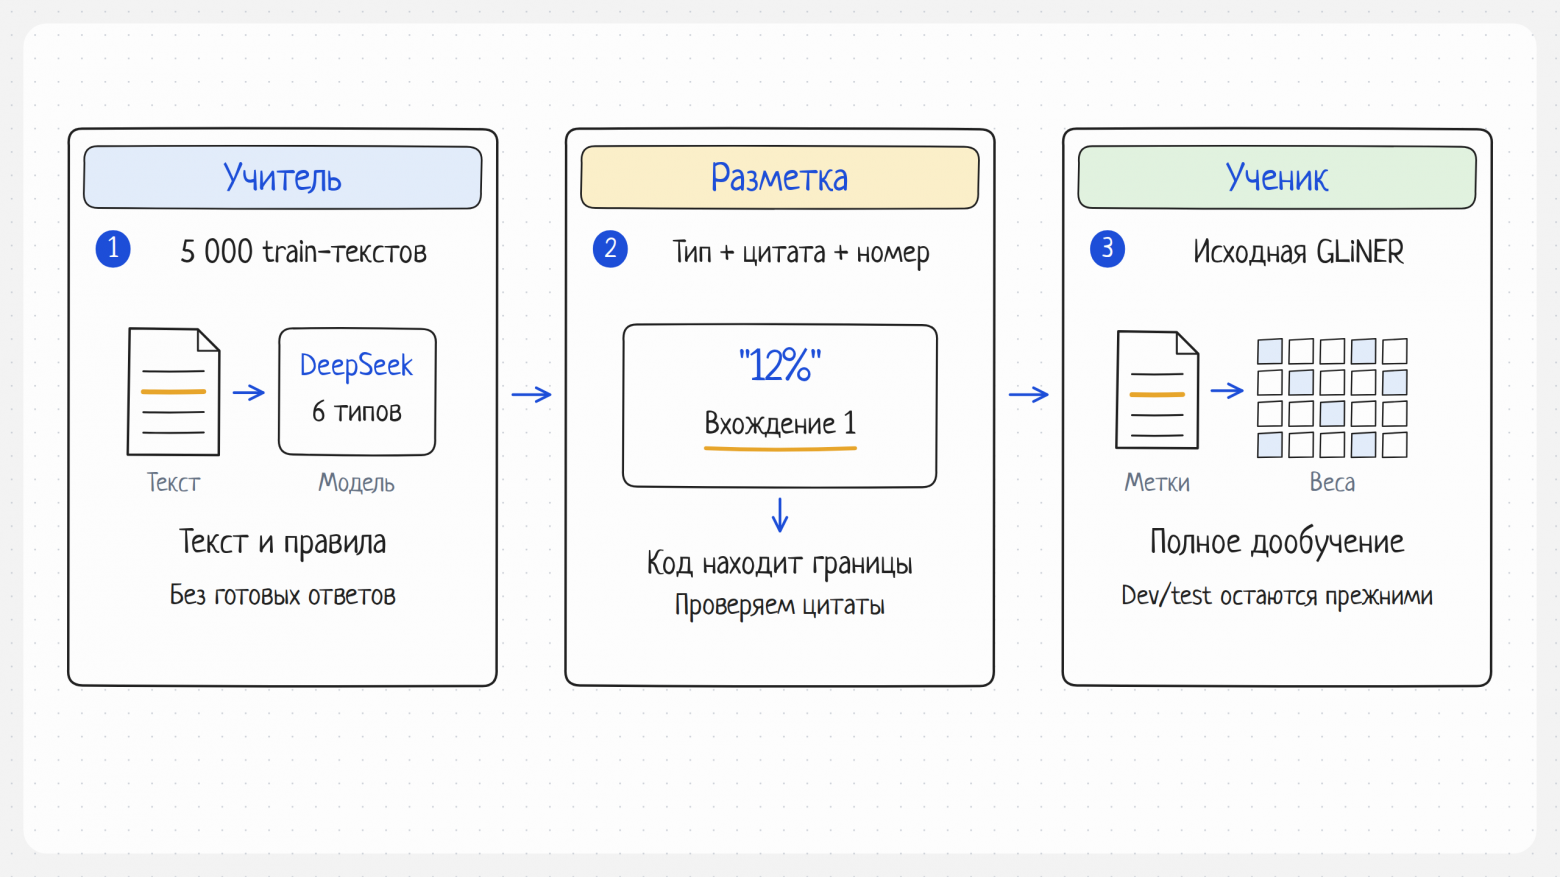
Учитель получает исходные train-тексты и инструкцию без авторских ответов. Цитаты превращаются в проверенные символьные метки. Исходная GLiNER проходит полное дообучение; dev и test не меняются и учителю не отправляются. Цитата “12%” на схеме иллюстрирует формат ответа.
Первая инструкция оказалась неудачной: учитель ошибался на повторных цитатах публичных значений, поэтому разметку остановили после 1 096 ответов. Правило уточнили на train-пилотах и собрали новую версию из 5 000 пригодных записей, сохранив первую попытку отдельно и не включая ее в обучение. В новой версии один ответ с невалидным форматом исправлен отдельным общим запросом; ответы с корректным форматом оставлены даже там, где учитель разошелся с авторской разметкой по смыслу.
Модель на этой разметке получила F1 95,62% на исходном test – на 1,49 процентного пункта выше полного дообучения на авторских метках. Как и в остальных вариантах, checkpoint и порог выбирались отдельно на dev: у ученика выбраны третья эпоха и порог 0,60. Разметка, попытки и преобразования цитат [14] сохранены вместе с происхождением меток. Поскольку тексты синтетические, в этом опыте с внешним учителем не использовались настоящие коммерческие документы.
Что получилось с LLM в роли NER
Отдельная ветка сравнения касалась архитектуры распознавателя: я взял Qwen3.5-4B-Base [15] и Gemma 4 E2B [16] и приспособил их текстовую часть для разметки токенов. Основной трансформер, или backbone, вычисляет представления токенов; вместо слоя предсказания следующего токена я добавил классификатор – NER-голову на 13 классов: O и по B/I для шести типов. Большая часть весов осталась в backbone: у загружаемой текстовой части Qwen около 4,21 млрд параметров, у Gemma E2B – около 4,63 млрд, существенно больше GLiNER.
Классы головы задают BIO-разметку: B отмечает начало сущности, I – ее продолжение, а O – остальной текст. Поэтому фраза 50% / 50% в течение 30 дней должна получить последовательность меток типа PAYMENT_TERMS, которую затем можно собрать в одну сущность с символьными координатами. Такую постановку описывает раздел курса Hugging Face о token classification [17].
Для разметки важны слова по обе стороны от значения, однако в модели с каузальным вниманием [18] представление текущего токена обычно не видит продолжения текста. В этом рецепте я подавал две копии документа и вычислял функцию потерь (loss) и итоговые предсказания только для второй: перед ней уже находилась первая копия целиком. Повтор последовательности для sequence labeling рассматривается в работе EACL 2026 [19]; здесь этот прием проверялся на гибридной Qwen3.5 и русских текстах нашего корпуса.
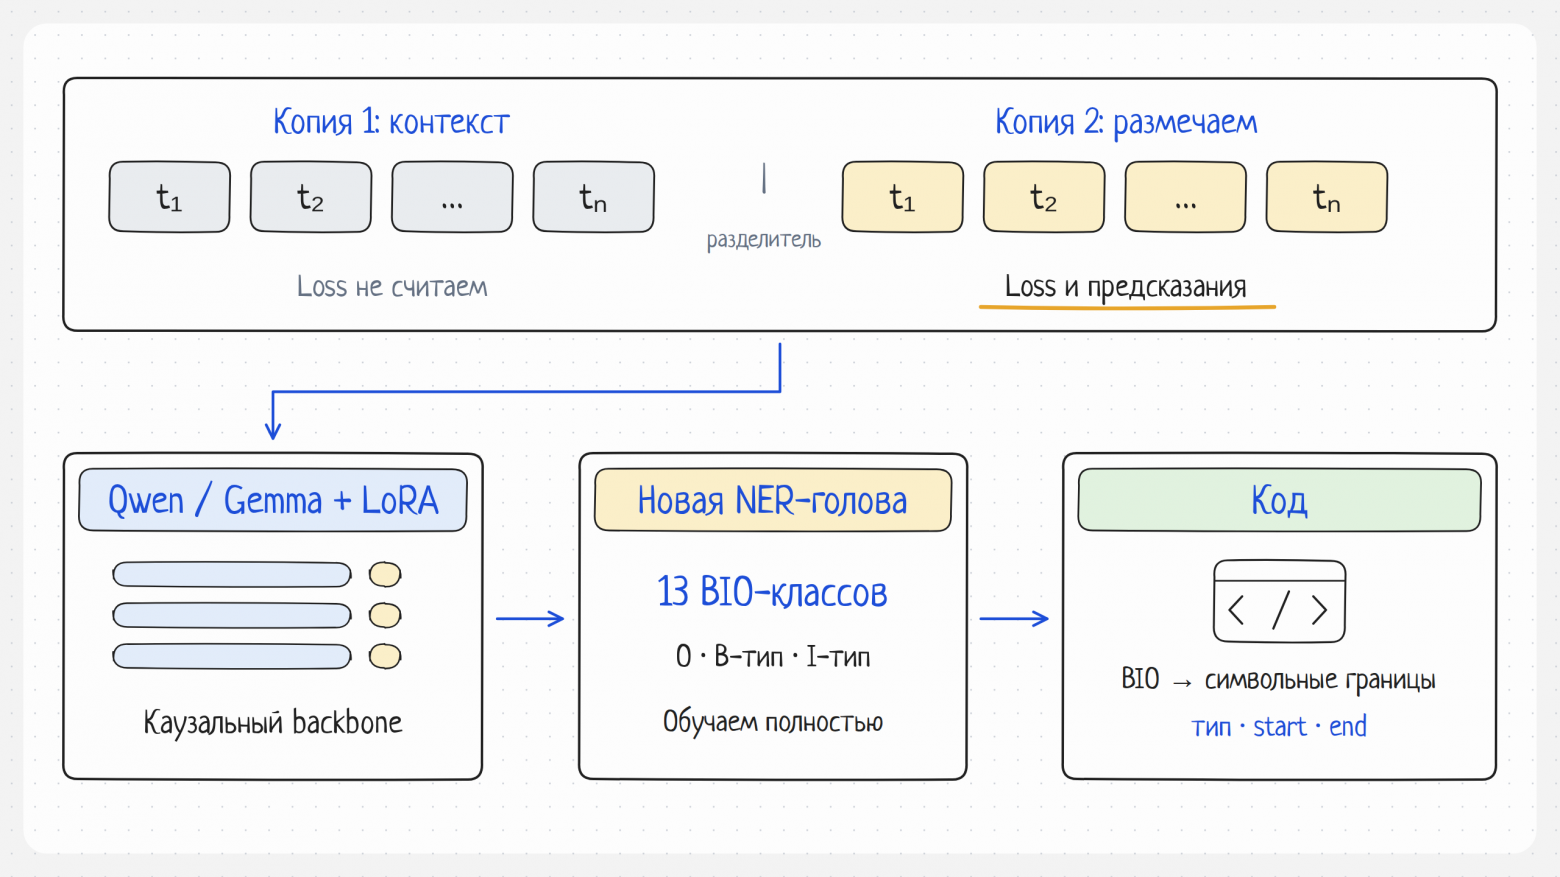
LoRA адаптирует backbone, новая NER-голова обучается полностью. Loss и итоговые предсказания считаются только для второй копии. Повтор дает доступ к исходному документу слева, но не меняет каузальное внимание внутренних слоев на двунаправленное.
Адаптеры LoRA и новая голова обучались три эпохи на том же train, после чего checkpoint и порог выбирались по dev. На итоговом test Qwen получил F1 79,48%, а Gemma – 67,89%. Эти результаты относятся ко всему рецепту с повтором текста: отдельного запуска с одной копией документа для измерения эффекта повторения не было.
Качество и ресурсы на коротком тесте
После этих запусков в сравнении оказалось девять NER-конфигураций, оцененных на одном наборе из 1 000 текстов. Внутри группы GLiNER менялись обучение и разметка, тогда как Qwen и Gemma отличаются еще и архитектурой, размером и форматом входа. В таблице собраны как строгие метрики распознавания, так и показатели маскирования, чтобы видеть, какие ошибки стоят за итоговым F1.
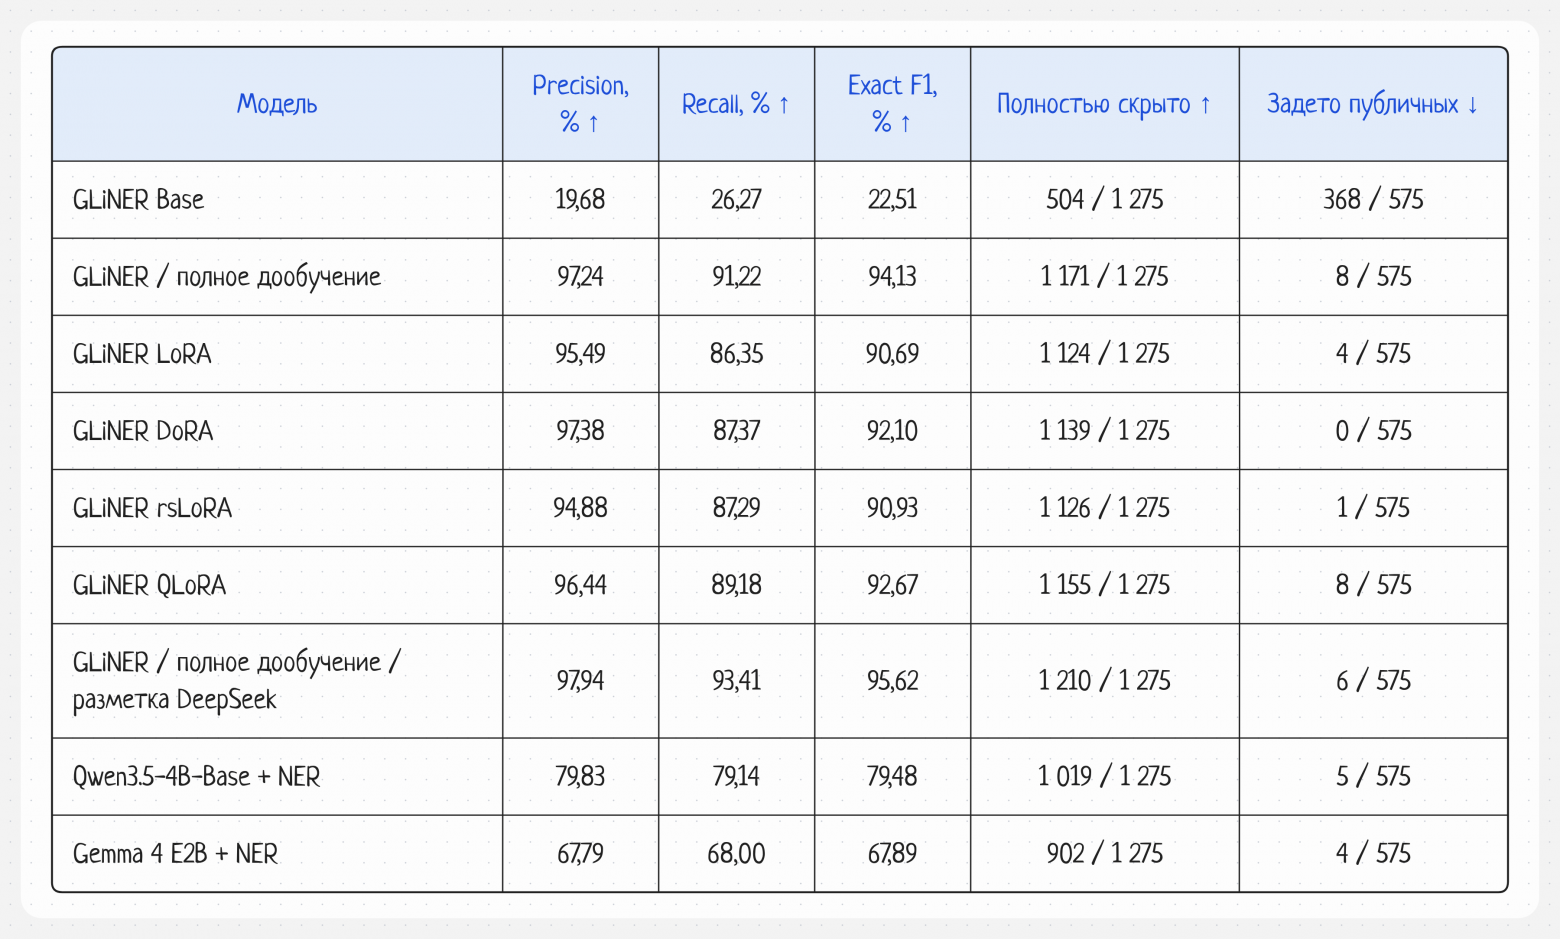
1 000 коротких синтетических текстов. Precision, recall и Exact F1 требуют совпадения типа и обеих границ. В столбцах маскирования – полностью скрытые секреты из 1 275 и задетые публичные упоминания из 575. Стрелки показывают, в какую сторону лучше; пороги и эпохи выбраны на dev.
После полного дообучения precision составила 97,24%, а recall – 91,22%. На этом же тесте модель целиком закрыла 1 171 секретную сущность из 1 275, но задела 8 публичных упоминаний. С разметкой DeepSeek число полностью закрытых секретов увеличилось до 1 210, а публичных ошибок осталось 6. При этом DoRA сохранила все 575 публичных упоминаний, но целиком скрыла 1 139 секретов – на 32 меньше, чем полное дообучение на исходной разметке. Так сравнение показывает оба вида ошибок: можно сохранить больше публичного текста, одновременно пропустив больше секретных фрагментов.
Разница в качестве – одна сторона выбора между полным дообучением и адаптерами. Другую показывают время обучения и расход памяти на RTX 3090:
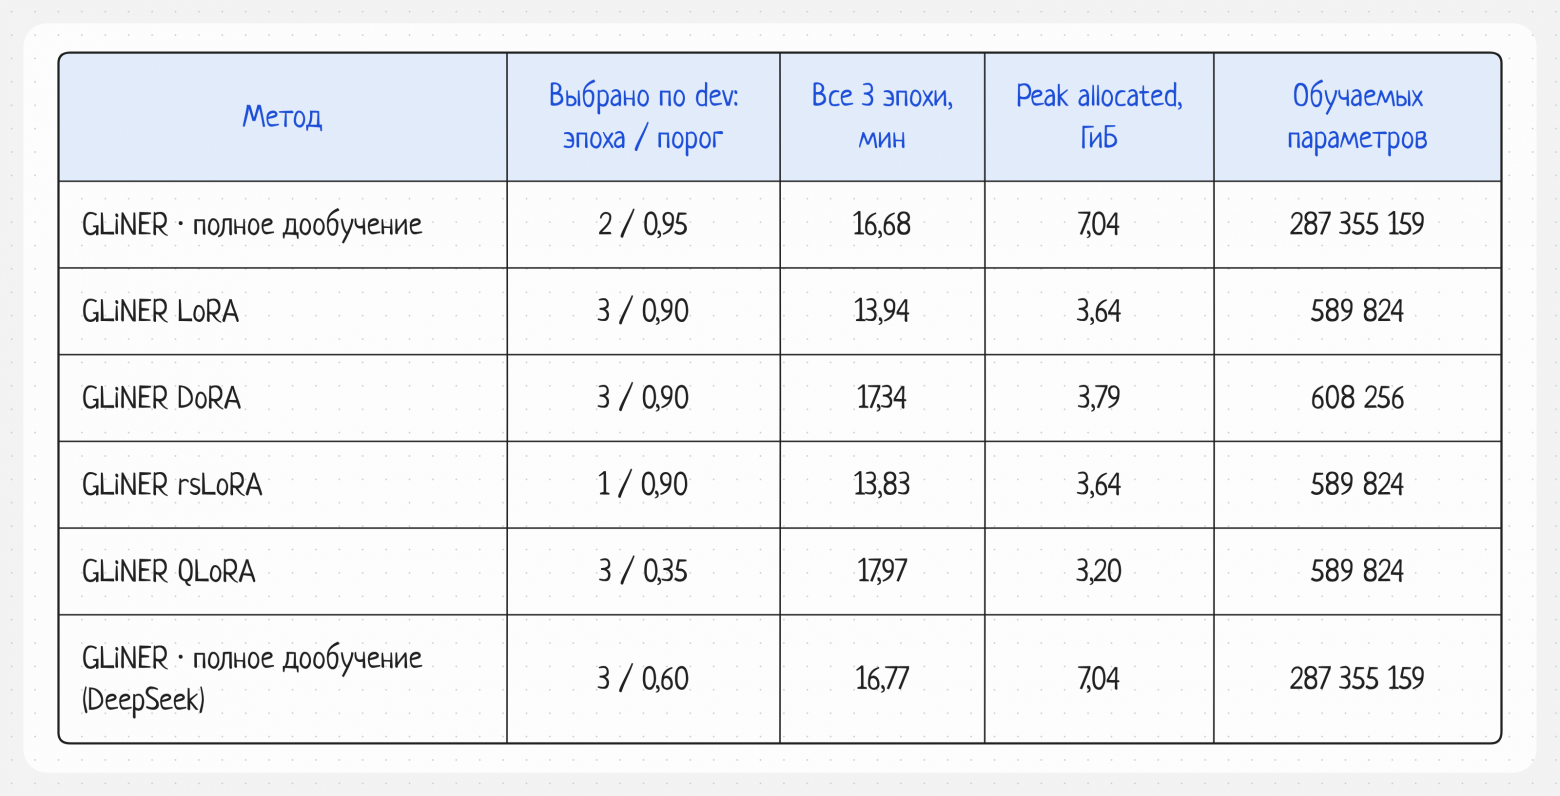
Три полные эпохи на одной RTX 3090. Время включает сохранение checkpoint и не включает dev-перебор и обращения к учителю. Peak allocated – пик памяти тензоров PyTorch, не минимально необходимая VRAM карты.
Три эпохи LoRA заняли примерно 14 минут с пиком 3,64 ГиБ, а полное дообучение – 16,68 минуты и 7,04 ГиБ. Это длительность всего запуска, включая эпохи после выбранного checkpoint, поэтому ее можно сопоставлять с ресурсами полного обучающего прохода. В нашем запуске LoRA потребовала меньше памяти, хотя базовые веса и активации по-прежнему нужно хранить вместе с адаптерами.
Проверка LLM с системным промптом
Помимо обучения NER-головы проверил instruction-версии с системным промптом, который просит вернуть разметку. Здесь модель генерировала ответ в JSON, а код принимал его только после строгого разбора: исправления формата и грамматического ограничения генерации не было. Использовал один zero-shot промпт, do_sample=False, выключенный thinking и максимум 384 выходных токена; температура, top_p и top_k при таком декодировании не используются. В таблице приведены качество и задержка – медиана (P50) и P95. Последний показывает время, быстрее которого прошли 95% измеренных запросов.
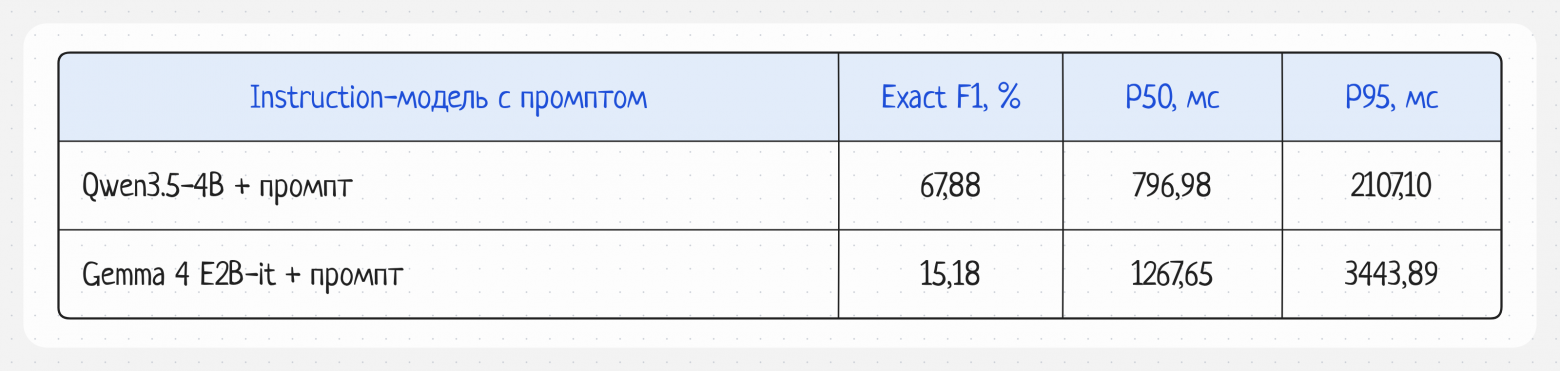
Качество – все 1 000 коротких текстов; задержка – тот же набор из 200 ID на RTX 5090. Дообученные BIO-модели и instruction-checkpoint с промптом имеют разные исходные веса и способы получения ответа.
У Gemma существенная часть ошибок возникла еще при получении структурированного ответа: 536 из 1 000 результатов содержали невалидный JSON, в том числе Markdown-ограждения, запрещенные инструкцией. В таком запуске Gemma полностью закрыла 201 секретную сущность и задела 117 публичных упоминаний, а Qwen – 782 из 1 275 секретных сущностей и 77 из 575 публичных упоминаний. Поэтому результат описывает работу выбранной инструкции вместе с декодером; перебор промптов, constrained decoding и другие настройки здесь не проверялись. На длинные документы этот вариант не переносили, а precision, recall и остальные показатели всех 11 систем [20] сохранены в текстовых таблицах.
Сколько занимает распознавание
Чтобы сопоставить время работы готовых распознавателей, повторно измерил все девять NER-конфигураций на одной RTX 5090. Каждая обрабатывала после прогрева одинаковые 200 test ID с batch 1, а таймер охватывал весь путь от токенизации и передачи на GPU до работы модели и восстановления координат. Загрузка весов и запись сырых результатов в замер не входили.
Перед этими измерениями адаптеры LoRA, DoRA и rsLoRA GLiNER были объединены с базовыми весами. QLoRA запускалась как NF4-модель с отдельным адаптером, поэтому ее время относится к этому способу исполнения.
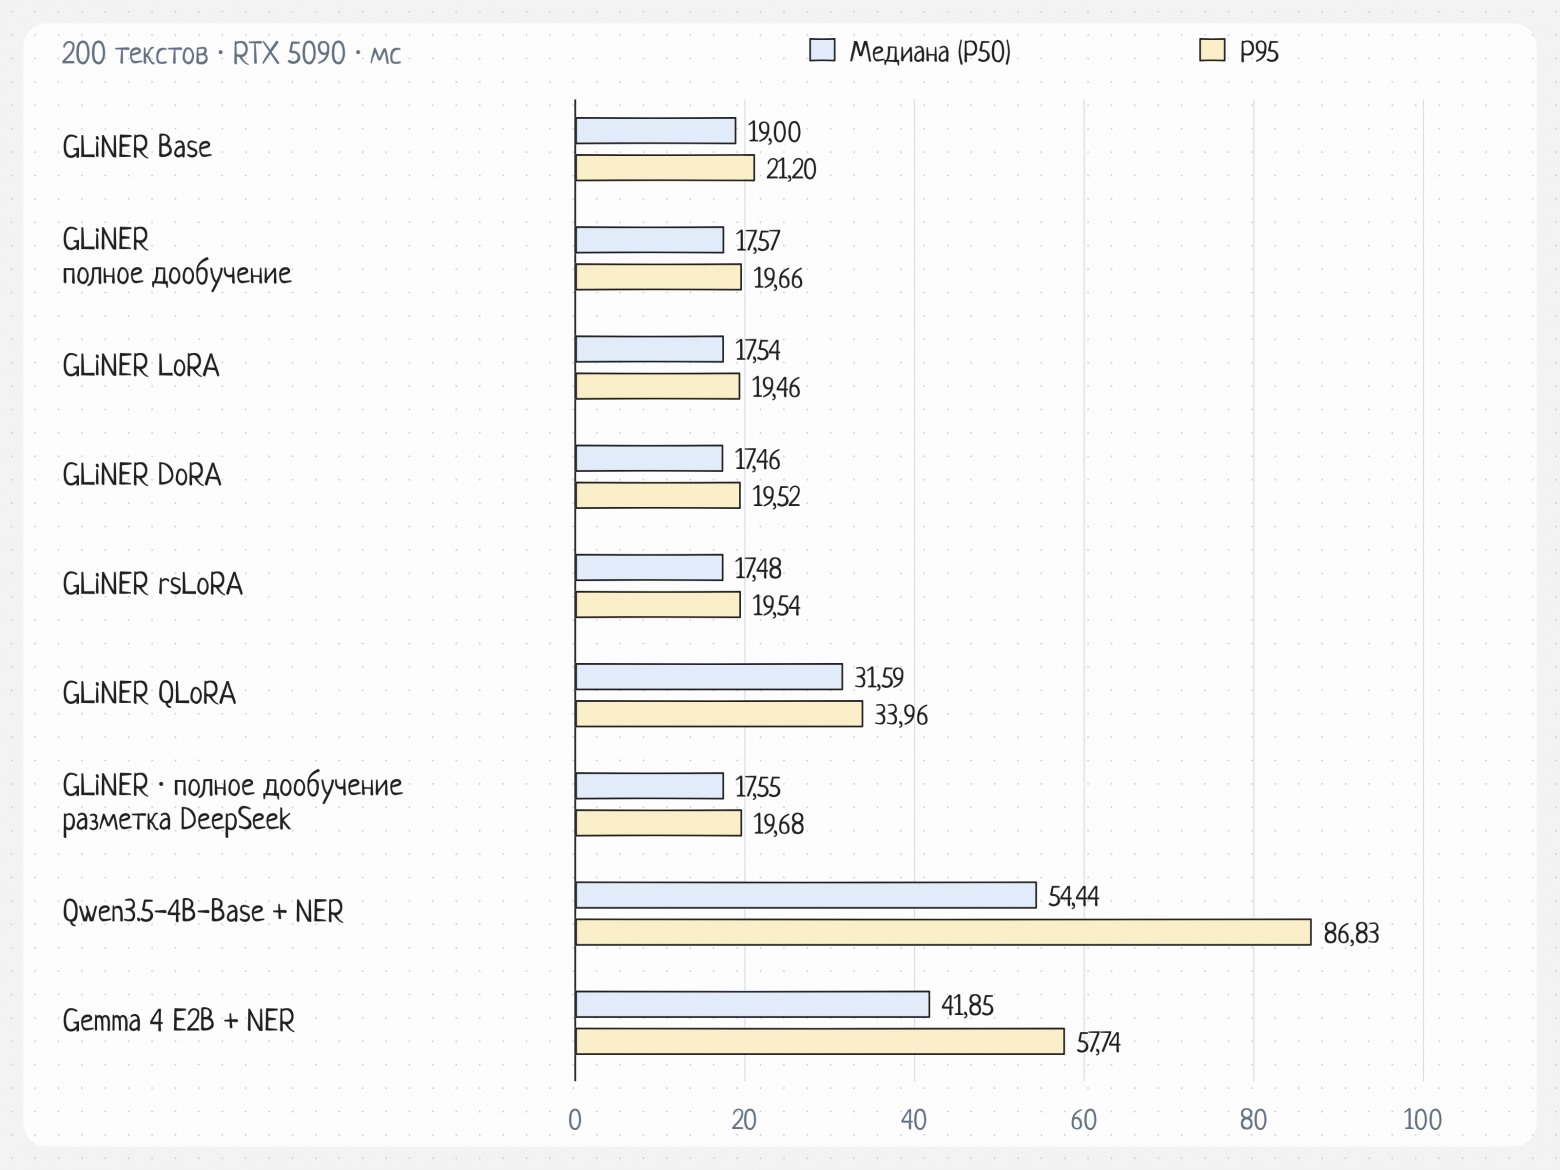
P50 и P95 на одинаковых 200 коротких текстах, RTX 5090. Время включает весь путь от исходного текста до списка сущностей.
Медианная задержка исходной GLiNER и вариантов с объединенными адаптерами составила около 17–19 мс. У QLoRA получилось около 32 мс, у Gemma и Qwen с NER-головами – около 42 и 54 мс соответственно.
Что происходит на длинном документе
Для проверки длинных входов подготовил отдельный синтетический набор из 1 000 документов длиной примерно 1K, 2K, 4K и 8K токенов. Целевой фрагмент находился в начале, середине или конце, а его статус – рядом со значением, поэтому опыт проверяет обработку большого объема текста при локально заданном статусе, без дальних смысловых связей через границы окон. Основные 960 текстов получены как 40 семейств × 4 длины × 3 положения × private/public; еще 40 документов нейтральные. Всего в наборе 480 секретных сущностей и столько же публичных целей.
Длины 1K-8K измерены штатным токенизатором Qwen и относятся к исходной строке, одинаковой для всех моделей. Фактический вход после подготовки получался разным: у GLiNER вместе со схемой он достигал 10 110 токенов, у Qwen/Gemma с NER-головой после сегментации и повторения – 32 217 и 31 174. У обеих LLM с NER-головами даже самый короткий новый вход превышал обучающий лимит 2 048 токенов.
Для GLiNER сравнил два способа обработки: целый документ и вызов extract_entities_long, который делит его на окна по 384 словных токена с перекрытием 64. На один документ получалось от 2 до 16 окон; после их обработки локальные координаты переводились в координаты исходного текста, а найденные фрагменты проходили общее декодирование по выбранному порогу.
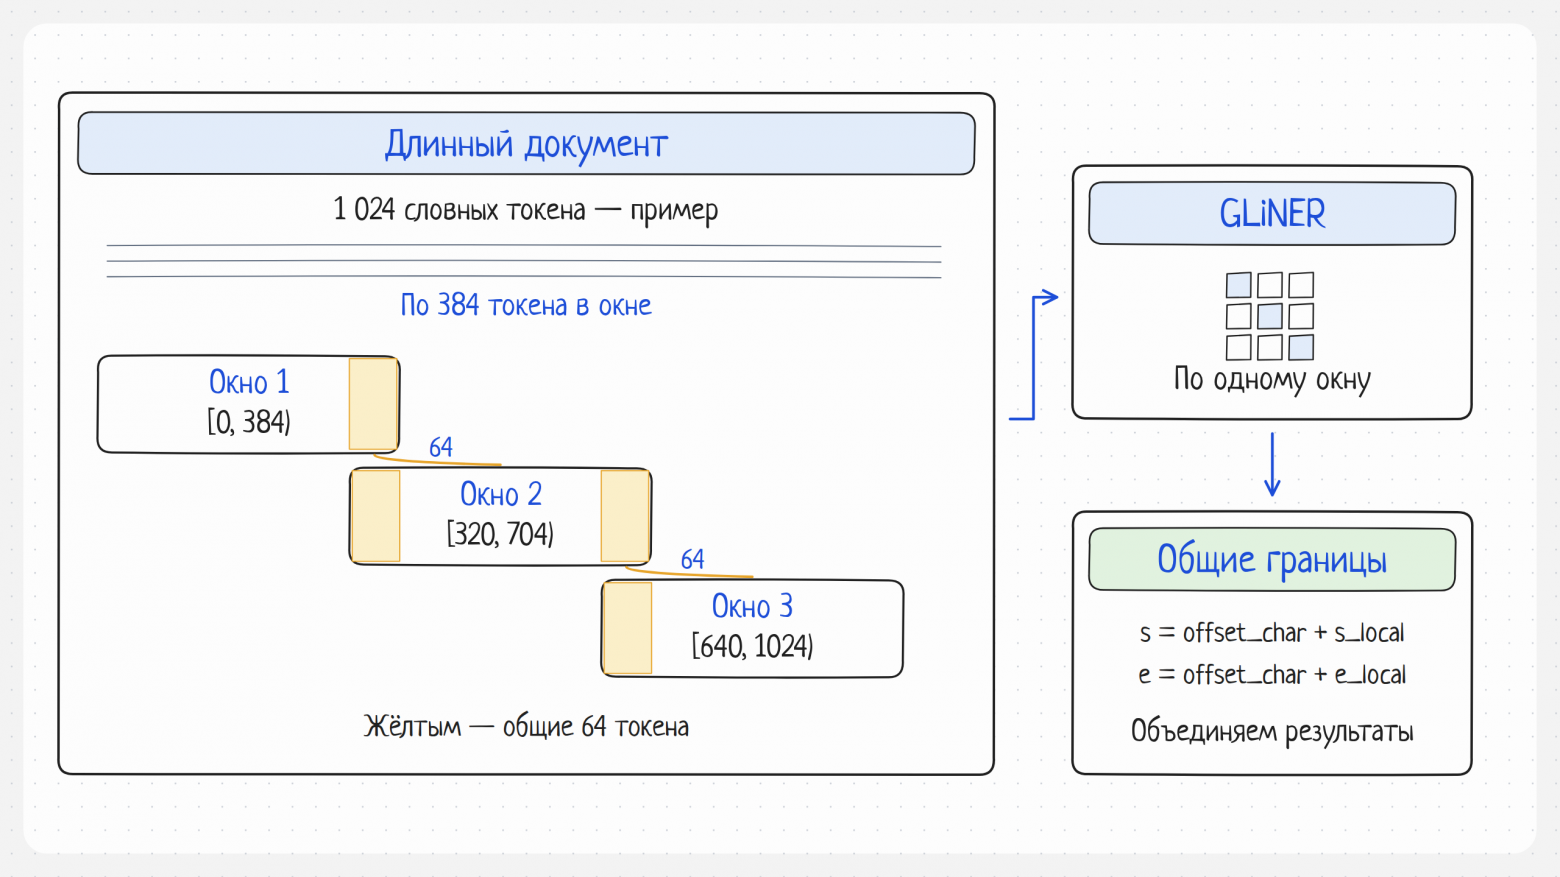
На схеме условный документ из 1 024 словных токенов: интервалы внутри окон задают позиции этих токенов. В формулах справа локальные границы и offset_char измеряются уже в символах исходного текста. Это разные единицы. Модель обрабатывает окна последовательно; задержка включает все окна и объединение результата.
При разбиении меняется не только доступный контекст: лимит кандидатов на сущности, который в полном режиме действует на документ, в оконном применяется к каждому окну. Поэтому результат сравнения включает и изменение общего числа рассматриваемых кандидатов. Все 16 NER-конфигураций обработали по 1 000 текстов на одной RTX 5090 32 ГБ без обрезки, ошибок и OOM. Для них сохранил прежние веса, пороги, слияние адаптеров и квантование, а пилотные примеры учитывал отдельно от основного набора.
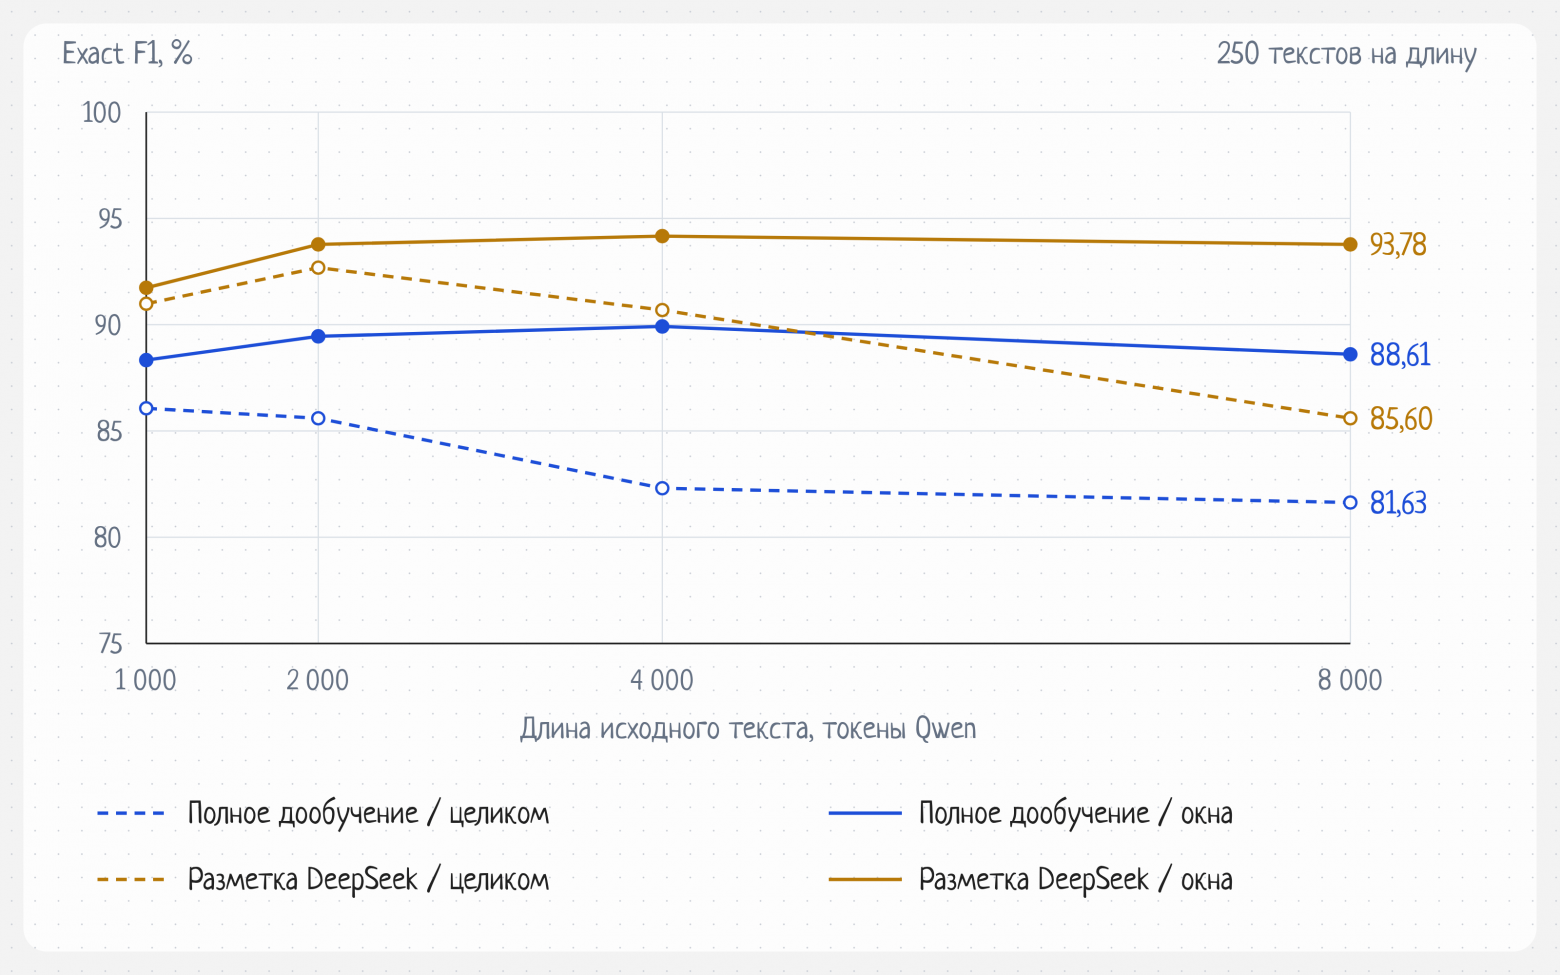
Каждая точка рассчитана по 250 документам одной длины, измеренной токенизатором Qwen. Варианты внутри одного семейства зависимы.
У GLiNER после полного дообучения на разметке DeepSeek обработка окнами дала общий F1 93,36%. На срезе 8K разница с обработкой целиком составила 93,78% против 85,60% у одного и того же checkpoint. Для этого же среза сравнил время обработки документа и пиковую память:
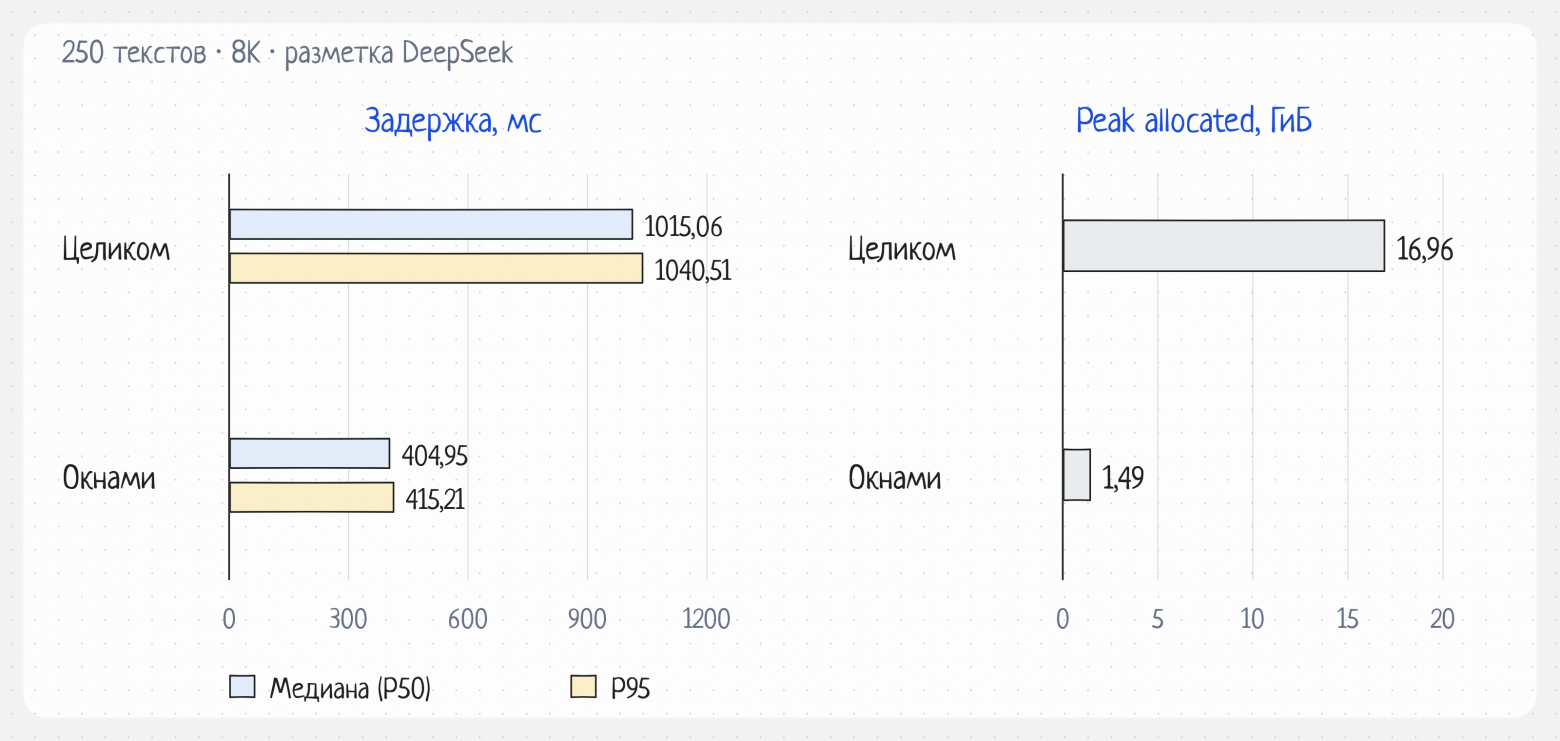
Один checkpoint, два способа обработки, 250 текстов на срезе 8K, batch 1. Задержка включает весь документ. Память – пик объема тензоров PyTorch (peak allocated).
На 8K окна дали P50 около 405 мс и пик 1,49 ГиБ против 1 015 мс и 16,96 ГиБ при обработке целиком. Однако на коротком срезе 1K полный документ обрабатывался быстрее: около 33 мс против 59 мс с окнами. В этом исполнении на длинном входе обработка окнами была быстрее и требовала меньше памяти, а на коротком занимала больше времени.
У Qwen/Gemma с NER-головой общий F1 на новом корпусе составил 45,69% и 53,99%. Обе модели сохранили без масок все 520 отрицательных документов, но целиком закрыли лишь 245 и 242 секретные сущности из 480. Здесь особенно заметна разница между сохранением публичного текста и обнаружением всех секретов. Снижение относительно короткого теста нельзя объяснить одной длиной: изменились сами тексты, а парный тест на коротких версиях этих же документов не проводился. Кроме того, все новые входы этих NER-голов вышли за длину обучения.
Качество распознавания и качество маскирования
Сводная таблица длинного теста позволяет сопоставить эти ошибки для всех конфигураций: насколько точно найдены типы и границы, сколько секретов закрыто целиком и сколько публичных целей задето маской.
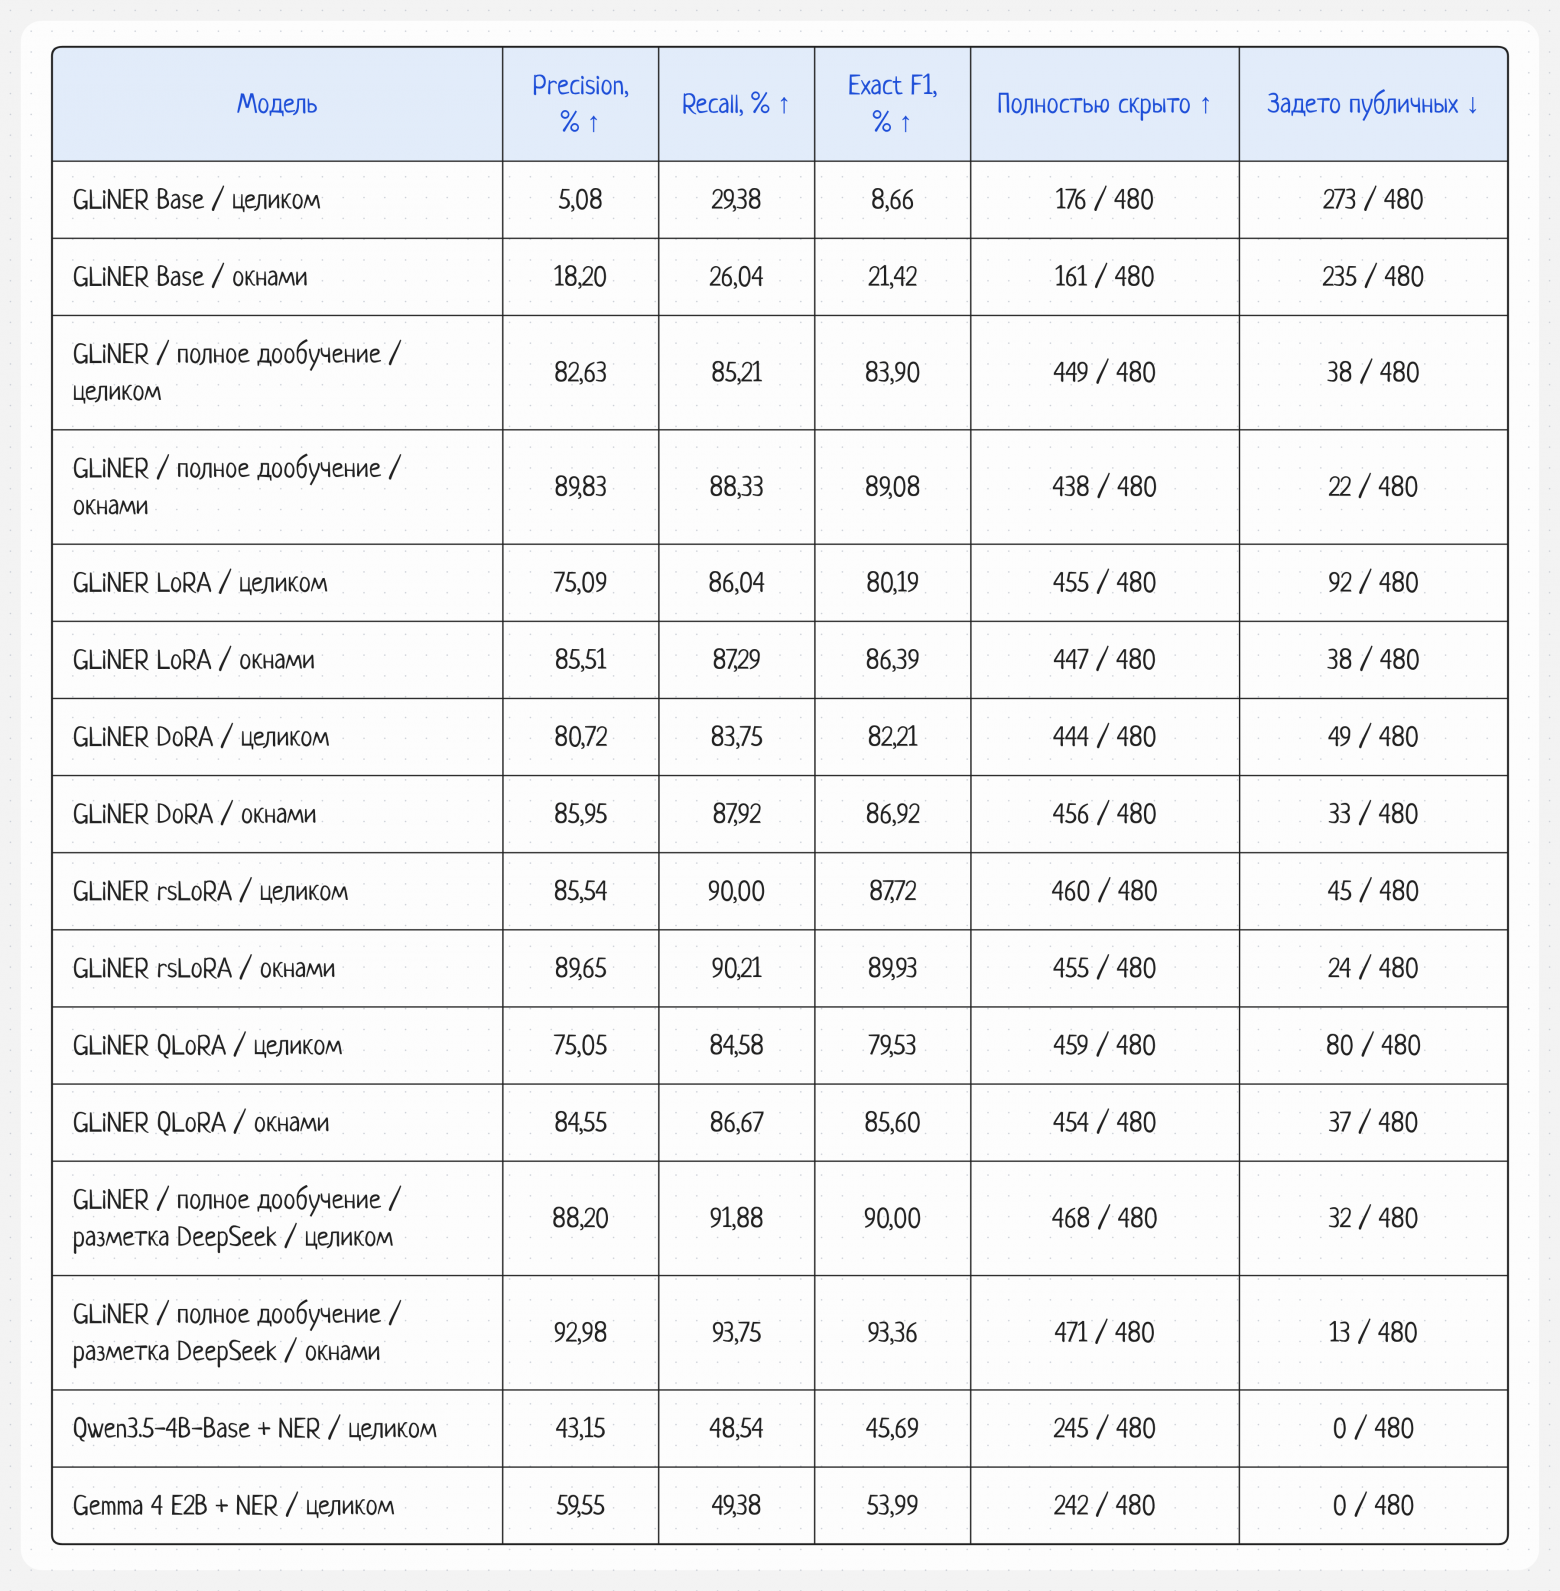
Отдельные 1 000 длинных документов, все четыре длины вместе. Всего 480 секретных сущностей и 480 публичных целей. Последний столбец учитывает пересечения с этими целями; остальные лишние маски в него не входят.
GLiNER после полного дообучения на разметке DeepSeek с окнами закрыла 471 из 480 секретных сущностей и задела 13 из 480 публичных целей. При этом у модели на исходной разметке переход к окнам дал менее однозначный результат: precision выросла с 82,63% до 89,83%, recall – с 85,21% до 88,33%, F1 – с 83,90% до 89,08%, а публичных ошибок стало 22 вместо 38. Но целиком закрытых секретов оказалось меньше – 438 вместо 449. Улучшение точных границ и уменьшение лишних масок здесь сопровождались ухудшением полного покрытия секретов.
Эти результаты относятся к нашему синтетическому корпусу и выбранным настройкам обучения. Короткий test повторно использовался при добавлении новых вариантов, а длинный набор содержит зависимые варианты 40 семейств; обучение с другими seed и качество на реальных документах в эксперимент не входили. Поэтому сравнение описывает поведение конкретных конфигураций в этих условиях.
Что показал эксперимент
Доменное дообучение заметно изменило поведение GLiNER в выбранной задаче: на коротком test модель целиком закрыла 1 171 из 1 275 секретов против 504 у исходной версии, а публичных ошибок осталось 8 вместо 368. Вместе с этим выросли precision, recall и F1. LoRA потребовала меньше памяти при обучении, но закрыла меньше секретов – 1 124 – при 4 публичных ошибках. Разница между этими вариантами видна не только в сводной оценке, но и в том, какие фрагменты остаются открытыми и какой публичный текст попадает под маску.
На длинных документах к выбору обучения добавляется способ обработки: окна чаще давали точные границы, однако у некоторых моделей реже закрывали секрет целиком, а короткие тексты быстрее обрабатывались без разбиения. Поэтому в результатах я оставил рядом точность границ, полное покрытие и публичные ошибки. Для разбора и повторения сохранены данные, инструкция разметки, обученные веса и код, который проходит путь от исходного текста до маски.
Код, данные и протоколы основной серии [21] · LLM с NER-головой [22] · Полный отчет длинного теста [23]
Таблицы в текстовом виде [24] · Все показатели качества и маскирования [20]
Автор: NullPilot
Источник [25]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38660
URLs in this post:
[1] обучение: http://www.braintools.ru/article/5125
[2] поведение: http://www.braintools.ru/article/9372
[3] памяти: http://www.braintools.ru/article/4140
[4] поведение: http://www.braintools.ru/article/5593
[5] fastino/gliner2.5-multi-v1: https://huggingface.co/fastino/gliner2.5-multi-v1
[6] Корпус, инструкция и читаемая выборка: https://github.com/stemirkhan/ner-domain-finetuning/blob/fda825cef2836270ed00b9594822ad4a11ea6e30/docs/dataset.md
[7] повторении: http://www.braintools.ru/article/4012
[8] ошибку: http://www.braintools.ru/article/4192
[9] Конфигурации и описание экспериментального протокола: https://github.com/stemirkhan/ner-domain-finetuning/blob/fda825cef2836270ed00b9594822ad4a11ea6e30/docs/experiments.md
[10] пример запуска на своем JSONL: https://github.com/stemirkhan/ner-domain-finetuning/blob/fda825cef2836270ed00b9594822ad4a11ea6e30/docs/quickstart.md
[11] PEFT: https://huggingface.co/docs/peft/en/developer_guides/lora
[12] опыте: http://www.braintools.ru/article/6952
[13] OpenCode Go: https://opencode.ai/docs/console/go/
[14] Разметка, попытки и преобразования цитат: https://github.com/stemirkhan/ner-domain-finetuning/blob/fda825cef2836270ed00b9594822ad4a11ea6e30/docs/teacher.md
[15] Qwen3.5-4B-Base: https://huggingface.co/Qwen/Qwen3.5-4B-Base
[16] Gemma 4 E2B: https://huggingface.co/google/gemma-4-E2B
[17] раздел курса Hugging Face о token classification: https://huggingface.co/learn/llm-course/ru/chapter7/2
[18] вниманием: http://www.braintools.ru/article/7595
[19] работе EACL 2026: https://aclanthology.org/2026.findings-eacl.339/
[20] precision, recall и остальные показатели всех 11 систем: https://github.com/stemirkhan/ner-domain-finetuning/blob/b530f5d489e22da9bd884595daaab52f07d7f25b/results/quality-metrics.md
[21] Код, данные и протоколы основной серии: https://github.com/stemirkhan/ner-domain-finetuning
[22] LLM с NER-головой: https://github.com/stemirkhan/ner-domain-finetuning/blob/fda825cef2836270ed00b9594822ad4a11ea6e30/docs/llm-ner.md
[23] Полный отчет длинного теста: https://github.com/stemirkhan/ner-domain-finetuning/blob/fda825cef2836270ed00b9594822ad4a11ea6e30/docs/long-documents.md
[24] Таблицы в текстовом виде: https://github.com/stemirkhan/ner-domain-finetuning/blob/b530f5d489e22da9bd884595daaab52f07d7f25b/results/article-tables.md
[25] Источник: https://habr.com/ru/articles/1108138/?utm_campaign=1108138&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.