Как работают токены — снова махинации с лимитами
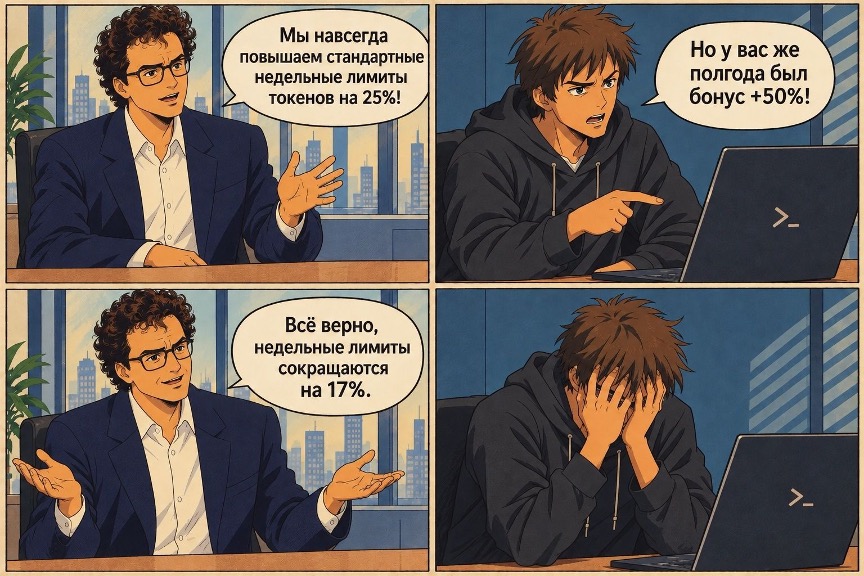
OpenAI и Anthropic грешат одним — постоянно меняют лимиты, которые входят в подписки. Причём официально эти объёмы они не публикуют, а значит, могут крутить их как хотят.
Устав от этой неразберихи, я решил, что хочу уменьшить расход токенов. При этом вряд ли я был первым с такой гениальной идеей. Для этого уже были инструменты. Я нашёл три основных — rtk, Headroom и ripwire. Всё завелось достаточно просто, я радовался тому, насколько дольше стало хватать токенов, ещё и друзьям писал — ставьте эти инструменты! И примерно два месяца так и жил.
Потом я решил собрать отчёт, сколько же расходов у меня получилось в баксах. Как бы выразиться помягче, мне не очень понравилось то, что я увидел. Для понимания, я построил тестовый стенд, и на 30 задачах SWE-bench счёт с этой троицей вырос на 18%, ещё раз — вырос, не упал.
На повторе моих реальных рабочих сессий — на 46%. rtk за всё время не сжал ни одного вызова из 3 452. ripwire агент тупо, попросту, мать его, не вызывал! Он не вызвал его ни разу! А Headroom одну мою сессию сделал дороже в 2.4 раза. От таких невероятных новостей мои глаза полезли на лоб, и я закопался в это дело ещё глубже.
Это ещё и при том, что у rtk 84 тысячи звёзд на GitHub, у Headroom 77 тысяч, и оба обещают срезать токены на 60-90% и больше.
Но самое смешное даже не это. 22 июля JetBrains опубликовали [1] свой замер rtk. В этот же день авторы rtk тихо УДАЛИЛИ из README свою знаменитую таблицу «118 тысяч токенов → 24 тысячи». И в описании коммита сами назвали её выдуманной.
Что не так с токенами
В сентябре Anthropic урезал недельные лимиты Claude Code, причём ещё и подал это как повышение — «permanently raising standard weekly limits in Claude Code by 25%», ну или «навсегда повышаем стандартные недельные лимиты Claude Code на 25%». Только до этого полгода действовал временный бонус +50%. В итоге после удалённого первого треда в уточнении они сами признали [2] — «this works out to a 17% reduction in weekly limits on Claude Code», «в итоге это означает сокращение недельных лимитов Claude Code на 17%». Вот так.
А ещё через пару недель, 29 сентября, OpenAI выкатил [3] подписку Pro 500 за $500 — и в тот же день урезал вдвое лимиты у Pro 200 для новых подписчиков.
Официально, конечно же, — «to reflect our increasingly efficient models», «чтобы отразить увеличение эффективности наших моделей», ага.
А совсем недавно, 22 октября, SemiAnalysis в один день и на одной модели замерили [4] два аккаунта Claude Max 20x. У одного пятичасовое окно оказалось на 19% больше, зато недельный бюджет на 20% меньше. Одна и та же подписка за $200, а лимиты разные. То есть лимиты на самом деле динамические, и какой объём вы реально купили, никто не знает.
Так я и оказался с rtk, Headroom и ripwire.
Откуда у меня эти числа
Сначала немного контекста. Ставил я всё это не просто себе в терминал, а в Tobari — десктопное приложение, которое я делаю и в котором в одной сетке живут окна с CLI-агентами (Claude Code, Codex, Grok, Agy и компания). Агенты в нём жгут мои деньги каждый день, поэтому рычаги экономии я встроил прямо туда и нарисовал панель «сэкономлено». Цифры на ней были красивые, и я реально был уверен, что всё успешно работает.
Но к чему это я? Цифры на панели считали сами инструменты. А отчёт задал неудобный вопрос — а счёт-то стал меньше? Спойлер — нет. Причём у каждого из трёх инструментов это случилось по своей, отдельной и довольно важной причине.
Так что сегодня разберём три вещи. Как устроены эти «экономайзеры» и что они обещают. Что произошло, когда я встроил их в реальный продукт и замерил по счёту. И почему токены — совсем не то, за что вы на самом деле платите.
Рынок у нас считает в токенах, но платить мы должны в долларах. И вот эта разница превращает почти любой «экономайзер» в налог, и то, как это реально устроено, очень интересно, и сейчас, чтобы пойти дальше, надо понять, из чего ваш диалог реально состоит.
Из чего на самом деле состоит ваш диалог с агентом
Берём чуть адаптированную, но вполне реальную сессию из моих логов. Claude Code, Opus 5.5, начало работы над проектом. Я пишу агенту одну строчку:
Изучи проект от и до и погрузись в него
Это стоит примерно 15 токенов. Через пару минут агент отвечает аккуратной сводкой по архитектуре. На экране обычная переписка — два сообщения, ничего особенного, но вот если посмотреть, из чего состоит диалог, становится интересно.
Объёмы прямо из транскрипта — сколько токенов каждый шаг добавил в контекст (результат тула вместе с командой самого агента).
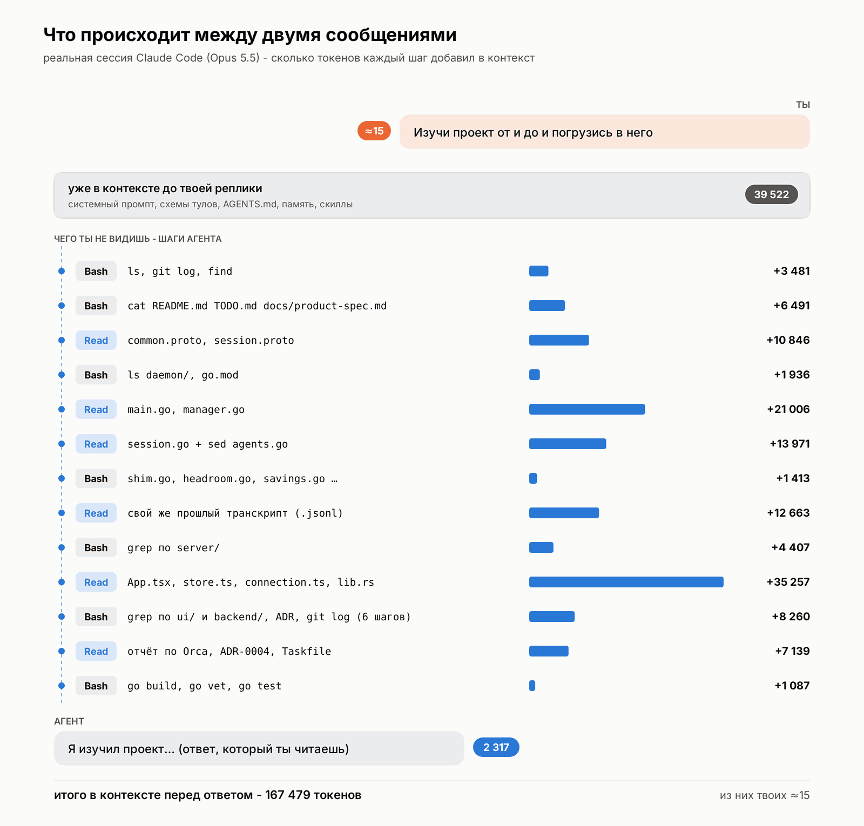
Да, в какой-то момент агент полез читать свой же прошлый диалог, что меня, кстати, удивило, но суть не в этом.
К финальному ответу контекст вырос с 39.5 до 167.5 тысяч токенов, и тут надо понять, кто и сколько «написал».
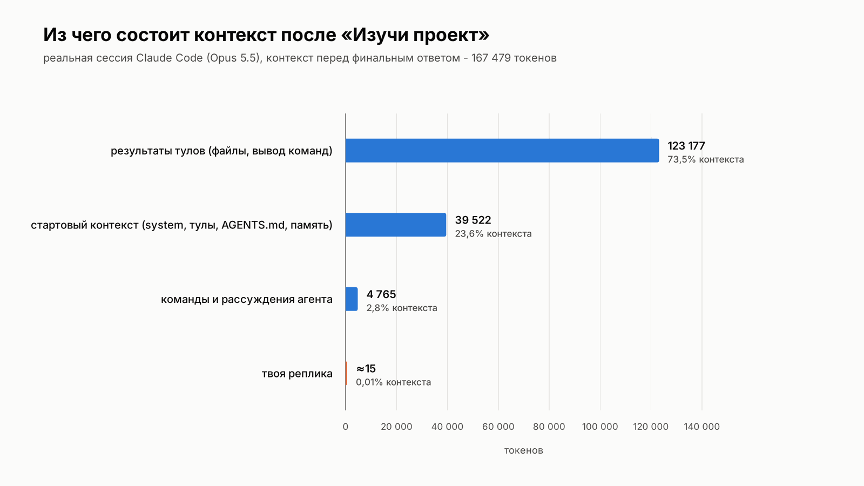
Моя реплика — это буквально одна сотая процента, а три четверти контекста — то, что агент сам притащил из репозитория (файлы целиком, вывод команд). Ещё четверть — стартовый контекст, который едет с вами в каждую сессию ещё до первого слова. В итоге мы видим, что сам агент «наговорил» меньше 3%.
А теперь вот главное. Модель между запросами ничего не помнит — это, думаю, все и так знают, — и в итоге, чтобы дописать финальный ответ на 2 317 токенов, агенту пришлось отправить ей все 167 тысяч токенов. Заново. 19 раз.
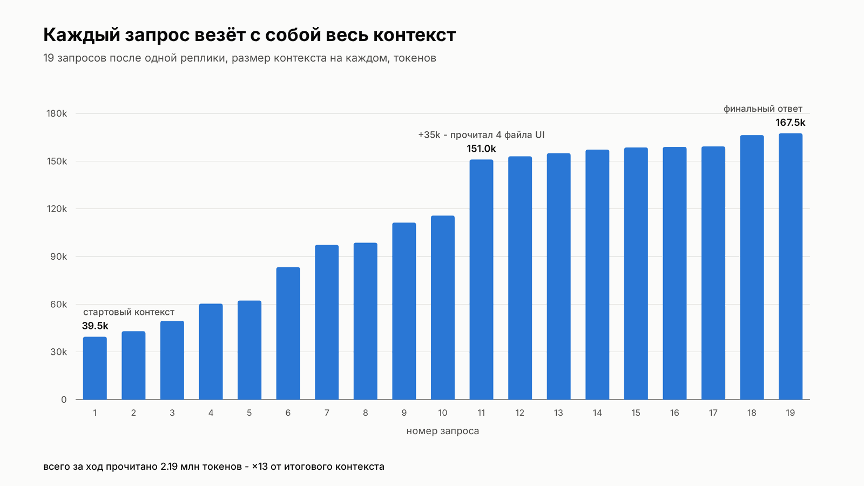
А теперь складываем столбики. За один ход агент отправил модели 2.19 миллиона токенов, при том, что сам диалог весит 167 тысяч, это буквально ×13. И это я написал всего одну строчку запроса…
Ведь если обобщить, агент работает циклом. Модель отвечает, просит вызвать тул (прочитать файл, запустить git status, поискать по коду), агент выполняет тул и отправляет модели следующий запрос — снова весь диалог целиком (который ещё и вырос после вызова тула/действия). Системный промпт, описания тулов, инструкции, всю историю, все прочитанные файлы и выводы команд.
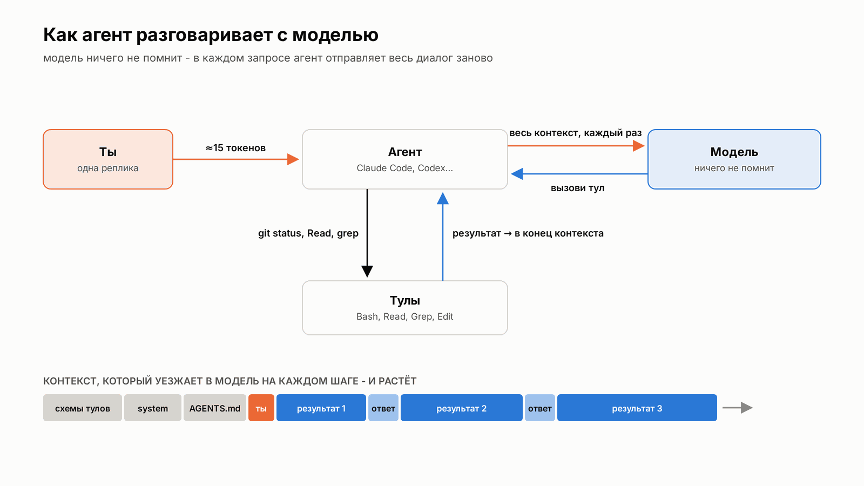
А ведь «Изучи проект» — это ещё небольшой кейс. Для сравнения, у меня медианный размер одного запроса к модели — 335 тысяч токенов, и таких запросов в средней сессии около сорока. И если бы я каждый раз платил за весь контекст по полной цене, агенты стоили бы как крыло самолёта. Ведь если мы возьмём с вами стоимость Opus 5.5 за 1 млн токенов, то поймём, как же дорого обойдётся нам одна задача. Но при таких ценах подписка бы просто не могла стоить 200 баксов (даже с учётом того, что она и так субсидированная), и нас спасает кэш промпта. Эту вещь люди считать не умеют — и поэтому повсеместно проваливаются в оптимизациях, от инструментов сжатия до всяких «умных роутеров».
А как работает кэш
Начало запроса запоминает любой провайдер, и если следующий запрос начинается теми же самыми байтами, это начало не считается заново, а читается из кэша. Получается, если не даром, то сильно дешевле. К примеру, порядок частей у Anthropic фиксированный — сначала схемы тулов, потом системный промпт, потом сообщения. И совпасть они должны точь-в-точь, с самого начала и до места первого отличия. Всё, что правее первого изменённого байта, пишется в кэш заново.
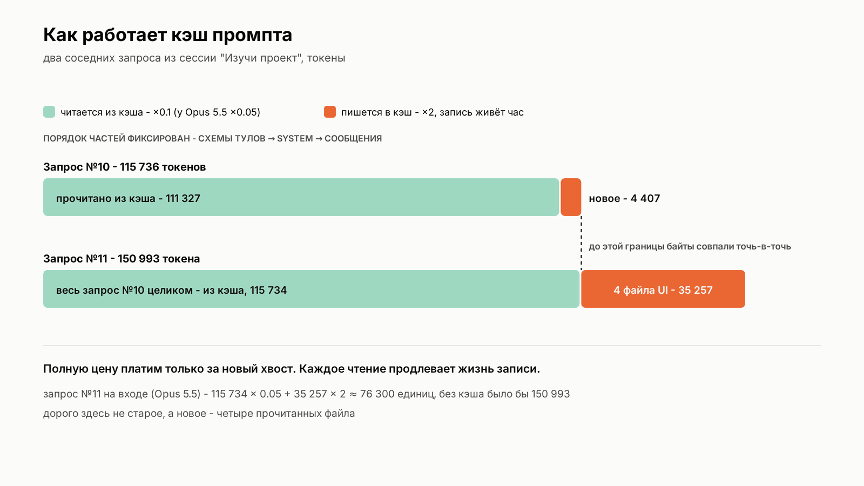
Запрос №11 начинается ровно с того же, чем был запрос №10, байт в байт. Поэтому все его 115 тысяч токенов прочитаны из кэша, а полную цену мы платим только за новый хвост — те самые четыре файла UI, примерно 35 тысяч токенов. Каждое чтение заодно продлевает жизнь записи, так что, пока агент работает без пауз, кэш тёплый.
И обратите внимание [5] на последнюю строчку. Даже с кэшем этот запрос стоит 76 тысяч единиц, и почти всё это — запись новых 35 тысяч, ведь дорого не старое, а новое. Это очень важно учитывать для будущего.
Возьмём цены в «единицах обычного входного токена» (для Sonnet).
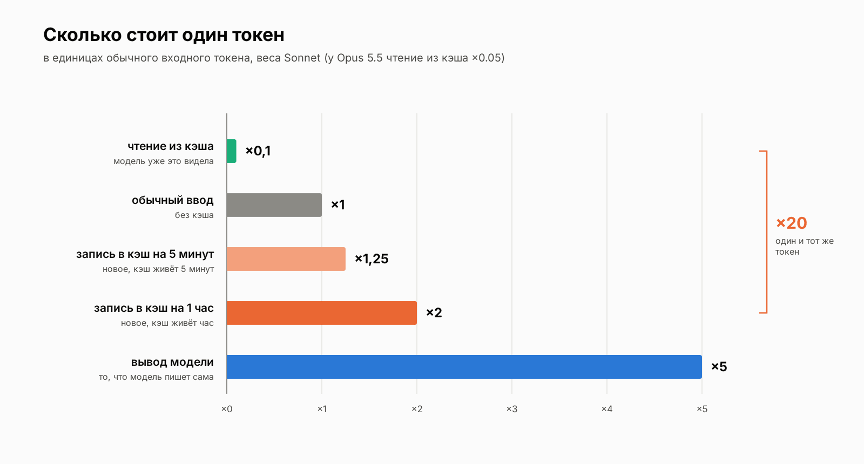
Один и тот же токен контекста стоит то ×0.1, то ×2, и разница эта в 20 раз. И зависит она не от того, сколько токенов в запросе, а от того, попал ли запрос в кэш :)
Для всего хода «Изучи проект» это выглядит так — 471 тысяча единиц с кэшем против 2.22 миллиона. Если бы за каждый из 19 запросов я платил по полной за весь контекст, получилось бы ×4.7. Без кэша агенты действительно стоили бы как крыло самолёта.
Вопрос «доделал?» за 600 тысяч токенов
А теперь самое весёлое из той же сессии. Вечером мы с агентом закончили на планировании, а утром, через 8 с лишним часов, я написал ему одно слово:
доделал?
Пара токенов, по идее. Агент проверил статус PR и ответил. Два запроса, всё.
Только кэш живёт час. За ночь он протух, и первый же запрос не прочитал контекст из кэша, а записал его заново целиком — 293 582 токена по цене записи. Сессия шла на Opus 5.5, у него чтение из кэша вообще умножаем на пять сотых, так что разница между «прочитать» и «записать» там уже в 40 раз.
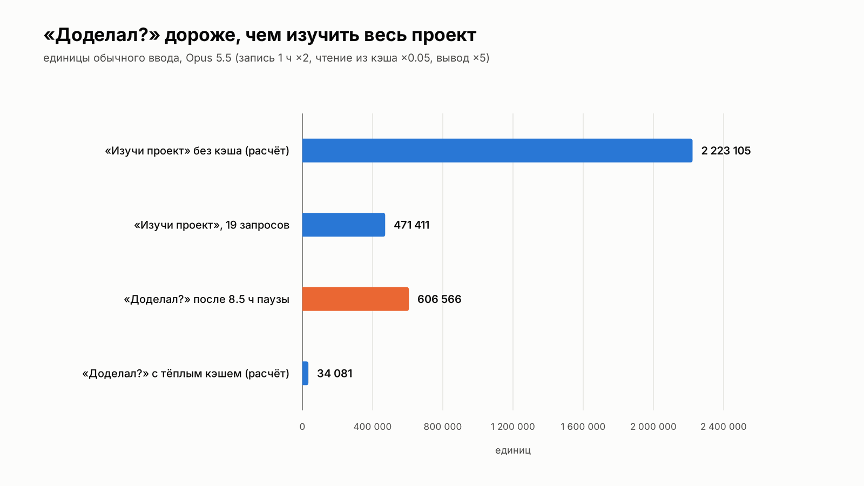
«Доделал?» обошёлся в 606 тысяч единиц. Это дороже всех 19 запросов «Изучи проект» (471 тысяча) — тех самых, где агент перелопатил полрепозитория. Спроси я то же самое, пока кэш был тёплым, вышло бы около 34 тысяч, почти в 18 раз дешевле.
И суть-то в чём: ни один «экономайзер» токенов тут ничего бы не сэкономил — токенов в реплике было от силы пара штук.
Почему ломается кэш
«Доделал?» — это только один способ. Вот ещё четыре, которые встречаются чаще всего.
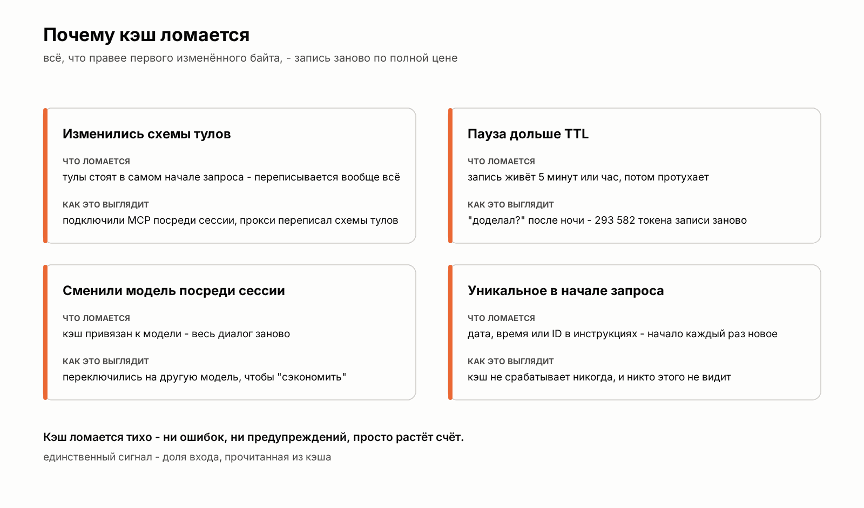
И самое неприятное — кэш ломается тихо, ни ошибок, ни предупреждений, агент отвечает так же хорошо, просто счёт растёт в разы. Единственный честный сигнал — доля входа, прочитанная из кэша. В замерах на Хабре у голого Claude Code она около 98%, и каждый процент вниз стоит дорого.
А теперь держите в голове первую карточку — про схемы тулов в самом начале запроса, поверьте, нам это очень пригодится.
Я выгрузил свой реальный счёт — 146 сессий, 35.5 тысяч запросов за два с небольшим месяца.
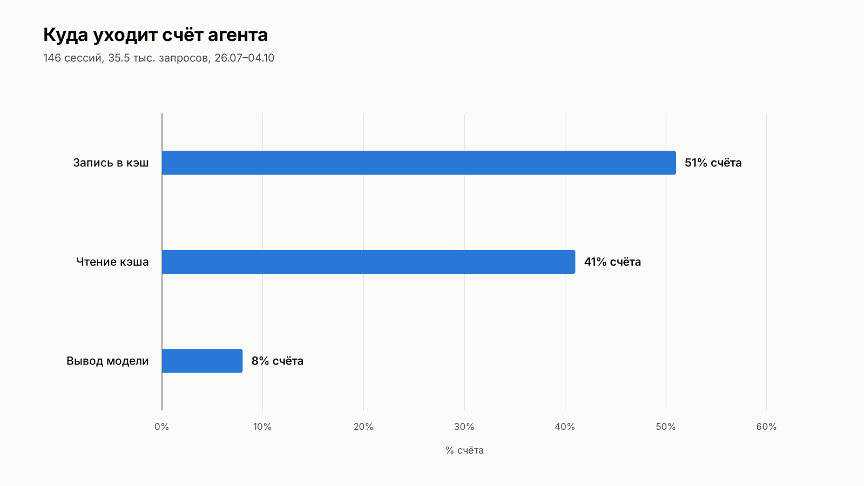
Ещё раз, 92% счёта — это кэш промпта, перечитывание и перезапись контекста. Причём 42% всего счёта — это перестройки контекста, который уже лежал в кэше и протух или сломался (26% — после пауз больше часа, остальное — внутри TTL).
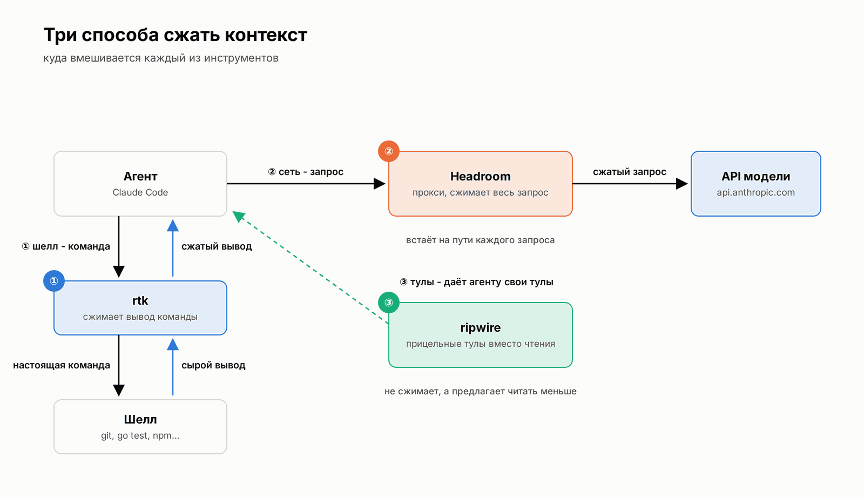
И отсюда выходит три инструмента для уменьшения потребляемого контекста
Идея у всех этих «экономайзеров» одна — положить в контекст меньше байтов. Отличается место, где они вмешиваются. И у наших трёх героев это три принципиально разные точки.
-
Шелл. Перехватываем команду и отдаём модели сжатый вывод. Три строчки вместо одиннадцати у git status. Это rtk.
-
Сеть. Вставляем прокси между агентом и API и сжимаем то, что агент отправляет. JSON, логи, старые выводы — всё, что выглядит толстым. Это Headroom.
-
Тулы. Не сжимаем ничего, просто даём агенту инструменты получше, чтобы он вообще не тащил в контекст лишнее. Вместо «прочитать файл на 800 строк» — «покажи мне функцию и кто её вызывает». Это ripwire.
Меньше токенов — меньше денег, что же могло пойти не так?
Начнём с rtk — просто CLI-прокси для команд шелла
Это один бинарь на Rust и одновременно с этим самый популярный из троицы.
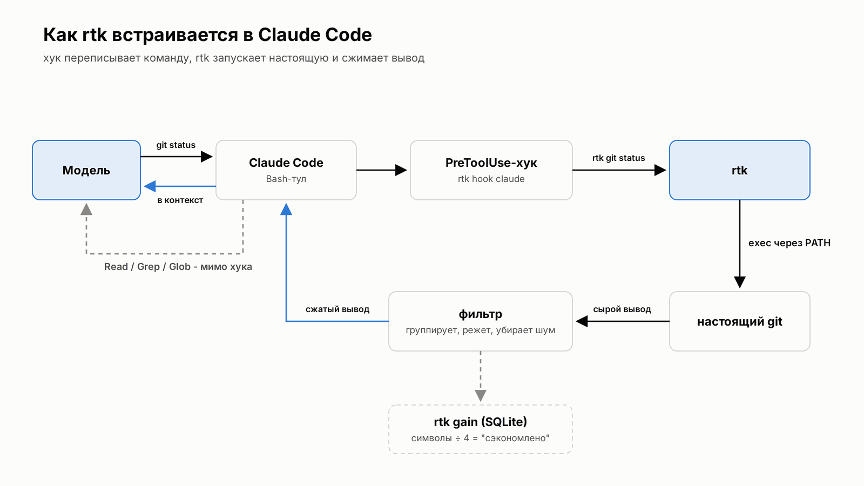
Работает просто. Когда, к примеру, агент вызывает git, он перехватывается агентом через hook, и rtk запускает настоящий git, забирает вывод и прогоняет через фильтр. Дальше фильтр группирует, обрезает, выкидывает шум и дубли, сохраняет код возврата и остальное. В итоге — модель получает сжатую версию.
И выглядит это реально приятно, в описании репозитория до сих пор написано «reduces LLM token consumption by 60-90%» («сокращает использование токенов на 60-90%»). В README долго висела таблица «Token Savings (30-min Claude Code Session)» — 12 операций, ~118 тысяч токенов превращаются в ~23.9 тысячи, −80%. Её можно посмотреть [6] в README версии v0.30.0 (строки 38-56). Мелким шрифтом под ней — «Estimates based on medium-sized TypeScript/Rust projects» («Оценки основаны на проектах среднего размера на TypeScript и Rust»). То есть это не замер, а частоты команд, умноженные на оценки.
А дальше очень весело: 22 июля, в день выхода исследования JetBrains, авторы закоммитили [7] docs: scope savings claims to bash output and document the estimator. Цитирую описание коммита — «RTK was documented as delivering „60-90% token savings“, which reads as a cost reduction. What RTK actually reduces is bash output bytes», по-русски: «В документации RTK заявлялось о сокращении количества токенов на 60-90%, что воспринимается как снижение затрат. Однако на самом деле RTK сокращает лишь объём вывода команд Bash в байтах». Вместе с таблицей удалили и другие цифры без источника — константу $3 за миллион токенов с примером на $36, «±10% tokenization accuracy», «99.5% hook-install». Таблицы сессий в самом коммите названы прямо — «invented session tables». То есть «выдуманными».
Теперь в README и в savings-explained.md честно написано [8], что 90% меньше вывода bash не делает сессию на 90% дешевле, экономия «dilutes at every step» («сокращается на каждом шаге»). Правда, в описании самого репозитория «60-90%» так и осталось. А после статьи JetBrains в rtk открыли [9] issue #3157 с заголовком «README is outdated – rtk makes agentic coding 7.6% more expensive» («README устарел: rtk делает агентное программирование на 7.6% дороже»), он до сих пор открыт.
Дальше идёт Headroom
Прокси между агентом и API, который сжимает всё, что агент отправляет. Самый амбициозный из троицы, и я в него даже верил, пока не понял, почему и как работает реальный счёт.
Как работает. Агент шлёт запросы не в API Anthropic, а в локальный Headroom (через
ANTHROPIC_BASE_URL). Headroom смотрит на тяжёлые куски и для каждого выбирает свой компрессор:
-
JSON — SmartCrusher, структурно. Выкидывает форматирование и повторы, оставляет ошибки [10], выбросы и первый/последний элементы.
-
Код — разбор по AST (Python, JS/TS, Go, Rust, Java, C/C++ и др.).
-
Логи и текст — собственная модель Kompress-v2-base, которая крутится локально.
А чтобы сжатие не стало безвозвратной потерей, есть CCR (Compress-Cache-Retrieve). Оригинал кладётся в локальное хранилище, а модели подсовывается тул headroom_retrieve. Если сжатого мало, она может попросить полный кусок. Будем честны, звучит очень хорошо, но, думаю, уже понятно, почему это не будет работать, с учётом устройства экономики.
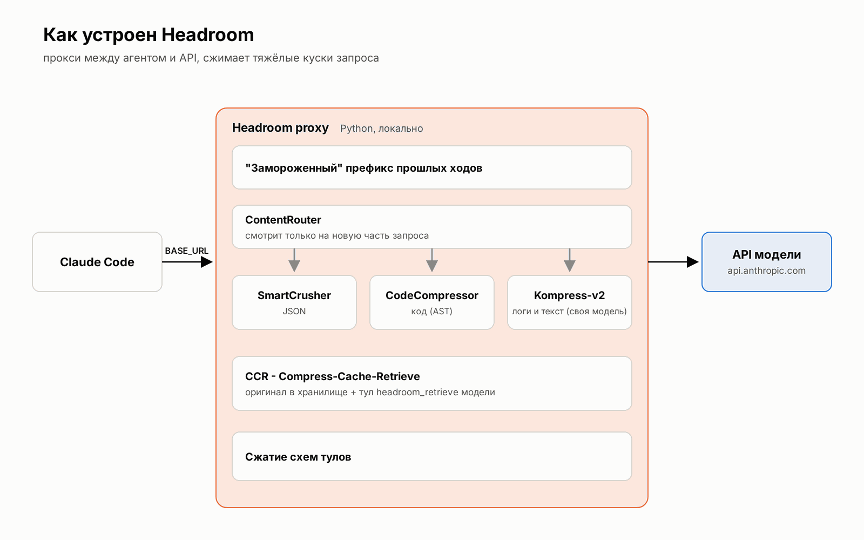
Есть два режима. cache (по умолчанию) замораживает прошлые ходы и сжимает только новое. token может переписывать и старые ходы ради максимального сжатия — ценой попаданий в кэш.
Сейчас у них в описании — «20% fewer tokens for coding agents, 60-95% fewer tokens for JSON, same answers» («На 20% меньше токенов для ИИ-агентов, на 60-95% меньше токенов для JSON — при тех же ответах»). Раньше заголовок был просто «60-95% fewer tokens» — так его цитирует [11] и статья на Хабре от 15 июля, а сводка cc.bruniaux.com [12] отмечает [13], что старый заголовок из README убрали. То есть «60-95%» тихо переехало с «токенов вообще» на «токены в JSON», а для агентов осталось 20%. В README есть раздел «Proof» — четыре синтетических сценария со сжатием от 21% до 57%, на повторяющихся JSON и логах больше 90%. И точностные бенчи (GSM8K, TruthfulQA, SQuAD), где качество не падает.
При этом все метрики авторов — это токены и точность. Ни одна не меряет итоговую стоимость с учётом кэша на живом агенте. А ещё в их же документации написано, что в режиме cache плитка «Tokens Saved» показывает около нуля. Сюрприз, да? :)
И ripwire — самый умный и самый честный из троицы
Code intelligence для агентов из организации redhat-et на GitHub.
ripwire на самом деле ничего не сжимает. Он парсит репозиторий через tree-sitter, строит граф вызовов, ранжирует символы Personalized PageRank и отвечает агенту плотным минифицированным XML, где искать, кто вызывает функцию, что сломается при правке, какие тесты гонять. Идея в том, чтобы агент вместо «прочитай файл целиком» спрашивал «покажи сигнатуру и вызывающих» — и тащил в контекст в разы меньше.
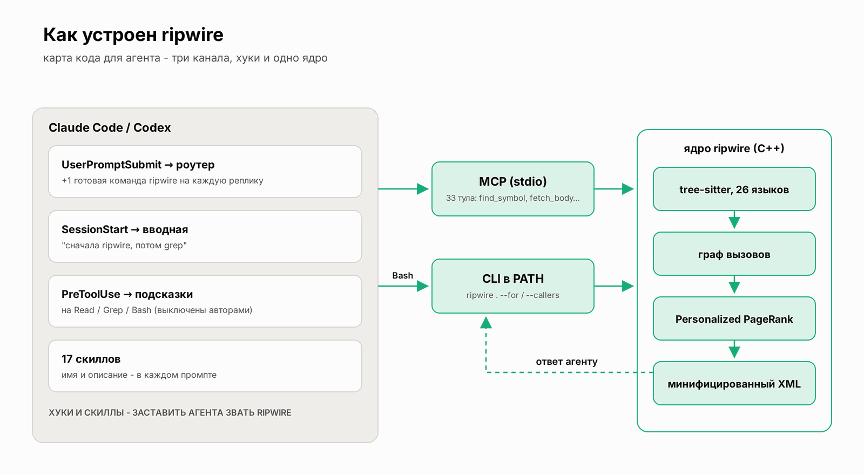
Но, как обычно, идём в их README и видим: «Fewer Tokens. Better Code.» (ну, тут понятно: «меньше токенов, лучше код»). Сигнатуры на 74.7% компактнее тел функций. Ответ на вопрос «кто вызывает» в 69-89 раз меньше, чем grep + чтение.
И вот тут ripwire выгодно отличается. У них есть docs/EVALS.md на 14.5 тысяч строк с заранее зарегистрированными гипотезами и опубликованными провалами. По поиску они реально лучшие — на LocBench 36.7% против 26.7% у codebase-memory и 13.3% у Aider. А в прогоне с живым агентом (Sonnet, 48 прогонов) решаемость 15/24 против 15/24 и −9.2% токенов вывода. Вход и кэш не мерили. Пилот на Codex дал +80% токенов вывода, и авторы сами его отозвали как несравнимый.
Как я встроил их в Tobari
Теперь к практике. У меня тут интеграция в демон, который сам поднимает окна агентов. Поэтому каждый инструмент встраивался по-своему.
rtk — через шимы. Хуки rtk у разных агентов пишутся в пяти диалектах, а у Grok в headless-режиме хуки не исполняются вовсе. Поэтому я сделал по-другому. Демон кладёт каталог шимов первым в PATH каждого агентского окна. Шим — это симлинк на бинарь демона с именем команды (git, go, npm, pytest и так далее), который через exec передаёт управление rtk. Так rtk должен был ловить даже то, что не видит хук, — вложенные вызовы, цепочки, агентов без хуков. Плюс каждый вызов логируется, чтобы видеть покрытие.
Полетела первая же шишка — git diff > model.patch записал в файл сжатую сводку вместо патча, и SWE-bench его не принял. Пришлось ввести правило «сжимаем только то, что читает человек или модель в терминале». Если stdout — файл или пайп, rtk не включается.
Спайк на живых командах выглядел обнадёживающе — git diff −67%, git log −66%, git status −40%. Правда, мелкий go test подрос на 100% (да-да, сжатый вывод вышел длиннее сырого).
Headroom — прокси на демон. Один процесс Headroom на демон, агентские окна Claude Code получают ANTHROPIC_BASE_URL на него. Я поставил режим cache, он самый бережный к кэшу. Если прокси молчит больше 45 секунд, процесс перезапускается, а окно, которое не дождалось прокси за 12 секунд, стартует напрямую. Ну и да, через пару разделов выяснится, что механика эта влетит мне в копеечку.
ripwire — на трёх уровнях. Бинарь в PATH, 17 скиллов симлинками в каталоги скиллов агента и MCP-сервер в каждое окно Claude Code и Codex. Логика [14] была простая — бинарь сам по себе мёртв (175 флагов, агент не знает, когда его звать), значит, нужны скиллы и MCP. Хуки ripwire я сознательно не ставил — они пишут в глобальный ~/.claude/settings.json.
Мнение «мне кажется, стало дороже» ничего не стоит
Поэтому я собрал tobari-bench с очень простыми правилами.
-
Парные прогоны. Одна и та же задача — голый Claude Code против Claude Code с рычагами.
-
Изоляция. Агент не видит моих настроек и моего AGENTS.md (иначе +11k промпта мимо эксперимента).
-
Прогрев кэша перед замером и проверка на каждом окне, что рычаги реально включились.
-
Мера у нас тут деньги, а не «сколько сэкономил инструмент». Формула из схемы весов выше, для Sonnet она совпадает с total_cost_usd самого Claude Code до процента.
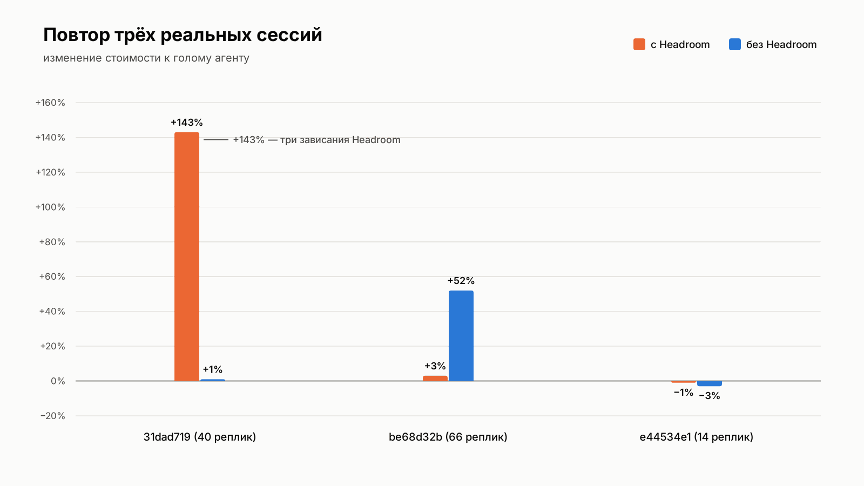
Два набора задач. 30 задач SWE-bench Verified средней сложности (Sonnet 5.5, задача на сессию) и повтор трёх моих реальных длинных сессий — 120 реплик, контекст до 150-250k.
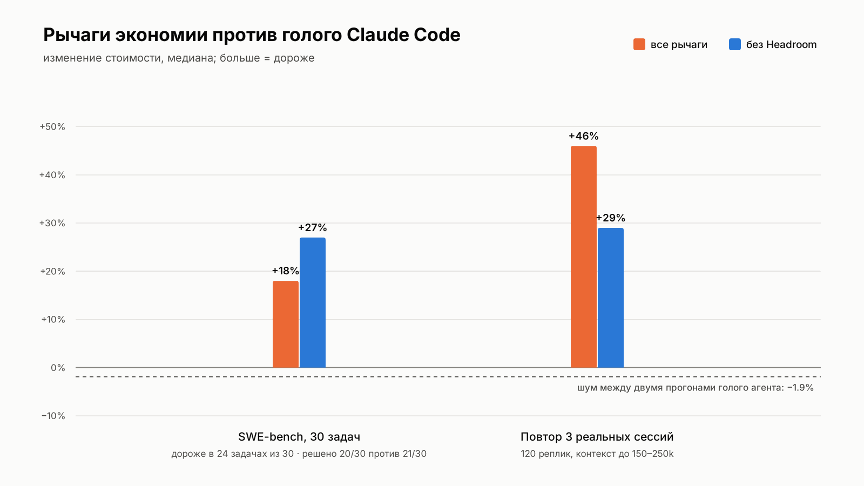
Шум между двумя прогонами голого агента — около 2%. Это такая погрешность.
Странная деталь — на SWE-bench «без Headroom» дороже, чем «с Headroom». Но радоваться за Headroom вот так с ходу не стоит, сейчас разберём по очереди, и всё встанет на места.
rtk сжимает честно, но дорого
Начнём с самого популярного. Тут лучше всего пригодится JetBrains, на 86 задачах SkillsBench, 425 оплаченных прогонов, Claude Code с rtk против голого. Результат — +7.6% к счёту на low effort (p=0.004) и ровно ноль на high. И качество было одинаковое.
Так откуда взялся плюс? Ходов стало на 13.8% больше, чтений кэша на 14.3% больше, ведь сжатый вывод иногда теряет деталь, которая была нужна, и агент идёт за ней ещё раз. А каждый лишний ход перечитывает весь контекст. В итоге у rtk в трекере это выглядит так:
-
#1313 [15] — молчаливые лимиты. git status показывает 15+10 файлов, grep — 200 совпадений, diff — 10 изменений на файл.
-
#4421 [15] — «зелёная» сводка тестов при ненулевом коде возврата.
-
#3410 [16] — find -exec и find -delete после переписывания молча ничего не делают.
Хорошо, а если бы сжатие вообще ничего не теряло? Тут ещё смешнее.
-
Read, Grep, Glob, Edit — не шелл. Это встроенные тулы Claude Code, мимо них хук не пройдёт. И авторы rtk это честно пишут в README.
-
Больше 60% вывода Bash дают sed, cat, grep, echo, ls. Через cat и sed агент читает код, который потом правит, в итоге ты его в целом невозможно корректно сжать.
То есть даже в идеальном мире rtk бьёт в узкую щель, и JetBrains посчитали её размер на своих транскриптах — хук мог тронуть 33% bash-вызовов, это ~20% символов результатов тулов, то есть потолок экономии ≈3% входа. Всего 3%!
Headroom ломает кэш, а взамен ничего не сжимает и увеличивает счёт
У меня Headroom стоял в самом бережном режиме cache, в итоге он НИЧЕГО НЕ СЖИМАЛ. У него есть открытый issue #3561 [17] — в версиях с 0.30 по 0.37 на пути Anthropic не срабатывает ни один компрессор содержимого. Работают только сжатие схем тулов и отложенная загрузка тулов. Причина нашлась в комментариях — компрессоры отключаются, когда метка кэша стоит одновременно на системном промпте и на последнем сообщении пользователя. А Claude Code именно так шлёт каждый запрос. При этом headroom doctor зелёный, а дашборд исправно рисует цифры. У меня стояла 0.37.
Но кэш ломался. Я сравнил первый запрос в одинаковых каталогах.
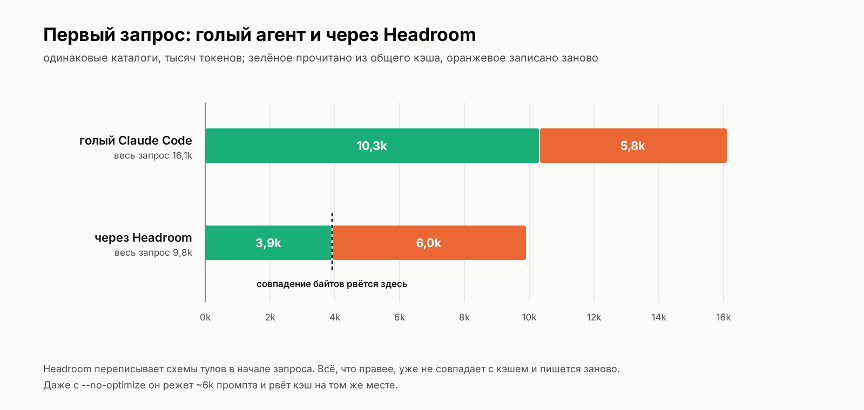
Через прокси из общего кэша читались только первые ~3.9 тысячи токенов — всё остальное каждый прогон писалось заново. Headroom переписывал схемы тулов, и совпадение байтов рвалось почти в самом начале. Даже с флагом –no-optimize он урезал промпт примерно на 6k и ломал кэш на том же месте. Простой reverse-proxy на Go, который я поставил для сравнения, ничего такого не делал.
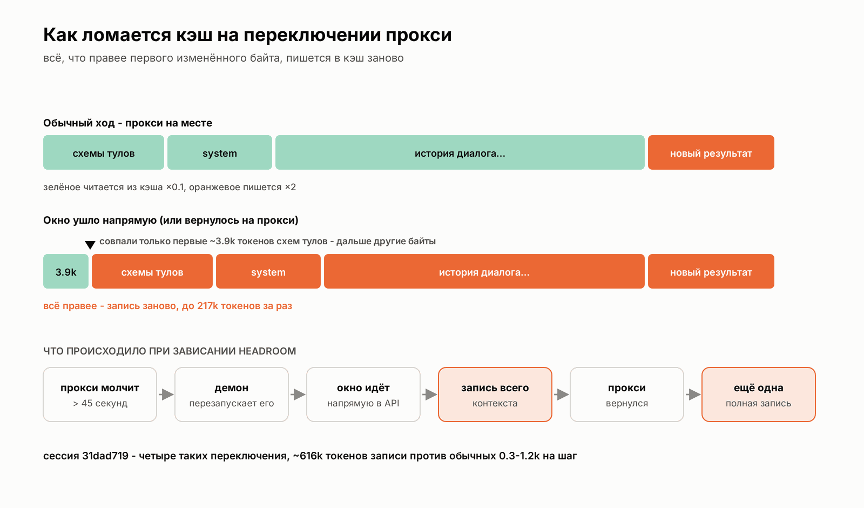
Вот как это выглядит в моей сессии (повтор реальной работы, 40 реплик).
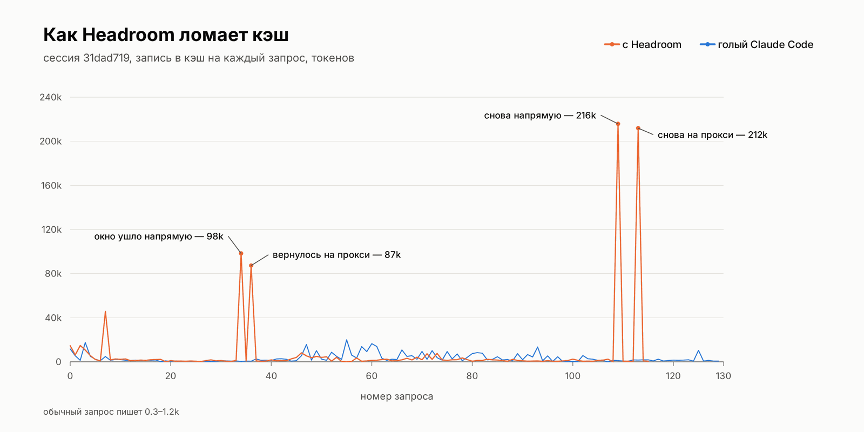
Обычный шаг пишет в кэш 0.3-1.2 тысячи токенов. Эти четыре шага записали ~616 тысяч. Время запросов в транскрипте совпадает с записями «окно стартует напрямую» в логе демона до минуты. Итог сессии — +143% к голому агенту. В той же сессии без Headroom было +1%.
Окей, ладно, допустим, баг #3561 починят, и это поможет? Дмитрий Афонченко на Хабре покопался [11] в логах Headroom и нашёл ещё одну деталь, реально фундаментальную проблему. Чтобы сжимать безопасно, Headroom должен подсунуть модели тул headroom_retrieve (иначе сжатое — это просто потерянные данные). Но добавить тул — это изменить начало запроса, то есть сломать кэш.
Поэтому в режиме cache он тул недобавляет (CCR: deferring tool injection … to preserve cache). Как следствие, не сжимает старые чтения. В режиме token сжимает — и ломает кэш.
Гениально в своей простоте. Либо экономишь токены и переплачиваешь за кэш, либо бережёшь кэш и ничего не экономишь, то есть сам продукт в целом технически не может функционировать корректно.
Теперь про странность с SWE-bench. Почему «без Headroom» вышло дороже (+27%), чем «с Headroom» (+18%)? Потому что в варианте «без Headroom» остаётся ripwire со своим постоянным следом в промпте, который никто не вызывает. А Headroom срезает ~6k промпта — схемы тулов. Эта срезка частично перекрывает его собственную поломку кэша на коротких задачах. Отдельного плеча «только Headroom» у меня не было, так что его чистый вклад на SWE-bench не выделен. Зато на длинных сессиях, где он успевает зависнуть, картина однозначная — +46% против +29%.
ripwire — это вообще инструмент, которым никто не пользуется
Третий пациент интересен тем, что он не ломает кэш и не прячет данные. Он просто лежит в промпте.
0 вызовов за ~250 прогонов. Ни SWE-bench, ни повтор моих сессий — агент ни разу не позвал ripwire. Он читал код через grep -n … -A 30 и sed -n 150,245p, как всегда.
А платили каждый ход. Описания 17 скиллов (~2.2k токенов) и MCP (~0.6k) — это ~2.9k токенов, которые лежат в каждом запросе. За прокси они ещё и каждый прогон писались в кэш заново. Это и есть главная причина +27% на SWE-bench «без Headroom». Платишь за инструмент, которым никто не пользуется, чисто как я в спортзале.
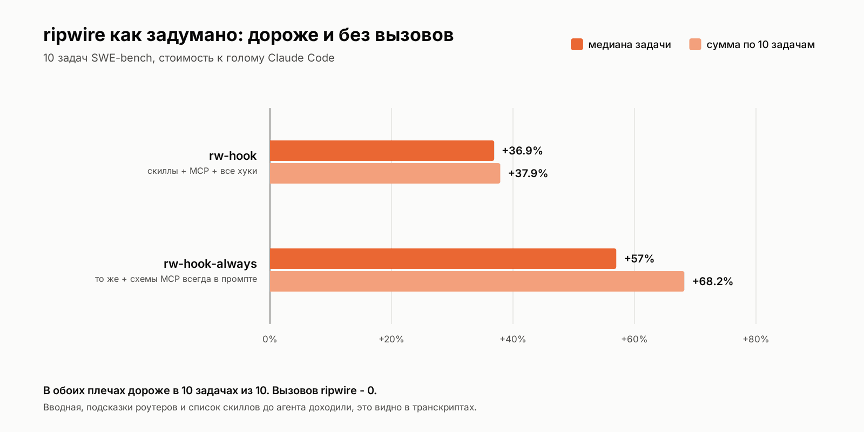
Всё доходило до агента, в транскриптах это видно. Вводная, 18 готовых команд от роутера по репликам, 8 — от роутера по вызовам тулов, инструкции MCP, список скиллов, но вызовов получалось ноль.
И это не только у меня. У самих авторов ripwire в hooks/ripwire-nudge.sh [18] есть раздел RETIRED — 2 сентября они выключили подсказки на вызовы тулов, потому что рандомизированный A/B на сотнях сессий не нашёл никакого эффекта. А в #381 [19] пользователь выложил полевые данные по роутеру за месяц — 18 968 реплик, 1 959 рекомендаций, 0 принятых. Мейнтейнеры признали окно A/B недействительным.
Тогда я заставил его работать. Добавил хук, который запрещает агенту Grep, Glob, поиск и чтение через Bash, а Read и Edit разрешает только после первого вызова ripwire (и читать — кусками не больше 80 строк). Тут агент наконец позвал ripwire 22 раза (13 grep, 5 find_symbol, 2 fetch_body, 1 replace_symbol_body, 1 через CLI) и 20 раз упёрся в запрет.
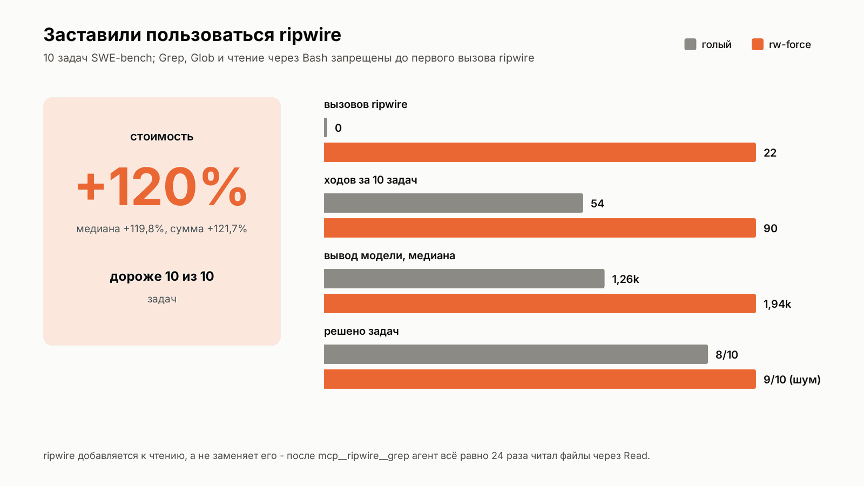
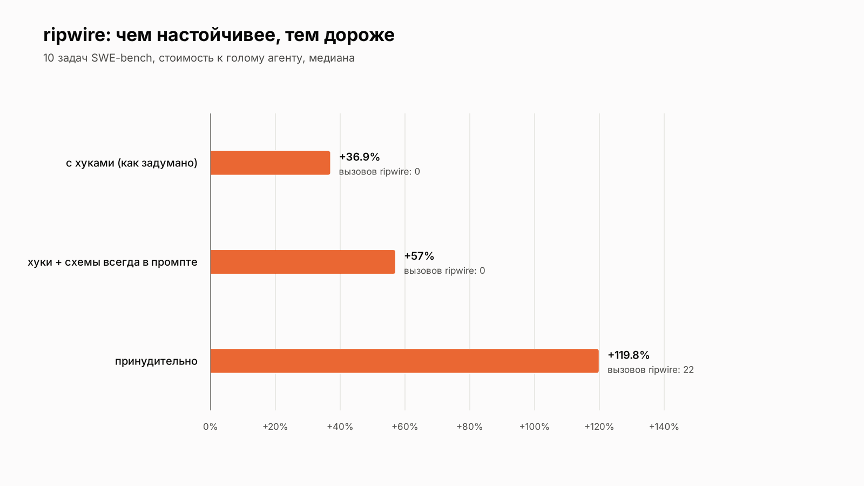
Почему так дорого? Потому что ripwire не заменяет чтение, а добавляет к нему. Claude Code не даёт сделать Edit без предварительного Read. Значит, вместо «Read → Edit» получается «попытка → отказ → ripwire → Read → Edit». После mcp__ripwire__grep агент всё равно 24 раза читал файлы через Read. А ответы ripwire не меньше прицельного sed — grep ~0.7k символов, find_symbol ~1.7k, а replace_symbol_body вернул 18.7k символов, больше целого файла. Каждый лишний ход — это перечитывание всего контекста.
Почему агент его не берёт. Главная помеха — отложенная загрузка MCP-тулов в Claude Code. Агент видит только имя тула, а схему должен подгрузить отдельным шагом. Я проверил это на своём маленьком MCP поверх ripwire (3 тула, ~290 токенов схем). С отложенной загрузкой — 0 вызовов. С флагом alwaysLoad в конфиге MCP (схемы всегда в промпте) — 9 вызовов на 10 задачах. Денег это не сэкономило (+3%, шум) — на коротких задачах агенту хватает одного-двух чтений.
А потолок? Исходники — это ~8% контекста моих длинных сессий. Даже если ripwire будет использоваться всегда и сократит чтение кода вдвое, это ~3-4% счёта. А лучшая денежная цифра самих авторов (−9.2% токенов вывода) при доле вывода 8% — это меньше 1% счёта.
Давайте честно. ripwire — хороший поисковик (по LocBench лучший), и авторы сами пишут, что он окупается на холодной ориентации в большом незнакомом репозитории и «does not pay on a question one grep already answers», то есть «не тратит деньги на вопрос, на который уже может ответить один grep». Только вот экономию счёта не показали ни их тесты, ни мои.
И это не только у меня
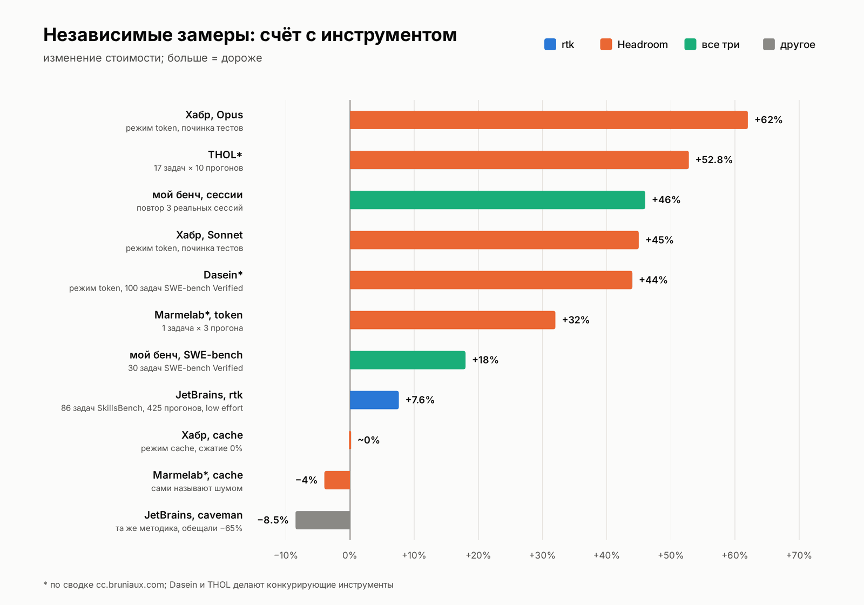
Дальше всё — по сводке cc.bruniaux.com [13]. Dasein и THOL делают авторы конкурирующих инструментов, это обязательно надо учитывать.
Медиана по независимым замерам Headroom — +32%. Ни одного замера, где кто-то из троицы стабильно уменьшил бы счёт, я не нашёл :D
У Афонченко есть отличный материал: сам Headroom отчитался, что сжал контекст на 2%. А вся разница в цене — это попадание в кэш, которое упало с ~98% до ~94%. Всего четыре процента, но нет, как бы не так!
Немного математики
Давайте посчитаем на моих реальных цифрах. Медианный контекст — 335k токенов, цена в «единицах обычного ввода» из таблицы выше.
Обычный ход с тёплым кэшем. Агент перечитывает весь контекст из кэша.
335 000 × 0.1 = 33 500 единиц
Тот же ход, если кэш сломался. Весь контекст пишется заново по часовому тарифу.
335 000 × 2 = 670 000 единиц → в 20 раз дороже обычного хода
Сколько стоит «сэкономить» вывод команды. Допустим, rtk сжал вывод на 2 000 токенов. Эти токены один раз записываются в кэш и дальше перечитываются каждым ходом. В средней сессии у меня 40 запросов, значит, после сжатия впереди в среднем ~20 ходов.
экономия = 2 000 × 2 (запись) + 2 000 × 0.1 × 20 (чтения) = 4 000 + 4 000 = 8 000 единиц поломка = 670 000 − 33 500 ≈ 636 500 единиц 636 500 / 8 000 ≈ 80
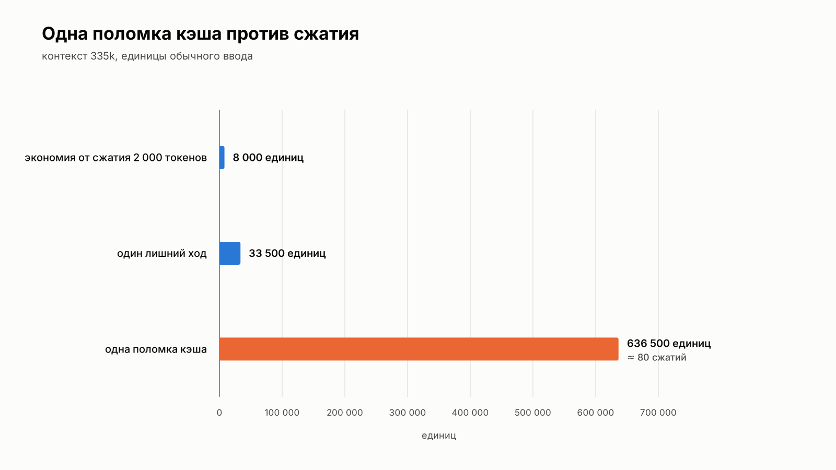
Одна поломка кэша съедает экономию от восьмидесяти (ох**ть) таких сжатий. А один лишний ход на моём контексте (33 500 единиц) съедает экономию от четырёх. Вот и весь фокус. Инструмент, который хотя бы изредка трогает префикс (Headroom), добавляет что-то в начало промпта (ripwire) или провоцирует лишний ход (rtk), заранее проиграл.
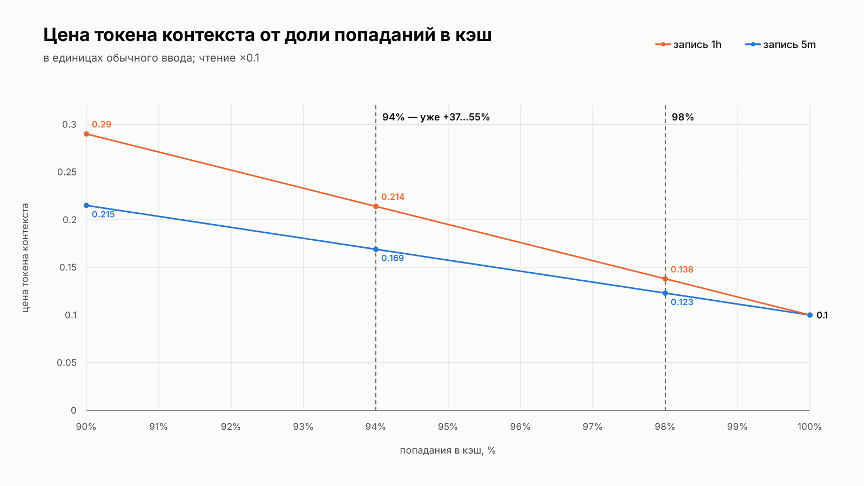
Почему 4% промахов кэша — это не 4%. Средняя цена токена контекста зависит от доли попаданий в кэш h.
цена = h × 0.1 + (1 − h) × цена_записи
h = 98%, запись 1h (×2): 0.98 × 0.1 + 0.02 × 2 = 0.138 h = 94%, запись 1h (×2): 0.94 × 0.1 + 0.06 × 2 = 0.214 → +55% h = 98%, запись 5m (×1.25): 0.98 × 0.1 + 0.02 × 1.25 = 0.123 h = 94%, запись 5m (×1.25): 0.94 × 0.1 + 0.06 × 1.25 = 0.169 → +37%
Упали с 98% до 94% попаданий — и вход дорожает на 37-55%. Афонченко намерил для Headroom +45…62%. Прикидка (только по входу, без вывода модели) и живой замер ложатся в одну вилку. Сжатие контекста в лучшем случае двигает цену на проценты. Промах кэша двигает её на десятки процентов.
Почему длинные сессии такие дорогие. Если контекст растёт примерно на одинаковую величину Δ за ход, то ход номер k стоит ~k × Δ × 0.1. Сумма за сессию из n ходов растёт как квадрат.
счёт сессии ≈ 0.1 × Δ × n² / 2
Сессия в два раза длиннее — в четыре раза дороже (это упрощённая модель, но мои данные с ней согласуются). Ходы, начатые при контексте больше 300k (14% всех ходов), дают 38% счёта, а ход при больше 500k в 6 раз дороже хода при меньше 100k. Деньги не в болтливых командах, они в хвосте длинной сессии.
А где тогда деньги?
И вот тут начинается самое интересное. Я поднял свой наблюдатель кэша (cacheproxy — прокси, который ничего не меняет, только записывает, что и где ломается) и неделю смотрел на реальную работу.
-
Размер контекста. Ходы, начатые при контексте больше 300k (14% ходов), дают 38% счёта.
-
Паузы. Перестройки после пауз больше часа — 26% счёта за два месяца по транскриптам и 8.8% за 4.5 дня под наблюдателем (разные периоды и разная нагрузка). Почти все — в окнах больше 200k.
-
Статичная база. Инструкции, схемы тулов, память [20], списки скиллов и MCP — медиана ~69k токенов на первом запросе — перечитываются каждым ходом, это ≈19% счёта.
-
Мой собственный AGENTS.md вырос с 17 до 82 КБ за две с половиной недели (ха-ха).
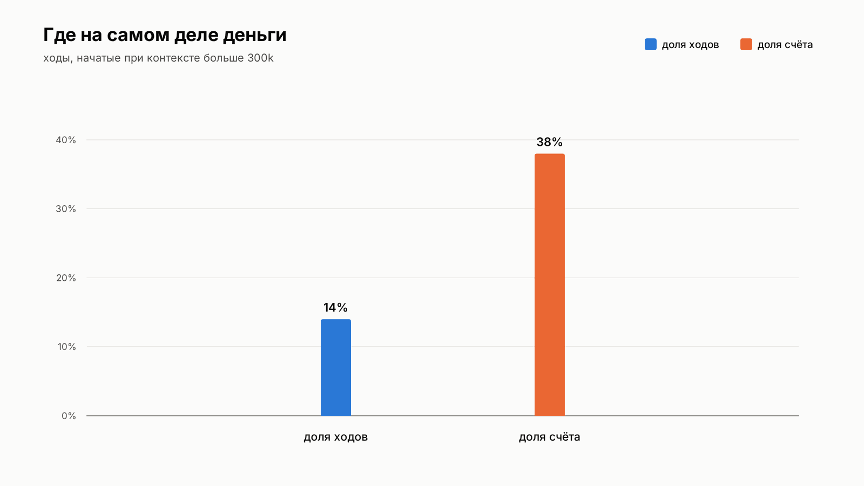
Суть простая. Неважно, сколько строк выплюнул git status. Деньги в том, какой огромный контекст ты таскаешь за собой и как часто он вылетает из кэша.
Реально работает только то, что дружит с кэшем
-
Кэш под тип окна. Для коротких автоматических задач TTL 5 минут и статичный системный промпт дали −21.5% (дешевле в 26 задачах из 29). Но для интерактивной работы тот же TTL 5m — это +10%, потому что люди делают паузы и кэш успевает протухнуть.
-
Не продолжать остывшее огромное окно. Если окно простояло больше получаса и в нём больше 150-300k, свежая сессия с дайджестом вместо продолжения — −13…15% в модели на моих данных.
-
Idle compaction. Claude Code с недавних пор сам сжимает контекст на простое перед истечением часового кэша (в changelog этого нет, вся инфа лежит в issue #98747 [21]). У меня это включилось 8 октября, и счёт на запрос упал на 15%, средний контекст — с 356k до 270k. Вендор сделал то, что обещали все эти «экономайзеры», только с правильной стороны — там, где кэш и так вот-вот протухнет.
И это ключ ко всему. Сжатие окупается только там, где кэш и так пишется заново, — на старте сессии или в остывшем окне. Посреди живой сессии любая правка префикса стоит перезаписи всего хвоста по двойной цене и почти никогда не окупается.
Будем реалистами
-
rtk бьёт в щель, через которую буквально идёт несколько процентов счёта;
-
Headroom встаёт на пути каждого запроса, и любая его ошибка — это перезапись всего контекста;
-
ripwire берёт плату за присутствие в промпте каждым ходом, а агент им не пользуется, а как заставишь — будет иногда вдвое дороже.
И что с этим делать? Об этом расскажу в продолжении, а то пост и так получился огромный. Спойлер — будет про проксирование моделей.
Автор: ZergsLaw
Источник [22]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38662
URLs in this post:
[1] опубликовали: https://blog.jetbrains.com/ai/2026/07/rtk-claude-code-token-savings/
[2] признали: https://www.bleepingcomputer.com/news/artificial-intelligence/anthropic-is-cutting-claude-codes-current-weekly-limits-by-17-percent/
[3] выкатил: https://thenextweb.com/news/openai-devday-pro-200-usage-cut-pro-500-plan
[4] замерили: https://fourweekmba.com/ai-same-200-claude-plan-two-limits-one-gets-20-less-a-week/
[5] внимание: http://www.braintools.ru/article/7595
[6] посмотреть: https://github.com/rtk-ai/rtk/blob/v0.30.0/README.md
[7] закоммитили: https://%5Dhttps://github.com/rtk-ai/rtk/commit/a1673f7428968adcb6bc0a6e68e6d67a8f8f2342
[8] написано: https://github.com/rtk-ai/rtk/blob/master/docs/guide/resources/savings-explained.md
[9] открыли: https://github.com/rtk-ai/rtk/issues/3157
[10] ошибки: http://www.braintools.ru/article/4192
[11] цитирует: https://habr.com/ru/articles/1058780/
[12] cc.bruniaux.com: http://cc.bruniaux.com
[13] отмечает: https://cc.bruniaux.com/token-savings/
[14] Логика: http://www.braintools.ru/article/7640
[15] #1313 : https://github.com/rtk-ai/rtk/issues/1313
[16] #3410: https://github.com/rtk-ai/rtk/issues/3410
[17] #3561: https://github.com/headroomlabs-ai/headroom/issues/3561
[18] hooks/ripwire-nudge.sh: https://github.com/redhat-et/ripwire/blob/main/hooks/ripwire-nudge.sh
[19] #381: https://github.com/redhat-et/ripwire/issues/381
[20] память: http://www.braintools.ru/article/4140
[21] #98747: https://github.com/anthropics/claude-code/issues/98747
[22] Источник: https://habr.com/ru/companies/h3llo_cloud/articles/1105992/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1105992
Нажмите здесь для печати.