Агенты тоже пользователи: зачем приложениям нужны оценки
Эта статья перевод оригинальной статьи «Agents are users, so your software needs evals [1]».
Также я веду телеграм канал «Frontend по‑флотски [2]», где рассказываю про интересные вещи из мира разработки интерфейсов и AI.
Вступление
Агенты уже пользуются приложениями и выполняют работу от имени людей. Независимо от того, создаёте ли вы самого агента или приложение, которым он пользуется, будь то API, CLI, MCP-сервер или SDK, оценки помогают измерить, насколько хорошо выполняется работа.
Агенты, вероятно, пропустили ваше видео о запуске и рекламный щит на шоссе 101. Тем не менее они проходят ту же воронку, что и люди: обнаружение продукта, выбор, получение доступа и успешное выполнение задачи.
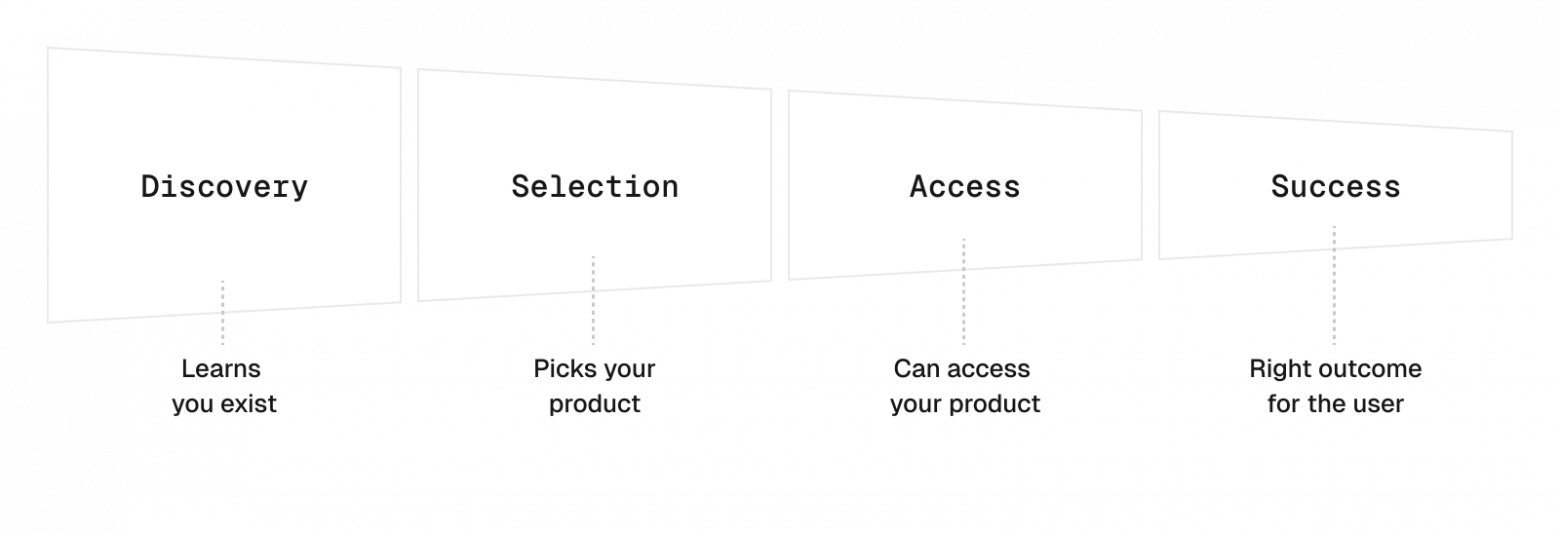
На каждом следующем этапе воронки остаётся меньше агентов, как и в случае с людьми. На схеме этапы поясняются так: агент узнаёт о продукте, выбирает его, получает к нему доступ и добивается правильного результата для пользователя.
Оценки можно построить для любого из этих этапов. В этой статье речь пойдёт о последнем: правильно ли агент выполнил задачу пользователя.
Проверить это сложнее, чем кажется. Агент может «успешно» заказать горячий латте, когда пользователь просил холодный. Запрос прошёл, и в системе наблюдаемости всё выглядит нормально. Кроме того, ответы LLM меняются от запуска к запуску, поэтому один удачный ручной тест не покажет, сработало ли исправление. Нужно повторять [3] одни и те же задачи и оценивать результаты до и после изменения.
Оценка (eval) и есть такой тест: его запускают много раз и выставляют баллы за результаты.
Пирамида тестирования агентных систем
Если обычный тест отвечает на вопрос «сработало ли это?», оценка отвечает на вопросы «как часто это работает и насколько хорошо?».
Авторы делят тесты агентных систем по типичному числу вызовов LLM: детерминированные тесты (0), одноходовые оценки (1) и сквозные оценки (2 и более за всю задачу). Эта классификация помогает примерно оценить трудоёмкость создания, время и стоимость запуска. Как и в практической пирамиде тестирования [4], основную часть набора должны составлять дешёвые и быстрые тесты.
Традиционная пирамида тестирования применима и к агентам: чем больше вызовов LLM, тем обычно выше затраты труда и денег. В основании находятся детерминированные тесты без вызовов модели, над ними одноходовые оценки с одним вызовом, а на вершине сквозные оценки с двумя и более вызовами.
При выборе уровня начните с проблемы, которую хотите обнаружить, и выберите самый низкий уровень, способный её выявить. Для проверки успешного выполнения нужен верхний уровень. Одноходовая оценка проверяет отдельное решение, например первую команду агента. Успех же зависит от всей последовательности: поиск кафе, отбор по условиям пользователя, заказ латте. Каждый шаг по отдельности может выглядеть разумным, а результат всё равно окажется неверным.
Сквозная оценка позволяет агенту выполнить задачу в заданной среде, после чего проверяет итог на соответствие требованиям пользователя. Популярные бенчмарки для программирования, например SWE-bench [5] и Terminal-Bench [6], относятся именно к этому типу.
Пример
Допустим, у вас есть SF Beans, API для заказа кофе в Сан-Франциско. Чтобы агенты могли пользоваться сервисом, вы выпускаете CLI sfbeans. Типичный запрос клиента:
Закажи мне большой холодный латте с цельным молоком, чтобы его можно было забрать к 9:00, дешевле $8 с чаевыми. Я в районе Мишен.
В 8:30 sfbeans знает следующее:
-
Fog City Roasters: сломалась машина для льда, холодных напитков сегодня нет.
-
24th St Beans: латте стоит $7,50 по меню, но $9,27 с налогом и чаевыми.
-
Dolores Drip: латте стоит $5,50, но раньше 9:20 его не забрать.
-
Valencia Grind: $7,42 с налогом и чаевыми, готов к 8:50. Подходят все три условия.
|
Уровень |
На какой вопрос отвечает |
Пример для sfbeans |
|---|---|---|
|
Детерминированный тест |
Приложение работает так, как ожидается? |
|
|
Одноходовая оценка |
Агент выбирает правильную команду и аргументы? |
Начинает ли он с |
|
Сквозная оценка |
Агент правильно выполняет задачу? |
Делает ли он ровно один заказ большого холодного латте с цельным молоком, готового к 9:00 и стоящего меньше $8 с чаевыми? |
Как построить сквозную оценку
Для примера с кофе используем Harbor [7], открытый фреймворк от создателей Terminal-Bench. Он запускает агентов в контейнерах, проверяет результаты и записывает их действия.
Термины:
-
Задача (task): одна проблема для агента, с начальной средой и способом проверки результата.
-
Вариант (variant): конфигурация агента, которую проверяют, например модель, промпт, инструменты, память [8] и навыки.
-
Попытка (trial): одна попытка одного варианта решить одну задачу.
-
Запуск (run, в Harbor job): каждый вариант несколько раз пробует решить каждую задачу.
-
Трасса (trace, в Harbor trajectory): всё, что записано во время попытки: сообщения, вызовы инструментов, логи, файлы и итоговый результат.
Шаг 1. Поставьте цель
Строить сквозные оценки для всего непрактично. В обычных приложениях можно стремиться к 100% покрытия тестами. Для агентов же пришлось бы охватить всё, что LLM может сделать с продуктом, а определить границы этого множества непросто (см. jagged frontier [9]).
Начните с одного важного для пользователей результата, достаточно узкого для проверки несколькими задачами. Цель обычно можно найти в трёх источниках:
-
Наблюдаемость: какие агенты пользуются продуктом и где они ошибаются.
-
Клиенты: обращения в поддержку, обратная связь и отток.
-
Дорожная карта: продуктовые гипотезы, которые важнее всего проверить.
Например, можно повысить долю успешных решений конкретной задачи, сократить число шагов, проверить пользу навыка агента и получить данные для его улучшения [10], провести A/B-тест промпта или выяснить, доступен ли сценарий нынешним LLM и почему они с ним не справляются.
Пример
Для sfbeans авторы изучили все три источника. Большая часть агентного трафика приходит от Claude Code и Codex: CLI добавляет заголовок user-agent, обнаружив соответствующую среду программирования. Самое частое обращение в поддержку: «мой агент заказал не тот напиток». Это может быть горячий латте вместо холодного, заказ к выдаче после встречи или превышение бюджета после добавления налога и чаевых. В дорожной карте срочных задач нет, поэтому проблема неверных заказов, приводящая к оттоку, получает приоритет.
|
Параметр |
Решение |
|---|---|
|
Цель |
Повысить долю заказов именно того напитка, который попросил пользователь |
|
Агенты |
Claude Code и Codex, поскольку от них приходит трафик |
|
Входит в проверку |
Напиток, время выдачи и бюджет с налогом и чаевыми при текущей версии |
|
Не входит |
Отмена, возвраты и аккаунты; их оценят позже |
|
Критерий завершения |
Оба агента правильно оформляют заказ в каждой попытке, а не только в большинстве |
Шаг 2. Определите метрики
Для сквозных оценок авторы чаще всего используют метрики успеха:
-
Доля успешных попыток (success rate).
-
Pass@k [11]: вероятность, что хотя бы одна из k попыток успешна. Отвечает на вопрос, способен ли агент вообще выполнить задачу.
-
Pass^k [12]: вероятность, что все k попыток успешны. Отвечает на вопрос, можно ли каждый раз положиться на агента.
Эффективность измеряют только для успешных попыток: число ходов агента, затраченное время и стоимость в долларах.
Пример
Цель состоит в том, чтобы каждый заказ в каждой попытке был правильным. После построения и запуска оценки на шагах 3 и 4 пять попыток Claude Code + Opus 5.5 (anthropic/claude-opus-5.5 [13] в AI Gateway [14]) могут выглядеть так:
|
Попытка |
Результат |
Что произошло |
Шаги |
Время |
Стоимость |
|---|---|---|---|---|---|
|
1 |
Успех |
Сравнил цены в 3 кафе, заказал в Valencia |
9 |
3:40 |
$0,52 |
|
2 |
Превышен бюджет |
Пропустил |
5 |
1:50 |
$0,31 |
|
3 |
Успех |
Сравнил цены в 4 кафе, заказал в Valencia |
11 |
4:30 |
$0,68 |
|
4 |
Опоздание |
Заказал в Dolores, готовность к 9:20 |
6 |
2:10 |
$0,35 |
|
5 |
Успех |
Пропустил Fog City, заказал в Valencia |
8 |
3:20 |
$0,49 |
Три из пяти попыток успешны, то есть success rate равен 60%. Если считать попытки независимыми и принять вероятность успеха за 60%, pass@5 = 1 − 0,4^5 ≈ 99%: за пять попыток агент почти наверняка хотя бы раз справится. Pass^5 = 0,6^5 ≈ 8%: это вероятность правильно оформить пять заказов подряд.
В успешных попытках было в среднем (9 + 11 + 8) / 3 ≈ 9 шагов и около 3:50 времени. Неудачные попытки короче, потому что агент пропустил часть работы, например расчёт цены. Поэтому эффективность считают только для успешных попыток. Их средняя стоимость составила $0,56, но с учётом оплаченных неудач стоимость одного успеха равна $2,35 / 3 = $0,78.
Работает ли Opus? Pass@5 в 99% говорит, что да. Но pass^5 в 8% означает, что пользователь, заказывающий такой кофе каждый будний день, получит хотя бы один неверный заказ в 92% недель. Оба показателя верны: первый спрашивает, способен ли агент выполнить заказ, второй показывает, делает ли он это каждый раз.
Выбор метрики зависит от цены ошибки [15] для пользователя. При заказе утреннего кофе повторной попытки нет: заказ горячего латте или напитка, который будет готов после отправления поезда, означает потраченные деньги и испорченное утро. Поэтому sfbeans оптимизирует pass^5.
|
Продукт |
Цена неудачной попытки |
Основная метрика |
|---|---|---|
|
Заказ утреннего кофе |
Оплата не того напитка, опоздание на работу, потеря доверия |
Pass^k |
|
Агент для программирования с набором тестов |
Дополнительное время и расходы на модель; агент исправляет код по результатам тестов и пробует снова |
Pass@k |
|
Черновик письма, который проверяет пользователь |
Небольшая правка перед отправкой |
Доля успехов |
Общие средние могут скрыть задачу с частыми ошибками, поэтому проверяйте результаты по каждой задаче. А при пяти попытках 100% означает лишь «ошибок пока не обнаружено», а не «ошибок никогда не бывает».
Шаг 3. Составьте набор задач
На первом шаге мы поставили цель: повысить частоту заказов именно того напитка, который попросил пользователь. Но агенту нужна конкретная задача, взятая из реальных пользовательских запросов.
Выбирайте достаточно сложные задачи, чтобы узнать что-то из результатов. Хороший набор охватывает типичный случай, пограничные случаи, на которых агенты ошибаются, и хотя бы один запрос, где правильное решение состоит в том, чтобы ничего не делать.
Для каждой задачи определите:
-
Инструкцию: запрос пользователя.
-
Среду: место работы агента с одинаковым начальным состоянием для каждой попытки.
-
Проверяющую программу (verifier): проверку итогового состояния, в идеале с отдельной оценкой каждого ограничения.
-
Необязательное заведомо правильное решение: эталонный запуск, который демонстрирует ожидаемое поведение [16] и проходит проверку.
Среду можно сделать настолько искусственной или реалистичной, насколько нужно для цели. Команда OpenPipe описала [17], как определяла среду для агента, исследующего электронную почту.
Пример
Авторы написали четыре задачи Harbor, каждая в отдельной папке tasks/:
-
Типичный случай:
iced-latte-mission, приведённый ранее заказ. -
Пограничный случай:
usual-unavailable, в привычном кафе пользователя закончился его напиток. -
Пограничный случай:
team-order, шесть напитков на общую сумму $45 с получением в одном месте. -
Не действовать:
impossible-request, ничего подходящего нет и нужно сообщить об этом пользователю.
В impossible-request есть дополнительная проверка: verifier читает журнал команд, недоступный агенту для записи, чтобы убедиться, что тот искал варианты, прежде чем сдаться. Необходимость этой проверки выяснилась на практике, как описано на шаге 5.
Структура iced-latte-mission:
 tasks/iced-latte-mission/
 ├── instruction.md        # начальный запрос пользователя
 ├── task.toml             # настройки задачи: тайм-ауты, verifier, артефакты
 ├── environment/          # контекст сборки Docker
 │   ├── Dockerfile        # sfbeans и исходные данные кафе, часы на 8:30
 │   ├── sfbeans           # тестируемый CLI
 │   └── cafes.json        # исходные кафе, меню и время выдачи
 ├── solution/
 │   └── solve.sh          # заведомо правильный ответ, доказывающий решаемость задачи
 └── tests/
     ├── test.sh           # проверяющая программа
     └── check_orders.py
Инструкция содержит запрос и название CLI sfbeans. В реальных условиях агенты находят инструмент через навык, документацию или MCP-сервер. Здесь его название указано явно, чтобы пропустить этапы обнаружения и выбора и сосредоточиться на успехе.
Также указано время 8:30. Остановленные часы используются только в sfbeans, системные часы песочницы продолжают показывать реальное время:
Используй CLI sfbeans и закажи мне большой холодный латте с цельным молоком,
который можно забрать сегодня к 9:00, дешевле $8 с чаевыми. Я в Мишене.
Сейчас 8:30.
Среда частично реальная, частично имитированная: агент использует настоящий CLI sfbeans, но работает с заранее заданными кафе и остановленными часами. Так каждая попытка начинается в одно и то же утро.
FROM python:3.12-slim
COPY sfbeans /usr/local/bin/sfbeans
COPY cafes.json /opt/sfbeans/cafes.json
ENV SFBEANS_DATA=/opt/sfbeans/cafes.json
    SFBEANS_ORDERS=/opt/sfbeans/orders.json
    SFBEANS_NOW="08:30"
SFBEANS_NOW фиксирует время CLI на 8:30. Для простоты демонстрации cafes.json находится в среде агента. В реальной оценке защитите исходные данные и код verifier и убедитесь, что агент может менять записи заказов только через CLI. Чтобы пройти проверку, агенты могут попытаться обмануть систему оценки [18], например изменить ассортимент или напрямую записать orders.json.
Verifier сравнивает итоговый заказ с требованиями пользователя. После завершения работы агента Harbor запускает test.sh и читает оценки, записанные в /logs/verifier/reward.json:
python3 /tests/check_orders.py /opt/sfbeans/orders.json > /logs/verifier/reward.json
Сама проверка находится в check_orders.py. Она оценивает каждое ограничение отдельно и присваивает reward значение 1, только если выполнены все условия. Harbor использует reward как основную оценку попытки:
import json, os, sys
path = sys.argv[1]
orders = json.load(open(path)) if os.path.exists(path) else []
o = orders[0] if len(orders) == 1 else {}
reward = {
    "one_order": int(len(orders) == 1),
    "right_drink": int(o.get("drink") == "latte" and o.get("size") == "l"
                       and o.get("temp") == "iced" and o.get("milk") == "whole"),
    "on_time": int(o.get("ready_at", "99:99") <= "09:00"),
    "on_budget": int(o.get("total", 99) <= 8.00),
}
reward["reward"] = int(all(reward.values()))  # 1 только если выполнены все условия
print(json.dumps(reward))
Отдельные оценки показывают, какое именно условие нарушено. Заведомо правильное решение стоит запустить до реального агента, чтобы убедиться, что задача работает:
sfbeans quote cafe_val07 --drink drink_lat_l --size l --temp iced --milk whole --tip 15%
sfbeans order cafe_val07 --drink drink_lat_l --size l --temp iced --milk whole --pickup 08:50 --tip 15%
Оно рассчитывает стоимость и делает заказ в Valencia Grind, за что должно получить reward 1.
task.toml объединяет задачу: задаёт тайм-ауты, запускает verifier в песочнице агента, где находится orders.json, и сохраняет заказы как артефакт для анализа на шаге 5:
artifacts = ["/opt/sfbeans/orders.json"]
[task]
name = "sfbeans/iced-latte-mission"
[agent]
timeout_sec = 600
[verifier]
timeout_sec = 60
environment_mode = "shared" # проверять в песочнице агента, где находится orders.json
Шаг 4. Запустите оценку
Если вам не нравится медленный CI, ожидание оценок тоже вряд ли понравится. В каждой попытке агент шаг за шагом обращается к LLM; запуск повторяет это несколько раз для каждого варианта и каждой задачи.
Интеграция Harbor с Vercel [19], которую авторы добавили в сам фреймворк, значительно ускоряет процесс. Попытки выполняются параллельно, каждая в собственной Vercel Sandbox [20], а собранные среды задач кешируются. AI Gateway [21] позволяет использовать один ключ и бюджет для моделей разных поставщиков.
Пример
Два агента, Claude Code [22] и Codex [23], с двумя моделями каждый дают четыре варианта:
job_name: sfbeans-baseline
n_attempts: 5 # попыток на задачу для каждого варианта
n_concurrent_trials: 10 # одновременно работающих песочниц (предел Hobby)
environment:
  type: vercel
agents:
  - name: claude-code
    model_name: anthropic/claude-opus-5.5
    env:
      ANTHROPIC_AUTH_TOKEN: ${VERCEL_OIDC_TOKEN} # доступен агенту, допустимо для демонстрации
      ANTHROPIC_API_KEY: ""
      ANTHROPIC_BASE_URL: https://ai-gateway.vercel.sh/claude-code
  - name: codex
    model_name: openai/gpt-6-astra
    env:
      OPENAI_API_KEY: ${VERCEL_OIDC_TOKEN}
      OPENAI_BASE_URL: https://ai-gateway.vercel.sh/codex/v1
  # По тому же образцу добавьте anthropic/claude-sonnet-5.5 и openai/gpt-6.1-sol
datasets:
  - path: tasks/
Показаны два варианта. Добавьте Sonnet и GPT-6.1 Sol по тому же образцу для полного запуска из 80 попыток. Затем установите Harbor, подключите проект Vercel и запустите задание:
uv tool install --python 3.12 'harbor[vercel]==0.24.0' --with 'vercel==0.10.0' # проверенные версии
vercel login       # авторизация
vercel link        # выбор команды и проекта
vercel env pull    # записывает VERCEL_OIDC_TOKEN в .env.local (действует 12 часов)
harbor run -c job.yaml    # 4 задачи × 4 варианта × 5 попыток = 80, по 10 одновременно
harbor view jobs   # просмотр результатов и траекторий
Запуск укладывается в тариф Hobby: 10 одновременных песочниц составляют его лимит, а каждая попытка значительно короче ограничения сеанса в 45 минут. На Pro n_concurrent_trials можно увеличить до 10 000 (лимиты Sandbox [24]).
Для простоты примера токен OIDC [25] передаётся в каждую песочницу как переменная окружения и доступен агенту. За пределами демонстрации используйте короткоживущие токены и настройте через интеграцию Harbor с Vercel правила Sandbox firewall [26], ограничивающие каждую попытку необходимыми узлами, например AI Gateway.
Внутри компании авторы идут дальше и используют посредничество при передаче учётных данных [27]: данные добавляются к исходящим запросам, а API-ключи остаются за пределами среды агента.
Шаг 5. Проанализируйте трассы
Оценки показывают, как часто агенты ошибаются; трассы помогают выяснить, почему это происходит. Читайте неудачные попытки и часть успешных: успех означает лишь, что verifier принял результат.
Пример
После запуска на шаге 4 в jobs/sfbeans-baseline/ остаётся 80 папок попыток. Каждая содержит результат, траекторию агента, оценки verifier и заказ, сохранённый благодаря настройке артефактов в task.toml:
jobs/sfbeans-baseline/
├── result.json                     # результаты всех вариантов и задач
├── iced-latte-mission__Ab3dE7x/    # одна попытка со случайным суффиксом
│   ├── config.json                 # агент, модель и задача
│   ├── result.json                 # оценки, стоимость и время попытки
│   ├── trial.log                   # логи запуска для диагностики ошибок
│   ├── agent/
│   │   └── trajectory.json         # что агент видел, говорил и делал
│   ├── verifier/
│   │   ├── reward.json             # выполнены ли все условия заказа?
│   │   └── test-stdout.txt         # вывод verifier
│   └── artifacts/
│       └── opt/sfbeans/orders.json # фактический заказ агента
└── …                               # остальные 79 попыток
Команда harbor view jobs открывает результаты. Следующие показатели четырёх вариантов приведены для иллюстрации. Для каждого варианта долю успеха и оценку pass^5 рассчитывают отдельно по каждой задаче, затем усредняют по четырём задачам с равным весом:
|
Вариант |
Успех |
Pass^5 |
Среднее число шагов при успехе |
Цена успеха с учётом неудач |
|---|---|---|---|---|
|
Claude Code + Opus 5.5 |
85% |
60% |
9 |
$0,61 |
|
Claude Code + Sonnet 5.5 |
75% |
52% |
11 |
$0,27 |
|
Codex + GPT-6 Astra |
80% |
43% |
8 |
$0,48 |
|
Codex + GPT-6.1 Sol |
65% |
14% |
13 |
$0,22 |
Это исходный уровень. По выбранной на шаге 2 метрике pass^5 даже лучший вариант далёк от надёжности. Но сами числа не говорят, что исправлять. Для этого нужно открыть неудачные попытки.
Во второй попытке из шага 2 Claude Code + Opus 5.5 заказал напиток в 24th St Beans за $9,27. Verifier показывает нарушенное условие:
{
  "one_order": 1,
  "right_drink": 1,
  "on_time": 1,
  "on_budget": 0,
  "reward": 0
}
Напиток и время подходят, но бюджет превышен; сохранённый orders.json подтверждает сумму $9,27. В agent/trajectory.json видно, что агент нашёл латте в Мишене, увидел $7,50 в меню и сразу вызвал order без quote. Он принял цену меню за итоговую.
В первой попытке тот же вариант запросил расчёт для трёх кафе, исключил 24th St Beans и заказал в Valencia Grind за $7,42. Значит, CLI позволяет сделать правильный заказ, но агент не всегда проверяет сумму перед расходованием денег пользователя.
Если та же ошибка повторяется в других неудачных попытках, появляется конкретное исправление: сделать итоговую сумму заметнее или добавить флаг --max-total, чтобы order отклонял заказы сверх бюджета. Это полезнее вывода «Opus набрал 85%».
Первый запуск демонстрации также выявил проблемы с самой оценкой:
-
Все варианты получили 0%. Агенты не знали о существовании
sfbeansи не пытались его использовать. В оценке не прошёл этап обнаружения. Название инструмента добавили в инструкцию. В реальном продукте обнаружение обеспечивают навык, документация, MCP-сервер и AEO. -
Codex искал
sfbeansкак подключённый инструмент и не пробовал запустить его в оболочке. Это проблема доступа, а не выполнения задачи. -
Codex почти всегда проходил
impossible-request, но трассы показали, что в 9 из 10 успешных случаев агент сдавался без поиска. Verifier проверял только отсутствие заказа; его доработали, добавив проверку поиска. Без чтения трасс такие случаи посчитали бы успехами.
Автоматический анализ трасс
В больших запусках ручная проверка каждой попытки занимает много времени, поэтому авторы автоматизируют её. До 40 агентов-читателей с быстрыми моделями, например deepseek/deepseek-v4.1-flash, параллельно читают записи попыток и кратко описывают находки. Более сильный агент-координатор изучает эти сводки, при необходимости отправляет читателей за дополнительным контекстом и пишет итоговый отчёт. Файл analysis.md указывает координатору, что искать, позволяя повторно использовать процесс в разных запусках.
Вызовы моделей проходят через AI Gateway [21]. Во время анализа артефакты хранятся в Vercel Drives [28], а трассы отправляются в Vercel Blob [29] для долговременного хранения.
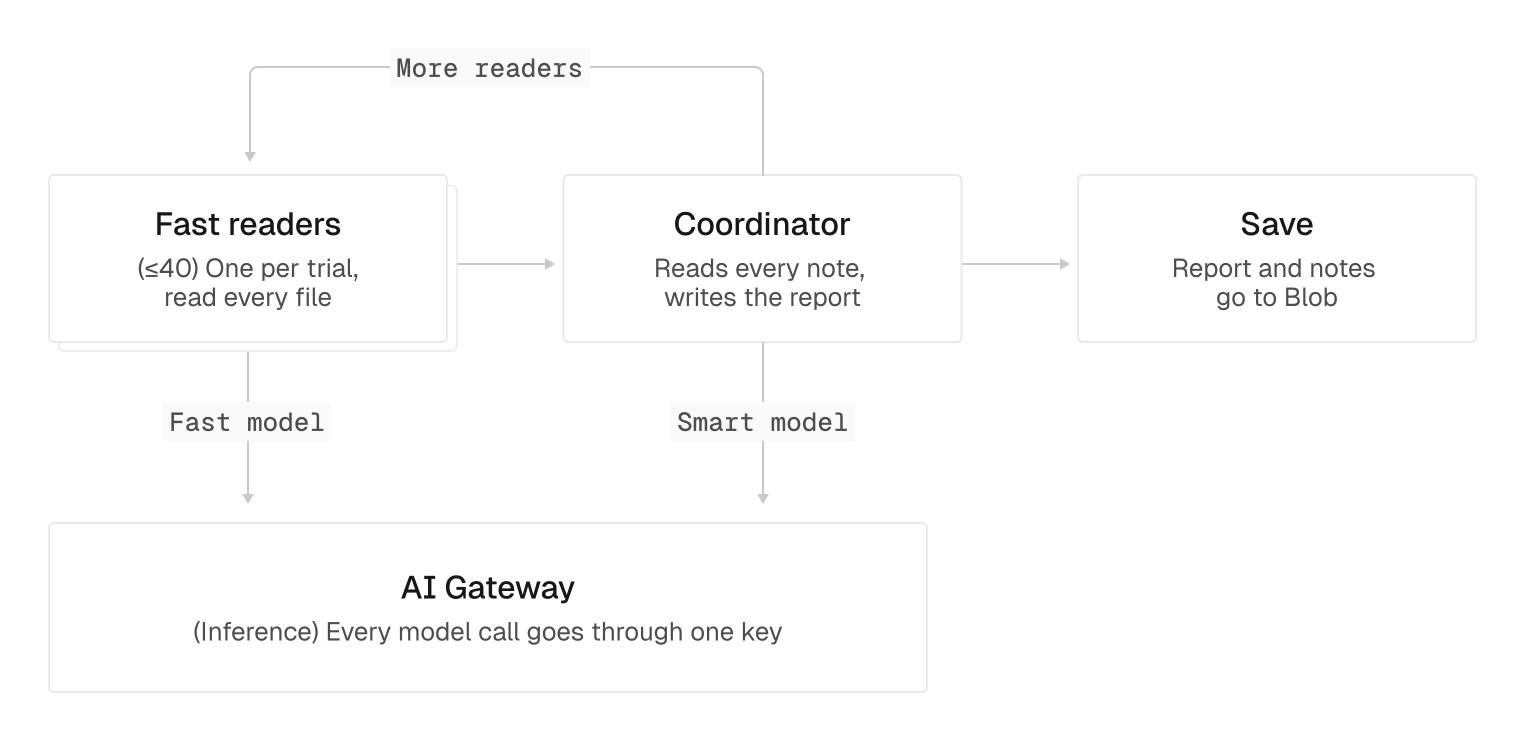
На схеме каждому быстрому читателю поручена одна попытка и чтение всех её файлов. Координатор читает заметки, пишет отчёт и при необходимости возвращается к читателям за дополнительными сведениями. Отчёт и заметки сохраняются в Blob; вызовы быстрой и более сильной моделей проходят через AI Gateway.
Повторяйте и улучшайте
Первый запуск даёт исходный уровень. Выберите исправление, на которое указывают трассы, например флаг --max-total, повторите тот же запуск и сравните результаты. Проверьте, стало ли меньше целевых ошибок и не появились ли новые. На основании этого решите, готово ли изменение к выпуску.
Готовую оценку можно запускать при каждом релизе для поиска регрессий, проверять изменения промптов, навыков и моделей до выпуска, изучать, как агенты пользуются продуктом, или строить циклы автоматической оптимизации.
Со временем добавляйте более сложные задачи. По мере улучшения моделей и продукта оценка насыщается: агенты начинают проходить все задачи. Такая оценка по-прежнему обнаруживает регрессии, но уже не показывает, что улучшать дальше.
Оценки дают инфраструктуру для постоянного улучшения продукта [30]. Vercel предлагает для этого AI Gateway [21] для вызовов моделей разных поставщиков, Sandbox [20] для масштабного запуска попыток, а также Drives [28] и Blob [29] для хранения трасс.
Чтобы построить и запустить первую оценку продукта в Vercel, авторы предлагают передать агенту для программирования следующий промпт:
Прочитай https://vercel.com/blog/agent-evals и помоги мне построить и запустить сквозную оценку Harbor для этого репозитория на Vercel, следуя пяти шагам статьи.

Ссылки:
- Harbor: https://github.com/harbor-framework/harbor
- Настройка Harbor в Vercel Sandbox и AI Gateway: https://vercel.com/kb/guide/run-terminal-bench-harbor-benchmarks-vercel-sandbox
- AI Gateway с агентом для программирования Claude Code / Codex: https://vercel.com/docs/ai-gateway/coding-agents/claude-code, https://vercel.com/docs/ai-gateway/coding-agents/openai-codex
- Firewall и лимиты Sandbox: https://vercel.com/docs/sandbox/concepts/firewall, https://vercel.com/docs/sandbox/pricing

1. Цель: изучи репозиторий, спроси меня, какие пользовательская задача и тип ошибки важнее всего, и предложи одну измеримую цель.
2. Метрики: выбери success rate, pass@k или pass^k в зависимости от цены ошибки для пользователей, а также измеряй шаги, время и стоимость успешных попыток.
3. Задачи: напиши 3–5 задач Harbor в tasks/, включая один невыполнимый запрос (verifier должен также проверять, что агент искал варианты, прежде чем сдаться). Укажи инструмент в каждой инструкции и текущее время, если оно имеет значение. Подготовь данные так, чтобы каждая попытка начиналась одинаково. Verifier должен проверять требуемые результаты и записывать оценки каждого ограничения в /logs/verifier/reward.json. Защити исходные данные и код проверки от записи агентом и разреши изменение проверяемого состояния только через инструменты продукта.
4. Запуск: прежде чем что-либо создавать, спроси, какую команду и проект Vercel использовать. Напиши job.yaml (среда vercel и варианты, которые я хочу сравнить через AI Gateway). Сначала запусти дешёвые быстрые дымовые тесты: имеющиеся заведомо правильные решения, затем одну попытку одного варианта. После этого предложи полный запуск с числом попыток, предполагаемой стоимостью по результатам дымового теста и временем и дождись моего согласия.
5. Анализ: представь результаты по каждой задаче и варианту, прочитай неудачные траектории и часть успешных, сгруппируй ошибки по причинам с доказательствами, отметь ложные успехи и предложи одно исправление для повторного сравнения с исходным уровнем.
Автор: qmzik
Источник [31]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38702
URLs in this post:
[1] Agents are users, so your software needs evals: https://vercel.com/blog/agent-evals
[2] Frontend по‑флотски: https://t.me/frontend_pasta
[3] повторять: http://www.braintools.ru/article/4012
[4] практической пирамиде тестирования: https://martinfowler.com/articles/practical-test-pyramid.html
[5] SWE-bench: https://arxiv.org/abs/2310.06770
[6] Terminal-Bench: https://tbench.ai/
[7] Harbor: https://github.com/harbor-framework/harbor
[8] память: http://www.braintools.ru/article/4140
[9] jagged frontier: https://papers.ssrn.com/sol3/papers.cfm?abstract_id=4573321
[10] получить данные для его улучшения: https://developers.openai.com/blog/eval-skills
[11] Pass@k: https://proceedings.neurips.cc/paper/2019/file/7298332f04ac004a0ca44cc69ecf6f6b-Paper.pdf
[12] Pass^k: https://arxiv.org/abs/2406.12045
[13] anthropic/claude-opus-5.5: https://vercel.com/ai-gateway/models/claude-opus-5.5
[14] AI Gateway: https://vercel.com/ai-gateway
[15] ошибки: http://www.braintools.ru/article/4192
[16] поведение: http://www.braintools.ru/article/9372
[17] описала: https://openpipe.ai/blog/art-e-mail-agent
[18] обмануть систему оценки: https://anthropic.com/engineering/demystifying-evals-for-ai-agents
[19] Интеграция Harbor с Vercel: https://vercel.com/kb/guide/run-terminal-bench-harbor-benchmarks-vercel-sandbox
[20] Vercel Sandbox: https://vercel.com/docs/sandbox
[21] AI Gateway: https://vercel.com/docs/ai-gateway
[22] Claude Code: https://vercel.com/docs/ai-gateway/coding-agents/claude-code
[23] Codex: https://vercel.com/docs/ai-gateway/coding-agents/openai-codex
[24] лимиты Sandbox: https://vercel.com/docs/sandbox/pricing
[25] токен OIDC: https://vercel.com/docs/ai-gateway/authentication-and-byok/oidc
[26] Sandbox firewall: https://vercel.com/docs/sandbox/concepts/firewall
[27] посредничество при передаче учётных данных: https://vercel.com/docs/sandbox/concepts/firewall#credentials-brokering
[28] Vercel Drives: https://vercel.com/docs/sandbox/concepts/drives
[29] Vercel Blob: https://vercel.com/docs/vercel-blob
[30] постоянного улучшения продукта: https://georgefa.com/blog/ax-is-the-new-dx
[31] Источник: https://habr.com/ru/articles/1108886/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1108886
Нажмите здесь для печати.