Цена ошибки: паддинг, чекпоинты на сетевом диске и сторож, который гасил здоровое обучение
Цена ошибки: паддинг, чекпоинты на сетевом диске и сторож, который гасил здоровое обучение
Ошибки [1] бывают в любой настоящей работе. Обычно о них пишут одной строкой где-то между графиками с результатами, а я решил сделать наоборот: собрать наши промахи в одну статью и разобрать их по-инженерному, то есть что именно сломалось, сколько это стоило и что мы после этого поменяли.
Во второй статье серии [2] я пообещал рассказать, как арендовал видеокарты в облаке и сжёг на них деньги, почти ничего не посчитав. В третьей [3] напомнил, что обещание в силе. Теперь выполняю. Большая часть статьи про облачное дообучение языковой модели, а в конце я расскажу о нескольких ошибках в измерениях: денег они почти не стоили, но были опаснее.
Как и раньше, я не называю базовые модели, техники дообучения, чекпоинты и источники данных. Классы карт, поставщиков, цены в час и порядок величин называю, потому что без них разговор о стоимости теряет смысл.
Зачем вообще облако
Распознавание речи и синтез голоса из второй [2] и третьей [3] статей учатся дома, на карте с 24 ГБ памяти [4], и её им хватает. А вот языковой модели, которая должна писать и отвечать по-крымскотатарски, её уже не хватает: для полного дообучения нужна карта на 141 ГБ и больше. Покупать такую ради нескольких прогонов в год незачем, их сдают в аренду по часам. Это как машина в прокате: платишь за время, пока она у тебя, и счётчику всё равно, едешь ты или стоишь на обочине с открытым капотом.
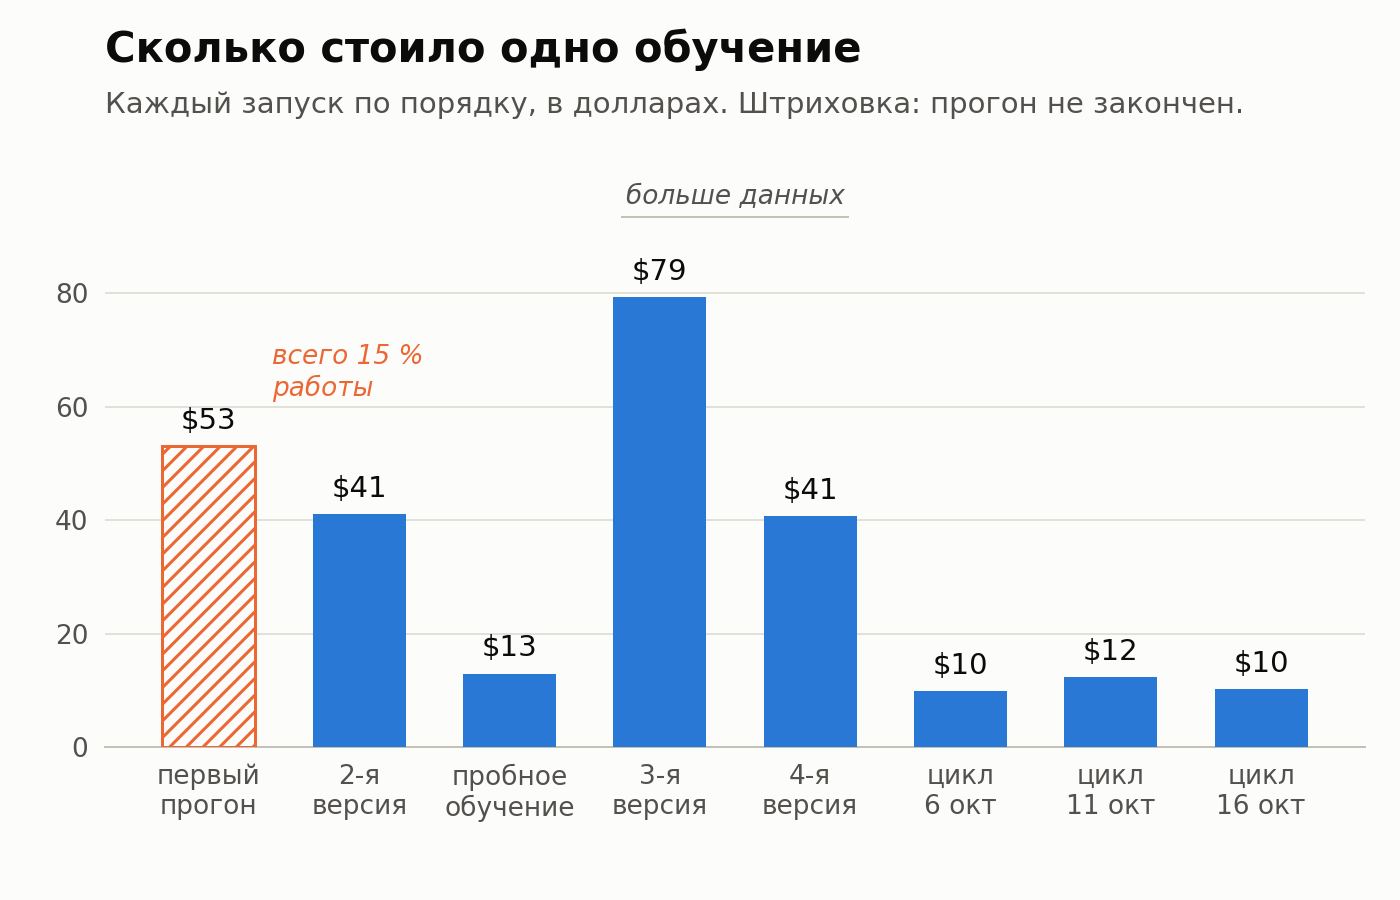
За полтора месяца на аренду ушло чуть больше $300. Это не один провальный прогон, а серия итераций: обучили, посмотрели, поменяли конфигурацию, запустили снова. С каждой итерацией прогон выходил дешевле и надёжнее, пока не сложился рецепт, который работает. Честно скажу, я был зол, что мы потратили столько денег. Но рад, что в итоге у нас есть правильный «рецепт» для следующих обучений: теперь мы знаем, сколько стоит прогон и за что платить не нужно. На графике видно, как менялась цена одного обучения [5].
Прогон №1: $53 за 15 % второй стадии
Первой арендованной картой была H200 на 141 ГБ, около $4,6 в час. Обучение было двухстадийным, и по смете весь прогон занимал 9–11 часов и $33–40. Через 11,5 часа и $53 я его остановил: вторая стадия была пройдена на 15 %, а до конца оставалось около 46 часов. Карта всё это время давала примерно 3–4 % своей полезной отдачи. Когда мы разобрались, нашлись три причины, и каждая из них самостоятельно съедала заметную часть денег.
Паддинг: смета считала токены, карта считала пустоту
Главная причина в том, что мы платили за пустоту. Наши обучающие диалоги короткие, медиана около 20 токенов, а в пачке каждый пример дополнялся паддингом до 1024. Маска внимания [6] и маска лосса делают так, что паддинг не влияет на результат, но на стоимость он влияет полностью: матрицы всё равно перемножаются на всю длину последовательности, просто большая часть этих чисел потом выбрасывается. Получается один короткий диалог в каждом ящике, а везёшь весь ящик. Смета была посчитана по реальному содержимому, 59 млн токенов, а карта обработала 1,17 млрд позиций. Отсюда и промах в 20 раз.
Обиднее всего, что в плане прямо стояло допущение: накладные расходы на паддинг будут порядка 20 %. Никто его не проверил, а проверка занимала минуту:
# оценка доли полезной работы при паддинге до max_len
lengths = [len(tokenize(x)) for x in sample]     # выборка из датасета
useful = sum(lengths)
padded = len(lengths) * max_len
print(f"полезно: {useful / padded:.1%}")           # у нас вышло около 5 %
Если медиана длины примера в пятьдесят раз меньше max_len, никакая оптимизация ядра не спасёт. Карта честно перемножает нули, а счёт выставляется за часы. Правильная смета считает не «размер корпуса × эпохи», а число позиций, которые карта реально пропустит через себя: шаги × микробатч × длина последовательности, делённые на фактическую скорость и умноженные на цену часа.
Чекпоинты на сетевой диск
Вторая причина была в сохранениях. Состояние обучения записывалось каждые 400 шагов, по 46 ГБ за раз, и не на локальный диск, а на сетевой том. Запись синхронная: пока чекпоинт не дописан, следующий шаг не начинается, и карта просто стоит. За прогон набралось около 600 ГБ записей, и в итоге карта была занята 58–68 % времени, даже если не считать паддинга.
Сохранения, конечно, нужны: без них любой сбой отбрасывает к началу. Но их частоту правильнее мерить часами работы, а не шагами. Вопрос звучит так: сколько стоит потерять час и сколько стоит одна запись. Чекпоинт на 46 ГБ оправдан раз в несколько тысяч шагов, а не раз в 400, и писать его лучше на локальный диск машины, а на сетевой том переносить уже потом.
Загрузчик данных не успевал
Третья причина оказалась совсем простой. На машине со 128 ядрами подготовку пачек делали 2 процесса. На коротких примерах карта считала пачку быстрее, чем ей готовили следующую, и снова ждала. Это классическое голодание загрузчика: мощная карта, к которой еду носят по одной тарелке. Ориентир, который мы себе записали, такой: число процессов загрузчика порядка четверти числа ядер, и загрузку карты стоит посмотреть в первые же минуты.
Почему домашняя проверка этого не поймала
Перед арендой весь пайплайн прошёл проверку дома и работал. Но эта проверка доказала только одно: код правильный. Дома время бесплатное, поэтому на пропускную способность никто не смотрел. Проверка «работает» и проверка «окупается» оказались разными, и вторую мы не сделали. До первого шага обучения ещё ушло около 45 минут и $3 на ловушки настройки машины, но это мелочь на фоне остального.
Не всё тогда пропало. Первая стадия прошла целиком, и её веса мы сохранили.
Packing: та же работа в 20 раз дешевле
Главную причину мы убрали первой. Короткие диалоги стали упаковываться в плотные блоки один за другим, с маской внимания, которая не даёт соседним примерам внутри блока видеть друг друга. Ящик теперь заполняется до краёв, и пустого места в нём почти нет: доля полезных токенов выросла с 5 % до 99 %. Пересчёт показал, что вторая стадия в старом виде стоила бы $331–413, а теперь стоит $14–17.
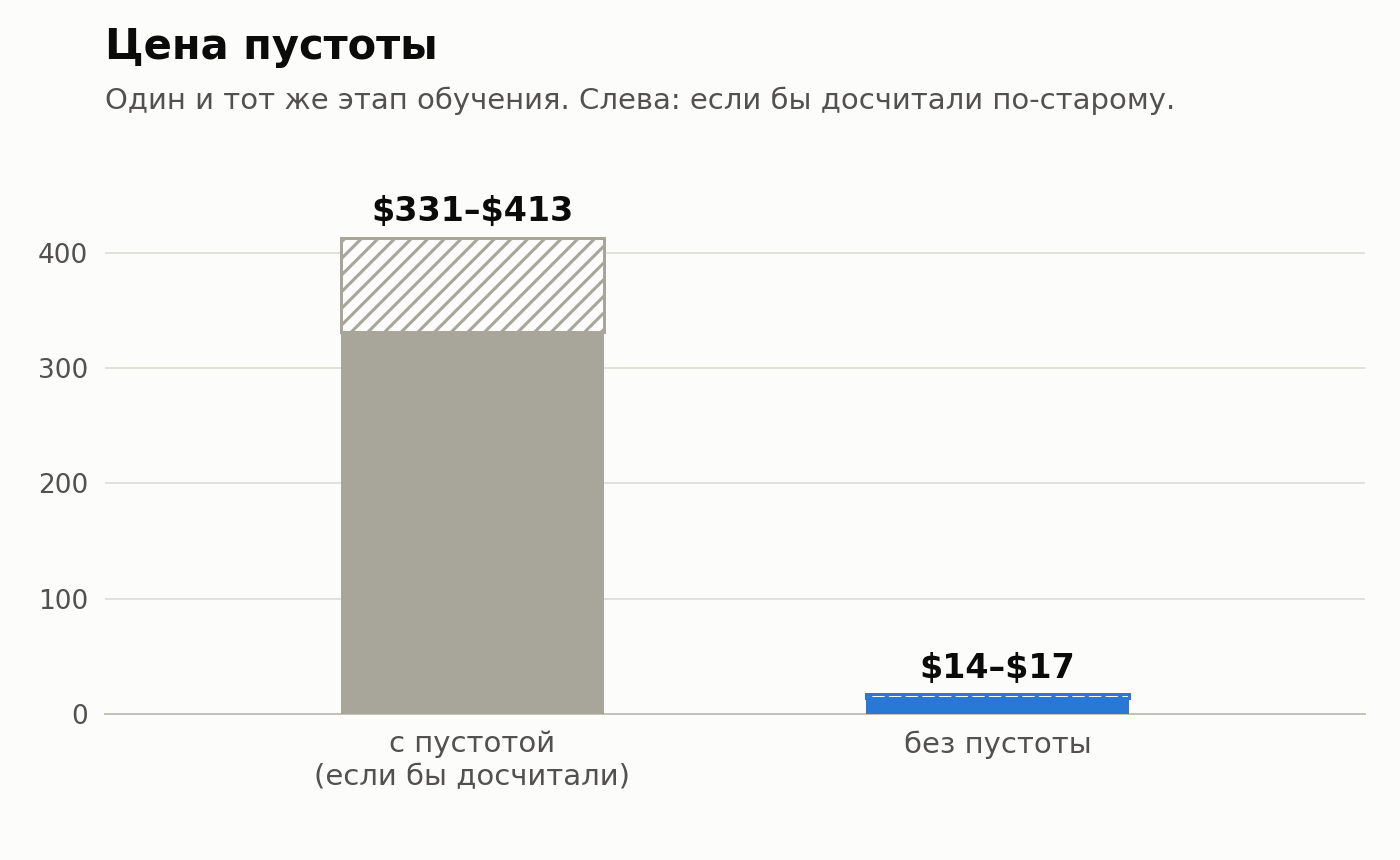
Тут нужна оговорка: левый столбец на графике не факт, а расчёт. Досчитывать по-старому, чтобы проверить, мы, разумеется, не стали.
Пять машин за сутки
Воодушевлённый, я запустил вторую попытку уже с packing, и за ночь и день с 1 на 2 сентября нам пришлось арендовать 5 машин подряд. Каждая умирала раньше, чем успевала закончить работу, а платить приходилось за каждую.
Первая из них сначала 20 минут простояла на той самой ловушке настройки, от которой мы уже один раз пострадали. Урок был записан в отчёт, но в код не попал, а запись в отчёте ещё не исправление. Потом эта машина упала на шаге 50 из 95. Свежая правка включила промежуточную проверку, которой требовалось около 160 ГБ памяти на карте в 141 ГБ. В первом прогоне эта проверка просто ни разу не успевала запуститься, поэтому её никто и не видел.
Другую машину погубил старый файл-метка «прогон провалился», оставшийся на постоянном томе от прошлой попытки. Сторож, о котором речь пойдёт ниже, прочитал его, поверил и погасил совершенно здоровое обучение на шаге 80 из 95, за 4 минуты до конца стадии.
Тогда я и увидел закономерность: само обучение не упало ни разу. Падало всё вокруг него, то есть скрипты запуска, проверки и сторожа. Каждый из этих кусков был проверен отдельно, а целиком цепочку никто никогда не прогонял.
Репетиция дома
Так появилась полная репетиция перед арендой: та же цепочка, те же сторожа, та же смена стадий, только с крошечной моделью на домашней карте и бесплатно. Одна такая репетиция 5 сентября заняла 4,7 часа и поймала 6 дефектов. Самый неприятный из них сидел в накоплении градиента: из-за того, как обёртка модели его обрабатывала, фактическая скорость обучения на первой стадии оказалась в 16 раз выше заданной. Обрезка градиента эту ошибку маскировала, поэтому лосс выглядел вполне прилично, и по графикам мы бы её не заметили. В облаке за каждый из шести дефектов мы бы заплатили.
Самая дорогая привычка: гасить машину на любую ошибку
Но самым дорогим в те сутки оказался не код, а наша привычка. На любую ошибку мы делали одно и то же: гасили машину, чинили и разворачивали всё заново. Новая машина заново ставит окружение, заново качает десятки гигабайт весов, и всё это время счётчик идёт. А вместе с машиной исчезают и логи, так что причину потом приходится угадывать, а иногда и платить за ещё одну машину, чтобы её воспроизвести.
Правило мы сформулировали в тот же день: не гасить, а чинить на месте и перезапускать процесс на той же машине. Как с проколотым колесом: его заклеивают прямо у дороги, а не бросают велосипед и не идут покупать новый. Беда в том, что в код это правило попало на час позже, чем надо. Пятая машина дошла до 65 % второй стадии, отработала 4,35 часа на $19,96 и упала. Спасатель, который должен был забрать логи, первым делом снял паузу перед выключением, а программы для копирования на машине не оказалось. Машина исчезла за минуты, и почему она упала, я не знаю до сих пор.
Похожая история случилась на побочных сравнительных замерах. Программа увидела на диске старый файл результата, решила, что уже скачала новый, и погасила машину вместе с настоящим результатом. После этого стало ясно, что старые метки и старые файлы на постоянном томе это отдельный класс ошибок, и теперь всё, что сигналит о состоянии прогона, привязано к конкретному запуску.
Как это выглядело после
Зато дальше правила начали окупаться. Прогон второй версии с packing и правилом «чини на месте» прошёл обе стадии за один заход и стоил около $41 за всё, хотя в первый раз мы отдали $53 всего за 15 % второй стадии. Следующее, пробное обучение стало первой настоящей проверкой правила. Короткий тест прямо на машине нашёл 3 дефекта за $1,5, мы исправили их на месте, и вся работа заняла 2,81 часа и $12,91 без единой аварии.
Сторожа: промахи в обе стороны
Сторожем у нас называется отдельная программа, которая следит за обучением, сохраняет результат и выключает машину, чтобы счётчик не шёл зря. Почти каждый его промах стоил денег, причём ошибался он в обе стороны: то был слишком мягким, то слишком строгим.
6 сентября закончилось обучение третьей версии на B300, а сторож этого не заметил: за тот день он уже дважды тихо ломался и никому об этом не сообщил. Машина за $7,89 в час простояла 30–40 минут с готовым результатом, пока я сам не заглянул проверить, что происходит, и вышло $4–5 впустую. После этого мы стали перед каждым запуском устраивать сторожу учебную тревогу: искусственно вызываем событие и смотрим, дошёл ли сигнал. Ближе к концу прогона машину теперь проверяем ещё и вручную. Из той же истории вырос и отдельный вывод: метка «прогон завершён» ещё не значит, что результат в безопасности. В безопасности он тогда, когда скачан и проверен.
24 сентября сторож, наоборот, перестарался. Он оценивал загрузку карты по замерам раз в 5 минут и в последних замерах увидел 94, 0, 100 и 0 %. Оба нуля пришлись на паузы сохранения, когда карта законно ждёт диск. В среднем вышло 48 % при пороге 50 %, и за 28 секунд до конца обучения сторож сохранил чекпоинт и уничтожил машину. Сами веса уцелели, все 51,6 ГБ, но служебные файлы чекпоинта оказались нулевой длины, и пришлось поднимать отдельную машину, чтобы всё спасти. Ошибка была в самой логике [7]: по загрузке карты нельзя отличить зависание от сохранения, а по счётчику шагов можно. Теперь условие выглядит примерно так:
# зависание = карта простаивает И шаги перестали идти
hung = gpu_util_avg < 0.5 and step_now == step_at_last_check
На сохранении и на финише карта имеет полное право отдыхать, а настоящее зависание видно по тому, что шаги стоят.
Оставался ещё вопрос, где сторож живёт. Сторож на самой арендованной машине умирает вместе с ней, то есть ровно в тот момент, когда он нужнее всего. Поэтому теперь он живёт дома и ходит к машине снаружи.
Лимиты: как чуть не убили здоровый прогон
С деньгами история похожая. Первая логика была простой: дошли до лимита, спасаем и гасим. 2 сентября сторож с лимитом $36 на шаге 10 из 1875 экстраполировал стоимость прогона в $35–38 и начал спасать совершенно здоровое обучение. Мы успели его остановить, но стало ясно, что жёсткий лимит в долларах опасен: на десятом шаге экстраполяция почти ничего не знает о реальной скорости, а если лимит сработает ближе к концу, он убьёт почти законченную работу, и пропадёт всё, за что уже заплачено. Поэтому теперь система у предела сначала сохраняет всё, что сделано, и только потом выключается.
Цены, которых нет
Была и ошибка попроще: поверить прайсу. Вот что мы нашли, когда начали проверять, что за ценами стоит на самом деле.
|
где |
что обещали |
что оказалось |
|---|---|---|
|
DigitalOcean |
MI300X 192 ГБ, $2,59/ч |
карты нет ни в одном регионе, лимит на GPU у нового аккаунта 0 и поднимается через поддержку; доступная замена $3,80/ч, на 47 % дороже |
|
RunPod |
MI300X, $2,39/ч |
12 попыток создать машину из 12 получили отказ |
|
Hostinger |
карта на 192 ГБ, $4,50/ч |
16 ГБ RAM и 200 ГБ диска; нам только под чекпоинты нужно около 315 ГБ |
|
AMD Developer Cloud |
MI300X, $1,99/ч |
карта доступна, на ней и прошли следующие версии |
Претензий к площадкам тут нет: прайс показывает цену, а не наличие и не конфигурацию. Карты из первой строчки не нашлось ни в одном регионе, а к карте из третьей прилагалось так мало оперативной памяти и диска, что не помещались даже наши чекпоинты. Все эти проверки обошлись меньше чем в цент, и с тех пор, прежде чем верить цене, мы проверяем, можно ли эту карту получить на самом деле.
Как теперь считается стоимость
Смета первого прогона ошиблась в 20 раз, и это был не единственный наш промах в расчётах. Вторую версию мы в отчёте записали в $32, потому что посчитали только часы обучения. Баланс показал $41. Машина жила почти 9 часов, а не 7, и всё это время платила ещё и за диски, так что прайсовые $3,59 в час за карту на деле превратились примерно в $4,6 за машину целиком. Счёт приходит не за обучение, а за жизнь машины от создания до удаления, вместе с установкой, скачиванием весов и выгрузкой результата.
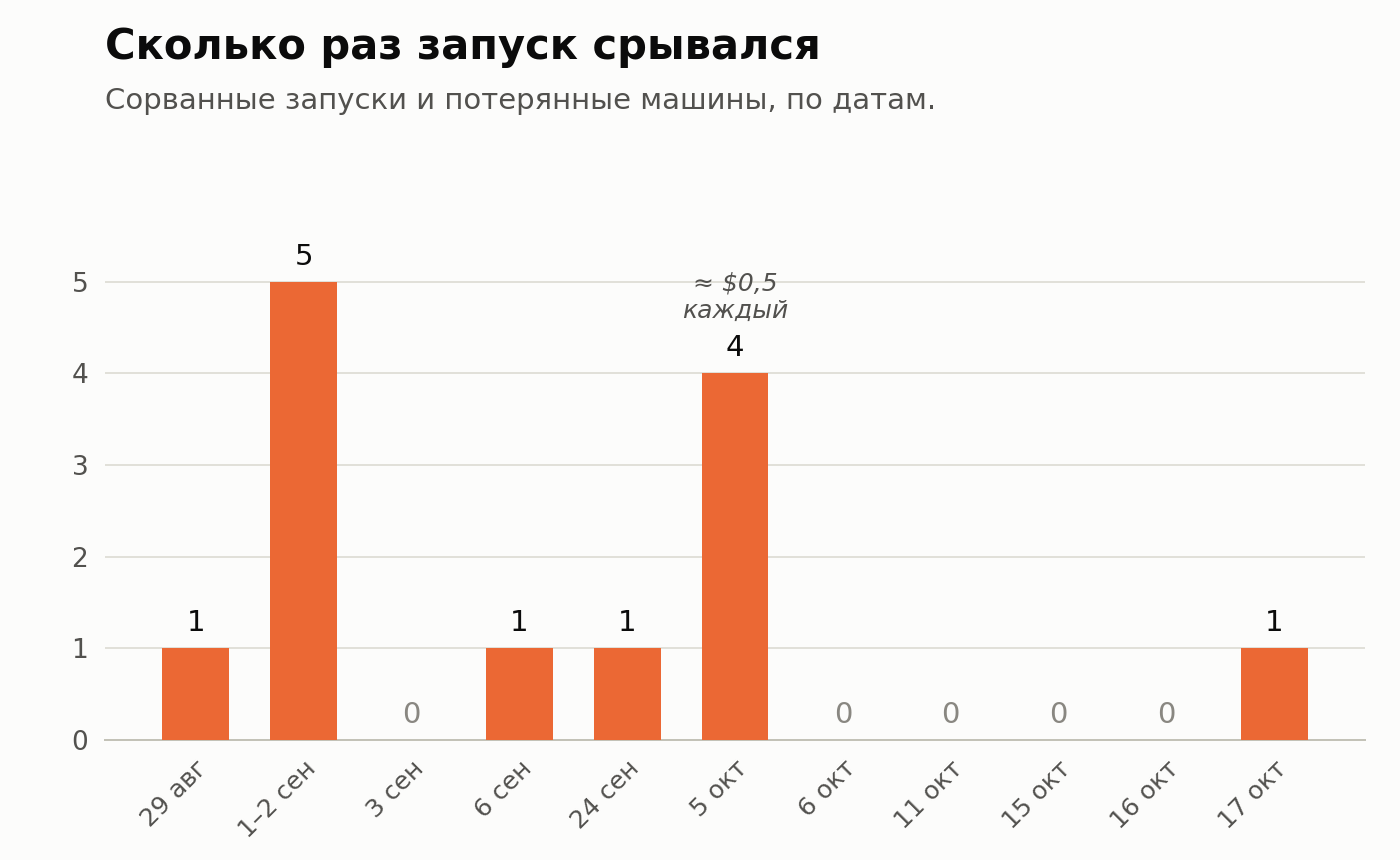
Поэтому смета теперь строится от реального числа шагов на реальной длине упакованных блоков, а через первые минуты работы сверяется с фактической скоростью. Если расхождение заметное, мы разбираемся до того, как прогон уйдёт в часы. Для масштаба: третья версия на B300 стоила $79,31 за 123 млн токенов, четвёртая на MI300X около $41 за примерно 200 млн, а очередной цикл дообучения сейчас стоит около $10–12. И когда 5 октября сорвались ещё 4 запуска, каждый обошёлся примерно в полдоллара: срыв, пойманный на старте, стоит копейки, а не прогон.
Ошибки в измерениях
Эти промахи денег почти не стоили, но они коварнее. Ошибка с арендой хотя бы видна по счёту, а ошибка в измерении выдаёт уверенную цифру, которая просто неверна. Часть таких историй уже была в серии. В первой статье [8] данных стало втрое больше, а ошибка не сдвинулась. Во второй [2] запрет на повторы портил живую речь. В третьей [3] обрезка съедала первое слово, а детектор вдохов находил их там, где их не было. В четвёртой [9] мой прогноз про синтетику вышел наоборот, а диалоги, которые приборы признали чистыми, носитель забраковал. Здесь добавлю то, о чём я ещё не писал.
Однажды распознавалка показала на книге ошибку около 100 %. Выглядело так, будто данные мусор, а причина была почти смешной: модель отвечала латиницей, а текст книги был набран кириллицей, и WER считал ошибкой каждое слово. Прежде чем что-то мерить, оба текста надо привести к одному алфавиту, причём официальным транслитератором, а не на глаз.
В другой раз синтез дважды из двух дал выброс высоты тона, и я построил на этом переделку данных. Когда мы прогнали не два, а 125 дублей, выбросов оказалось 0. Генерация стохастическая, и два сэмпла говорят о ней примерно ничего. Похожая ловушка ждала и с произношением имён собственных, только там дело было не в числе повторов, а в том, что именно повторять [10]. Дефект не нашёлся на 60 именах в одной фразе по 5 дублей, хотя в жизни возникал примерно в половине фраз. Стоило взять 4 имени в 8 разных фразах, и он вылез сразу, p = 0,0013. Варьировать надо тот фактор, от которого дефект зависит, а не тот, который проще перебрать.
Ещё одну ошибку сделала за нас автоматика. Настройка «хранить только последние N чекпоинтов» удалила самый удачный, и два обучения потеряли свой лучший момент. Лучший по валидации чекпоинт надо держать отдельно от ротации.
А самой неприятной оказалась последняя. 68 % текста в старой проверочной части повторялось в обучающих данных, поэтому часть цифр третьей версии была завышена. Это как дать ученику на экзамене те же задачи, что он решал на уроках: оценка выходит выше, чем знания. Мы собрали чистую проверочную часть из произведений, которых больше нигде в данных нет.
Что изменилось
Если собрать всё вместе, картина получается такая. Поначалу почти каждый запуск где-нибудь срывался, а теперь срывы стали редкими и дешёвыми.
Перед арендой вся цепочка проходит бесплатную репетицию дома на крошечной модели, и проверяется не только то, что она работает, но и сколько она будет стоить. Смета считается по упакованным токенам и реальным шагам, сверяется с первыми минутами работы и ведётся по жизни машины, а не по часам обучения. Чекпоинты пишутся по часам, а не по шагам, и на локальный диск, а загрузчик подобран под число ядер. Сторож живёт вне арендованной машины, проходит учебную тревогу до запуска и отличает зависание от паузы на сохранении, а система у предела сначала спасает результат и только потом выключается. На ошибку мы больше не гасим машину, а чиним на месте, поэтому сбой теперь стоит пару долларов, а не целого прогона. И прайсу мы верим только после того, как карту удалось получить.
Дешёвый цикл при этом не значит удачный. Версия с очередной порцией данных в слепом сравнении [8] (как оно устроено, я рассказывал в первой статье) сыграла с предыдущей 6 : 5, то есть разницы нет, и в работу она не пошла. Но такая неудача теперь стоит $10, а не $53, и после неё остаётся полный отчёт с логами, а не машина, исчезнувшая вместе с причиной.
Что дальше
Облачное обучение мы не бросаем. Сейчас мы на этапе сбора данных, а обучать будем по-прежнему на арендованных машинах, только каждый запуск теперь в разы дешевле и не ломается на ровном месте. А последняя версия распознавалки уже вышла лучше прежней: она точнее на проверочных расшифровках и чаще выигрывала в том же слепом сравнении.
Дальше всё упирается не в железо и не в деньги, а в живую разговорную речь, которую расшифровали люди. Видеокарты мы считать научились, а вот живого языка моделям пока не хватает.
Версия статьи для ana-yurt.com [11], проще и с меньшим количеством цифр: [[ССЫЛКА: ana-yurt.com [11] статья №5]].
Если вы носитель крымскотатарского, помощь нужна конкретная и без программирования: слушать короткие записи и говорить, правильно ли машина их расшифровала, читать страницы текста и отмечать, где слово турецкое, а где наше, составлять живые диалоги, начитывать несколько минут текста своим голосом. Пишите на ai@ay.mw [12] или в Telegram: t.me/ana_yurt_dev [13]. Поддержать работу материально можно на ko-fi.com/anayurt [14]: после всех этих уроков каждый доллар работает намного дольше.
Автор: servinosm
Источник [15]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38843
URLs in this post:
[1] Ошибки: http://www.braintools.ru/article/4192
[2] второй статье серии: https://habr.com/ru/articles/1085868/
[3] третьей: https://habr.com/ru/articles/1092578/
[4] памяти: http://www.braintools.ru/article/4140
[5] обучения: http://www.braintools.ru/article/5125
[6] внимания: http://www.braintools.ru/article/7595
[7] логике: http://www.braintools.ru/article/7640
[8] первой статье: https://habr.com/ru/articles/1081242/
[9] четвёртой: https://habr.com/ru/articles/1100892/
[10] повторять: http://www.braintools.ru/article/4012
[11] ana-yurt.com: http://ana-yurt.com
[12] ai@ay.mw: mailto:ai@ay.mw
[13] t.me/ana_yurt_dev: http://t.me/ana_yurt_dev
[14] ko-fi.com/anayurt: http://ko-fi.com/anayurt
[15] Источник: https://habr.com/ru/articles/1110050/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1110050
Нажмите здесь для печати.