Внутри Apple Neural Engine в M4. Часть 1: реверс-инжиниринг
Статья о том, как мы обошли Core ML и начали работать с железом напрямую.
Всё началось с простого вопроса: можно ли обучать модель на Apple Neural Engine?
Apple не хочет, чтобы вы знали ответ. Компания не публикует систему команд ANE, не документирует его внутреннюю архитектуру и даже не позволяет программировать его напрямую. Всё проходит через Core ML [1], который добавляет несколько уровней абстракции, проходы оптимизации и накладные расходы. Из-за этого почти невозможно понять, что на самом деле делает железо.
Поэтому мы занялись реверс-инжинирингом [2].
За несколько дней мы проследили весь программный стек от Core ML до драйвера ядра IOKit, выяснили, как компилировать и выполнять программы на ANE без Core ML, разобрались с бинарным форматом, измерили реальную пиковую производительность – спойлер: заявленные Apple «38 TOPS» вводят в заблуждение – и в итоге запустили обучение [3] нейросети на чипе, рассчитанном исключительно на инференс.
Это первая часть серии из трёх статей. Здесь речь пойдёт о реверс-инжиниринге: о том, как мы слой за слоем разобрали систему, чтобы понять, что на самом деле представляет собой Neural Engine в M4 и как работать с ним напрямую.
Что такое Neural Engine?
ANE – не GPU и не CPU. Это движок выполнения вычислительных графов: специализированный ускоритель с фиксированным набором функций, который принимает скомпилированный вычислительный граф нейросети и выполняет его целиком как единую атомарную операцию. Вы не отправляете ему отдельные инструкции умножения с накоплением. Вместо этого вы передаёте скомпилированную программу, описывающую весь вычислительный граф, а оборудование выполняет её от начала до конца.
Apple впервые представила Neural Engine в процессоре A11 в 2017 году. Тогда он состоял из двух ядер. С каждым новым поколением компания наращивала его возможности:

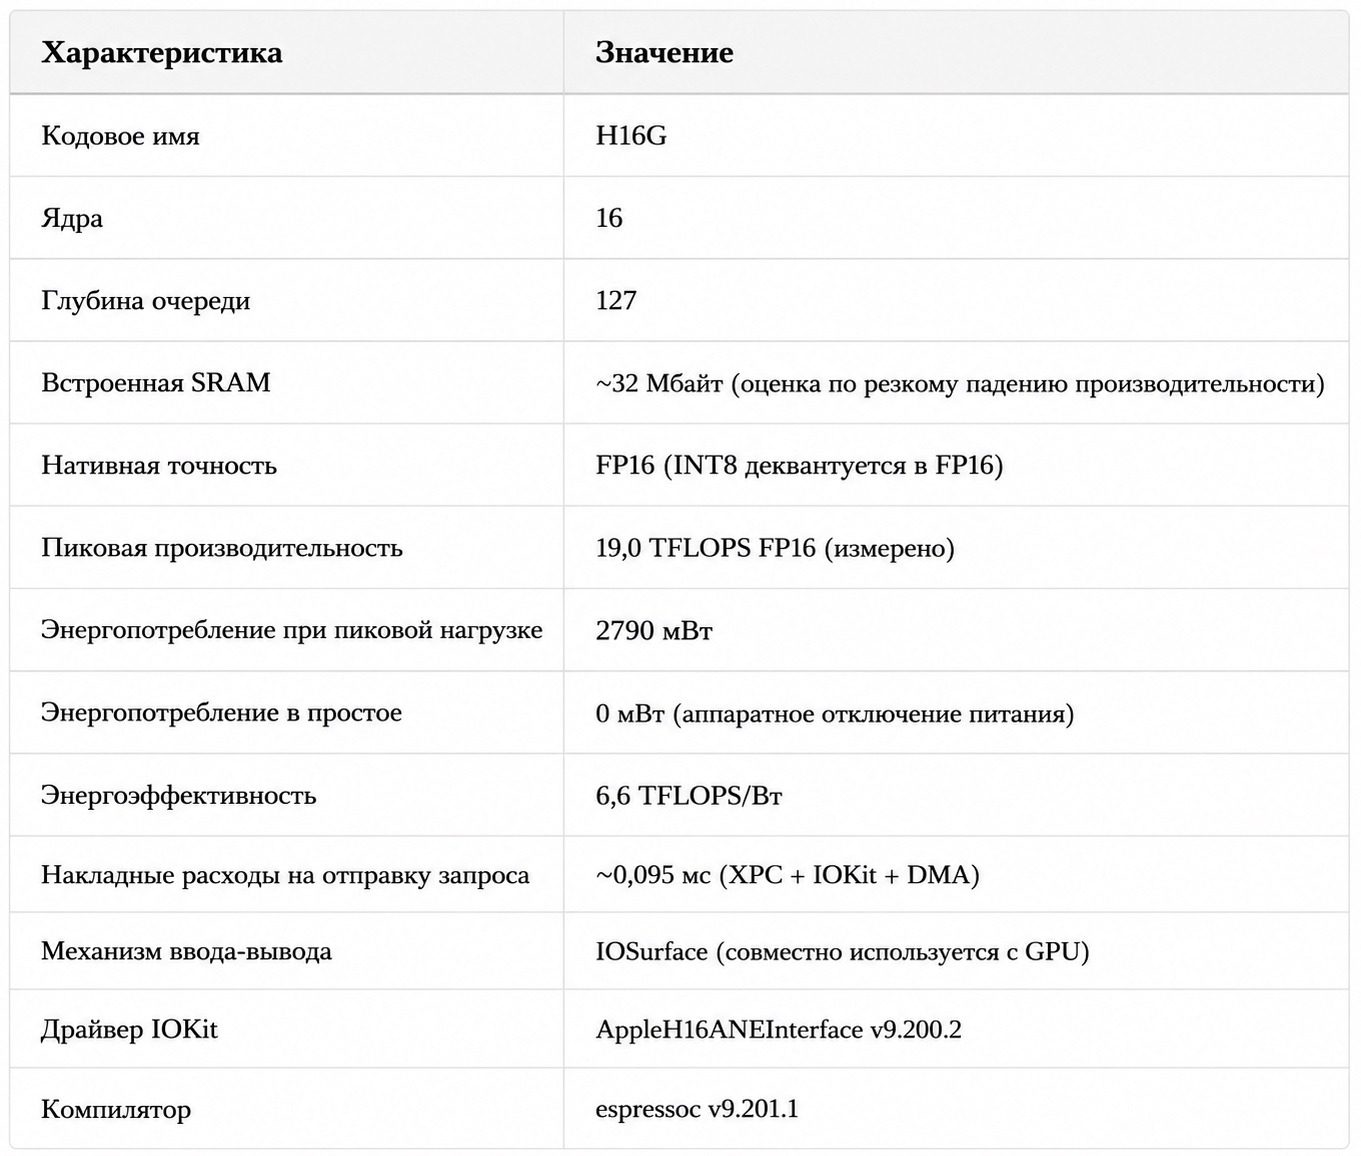
Мы работаем с ANE из M4, кодовое имя которого – H16G. У него 16 ядер, глубина очереди в 127 запросов на выполнение, независимое динамическое масштабирование напряжения и частоты (DVFS), а также аппаратное отключение питания неиспользуемых блоков, благодаря которому в состоянии простоя энергопотребление падает ровно до 0 мВт.
Предыдущие работы
Мы были не первыми, кто решил покопаться во внутренностях ANE.
-
hollance/neural-engine [4] — подробная документация Мэттейса Холлеманса, созданная сообществом и описывающая поведение [5] ANE, его производительность и поддерживаемые операции. На сегодняшний день это лучший источник информации [6] об ANE.
-
mdaiter/ane [7] — ранняя работа по реверс-инжинирингу с рабочими примерами на Python и Objective-C, в которой описаны фреймворк ANECompiler и отправка задач через IOKit.
-
eiln/ane [8] — драйвер ANE для Linux, созданный методом реверс-инжинирингом в рамках проекта Asahi Linux. Он помогает понять, как устроен интерфейс на уровне ядра.
-
apple/ml-ane-transformers [9] — собственная эталонная реализация трансформеров от Apple, оптимизированная под ANE. Она подтверждает такие архитектурные решения, как формат с каналами на первом месте и предпочтительное использование свёрток 1×1.
Однако, насколько нам известно, до нас никто не смог: (а) получить прямой доступ к API _ANEClient на M4 без Core ML, (б) разобраться с компиляцией MIL-моделей непосредственно в памяти [10], (в) измерить реальную пиковую пропускную способность в обход накладных расходов Core ML и (г) обучить модель на ANE.
Методология
Мы совместили несколько подходов:
-
обнаружение классов с помощью команды
dyld_info -objcдляAppleNeuralEngine.framework, которая выводит все классы и методы Objective-C; -
подмена реализаций методов (method swizzling), чтобы перехватывать обращения Core ML к закрытым фреймворкам ANE;
-
анализ бинарных файлов скомпилированных пакетов E5, чтобы разобраться в формате нейронных программ;
-
анализ масштабирования: мы меняли размеры матриц, глубину вычислительных графов и количество каналов, чтобы восстановить аппаратную топологию.
В AppleNeuralEngine.framework мы обнаружили более 40 закрытых классов, среди которых ANEClient, ANEModel, ANERequest, ANEIOSurfaceObject, _ANEInMemoryModel и многие другие.
Программный стек
Вот как выглядит полный программный стек ANE: от публичного API Core ML до самого оборудования:

Главное открытие состояло в том, что Core ML — не единственный способ получить доступ к ANE. Класс _ANEClient из AppleNeuralEngine.framework позволяет напрямую работать с конвейером «компиляция → загрузка → выполнение». Core ML — всего лишь удобная обёртка над ним.
_ANEClient: прямой доступ к Neural Engine
Ниже приведена полная последовательность действий для компиляции и запуска программы на ANE без Core ML:
// 1. Получаем общее подключение клиента
id client = [_ANEClient sharedConnection];

// 2. Создаём ссылку на модель
id model = [_ANEModel modelAtURL:compiledURL key:@"mykey"];

// 3. Компилируем MIL-текст в бинарный файл E5
// Результат сохраняется в кеше
[client compileModel:model options:@{
    @"kANEFModelType": @"kANEFModelMIL",
    @"kANEFNetPlistFilenameKey": @"model.mil"
} qos:21 error:&err];

// 4. Загружаем программу на оборудование ANE
[client loadModel:model options:@{} qos:21 error:&err];
// → назначается programHandle, глубина очереди — 127

// 5. Создаём буферы ввода-вывода IOSurface
IOSurfaceRef surface = IOSurfaceCreate(props);
id wrapped = [_ANEIOSurfaceObject objectWithIOSurface:surface];

// 6. Формируем запрос на выполнение
id req = [_ANERequest requestWithInputs:@[wA, wB]
    inputIndices:@[@0, @1]
    outputs:@[wOut]
    outputIndices:@[@0]
    weightsBuffer:nil
    perfStats:nil
    procedureIndex:@0];

// 7. Выполняем программу на ANE
[client evaluateWithModel:model options:@{}
    request:req qos:21 error:&err];

// 8. Считываем результаты из выходного IOSurface
IOSurfaceLock(outSurface, kIOSurfaceLockReadOnly, NULL);
float *data = IOSurfaceGetBaseAddress(outSurface);
// ... считываем результаты ...
IOSurfaceUnlock(outSurface, kIOSurfaceLockReadOnly, NULL);
Для ввода-вывода используются IOSurface — тот же механизм разделяемой памяти, который применяется для текстур GPU. Теоретически это позволяет передавать данные между GPU и ANE без копирования, если обе подсистемы используют один и тот же IOSurfaceRef.
Главное открытие: ANE поддерживает глубину очереди в 127 запросов. Одновременно в обработке могут находиться до 127 запросов на выполнение. Это намного больше, чем у большинства очередей аппаратных ускорителей, и указывает на то, что ANE рассчитан на потоковый инференс с высокой пропускной способностью.
MIL: входной язык
Core ML передаёт нейросети в ANE не в формате ONNX или protobuf. Для этого используется MIL — Machine Learning Intermediate Language, типизированное промежуточное представление в форме статического однократного присваивания (SSA), которое выглядит так:
program(1.3)
[buildInfo = dict<string, string>({
    {"coremltools-version", "9.0"}
})]
{
    func main<ios18>(
        tensor<fp16, [1, 1024, 1, 1024]> x,
        tensor<fp16, [1, 1024, 1, 1024]> w
    ) {
        bool tx = const()[val = bool(false)];
        bool ty = const()[val = bool(false)];
        tensor<fp16, [1, 1024, 1, 1024]> out =
            matmul(transpose_x = tx, transpose_y = ty,
                   x = x, y = w);
    } -> (out);
}
MIL оказался на удивление читаемым. Для каждого значения указаны и точность, и форма. Операции имеют понятные имена и принимают именованные аргументы. В сигнатуре функции входные тензоры объявляются с явным указанием размерностей.
Формат размещения тензоров соответствует нативному для ANE представлению NCDHW + Interleave: [Batch, Channels, Depth, Height, Width]. Для матрицы размером 1024 × 1024 в четырёхмерном представлении это будет [1, 1024, 1, 1024].
Бинарный формат E5
Когда ANECompiler обрабатывает программу на MIL, он создаёт бинарный файл E5 — файл со структурой FlatBuffers, состоящий из следующих разделов:
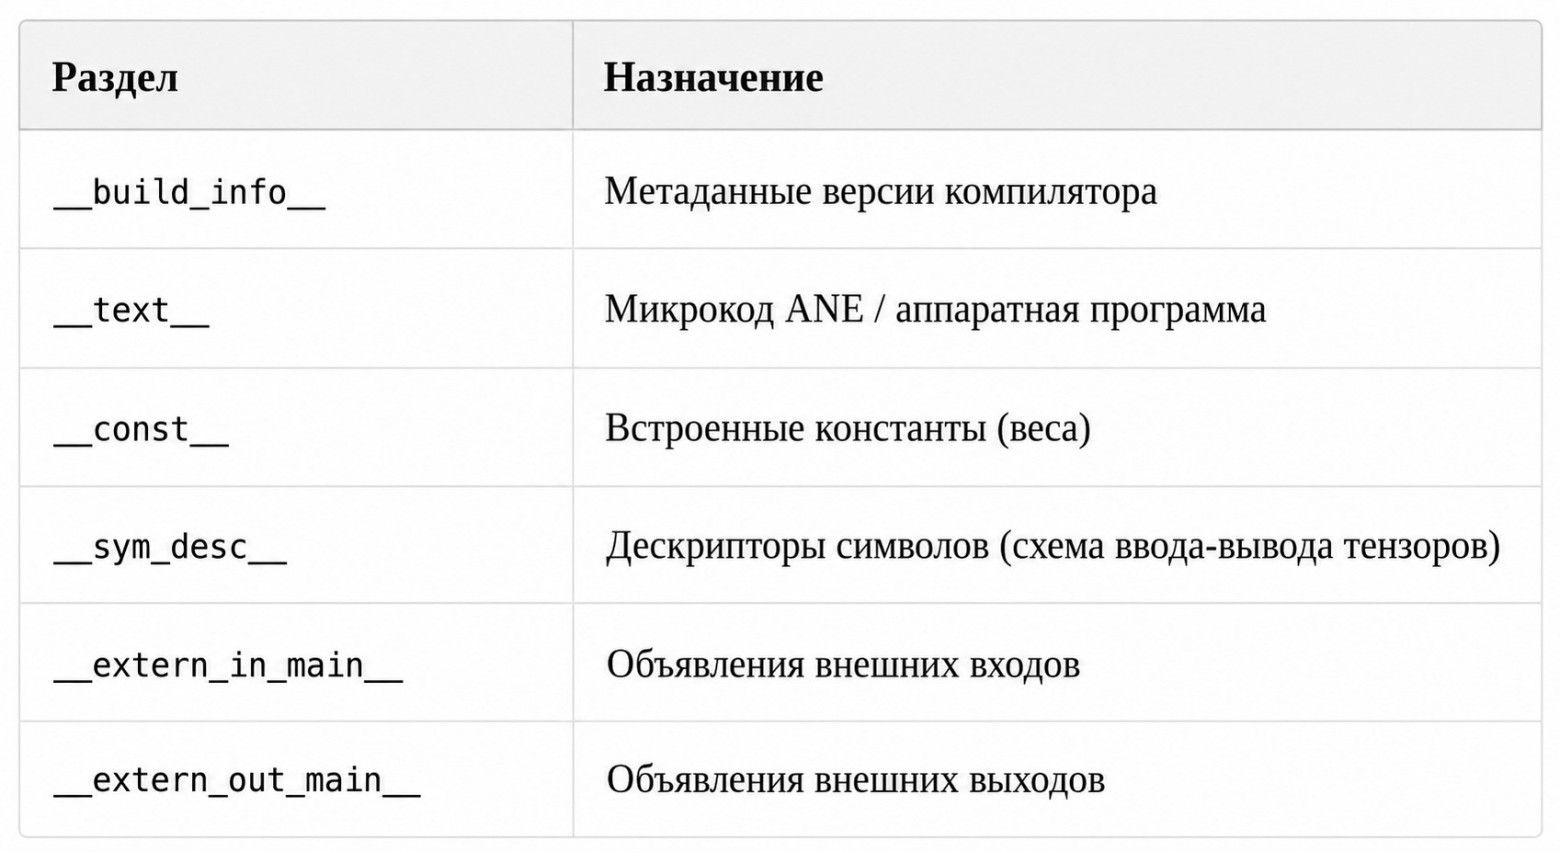
Самое интересное: матричное умножение размером 1024 × 1024 компилируется в файл объёмом 2688 байт, а размером 128 × 128 — в 2680 байт. Размеры почти совпадают. Бинарный файл E5 не содержит реализацию алгоритма матричного умножения. Он описывает параметризованную программу, поведение [11] которой во время выполнения определяется дескрипторами тензоров. Этот «микрокод» больше похож на конфигурацию, чем на традиционный машинный код.
Отсюда следует, что оборудование ANE, вероятно, поддерживает небольшой набор фиксированных вычислительных примитивов: свёртку, матричное умножение и поэлементные операции. Их параметры задаются дескрипторами формы тензоров. Бинарный файл E5 описывает, какие примитивы нужно объединить в цепочку и как связать их между собой, а не сами вычисления.
Компиляция в памяти: Святой Грааль
Компиляция через файлы работает, но у неё есть недостаток: MIL-текст приходится записывать на диск, создавать структуру каталогов и передавать компилятору путь к ней. Для обучения, где модель нужно перекомпилировать с обновлёнными весами через каждые несколько шагов, такие постоянные обращения к файловой системе неприемлемы.
Мы обнаружили класс _ANEInMemoryModelDescriptor, который принимает MIL-текст непосредственно из памяти:
id desc = [_ANEInMemoryModelDescriptor
    modelWithMILText:milData      // NSData*, а не NSString*!
    weights:weightDict            // NSDictionary*, а не NSData*!
    optionsPlist:nil];

id model = [_ANEInMemoryModel
    inMemoryModelWithDescriptor:desc];

[model compileWithQoS:21 options:@{} error:&err];
[model loadWithQoS:21 options:@{} error:&err];
[model evaluateWithQoS:21 options:@{}
    request:req error:&err];
Чтобы всё заработало, нам пришлось разобраться с тремя неочевидными нюансами, на которые ушло несколько дней отладки:
-
NSData, а не NSString. Параметр
milTextожидает объект NSData* с байтами в кодировке UTF-8, а не NSString*. Если передать строку, операция завершится без явной ошибки [12], но работать не будет. -
NSDictionary, а не NSData. Параметр weights принимает словарь, в котором имена весов сопоставлены с объектами NSData, а не единый буфер данных.
-
Обходной путь с временным каталогом. Даже вариант «в памяти» внутри всё равно записывает данные во временный каталог. Если у процесса нет прав на запись в каталог по умолчанию, компиляция завершается с малопонятной ошибкой. Поэтому нам пришлось обеспечить доступный для записи временный путь.
И ещё одна забавная находка: во внутреннем коде Apple в имени одного из классов встречается Desctiptor — именно так, с опечаткой. Даже инженеры Apple ошибаются в закрытых API. :)
Аппаратный профиль: что нам известно
С помощью исследования IOKit, анализа масштабирования и измерения энергопотребления мы составили следующий профиль ANE в M4:
Каналы DVFS
IOReportLegend в IOKit показывает, что ANE использует собственную независимую систему управления питанием с адаптивным тактированием, дизерингом и несколькими аппаратными и программными триггерами:
|
|
Столь развитая система DVFS указывает на то, что ANE может независимо изменять частоту и напряжение в зависимости от характера нагрузки, отдельно от доменов питания CPU и GPU.
Поддерживаемые операции
Судя по экспортируемым символам ANECompiler.framework, ANE аппаратно поддерживает следующие операции:
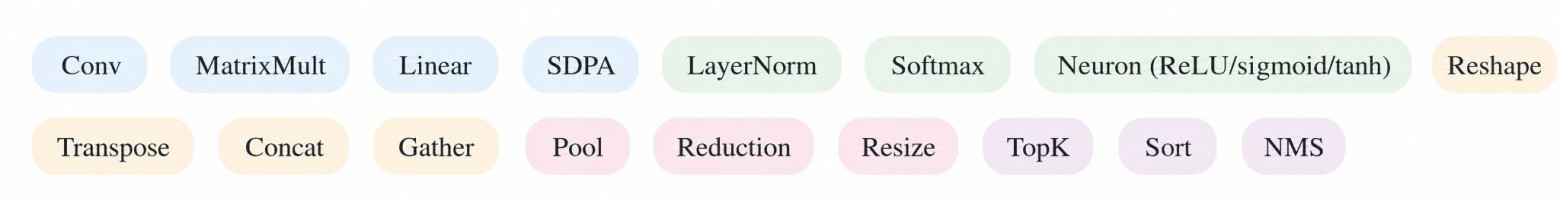
Примечательно, что основным вычислительным примитивом ANE, по всей видимости, служит Conv. Во второй части мы покажем, что представление matmul в виде свёртки 1×1 позволяет значительно повысить пропускную способность.
Протокол IOSurface
Все данные передаются в ANE и обратно через IOSurface. Протокол устроен достаточно просто:
// Создаём IOSurface для тензора float размером 1024×1024
NSDictionary *props = @{
    @"IOSurfaceWidth":           @(1024),
    @"IOSurfaceHeight":          @(1024),
    @"IOSurfaceBytesPerElement": @(4),     // float32
    @"IOSurfaceBytesPerRow":     @(4096),  // 1024 * 4
    @"IOSurfaceAllocSize":       @(4194304),
    @"IOSurfacePixelFormat":     @(0)
};
IOSurfaceRef surface = IOSurfaceCreate(props);

// Записываем данные
IOSurfaceLock(surface, 0, NULL);
float *ptr = IOSurfaceGetBaseAddress(surface);
memcpy(ptr, data, 4194304);
IOSurfaceUnlock(surface, 0, NULL);

// Оборачиваем для ANE
id wrapped = [_ANEIOSurfaceObject objectWithIOSurface:surface];
Поскольку IOSurface — тот же механизм, который используется для совместного доступа к текстурам GPU, появляется возможность создавать конвейеры GPU ↔ ANE без копирования данных, в которых оба ускорителя работают с одной и той же областью памяти.
Кеш компиляции
Компилятор ANE сохраняет бинарные файлы E5 на диске, чтобы не компилировать модель повторно:
~/Library/Caches/<app>/com.apple.e5rt.e5bundlecache/<build>/<hash>/
  <hash>.bundle/
  └── H16G.bundle/           ← H16G — целевая платформа ANE в M4
      ├── H16G.e5            ← бинарный файл FlatBuffers объёмом 2–3 Кбайт
      └── main/
          └── main_ane/
              └── model.anehash
Первая компиляция занимает около 20–40 мс. При попадании в кеш затраты практически отсутствуют. Для инференса это удобно: модель можно скомпилировать один раз и затем выполнять сколько угодно. Но при обучении возникает проблема, поскольку веса меняются на каждом шаге.
Неисследованные возможности
Некоторые обнаруженные классы мы пока не изучили. Они намекают на возможности, которые ещё предстоит проверить:
-
_ANEChainingRequest— возможно, позволяет объединять несколько скомпилированных моделей в один запрос на выполнение; -
ANESharedEvents/ANESharedSignalEvent/_ANESharedWaitEvent— примитивы барьеров и сигналов в стиле Metal для синхронизации GPU ↔ ANE; -
_ANEPerformanceStats— возможно, предоставляет доступ к аппаратным счётчикам производительности; -
_ANEVirtualClient— виртуализированный доступ к ANE, потенциально предназначенный для совместного использования несколькими процессами.
Кое-чего мы действительно пока не знаем:
-
точную микроархитектуру ядер ANE и систему команд;
-
как ядра распределяются между операциями внутри вычислительного графа;
-
тактовую частоту ANE, поскольку DVFS динамически изменяет её;
-
доступны ли аппаратные счётчики производительности;
-
точную топологию SRAM: разбита ли она на банки, является ли общей или выделяется отдельно каждому ядру.
Что дальше
Теперь, когда у нас есть прямой доступ к ANE, можно измерить его реальные возможности. Во второй части мы проведём полный набор бенчмарков: исследуем масштабирование matmul, резкое падение производительности при выходе за пределы SRAM, выясним, почему свёртка работает в три раза быстрее matmul, почему заявление Apple о «38 TOPS» вводит в заблуждение и как обход Core ML позволяет увеличить пропускную способность в 2–4 раза.
А в третьей части мы сделаем то, что Apple считает невозможным: обучим нейросеть на Neural Engine.
Когда после реверс-инжиниринга закрытого ускорителя хочется лучше понимать, что происходит ниже уровня библиотек и обёрток, одной теории быстро становится мало. Практика с интерфейсами микроконтроллеров и модулями ядра помогает связать протоколы, драйверы и работу с железом в единую картину. Присоединяйтесь к бесплатным разборам:
-
12 августа, 20:00. «Тайный язык общения чипов. Подключаем всё к ESP32». Записаться [13]
-
17 августа, 20:00. «Что такое модуль ядра. Как его написать, собрать, запустить». Записаться [14]
Полный список бесплатных уроков августа смотрите в дайджесте. [15]
Автор: kmoseenk
Источник [16]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/34268
URLs in this post:
[1] Core ML: https://developer.apple.com/documentation/coreml
[2] реверс-инжинирингом: https://otus.pw/JqbK/
[3] обучение: http://www.braintools.ru/article/5125
[4] hollance/neural-engine: https://github.com/hollance/neural-engine
[5] поведение: http://www.braintools.ru/article/9372
[6] источник информации: http://www.braintools.ru/article/8616
[7] mdaiter/ane: https://github.com/mdaiter/ane
[8] eiln/ane: https://github.com/eiln/ane
[9] apple/ml-ane-transformers: https://github.com/apple/ml-ane-transformers
[10] памяти: http://www.braintools.ru/article/4140
[11] поведение: http://www.braintools.ru/article/5593
[12] ошибки: http://www.braintools.ru/article/4192
[13] Записаться: https://otus.pw/qscrH/
[14] Записаться: https://otus.pw/wBcj/
[15] в дайджесте.: https://otus.pw/9Pu4/
[16] Источник: https://habr.com/ru/companies/otus/articles/1069184/?utm_campaign=1069184&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.