Автоэнкодер как динамическая система, латентное векторное поле, его аттракторы и другие красивые слова
Привет, друзья!
Меня зовут Сабрина, я XAI/MI researcher, и это наш новый туториал и в этот раз он ближе к разбору статьи. Если вы не знаете ни одного термина из заголовка — вам можно и нужно читать статью — она написана с целью познакомить Вас со всеми терминами во время прочтения.
Работать будем с двумя красивыми вещами. Первая — из DL: автоэнкодеры. Вторая — из математики: динамическая система и то, что расположено внутри нее.
Изучать динамическую систему в AE будем на основе публикации Navigating the Latent Space Dynamics of Neural Models [1]. Приступим!
Введение
Работа Navigating the Latent Space Dynamics of Neural Models [1] попалась мне на глаза ещё в мае 2025 и привлекла своей необычной постановкой. Сейчас, в сентябре 2026 наконец-то её разбирая, я рада увидеть её принятой на ICLR 2026!
Наш план на разбор большой, отсюда вы можете читать его по частям, возвращаясь к нужным. Для разбора как всегда также есть ноутбук для запуска plug-and-play. В процессе туториала, идя по нему step-by-step, у нас получится:
-
Задать определение векторного поля в общем смысле и посмотреть, что это за объект внутри модели.
-
Узнать детали поля (когда пояляется, как сходится, какие есть теоремы).
-
Узнать, что такое аттракторы, бассейны притяжения и и как найти их (вместе с тонкостями процесса).
-
Проанализировать, как поле эволюционирует за обучение [2].
-
Увидеть, зачем это надо, кроме красивых картинок.
-
Порадоваться — ведь шесть шагов выше — это разбор ICLR статьи и вы его преодолели.
Шаг 6 — самый значимый. Если вы будете “трогать” термины впервые — это титанический труд — дойти до конца. Поэтому не сдавайтесь, читайте, перечитывайте и всё получится! Приступим.
Часть 1. Поле внутри модели
1.1 Автоэнкодер и его латент
Начнём с начала. Как я писала выше, первым объектом этого туториала для нас будет автоэнкодер. Вспомним, что его задает.
Авторэнкодер
есть пара энкодер и декодер (
), где энкодер
сжимает (или разжиает) вход
в представление
, декодер
восстанавливает по этому представлению объект обратно. Учится конструкция автоэнкодера так, чтобы композиция
могла восстановить объект, то есть дать
. Чаще всего, для этого валидно использовать MSE и для эффективности можно добавить регуляризационный член:
где
— явная (ограничение на параметры) или неявная (ограничение на обучение) регуляризация.
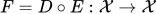
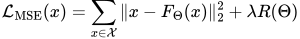
В такой постановке у нас:
-
Видно, что чтобы задать модель нужны две части
-
Четко выделена компонента
 , от которой зависит восстановление и успешность обучения.
Далее нас будет интересовать именно  , причем всё целиком. Его назовём латентным пространством. Вопрос, который мы будем исследовать: как проанализировать латентное пространство, имея в арсенале обе части модели.
Почему нас так интересует латент?
По постановке, латенты должны быть богаты (и в случае хорошего обучения они такие и есть). Это следствие интуиции — на основе их, сжатых/расжатых, декодер в случае успешного обучения близко восстанавливает исходный объект. И это всегда делало латетнты важным объектом анализа.
В качестве подопытного, обучим автоэнкодер с представлением размера  на 10 000 картинках MNIST. Такой размер скрытого представления дает нам власть строить векторное поле на плоскости в точном его виде — без сжатий и потерь информации.
Стандартный анализ латентов и ноу-хау, с которым мы будем работать
Как я уже сказала, идея анализа латентов не нова. Стандартно их принять анализировать следующей последовательностью шагов:
-
Поставить вопрос: как в модели кодируется “что-то”? (Выбрать, что)
-
Рассмотреть некоторые данные (сет подбирается под задачу, например разные классы, или конкретно-специфическая выборка);
-
Прогнать данные через через энкодер и снять представления для анализа;
-
Получить “след” и проанализировать его (например, объекты одного класса обычно сбиты в кластер, можно посмотреть, как одна картинка перетекает в другую, а ещё можно подвигать представления на основе направлений из разностей центроид между классами).
Такая постановка задачи сфокусирована на том, что:
-
латент определен и понимается как карты объектов: множество точек плюс наше описание на языке слов, направлений и центроид того, как оно себя ведет.
-
объект интерпретации — расположение конкретных данных в модели, но не сама модель;
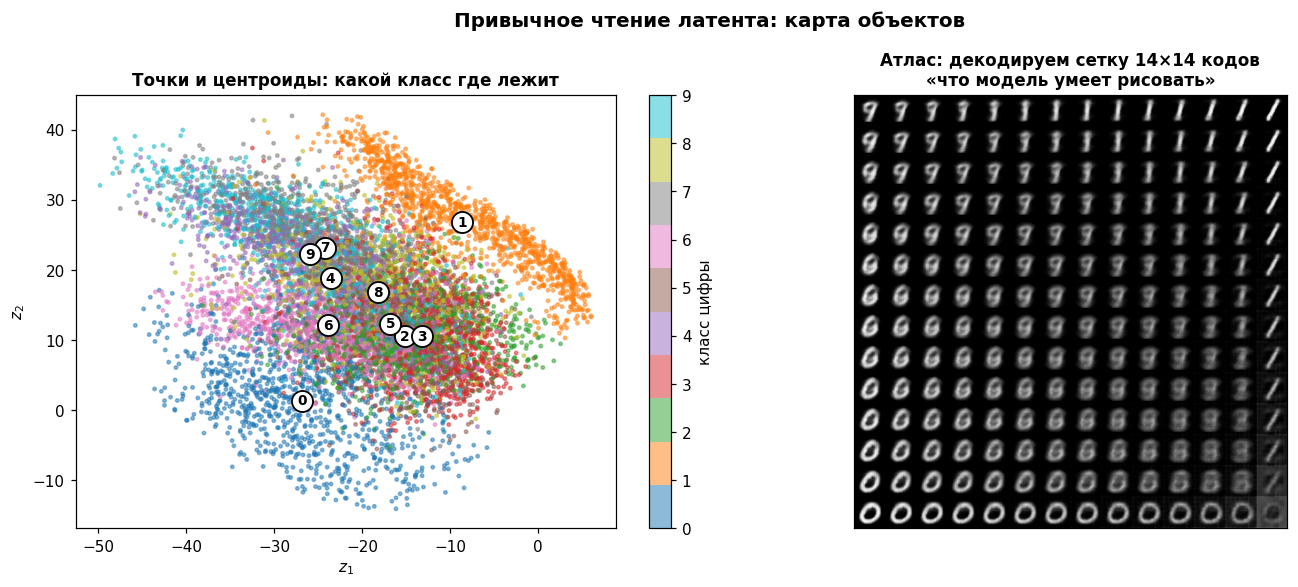
Построение графиков
Слева. Прогоняем все 10 000 обучающих картинок через энкодер и рисуем полученные коды  точками с цветом по классу цифры, а поверх ставим центроиды — покоординатные средние кодов внутри каждого класса.
Справа. Рассматриваем облако латентов справа. По каждой из координат берем по 14 и строим сетку из  кодов, накрывающую облако латентов (узлы расставлены по квантилям от 2-го до 98-го процентиля каждой оси). Далее декодируем каждый узел и выкладываем 196 полученных картинок в одно полотно в том же порядке — так что соседние клетки отвечают соседним точкам латента (отсюда плавный переход).
1.3. Нестандартный анализ: смена парадигмы
Постановка выше рассказала нам про расположение данных в модели, но не сказало, а что внутри себя собрала модель. Для ответа на такой вопрос, авторы Navigating the Latent Space Dynamics of Neural Models [1]предложили рассмотреть AE сам по себе, как некоторую систему, изучившую некоторую структуру. Для этого предложено изучить следующую конструкцию:
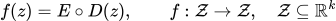
Да! Энкодер от декодера. По определению — это отображение латентного пространства в себя, а раз это отображение в себя, то можно повторить его сколь угодно много раз: 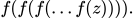
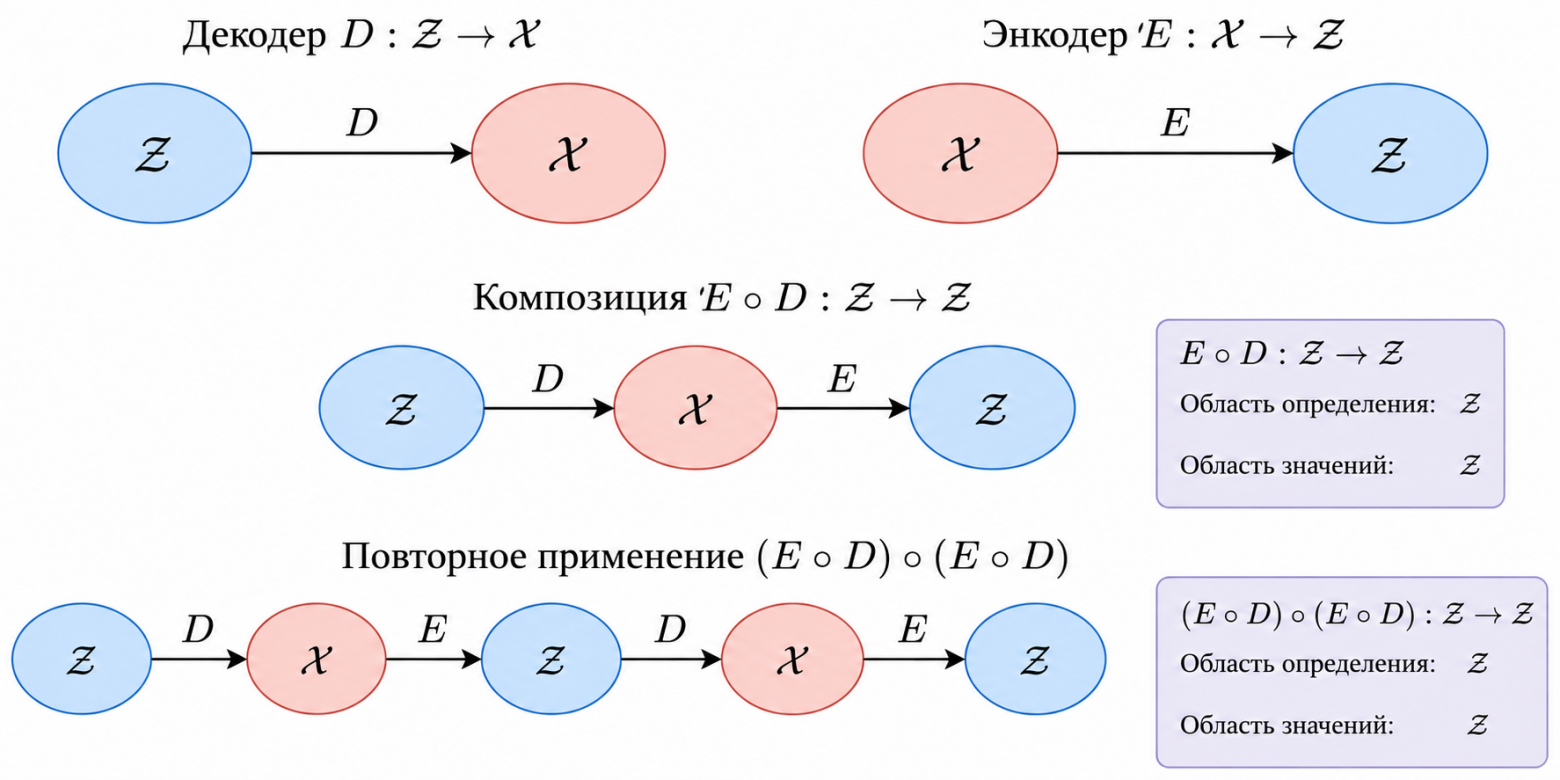
 , энкодер
 . Значит композиция
 начинает в
 уходит в
 и возвращается обратно в
 . Область определения и область значений отсюда — одно и то же множество, и только поэтому результат можно подать этой же функции на вход ещё раз. У композиции
 типы тоже сходятся (
 ) (при достаточном качестве обучения), и её тоже можно итерировать. Это вариант классической постановки.
Заметим, что:
-
Такое представление ограничено тем и только тем, что выучила внутри себя сеть и стало быть будет тем хуже, чем хуже наш AE;
-
Мы можем получить случай
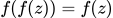 (неподвижную точку). Тогда как в постановке
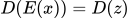 у нас такие точки скорее артефакт переобучения и как правило не возникают, тут они — просто точки, ибо как выглядит прострнство внутри энкодера мы не знаем (и хотим узнать).
Неподвижные точки будем далее обозначать как

Тождественность f как побочный эффект обучения.
Заметим, что лосс требует 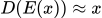 . Рассмотрим фиксированную картинку
 из множества тестовых данных с представлением
 . Для неё по определению выполнено
 если модель хорошо обучена. Поставим это в исследуемую композицию
 :
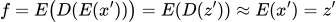
отсюда на латентах данных обучения, валидации и теста $f$ почти тождественна. Однако, важно зафиксировать, что:
-
«Почти» — это в точности до уровня качества модели. Даже если ошибка [3] реконструкции будет порядка 0.05, то невязка, малая в начале, будет накапливаться с количеством взятия
 .
-
На всём
 остается (достаточно большое) подмножество
 . которое никогда не появлялось в данных (и может там вообще не быть (например, ещё не придуманный шрифт MNIST-а)). На нём ничто не мешает
 вести себя как угодно, так как лосс туда доходил только ковсенно.
И здесь ещё раз виден тезис — композиция  — то, чему модель училась. Композиция
 нигде в лоссе не фигурирует: её поведение [4] на латентах данных получилось как следствие, а вне данных не контролировалось. И всё, что мы по постановке увидим в таком поле, — побочный эффект обучения, а не его цель.
Математический аппарат
Итак, у нас есть некоторое отображение в себя с последовательностью шагов. В частном случае, в математике [5] есть часть динамической системы. Неформально динамическая система — это всегда множество состояний, для которых справедлив переход друг меж другом в зависимости от параметра времени (или его аналога). Формально:
Динамической системой, заданной на (гладком многообразии)
, называется отображение
, записываемое в параметрическом виде
, где
оно дифференцируемо, и
— тождественное отображение
.
Гладкость нам нужна для диффенцируемости, а многообразие — для того чтобы видеть близость нашего  к чему‑то линейному.
Теоретическое примечание
При этом: для стационарных обратимых систем семейство  образует группу (в смысле математической группы) преобразований, то есть
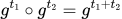 . Само
 при этом называют фазовым пространством, а траекторию точки под действием
 — фазовой траекторией.
Стационарность — значит, что правило движения не зависит от того, который час (который шаг):  определяется только длительностью
 , а не моментом старта.
Обратимость значит, что двигаться можно и назад, для  .
В динамической системе допустимы “два подтипа”, зависящих от формана параметра  . Это:
-
Поток — параметр
 рассмотрен как непрерывное время. Это определение описывает ОДУ (обыкновенное дифференциальное уравнение)
-
Каскад — время идёт шагами, и система задаётся парой
 , где f
 . Траектория точки — последовательность
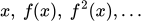
Чтобы нанести определение на нашу задачу, декомпозируем его:
|
В определении потока |
В задаче |
|
фазовое пространство |
латентное |
|
Гладкое многообразие |
Также многообразие |
|
Отображение |
Определено:
|
|
Непрерывное время |
Дискретное время: |
|
|
Можно определить как |
|
|
|
|
Семейство |
|
|
|
Производной по времени нет, но есть производная |


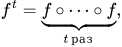


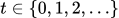


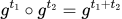
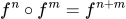


Строки 1, 2, 3 и 5 и 6 совпадают. Седьмая — нет, ибо  не обратима, а обратного элемента для
 нет по построению, так как
 сминает
 в
 , и разные точки после шага становятся неразличимы (нет взаимо-однозначного соответствия).
Четвертная и восьмая расходятся же так как время дискретно, откуда отношение приращения функции к бесконечно-малому приращению аргумента ( ) не определено (оно (приращение) у нас всегда фиксрованного размера).
Отсюда, когда мы работаем с преобразованиями, описаннывами выше — мы в случае каскада и работаем с дискретным временем.
Шаги в пространстве: дискретное против непрерывного
-
Когда мы идем дискретно, мы идем прыжком на весь вектор сразу. Производной по времени нет: последовательность z
 не является функцией непрерывного аргумента, и брать
 не от чего. Её аналог — конечная разность:
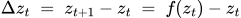
-
Когда мы идем непрерывно, двигаясь вдоль вектора и пересчитывая направление бесконечно часто. Вот здесь производная появляется, и получается обыкновенное дифференциальное уравнение:
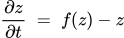
Правые части уравнений одинаковые — это одно и то же поле. Отличается только левая: конечная разность против производной. Непрерывный вариант — предел дискретного при длине шага  , а наша итерация — противоположный край:
 , грубый шаг из возможных. Формально это метод Эйлера.
Метод Эйлера
Метод Эйлера приближает решение 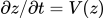 так:
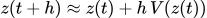 . Подставим
 и
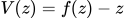 :
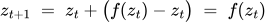
— что есть наша итерация, где  означает, что малости шага нет, и отсюда:
Траектории разные. Точка, прошедшая  шагов итерации, — это не та точка, в которую её привёл бы поток за время
 . Мы считаем ломаную, а не кривую потока.
А вот неподвижные точки, о которых мы ещё поговорим ниже, будут одни и те же. Условие  равносильно
 , никакого приближения здесь нет. То есть пути разные, а концы совпадают — и именно поэтому искать итерацией то, что живёт в непрерывной картинке, корректно.
Благодаря шагам, мы можем попробовать восстановить будущее каждой точки. Объект, который его задаёт, есть вектор 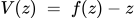 , а набор всех таких векторов, по одному в каждой точке пространства, называется векторным полем.
Для непрерывного времени  , введенный выше — это скорость. Он описывает, в какую сторону и как быстро она движется прямо сейчас. Будущее точки — решение уравнения
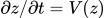 : гладкая кривая, которая в каждой своей точке касается поля. Путь, пройденный за время
 , — это как раз
 из определения выше.
Для дискретного времени это приращение: куда точка попадёт ровно за один шаг.
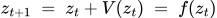
Будущее точки — последовательность 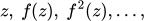 то есть ломаная из конечных отрезков. Между узлами не происходит ничего: промежуточных положений у точки нет.
Неподвижные точки и аттракторы
Кажется, на этом этапе время устать от теории и снова посмотреть в модель. Уже выше, если вы читали каты, мы заметили особые точки — такие, что  , то есть
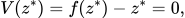
 . Такие точки называют неподвижными и к ним можно прийти с разных сторон поля. Если траектории всех достаточно близких точек сходятся к
 , будем называть её аттрактором.
Отлично. Определения в наших руках, и время посмотреть на них в нашем AE. Возьмём 2600 стартовых точек и поищем траектории с наивным приближением аттракторов. Для этого выполним для них итерацию  для каждой точки. Полученные точки (куда переходили
 после функции) склеим по евклидовой норме 0.1 — это будут неподвижные точки.
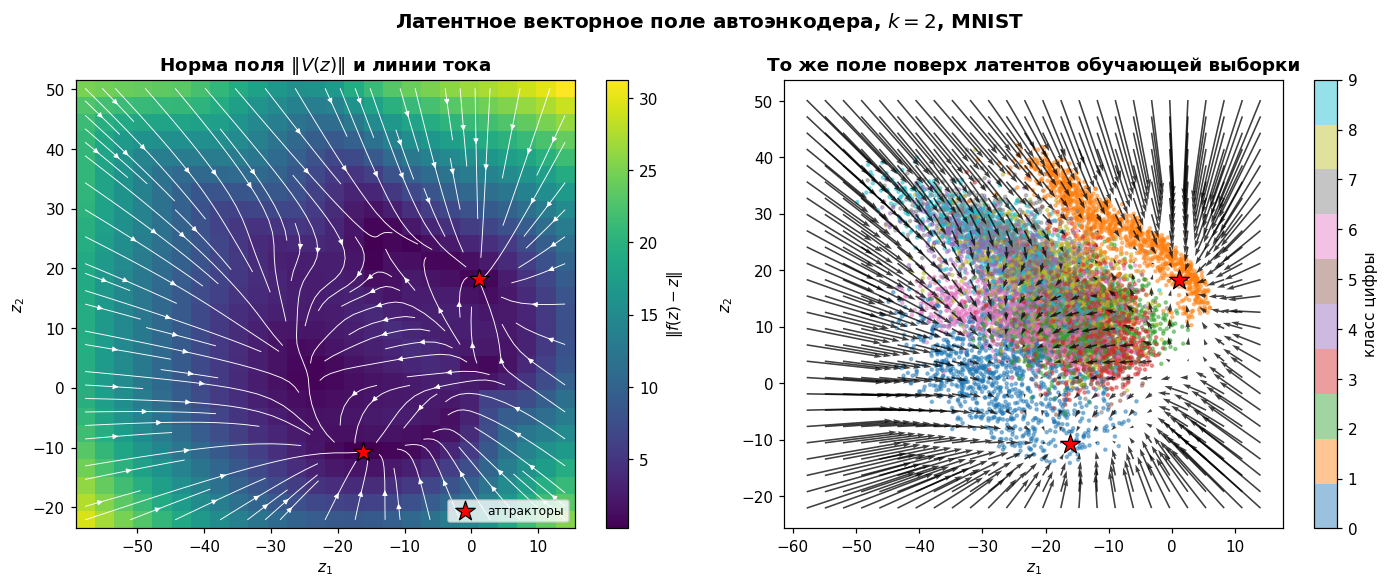
Что задает картинка:
-
Структуру. Стрелки почти отовсюду они указывают внутрь, в область, где лежат латенты обучающих картинок.
-
Места, где поле обнуляется (белые области). Там $f(z) approx z$: кодирование и декодирование перестают что-либо менять. У нашей модели таких точек две, и обе есть наши аттракторы по определению 2 (невязка
 порядка
 и
 ).
-
Норма поля растёт с удалением от данных. Чем дальше точка от того, что модель видела, тем сильнее её движение или, говоря иначе, длина стрелки — мера «насколько эта точка чужая». В блоке “практическое применение” мы увидим, как из этого следствия авторы предлагают строить OOD-детектор.
Почему мы сходимся к (почти) неподвижности?
Гипотеза работы — потому что нейросети — сжимающие.
Сжимающее отображение — это такое, которое сближает любые две точки: если взять
и
и применить к ним
, расстояние между ними гарантированно уменьшится, причём не меньше чем в фиксированное число раз. Отсюда получаем сходимость: за
шагов расстояние падает как
, то есть геометрически, и любые две траектории рано или поздно “склеиваются”.
Оценить сжимаемость можно: это описано в практической тетради к разбору. Вкратце — модели сжимающи ещё при инициализации — то есть до обучения.
После обучения — сжимающие свойства отображения ухудшаются на обучающих данных и становятся тем сильнее, чем ближе мы к границе вне обучающих данных. Это происходит потому, что процесс обучения вынуждает модель не терять информацию о точках. Отсюда лоссом модель получает штраф за любое сжатие (оно приводит к потери информации).
Одно из чисел, характеризующее сжимаемость, есть характеристика, связанная с альтернативным определением сжимаемости через липшицевость.
Липшцевость: определение
Функция  липшицева, если существует константа
 такая, что для любой пары точек
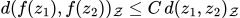
С другой стороны, данная константа может быть описана через Якобиан, как:
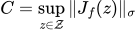
где  — спектральная норма (максимальное сингулярное число).
При  отображение называется сжимающим (contractive) (то есть константа — наш первый индикатор сжимаемости). На наших данных сжимаемость есть, однако по выборке она скорее непрерывная характеристика:
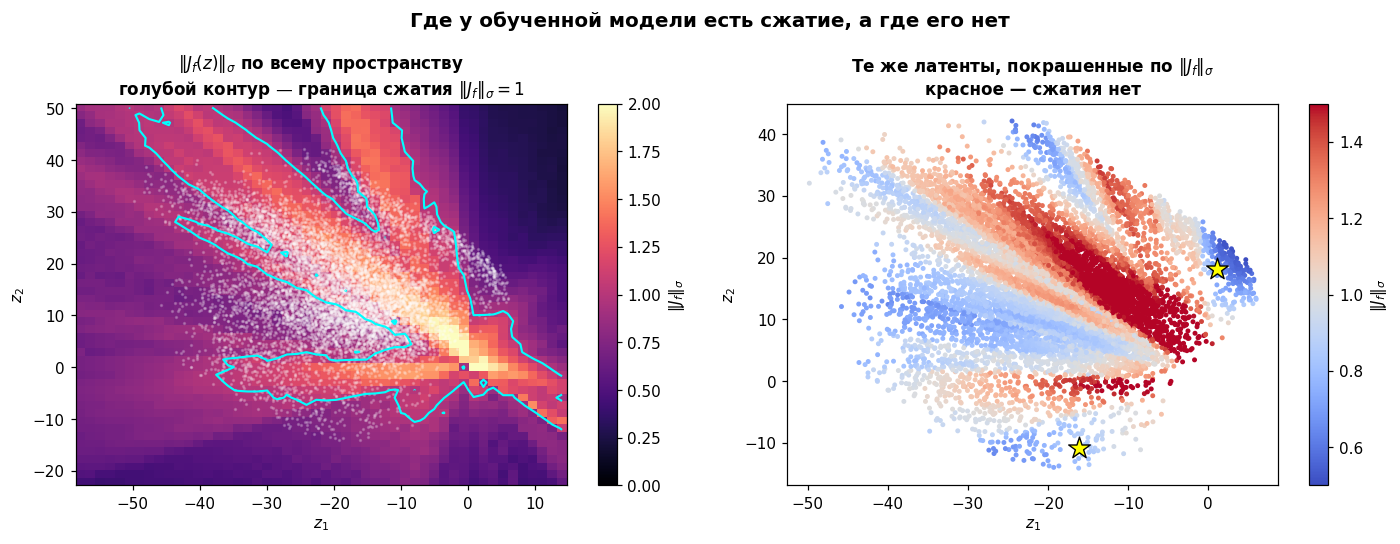
Заметим, что сжимаемость не бинарна (есть или нет), а скорее непрерывна по удалению от данных::
-
На обучающих данных — сжатия нет: средняя норма примерно 1.08, и условие сжатия < 1 выполняется меньше чем в половине точек.
-
Сразу за краем облака оно уже появляется: медиана
 , условие выполняется в 87%.
-
Далеко от данных модель сжимающая: медианная
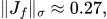 условие < 1 выполняется в 96% точек.
Это закономерно из обучения. На данных автоэнкодер обязан не терять информацию, иначе реконструкция развалится. Отображение, сохраняющее информацию, локально близко к изометрии (сохраняет расстояния между точками), то есть  .
Сжимать до нуля модель может себе позволить только там, где ничего ценного нет — то есть вне носителя данных.
Запомним результат: сжатие живёт на подходе к данным, а не внутри них. Сам по себе — он интерес [6] при внутренней работе с моделями.
Поиск аттракторов
Итак, аттракторы особы. Выше мы нашли две неподвижные точки на основе движения: проитерировали 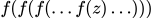 до остановки и склеили полученные точки по евклидовой норме.
Наши точки получились при одном конкретном наборе: столько-то стартов, такой-то бюджет итераций, такой-то порог склейки. Если поменять любую из них — ответ может измениться и перед нами возникает вопрос — как искать оптимально?
В работе, авторы приводят следующий алгоритм (Appendix D):
-
Взять стартовые точки
 (латенты обучающих данных, латенты теста, или просто гауссов шум).
-
Итерировать
 , пока
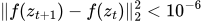 (или
 дляпредобученных моделей в разделах 4.1–4.2), но не более
 шагов (или соответственно
 ).
-
Считать две точки остановки одним и тем же аттрактором, если
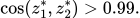
Здесь каждый из трёх шагов тоже содержит порог, который тоже повлияет на сам ответ. Обойтись без порогов на шагах поиска аттракторов мы не сможем и нас настигают ограничения:
-
Дедупликация по косинусу или норме полагает, что «две точки — один и тот же аттрактор, если угол/норма между ними мала». Однако в такой постановке важно помнить, что мы перенимаем также ограничения метрик:
— Косинус не видит нормы. Точки (1, 0) и (100, 0) имеют
 и будут объявлены одним аттрактором, хотя расстояние между ними — 99. Для латентных пространств, которые почти всегда анизотропны и имеют выделенное «среднее направление», это значит, что аттракторы, отличающиеся в основном длиной, схлопнутся в один.
— Норма относительна и требует пересчета на типичную норму пространства.
— Порог относительный к размерности. В
 два случайных вектора имеют
 , и порог 0.99 оказывается тут строгим: любые две точки остановки, различающиеся на доли процента, будут посчитаны разными аттракторами. В
 тот же порог — наоборот, щедрый.
-
Критерий отстановки:
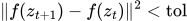 означает «мы медленно движемся». Для линейной динамики с коэффициентом сжатия $rho$ остаточная
ошибка связана с размером шага как
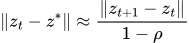
то есть при
 (у наших двух аттракторов
 равна 0.83 и 0.66) ошибка примерно в шесть раз больше последнего шага. Останавливаемся мы не в аттракторе, а в облаке вокруг него — и размер этого облака задаёт, сколько «разных» аттракторов мы потом насчитаем.
Следствие: «число аттракторов» — это не свойство модели, это свойство (набор стартовых точек, ограничения на итерации, критерий склейки точек).
Любое утверждение вида «у модели стало столько аттракторов» осмысленно только при репорте также условий нахождения!
И помимо количества также полезно анализировать качество. Его нам может дать граница в виде бассейнов.
Бассейны притяжения
Вспомним, что бассейном притяжения называется множество стартовых условий  , приводящих к одному и тому же
 . Построим их для нашего случая.
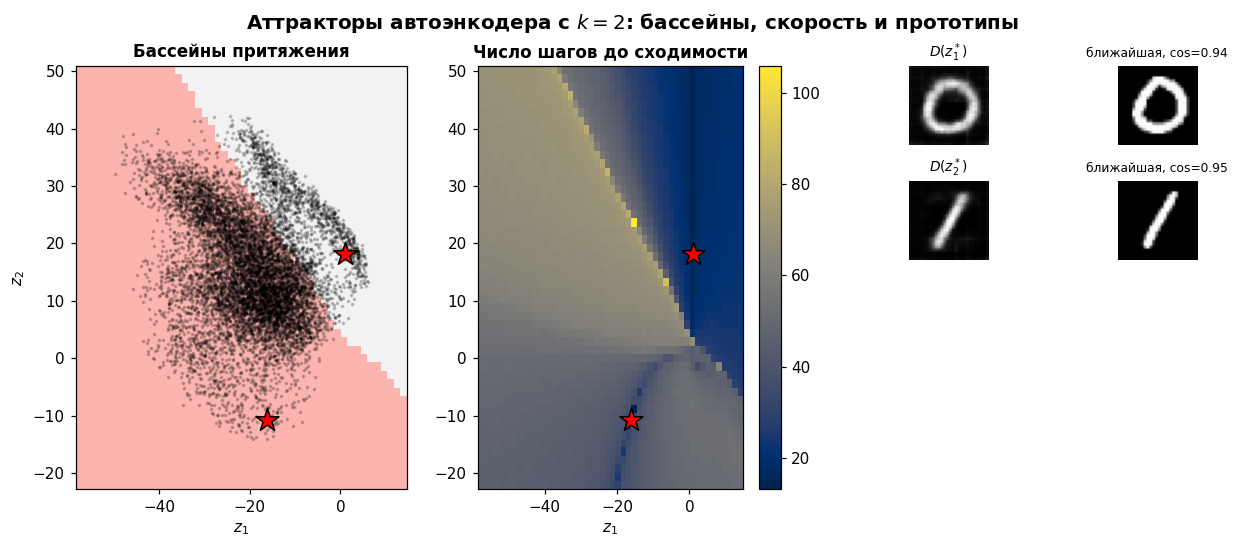
Заметим, что:
-
Граница бассейнов достаточно резкая. То есть динамика не непрерывна по начальным условиям, что закономерно, исходя из постановки нашего шага
 . Для динамических систем в простом случае такие границы валидные.
С точки зрения [7] переноса нашего математического аппарата на модели это дает дает вывод о том, что характеризовать точку ближайшим аттрактором некорректно в близости границы.
-
Число шагов до сходимости различно, но тоже имеет структуру. Причем быстрее сходимость там, где данных у нас мало. Это можно использовать для OOD-детекции, в статье также описано как.
-
Декодированные аттракторы есть простейшие цифры ноль и единица.
Зачем уделять аттрактором столько внимания [8]?
Основной тезис статьи: аттракторы — это словарь, который сеть выучила, и по нему видно, в каком режиме находится модель. Если аттракторы совпадают с обучающими примерами — модель запоминает. Если аттракторы стали абстрактными «строительными блоками» — модель обобщает.
Авторы описывают утверждение о формальной связи:
Пусть  — конечный словарь аттракторов,
 — проекция на ближайший аттрактор, а декодер
 липшицев с константой
 . Тогда для любой тестовой точки
 :
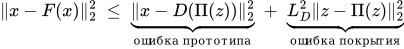
Смысл таков: ошибка реконструкции распадается на два члена. Первый —насколько хорош прототип: близка ли декодированная версия ближайшего аттрактора к самому объекту. Второй — насколько густо аттракторы покрывают латентное пространство. Запоминание [9] делает первый член нулевым на обучающих точках, но оставляет покрытие недостаточным. Обобщение требует, чтобы аттракторы одновременно были хорошими прототипами и густо покрывали пространство.
Эксперимент, показывающий, как разложение и баланс запоминания и обобщения меняется в процессе обучения также приложен в тетради (части 4 и 5).
Примечание: в статье у авторов опечатка в доказательестве. На вывод это не влияет, но будьте внимательны (разбор ошибки тоже отмечен в ноутбуке).
Что можно делать с теорией?
Data-free probing: что лежит в весах, если данных нет вообще
Постановка: Есть предобученная модель. Данных, на которых её учили, у нас нет. Вопрос: можно ли что-то содержательное из весов?
Идея статьи: сэмплируем 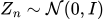 , итерируем до нахождения аттракторов и полученный набор объявляем словарём сигналов, после чего смотрим, насколько разреженно им кодируются реальные данные. У авторов это AE Stable Diffusion, 4096 шумовых точек и шесть датасетов и результат: аттракторы выигрывают на всех датасетах.
Мне это воспроизвести не удалось на рассмотренном простом примере и моя гипотеза — причина бедности словаря модели и простота постановки.
OOD-детекция по траекториям
Постановка (та же): Есть предобученная модель. Данных, на которых её учили, у нас нет.
Вопрос: пришёл ли объект из того распределения, на котором модель училась?
Идея статьи: у OOD-объекта есть два способа выдать себя и их и проверяем:
-
Его траектория не сходится к аттракторам обучающих данных — то есть он вообще в другом бассейне.
-
Даже если бассейн общий, он сходится иначе — обычно быстрее, потому что снаружи носителя данных поле сильнее (мы это видели в части 2:
 вдали и
 на данных).
Чтобы поймать оба случая , берётся вся траектория:
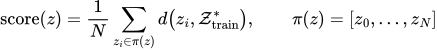
Полученная оценка (среднее расстояние) сравнивается с KNN в пространстве признаков (средняя дистанция до K ближайших обучающих латентов).
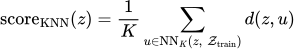
Разница между ними: траекторный скор меряет расстояние до аттракторов и вдоль всего пути, а KNN — до самих обучающих латентов и в одной точке. Аттракторы лежат в центре облака, обучающие латенты — по всему облаку.
Обе метрики качества считаются как качество классификации по одной разметке: ID получает метку 0, OOD — метку 1. AUROC — вероятность, что случайный OOD-объект получит скор выше случайного ID-объекта (0.5 — метод не различает ничего). FPR95 — берём порог по вероятности, пропускающий 95% своих, и смотрим, какая доля чужих через него просочилась; чем меньше, тем лучше.
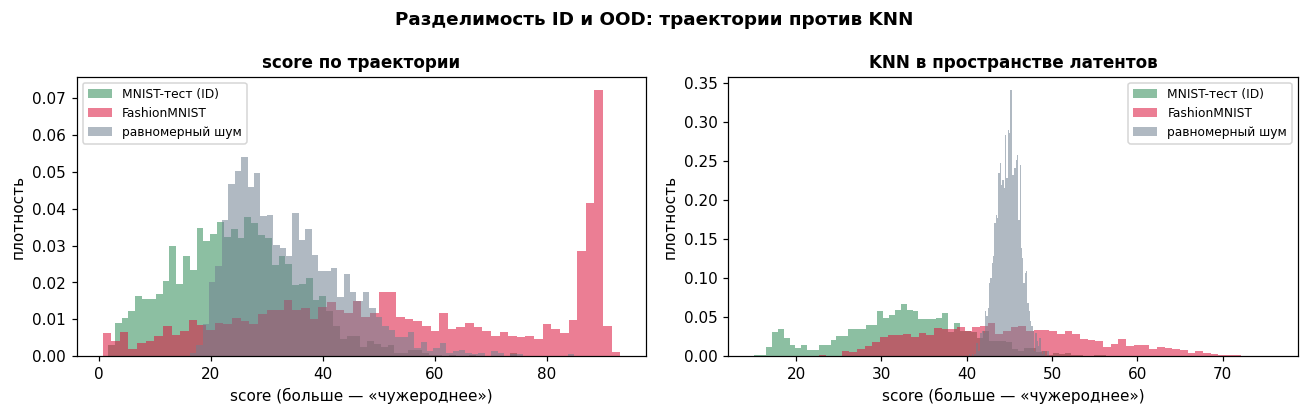
Рассмотрим этот эксперимент. Возьмем как ID — тест MNIST, OOD — FashionMNIST и равномерный шум, модель — наш k=32. Разделимость сравним на основе плотностей и на основе решения задач
обучающих аттракторов: на 1000 точек имеем 5 различных (в ноутбуке они ещё
и визулазированы)

Результаты по линейной разделимости

         OOD-набор |     траектории      |     KNN (K=50)
                   |    AUROC     FPR95 |    AUROC     FPR95
      FashionMNIST |    0.828     0.374 |    0.821     0.528
   равномерный шум |    0.729     0.807 |    0.943     0.517
Что видим. По горизонтали — значение скора, по вертикали — плотность. Хорошая картинка должна выглядеть выглядит как две несовпадающие горки: зелёная (свои) слева, цветная (чужие) справа. Чем меньше они перекрываются, тем выше AUROC.
-
Слева, траекторный скор. Зелёная и серая горки сидят друг на друге — шум по этому скору неотличим от настоящих цифр. Красная сдвинута вправо и имеет отдельный пик у правого края: часть FashionMNIST уезжает совсем далеко от аттракторов.
-
Справа, KNN. Серая горка превратилась в узкий пик, стоящий правее зелёной, — шум отлично отделяется. Красная широкая и сильно перекрывается с зелёной.
Почему плотности выглядят так по-разному.
Два скора — это две разные величины в разных единицах: слева среднее расстояние до пяти аттракторов вдоль тридцати шагов, справа — среднее расстояние до пятидесяти ближайших обучающих латентов в одной точке.
Диапазоны у них разные (0–95 против 15–70), а построение нормирует площадь каждой горки на единицу.
Поэтому узкое распределение рисуется высоким, широкое — низким, и высоту столбиков между панелями сравнивать нельзя — только форму и перекрытие.
Узкий серый пик справа следует из того, что две тысячи равномерно-шумных картинок статистически одинаковы, у них нет ни штрихов, ни структуры, поэтому и кодируются они почти в одну точку — и расстояния до обучающей выборки у них получаются почти одинаковыми.
Слева тот же шум размазан шире, потому что траекторный скор усредняет по тридцати шагам, а на этом пути точки успевают разойтись.
На сами метрики масштаб не влияет: и AUROC, и FPR95 зависят только от порядка скоров, а не от их абсолютных значений.
Обобщение и вывод
Итак, мы рассмотрели эксперимент, позволяющий изучить внутреннюю картину мира модели на основе идей из динамических система. Подход не общий и валиден только для автоэнкодеров, у дискриминативной модели — классификатора, энкодера-онли, next-token-предсказателя — его нет.
В статье это тоже рассмотрено и даже почти успешно, но с границами интерпретации экспериментов. А именно, описано, что:
-
можно обучить декодер поверх замороженного энкодера (в Appendix B.8.1 так сделано для DINOv2 и SigLIP2);
-
можно работать в выходном пространстве, определив поле как остаток
 ;
-
можно итерировать весь residual stream целиком (в Appendix B.8.2 — для Qwen3-0.6B и SmolLM2-1.7B).
Из других ограничений, справедливо также то, что пока мы рассматривали эксперимент в простом сетапе, мы получили не полную воспроизводимость (хотя основные геометрические паттерн воспроизвелись отлично, практические — не совсем точно и осмысленно в силу простоты данных).
Отсюда важно забрать с собой то, что когда пытаетесь повторить сильные результаты — будьте уверенны о близостях постановок вашего и рассматриваемого случая.
На этом у меня всё и вы молодцы!
Спасибо, что дочитали! Надеюсь, вы повторите что-то у себя или просто получили удовольствие от красоты теории.
До новых встреч, друзья!
Если понравилось, как всегда зову в:
-
[Telegram Blog, ru](https://t.me/jdata_blog [10])
-
[Другие туториалы (поставьте звездочку)](https://github.com/SadSabrina/XAI-open_materials [11])
Автор: sad__sabrina
Источник [12]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36225
URLs in this post:
[1] Navigating the Latent Space Dynamics of Neural Models: https://arxiv.org/abs/2505.22785
[2] обучение: http://www.braintools.ru/article/5125
[3] ошибка: http://www.braintools.ru/article/4192
[4] поведение: http://www.braintools.ru/article/9372
[5] математике: http://www.braintools.ru/article/7620
[6] интерес: http://www.braintools.ru/article/4220
[7] зрения: http://www.braintools.ru/article/6238
[8] внимания: http://www.braintools.ru/article/7595
[9] Запоминание: http://www.braintools.ru/article/722
[10] https://t.me/jdata_blog: https://t.me/jdata_blog
[11] https://github.com/SadSabrina/XAI-open_materials: https://github.com/SadSabrina/XAI-open_materials
[12] Источник: https://habr.com/ru/articles/1087240/?utm_campaign=1087240&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.